AI-чат с векторной памятью: постоянная семантическая память для агентов
2026-09-15
Jenova предлагает AI-чат с векторной памятью — диалоги, которые запоминают смысл, а не только несколько последних сообщений. По состоянию на сентябрь 2026 года большинство ассистентов по-прежнему забывают предпочтения, теряют контекст проекта и заставляют вас заново объяснять одни и те же файлы. Эта платформа хранит диалоги, документы и предпочтения, чтобы специализированные агенты могли извлекать нужный контекст по вашему запросу.
✅ Постоянная память между сеансами, а не скользящее окно, которое само себя очищает
✅ Семантическое извлечение вместо поиска по ключевым словам — находите то, что имели в виду, а не то, что напечатали
✅ Базы знаний, которые можно прикрепить один раз и повторно использовать для исследований, кода и текстов
✅ Одна и та же модель памяти в веб-версии, iOS и Android
Чат без состояния дешёв в эксплуатации и дорог в использовании. Чтобы понять, почему векторная память теперь находится в центре полезного AI-чата, стоит разобраться, как эмбеддинги, извлечение и долгосрочный контекст на самом деле дают сбои в повседневной работе.
Краткий ответ: что такое AI-чат с векторной памятью?
AI-чат с векторной памятью — это система извлечения, которая хранит смысл диалогов в виде эмбеддингов, чтобы AI мог вспоминать релевантный контекст, документы и предпочтения между сеансами. В этом разница между чат-ботом, который начинает каждую ветку заново, и агентом, который продолжает работу.
Ключевые возможности:
- Преобразование сообщений, файлов и фактов в векторы для поиска по сходству
- Добавление в контекстное окно модели только наиболее релевантных воспоминаний
- Хранение неограниченной истории чата и предпочтений между сеансами на одной платформе
- Опора ответов на прикреплённые базы знаний, а не на параметрические догадки
- Перенос той же памяти с рабочего стола на телефон без повторного ввода контекста для агента
Почему большинство AI-чатов всё ещё забывает
Большие языковые модели хорошо рассуждают, но плохо ведут архив. Их веса содержат общие знания; в них нет вашего бэклога, вашей схемы или вашего последнего решения. Генерация с дополненным поиском существует именно потому, что параметрическая память непоследовательна и её трудно обновлять для частной предметной области — этот вывод обобщён в обзоре архитектур RAG 2025 года.
Спрос индустрии на этот слой извлечения больше не является экспериментальным:
USD 2,652.1 million → USD 8,945.7 million — Прогнозируемый мировой рынок векторных баз данных с 2025 по 2030 год при CAGR 27.5%
Эти расходы — симптом. Команды покупают векторную инфраструктуру, потому что чаты без памяти снова и снова дают одни и те же сбои:
- Контекстные окна переполняются, и старые решения исчезают посреди проекта
- Поиск по ключевым словам пропускает перефразирования, синонимы и подразумеваемые намерения
- Самодельные стеки RAG — чанкинг, индексы, оценка, авторизация — останавливаются до выхода в продакшен
- Персонализация оказывается запертой в истории чата одного поставщика
- Ответы начинают отклоняться от фактов, когда модель не может опереться на ваши файлы
Однако встроить в повседневный чат устойчивую, приватную и семантически доступную для поиска память всё ещё удручающе сложно:
Контекстные окна — это не память
Контекстное окно — это буфер, а не архив. История разговора, вопрос пользователя и несколько «сохранённых фактов» объединяются в промпт; всё, что не помещается, отбрасывается. Поэтому агент для программирования забывает ошибку, которую вы вставили вчера, а репетитор снова спрашивает ваш целевой балл. Векторная память находится за пределами окна: она извлекает небольшой релевантный фрагмент во время инференса, вместо того чтобы надеяться, что в окно всё ещё помещается полная расшифровка диалога.
Поиск по ключевым словам не способен представить смысл
Классический поиск вознаграждает точные токены. Векторный поиск сравнивает эмбеддинги — многомерные числовые представления смысла — с помощью таких метрик, как косинусное сходство или евклидово расстояние. Эмбеддинги вместе с векторным индексом образуют слой извлечения, который делает возможными современные приложения на LLM. Без этого слоя запрос «план найма на третий квартал» не извлечёт заметку с названием «штат на осень».
Самодельный RAG — это инфраструктурный проект
Продакшен-конвейеру извлечения нужны стратегия чанкинга, выбор эмбеддингов, индекс ANN, фильтры метаданных, оценка и задачи обновления. Опубликованные бенчмарки ANN показывают, почему это важно командам: движки сравнивают одновременно по задержке, пропускной способности и точности, потому что скорость без полноты — это уже другой продукт. Большинству людей, которым просто нужен чат с памятью, не следует управлять этим стеком.
Персонализация без переносимой памяти ненадёжна
Stanford’s Digital Economy Lab утверждает, что устойчивое преимущество в AI будет строиться на постоянном личном контексте, управляемом пользователем, а не на очередном изолированном чат-боте. Сегодня память обычно является функцией поставщика: она не перемещается вместе с вами и может незаметно влиять на то, что вам показывают. В материале Columbia Journalism Review о памяти чат-ботов отмечается, что их знание о пользователе может менять получаемую людьми информацию.
Именно для этого была создана Jenova.
Решение Jenova
Jenova рассматривает AI-чат с векторной памятью как функцию по умолчанию, а не как дополнение, которое нужно подключать позже. Неограниченная история чата, постоянная память между сеансами и прикрепляемые базы знаний доступны каждому специализированному агенту. Вы общаетесь на естественном языке; платформа извлекает нужные эмбеддинги, инструменты и файлы до того, как модель сформирует ответ.
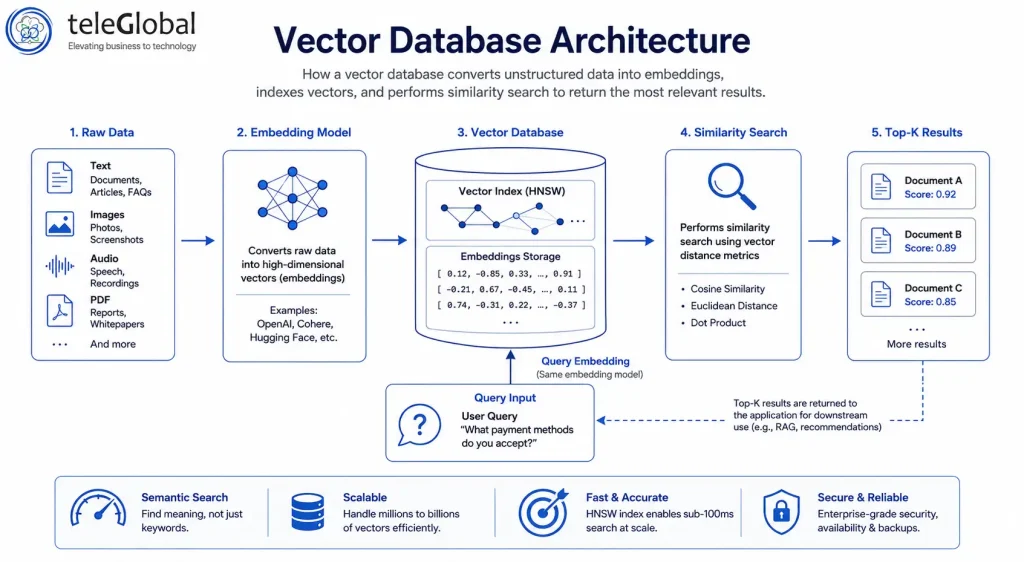
Диаграмма выше показывает механику этого опыта: неструктурированный текст, изображения и документы превращаются в эмбеддинги, попадают в векторный индекс и возвращаются как top-k совпадения для запроса. Вам не нужно настраивать параметры HNSW или выбирать метрику расстояния. Просто начните ветку чата.
| Традиционный подход | Jenova |
|---|---|
| Вставлять один и тот же бриф в каждый новый чат | Постоянная память между сеансами и агентами |
| Поиск по ключевым словам в заметках и PDF | Семантическое извлечение по эмбеддингам |
| Самостоятельно размещать векторную БД, модель эмбеддингов и оценку RAG | Полностью управляемые хранение и извлечение |
| Один поставщик моделей — одно изолированное хранилище памяти | Доступ к нескольким моделям с общим контекстом |
| История только на компьютере, которая исчезает на мобильном устройстве | Полная согласованность в веб-версии, iOS и Android |
Исследования, которые накапливаются, а не начинаются заново
Обзоры литературы и анализ рынков терпят неудачу, когда ассистент не помнит статьи, которые вы уже отклонили. Real-Time Search получает актуальные результаты из Google, Reddit, YouTube, GitHub и других источников, а векторная память сохраняет ваши критерии включения, предыдущие цитаты и правила «не использовать этот источник». Вы не начинаете каждое утро новый булев запрос — вы продолжаете исследование с поддержкой извлечения.
Кодовые базы, которые агент действительно знает
Python Coding Assistant полезен для скрипта уже в первый день. Он становится по-настоящему ценным на двенадцатый день, когда всё ещё знает структуру ваших пакетов, нестабильный тест, который вы решили пропустить, и контракт API, зафиксированный на прошлой неделе. Один раз прикрепите заметки по репозиторию или проектный документ. Последующие запросы извлекут этот контекст, а не изобретут параллельную архитектуру.
Тексты, сохраняющие ваш голос и факты
Черновики умирают в чатах без состояния, потому что тон, запрещённые фразы и URL-адреса первоисточников выпадают из окна. Агент платформы, ориентированный на написание текстов, может хранить примеры вашего стиля и решения по структуре как память, а затем извлекать их, когда вы говорите: «тот же голос, что и в публикации о запуске». В сочетании с прикреплёнными документами это векторная память, обеспечивающая редакционную преемственность, а не просто более длинный промпт.
Жизнь и обучение, которые не должны сбрасываться
Коучинг и языковая практика работают только тогда, когда агент помнит ограничения: травмы, даты экзаменов, лексику, которой вы уже владеете. Постоянная память превращает универсального репетитора в того, кто перестаёт повторять упражнения первой недели. То же хранилище, которое извлекает traceback Python, может извлечь и факт, что вы лучше учитесь через ролевые игры, а не через грамматические таблицы.
Попробуйте платформу бесплатно — кредитная карта не требуется.
Специализированные AI-агенты для AI-чата с векторной памятью
Память полезна ровно настолько, насколько полезен рабочий процесс, которому она служит. Эти агенты созданы для задач, где забывчивость обходится дорого: длительных исследований, повторяющейся логистики, глубокого погружения в практику и игр с последовательными персонажами.
Deep Research
Многочасовое исследование — классический сценарий для AI-чата с векторной памятью. Этот агент просматривает сотни источников, синтезирует выводы с внутритекстовыми цитатами и создаёт отчёты, которые можно продолжить завтра без повторного определения вопроса.
- Хранит исследовательский вопрос, исключённые источники и рабочий тезис
- Извлекает предыдущие выводы, чтобы поздние разделы не противоречили ранним
- Обосновывает утверждения процитированными материалами, а не только памятью модели
Academic Research Assistant
Рабочие процессы аспирантов и преподавателей охватывают месяцы литературы, стили цитирования и версии рукописей. Ассистент находит статьи в основных базах данных и помогает с подготовкой рукописи, а память сохраняет выбранное вами издание, методологию и набор уже прочитанных работ.
- Поиск литературы в реальном времени по академическим репозиториям
- Поддержка цитирования и работы с рукописью, связанная с вашим текущим черновиком
- Преемственность между связанными статьями, а не разовые ответы чата
Personal Secretary
Логистика — это проблема памяти: постоянные поставщики, предпочтения в поездках, получатели пятничного обновления. Этот агент координирует календарь, электронную почту и ежедневные операции с глубоким личным контекстом, чтобы вам не приходилось обучать его своему распорядку каждый понедельник.
- Помнит постоянные предпочтения и людей, с которыми вы работаете
- Связывает планирование с уже используемыми вами инструментами
- Переносит контекст из утреннего брифинга в дневное продолжение работы
Roleplay Game Master
Последовательность повествования невозможна без долгосрочной памяти. Этот агент создан для захватывающих ролевых игр с неограниченной памятью и стабильными персонажами: сюжетные обещания, названия фракций и тон не сбрасываются при переполнении контекстного окна.
- Неограниченная память для состояния истории и голоса персонажей
- Извлечение ранних сцен, когда они нужны для поздней главы
- Творческая свобода без потери последовательности
Learn Russian Through Roleplay
Изучение языка зависит от интервального и личного контекста: слов, в которых вы ошибались, уровня формальности, историй, которые вы уже прожили. Этот наставник использует неограниченное число сценариев и неограниченную память, поэтому практика накапливается, а не зацикливается на сценариях для начинающих.
- Помнит ваши пробелы в словарном запасе и предпочитаемые типы сценариев
- Сохраняет последовательность персонажей и обстановки между сеансами
- Превращает каждый разговор в практику с поддержкой извлечения
Как работает AI-чат с векторной памятью
Вам не нужно развёртывать векторную базу данных. Начните разговор — платформа сама обрабатывает эмбеддинги, извлечение и контекстное окно.
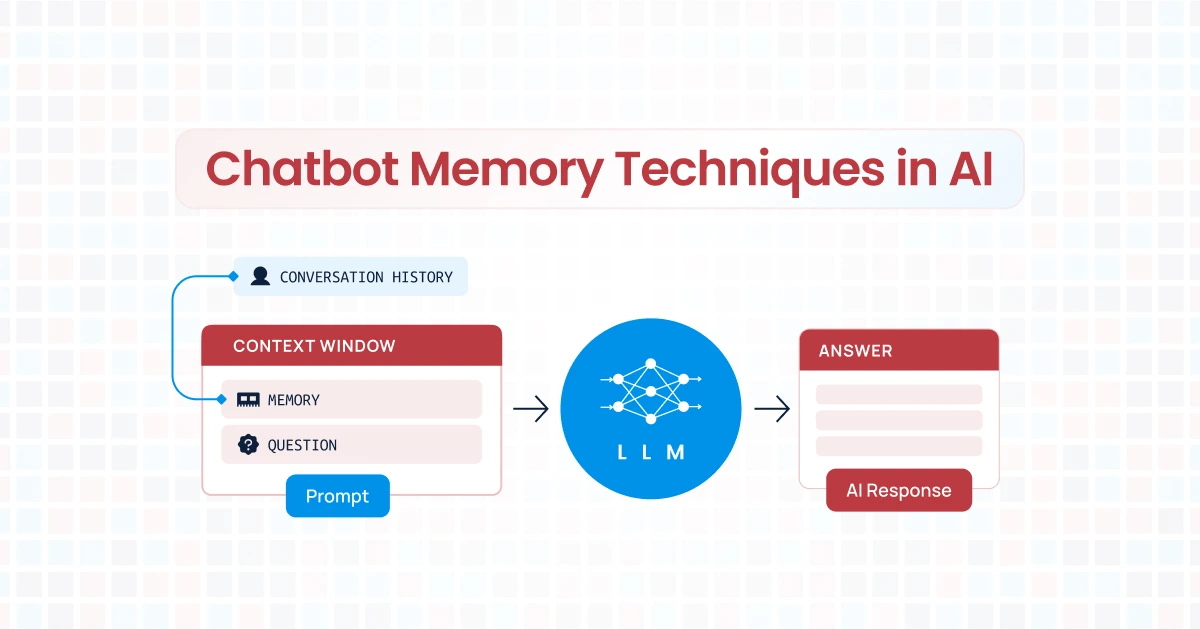
Вторая диаграмма показывает видимый пользователю цикл. История, сохранённая память и новый вопрос собираются в промпт; модель отвечает. Векторное извлечение определяет, какие воспоминания должны попасть в этот промпт, чтобы окно оставалось сфокусированным.
Шаг 1: Откройте агента и сформулируйте результат
Выберите специалиста для задачи — исследования, кода, путешествий, обучения — и скажите, как выглядит «готово». Первое сообщение становится эмбеддингом, как и всё, что последует за ним.
«Я пишу систематический обзор по генерации с дополненным поиском. Предпочитаю обзоры с 2024 года, исключаю блоги поставщиков и использую стиль цитирования IEEE.»
Шаг 2: Прикрепите знания, которым модель должна доверять
Загрузите брифы, файлы PDF, заметки или спецификации. Эти документы индексируются для семантического поиска, поэтому последующие вопросы извлекают фрагменты по смыслу. Это тот же подход, который компании финансируют как инфраструктуру RAG, но вам не нужно управлять индексом.
«Используй прикреплённую матрицу литературы. Если статья помечена как отклонённая, больше не цитируй её.»
Шаг 3: Продолжайте работу между сеансами
Закройте ноутбук. На следующий день задайте уточняющий вопрос. Постоянная память и неограниченная история означают, что агент извлечёт границы обзора, список отклонений и заголовок последнего раздела плана, а не встретит вас как незнакомца.
«Продолжи с раздела об ограничениях и добавь три статьи, которые мы отметили для обсуждения.»
Шаг 4: Переключайтесь между устройствами без повторного ввода контекста
Откройте ту же ветку на iOS или Android. Настройки и история синхронизируются. Запрос по дороге может извлечь те же векторы, что и сеанс за рабочим столом, — именно для этого нужен AI-чат с векторной памятью: для непрерывности, а не для нового изолированного чата на каждом устройстве.
«Я еду в университет — проверь меня по трём режимам отказа RAG, которые мы перечислили вчера.»
Результаты и сценарии использования
Векторная память проявляется в сэкономленных часах, которые не приходится тратить на повторение, а не в диаграмме бенчмарков. Эти сценарии типичны для изменений, которые происходят, когда чат извлекает смысл.
📊 Многонедельный синтез литературы
Сценарий: Аспиранту нужен обзор статей о надёжности RAG с цитатами, обновляемый каждые несколько дней по мере появления новых препринтов.
Традиционный подход: Папка с PDF, таблица с заметками и чат-бот, который забывает список исключений. Повторная вставка брифа в каждом сеансе. Легко дважды процитировать один источник или пропустить противоречие.
Deep Research: Вопрос, исключения и рабочая структура сохраняются. Новые запуски извлекают предыдущий синтез, поэтому отчёт развивается, а не разветвляется.
- Цитаты остаются согласованными с ранними разделами
- Отклонённые источники остаются отклонёнными
- Уточняющие запросы обходятся дешевле, чем первый поиск
💼 Сервис Python, который развивается несколько спринтов
Сценарий: Вы создаёте сервис FastAPI с зафиксированной спецификацией OpenAPI, известным нестабильным тестом и ограничением развёртывания на Python 3.11.
Традиционный подход: Каждый новый чат придумывает другую структуру папок. Первые десять минут уходят на повторное объяснение решений, которых модель не видит.
Python Coding Assistant: Заметки по архитектуре и спецификация хранятся в памяти и прикреплённых материалах. Отчёт об ошибке в четверг извлекает список ограничений среды.
- Меньше противоречивых рефакторингов
- Отладка начинается с реального стека
- Быстрее вводится в курс будущая версия вас самих или коллега, читающий ветку
🎭 Кампания, которая не должна противоречить самой себе
Сценарий: Еженедельная игра с именованными NPC, секретом, о котором группа ещё не знает, и тоном, заданным в первой сессии.
Традиционный подход: Заметки по сессиям лежат в другом приложении; чат-бот вводит нового злодея, потому что не может извлечь старое сюжетное обещание.
Roleplay Game Master: Состояние истории — это память. Когда игрок упоминает мимоходом сказанную деталь из трёх сессий назад, извлечение может вернуть её в сцену.
- Голоса персонажей остаются стабильными
- Сюжетные обещания доступны для запросов
- Длинные арки сохраняют связность
📱 Планирование поездки из очереди в аэропорту
Сценарий: Вы спланировали поездку по трём городам за рабочим столом: лимит бюджета, дни с упором на пешие прогулки, никаких ночных рейсов. У выхода на посадку вам нужно изменить только завтрашний день с учётом погоды.
Традиционный подход: Сделать скриншот собственных заметок. Надеяться, что мобильный чат-бот выведет ограничения, которых никогда не видел.
Travel Planning Advisor: Предпочтения и маршрут уже находятся в памяти. Запрос с телефона извлекает их и изменяет один день без перестройки всей поездки.
- Ограничения переживают смену устройства
- Локальные уточнения не выходят за бюджет
- Не нужно снова печатать бриф в телетрапе
Реальное использование демонстрирует ту же закономерность, за которую корпоративные покупатели векторных баз данных готовы платить: низколатентное семантическое извлечение в ответ на живые вопросы, а не просто более большое окно чата.
Часто задаваемые вопросы
Что такое AI-чат с векторной памятью?
AI-чат с векторной памятью хранит сообщения, файлы и факты в виде эмбеддингов, а затем извлекает ближайшие совпадения, когда вы задаёте вопрос. Эти совпадения вставляются в контекстное окно модели, чтобы ответ мог учитывать вашу историю и документы. В Jenova это извлечение встроено в специализированных агентов, а не предлагается как отдельная база данных, которую нужно поддерживать.
Можно ли бесплатно использовать Jenova для AI-чата с векторной памятью?
Да. Бесплатный тариф включает основные функции с ограниченным ежемесячным использованием. Платные тарифы увеличивают доступный объём использования и добавляют такие возможности, как выбор пользовательской модели. Использование сбрасывается в дату биллинга: весь лимит доступен с первого дня, а не выдаётся небольшими ежедневными порциями.
Чем это отличается от чат-бота, который «сохраняет воспоминания»?
Многие продукты хранят короткий список фактов или скользящую расшифровку диалога. Векторная память извлекает данные по семантическому сходству из неограниченной истории и прикреплённых знаний, что ближе к RAG, чем к стикеру с заметкой. Независимая работа по продакшен-памяти долгосрочного хранения для агентов рассматривает масштабируемую память как отдельную системную задачу, а не как переключатель в настройках. OpenAI также расширила способность ChatGPT ссылаться на предыдущий контекст чата; архитектурный вопрос заключается в том, остаётся ли память изолированным хранилищем поставщика или становится инфраструктурой для каждого вашего рабочего процесса.
Могу ли я опереть чат на собственные документы?
Да. Прикрепите файлы, которые должны иметь приоритет над исходными предположениями модели: спецификации, программы курсов, расшифровки, руководства по бренду. Когда вы задаёте связанные вопросы, извлечение отдаёт предпочтение этому корпусу, что помогает сократить галлюцинации на частных материалах. Writing Assistant может продолжать использовать эти примеры для тона, а исследовательский агент — для утверждений.
Работает ли AI-чат с векторной памятью на мобильных устройствах?
Да. Веб-версия, iOS и Android используют общие историю, настройки и память. Когда вы не можете печатать, доступно преобразование речи в текст. Сценарий путешествия выше — это и есть целевой дизайн: извлекать с телефона те же векторы, которые были созданы за рабочим столом.
Достаточно ли точен агент с памятью для чувствительных тем?
Память повышает последовательность, но не делает модель безошибочной. Обзоры RAG по-прежнему отмечают качество извлечения, шумный контекст и достоверность как нерешённые проблемы (Sharma, 2025). При принятии медицинских, юридических или финансовых решений используйте агента как поддержку и проверяйте информацию по первичным источникам. Personal Therapist может помнить темы, которые вы попросили его удерживать, что полезно для непрерывности, но не заменяет лицензированную помощь.
Векторная память — интерфейс чата, который наконец накапливает ценность
AI-чат без состояния тратит впустую единственный дефицитный ресурс: время, потраченное на объяснение себя. AI-чат с векторной памятью сохраняет смысл как эмбеддинги, извлекает его по требованию и позволяет специализированным агентам продолжать работу. Рынок этого слоя извлечения растёт, потому что проблема универсальна: от семантического поиска в продакшен-системах до личного контекста, который должен принадлежать пользователю.
Jenova предоставляет эту память для исследований, кода, повествования и планирования, не требуя от вас управлять векторной базой данных. Продолжайте отчёт Deep Research, сервис на Python или ролевую кампанию так, словно агент всё это время находился рядом.
Изучите полную библиотеку агентов на Jenova.
Для разработчиков: Каждый агент из этой статьи доступен программно через Jenova API — интегрируйте векторную память, извлечение и мульти-модельных агентов в своё приложение с помощью одной интеграции. Полная документация →