Загруженные заметки о сюжете или постоянная память проекта: что лучше для серийной художественной прозы?
2026-08-10
Какая модель контекста действительно выдерживает нагрузку согласованности на протяжении 100+ глав?
Постоянная память проекта начинает превосходить загруженные заметки о сюжете, когда ваша серия пересекает рубеж примерно в 50 000 слов или 20 эпизодов: загруженные заметки приходится заново читать в каждой сессии, тогда как постоянная память накапливает принятые вами решения. Для более коротких сериалов или проектов с одной сюжетной аркой загруженные заметки часто проще, дешевле и предсказуемее. Сегодня это пространство выбора определяют три инструмента: Novelcrafter (структурированный поиск по библии мира), Sudowrite (генерация прозы в рамках сессии) и Jenova (постоянная память агента между сессиями).
Ключевые факторы, отличающие устойчивый процесс работы над сериалом от процесса, который рушится под грузом нарушений согласованности:
✅ Извлечение против памяти — загруженные заметки нужно искать и заново подставлять в каждую сессию; постоянная память переносит состояние вперёд без повторной загрузки ✅ Структурированный и неструктурированный контекст — база данных в стиле Codex лучше стопки PDF, но ни одна из них не помнит, что вы решили в главе 40 ✅ Пределы контекстного окна — стоимость self-attention растёт квадратично с длиной входного текста, поэтому стратегия «просто загрузить всё» быстро упирается в жёсткий предел ✅ Скорость обратной связи — авторы сериалов пересматривают сюжет в середине серии, ориентируясь на реакцию читателей, а значит, источник согласованности постоянно меняется ✅ Повторное использование в масштабах серии — четвёртой книге нужен лор из первой без необходимости снова загружать лор первой книги
Честный ответ: большинство активно работающих авторов сериалов в итоге используют оба подхода. Чтобы сделать осознанный выбор, сначала нужно разделить, что на самом деле означает «память» в AI-инструменте для письма: это слово несёт гораздо больше смысловой нагрузки, чем обычно объясняют поставщики.
В чём разница между загруженными заметками о сюжете и постоянной памятью проекта?
Загруженные заметки о сюжете — это статичные справочные документы, из которых модель извлекает данные и которые заново читает в рамках сессии; постоянная память проекта — это накапливаемое состояние, которое сохраняется между сессиями без повторной передачи с вашей стороны. Разница заключается в архитектуре, а не в оформлении.
Когда вы загружаете библию персонажей в рабочее пространство проекта, вы наполняете базу знаний. Модель ищет в ней данные, извлекает релевантные фрагменты и помещает их в активное контекстное окно. Так работает функция Projects в Claude: вы загружаете документы в изолированное рабочее пространство, а на платных тарифах «ваши проекты автоматически масштабируются для работы с большими объёмами контента посредством Retrieval Augmented Generation (RAG)», когда объём знаний приближается к ограничениям контекста.
Постоянная память проекта работает иначе. Она хранит историю бесед и решений: на чём вы остановились, от чего отказались, как изменился голос персонажа — и показывает эти сведения в будущих сессиях без этапа загрузки.
Практическая проверка: если в сессии 12 вы сказали своему AI, что мотивация антагониста изменилась, будет ли об этом знать сессия 47? При работе с загруженными заметками — только если вы отредактировали и повторно загрузили файл. При постоянной памяти — да.
🧠 Почему это различие важнее для сериалов, чем для романов
У отдельного романа конечный объём элементов, требующих согласованности: одна арка, один состав персонажей, одна кульминация. У сериала этот объём непрерывно расширяется. Сет Ринг, автор фэнтезийных сериалов с 25+ книгами, в интервью Author Media описал давление темпа: «напряжённое требование выпускать контент по столь агрессивному графику» именно и «продвинуло моё мастерство вперёд так, как ничто другое». Этот график и превращает ручное ведение заметок в провальную стратегию: каждый час, потраченный на повторную загрузку Codex, — это час, не потраченный на выпуск главы.
Почему AI-инструменты для письма вообще испытывают трудности с долгими сериями?
AI-инструменты теряют согласованность в сериалах, потому что архитектуры трансформеров располагают рабочей памятью, но не обладают встроенной долговременной памятью: у них есть контекстное окно, а не история. IBM Research формулирует это прямо: «Контекстные окна могут работать как своего рода рабочая память, но LLM не имеют долговременной памяти, а лежащие в их основе архитектуры трансформеров с трудом сохраняют согласованность при обработке длинных входных последовательностей».
Структура затрат усугубляет проблему. По словам научного сотрудника IBM Research Рожериу Фериса, «по мере роста длины входного текста вычислительная стоимость self-attention увеличивается квадратично». Загрузка библии серии объёмом 200 000 слов в каждую сессию не просто дорого обходится — она ухудшает соотношение сигнала и шума.
Именно поэтому наивное решение — загружать больше — перестаёт работать. В собственных сравнительных материалах Sudowrite признаёт потолок сессионных инструментов: «его память хороша, но не идеальна. В рамках долгого проекта он может забыть ключевые детали, если они не находились в непосредственном контекстном окне, что является распространённым ограничением даже самых продвинутых LLM».
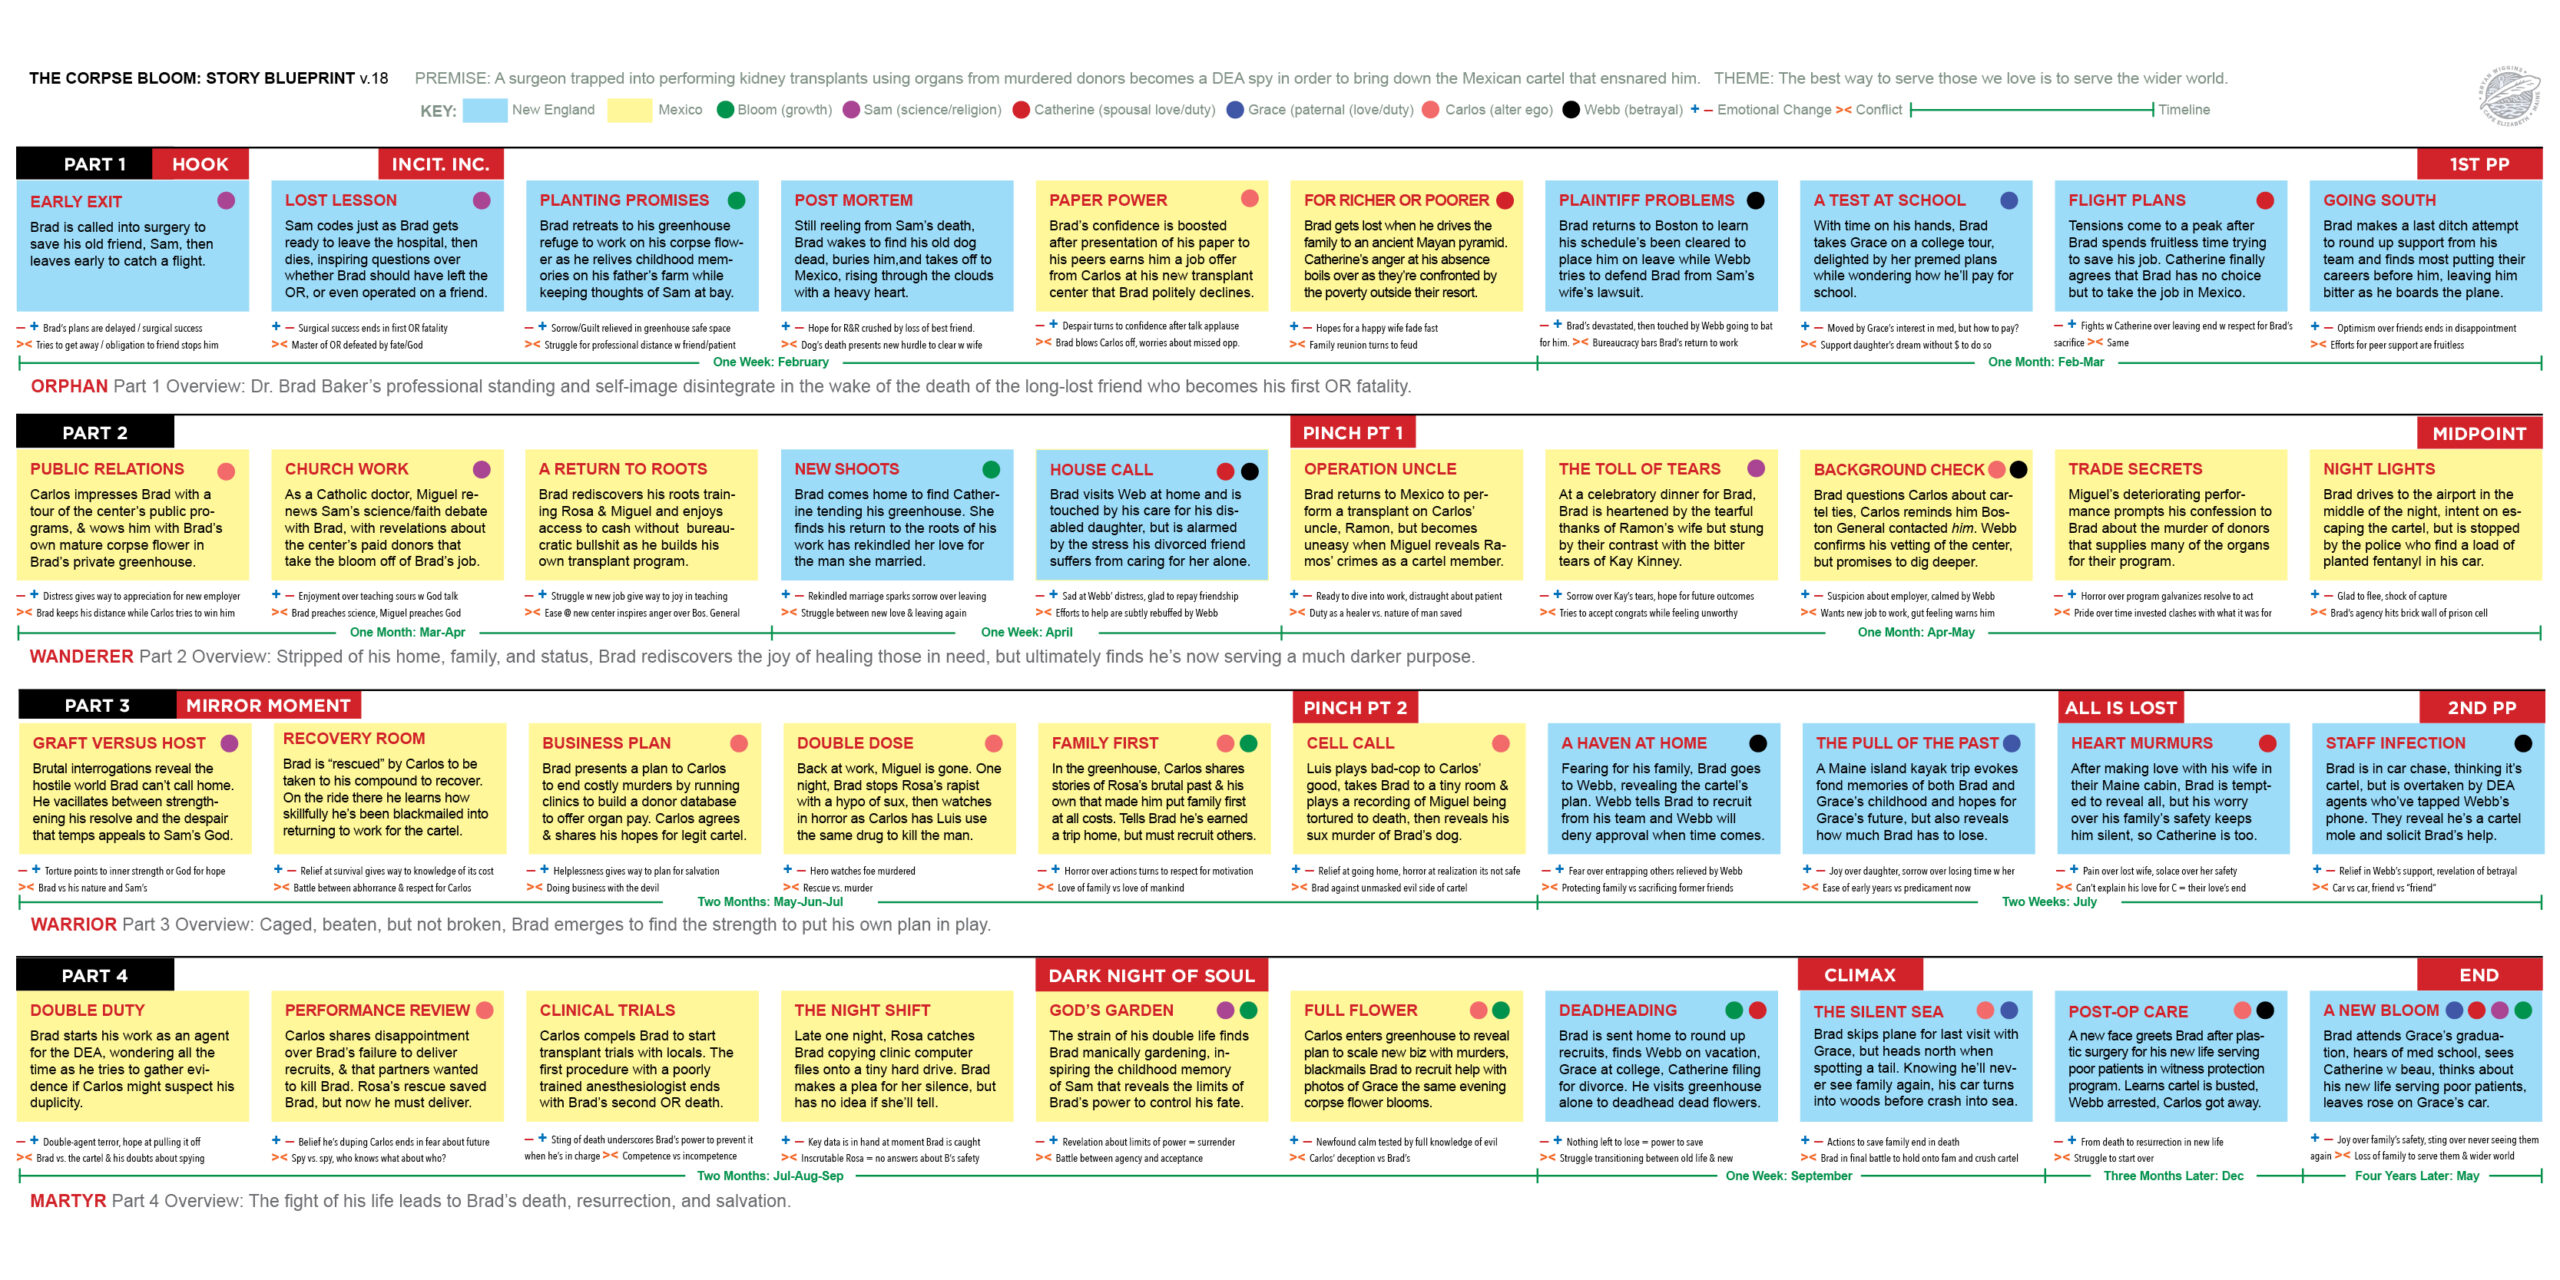
Кривая долга согласованности: каждая глава добавляет обязательства по согласованности, не убирая ни одного из прежних. В главе 10 вы отслеживаете около 15 фактов. В главе 80 — уже сотни: имена, травмы, долги, обещания, позиции на временной шкале, кто что знает. Затраты на поддержание загруженных заметок растут линейно. Затраты на постоянную память остаются значительно ближе к постоянному уровню.
Что авторам сериалов действительно следует оценивать при выборе системы контекста?
Правильная система оценки для серийной прозы учитывает шесть измерений, и качество прозы — не самое важное из них. Вот схема, используемая в этом сравнении: назовём её моделью нагрузки на согласованность.
| № | Измерение | Что измеряет | Почему это важно для сериалов |
|---|---|---|---|
| 1 | Память между сессиями | Помнит ли инструмент решения из прошлых сессий без повторной загрузки? | Определяет объём обслуживания на одну главу |
| 2 | Структурированное извлечение | Можно ли точно запрашивать лор, а не загружать его целиком? | Предотвращает размывание контекста и взрыв затрат |
| 3 | Повторное использование в серии | Переносится ли Codex первой книги в четвёртую? | Без этого многокнижные серии распадаются |
| 4 | Распространение правок | Обновляется ли система, когда канон меняется в середине серии? | Авторы сериалов пересматривают сюжет по живой реакции читателей |
| 5 | Гибкость моделей | Можно ли менять модели, не теряя накопленный контекст? | Качество моделей меняется; привязка к поставщику имеет реальную цену |
| 6 | Предсказуемость затрат | Фиксированная подписка или кредиты по счётчику? | Сериалы требуют огромного объёма генерации |
Измерение 4 — то, которому большинство авторов уделяют недостаточно внимания. Серийная проза особенно часто требует правок во время производства. Ринг рассказывает, что вносит «очень мало изменений в поздние главы и больше изменений в ранние», поскольку читательские теории показывают, куда движутся ожидания. Система контекста, не способная усвоить изменение канона в середине серии, будет незаметно продолжать писать по старому канону.
Измерение 1 — то, что поставщики чаще всего преувеличивают. «Память проекта» в маркетинговых текстах часто означает «базу знаний в рамках проекта», а не «накопленное состояние между сессиями». Читайте документацию, а не лендинг.
Как ведущие инструменты сравниваются по нагрузке на согласованность?
Ни один инструмент не побеждает по всем шести измерениям: Novelcrafter лидирует в структурированном извлечении, Jenova — в памяти между сессиями, а Sudowrite — в генеративном темпе, при этом заметно уступая в согласованности.
| Возможность / измерение | Sudowrite | Novelcrafter | Jenova | Claude Projects | ChatGPT Projects |
|---|---|---|---|---|---|
| Память между сессиями | Ограниченная — зависит от контекста сессии | Codex сохраняется как структурированные данные и извлекается заново для каждой сцены | Постоянная память между сессиями; агенты сохраняют прошлые решения | База знаний в рамках проекта; накопленного состояния решений нет | Память только в пределах проекта ограничивает предыдущие чаты одним проектом |
| Структурированное извлечение | Story Engine + Canvas; ориентировано на мозговой штурм, а не на базы данных | Самое сильное — Codex автоматически связывает персонажей, места и лор | Подключаемые документы + базы знаний для ответов, опирающихся на источник | RAG активируется вблизи ограничений контекста, увеличивая ёмкость до 10 раз | Данные о структурированном связывании сущностей не подтверждены |
| Повторное использование в серии | Не является основной возможностью | Явно предусмотрено — «Codex можно использовать совместно между книгами серии» | Постоянная память охватывает сессии и долгие проекты | Вручную — повторная загрузка или дублирование проекта | Ограничено отдельным проектом |
| Гибкость моделей | Доступ к премиальным моделям за кредиты | BYO-API: OpenAI, Anthropic, Google, Mistral, OpenRouter, локальные модели | OpenAI, Anthropic, Google, DeepSeek, xAI — переключение без привязки к поставщику | Только модели Anthropic | Только модели OpenAI |
| Порог освоения | Низкий — для основ «почти отсутствует» | Высокий — требует вложений в настройку Codex | Средний — выбор агента, затем диалог | Низкий | Низкий |
| Цены | Тарифы на кредитах (Hobby/Professional/Max) | Подписка; предсказуемая генерация без счётчика | Бесплатный тариф; Plus $20/мес. (30× использования); Premium $50/мес. (75× использования) | Бесплатный тариф (максимум 5 проектов); RAG требует платного тарифа | На основе подписки |
| Лучше всего подходит для | Авторов, пишущих от открытия к открытию и нуждающихся в темпе прозы и спасении от чистого листа | Планировщиков, ведущих структурированные многокнижные серии с глубоким построением мира | Авторов, которым нужна диалоговая согласованность в долгих проектах без ручного ведения библии | Команд, которым нужны общие рабочие пространства с большим количеством документов | Пользователей, уже работающих в экосистеме OpenAI |
Если читать эту таблицу честно: Codex от Novelcrafter — самое строгое из доступных сейчас решений для согласованности сериалов. Это специально созданная база данных, и Kindlepreneur отмечает, что она «настолько сложна, что ей не хватает некоторых простых функций, которые есть у конкурентов вроде Sudowrite». Эта сложность — цена точности. Постоянная память Jenova уменьшает объём ручного обслуживания, но не даёт графа связей между сущностями, как в Novelcrafter. Sudowrite действительно превосходен в генерации прозы и действительно слаб в обеспечении согласованности на протяжении 100 глав — это разные следствия одной философии дизайна.
Когда загруженные заметки о сюжете действительно лучше?
Загруженные заметки о сюжете — лучший выбор, когда ваш канон стабилен, проект ограничен по масштабу и вам нужен точный контроль над тем, что именно видит модель. Это не запасной вариант — для нескольких реальных сценариев это правильная архитектура.
Загруженные заметки побеждают, когда:
- Ваш сериал короче примерно 30 эпизодов, а полная библия свободно помещается в контекст без разбиения RAG на фрагменты
- Вы пишете по зафиксированному плану — заранее спланированный сериал, в котором канон не дрейфует в ходе работы
- Нескольким соавторам нужно видеть и редактировать один и тот же канонический источник, а общий документ подходит для этого лучше, чем память одного пользователя
- Вам нужна проверяемость — можно открыть файл и удостовериться, что именно было сообщено AI
- Вы часто меняете инструменты — переносимые заметки в Markdown переживают смену платформы, а проприетарная память — нет
Аргумент в пользу контроля недооценён. Постоянная память по природе является чёрным ящиком: вы не можете легко проверить, что именно система решила сохранить. Хорошо поддерживаемый Codex или папка с файлами Markdown доступны для проверки, сравнения версий и контроля изменений. Некоторые авторы на
отмечают, что Novelcrafter «в конечном счёте мощнее, но имеет заметно более крутую кривую обучения». Эта сила и заключается в явности модели на основе заметок.📋 Как создавать заметки для загрузки без раздувания объёма
Если вы выбираете путь загруженных заметок, структура важнее объёма:
- Разделяйте по типу сущности, а не по главам. Один файл для персонажей, один для локаций, один для временной шкалы, один для правил/магии/технологий. Заметки по главам вынуждают извлекать целые документы.
- Начинайте каждую запись с однострочного резюме. Разбиение RAG извлекает фрагменты; фрагмент должен быть понятен сам по себе.
- Ведите файл текущего состояния отдельно от истории. То, что верно сейчас в сериале, отличается от того, что было верно в эпизоде 12.
- Явно версионируйте изменения канона. Добавляйте строку
CHANGED (ep. 47): antagonist motive is now X, previously Y, а не перезаписывайте всё молча. - Осознанно ограничивайте общий объём загрузок. Качество извлечения ухудшается из-за шума в корпусе; компактная библия на 8 000 слов превосходит разросшуюся на 60 000 слов.
Когда постоянная память проекта явно побеждает?
Постоянная память решительно побеждает, когда количество решений в вашем проекте превышает количество фактов. Это происходит примерно тогда, когда вы перестаёте помнить, почему сделали тот или иной выбор.
Факты хорошо живут в документах. Решения — нет. «У Киры шрам на левом предплечье» — факт, ему место в Codex. «Мы решили, что арка Киры должна сопротивляться искуплению, потому что читатели в эпизоде 31 слишком рано предсказали этот ход» — решение, и оно исчезнет, если ничто его не сохранит.
Постоянная память побеждает, когда:
- Вы написали 50+ эпизодов, и восстановление контекста в каждой сессии начинает отнимать ощутимое время
- Ваш голос — это и есть продукт: вы хотите, чтобы AI усвоил закономерности вашей прозы, а не получал инструкции заново
- Вы ведёте несколько сериалов одновременно и каждому нужно сохранять собственное состояние
- Отзывы читателей определяют правки — типичная для сериалов динамика, которую описывает Ринг: «каждая глава — это итерация на основе немедленной обратной связи из комментариев»
- Вы хотите уменьшить рутинные действия — стоимость подготовки к каждой сессии письма является главным фактором того, будет ли сериал закончен по графику
Подход Jenova нацелен именно на это: неограниченная история чатов с постоянной памятью между сессиями, благодаря которой агенты сохраняют предпочтения, прошлую работу и долгие проекты. Для серийной прозы универсальным вариантом служит агент Creative Fiction Writer, а для сериалов определённого формата есть специализированные агенты: Webtoon Creator для вертикальных эпизодических работ с 100+ эпизодами, Manga Creator для серийной манги и Microdrama Screenwriter для вертикальных драматических сезонов по 60–100 эпизодов.
Честные ограничения: Jenova не предлагает Codex с отношениями между сущностями, как Novelcrafter: здесь нет автоматически связываемой вики, которая визуально отображает отношения персонажей и локаций. Если ваше построение мира требует структурированной базы данных, которую можно просматривать и проверять запись за записью, Codex от Novelcrafter остаётся более сильным инструментом. Память Jenova диалоговая и накопительная, а не схематизированная. Постоянную память также можно включать и отключать для каждого пользователя, а значит, она не является гарантированным состоянием по умолчанию.
Как на практике настроить каждый подход для сериала?
Затраты на настройку различаются примерно на порядок, и именно эта разница определяет, какой подход выдержит еженедельный график публикаций.
Настройка структурированных загруженных заметок в Novelcrafter:
- Создайте контейнер серии и добавьте книгу 1
- Создайте записи Codex для каждого персонажа, локации, фракции и объекта — с настраиваемыми полями
- Свяжите записи Codex с Story Beats, чтобы AI получал «точное, отобранное контекстное окно» для каждой сцены
- Включите совместное использование Codex между книгами серии, чтобы книга 4 наследовала лор книги 1 без повторного ввода
- Подключите предпочитаемую модель через BYO-API
Рассчитывайте на несколько часов предварительной настройки. Взамен контекст для каждой сцены впоследствии становится почти автоматическим.
Настройка постоянной памяти в Jenova:
- Откройте нужного агента: для прозаических сериалов — Creative Fiction Writer по адресу
jenova.ai/a/creative-fiction-writer - Включите Global Memory в Settings, чтобы контекст сохранялся между сессиями
- Прикрепите существующую библию серии как документ, если она у вас есть: постоянная память и загруженные документы дополняют, а не исключают друг друга
- В первой сессии задайте канон в диалоге:
«Это сериал в жанре litRPG на Royal Road, сейчас идёт эпизод 34. Главный герой — Рен, опальный картограф. Основное правило: магия требует памяти — каждое заклинание навсегда стирает конкретное воспоминание. Отслеживай, какие воспоминания Рен уже сжёг, чтобы мы никогда не использовали одно и то же повторно».
- В следующих сессиях сообщайте изменения, а не повторно задавайте базовый контекст:
«Изменение в эпизоде 41: теперь выясняется, что наставник Рена был соучастником, а не действовал по принуждению. Читатели угадали вариант с принуждением ещё к эпизоду 29, поэтому он больше не работает. Скорректируй всё, что следует дальше».
Настройка занимает минуты, а не часы. Обратная сторона — менее явная проверяемость того, что именно сохранила система.
Настройка заметок в Claude Projects: создайте проект, загрузите библию в базу знаний и задайте инструкции проекта для тона и роли. На платных тарифах RAG автоматически масштабирует работу по мере приближения объёма знаний к пределам контекста. Учтите ограничение бесплатного тарифа в пять проектов — это существенно, если вы ведёте несколько сериалов.
Что говорят об этом компромиссе работающие авторы сериалов и инженеры?
Среди людей, которые регулярно выпускают серийную прозу в больших объёмах, преобладает мнение, что вопрос памяти на самом деле маскирует вопрос обслуживания.
«Самая частая ошибка, которую мы видим, — не забытый AI цвет глаз персонажа. Это забытое AI решение: причина, по которой вы отказались от определённого сюжетного направления одиннадцать недель назад. Загруженные заметки фиксируют мир, но почти никогда не фиксируют ход рассуждений. А в серийной прозе именно он сохраняет цельность серии, потому что мир постоянно переопределяется вместе с читателями в реальном времени».
«Наша позиция такова: это не выбор одного из двух вариантов. Структурированные документы — правильное вместилище для стабильного канона: имён, географии, жёстких правил магии. Постоянная память — правильное вместилище для меняющегося замысла: дрейфа голоса, корректировок арок, того, что читательская аудитория уже угадала. Авторы, которые успешно ведут сериалы по 100 эпизодов, почти всегда приходят к обоим подходам; вопрос в инструментах сводится лишь к тому, какой из них приходится поддерживать вручную».
«Экономический аргумент тоже важен. Каждый час, потраченный на повторную загрузку и синхронизацию библии сюжета, — это час, не потраченный на следующий эпизод. При еженедельном ритме публикаций эти накладные расходы накапливаются и превращаются в пропущенные главы, а пропущенные главы стоят читателей. Правильная система — та, у которой минимальные рутинные затраты на сессию при сохранении канона в порядке».
— Команда продукта Jenova, 7 лет создающая системы агентов с постоянной памятью для долгих творческих процессов
Можно ли объединить оба подхода, не создав два источника истины?
Да. Устойчивый шаблон — сделать загруженные заметки авторитетным источником для стабильного канона, а постоянную память — авторитетным источником для меняющегося замысла, с явным правилом о том, какой слой приоритетнее при конфликте.
Двухслойная архитектура канона:
| Слой | Содержимое | Где хранится | Частота обновления |
|---|---|---|---|
| Жёсткий канон | Имена, география, правила магии/технологий, опорные точки временной шкалы, физические описания | Загруженные структурированные заметки (Codex, Markdown, база знаний проекта) | Редко — только при сознательном ретконе |
| Мягкий канон | Настройка голоса, замысел арки, отвергнутые направления, корректировки по реакции читателей, решения о темпе | Постоянная память проекта | Непрерывно, в диалоге |
Правило конфликта: жёсткий канон всегда побеждает в фактах; мягкий канон всегда побеждает в замысле. Если в заметках город называется Vellum, а память утверждает Vellumhaven, заметки правы. Если в заметках говорится, что антагонист обретает искупление, а память сообщает, что вы отказались от этой арки в эпизоде 41, права память.
Это повторяет направление исследований архитектуры памяти. Проект Larimar от IBM проводит именно такую границу: традиционные знания LLM он описывает как аналог «неокортекса мозга, который обучается медленно и долго хранит воспоминания», тогда как модуль эпизодической памяти работает «как гиппокамп, удерживающий краткосрочные воспоминания, которые позднее могут быть консолидированы». Ваша библия сюжета — это неокортекс. Решения от сессии к сессии — гиппокамп. Оба слоя критически важны.
⚙️ Практический еженедельный ритм для двухслойного сериала
- Понедельник (синхронизация канона, около 15 минут): перенесите из памяти в загруженные заметки всё, что стало постоянным за прошлую неделю. Появился новый персонаж? Запись Codex. Установлено новое правило? Файл правил.
- Вторник–четверг (черновик): работайте в диалоге. Не объясняйте канон заново; сообщайте только то, что изменилось.
- Пятница (разбор читательской реакции): фиксируйте, что читатели верно предсказали. Предсказанные повороты перестают работать — записывайте изменение направления в память, а не в заметки, поскольку это замысел, а не факт.
- Ежемесячно (аудит): перечитывайте заметки свежим взглядом. Всё, что в них заявлено, но больше не соответствует действительности, — это долг согласованности. Исправьте его до публикации.
Какой подход выбрать с учётом профиля вашего сериала?
Соотносите систему с формой вашего проекта, а не с общими рейтингами инструментов: правильный ответ заметно различается для четырёх распространённых профилей сериалов.
📱 Короткий сериал (до 30 эпизодов, одна арка)
Загруженные заметки — и точка. Ваша библия помещается в контекст, канон почти не дрейфует, а преимущества постоянной памяти ещё не начали проявляться. Достаточно Claude Projects или процесса работы в Sudowrite с компактным справочным документом. Не платите цену настройки Codex за проект, который закончится через три месяца.
📚 Многокнижная серия (3+ книги, глубокое построение мира)
Novelcrafter. Совместное использование Codex между книгами — специализированное решение для специализированной проблемы, и ни одна система постоянной памяти пока не воспроизводит связанный по сущностям, доступный для просмотра лор в пределах серии. Примите необходимость обучения.
🔄 Продолжающийся веб-сериал (Royal Road, Substack, 80+ эпизодов, живая реакция читателей)
Постоянная память с компактной поддерживающей библией. Это профиль, где распространение правок становится важнее всего: канон еженедельно меняется в ответ на читательские теории, и система, требующая ручной повторной загрузки после каждого изменения, не выдержит ваш график публикаций. Creative Fiction Writer от Jenova хорошо подходит для этой формы; Codex от Novelcrafter — тоже, если у вас есть дисциплина ежедневно его поддерживать.
🎬 Визуальный/эпизодический сериал (вебтун, манга, микродрама)
Специализированные по формату агенты, поскольку нагрузка согласованности включает не только нарративный канон, но и визуальное единообразие с крючковой структурой эпизодов. Webtoon Creator, Manga Creator и Microdrama Screenwriter несут знания, характерные для формата: ритм вертикальной прокрутки, поток панелей, разрывы эпизодов с учётом платного доступа — чего нет у универсального инструмента для письма.
Рекомендация по умолчанию для большинства авторов сериалов, читающих это: начните с загруженных заметок, потому что они недороги и проверяемы, а к постоянной памяти переходите в первый раз, когда поймаете себя на том, что повторно объясняете AI нечто уже объяснённое. Это и есть сигнал; обычно он появляется между эпизодами 25 и 40.