Поисковый MCP-сервер для Reddit с ИИ: Преобразование социальных данных в ценную информацию
2025-08-08
Поисковый MCP-сервер для Reddit преобразует обширный архив бесед Reddit в структурированную, запрашиваемую базу данных для AI-агентов. Хотя Reddit насчитывает более 100 000 активных сообществ с подлинными обсуждениями практически на любую тему, доступ к этому кладезю информации был до сих пор удручающе сложен для автоматизированных систем.
Эта революционная интеграция с Model Context Protocol (MCP) обеспечивает:
✅ Поиск на естественном языке по более чем 100 000 сабреддитов ✅ Интеллектуальное определение намерений, понимающее контекст ✅ Многомерная фильтрация по релевантности, времени, вовлеченности ✅ Структурированный доступ к данным для AI-агентов и разработчиков
Чтобы понять, почему это важно, давайте рассмотрим проблемы, с которыми сталкивается любой, кто пытается извлечь значимые выводы из неструктурированных данных Reddit.
Краткий ответ: Что такое поисковый MCP-сервер для Reddit?
Поисковый MCP-сервер для Reddit — это интеграция на базе ИИ, которая преобразует Reddit в структурированную, запрашиваемую базу данных для интеллектуальных агентов с использованием Model Context Protocol. Он позволяет выполнять поиск на естественном языке по постам, сабреддитам и пользователям с автоматическим определением намерений и фильтрацией.
Ключевые возможности:
- Поиск постов с запросами на естественном языке и автоматической сортировкой по релевантности
- Обнаружение сообществ на основе тем, описаний или количества участников
- Анализ активности пользователей и моделей влияния
- Объединение нескольких поисковых операций для сложных рабочих процессов обнаружения
Проблема: Вызов неструктурированных данных Reddit
Reddit представляет собой один из самых ценных источников данных в интернете, но эффективный доступ к нему сопряжен со значительными препятствиями:
Основные проблемы:
- Неоднозначность намерений – общие запросы возвращают нерелевантные результаты
- Сложная иерархия – навигация по постам, сабреддитам и метаданным требует опыта
- Отсутствие нативного интерфейса для ИИ – пользовательские обертки API хрупки и сложны в обслуживании
- Ограниченное понимание контекста – традиционный поиск не может различить «в тренде сейчас» и «самое обсуждаемое в этом месяце»
- Фрагментированные рабочие процессы – исследователям приходится вручную собирать информацию из нескольких поисков
Устранение неоднозначности намерений пользователя
Запрос вроде «последнее об оборудовании для ИИ» может означать совершенно разные вещи в зависимости от контекста. Вы ищете лучшие посты за сегодня? Самые обсуждаемые темы за эту неделю? Новые обсуждения с небольшим количеством апвоутов, но высокой вовлеченностью?
Традиционным поисковым строкам не хватает контекстуального понимания для различения этих намерений. Согласно исследованию агентов на основе больших языковых моделей, эта проблема устранения неоднозначности представляет собой фундаментальное ограничение в системах информационного поиска.
Навигация по сложной структуре Reddit
Эффективный поиск на Reddit требует понимания нескольких уровней:
- Метаданные поста – апвоуты, комментарии, награды, временные метки
- Контекст сабреддита – правила сообщества, количество участников, уровни активности
- Сигналы пользователя – карма, история постов, репутация в сообществе
- Временная динамика – что является «горячим» по сравнению с «лучшим» за разные периоды времени
Ручная навигация по этой структуре для исследования или анализа отнимает много времени и чревата ошибками.
Пробел в интеграции
Для AI-агентов взаимодействие с Reddit обычно требовало специально созданных оберток API, которые были:
- Сложны в обслуживании по мере развития API Reddit
- Невозможно масштабировать для нескольких вариантов использования
- Лишены стандартизации для общения между агентами
- Неспособны выражать сложные запросы на естественном языке
Поисковый MCP-сервер для Reddit был разработан специально для решения этих проблем.
Решение с помощью ИИ: Структурированный доступ через MCP
Поисковый MCP-сервер для Reddit предоставляет стандартизированный, интеллектуальный интерфейс, который любой MCP-совместимый агент может использовать для точных запросов к Reddit.
| Традиционный поиск на Reddit | Поисковый MCP-сервер для Reddit |
|---|---|
| Только совпадение по ключевым словам | Понимание естественного языка |
| Ручной выбор фильтров | Автоматическое определение намерений |
| Фрагментированные результаты | Структурированные, обогащенные данные |
| Пользовательская интеграция API | Универсальный протокол MCP |
| Ограниченный контекст | Многомерная фильтрация |
Архитектура: Три основных поисковых инструмента
Сервер предоставляет три специализированных инструмента, каждый из которых предназначен для определенного вектора поиска:
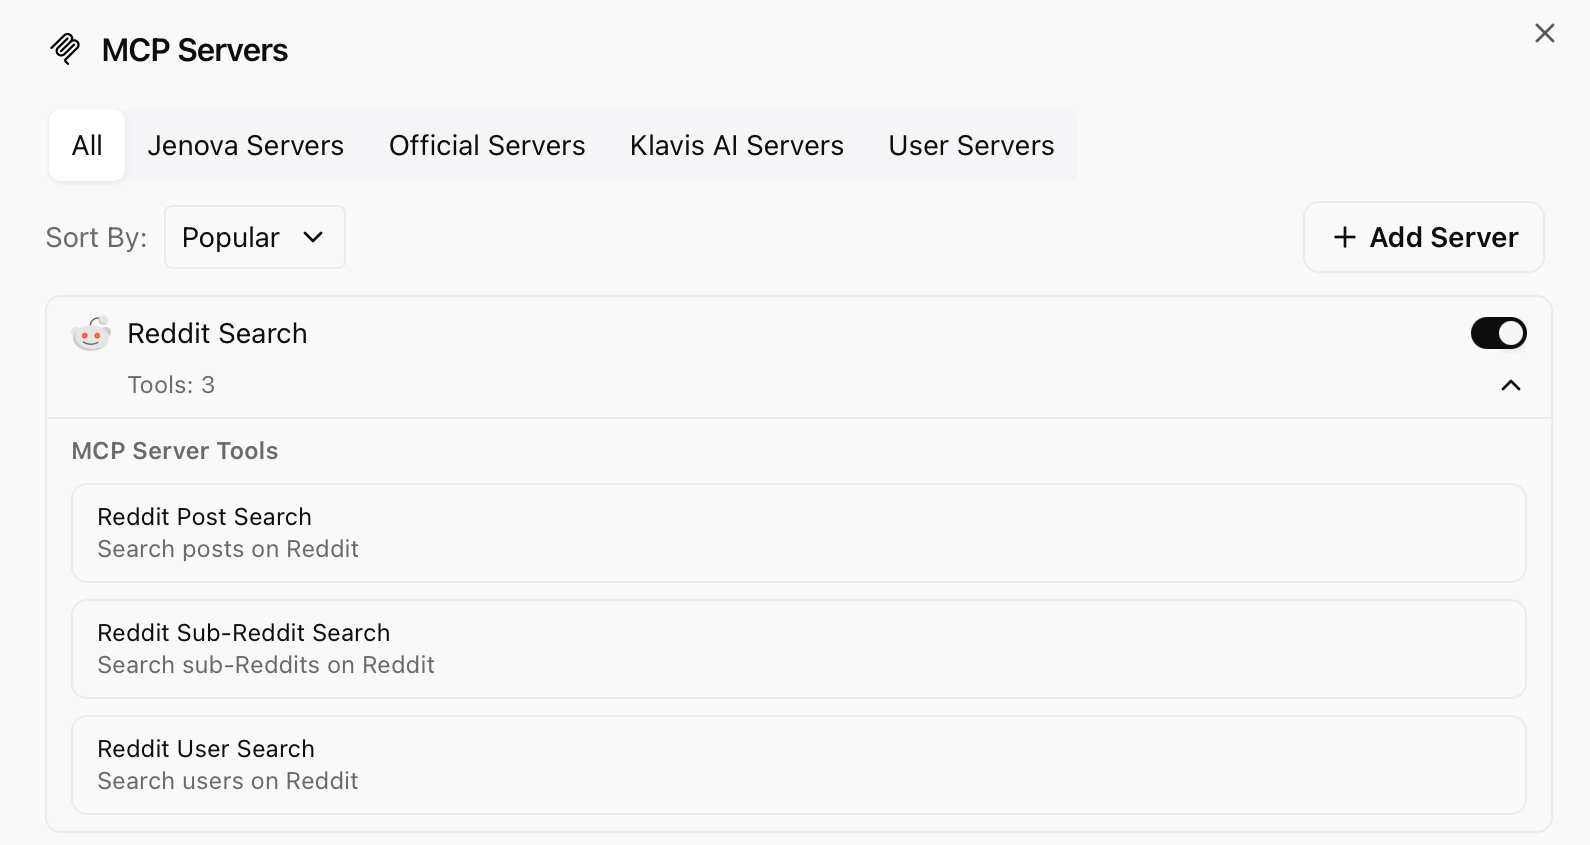
Поиск постов на Reddit
Этот основной инструмент позволяет агентам искать отдельные посты, используя естественный язык. Система интеллектуально интерпретирует намерение пользователя и автоматически применяет соответствующие фильтры:
- Опции сортировки:
hot,new,top,relevance - Временные фильтры: час, день, неделя, месяц, год, за все время
- Метрики вовлеченности: апвоуты, комментарии, награды
- Таргетинг по сабреддитам: поиск в определенных сообществах или по всему Reddit
Поиск саб-реддитов на Reddit
Находите целые сообщества на основе:
- Ключевых слов и описаний тем
- Количества участников и уровней активности
- Направленности и правил сообщества
- Связанных сетей сабреддитов
Это позволяет проводить более широкий анализ того, где происходят конкретные обсуждения и какие сообщества наиболее релевантны для вашего исследования.
Поиск пользователей на Reddit
Для приложений, требующих анализа конкретной активности или влияния пользователя:
- Находить пользователей по имени пользователя
- Получать публичную историю активности
- Анализировать модели публикаций и вовлеченность
- Выявлять влиятельных членов сообщества
Интеллектуальное объединение запросов
Архитектура с несколькими инструментами позволяет поисковому MCP-серверу для Reddit объединять команды для сложных рабочих процессов обнаружения.
Пример рабочего процесса:
- Использовать поиск по саб-реддитам для определения топ-5 сообществ, связанных с «квантовыми вычислениями»
- Использовать поиск по постам, чтобы найти самые популярные посты в каждом сообществе за последнюю неделю
- Использовать поиск пользователей для выявления самых активных участников этих обсуждений
- Синтезировать выводы по всем точкам данных
Такой уровень оркестровки ранее был невозможен без обширной пользовательской разработки.
Как это работает: От естественного языка к структурированным данным
Поисковый MCP-сервер для Reddit доступен исключительно через Jenova, первую платформу AI-агентов, созданную для экосистемы MCP. Вот как интеграция преобразует поиск на Reddit:
Шаг 1: Запрос на естественном языке
Пользователи задают вопросы на простом языке: «Что люди на Reddit говорят о новом обновлении GPT-5?» Нет необходимости изучать синтаксис запросов или вручную выбирать фильтры.
Шаг 2: Определение намерений и выбор инструмента
Оркестрационный движок Jenova анализирует запрос, чтобы понять намерение. Ищет ли пользователь недавние обсуждения? Посты с самым высоким рейтингом? Новые обсуждения? Система автоматически выбирает инструмент поиска постов на Reddit и применяет соответствующие фильтры.
Шаг 3: Интеллектуальная фильтрация
На основе обнаруженного намерения ИИ применяет многомерные фильтры:
- «Горячие мнения о последнем трейлере фильма» → Приоритет отдается постам с высоким соотношением комментариев к апвоутам в развлекательных сабреддитах
- «Сводка последних анонсов оборудования» → Ищет посты с высоким рейтингом и информативностью в технологических сообществах
- «Новые обсуждения климатической политики» → Находит новые посты с растущей вовлеченностью в релевантных сабреддитах
Шаг 4: Рендеринг обогащенного контента
Jenova не просто возвращает ссылки. Она отображает контент Reddit — включая текст, изображения и видео — прямо в своем интерфейсе. Это создает плавный исследовательский опыт без переключения контекста.

Шаг 5: Итеративное уточнение
Пользователи могут уточнять поиск в разговорной манере: «Покажи мне больше постов, подобных этому» или «Какие лучшие комментарии в этой теме?» Система сохраняет контекст на протяжении всего разговора.
Реальные приложения и варианты использования
📊 Маркетинговые исследования и конкурентная разведка
Сценарий: Менеджеру по продукту необходимо понять настроения клиентов относительно недавнего запуска конкурента.
Традиционный подход: Вручную искать на Reddit, читать десятки тем, делать заметки, синтезировать выводы. Требуемое время: 4-6 часов.
Поисковый MCP-сервер для Reddit: Запрос на естественном языке возвращает лучшие обсуждения с анализом настроений, ключевыми темами и влиятельными голосами. Требуемое время: 15 минут.
Ключевые преимущества:
- Выявлять возникающие проблемы до того, как они станут широко распространенными
- Отслеживать тенденции настроений с течением времени
- Обнаруживать неудовлетворенные потребности в целевых сообществах
💼 Социальный мониторинг для управления брендом
Сценарий: Команде по коммуникациям необходимо отслеживать упоминания бренда в различных сообществах Reddit.
Традиционный подход: Настроить оповещения по ключевым словам, вручную просматривать каждое упоминание, классифицировать по настроению и срочности.
Поисковый MCP-сервер для Reddit: Автоматизированный мониторинг с интеллектуальной фильтрацией выявляет высокоприоритетные упоминания, требующие ответа.
Ключевые преимущества:
- Оповещения в реальном времени о кризисах бренда
- Выявлять сторонников и противников бренда
- Отслеживать эффективность кампаний в сообществах
📱 Обнаружение контента и анализ трендов
Сценарий: Создатель контента хочет выявить трендовые темы в своей нише до того, как они станут мейнстримом.
Традиционный подход: Ежедневно просматривать несколько сабреддитов, вручную отслеживать паттерны апвоутов, угадывать возникающие тренды.
Поисковый MCP-сервер для Reddit: Запрос постов с высокой скоростью вовлеченности в целевых сообществах, отсортированных по новизне.
Ключевые преимущества:
- Обнаруживать тренды за 24-48 часов до их пика
- Выявлять пробелы в контенте в вашей нише
- Понимать, что находит отклик у конкретной аудитории
🎯 Академические исследования и сбор данных
Сценарий: Исследователю, изучающему онлайн-сообщества, необходимо собирать и анализировать модели обсуждений.
Традиционный подход: Использовать API Reddit с пользовательскими скриптами, вручную очищать и структурировать данные, проводить анализ.
Поисковый MCP-сервер для Reddit: Структурированный доступ к данным со встроенной фильтрацией позволяет проводить немедленный анализ.
Ключевые преимущества:
- Воспроизводимые исследовательские рабочие процессы
- Стандартизированный сбор данных по всем исследованиям
- Интеграция с инструментами анализа через MCP
Преимущество MCP: Надежность и масштабируемость
Глубокая интеграция между Jenova и поисковым MCP-сервером для Reddit демонстрирует мощь стандарта Model Context Protocol.
Jenova выступает в роли интеллектуального клиента, который использует специализированные инструменты, предлагаемые MCP-сервером Reddit. Эти отношения клиент-сервер являются основным принципом MCP и обеспечивают:
- Надежность: Мультиагентная архитектура Jenova достигает надежности вызова инструментов в 97,3%, гарантируя безупречное выполнение сложных, многоэтапных запросов
- Масштабируемость: Стандартизированный протокол позволяет одному и тому же агенту взаимодействовать с несколькими MCP-серверами без пользовательской интеграции
- Поддерживаемость: Обновления API Reddit обрабатываются на уровне сервера, а не в каждом клиентском приложении
- Компонуемость: Агенты могут объединять операции на нескольких MCP-серверах для сложных рабочих процессов
Эта архитектура представляет собой фундаментальный сдвиг от монолитных систем к модульной, управляемой протоколами инфраструктуре ИИ.
Часто задаваемые вопросы
Чем поисковый MCP-сервер для Reddit отличается от нативного поиска Reddit?
Поисковый MCP-сервер для Reddit обеспечивает понимание естественного языка, автоматическое определение намерений и структурированный доступ к данным, предназначенный для AI-агентов. Нативный поиск Reddit требует ручного выбора фильтров и возвращает неструктурированные результаты. MCP-сервер также позволяет сложное объединение запросов и интеграцию с другими инструментами ИИ через Model Context Protocol.
Является ли использование поискового MCP-сервера для Reddit бесплатным?
Поисковый MCP-сервер для Reddit доступен через Jenova, которая предлагает как бесплатные, так и платные тарифы. Пользователи бесплатного тарифа получают полный доступ ко всем основным функциям, включая поисковый MCP-сервер для Reddit, с ежедневными лимитами использования. Платные подписчики получают значительно более высокие лимиты использования. Посетите www.jenova.ai для получения конкретной информации о ценах.
Могу ли я использовать поисковый MCP-сервер для Reddit в коммерческих целях?
Да, сервер предназначен как для личного, так и для коммерческого использования, включая маркетинговые исследования, мониторинг бренда, обнаружение контента и академические исследования. Коммерческие пользователи обычно получают выгоду от платных тарифов Jenova для более высоких лимитов использования.
Работает ли поисковый MCP-сервер для Reddit на мобильных устройствах?
Да, интерфейс Jenova полностью адаптивен и оптимизирован для мобильных устройств. Вы можете выполнять поиск на Reddit на естественном языке и просматривать обогащенный контент на смартфонах и планшетах.
Насколько точно определение намерений?
Система использует передовые языковые модели для интерпретации намерений запроса с высокой точностью. Мультиагентная архитектура Jenova достигает надежности вызова инструментов в 97,3%, гарантируя правильную интерпретацию и выполнение запросов. Пользователи также могут уточнять поиск в разговорной манере, если первоначальные результаты не соответствуют их намерениям.
К каким данным получает доступ поисковый MCP-сервер для Reddit?
Сервер получает доступ только к общедоступным данным Reddit через официальные API. Он соблюдает условия обслуживания Reddit и не получает доступ к личным сообщениям, удаленному контенту или данным пользователей сверх того, что является общедоступным. Jenova очень строго относится к данным и конфиденциальности пользователей и не использует данные пользователей для обучения своих моделей.
Заключение: Будущее социальной разведки на основе ИИ
Поисковый MCP-сервер для Reddit представляет собой нечто большее, чем просто новый поисковый инструмент — это доказательство концепции будущего взаимодействия с данными на основе ИИ. Размещая стандартизированный, интеллектуальный слой поверх огромных, неструктурированных данных Reddit, Model Context Protocol позволяет AI-агентам воспринимать и понимать социальные беседы с беспрецедентной тонкостью.
По мере того как все больше сервисов становятся доступными через выделенные MCP-серверы, возможности агентов, таких как Jenova, будут расти экспоненциально. Мы движемся к будущему, в котором агенты будут беспрепятственно организовывать задачи в десятках сервисов — от поиска в социальных сетях и научных статьях до управления календарями и отправки электронных писем — все это через универсальный, надежный протокол.
Трансформация от ручного просмотра Reddit к интеллектуальному социальному мониторингу на основе ИИ теперь завершена. Независимо от того, проводите ли вы маркетинговые исследования, отслеживаете настроения бренда, обнаруживаете тренды контента или анализируете онлайн-сообщества, попробуйте поисковый MCP-сервер для Reddit, чтобы ощутить следующее поколение социальной разведки данных.
Ссылки
- Model Context Protocol. (2024). Официальная документация MCP. Получено с https://modelcontext.org/
- Reddit, Inc. (2024). Reddit - Погрузись во что угодно. Получено с https://www.reddit.com
- arXiv. (2024). Обзор автономных агентов на основе больших языковых моделей. Получено с https://arxiv.org/abs/2308.11432