Как тестировать AI-ассистента для исследований на целостность источников?
2026-08-22
Какие пять проверок аудита отличают проверяемую цепочку источников от театра цитат?
Пригодный AI-ассистент для исследований — тот, который можно аудировать, а не тот, который лишь выглядит снабжённым цитатами. В 2026 году практический критерий заключается в том, создаёт ли инструмент цепочку источников — восстанавливаемый путь от каждого утверждения к реальному, датированному, кликабельному документу — по пяти проверкам: охват источников, кликабельность цитат, соответствие утверждения источнику, даты обновлений и маркировка выводов. Академический исследовательский ассистент Jenova создан для поиска актуальной литературы и управления цитатами, тогда как Elicit, Scite, Consensus, Perplexity и ChatGPT Deep Research проходят одни из этих проверок и не проходят другие.
Разница не сводится к «большему числу сносок». Руководства по библиотечной оценке прямо указывают: даже если AI-инструмент ссылается на реальную страницу, сгенерированный текст всё равно может быть ошибочным, поэтому необходимо сопоставлять ответ с указанным источником, а не просто подтверждать наличие URL (Библиотеки Северо-Западного университета). Поэтому справедливый аудит оценивает пять измерений TRACE:
✅ Прослеживаемость — каждое существенное утверждение имеет кликабельную цитату, открывающую нужный документ
✅ Охват поиска — источники охватывают нужный корпус (статьи, отчёты, новости, первичные данные), а не один удобный индекс
✅ Соответствие — процитированный фрагмент действительно подтверждает утверждение, включая числа и оговорки
✅ Актуальность — даты публикации или обновления видны, а устаревшие источники помечены
✅ Эпистемическая маркировка — ассистент отмечает, что процитировано, что выведено, а что неизвестно
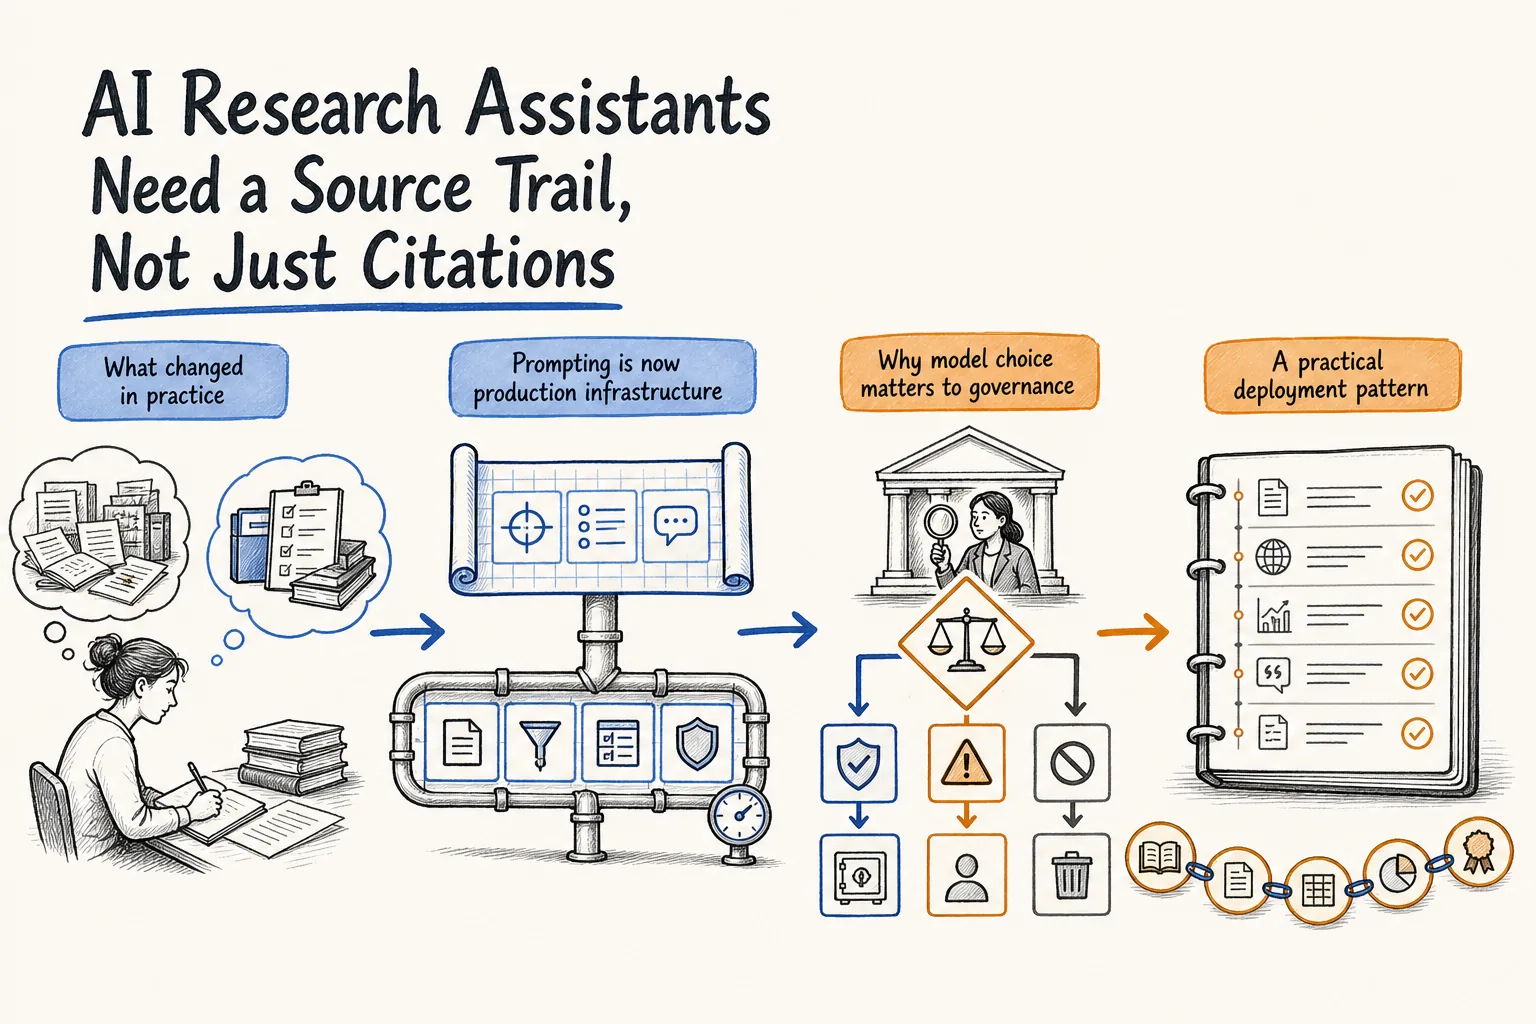
Чтобы осмысленно сравнивать инструменты, рассматривайте промпты и оценку как производственную инфраструктуру: одинаковые запросы, одинаковые правила «пройдено/не пройдено», одинаковое требование маркировать неподтверждённый синтез как вывод, а не как факт.
Почему проверка цитат особенно важна для AI-ассистентов для исследований в 2026 году?
Проверка цитат стала важнее, поскольку исследователи используют генеративные инструменты для высокорискового синтеза, хотя эти инструменты по-прежнему выдумывают, неверно атрибутируют и незаметно обновляют источники. Библиотеки Университета Невады в Рино чётко описывают проблему: вы оцениваете утверждение, а не убедительность списка источников, и цитата, которую невозможно найти, может быть галлюцинацией.
Уровень ошибок не является чисто теоретическим. Исследование JMIR о ссылках, сгенерированных ChatGPT показало, что лишь около 73–76% цитат соответствовали реальным источникам. Stanford HAI сообщил, что юридические AI-модели галлюцинировали хотя бы в одном из шести тестовых запросов. Именно поэтому «инструмент выдал мне библиографию» не является критерием приёмки.
Актуальность ещё больше повышает ставки. Отраслевые исследования цитат в AI-поиске сообщают, что примерно половина страниц, цитируемых AI, моложе 13 недель, а контент, на который ссылается AI, в среднем примерно на 25% свежее классических веб-результатов. Ассистенты, не указывающие даты обновления, могут выглядеть актуальными, одновременно повторяя данные прошлого квартала. Если ваш рабочий процесс включает обзоры литературы, аналитические записки по политике или инвестиционные исследования, неаудированный ассистент — это безмолвный соавтор без лабораторного журнала.
Какую шкалу оценки использовать для аудита AI-ассистента для исследований?
Используйте шкалу на уровне утверждений с бинарными порогами и одной градуированной оценкой соответствия, а не целостное впечатление «это выглядит академично». Единица оценки — одно фактическое предложение вместе с процитированным фрагментом; это тот же уровень детализации, который применяется в автоматизированных конвейерах валидации цитат, сравнивающих утверждения со ссылочным текстом.
Оценивайте каждое существенное утверждение по этой шкале:
| Проверка | Пройдено | Частично | Не пройдено |
|---|---|---|---|
| Охват источников | Первичный или рецензируемый источник, соответствующий утверждению | Только релевантный вторичный источник | Блог, SEO-страница или неверная предметная область для утверждения |
| Кликабельная цитата | URL открывает процитированный документ в пригодном для работы месте | URL открывает главную страницу или экран платного доступа | Неработающая, перенаправленная на нерелевантный ресурс или вымышленная ссылка |
| Соответствие утверждения источнику | Источник подтверждает утверждение, включая числа и оговорки | Источник относится к теме, но не подтверждает точное утверждение | Противоречие, неверное число или неподтверждённый скачок вывода |
| Дата обновления | Дата указана и соответствует запросу | Дата есть, но источник устарел относительно вопроса | Даты нет либо она подразумевается без доказательств |
| Маркировка вывода | Ассистент отмечает синтез, экстраполяцию и неизвестное | Факты из источников и выводы смешаны, маркировка слабая | Выводы представлены как установленные факты |
Практический порог для профессионального использования: ноль вымышленных ссылок, ноль немаркированных числовых утверждений и не менее 80% существенных утверждений, полностью подтверждённых процитированным фрагментом. Подтверждаемость — правильный стандарт, поскольку он оценивает разрыв между выводом и доказательством, а не совпадение ключевых слов; исследование ACL Findings по оценке Open-QA показывает, что оценка подтверждаемости ближе к человеческому суждению, чем метрики точного совпадения.
Применяйте шкалу к фиксированному набору проверочных запросов: один вопрос о быстро меняющихся новостях или политике, одно количественное научное утверждение, один вопрос о противоречивой литературе и один вопрос «что неизвестно». Если ассистент не умеет корректно признавать неудачу в последнем случае, он не готов для исследований.
Как Elicit, Consensus, Scite, Perplexity и Jenova сравниваются по целостности источников?
Ни один AI-ассистент для исследований не лидирует по всем измерениям TRACE. Elicit особенно силён в структурированном извлечении данных из большого корпуса статей; Scite — в оценке полярности цитирования; Perplexity и ChatGPT — в быстрых ответах по открытому вебу со встроенными ссылками; Академический исследовательский ассистент Jenova сильнее, когда требуется актуальная сессия исследований из множества источников с возможностью сохранять журнал аудита между запросами.
Практические сравнения 2026 года обычно рассматривают Elicit как основной инструмент для обзоров литературы, а Consensus — как более быстрый индикатор доказательств в формате «да/нет». Обзоры инструментов для медицинских исследований описывают Perplexity как самый быстрый универсальный вариант со встроенными цитатами, менее ограниченный, чем академические специализированные инструменты. Сравнение инструментов для обзора литературы HKUST — полезный каталог различий в охвате и доступе среди этих решений.
| Функция / измерение | Elicit | Scite | Consensus | Perplexity / ChatGPT | Академический исследовательский ассистент Jenova |
|---|---|---|---|---|---|
| Охват источников | Более 125M статей; академическая направленность (Elicit) | Граф цитирования и полнотекстовые Smart Citations (Scite) | Корпус статей, настроенный на исследовательские вопросы | Открытый веб и дополнительные академические источники | Актуальный веб + академический поиск, работа с рукописями и цитатами |
| Кликабельные цитаты | Карточки статей и извлечённые фрагменты | Страницы цитирования с контекстными фрагментами | Ответы, подкреплённые статьями | Встроенные URL; качество зависит от запроса | Встроенные кликабельные ссылки на источники в исследовательских ответах |
| Соответствие утверждения источнику | Заявленная точность извлечения: 1 502/1 511 точек данных (99,4%) | Показывает подтверждающие и опровергающие цитаты | Силен для бинарных вопросов о доказательствах | Необходима пользовательская проверка; риск галлюцинаций задокументирован | Зависит от извлечённого фрагмента; опубликованного бенчмарка извлечения нет |
| Даты обновления | Метаданные статей: год, издание | Контекст года публикации | Контекст года публикации | Непоследовательны, если не запросить явно | Может показывать и сопоставлять даты, если источники их содержат |
| Маркировка выводов | Структурированные столбцы уменьшают скрытые скачки вывода | Метки полярности, но не полные эпистемические теги | Consensus Meter показывает степень согласия | Редко маркирует выводы без специального запроса | Можно указать маркировать подтверждённые и выведенные утверждения |
| Цены (по состоянию на 2026 год) | Не проверены в этом обзоре | Не проверены; более ранние тесты отмечали короткий пробный период (Pure AI) | Около 144 долларов в год на начальном тарифе в одном сравнении 2026 года | Не проверены; тарифы поставщиков различаются | Бесплатный ограниченный доступ; Plus $20/мес. (30×), Premium $50, Pro $100, Max $200, Ultra $500, Enterprise $1,000 |
| Лучше всего подходит для | Систематического извлечения данных из статей | Проверки, подтверждает ли литература утверждение | Быстрых научных вопросов «да/нет» | Широкого веб-исследования со встроенными ссылками | Аудируемых многошаговых исследований и управления цитатами |
Честное ограничение Jenova носит структурный характер: это не специализированная таблица извлечения данных из статей, как Elicit, и она не предоставляет граф цитирования Scite с разделением на подтверждающие и опровергающие работы. Её преимущество — память сессии в сочетании с актуальным поиском, что важно, когда аудит требует последующих вопросов по той же цепочке источников. Ограничение Elicit противоположно: он исключительно хорош внутри индекса статей, но слабее как исследователь общего веба или политических документов. Perplexity и ChatGPT остаются инструментами, которым легче всего чрезмерно доверять, поскольку беглые встроенные цитаты всё ещё могут не выдержать проверки соответствия.
Как тестировать охват источников и кликабельные цитаты?
Охват тестируют, задавая вопросы, на которые невозможно правильно ответить по одному корпусу, а затем открывая каждую ссылку. Успешный тест охвата означает, что ассистент находит тип источника, необходимый для утверждения: клиническое испытание для оценки эффекта, нормативный акт или страницу ведомства для юридического порога, кодовую книгу набора данных для статистического показателя — а не удобный блог с теми же ключевыми словами.
Составьте три проверочных запроса на охват:
- Проверка только академических источников: «Что показывают рандомизированные исследования с 2020 года об X и какие результаты были предварительно зарегистрированы?»
- Проверка первичного документа: «Что говорится в исходном правиле ведомства, заявлении или наборе данных — без пересказа из новостей?»
- Проверка неизвестного: «Какие авторитетные источники обсуждают это и по-прежнему считают эффект недоказанным?»
Затем примените протокол перехода по ссылкам. Для каждой цитаты зафиксируйте, разрешается ли URL, является ли целевая страница именно процитированным документом и может ли человек найти подтверждающий фрагмент за две минуты. Руководство Северо-Западного университета рекомендует искать заголовок в библиотечном каталоге или базе данных, поскольку AI-системы часто прикрепляют реальное название к неверному журналу, автору или году. Неработающие ссылки, ссылки на главную страницу и сноски вида «источник: интернет» автоматически означают провал.
В Jenova сделайте охват явным требованием, а не надеждой:
«Ответь, используя как минимум четыре независимых источника. Отдавай предпочтение рецензируемым статьям, государственным органам или органам стандартизации и первичным наборам данных. Для каждого утверждения укажи кликабельный URL, название документа, дату публикации или обновления и цитату из 15–25 слов, подтверждающую утверждение. Если не удаётся найти первичный источник, сообщи об этом и остановись.»
В Elicit эквивалентная проверка состоит в том, чтобы убедиться, что извлечённые ячейки ведут к видимым фрагментам статьи, а не к модельному пересказу. В Perplexity или ChatGPT проверка строже: открывайте каждую встроенную ссылку, потому что исследовательские агенты открытого веба могут извлечь множество страниц, но сослаться на самую слабую из них. Сочетание Академического исследовательского ассистента Jenova с Real-Time Search полезно, когда проверочный запрос одновременно охватывает статьи, форумы, репозитории кода и новости, но каждый канал всё равно требует собственной проверки перехода по ссылкам.
Как тестировать соответствие утверждений источникам и маркировку выводов?
Соответствие тестируют, выясняя, подтверждает ли процитированный фрагмент предложение, а не просто связан ли он с темой. Наиболее важный сбой — почти совпадающее число или потерянная оговорка: источник говорит «около 80%», модель пишет «78%», а цитата всё равно выглядит идеальной. Именно этот класс ошибок должны выявлять автоматизированные средства оценки.
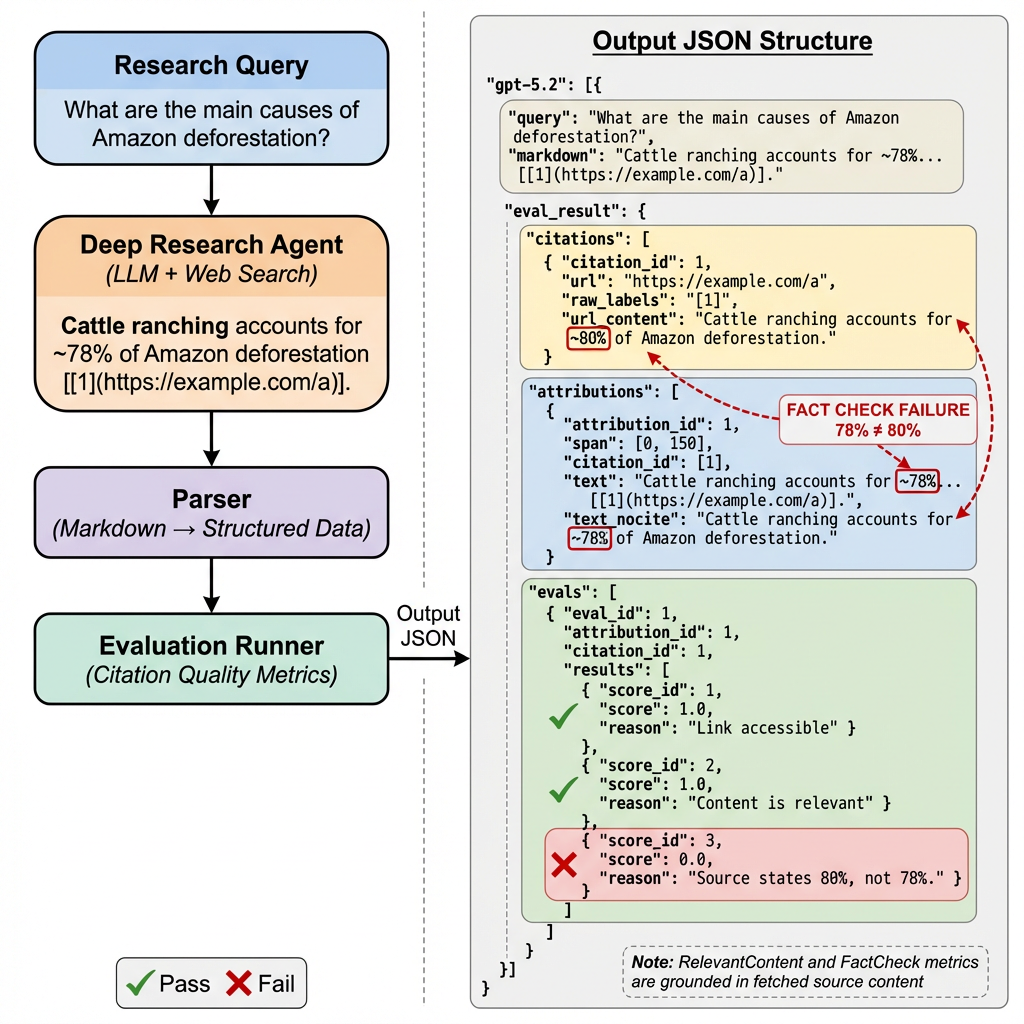
Используйте трёхуровневую проверку соответствия для каждого количественного или причинного утверждения:
- Сопоставление фрагмента: выделите предложение в источнике, которое предположительно подтверждает утверждение.
- Подтверждаемость: определите: подтверждено, недостаточно данных или противоречит. Вариант «недостаточно данных» означает провал, если ассистент представил утверждение как факт.
- Точность чисел и оговорок: единицы измерения, выборка, год, доверительный интервал и слова вроде «может», «на мышах» или «в одной стране» должны быть сохранены полностью.
Именно поэтому текстовая подтверждаемость является более надёжной метрикой аудита, чем «страница относится к теме». Оценка Open-QA на основе подтверждаемости существует именно для количественной оценки разрыва вывода между двумя текстами. Подход NVIDIA к валидации цитат применяет ту же идею на практике: сопоставляет утверждение со ссылочным текстом, а затем оценивает его.
Маркировка выводов — сопутствующая проверка. Исследовательский ассистент должен помечать каждый абзац как sourced, inferred или unknown. Синтез допустим; немаркированный синтез — нет. Рекомендации UNR по проверке утверждений предлагают правильный подход: спросить, кто может проверить это утверждение. Если проверяющий — «общие знания модели», предложению требовалась метка вывода.
Строгий промпт для этой проверки:
«Раздели ответ на три маркированных блока: (1) утверждения, напрямую подтверждённые источниками, каждое с цитатой и URL; (2) выводы с указанием предпосылок, на которых они основаны; (3) неизвестное. Не перемещай вывод в блок 1. Если число в источнике приблизительное, сохрани эту приблизительность.»
Elicit снижает количество скрытых выводов, принуждая к ответам в столбцах извлечения, и это действительно сильная сторона. Scite маркирует, подтверждают или опровергают последующие статьи данную цитату, что помогает выявить другой скачок вывода — представление одной работы как устоявшегося консенсуса. Jenova может соблюдать формат трёх блоков в рамках длинной сессии, но не будет принудительно применять эти метки, если вы их не потребуете. Это реальный продуктовый недостаток по сравнению с инструментами со встроенными индикаторами доказательств.
Как проверять даты обновления и свежесть источников?
Свежесть проверяют, требуя видимую дату для каждого источника и добавляя как минимум один запрос, правильный ответ на который изменился за последний год. Ассистент, который не может показать, когда была опубликована страница или статья, не готов отвечать на вопросы о ценах, регулировании, выпусках моделей, эпидемиологии или структуре рынка.
Исследование свежести контента в AI-поиске показывает, что актуальность влияет на то, будет ли система извлекать страницу для текущего вопроса. Работы по отслеживанию AI-цитат также предупреждают, что поисковые системы непрерывно переоценивают источники, поэтому вчерашняя аккуратная записка может незаметно устареть. Поэтому ваш аудит должен фиксировать три даты, а не одну:
- Дата источника — дата публикации или последнего обновления на странице или в статье
- Дата доказательств — год, когда были собраны исходные данные
- Дата ответа — момент, когда ассистент получил источник
Распространённая ошибка — цитировать обзор 2019 года для «текущего» показателя распространённости или ссылаться на интерактивную панель без фиксации времени получения данных. Академические специализированные инструменты, такие как Elicit и Consensus, обычно показывают год публикации, поскольку опираются на метаданные статей. Инструменты открытого веба часто этого не делают, если не дать специальную инструкцию. Jenova может сообщать даты, когда извлечённый документ их содержит, но не может выдумать достоверную отметку времени для страницы без даты — и должна прямо сообщать об этом.
Примеры проверочных запросов на свежесть:
«Каков текущий показатель по состоянию на 2026 год? Укажи дату обновления источника. Если лучший источник старше 18 месяцев, пометь ответ как исторический, а не текущий.»
«Сравни самый новый найденный источник с наиболее цитируемым старым источником. Что изменилось, а что осталось прежним?»
Если ассистент не может отличить обновлённую HTML-страницу от неизменённой перепечатки PDF, оценивайте актуальность как непрохождение, даже если URL работает.
Как провести воспроизводимый аудит TRACE с помощью одного промпта?
Воспроизводимый аудит проводят, фиксируя набор проверочных запросов, таблицу оценивания и заставляя каждый инструмент выдавать одинаковые машиночитаемые поля. Цель — получить стенограмму, которую другой исследователь сможет переоценить, не наблюдая за вашей работой.
Используйте эту последовательность для Академического исследовательского ассистента Jenova, затем повторите её как минимум на одном специализированном инструменте (Elicit или Scite) и одном универсальном инструменте (Perplexity или ChatGPT):
- До вопроса укажите роль и контракт формата вывода.
- Задайте по одному проверочному запросу каждого класса: количественный, противоречивый, первичный документ и неизвестное.
- Требуйте название, URL, дату, цитату и метку утверждения для каждой цитаты.
- Откройте каждую ссылку и оцените TRACE до любых уточняющих вопросов.
- Только после этого запросите исправление не прошедших проверку утверждений.
Стартовый контракт:
«Ты проходишь аудит. Для каждого существенного утверждения выведи: текст утверждения; метку (
sourced/inferred/unknown); название источника; кликабельный URL; дату публикации или обновления; подтверждающую цитату не более 25 слов. Если соответствие неполное, понизь метку доinferredилиunknown. Не цитируй источники, которые ты не получил. В конце добавь примечание об охвате с перечнем использованных и отсутствующих типов источников.»
В Elicit параллельная процедура выглядит так: выполните тот же вопрос в формате исследовательского отчёта, затем выборочно сверяйте извлечённые ячейки с фрагментом PDF. В Scite выполните основной запрос как запрос контекста цитирования и подсчитайте подтверждающие и опровергающие статьи, прежде чем принять предложение, звучащее как консенсус. В ChatGPT Deep Research собственный исследовательский процесс OpenAI всё равно требует изучать источники; функция продукта обеспечивает поиск и структуру, но не заменяет проверку подтверждаемости.
Ведите простой журнал: утверждение, URL, дата, оценки TRACE, примечания. Десяти утверждений по четырём проверочным запросам достаточно, чтобы увидеть закономерность. Если соответствие не проходят более двух числовых утверждений, прекратите использовать инструмент для любых материалов, на которые будет ссылаться кто-либо ещё.
Что говорят специалисты по исследовательской добросовестности о проверке AI-цитат?
Практика исследовательской добросовестности пришла к прямому правилу: относитесь к AI-цитатам как к непроверенным утверждениям, пока человек или автоматизированная проверка подтверждаемости не откроет источник. Полезный спор больше не о том, галлюцинируют ли модели, а о том, какие сбои можно измерить и контролировать.
«Отрасль продолжает оптимизировать более красивые библиографии. Это неверная единица оценки. Цитата — это указатель, а не доказательство. Если процитированный фрагмент не подтверждает предложение — особенно число, популяцию и год, — цитата носит декоративный характер. Мы видели, как ошибки “78% вместо 80%” проходили все косметические проверки: реальный URL, релевантное название, уверенный тон. Именно такие ошибки попадают в рукописи.»
«Маркировка выводов — самый дешёвый контроль, который пропускает большинство команд. Как только ассистенту разрешено смешивать поиск с общими знаниями, он начинает представлять догадки как результаты. Принудите его использовать три категории — подтверждённое источниками, выведенное, неизвестное — и уровень галлюцинаций станет видимым. Команды, отказывающиеся показывать категорию неизвестного, сообщают вам, что не способны представлять неопределённость.»
«Тестирование охвата — это также выбор в области управления. Ассистент, работающий только со статьями, будет выглядеть строго, но всё равно пропустит меморандум ведомства, изменивший правило в прошлом месяце. Ассистент, работающий только с вебом, будет выглядеть актуально, но всё равно пропустит испытание, которое действительно измерило результат. Здесь важен выбор модели, поскольку одни модели осторожнее формулируют выводы, другие сжимают информацию, а третьи опускают оговорки. Аудит должен следовать за утверждением, а не за брендом.»
— Команда продукта Jenova, оценка исследовательских агентов, 6 лет разработки процессов поиска и цитирования для академических и профессиональных пользователей
Эта позиция согласуется с библиотечной практикой. Северо-Западный университет документирует случаи, когда модель ссылалась на реальную энциклопедическую статью, но всё равно ошибалась в именах и датах. UNR советует исследователям спрашивать, кто может проверить утверждение. Оба подхода представляют TRACE, изложенный обычным языком.
Когда AI-ассистент для исследований достаточно хорош для реальной исследовательской работы?
AI-ассистент для исследований достаточно хорош, когда он проходит аудит TRACE на ваших реальных типах вопросов, а не прошедшие проверку утверждения либо исправляются по источнику, либо понижаются до маркированного вывода. Он недостаточно хорош, если выдаёт беглые, насыщенные ссылками ответы, которые разрушаются при проверке переходом по ссылкам и подтверждаемости.
Используйте такое правило выбора:
- Используйте специализированный инструмент извлечения, такой как Elicit, когда задача состоит в отборе или извлечении данных из известного набора статей, и вы всё равно будете выборочно проверять ячейки.
- Используйте Scite, когда вопрос в том, подтверждает, упоминает или опровергает литература конкретное утверждение.
- Используйте Consensus, когда вам нужно быстро определить направление доказательств по ограниченному научному вопросу.
- Используйте Perplexity или ChatGPT для широкого предварительного исследования, а затем повторно проверяйте каждое число, прежде чем включить его в рукопись.
- Используйте Академический исследовательский ассистент Jenova, когда работа многошаговая — поиск литературы, работа с языком рукописи и управление цитатами в одной аудируемой цепочке — и вы готовы требовать поля TRACE в промпте.
Не используйте ни один из них как неконтролируемый финальный этап. Результаты JMIR о точности цитат и показатели галлюцинаций Stanford HAI — достаточная причина сохранять человека в контуре принятия решений. Выигрышная конфигурация 2026 года — не одна «доверенная» модель. Это цепочка источников, которую можно воспроизвести: кликабельные ссылки, датированные документы, подтверждённые утверждения и видимая граница между доказательствами и выводами.
Источники
- Библиотеки Северо-Западного университета — оценка контента, сгенерированного AI
- Библиотеки Университета Невады в Рино — AI и оценка источников
- JMIR — оценка эффективности больших языковых моделей и надёжности сгенерированных цитат
- Stanford HAI — AI на суде: юридические модели галлюцинируют в 1 из 6 и более тестовых запросов
- AuthorityTech — свежесть контента для SEO в 2026 году
- Обсуждение Chris Long / Ahrefs — свежесть и видимость в AI-поиске
- ACL Findings — точная и детализированная оценка Open-QA через текстовую подтверждаемость
- NVIDIA Developer — автоматическая валидация цитат с использованием NVIDIA NIM
- Elicit — AI для научных исследований, охват и точность извлечения
- Scite — Smart Citations для научной литературы
- The Drive AI — Elicit против Consensus против Semantic Scholar
- iatroX — лучшие AI-инструменты для медицинских исследований в 2026 году
- Библиотека HKUST — сравнение новых AI-инструментов для обзора литературы
- Omid Saffari — лучшие AI-инструменты для исследований 2026: Elicit против Consensus
- Pure AI — требуются цитаты: тестирование 7 AI-инструментов для исследований
- SEOptimer — свежесть контента в SEO и AI-поиске
- OtterlyAI — как отслеживать AI-цитаты и источники в поисковых системах
- Firecrawl — веб-поиск и глубокое исследование для AI-агентов
- OpenAI Academy — исследования с ChatGPT: поиск и Deep Research