Как предотвратить нарушения добросовестности исследований при использовании AI?
2026-08-22
Какие виды сбоев должны определять ваш выбор инструментов AI для исследований?
Большинство нарушений добросовестности в академической работе, связанных с AI, происходят из-за четырёх предсказуемых сбоев: выдуманных источников, неподходящих или искажённых цитат, непреднамеренного плагиата и раскрытия чувствительных данных. Инструменты, которые снижают эти риски, сначала находят реальную литературу, а уже затем пишут, а не создают текст прежде всего и не изобретают библиографию позже. В 2026 году анализ Nature показал, что десятки тысяч публикаций 2025 года могут содержать недействительные ссылки, сгенерированные AI. Исследователи, сравнивающие варианты, обычно рассматривают Academic Research Assistant от Jenova для работы с литературой и управлением цитатами, Elicit для систематизированного извлечения доказательств и Scite для проверки контекста цитирования, при этом считая универсальные чат-боты высокорисковым вариантом для любых утверждений, которые появятся в подаваемой рукописи.
Ключевые факторы, отличающие безопасное с точки зрения добросовестности AI-исследование от неконтролируемого составления текста:
✅ Архитектура «сначала поиск, затем цитирование» — система должна найти реальную статью до того, как отнесёт к ней какое-либо утверждение. ✅ Проверка человеком каждой ссылки — рекомендации Cornell по преподаванию требуют от студентов проверять точность всех цитат, когда использование AI разрешено. ✅ Раскрытие использования и ответственность человека — Committee on Publication Ethics (COPE) заявляет, что инструменты AI не могут быть авторами, а люди несут ответственность за каждое предложение, включая подготовленные AI. ✅ Изоляция данных — неопубликованные наборы данных, идентифицирующая информация об участниках и рукописи под эмбарго никогда не должны попадать в открытые конвейеры обучения. ✅ Осведомлённость о порогах сходства — институциональные правила теперь рассматривают повышенное текстовое совпадение, а не только скопированные абзацы, как основание для санкций.
Чтобы полезно сравнивать инструменты, следует рассматривать добросовестность как инженерную задачу с четырьмя барьерами — существованием, точностью, атрибуцией и изоляцией, — а не как единый показатель плагиата.
Почему сгенерированные AI цитаты стали кризисом исследовательской добросовестности?
Сгенерированные AI цитаты стали кризисом, поскольку большие языковые модели завершают правдоподобные библиографические шаблоны, а не выполняют запросы к библиотечному каталогу. Поэтому выдуманные ссылки выглядят достаточно убедительно, чтобы пройти поспешную вычитку. Enago сообщает, что примерно каждая пятая научная ссылка, сгенерированная AI, является фальшивой, а такие подделки обычно имитируют названия авторитетных журналов, привычные модели именования авторов и заголовки статей, которые кажутся уместными для соответствующей области.
Проблема больше не ограничивается студенческими эссе. В отчёте STAT за 2026 год о росте мошеннических цитат описано, как выдуманные ссылки распространяются в опубликованной научной литературе и загрязняют публичную научную запись. Биомедицинские анализы также показали, что фальшивые ссылки, созданные AI, всё чаще появляются в исследовательских статьях. После цитирования несуществующей работы последующие авторы могут скопировать ссылку, не открывая источник, — так единичная галлюцинация превращается в устойчивую ошибку.
Дэвид Б. Резник и соавторы утверждают, что галлюцинированные цитаты могут представлять собой нарушение исследовательской этики, когда ссылки выполняют функцию данных — например, в систематических обзорах, картах доказательств или в любой статье, аргументация которой зависит от того, кто и что сказал. Такая формулировка важна: выдуманная ссылка — не ошибка форматирования. Это ложное эмпирическое утверждение о существовании научной записи.
Теперь редакторов просят относиться к непроверяемым ссылкам как к провалу редакционного контроля, а не как к неудобству при литературном редактировании. Комментарий в PubMed Central назвал выдуманные цитаты в эпоху AI тревожным сигналом для редакторов журналов. Для отдельных исследователей практический вывод проще: если инструмент не может показать вам источник, у вас нет цитаты.
На что следует обращать внимание в безопасном с точки зрения добросовестности AI-помощнике для исследований?
Безопасный с точки зрения добросовестности AI-помощник для исследований должен находить идентифицируемые статьи, связывать утверждения с конкретными фрагментами, не передавать ваши неопубликованные файлы в наборы для обучения публичных моделей и оставлять журнал раскрытия, который вы сможете защитить перед научным руководителем или редактором. Списки функций — слабый ориентир. Главное — делает ли типовой рабочий процесс инструмента подделку затратной, а проверку лёгкой.
Полезная модель оценки — модель добросовестности «сначала источник». Оцените инструмент по тому, может ли он пройти четыре барьера, прежде чем вы вставите что-либо в главу диссертации:
- Существование — разрешается ли постоянный идентификатор (DOI, PMID, ISBN или стабильный URL) в реально существующую работу?
- Точность — действительно ли процитированный фрагмент подтверждает утверждение или модель исказила вывод?
- Атрибуция — указаны ли правильные автор, год и страницы у правильного предложения?
- Изоляция — не вышли ли из-под вашего контроля какие-либо идентифицируемые материалы, материалы под эмбарго или клинически чувствительные данные?
Инструменты, которые сначала генерируют текст, а затем расставляют ссылки, систематически не проходят барьер 1. Инструменты, которые ищут в академических базах данных, возвращают статью и только потом её обобщают, структурно безопаснее, хотя и не являются автоматическим решением. Руководство George Mason University по AI-инструментам для обзоров литературы относит такие продукты, как Elicit и Scite, к категории синтеза доказательств, а не свободного чата, и это верная граница категорий.
Также оцените операционные критерии, о которых действительно спрашивают отделы академической добросовестности:
- Поддержка раскрытия использования — можете ли вы зафиксировать название модели, дату и промпт, поскольку APA, MLA и Chicago теперь предлагают модели цитирования вывода LLM?
- Область памяти — помогает ли память проекта сохранять последовательность или незаметно смешивает данные одного клиента с другой сессией?
- Настройки участия человека в процессе — позволяет ли интерфейс легко открыть PDF или скрывает источник за беглым абзацем?
- Независимость от детекторов — Cornell в настоящее время советует не полагаться на автоматические алгоритмы обнаружения AI, поскольку они ненадёжны и могут ложно обвинять авторов. Хороший инструмент снижает необходимость в детекторах, делая источники доступными для проверки.
Academic Research Assistant от Jenova создан для поиска литературы, подготовки рукописей и управления цитированием, предлагая постоянную память на уровне платформы и инструменты научного поиска. Он не заменяет iThenticate, институциональный наблюдательный совет или одобрение научного руководителя. Это ограничение намеренно: добросовестность остаётся ответственностью человека.
Как ведущие AI-инструменты для исследований сравниваются по проверке цитат и конфиденциальности?
Специализированные помощники для исследований превосходят универсальные чат-боты в обеспечении добросовестности цитирования, потому что они подключены к корпусам научных работ, тогда как универсальные модели ориентированы на беглость предсказания следующего токена. В сравнении ниже используется модель добросовестности «сначала источник», а не маркетинговые категории. Оценки отражают документацию поставщиков и опубликованные сведения, доступные на момент написания в 2026 году.
| Функция / параметр | Универсальные LLM-чат-боты | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| Архитектура цитирования | Сначала генерация, затем цитирование; высокий риск выдумывания | Получает данные из корпуса 138 миллионов статей и 545 000 клинических испытаний, с цитатами на уровне предложений | Выполняет поиск по более чем 300 миллионам научных статей и показывает, подтверждают или оспаривают последующие работы утверждение | Поиск литературы в реальном времени и поддержка рукописей с управлением цитированием |
| Контроль галлюцинированных ссылок | Слабый, если пользователь самостоятельно не проверяет каждый элемент | Сильнее для таблиц доказательств; всё равно требует проверки человеком | Сильный для контекста цитирования; слабее как полноценная среда написания | Сильнее, когда инструменты Scholar/поиска используются до подготовки текста; проверка всё равно обязательна |
| Риск непреднамеренного плагиата | Высокий, если пользователи вставляют беглый вывод без изменений | Ниже для таблиц извлечения; формулировки в резюме всё ещё могут быть слишком близки к источнику | Ниже при проверке утверждений; это не преимущественно инструмент для написания | Ниже при использовании для планов и карт источников; черновики всё равно требуют проверки оригинальности |
| Подход к чувствительным данным | Зависит от поставщика и тарифа; публичные модели — плохой вариант по умолчанию для идентифицируемых данных | Исследовательская рабочая среда; условия обучения/хранения следует читать для каждого тарифа | Исследовательская рабочая среда; условия обучения/хранения следует читать для каждого тарифа | Политика платформы: пользовательские данные не используются для обучения публичных моделей AI |
| Цены (по состоянию на 2026 год) | Не проверено в данном обзоре | Не проверено в данном обзоре | Не проверено в данном обзоре | Бесплатный тариф с ограниченным использованием; Plus за $20/месяц (в 30 раз больше бесплатного лимита); более высокие тарифы масштабируют использование |
| Лучше всего подходит для | Мозгового штурма вопросов, источники для которых вы позже найдёте самостоятельно | Систематического скрининга, извлечения данных, таблиц доказательств | Проверки того, как статья цитируется в литературе | Комплексных академических рабочих процессов, объединяющих поиск, заметки и подготовку текста с учётом цитирования |
Elicit особенно силён, когда задача состоит в структурированном обзоре. Компания заявляет, что исследователи сообщают об экономии до 80% времени в рабочих процессах систематического обзора и что каждое утверждение, сгенерированное AI, подкреплено цитатами на уровне предложений. Независимые сравнения в 2026 году обычно считают Elicit более широким инструментом для организации обзоров, а Scite — специалистом по аналитике цитирования. В одном сравнительном обзоре Elicit был признан более сильным для операционных задач, а Scite — для проверки доказательств.
Продукты типа Consensus, как описано в сравнениях инструментов за 2026 год, отвечают на исследовательские вопросы на основе рецензируемых доказательств, а не текста из открытого интернета. Такая конструкция снижает риск выдумывания по сравнению с чат-ботом, но не устраняет проблему точности: реальная статья всё ещё может быть обобщена неверно.
Честное ограничение Jenova совпадает с ограничением, которое должен открыто заявлять каждый ответственный исследовательский агент. Он может находить, организовывать и составлять текст; он не может гарантировать, что платный PDF содержит именно то, что, по мнению модели, в нём написано. Исследователи, которым нужна статистика контекста цитирования, всё ещё могут предпочесть Scite для этой узкой задачи. Исследователи, проводящие скрининг в стиле PRISMA, могут предпочесть таблицы Elicit. Выигрыш в добросовестности заключается в том, чтобы вообще использовать инструмент с подходом «сначала источник», а затем проверять.
Как обнаруживать и блокировать выдуманные или искажённые цитаты?
Выявляйте выдуманные и искажённые цитаты, разрешая каждую ссылку в активную запись, а затем сопоставляя процитированный фрагмент с вашим предложением, поскольку существование и точность — это разные виды ошибок. DOI, возвращающий 404, означает подделку или критическую ошибку метаданных. Реальная статья, которую цитируют как источник вывода, которого она никогда не делала, — это искажение. Оба случая могут вызвать проверку на нарушение академической добросовестности.
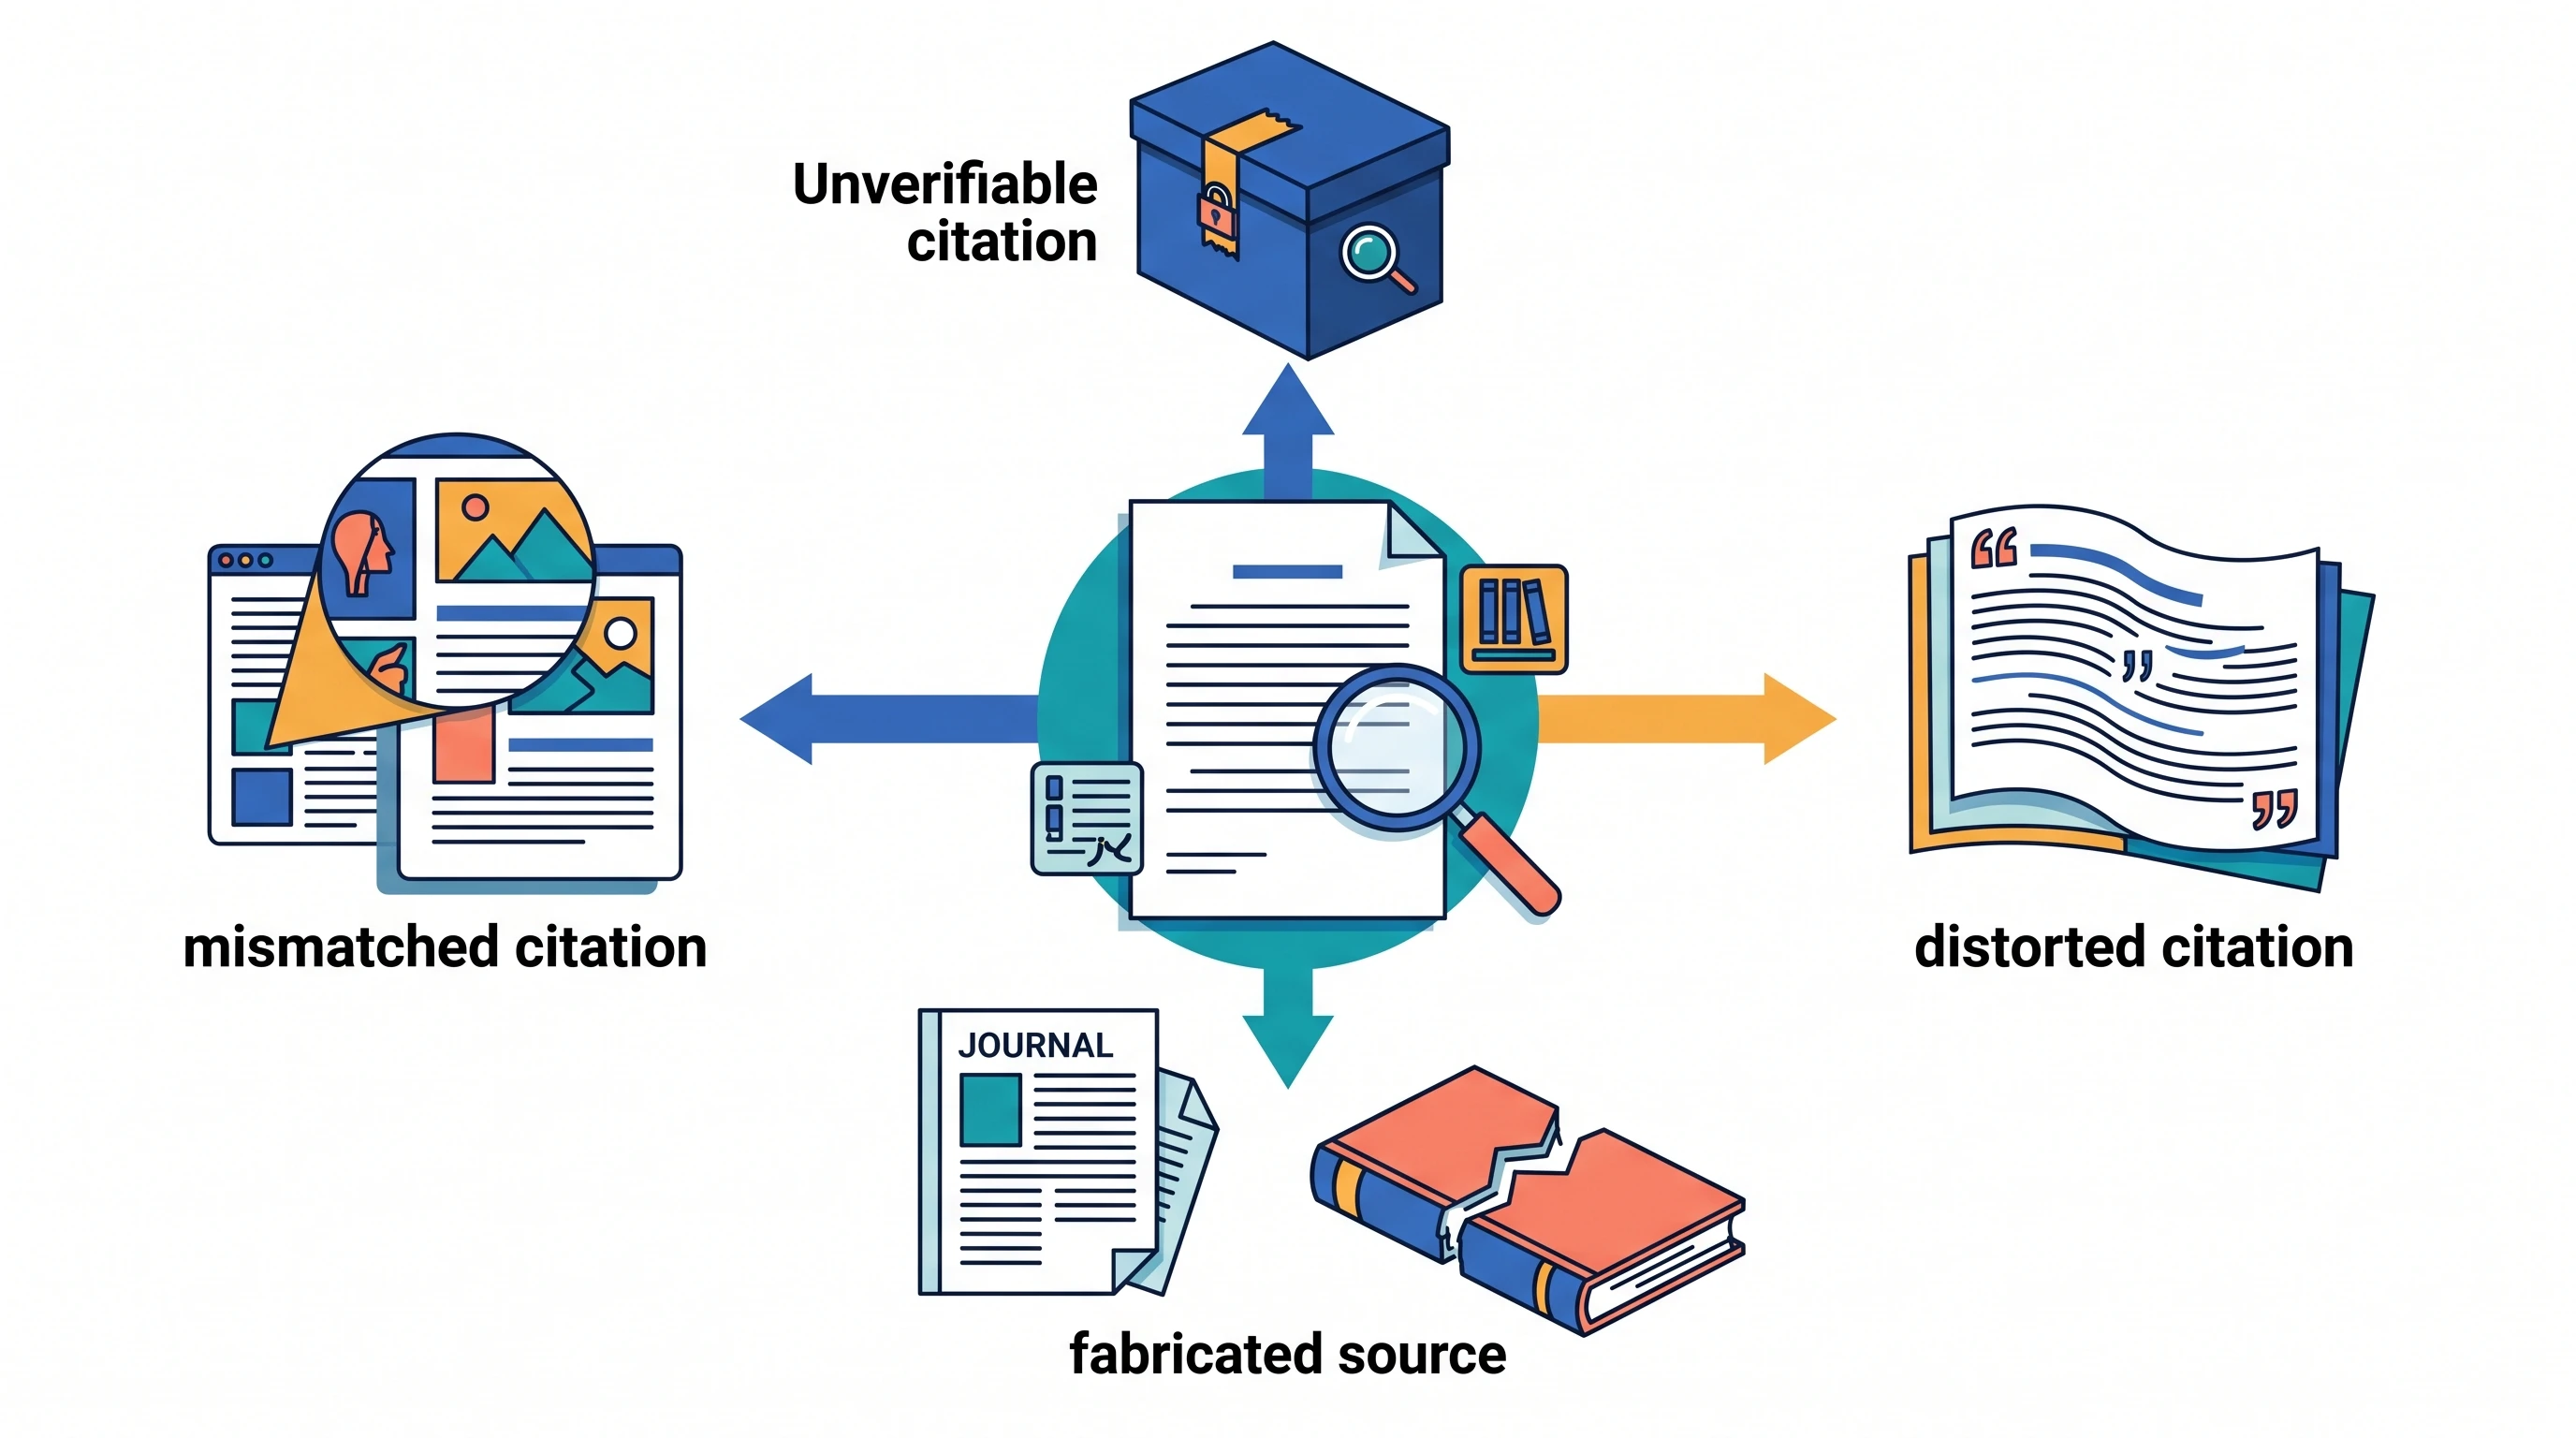
В библиографиях с поддержкой AI регулярно встречаются четыре вида нарушений:
- Выдуманный источник — статьи, набора данных или книги не существует.
- Непроверяемая цитата — элемент может существовать, но невозможно найти доступную запись, DOI или архивную копию.
- Несоответствующая цитата — реальная работа привязана к неверному утверждению, автору или году.
- Искажённая цитата — источник существует и относится к теме, но модель изменила смысл результата на противоположный, опустила оговорку или представила ограничение как вывод.
Практический протокол блокировки занимает около двух минут для каждого ключевого утверждения и значительно меньше, когда становится привычкой:
- Скопируйте ссылку в Crossref, PubMed, Google Scholar или на сайт журнала и подтвердите соответствие названия, автора и года.
- Откройте PDF или HTML и найдите фрагмент. Если вы не можете его найти, удалите цитату.
- Проверьте, сохранены ли оговорки. «Связано с» не означает «вызывает». «У мышей» не означает «у пациентов».
- Отклоняйте любой источник, который модель не может предоставить по запросу. «Я помню статью 2019 года в Nature Neuroscience...» — это не цитата.
- Ведите журнал проверки (электронную таблицу или заметку в менеджере ссылок) для глав диссертации и журнальных материалов.
Academic Research Assistant от Jenova наиболее полезен на шаге 1, когда вы просите его найти статьи-кандидаты и построить карту источников до появления какого-либо текста. Используйте его вместе со Scite, когда нужно узнать, подтверждает или оспаривает последующая литература статью, на которую вы собираетесь опереться. Используйте его вместе с Elicit, когда извлекаете методы и результаты из набора испытаний.
Промпт с высоким уровнем добросовестности выглядит так:
«Найди рецензируемые статьи за 2020–2026 годы по теме [тема]. Для каждой статьи укажи название, авторов, год, DOI, издание и утверждение из 25 слов, которое явно сформулировано в аннотации или результатах. Если ты не можешь проверить DOI, не включай статью. Не выдумывай ссылки.»
Универсальные чат-боты всё ещё иногда не справятся с этим промптом. Разница в том, что рабочий процесс «сначала источник» делает сбой заметным.
Как предотвратить непреднамеренный плагиат при подготовке текста с AI?
Вы предотвращаете непреднамеренный плагиат, рассматривая вывод AI как необработанный материал без лицензии — а не как текст, который принадлежит вам, — и переписывая на основе заметок, а не беглых предложений модели. Непреднамеренный плагиат теперь является наиболее распространённым случаем: пользователь не хотел присваивать чужой текст, но модель настолько близко сжала источник, что программа проверки сходства, экзаменатор или рецензент всё равно сможет обнаружить совпадение формулировок.
COPE требует, чтобы авторы, использующие AI при подготовке текста, рисунков или анализе, раскрывали инструмент и способ его применения, как правило, в разделе «Методы» или аналогичном разделе. Авторы остаются «полностью ответственными за содержание своей рукописи, включая части, созданные инструментом AI». Это предложение отражает всю правовую структуру. Модель не может владеть авторским правом, урегулировать конфликты интересов или отвечать на уведомление об отзыве статьи. Вы можете.
В черновиках с поддержкой AI возникают три пути к плагиату:
- Отражение источника — модель перефразирует статью, которую вы вставили или которую она получила, сохраняя исходный синтаксис.
- Самоплагиат — модель повторно использует ваш ранее опубликованный абзац методов, поскольку вы загрузили его как «контекст».
- Масштабное лоскутное письмо — множество слегка изменённых предложений из множества работ, которые всё равно отмечает программное обеспечение для проверки сходства.
Более безопасная последовательность подготовки текста:
- Самостоятельно прочитайте источник и запишите тезис своими словами с номером страницы.
- Попросите модель реорганизовать ваши тезисы, а не PDF.
- Запустите институциональный инструмент проверки сходства для главы, а не полагайтесь на «оценку оригинальности» чат-бота.
- Раскройте использование AI в форме, указанной вашим журналом или аспирантурой.
Промпт, снижающий риск отражения источника:
«Я вставлю собственные заметки к плану, а не PDF источников. Перестрой их в логичную аргументацию. Не добавляй новые цитаты. Не разворачивай ни один пункт в формулировку, которая может выглядеть как готовое научное предложение. Отмечай каждый пункт, которому всё ещё нужен источник.»
Academic Research Assistant от Jenova помогает в этом случае, когда вы храните текст источников на уровне заметок, а черновик готовите в отдельной ветке. Постоянная память — преимущество для длинных диссертаций, поскольку агент может помнить ваш исследовательский вопрос и исключённые статьи. Однако это также риск, если вы вставляете неопубликованный черновик соавтора в тот же проект. Изоляция — часть оригинальности: не допускайте перетекания одной рукописи в другую.
European Network for Academic Integrity публикует общие рекомендации по академической добросовестности, которые учреждения по-прежнему используют как базовый словарь. Обзор ScienceDirect за 2025 год утверждает, что университеты должны развивать компетенции студентов и формулировать явные политики в отношении AI, а не просто покупать детекторы. Это верный акцент. Детекторы предполагают. Раскрытие использования и журналы источников доказывают.
Как не допустить попадания чувствительных исследовательских данных в публичные AI-системы?
Вы не допускаете попадания чувствительных исследовательских данных в публичные AI-системы, никогда не вставляя идентифицируемые материалы, данные под эмбарго или материалы с договорными ограничениями в инструмент, если вы не можете назвать его условия обучения, хранения и субподрядчиков. IBM определяет конфиденциальность AI как защиту персональной или чувствительной информации, которую системы AI собирают, используют, передают или хранят. Академическая работа наполнена именно такими видами информации: расшифровками интервью, заметками о пациентах, школьными записями, неопубликованными отрицательными результатами и описаниями грантов.
Классические принципы конфиденциальности сталкиваются с наивным использованием AI. Уполномоченный по информации штата Виктория отмечает, что AI ставит под сомнение ограничение сбора, спецификацию цели и ограничение использования — идею о том, что следует собирать только необходимое, объяснять цель и не использовать данные повторно для новой цели. Вставка полного качественного набора данных в публичный чат-бот для «выявления тем» — это новая цель, которую участники не одобряли.
Контрольный список изоляции, выдерживающий этическую экспертизу:
- Минимизируйте — отправляйте код, деидентифицированный фрагмент или словарь переменных, а не исходный файл. Рекомендация по минимизации данных в системах AI — собирать и хранить только то, что требуется для задачи.
- Деидентифицируйте до загрузки — удалите имена, местоположения, редкие диагнозы и метаданные файлов.
- Предпочитайте платформы, прямо заявляющие, что не обучают публичные модели на вашем содержимом — политика платформы Jenova заключается в том, что пользовательские данные не используются для обучения публичных моделей AI и шифруются при передаче и хранении. Читайте условия любого конкурента с таким же уровнем конкретики; фраза «мы серьёзно относимся к конфиденциальности» не является мерой контроля.
- Разделяйте проекты — одна ветка агента на одно исследование, чтобы данные больницы нельзя было вспомнить во время подготовки публичного поста в блоге.
- Проверяйте договоры — исследования, финансируемые индустрией, результаты двойного назначения и соглашения об использовании данных часто полностью запрещают сторонних обработчиков.
Jenova сильнее потребительского чат-бота в этом аспекте благодаря позиции об отсутствии обучения публичных моделей и контролируемой вами памяти проекта. Это не электронная медицинская карта с сертификацией HIPAA, не механизм анонимизации и не замена защищённой среды вашего университета. Если в протоколе IRB указано разрешённое программное обеспечение, этот список имеет приоритет.
Для интервью-исследований безопасный промпт выглядит так:
«Вот шесть деидентифицированных фрагментов, из которых уже удалены имена и места. Предложи только тематические коды. Не пытайся угадать личности. Не храни эти фрагменты после этой задачи, если позднее я попрошу тебя их забыть.»
Если вы не можете написать такой промпт, потому что текст всё ещё позволяет идентифицировать людей, вы ещё не готовы использовать AI для работы с ним.
Как построить безопасный с точки зрения добросовестности рабочий процесс AI-исследования?
Безопасный рабочий процесс начинается с исследовательского вопроса и библиотеки источников, использует AI только на обозначенных этапах и заканчивается абзацем о раскрытии использования и журналом проверки. Приведённая ниже последовательность работает в Academic Research Assistant от Jenova и может быть воспроизведена, с разными сильными сторонами, в Elicit или Scite.
Этап 1 — Определите рамки без источников. Попросите агента перечислить конкурирующие определения, вероятные базы данных и правила исключения. Пока не принимайте ни одной цитаты.
«Я пишу главу методов по вопросу [вопрос]. Перечисли подвопросы, которые должен охватывать систематический поиск. Не цитируй статьи. Отметь, где мой вопрос слишком широк.»
Этап 2 — Найдите, затем зафиксируйте библиотеку. Используйте Academic Research Assistant (или Elicit, если вы проводите скрининг сотен испытаний), чтобы собрать записи-кандидаты с DOI. Экспортируйте их в Zotero, EndNote или институциональный менеджер ссылок. Системой учёта становится менеджер ссылок, а не расшифровка чата.
Связанный Deep Research агент Jenova полезен, когда вам нужен широкий, насыщенный цитатами обзор перед сужением корпуса. Рассматривайте такой обзор как карту, а не как литературу, которую вы прочитали.
Этап 3 — Извлекайте данные в таблицу, а не в абзац. Запрашивайте дизайн исследования, выборку, результат и ограничение в столбцах. Elicit создан специально для этого; Jenova может подготовить такую же таблицу, если вы предоставите ему статьи, которые уже открыли.
Этап 4 — Пишите на основе собственных заметок. Пишите или диктуйте тезисы. Позвольте агенту составить план и проверить логику на прочность. Не позволяйте ему «сглаживать» язык, пока источники не зафиксированы.
Этап 5 — Проверьте и раскройте использование. Разрешите каждый DOI. Прочитайте каждый фрагмент, на который ссылаетесь. Добавьте в методы фразу, например: «Большая языковая модель (название модели, дата) использовалась для организации заметок и предложения поисковых терминов; все цитаты были проверены автором по первичным источникам».
Настройка Jenova занимает несколько минут: откройте Academic Research Assistant, укажите свою область и ограничения добросовестности в первом сообщении и прикрепляйте только те файлы, которые вам разрешено обрабатывать. Бесплатный тариф предусматривает ограниченное использование; Plus начинается от $20 в месяц с лимитом, в 30 раз превышающим бесплатный. Использование представляет собой месячный пул, а не дневной лимит, что важно во время интенсивной доработки.
Для Elicit параллельный путь выглядит так: сформулируйте вопрос обзора, создайте таблицу доказательств, настройте, какие статьи входят в отчёт, затем экспортируйте и проверьте. Для Scite параллельный путь таков: добавьте ключевые статьи и изучите подтверждающие и оспаривающие цитаты, прежде чем заявлять о консенсусе.
Непременное правило рабочего процесса — порядок. Поиск до предложений. Фрагменты до перефразирования. Раскрытие использования до подачи.
Что эксперты по исследовательской добросовестности говорят об академической работе с поддержкой AI?
Специалисты по исследовательской добросовестности всё чаще рассматривают галлюцинированные цитаты, нераскрытое составление текста с помощью AI и неконтролируемые загрузки данных как сбои процесса, от которых учреждения могут защититься на уровне проектирования, а не как редкие случаи студенческого мошенничества.
«Ошибка, которую мы наблюдаем, заключается не в том, что исследователи используют модели. Она в том, что они применяют цикл “сначала генерация, затем цитирование” для задач, где сама цитата является данными. Если ваш раздел результатов зависит от существования статьи, то беглая фальшивая ссылка ближе к фальсификации данных, чем к небрежному форматированию. Решение архитектурное: получить запись, извлечь утверждение, затем писать. Инструменты, которые меняют этот порядок на обратный, будут и дальше засевать литературу призраками».
«Провалы конфиденциальности происходят из-за того же переворота порядка. Люди вставляют самый полный файл, который у них есть, потому что это удобно, а это прямо противоположно ограничению сбора. Сначала деидентифицируйте, затем минимизируйте и выберите систему, которая не будет обучать публичные модели на остаточных данных. Удобство не освобождает от этических обязанностей».
«Мы также советуем лабораториям перестать перекладывать обеспечение добросовестности на AI-детекторы. Детекторы не могут показать источник, не могут доказать намерение и создают ложноположительные результаты, наказывающие авторов, для которых язык не является родным. Журнал проверки и раскрытие использования в стиле COPE требуют больше времени в первый день, но значительно ускоряют работу, когда рецензент спрашивает: “Откуда взялась эта ссылка?”»
— Команда продукта Jenova, исследования академических рабочих процессов AI, восемь лет проектирования исследовательских агентов с учётом цитирования
Эта позиция согласуется с формальными рекомендациями. COPE возлагает ответственность на авторов-людей. Cornell просит преподавателей требовать проверки цитат и собирать объективные доказательства — несуществующие ссылки, методы, которые студент не может объяснить, — а не опираться на оценку детектора. Рассмотрение Cambridge академической добросовестности в эпоху AI исходит из той же предпосылки: если оценивание больше не отражает обучение, жертвой становится сама ценность квалификации.
Что происходит, когда использование AI пересекает институциональные пороги добросовестности?
Когда использование AI пересекает институциональные пороги, санкции применяются к автору-человеку и всё чаще к научным руководителям — от обязательной доработки до приостановки подачи или отмены регистрации. Политики различаются по странам и университетам, но направление развития в 2026 году — более жёсткие диапазоны сходства, явная проверка использования AI и меньше терпимости к объяснению «модель это выдумала».
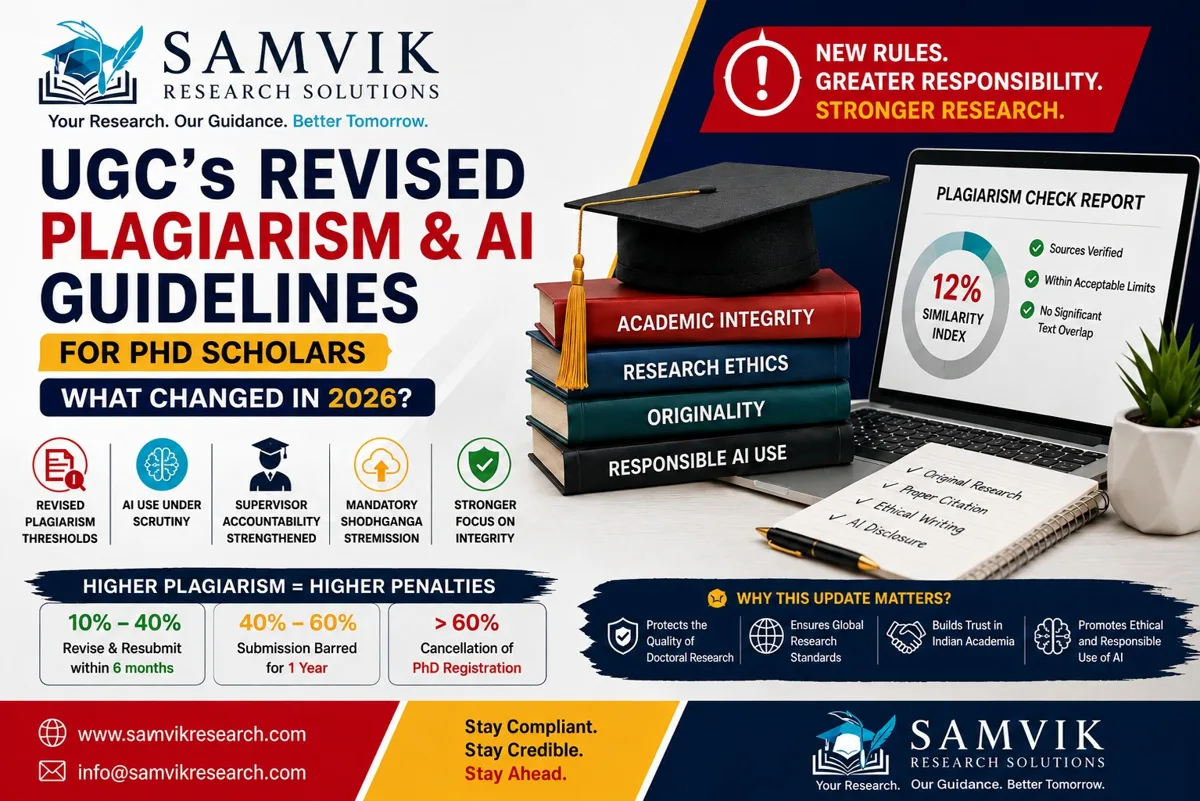
Рекомендации, распространённые среди аспирантов PhD в 2026 году в связи с пересмотром правил University Grants Commission (UGC), показывают, как числовые пороги становятся карьерными последствиями. В этой системе сходство от 10% до 40% требует доработки и повторной подачи в течение шести месяцев; от 40% до 60% может запретить подачу на год; а сходство выше 60% может привести к отмене регистрации PhD. Эти же рекомендации сочетают такие диапазоны с более тщательной проверкой использования AI, более высокой ответственностью научных руководителей и обязательным размещением в репозитории. Даже если ваш университет применяет иные пороговые значения, логика переносима: совпадение рассматривается как измеримый сигнал добросовестности, а «AI помог» не является защитой, если текст не ваш или ссылки не реальны.
Журналы добавляют второй уровень контроля. Позиция COPE по авторству означает, что вы не можете указать ChatGPT, Elicit, Scite или Jenova в качестве соавтора. Вы можете — и часто обязаны — назвать инструмент в разделе «Методы». Нераскрытие использования всё чаще расценивается как нарушение прозрачности, даже если научная работа корректна. Выдуманные ссылки, напротив, могут оправдать отклонение или отзыв публикации, поскольку они фальсифицируют научную запись.
Практические последствия для каждого, кто подаёт работу в 2026 году:
- Узнайте местный диапазон допустимого сходства до начала написания, а не после запуска проверки.
- Сохраняйте промпты и версии моделей, чтобы вы могли восстановить вклад инструмента.
- Не считайте низкий показатель AI-детектора разрешением. Считайте разрешением полную библиографию, в которой можно проверить каждую ссылку.
- Если вы руководите студентами, проверяйте их журналы источников. Ответственность перемещается вверх по цепочке.
При использовании в этих рамках AI остаётся законным ускорителем для поиска, извлечения и организации. При использовании как невидимого соавтора с выдуманным списком литературы он становится одним из самых быстрых способов остановить получение степени или публикацию статьи.
Источники
- Nature — Галлюцинированные цитаты загрязняют научную литературу
- Enago — Ссылки, сгенерированные AI: 1 из 5 является фальшивой
- STAT — Мошеннические цитаты, связываемые с галлюцинациями AI, распространяются в академических статьях
- Today’s Clinical Lab — Фальшивые ссылки, созданные AI, всё чаще встречаются в биомедицинской литературе
- Accountability in Research (Taylor & Francis) — Галлюцинированные цитаты, созданные генеративным искусственным интеллектом
- PubMed Central — Выдуманные цитаты в эпоху AI: тревожный сигнал для редакторов
- Cornell University Center for Teaching Innovation — AI и академическая добросовестность
- COPE — Авторство и инструменты AI
- Elicit — AI для научных исследований (размер корпуса, цитаты на уровне предложений, рабочий процесс систематического обзора)
- Scite — Ответы с подтверждением цитатами по более чем 300 миллионам научных статей
- Paperguide — Сравнение Elicit и Scite для исследователей (2026)
- The Drive AI — Elicit, Consensus и Semantic Scholar: сравнение
- Библиотеки George Mason University — AI-инструменты для обзоров литературы
- IBM — Изучение вопросов конфиденциальности в эпоху AI
- Office of the Victorian Information Commissioner — Искусственный интеллект и конфиденциальность: проблемы и вызовы
- Fortra — Конфиденциальность данных AI: вызовы и решения
- European Network for Academic Integrity — Общие рекомендации по академической добросовестности
- ScienceDirect — Переоценка академической добросовестности в эпоху AI
- Cambridge University Press — Академическая добросовестность в эпоху AI