Как не дать AI забыть контекст исследования, длящегося месяцами?
2026-08-21
Какие архитектуры памяти сохраняют стратегии поиска в течение полного цикла обзора?
Чат-боты, привязанные к одной сессии, теряют поисковые строки, критерии включения и извлечённые результаты сразу после завершения разговора — поэтому обзоры, длящиеся месяцами, останавливаются. Инструменты, рассматривающие протокол как устойчивое состояние, — Jenova's Academic Research Assistant с постоянной памятью между сессиями, Elicit с рабочими пространствами для систематических обзоров на уровне проекта и привязанные к источникам блокноты, такие как Gemini Notebook, — сохраняют работоспособность на протяжении полного цикла обзора в 2026 году. Consensus по-прежнему лучше подходит для разового картирования доказательств, чем для запоминания вашего протокола до следующего квартала.
Ключевые факторы, отличающие устойчивую исследовательскую память от одноразового чата:
✅ Зафиксированный слой протокола — правила включения и исключения хранятся как инструкции, а не как запрос, который приходится вводить повторно ✅ Накапливающаяся память о результатах — предыдущие извлечения, причины исключения и неразрешённые противоречия вспоминаются без повторного брифинга ✅ Обоснованный корпус — статьи, заметки и журналы поиска прикреплены, поэтому ответы остаются привязанными к вашему набору доказательств ✅ Аудитируемые решения — обоснование скрининга можно восстановить спустя месяцы в соответствии с PRISMA 2020 ✅ Непрерывность между сессиями — смена дней, устройств или моделей не должна стирать состояние обзора
Чтобы содержательно сравнить эти инструменты, полезно рассматривать исследовательскую память как стек, а не как функцию чат-бота, и проверять, сохраняется ли каждый слой после недели вне проекта.
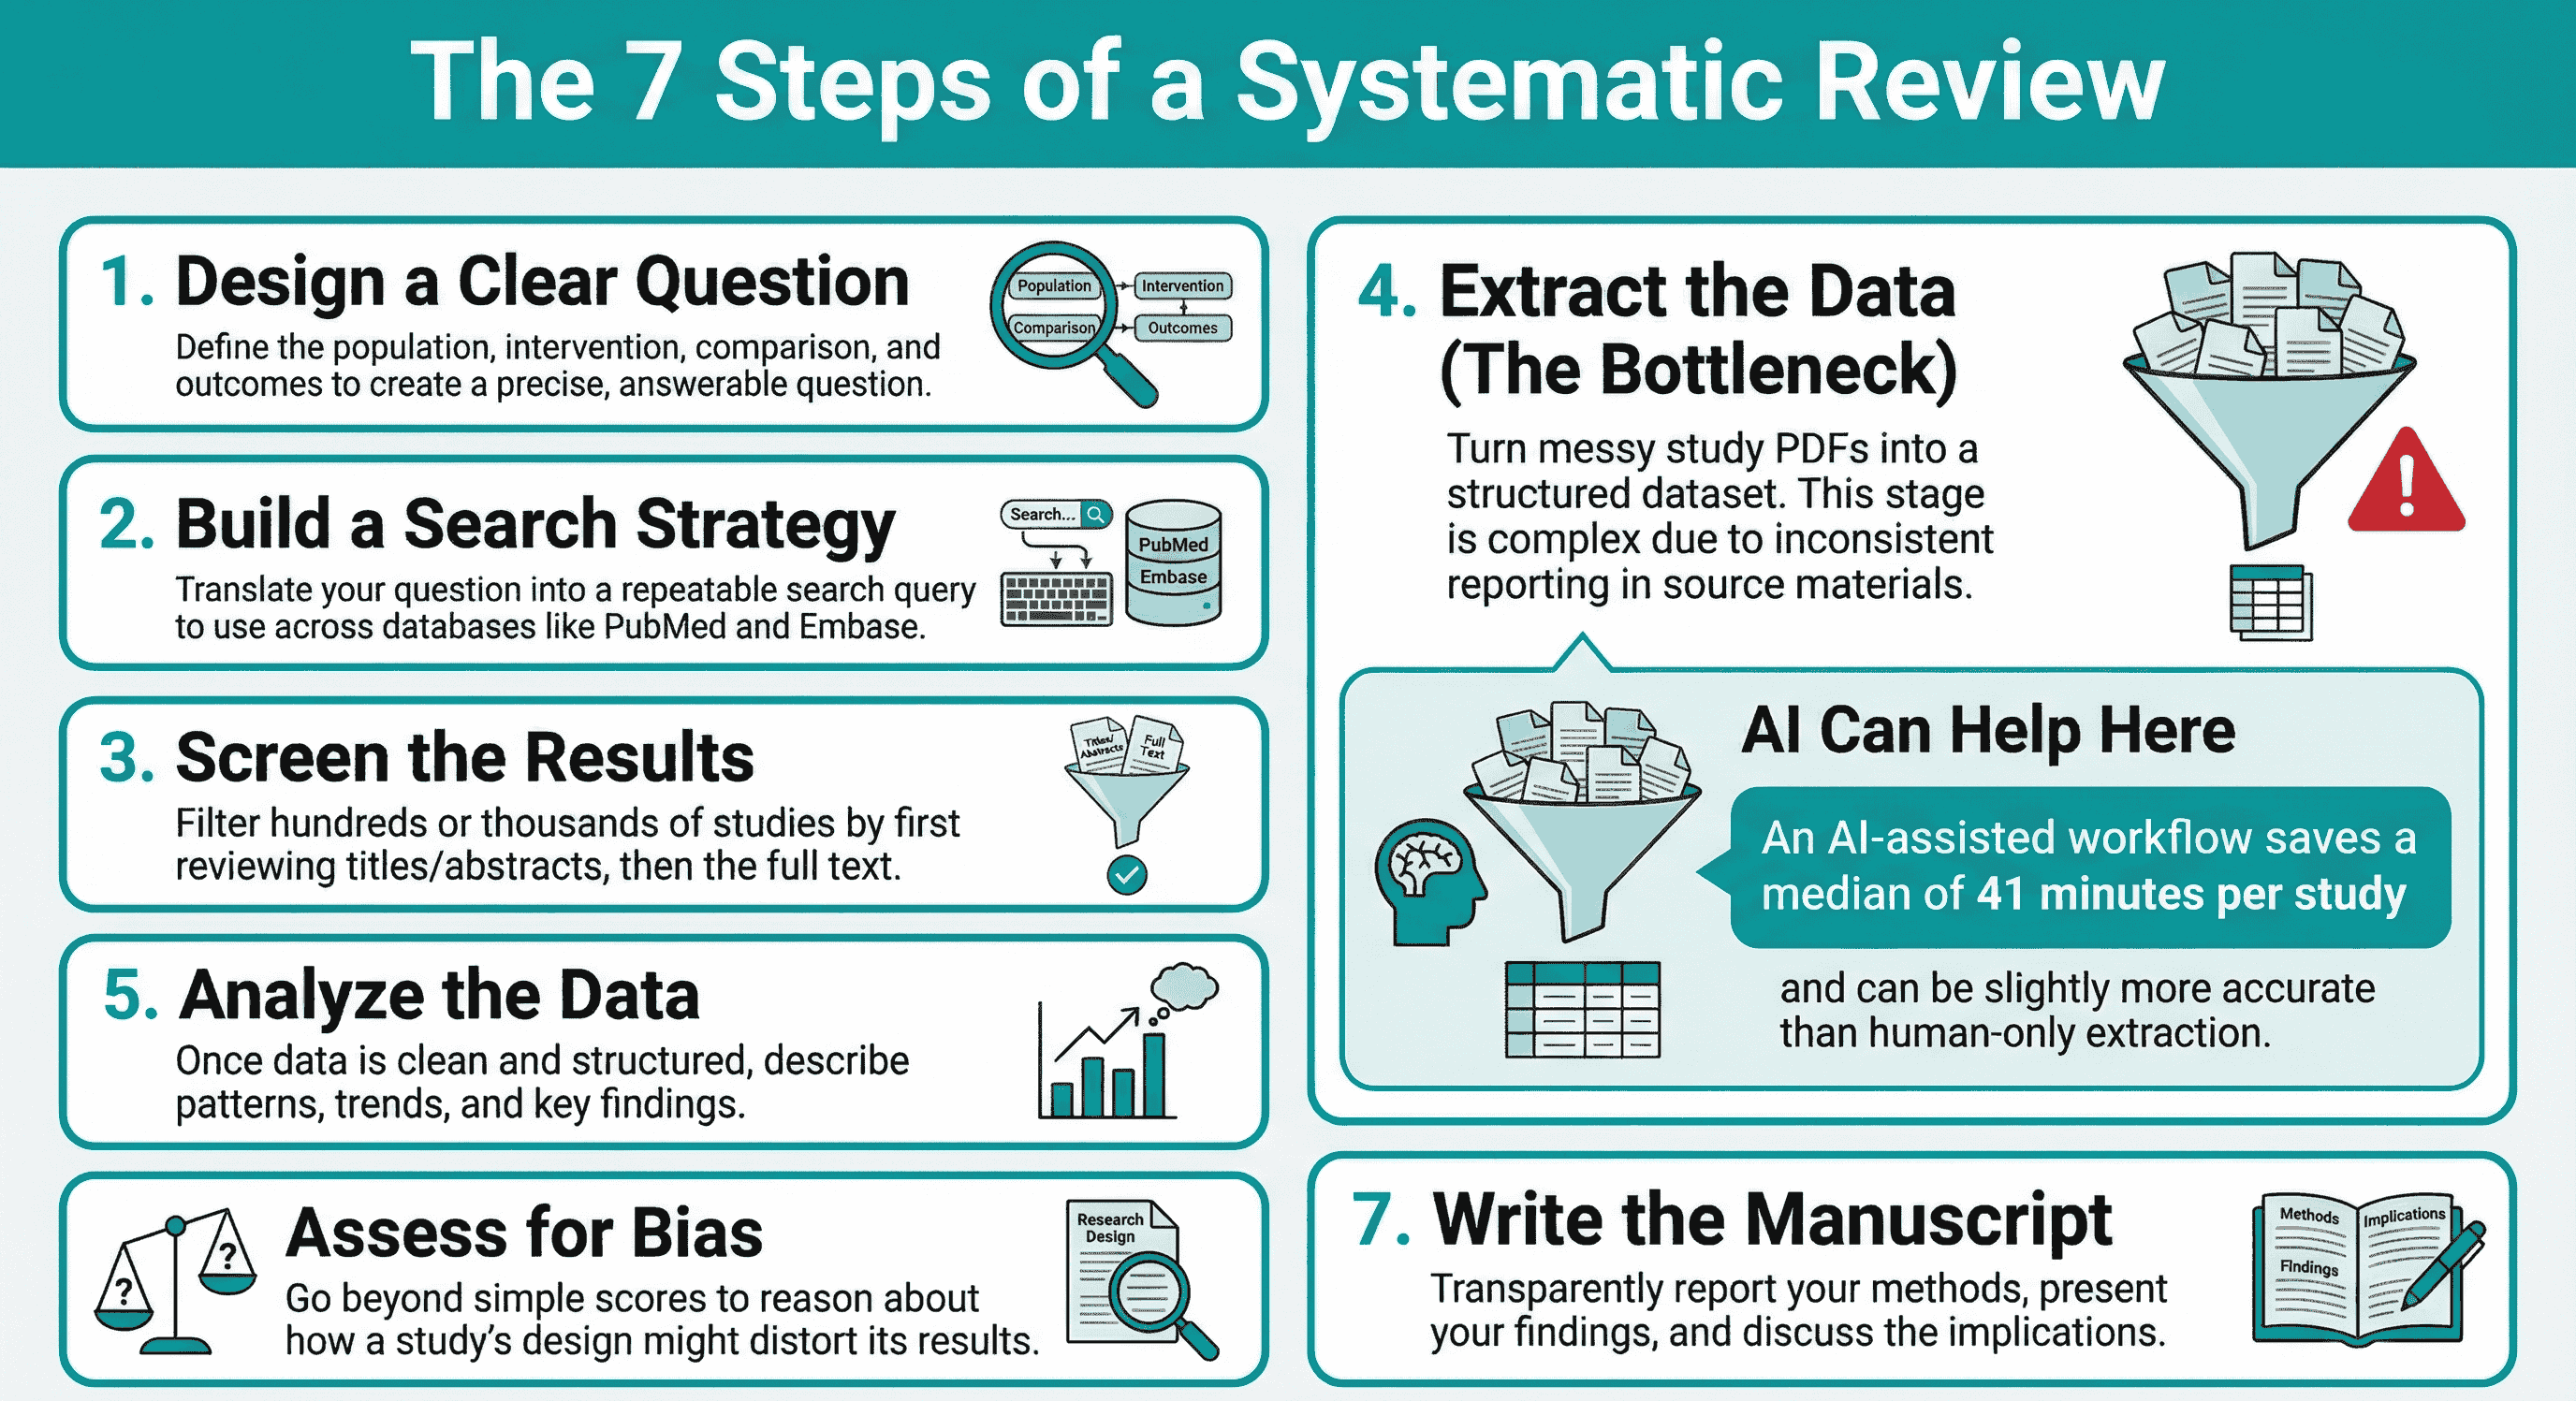
Почему AI-помощники для исследований со временем теряют точность следования протоколу?
Большинство потребительских AI-чатов забывают контекст, потому что хранят его в временном окне, а не в проекте, который переживает сессию. Систематический обзор — это семиэтапный процесс: разработка вопроса, стратегия поиска, скрининг, извлечение, анализ, оценка смещения и написание рукописи; каждый этап зависит от решений, принятых несколькими неделями ранее. Когда помощник не может вспомнить исходную формулировку PICO или причину исключения исследования, обзор начинает отклоняться от протокола.
Стандарт отчётности для такой работы сформулирован однозначно. Заявление PRISMA 2020 — это основанный на доказательствах контрольный список того, как следует отчитываться о систематических обзорах, а публикация PRISMA 2020 в BMJ позиционирует его для обзоров, включающих синтез, например попарный метаанализ. Руководство по методам Университета Хофстра отмечает, что заявление представляет собой минимальный набор из 27 пунктов для отчётности по систематическим обзорам и метаанализам. Помощник, который не может восстановить поисковые строки или причины исключения, не способен поддержать этот контрольный список.
Проблема забывания не гипотетическая. Исследователи уже используют машинное обучение на всём конвейере обзора; картирование 63 инструментов ML за 2022 год охватывало задачи от поиска литературы до извлечения данных. Однако такие инструменты редко решают сами по себе проблему долгосрочной точности: одно и то же правило включения должно применяться одинаково в четвёртый месяц работы и в первый.
Помощники в формате чата усугубляют это тремя конкретными способами:
- Испарение протокола. Булевы строки, охват баз данных (PubMed, Embase) и ограничения по датам живут в запросе, который не сохранён как самостоятельный объект.
- Дрейф критериев. Неформальные пересказы правил включения постепенно меняют определения популяции, вмешательства или исходов.
- Амнезия результатов. Извлечённые размеры эффектов, противоречивые результаты и заметки «вернуться к этой статье» исчезают вместе с веткой диалога.
Руководство King's College London по синтезу доказательств отражает текущий консенсус: AI может помогать на разных этапах обзора, но не заменяет методологический контроль. Память и есть этот контроль, растянутый во времени.
На что обращать внимание в AI-инструменте, который помнит исследовательский контекст?
Оценивайте AI для долгосрочных исследований по сохранности протокола, непрерывности результатов, привязке к источникам, аудируемости, охвату корпуса и стоимости поддержания этого состояния, а не по тому, насколько беглым кажется один чат. Инструмент, который пишет элегантные резюме, но не может извлечь журнал исключений за прошлый месяц, отнимет больше часов, чем сэкономит.
В этой статье используется четырёхслойная модель — Стек непрерывности исследования — чтобы сделать такую оценку конкретной:
- Зафиксированный протокол. Стратегии поиска и критерии включения/исключения хранятся за пределами буфера чата: в пользовательских инструкциях, документе протокола или конфигурации скрининга.
- Накапливающаяся память. Предыдущие результаты, открытые вопросы и разногласия рецензентов растут между сессиями, а не сбрасываются.
- Обоснованный корпус. Фактические статьи, PDF, заметки и выгрузки поиска, которые помощнику разрешено использовать.
- Аудит решений. Восстанавливаемые причины включения/исключения, в идеале с цитатами, чтобы позднее второй рецензент мог подготовить диаграмму потока PRISMA.
Проверка по этому стеку меняет вопрос о выборе инструмента. Elicit создан так, чтобы критерии скрининга, причины исключения и оценки по отдельным критериям были аудитируемы по PRISMA, что особенно сильно на слоях 1 и 4. Gemini Notebook создан так, чтобы ответы цитировали точные фрагменты из загруженных источников, что особенно сильно на слое 3. Consensus создан для поиска по более чем 250 миллионам научных статей и демонстрации того, где доказательства сходятся, что сильно для поиска и слабо для запоминания вашего протокола. Jenova's Academic Research Assistant построен вокруг неограниченной истории чатов, постоянной памяти между сессиями и подключаемых баз знаний, что сильно на слоях 1–3 для многомесячной программы работы и слабее в отношении встроенных диаграмм PRISMA.
Взвешивайте слои по типу проекта. Для систематического обзора в стиле Cochrane следует повысить вес аудируемости. Для литературного обзора диссертации, охватывающего два семестра, — вес накапливающейся памяти. Для лаборатории, повторно использующей одни и те же статьи в разных проектах, — вес обоснованного и повторно используемого корпуса.
Как Jenova, Elicit, Consensus и Gemini Notebook работают с долгосрочной исследовательской памятью?
Jenova наиболее сильна, когда исследовательская программа строится как диалог, развивается итеративно и измеряется месяцами; Elicit — когда единицей работы является формальный систематический обзор; Consensus — для быстрого картирования доказательств; Gemini Notebook — когда корпус уже собран. Ни один из этих четырёх инструментов не является универсально предпочтительным, поскольку они оптимизируют разные слои Стека непрерывности исследования.
| Функция / измерение | Elicit | Jenova Academic Research Assistant | Consensus | Gemini Notebook |
|---|---|---|---|---|
| Сохранность протокола | Рабочее пространство проекта; обновления живого обзора | Неограниченная история, постоянная память, пользовательские инструкции | Фильтры на уровне запроса; не сохранённый протокол | Инструкции и источники в рамках блокнота |
| Критерии включения | Автопредлагаемые критерии; двойная проверка; причины исключения | Закодированы в инструкциях и вспоминаются между сессиями | Фильтры на естественном языке, применяемые к каждому поиску | Определяются пользователем внутри ограниченного блокнота |
| Вспоминание предыдущих результатов | Повторно используемые извлечённые таблицы и отчёты | Память между сессиями о заметках, противоречиях и решениях | Синтез на уровне запроса, а не продольный журнал | Привязка к тому, что вы загрузили |
| Корпус / источники | 138 миллионов статей, PubMed, ClinicalTrials.gov, загрузки | Пользовательские загрузки, базы знаний, инструменты поиска в реальном времени | 250 млн+ статей, лицензированные полные тексты | Загруженные PDF, документы, сайты, аудио, видео |
| Аудируемость | Поток PRISMA, цитаты, оценки по критериям | Диалоговый след; нет встроенной диаграммы PRISMA | Академические цитаты и Consensus Meter | Цитаты на уровне фрагментов из источников |
| Цены (по состоянию на 2026 год) | Платная подписка, включая документированный тариф Pro | Бесплатный тариф; платные планы от $20 в месяц | Платная подписка | Бесплатно для частных пользователей; данные организаций не используются для обучения |
| Лучше всего подходит для | Формальных систематических обзоров и живых обновлений | Многомесячных исследовательских программ, которые не должны забывать | Быстрых снимков доказательств и поиска в медицинском режиме | Синтеза закрытого корпуса и обучения на источниках |
Elicit
Elicit — специализированный научный исследовательский помощник, используемый для поиска, резюмирования, извлечения данных и общения с более чем 125 миллионами статей, а его продукт для систематических обзоров индексирует 138 миллионов статей с еженедельными обновлениями. Он может проводить скрининг до 40 000 статей, автоматически предлагать критерии скрининга и сохранять каждое решение аудируемым по PRISMA благодаря причинам исключения и подтверждающим цитатам.
Его ограничение для многомесячной программы смешанных исследований — специализация. Elicit превосходно справляется со структурированными операциями обзора; он в меньшей степени разработан как универсальный исследовательский партнёр, который помнит сопутствующие гипотезы, обратную связь научного руководителя и развивающиеся заметки за пределами объекта обзора.
Jenova Academic Research Assistant
Academic Research Assistant — академический исследовательский партнёр для поиска литературы, подготовки рукописей и управления цитированием, работающий на платформе с неограниченной историей чатов и постоянной памятью между сессиями. Стратегии поиска и критерии включения можно зафиксировать в пользовательских инструкциях агента; PDF, протоколы и журналы скрининга можно прикрепить как приватную базу знаний, чтобы последующие сессии начинались с того же набора доказательств.
Его честное ограничение противоположно ограничению Elicit. В нём нет встроенной диаграммы потока PRISMA, интерфейса двойного рецензирования для скрининга или специализированного корпуса из 138 миллионов статей для систематических обзоров. Командам, которым нужны аудиторские следы уровня Cochrane, всё равно придётся экспортировать решения в менеджер обзоров. Связанную работу, для которой нужен однопроходный отчёт с большим количеством цитат, можно поручить Deep Research, который синтезирует сотни источников с встроенными цитатами, а затем сохранить результаты в той же длительно ведущейся ветке, чтобы они не стали ещё одним документом-сиротой.
Consensus
Consensus — академическая поисковая система на основе AI, использующая более 250 миллионов статей, включая лицензированные полные тексты. Она сообщает об использовании 10 миллионами исследователей, студентов и клиницистов, а также о партнёрстве с более чем 170 университетскими библиотеками. Deep Search расширяет термины и проходит по графу цитирования; медицинский режим сужает поиск примерно до 50 000 клинических рекомендаций и 8 миллионов статей из ведущих 1 000 медицинских журналов. Consensus Meter визуализирует степень согласованности доказательств по вопросу, предполагающему ответ «да» или «нет».
Сравнение Paperguide за 2026 год задаёт верную рамку: Consensus находит и оценивает доказательства; Gemini Notebook преобразует источники, которые у вас уже есть. Возможности Consensus как системы памяти ограничены. Он не хранит ваши критерии включения как живой протокол, поэтому проект, продолжающийся семестр, всё равно нуждается во внешнем месте для записи «что мы решили в марте».
Gemini Notebook
Gemini Notebook — продукт, ранее называвшийся NotebookLM и переименованный в июле 2026 года, — это партнёр для мышления, привязанный к источникам. Вы загружаете PDF, сайты, видео YouTube, аудио, Google Docs и презентации; ответы содержат цитаты с точными фрагментами. Данные организаций не используются для обучения продукта.
Граница этого инструмента — сам блокнот. Он не забудет источники, которые вы ему передали, именно поэтому он подходит для определённого набора материалов для чтения, однако не обнаружит статью, которую вы никогда не загружали. Для многомесячного обзора, в котором поиск ещё продолжается, это структурное ограничение, а не проблема настроек.
Как сохранять стратегии поиска и критерии включения между сессиями?
Сохраняйте их, записывая как устойчивые объекты — документ протокола, пользовательские инструкции или конфигурацию скрининга, — и не оставляйте единственный экземпляр внутри одноразового запроса. Если стратегия существует только во вчерашнем чате, она не существует.
Практический шаблон выглядит так:
- Зафиксируйте вопрос в форме PICO. Популяцию, вмешательство, сравнение и исходы следует дословно копировать в постоянные инструкции помощника, а не перефразировать каждый понедельник.
- Храните поиск как воспроизводимый артефакт. Названия баз данных, булевы строки, ограничения по датам и языкам, а также источники серой литературы должны находиться в документе, который помощник может перечитать.
- Отделяйте включение от впечатления. Критерии вроде «RCT, взрослые, 2015–2026, полный текст на английском» должны быть перечислены как правила. Предпочтения вроде «кажется релевантным нашей теории» должны помечаться как гипотезы, чтобы они не могли незаметно переписать протокол.
- Ведите журнал исключений с причинами. PRISMA требует прозрачной отчётности о процессе отбора; в обзоре методов DistillerSR подчёркивается, что PRISMA существует, чтобы помогать авторам избегать ошибок, подрывающих обзоры.
Для Jenova этап фиксации протокола — это блок пользовательских инструкций плюс прикреплённый PDF протокола. Постоянный запрос, который сохранится на месяцы, выглядит так:
Ты мой партнёр по систематическому обзору для проекта HEP-24. Популяция: взрослые 18+ с NAFLD. Вмешательство: агонисты рецептора GLP-1. Сравнение: стандартная помощь или плацебо. Первичные исходы: MRI-PDFF и NAS. Включай RCT и проспективные когорты, 2018–2026 годы, полный текст на английском. Исключай исследования на животных, тезисы конференций без данных и исследования длительностью менее 8 недель. Всегда повторяй правила включения перед скринингом нового набора и никогда молча не расширяй популяцию.
Для Elicit аналогом является уточнение протокола обзора внутри продукта с последующим использованием автоматически предложенных критериев скрининга, которые вы принимаете, редактируете или заменяете. К каждому решению можно добавить причину исключения и подтверждающую цитату, что ближе к аудиторскому файлу PRISMA, чем журнал чата.
Для Gemini Notebook вставьте тот же блок PICO в инструкции блокнота и загрузите протокол вместе с выгрузкой поиска. Помощник будет соблюдать эти файлы и не станет придумывать статьи за их пределами.
Режим сбоя, за которым нужно следить, — «полезное расширение». Через шесть недель модели часто начинают включать смежные популяции, поскольку они звучат релевантно. Зафиксированный протокол, который помощник обязан повторять в начале каждой сессии, — самый дешёвый контроль, который вы можете добавить.
Как постоянная память меняет извлечение данных и оценку смещения?
Постоянная память превращает извлечение из разовой задачи переписывания в накапливаемый набор данных — именно здесь теряется большая часть времени и где помощь AI теперь можно эмпирически проверить. Схема семиэтапного обзора выделяет извлечение как узкое место, потому что исходные PDF непоследовательно сообщают об исходах; помощник, не помнящий таблицу извлечения, будет каждую неделю возвращать этот беспорядок.
Доказательства за 2026 год точнее маркетинговых заявлений. Исследование внутри обзора на medRxiv сравнило извлечение с помощью Elicit с извлечением только людьми в 50 RCT по хроническим заболеваниям и не выявило различий в общей точности (средняя разница 0,57 по шкале от 0 до 100), при этом извлечение с помощью AI было быстрее на 24,82 минуты и стоило на $181,98 меньше для всех 50 исследований. Типы и тяжесть ошибок были сходными. Собственная валидация Elicit сообщает, что VDI/VDE корректно извлекла 1 502 из 1 511 точек данных (99,4%), а исследователи CSIRO обнаружили почти нулевой уровень ложноотрицательных результатов по сравнению с ручным извлечением.
Отдельное направление работ рассматривает AI как второго рецензента, а не замену человеку. В статье Cochrane Evidence Synthesis and Methods сообщается, что инструменты AI показали высокую и сходную с рецензентами-людьми эффективность извлечения данных, особенно для стандартизированных переменных. Методологическая заметка Birmingham City University осторожнее: генеративные инструменты хорошо справляются с годом, страной и числом участников, но это не то же самое, что извлечение нюансированных исходов по группам испытания.
Помимо базовой точности извлечения, память обеспечивает согласованность таблицы:
- Одни и те же названия исходов, временные точки и единицы измерения используются на 12-й неделе так же, как на 2-й.
- Уже отмеченные расхождения («в одной статье указаны два размера выборки») не обнаруживаются заново как новые.
- Оценка смещения может рассуждать о дизайне, а не только об оценке. Работа с риском смещения касается того, как рандомизация, ослепление и отсутствующие данные могут исказить результаты, — а для этого нужно помнить заметки о дизайне исследования, а не только аннотацию.
Ограничение Jenova здесь заключается в интерфейсе, а не в намерении. Постоянная память вспомнит, что вы считаете сокрытие распределения критически важной областью, но не заполнит автоматически таблицу Cochrane RoB 2. Ограничение Elicit противоположно: извлечение может быть высокоструктурированным и подтверждённым цитатами, тогда как неформальные рассуждения о смещении, возникающие на встрече с научным руководителем, всё ещё нуждаются в месте для хранения. Командам, выполняющим обе задачи, стоит извлекать данные в структурированном инструменте, а комментарии на уровне дизайна хранить в длительно работающем исследовательском агенте.
Как настроить AI-процесс исследования, рассчитанный на месяцы?
Настройте его, создав один устойчивый дом для проекта, загрузив протокол до первого поиска и проводя каждую последующую сессию как обновление этого дома, а не как новый чат. Логика процесса одинакова независимо от того, используете ли вы агент с нативной памятью или рабочее пространство для систематического обзора; различаются только кнопки.
Настройка Jenova (менее двух минут, затем постоянная работа)
- Откройте Academic Research Assistant и, если проект долгосрочный, сохраните протокол как пользовательские инструкции в выделенном агенте.
- Прикрепите протокол, поисковые строки и существующую таблицу скрининга как базу знаний.
- Начинайте со сводки состояния, а не с расплывчатого «продолжить»:
Повтори наш PICO, просмотренные базы данных, дату последнего поиска, число включённых/исключённых исследований и три неразрешённых противоречия из прошлой сессии. Затем проведи скрининг следующих 25 названий по зафиксированным критериям. Не расширяй критерии включения.
- Завершайте каждую сессию письменной передачей, которую сможет загрузить следующая сессия: обновления поиска, новые исключения с причинами, всё ещё отсутствующие поля извлечения и вопросы для второго рецензента.
Платные планы Jenova начинаются от $20 в месяц и дают лимит использования в 30 раз выше бесплатного; более высокие уровни стоят $50, $100, $200, $500 и $1 000 в месяц. Использование сбрасывается ежемесячно в дату выставления счёта. Такая цена важна для многомесячной работы, потому что обзор, который прекращается при достижении лимита бесплатного тарифа в середине скрининга, — это сбой памяти иного рода.
Настройка Elicit
Поток систематического обзора Elicit выглядит так: уточнить протокол, объединить поиск в PubMed, ClinicalTrials.gov и его корпусе статей либо импортировать результаты из других баз данных, провести скрининг с двойной проверкой при поддержке AI, извлечь данные в поля с подтверждающими цитатами, а затем синтезировать отчёты, которые могут включать диаграммы потока PRISMA, таблицы резюме статей и стратегии поиска. Живые обзоры — функция для работы в течение месяцев: объедините обзор с оповещениями, чтобы один и тот же протокол принимал новые статьи без создания нового проекта.
Настройка Gemini Notebook
Создайте один блокнот на каждый обзор. Загрузите протокол, выгрузку поиска и PDF. Задавайте только вопросы, на которые можно ответить по этим файлам. Когда новые статьи пройдут скрининг, добавляйте их в тот же блокнот, а не создавайте второй; разделённые блокноты — это способ, которым инструменты, привязанные к источникам, «забывают».
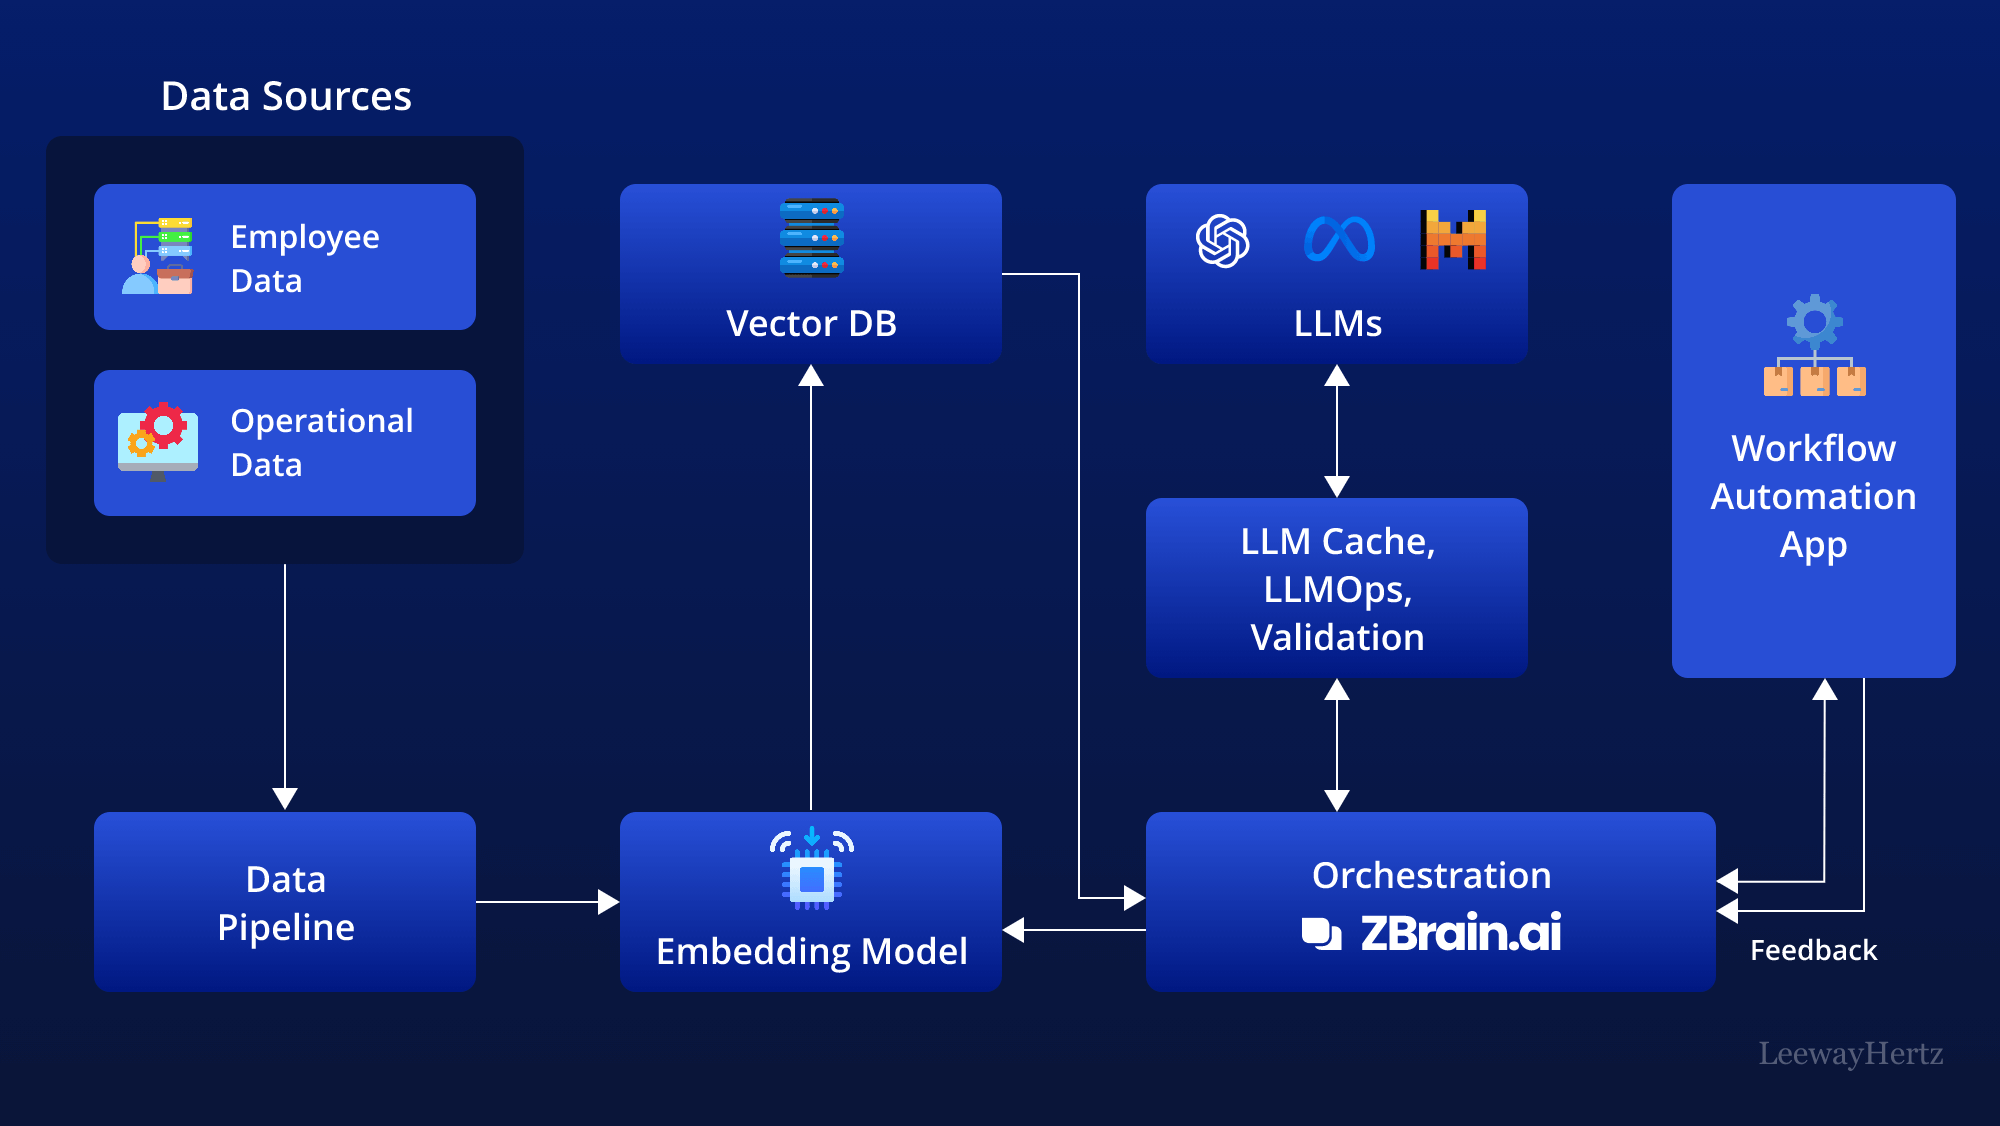
Архитектурная диаграмма — промышленная версия той же идеи. Устойчивая исследовательская память — это конвейер: источники проходят через загрузку, эмбеддинги, векторное хранилище, оркестрацию, вызовы моделей, валидацию и петлю обратной связи. Исследователям не нужно собирать этот стек самостоятельно, но им нужен продукт, который его реализует. Сессионный чат — лишь последний блок. Если результаты никогда не попадают в память, базу знаний или рабочее пространство обзора, конвейер не имеет состояния, и на четвёртом месяце вам придётся заново объяснять то, что было на первом.
Что методологи исследований говорят о памяти AI в синтезе доказательств?
Методологи рассматривают AI как экономящего труд рецензента с проблемой аудита, а не как замену протоколу, который можно восстановить. Полезный вопрос эксперта не в том, «может ли модель извлечь размер выборки?», а в том, «может ли второй человек увидеть, почему эта статья была исключена в феврале, и по-прежнему согласиться с этим в октябре?»
«Обзоры, которые разваливаются на шестом месяце, почти никогда не терпят неудачу потому, что модель пропустила синоним. Они терпят неудачу потому, что правило включения никогда не хранилось как объект. Команды вводят немного другое определение популяции в каждой сессии, а затем удивляются, почему таблица доказательств не стабилизируется. Постоянная память в таком случае — не функция удобства. Это единственный способ, при котором протокол и результаты существуют на одной временной шкале.»
«Мы также видим, как команды слишком доверяют структурированному извлечению и недостаточно вкладываются в журналы решений. Поля данных, подтверждённые цитатами, необходимы, а исследования извлечения за 2026 год обнадёживают с точки зрения точности относительно времени. Но они не фиксируют, почему пограничное испытание было оставлено. Если ваш AI не может извлечь эту причину, у вас нет живого обзора. У вас есть серия связанных чатов.»
«Практический дизайн, который мы рекомендуем, скучен: зафиксируйте протокол в инструкциях, накапливайте результаты в памяти или рабочем пространстве, обосновывайте ответы корпусом, на который можно указать, и экспортируйте аудит, который может использовать контрольный список PRISMA. Выбирайте инструменты для этих четырёх задач. Не выбирайте инструмент потому, что первое послеобеденное время с ним показалось гладким.»
— Product Team Jenova, проектирование длительных исследовательских процессов
Эта позиция соответствует миру отчётности, в который должны войти обзоры. Статья PRISMA 2020 с объяснениями и разъяснениями на PMC прямо указывает, что руководство предназначено для обзоров, включающих синтез, а EQUATOR Network размещает то же обновлённое руководство по отчётности. Помощник, который не может помнить методы, не может помочь вам отчитаться о методах.
Что происходит с воспроизводимостью, когда AI-помощник не может вспомнить исключения прошлого месяца?
Воспроизводимость превращается в театральную декорацию: вы всё ещё можете создать беглый раздел об относящихся работах, но больше не можете защитить набор исследований. Многомесячный проект порождает сотни решений о включении и исключении. Если эти решения нельзя извлечь, новый специалист по скринингу, научный руководитель или рецензент журнала не сможет отличить исключение, продиктованное протоколом, от настроения конкретной сессии.
Живые систематические обзоры делают этот сбой очевидным. Elicit описывает живые обзоры как объединение завершённого обзора с оповещениями, чтобы новая информация могла включаться ежегодно или по мере необходимости, и позволяет делиться ссылкой на весь процесс и промежуточные результаты. Это работает только тогда, когда исключения прошлого квартала являются частью обновляемого объекта. Чат-бот, который «помнит тему», но не журнал исключений, повторно включит уже отклонённые статьи или повторно исключит уже извлечённые.
Три проверки воспроизводимости быстро выявляют разрыв:
- Тест воспроизведения. Попросите помощника после недельного перерыва перечислить последние 20 исключений с причинами. Если он выдумывает причины или смешивает проекты, аудиторский слой отсутствует.
- Тест расширения. Дайте ему не относящуюся к области аннотацию, которая тематически выглядит заманчиво. Если он выступает за включение, не ссылаясь на зафиксированные критерии, сохранность протокола не сработала.
- Тест передачи. Коллега должен быть способен продолжить работу по последней сводке состояния помощника без устного брифинга. Если это невозможно, память является личной, а не научной.
Jenova успешно проходит тесты воспроизведения и передачи, когда действительно используются инструкции, базы знаний и память сессий; однако вам всё равно потребуется экспортировать журнал в форме PRISMA, если журналу нужна диаграмма потока. Elicit более нативно проходит тест аудита, но по-прежнему требует хранить неформальное научное суждение где-то ещё. Consensus и Gemini Notebook при использовании по отдельности не проходят разные проверки: Consensus не воспроизведёт ваши исключения, а Gemini Notebook не воспроизведёт статьи, которые никогда не были загружены.
Следовательно, проблема многомесячного исследования заключается не в том, «какая модель умнее в 2026 году». Она в том, хранятся ли стратегии поиска, критерии включения и предыдущие результаты в стеке, который всё ещё существует, когда вы возвращаетесь. Выберите инструмент, который сохраняет эти три объекта, а затем заставляйте помощника повторять их в начале каждой сессии, чтобы дрейф происходил открыто.
Источники
- PRISMA 2020 — контрольный список, диаграммы потока и руководство по отчётности для систематических обзоров
- Заявление PRISMA — обзор основного руководства по отчётности для систематических обзоров
- The BMJ — заявление PRISMA 2020: обновлённое руководство по отчётности для систематических обзоров
- LibGuides Университета Хофстра — контрольный список PRISMA из 27 пунктов для систематических обзоров и метаанализов
- ScienceDirect — AI-инструменты для систематических обзоров литературы и метаанализов, включая картирование 63 инструментов ML
- King's College London — AI-инструменты в синтезе доказательств
- Elicit — систематические обзоры литературы: скрининг, извлечение, аудит PRISMA, живые обзоры и результаты валидации
- Elicit — обзор продукта и цен, включая размер корпуса и базу исследователей
- Consensus — академическая поисковая система на основе AI, размер корпуса, Deep Search и медицинский режим
- Paperguide — Consensus и NotebookLM: поиск доказательств в сравнении с преобразованием источников (2026)
- Gemini Notebook, ранее NotebookLM — блокноты, привязанные к источникам, цитаты на уровне фрагментов и политика использования данных
- DistillerSR — руководство PRISMA и ошибки, подрывающие систематические обзоры
- medRxiv — точность и эффективность извлечения данных с помощью AI и Elicit по сравнению с извлечением только людьми (2026)
- Wiley / Cochrane Evidence Synthesis and Methods — AI-инструменты как вторые рецензенты для извлечения данных
- Birmingham City University — эффективность генеративного AI при извлечении данных для литературного обзора
- PubMed Central — объяснение и разъяснение PRISMA 2020
- EQUATOR Network — запись руководства PRISMA 2020 по отчётности