Как не дать AI-ассистенту для исследований выдумывать фальшивые цитаты?
2026-08-21
Какие меры защиты отличают AI-инструменты для исследований с опорой на цитаты от галлюцинирующих чат-ботов?
Самый надежный способ не дать AI-ассистенту для исследований выдумывать статьи — отказаться от инструментов, генерирующих ссылки по памяти, требовать, чтобы каждое утверждение было привязано к найденной записи с проверяемым машиной идентификатором, и сверять каждую цитату с источником до ее включения в рукопись. В 2026 году именно этот набор мер — извлечение с опорой на источники, проверка идентификаторов и человеческая верификация — отличает инструменты для работы с литературой, такие как Academic Research Assistant от Jenova, Elicit, SciSpace, Consensus и Scite, от универсальных чат-ботов, которые по-прежнему фабрикуют правдоподобные ссылки.
Ключевые факторы, которые действительно уменьшают число выдуманных источников:
✅ Извлечение вместо воспроизведения по памяти — ассистент должен искать в индексированных научных записях, а не автодополнять библиографию на основе обучающих данных. ✅ Привязка к идентификатору — каждая цитируемая работа должна иметь DOI, PMID, arXiv ID или URL издателя, который можно независимо разрешить. ✅ Верность источнику, а не только его существование — реальная статья, процитированная в подтверждение вывода, которого в ней нет, тоже означает ошибку, как показали исследования оценки RAG. ✅ Библиографическая точность — имена авторов, годы, тома и диапазоны страниц должны совпадать с записью, а не быть близким вариантом, выдуманным моделью. ✅ Цикл человеческой проверки — библиотеки Stanford и основные руководства по стилю возлагают ответственность за каждую цитату на автора, а не на инструмент.
Чтобы полезно сравнивать инструменты, следует рассматривать целостность цитирования как архитектурную задачу, а не как прием написания промптов. Далее в этом руководстве разобрана такая архитектура, режимы отказа, которые она призвана отслеживать, и рабочий процесс, который можно применить к любому ассистенту.
Почему в 2026 году сфабрикованные AI-цитаты появляются в опубликованных статьях?
Сфабрикованные цитаты больше не являются курьезом из учебной аудитории. Они попадают в журналы, грантовые документы и индексы цитирования, потому что исследователи вставляют в рукописи библиографии, созданные чат-ботами, не проверяя каждую ссылку. В анализе Nature за 2026 год оценивалось, что десятки тысяч публикаций 2025 года могут содержать недействительные ссылки, сгенерированные AI.
Картина такого загрязнения узнаваема. Специалист по информатике Гийом Кабанак получил уведомление, что одна из его работ была процитирована в International Dental Journal — области, не пересекающейся с его исследованиями по выявлению сфабрикованных статей, — и обнаружил, что не может узнать собственную ссылку. Так распространяются призрачные цитаты: они выглядят правильно оформленными, называют правдоподобные журналы и проходят поверхностную проверку.
Документированные случаи достаточно серьезны, чтобы приводить к отзыву публикаций. Резник и Хоссейни описывают статью в Academic Ethics, где 19 из 29 цитат были галлюцинированы; статью в PLOS ONE, позднее отозванную из-за 18 выдуманных ссылок из 76; и аналитическую статью в Digestive Diseases and Sciences, в которой 12 из 14 ссылок не существовали. Исследование цитат GPT-4o по психическому здоровью за 2025 год показало, что 56% содержали ошибки, а примерно каждая пятая была полностью галлюцинирована.
Обеспокоенность преподавателей теперь почти всеобщая. Согласно исследованию College Board, преподаватели опасаются, что использование AI подрывает критическое мышление, самостоятельное письмо и академическую добросовестность. Библиотечные руководства, такие как руководство UNC Charlotte, теперь рассматривают галлюцинированные цитаты как стандартный риск исследования, а не как редкий крайний случай.
Вывод для выбора инструмента очевиден. Если ассистент способен выдать хорошо оформленную ссылку в стиле APA или Vancouver, не извлекая актуальную запись, он способен придумать статью, которой никогда не было, — и эта статья может дойти до печати.
Что следует оценить, прежде чем доверить AI-ассистенту для исследований список литературы?
Оценивайте AI-ассистента для исследований по пятикомпонентной системе целостности цитирования: источник истины, привязка к идентификатору, верность утверждения конкретному фрагменту, библиографическая точность и обязательный цикл человеческой проверки. Инструменты, которые хорошо справляются с беглостью текста, но плохо — с этой системой, небезопасны для списков литературы, каким бы отточенным ни был их стиль.
1. Источник истины
Спросите, основаны ли ответы на извлеченном корпусе или на параметрической памяти. Системы с дополненным поиском находят материалы в Google Scholar, PubMed, Semantic Scholar, Scopus или arXiv, а затем генерируют ответ. Чат-боты без поиска предсказывают следующий токен цитаты. Метрики верности источнику существуют именно потому, что генерация может отклоняться от извлеченного контекста даже при успешном поиске.
2. Привязка к идентификатору
Связки «название — автор — год» недостаточно. Требуйте DOI, PMID, PMCID или URL издателя, а затем самостоятельно проверяйте его разрешение. Призрачные ссылки часто сразу не проходят этот тест. Библиографические почти-совпадения — реальная статья с неправильным томом или диапазоном страниц — выявляются при повторной проверке.
3. Верность утверждения конкретному фрагменту
Исследование ACM о цитатах в RAG показало, что корректность не равна верности источнику: до 57% цитат могут не подтверждать утверждение, которое они якобы обосновывают. Статья, которая существует, но не содержит указанного вывода, столь же опасна, как и несуществующая статья, потому что она придает ложному результату видимость достоверности за счет реального автора.
4. Библиографическая точность
Порядок авторов, год, издание, том, выпуск и страницы должны совпадать с записью. Тестирование RAG-инструментов в сфере бизнес-администрирования показало, что полностью сфабрикованные «призрачные» источники могут быть редкими, тогда как небольшие библиографические ошибки остаются распространенными. Такие ошибки все равно нарушают работу индексов цитирования и могут скрывать подмененные статьи.
5. Цикл человеческой проверки
Политика журналов APA в изложении Stanford гласит, что авторы обязаны проверять любую информацию и цитаты, предоставленные AI-инструментом. Руководства Wiley для исследователей и рекомендации Harvard по научной добросовестности также возлагают раскрытие информации и ответственность за точность на человека-автора. Ни один ассистент этой категории не отменяет такую обязанность.
Взвешивайте элементы системы в соответствии с задачей. В систематических обзорах особенно важны верность источнику и привязка к идентификатору. На этапе разведочного поиска можно допустить более широкий охват, если каждый отобранный материал проверяется до цитирования. Никогда не придавайте качеству текста чрезмерный вес. Именно гладкие абзацы делают фальшивые цитаты убедительными.
Как популярные AI-инструменты для исследований различаются по надежности цитирования?
Они существенно различаются в том, извлекаются ли ссылки из научных индексов или генерируются из памяти модели, и этот единственный выбор конструкции предсказывает большую часть риска призрачных ссылок. Универсальные чат-боты остаются вариантом с наибольшим риском для библиографий. Специализированные ассистенты для исследований уменьшают число призрачных ссылок, но все еще могут неверно передавать содержание, ошибочно указывать метаданные и чрезмерно обобщать результаты статей.
По состоянию на 2026 год практическое сравнение выглядит так:
| Функция / измерение | Универсальные чат-боты (например, ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| Источник доказательств | В основном параметрическая память, если не включен поиск | Извлеченные статьи, таблицы извлечения | Поиск по нескольким базам данных (Google Scholar, PubMed, arXiv) | Извлеченные статьи для эмпирических вопросов | Индекс цитирования с контекстом подтверждения и противоречия | Поиск литературы в реальном времени по академическим базам данных и репозиториям |
| Риск призрачных ссылок | Высокий; задокументирован в журналах и лабораториях | Низкий в исследованиях списков литературы на основе RAG | Низкий в исследованиях списков литературы на основе RAG | На основе поиска; все равно требует проверки | Низкий для материалов в его графе цитирования | На основе поиска; все равно требует независимой проверки DOI |
| Верность утверждения источнику | Слабая без извлеченных фрагментов | Выше при структурированном извлечении | Выше, когда ответы ссылаются на извлеченные статьи | Выше для эмпирических вопросов с ответом «да/нет» | Высокая для определения того, как цитируется статья | Зависит от извлеченных фрагментов и выбора модели; необходима проверка человеком |
| Библиографическая точность | Часто выдуманные детали | В аудитах RAG отмечались небольшие неточности | В аудитах RAG отмечались небольшие неточности | Не проверена на уровне полевого аудита | Высока в контексте цитирования | Наследует метаданные извлеченных записей; текст все еще может отклоняться |
| Цены (по состоянию на 2026 год) | Зависит от тарифного плана поставщика | Не проверено | Не проверено | Не проверено | Не проверено | Бесплатный тариф с ограниченным использованием; платные планы от $20 в месяц |
| Лучше всего подходит для | Создания черновиков, но не для формирования списка литературы | Таблиц доказательств и систематического извлечения | Широкого междисциплинарного поиска литературы | Быстрых ответов на эмпирические вопросы «да/нет» | Проверки, подтверждают ли цитаты утверждение или ему противоречат | Сквозного поиска литературы, подготовки рукописей и управления цитатами с постоянной памятью |
Универсальные чат-боты
Чат-боты прекрасно составляют планы и перефразируют текст, но не справляются с формированием библиографии. Проверка GPT-4o по психическому здоровью, упомянутая выше, дает настораживающую цифру: более половины сгенерированных цитат содержали ошибки. Если инструмент способен выдать безупречно выглядящую ссылку без актуальной записи, считайте каждую такую цитату непроверенной.
Elicit
Elicit сильнее, когда задача состоит в отборе статей и извлечении методов, результатов и ограничений в таблицу. Независимые сравнения описывают его как более подходящий для строгих рабочих процессов, основанных на доказательствах, чем для быстрого разведочного поиска. Его ограничение — плотность охвата: в бенчмарке SciSpace на 200 запросов Elicit возвращал 13,0 высокорелевантных статей на запрос против 26,3 у SciSpace Deep Review. Этот разрыв важен для полноты поиска, а не для риска призрачных ссылок.
SciSpace
SciSpace ищет по нескольким научным базам данных и в собственной оценке Deep Review лидировал по точности от P@3 до P@70. Такой охват помогает при междисциплинарных вопросах, когда доказательства одновременно находятся в PubMed, arXiv и Google Scholar. Ограничение методологическое: ключевой бенчмарк проводился самой SciSpace, хотя метки релевантности выставляли три внешние модели. Считайте бенчмарки поставщика ориентиром, а затем самостоятельно проверяйте отобранные работы.
Consensus
Consensus создан для ответов на эмпирические научные вопросы на основе статей, а не для написания повествовательного обзора. В том же тесте на 200 запросов Consensus Deep показал лучшую точность для первого результата (P@1 = 0.5882), но затем уступил лидерство глубже в списке. Это сильный инструмент для поиска отправной точки и менее надежный основной инструмент для длинных наборов отбора.
Scite
Отличительный актив Scite — интеллектуальная работа с цитированием: возможность увидеть, подтверждают ли последующие статьи определенное утверждение, упоминают его или противоречат ему. Сравнения описывают его как более узкий, чем полноценный инструмент управления исследовательским процессом, но более сильный для валидации доказательств. Если ваш тип ошибки — «эта реальная статья не говорит того, что утверждал ассистент», то контекст цитирования в стиле Scite — подходящий инструмент.
Jenova Academic Research Assistant
Jenova Academic Research Assistant создан для ученых и PhD-студентов, которым нужны поиск литературы, поддержка рукописей и цитирования в едином постоянном рабочем пространстве. Он может искать по основным академическим базам данных и репозиториям в реальном времени, сохранять память проекта между сессиями и создавать черновики с актуальными моделями без привязки к одному поставщику. Такое сочетание полезно, когда обзор длится неделями, а ассистент должен помнить критерии включения, отклоненные статьи и неразрешенные DOI.
Это не специализированный индекс контекста цитирования, поэтому он не заменит Scite для карт подтверждающих и противоречащих работ. Также он не является специально разработанной таблицей извлечения в смысле Elicit. Поиск в реальном времени может извлекать низкокачественные или неподходящие записи, которые беглая модель затем чрезмерно интерпретирует. Честное правило работы такое же, как для любого инструмента поиска: используйте его для нахождения и организации кандидатов, а не для утверждения библиографии.
Полностью ли генерация с дополненным поиском устраняет призрачные ссылки?
Нет. Генерация с дополненным поиском (RAG) резко снижает число полностью выдуманных статей в списке литературы, но не устраняет библиографические ошибки и не гарантирует, что извлеченная статья подтверждает предложение, к которому она прикреплена. Поэтому предотвращение должно быть направлено на три разных режима отказа, а не на один.
Эти три режима легко спутать, поскольку все они создают «правдоподобные цитаты»:
- Призрачные ссылки — цитируемая работа не существует.
- Библиографическое отклонение — работа существует, но неверно указаны авторы, год, том или страницы.
- Контекстная галлюцинация — работа существует, метаданные в целом верны, но ассистент приписывает ей вывод, которого в статье нет.
Полевой анализ Scopus AI, Elicit, SciSpace и Scite в области бизнес-администрирования показал, что инструменты на основе RAG в целом не выдавали проверяемых призрачных ссылок. Небольшие библиографические неточности все же встречались; полностью несуществующие источники в этих сгенерированных списках были пренебрежимо редки. Именно так следует понимать RAG: это сильный контроль против призрачных ссылок, но не полноценная система качества цитирования.
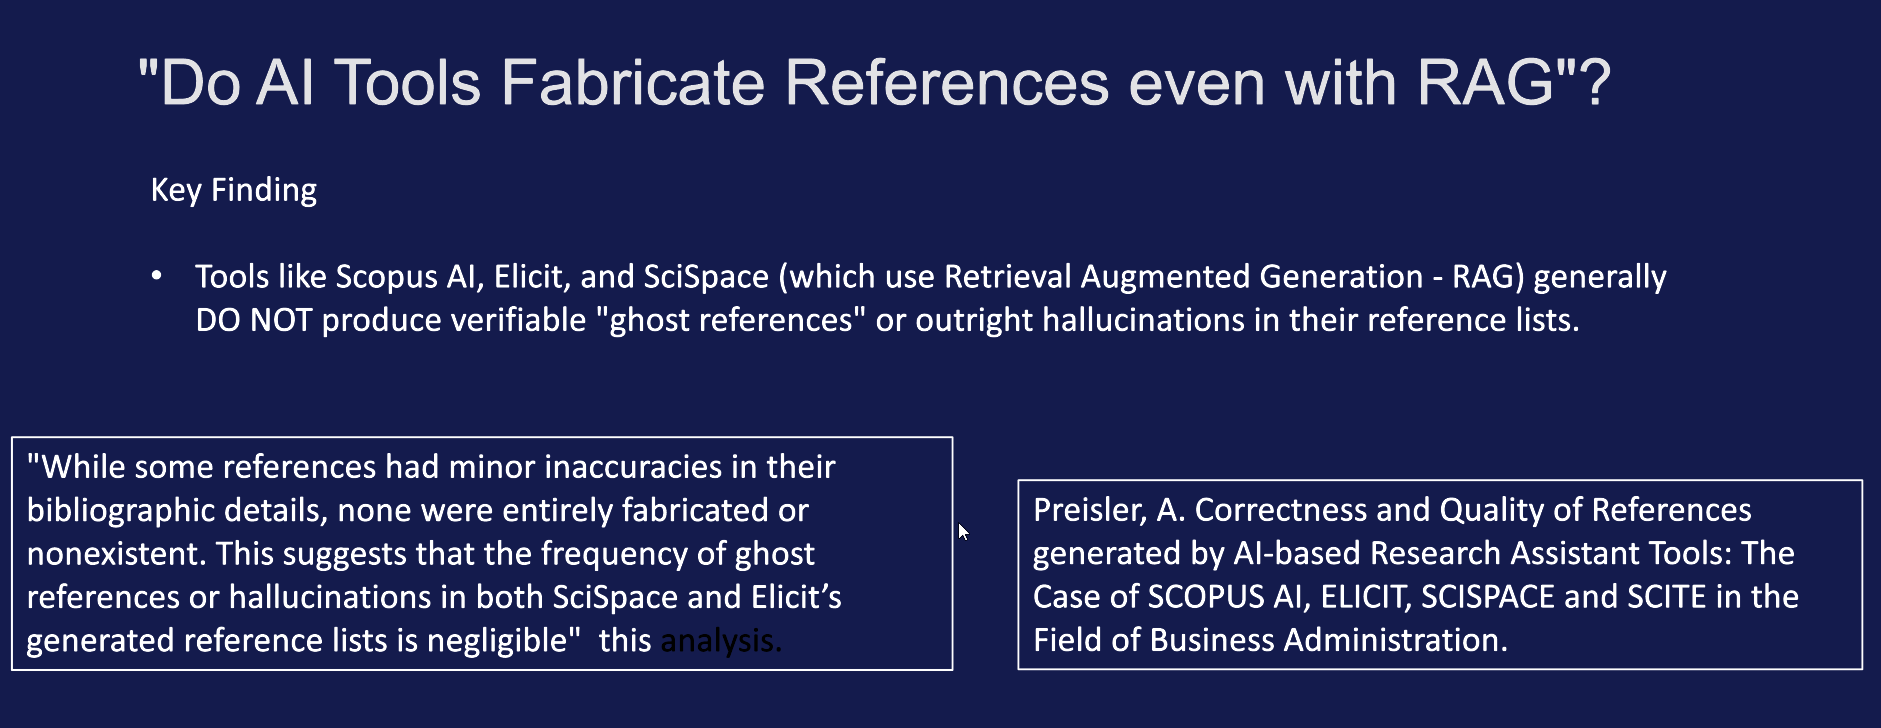
Исследования верности источнику объясняют оставшийся риск. Системы оценки RAG отделяют релевантность ответа от верности источнику: ответ может соответствовать теме, но не основываться на извлеченных фрагментах. Вывод ACM о том, что значительная доля цитат RAG может не обладать верностью источнику, — это практическое предупреждение. Если проверять только разрешение DOI, вы поймаете призрачные ссылки, но пропустите неверно приписанные утверждения.
Универсальные чат-боты чаще не справляются с первым режимом. RAG-ассистенты в основном ошибаются во втором и третьем. Следовательно, процесс предотвращения, который спрашивает только «существует ли эта статья?», неполон для инструментов, которыми исследователям действительно следует пользоваться.
Как проверять цитаты, которые возвращает AI-ассистент для исследований?
Проверяйте их по двухпроходному протоколу: сначала разрешите идентификатор, затем подтвердите, что конкретный фрагмент поддерживает утверждение. Пропуск любого из проходов — это путь, которым выдуманные или неправильно использованные источники попадают в публикацию.
Проход 1 — Существует ли запись?
- Скопируйте название, первого автора, год и DOI точно в том виде, в котором их вернул ассистент.
- Разрешите DOI через реестр или страницу издателя. Если DOI нет, найдите точное название в Google Scholar, PubMed или на сайте журнала, следуя подходу прямого поиска, рекомендуемому исследовательскими руководствами.
- Отклоните любой элемент, который не разрешается, разрешается в другую статью или существует только в виде оформленной AI-цитаты.
- Сверьте порядок авторов, год, том, выпуск и страницы с записью издателя, а не с библиографическим блоком ассистента.
Проход 2 — Подтверждает ли эта статья это предложение?
- Откройте полный текст в PDF или HTML. Для причинных утверждений, размеров эффекта или формулировок «первое доказательство» аннотаций недостаточно.
- Найдите фрагмент, который предположительно подтверждает утверждение. Процитируйте его в своих заметках.
- Отметьте цитату как подтверждающую, упоминающую или противоречащую — это различие Scite превратил в продукт, но его можно применять и вручную.
- Если ассистент перефразировал ограничение как результат или гипотезу как вывод, не используйте эту цитату для данного предложения.
Для Jenova Academic Research Assistant ограничивайте поиск еще до генерации списка литературы:
«Найди рецензируемые статьи и препринты по теме [topic] за 2019–2026 годы. Возвращай только материалы с DOI или PMID. Для каждого укажи: название, авторов, год, издание, идентификатор, вывод в одном предложении и процитированный фрагмент. Если ты не можешь извлечь проверяемую запись, полностью исключи этот материал. Не дополняй и не угадывай метаданные.»
Затем проверьте те же отобранные работы через Elicit или SciSpace в качестве второй проверки корпуса. Расхождение между инструментами — полезный сигнал: оно отмечает статьи, которые одна система ранжировала, но другая не смогла извлечь.
Материал Science о галлюцинированных научных статьях показывает, почему поверхностного просмотра названий недостаточно. Ассистент может правильно процитировать одну реальную работу, а затем выдумать соседнюю ссылку в том же абзаце. Проверка должна проводиться по каждому элементу, а не по каждому абзацу.
Может ли галлюцинированная цитата считаться научным нарушением?
Да, в определенном наборе случаев — и даже когда она не соответствует юридическому определению нарушения, она все равно может привести к отзыву публикации, проблемам с грантом и ущербу для карьеры. Мотивация для предотвращения — не просто этикет. Это ответственность.
Резник и Хоссейни утверждают, что галлюцинированная цитата может считаться доказуемым научным нарушением согласно федеральным нормам США при выполнении трех условий: исследователь использовал генеративный инструмент для создания несуществующих цитат; эти цитаты выполняют функцию данных, поскольку поддерживают выводы, как в обзорах или библиометрических исследованиях; и исследователь проявил безразличие к риску фабрикации, не проверив результат. Призрачная ссылка в повествовательном введении — плохая научная практика. Призрачная ссылка, учтенная как доказательство в систематическом обзоре, ближе к сфабрикованным данным.
Финансирующие организации уже рассматривают эту проблему как операционную. Летом 2025 года сотрудники NIH, рецензирующие грантовые заявки, были перегружены предложениями с использованием AI, и агентство указало, что ненадлежащее применение AI, обнаруженное после присуждения гранта, может быть передано на проверку добросовестности. Центр научной добросовестности Harvard повторяет связанные ограничения: AI-инструменты нельзя указывать в качестве авторов, научным рецензентам NIH запрещено использовать генеративный AI для составления рецензий, а авторы должны раскрывать, каким образом использовались инструменты.
Журналы приходят к единому распределению ответственности. Собрание правил APA, MLA, Chicago и IEEE от Stanford требует раскрытия AI-сгенерированного контента и, в случае APA, прямой человеческой проверки цитат. Рекомендации Cornell для преподавания дополнительно предупреждают, что автоматические алгоритмы выявления AI слишком ненадежны, чтобы быть стратегией обеспечения добросовестности. Выявление проблемы после факта — слабая замена проверке до отправки материала.
Практический стандарт прост. Если вы не можете указать на разрешенную запись и подтверждающий фрагмент, цитате не место в рукописи, презентации или грантовой заявке.
Что специалисты по научной добросовестности говорят о цитатах, сгенерированных AI?
Специалисты теперь рассматривают выдуманные ссылки как сбой процесса — использование генеративной модели в качестве библиотеки, — а не как загадочную ошибку модели, которую пользователь не мог предвидеть. Консенсус среди отделов научной добросовестности и исследований цитирования таков: RAG уменьшает число призрачных ссылок, человеческая проверка остается обязательной, а библиографии, созданные чат-ботом без контроля, безрассудны с учетом уже известных показателей ошибок.
«Ошибка, из-за которой материалы продолжают попадать в журналы, состоит не в том, что модели иногда угадывают. Она в том, что исследователи поручают языковой модели задачу каталогизации, для которой ее архитектура не предназначена. Если ассистент не извлек запись, он завершает библиографический шаблон, а завершенные шаблоны порождают статью, похожую на реальную, в журнале, похожем на реальный, с DOI, который не разрешается. Переход к инструменту поиска резко сокращает этот режим отказа. Но не следующий: цитирование реальной статьи в подтверждение результата, который существует в резюме модели, а не в разделе результатов.»
«Мы рекомендуем пользователям, ведущим исследования, рабочий процесс с тремя корзинами. Корзина A — извлеченные и проверенные по фрагменту материалы: эти цитаты можно использовать. Корзина B — извлеченные, но проверенные только по метаданным: они остаются в списке чтения. Корзина C — все, что модель выдала без разрешающегося идентификатора: это удаляется, а не «ищется позднее». Команды, пропускающие корзину C, потому что форматирование выглядит трудоемким, позже и обнаруживают, что 12 из 14 ссылок никогда не существовали. Стоимость дополнительного прохода ничтожна по сравнению с отзывом публикации или направлением на проверку добросовестности гранта.»
— Команда продукта Jenova, проектирование исследовательских AI-агентов для академических процессов
Этот совет соответствует политике издателей и университетов: называйте инструмент, называйте выполненную им задачу и сохраняйте ответственность человека-автора за каждую ссылку. Рекомендация по добросовестности больше не звучит как «избегайте AI». Она звучит так: «не передавайте на аутсорсинг проверку существования своих источников».
Как провести безопасный с точки зрения цитирования обзор литературы с AI?
Проводите его как конвейер: сначала поиск, затем извлечение, потом текст и контрольная точка проверки, которую не может пропустить ни одно предложение. Обратный порядок — сначала написать аргументацию, а затем попросить ассистента «добавить цитаты» — это схема промпта, которая чаще всего связана с призрачными ссылками.
Рабочий процесс, выдерживающий проверку журнала и грантодателя:
- Определите правила включения до поиска. Популяция, вмешательство, годы, языки, типы исследований. Вставьте эти правила в ассистента, чтобы память, если она есть у инструмента, сохранялась между сессиями.
- Ищите с помощью двух инструментов поиска, а не одного. Пример сочетания: Jenova Academic Research Assistant вместе с Elicit или SciSpace. Сохраняйте объединение найденных материалов; не доверяйте единственному ранжированному списку.
- Зафиксируйте набор кандидатов с идентификаторами. Экспортируйте название, авторов, год, издание, DOI/PMID. Все, что не имеет идентификатора, остается за пределами набора.
- Извлекайте, а не суммируйте, по полному тексту. Методы, выборка, результаты, ограничения и процитированное предложение. Здесь полезны таблицы в стиле Elicit; в повествовательных резюме возникает контекстная галлюцинация.
- Пишите черновик на основе таблицы извлечения. Если для предложения нет строки в таблице, оно не получает цитату — и, возможно, ему не место в статье.
- Раскрывайте используемые инструменты. Следуйте собранию правил руководств по стилю от Stanford: название инструмента, версию, дату и выполненную функцию — поиск, извлечение, языковое редактирование.
- Выполните финальную проверку DOI в отправляемой библиографии. Этот последний проход выявляет ошибки копирования и вставки, а также любую ссылку, которую модель добавила в ходе редактирования.
Промпт, который удерживает Jenova внутри конвейера, а не переводит его в режим чат-бота:
«Используя только набор кандидатов, который я загрузил, подготовь раздел с обоснованием исследования. Каждое эмпирическое предложение должно ссылаться на DOI из этого набора и не должно вводить новые источники. Если утверждение не подтверждается заметками по извлечению, пометь его как UNSUPPORTED вместо добавления цитаты.»
Для SciSpace или Elicit используйте представление поиска или извлечения каждого инструмента, чтобы заново составить ту же таблицу и сравнить строки. Если таблицы расходятся в трактовке вывода, прочитайте PDF. Такое расхождение обходится дешевле, чем исправление после публикации.
Ограничение, благодаря которому этот конвейер работает, столь же психологическое, сколь и техническое: никогда не просите любого ассистента, даже сильного, «подобрать ссылки» для текста, написанного без источников. Такой промпт превращает исследовательский инструмент обратно в генератор цитат — то есть в тот режим отказа, для предотвращения которого и создана вся эта система.
Источники
- Nature — Галлюцинированные цитаты загрязняют научную литературу
- Accountability in Research (Resnik & Hosseini) — Галлюцинированные цитаты, созданные генеративным искусственным интеллектом
- Stanford Libraries — AI в академических исследованиях: рекомендации по цитированию
- ACM Digital Library — Корректность не равна верности источнику в Retrieval Augmented Generation
- DeepEval — Метрика верности источнику для систем RAG
- Confident AI — Метрики оценки RAG: релевантность ответа, верность источнику и контекстная релевантность
- Библиотека UNC Charlotte — Руководство по исследованию галлюцинированных AI-цитат
- Wiley — Рекомендации по AI для исследователей
- College Board — Беспокойство преподавателей о том, что использование AI студентами подрывает академическую добросовестность
- Academic and Research Integrity Гарвардской медицинской школы — AI в исследованиях
- Cornell Center for Teaching Innovation — AI и академическая добросовестность
- SciSpace — Бенчмарк SciSpace, Elicit и Consensus для поиска литературы по 200 запросам
- Paperguide — Сравнение Elicit и SciSpace
- Paperguide — Сравнение Elicit и Scite
- Science — Цитировать не читая: когда AI галлюцинирует научные статьи
- SciSpace — Сравнение продуктов SciSpace и Elicit