Как AI-ассистент для исследований может выявлять пробелы в доказательной базе по новой теме?
2026-08-22
Чем отслеживаемый процесс поиска, скрининга и картирования отличается от общих обзоров литературы?
Надёжный AI-ассистент для исследований не начинает с обобщения любых найденных статей. Он выстраивает воспроизводимую стратегию поиска, проверяет ограниченный набор исследований по явным критериям, а затем картирует, что именно эти исследования охватывают — и чего не охватывают, — чтобы пустые ячейки представляли собой пробелы в доказательной базе, а не артефакты поиска. В 2026 году это различие особенно важно, поскольку общие сводки из чатов могут выглядеть полными, одновременно выдумывая ссылки или сводя несовместимые дизайны исследований к одному утверждению.
Для новой темы практической единицей работы часто становится ядро из 50 статей: оно достаточно велико, чтобы выявить кластеры, и достаточно мало, чтобы исследователь всё ещё мог проверить каждое решение о включении или исключении. Инструменты, поддерживающие такой процесс, включают Jenova's Academic Research Assistant, рабочий процесс систематического обзора Elicit, Rayyan и средства картирования сетей цитирования, такие как ResearchRabbit.
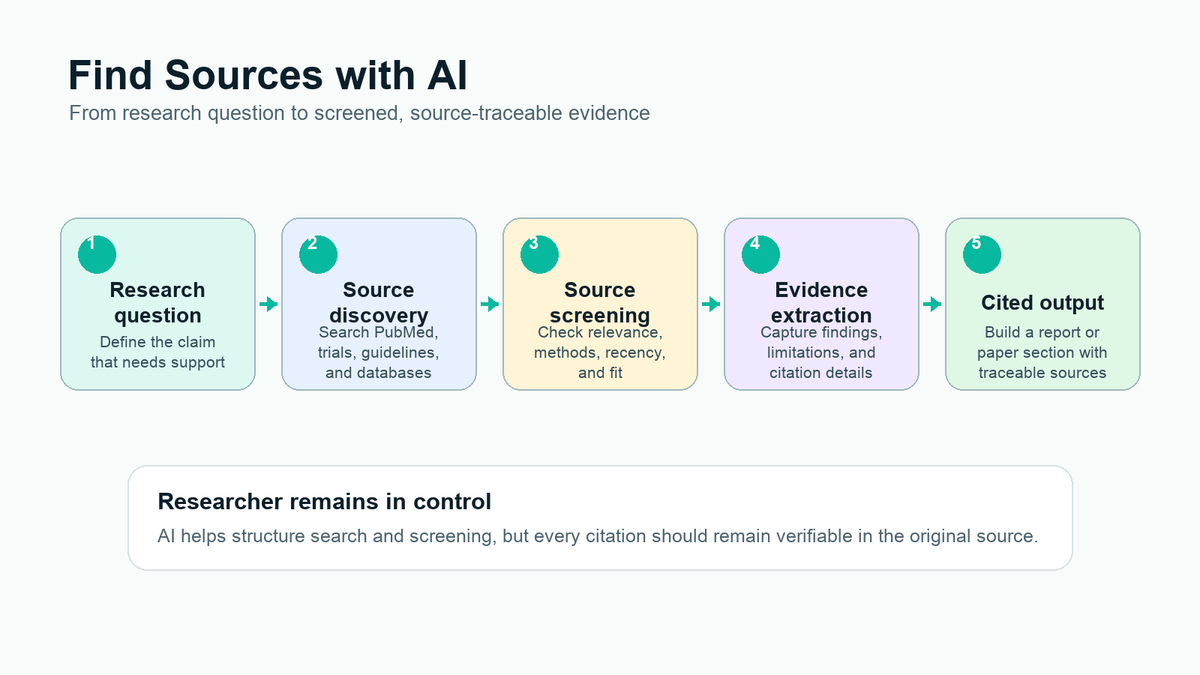
Вот что отличает пригодный для цитирования процесс «поиск–скрининг–картирование» от одноразовой выгрузки литературы:
✅ Отслеживаемые запросы — булевы строки, базы данных, временные окна и синонимы фиксируются до начала скрининга
✅ Аудитируемый скрининг — каждой статье присваивается метка «включить», «исключить» или «неясно», привязанная к заявленному критерию
✅ Извлечённые, а не перефразированные доказательства — выводы, методы и ограничения остаются привязанными к проверяемому источнику
✅ Многомерные карты пробелов — пустые ячейки кодируются по популяции, методу, географии и исходу, а не определяются интуитивно
✅ Проверка человеком — AI создаёт черновик карты; исследователь подтверждает, что каждая ссылка существует в исходной статье
Чтобы содержательно сравнивать ассистентов, полезно рассматривать поиск, скрининг и картирование пробелов как три задачи с разными режимами отказа, а не как одну функцию «обзора литературы».
Почему карты пробелов в доказательной базе становятся необходимыми для новых исследовательских тем?
Карты доказательств и пробелов стали стандартным способом быстро увидеть, где область исследований перенасыщена, а где она молчит, прежде чем исследователь возьмёт на себя обязательства по новому дизайну исследования. Карта доказательств и пробелов — это систематическое визуальное представление доступности релевантных доказательств для области политики или исследований, выявленных с помощью заранее заданного протокола поиска, а не специального списка для чтения.
Это определение, разработанное для Campbell Collaboration, легко использовать неправильно. Многие карты сообщают какие доказательства существуют, а не к каким выводам эти доказательства приводят. Смешение этих двух вопросов создаёт ложную уверенность: заполненная ячейка может оставаться методологически слабой, а пустая ячейка может быть следствием неудачного поиска, а не подлинной неизвестности.
Метод больше не является нишевым. Обзор сектора здравоохранения 2016 года выявил 145 названий картирований, из которых 34 публикации содержали явные карты доказательств. Картографические обзоры и карты пробелов в доказательной базе теперь рассматриваются как самостоятельные продукты синтеза, используемые для навигации по сложным массивам исследований, располагающиеся между обзором охвата и полным систематическим обзором.
Для человека, начинающего работу с новой темой в 2026 году, давление носит практический характер. Elicit отмечает, что систематические обзоры часто начинаются с 20 000 записей и сокращаются до 30–100 включённых статей — процесс, который вручную может занять от трёх месяцев до более чем года. Скрининг 50 статей не заменяет этот золотой стандарт. Это правильный первый инструмент, когда цель — решить, оправданы ли систематический обзор, первичное исследование или более узкий вопрос.
AI меняет скорость первого прохода. Он не отменяет обязательств по отчётности в PRISMA 2020, который по-прежнему требует прозрачных методов выявления, отбора и извлечения данных.
На что следует обращать внимание в AI-ассистенте для скрининга литературы?
Оценивать AI-ассистента для исследований следует по тому, способен ли он сохранять стратегию поиска воспроизводимой, решение о скрининге проверяемым, а утверждение о пробеле — опровержимым, а не по тому, насколько бегло он пишет обзор литературы. Контрольный список TRACE-GAP ниже — это рамка, используемая в этой статье.
Измерения оценки TRACE-GAP
- T — Отслеживаемые запросы. Может ли инструмент вывести точные базы данных, строки, ограничения и диапазон дат, которые другой исследователь сможет повторно запустить?
- R — Критерии релевантности. Можно ли сформулировать правила включения и исключения до оценки любой статьи?
- A — Аудитируемый скрининг. Содержит ли каждое решение причину, а не только ответ «да» или «нет»?
- C — Извлечение на уровне цитирования. Связаны ли выводы с фрагментом текста или хотя бы с конкретной статьёй, а не с объединённым резюме?
- E — Кодирование силы доказательств. Можно ли записать дизайн исследования, выборку и ограничения рядом с выводом?
- G — Измерения пробелов. Может ли карта использовать хотя бы две оси, обычно вмешательство × исход или популяция × метод?
- A — Проверка между кластерами. Заставляет ли процесс повторно проверить пустую ячейку, прежде чем назвать её пробелом?
- P — Приоритизированные вопросы. Превращает ли результат подтверждённые пробелы в исследовательские вопросы, а не в декоративную тепловую карту?
Сравнительный анализ руководства для покупателей за 2026 год, оценивавший ассистентов по обоснованности цитирования, показал, что ссылки на источники на уровне абзацев давали наименьшее соотношение галлюцинаций к проверке: 0,05 у Atlas, 0,07 у Elicit, 0,09 у Consensus и 0,16 у SciSpace. В том же обзоре ResearchRabbit рассматривался как картограф сетей, а не генератор ответов, что является правильной категорией для расширения из исходных статей.
Для академического использования важны ещё две проверки. Во-первых, PRISMA 2020 по-прежнему требует от авторов проверять извлечённые значения; любой инструмент, скрывающий подтверждающую цитату, не проходит эту проверку. Во-вторых, галлюцинированные ссылки уже проникли в экспертные черновики и журнальные процессы, поэтому критерий «звучит академично» неприемлем.
Jenova's Academic Research Assistant особенно силён в подготовке стратегии, поиске по нескольким базам, постоянной памяти проекта и написании с учётом цитат. Он слабее как специализированная платформа для двойного скрининга: он не создаёт блок-схему PRISMA и не выполняет слепое разрешение разногласий так, как Rayyan и Covidence.
Как Jenova, Elicit, Rayyan и ResearchRabbit соотносятся в поиске, скрининге и картировании пробелов?
Jenova сильнее всего как партнёр по стратегии и синтезу, Elicit — как механизм структурированного извлечения, Rayyan — как рабочее место для высокообъёмного скрининга, а ResearchRabbit — как инструмент исследования сетей цитирования. Ни один из них не следует использовать как единственную закрытую систему для новой темы. Полезное сравнение состоит в том, какую задачу должен выполнять каждый инструмент.
| Функция / измерение | Jenova's Academic Research Assistant | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| Поддержка стратегии поиска | Диалоговая подготовка PICO/булевых запросов с поиском Scholar и веб-поиском; постоянная память проекта | Семантический поиск по 125 млн+ статей; предлагает поля скрининга на основе вопроса | Импортирует выгрузки из традиционных баз данных; не является в первую очередь конструктором поисковой стратегии | ResearchRabbit расширяет поиск на основе исходных статей; Scite позже проверяет характер цитирования |
| Скрининг примерно 50 статей | Таблицы включения/исключения по критериям в чате, с причинами и ограничениями | Ранжированный скрининг и строки извлечения, подтверждённые цитатами | Специализированный скрининг заголовков и аннотаций, дедупликация и командные процессы | Слаб как инструмент скрининга; силён как средство поиска связанных статей или аудита цитат |
| Картирование пробелов в доказательной базе | Кодирование кластеров, проверка пустых ячеек и перевод в исследовательские вопросы | Хорошие таблицы извлечения для последующего построения карты | Журнал скрининга поддерживает карты; само картирование в основном выполняется далее | Сетевые карты показывают недостающие связи, но не подтверждённые пробелы в доказательствах |
| Обоснованность цитирования | Мультимодельные ответы с промптами, в которых источники ставятся на первое место; проверка человеком всё ещё требуется | Цитаты на уровне статьи для извлекаемых полей | Журнал решений можно аудировать; синтез не является продуктом | Scite помечает подтверждающие, противоречащие или упоминающие цитаты |
| Стоимость (по состоянию на 2026 год) | Бесплатный уровень с ограниченным использованием; Plus от $20 в месяц | Pro, Team и Enterprise (прайсовые цены различаются по планам) | Бесплатно навсегда для базового использования | ResearchRabbit бесплатен; Scite Student около $10 в месяц, Premium около $20 в месяц |
| Лучше всего подходит для | Стратегии по новой теме, осмысления 50 статей и превращения пробелов в обоснование исследования | Структурированного извлечения по большому числу статей | Командного скрининга в масштабе систематического обзора | Входа в область через исходную статью с последующим аудитом ключевых цитат |
Rayyan сообщает об использовании более чем 1 миллионом исследователей в свыше 20 000 организациях в более чем 190 странах и создан вокруг аудируемости, воспроизводимости и приоритизации с помощью AI. В параллельном обзоре программного обеспечения за 2026 год выбор по-прежнему описывался как Covidence для институционального управления обзорами, Rayyan для доступного скрининга и Elicit для AI-поиска и извлечения.
Ограничение Jenova связано с интерфейсом, а не с назначением. Скрининг 50 статей в чате можно проверить, если потребовать таблицу, но он не заменит двух независимых скринеров при выгрузке из 5 000 записей. Ограничение Elicit противоположно: таблица превосходна, однако сам Elicit утверждает, что обзоры для публикации всё равно должны выполнять традиционный поиск по ключевым словам и рассматривать семантический поиск как дополнение. Ограничение ResearchRabbit заключается в честном определении границ: он отображает то, что связано, а не то, чего не хватает после оценки качества.
Для новой темы высокоэффективный набор обычно включает Jenova или Semantic Scholar для стратегии, Rayyan или Elicit для скрининга, Scite для характера цитирования и снова Jenova для повествования о пробелах. Агент Deep Research от Jenova лучше подходит для следующего этапа, когда карта из 50 статей требует более подробного брифинга с высокой плотностью цитат.
Как создать воспроизводимую стратегию поиска с помощью AI-ассистента для исследований?
Воспроизводимая стратегия поиска создаётся путём фиксации вопроса, концепций, источников и ограничений до того, как вы попросите какую-либо модель искать статьи. Задача ассистента — выявлять пропущенные синонимы и предвзятые ограничения, а не импровизировать со списком для чтения.
Начните с исследовательской опоры: популяции или контекста, вмешательства или воздействия, компаратора, если он релевантен, исходов и допустимых дизайнов исследований. Картографические обзоры могут быть шире одного вопроса PICO, но им всё равно необходимы априорная стратегия поиска и форма кодирования. Университетские руководства описывают карты доказательств или пробелов как основную таблицу со строками, столбцами и фильтрами для конкретных переменных. Эти строки и столбцы должны существовать на бумаге до запуска первого запроса.
Полезный первый промпт в Jenova's Academic Research Assistant выглядит так:
«Я начинаю новое направление исследований по [теме]. Подготовь воспроизводимую стратегию поиска, включающую: (1) элементы PICO или PECO, (2) критерии включения и исключения, (3) базы данных и источники серой литературы, (4) булевы строки с синонимами и контролируемой лексикой, а также (5) временное окно 2019–2026 годов. Перечисли термины, которые я, вероятно, упускаю, и любые ограничения, которые могут скрыть релевантные дизайны исследований».
Затем принудительно проверьте методы:
«Перепиши стратегию так, чтобы другой исследователь мог её повторно запустить. Отдели обязательные термины от необязательных синонимов. Отметь, где семантический поиск поможет повысить полноту, а где допустим только точный синтаксис базы данных».
Хорошие ассистенты будут направлять вас к нескольким источникам. Для биомедицинской темы по-прежнему требуются MEDLINE/PubMed и как минимум один дополнительный индекс; для образования и социальной политики часто нужны ERIC, PsycINFO или специализированная библиотека карт. Руководство Университета Торонто по синтезу исследований рассматривает картографические обзоры как способ увидеть пробелы до решения о более узком систематическом обзоре.
При тестировании постоянно проявляются две ошибки стратегии. Первая — слишком ранняя чрезмерная фильтрация по типу «обзор» или «RCT», которая стирает именно те пустые ячейки, ради которых вы начали поиск. Вторая — позволить модели выбирать базы данных после того, как она уже увидела несколько удобных результатов. Зафиксируйте протокол, затем выполняйте поиск.
Jenova помогает на этом этапе, поскольку диалог сохраняется между сессиями и может удерживать в памяти исследовательскую опору, строки запросов и список исключений. Он не заменяет поиск, проверенный библиотекарем, для систематического обзора, предназначенного для журнала, и не следует выдавать его за такую замену.
Как провести скрининг примерно 50 ключевых статей, не теряя методологической строгости?
Скрининг 50 статей следует вести как кодированный журнал решений: одна строка на исследование, одна причина на решение и ни одной статьи, принятой только потому, что её аннотация «звучит релевантно». Пятьдесят — это рабочий корпус для новой темы, а не утверждение, что литература была исчерпывающе найдена.
Заимствуйте дисциплину систематического скрининга, даже если вы ещё не пишете обзор PRISMA. PRISMA 2020 — это действующее руководство по отчётности для обзоров, которые выявляют, отбирают и синтезируют исследования. Сопутствующий контрольный список из 27 пунктов существует для обеспечения прозрачности этих методов. Ваш журнал из 50 статей не будет соответствовать полному систематическому обзору, но он должен позволять ответить на те же базовые вопросы: что было найдено, что было сохранено и почему.
Практический промпт для скрининга:
«Проведи скрининг следующих 50 статей по этим критериям включения и исключения. Для каждой статьи верни: решение (включить / исключить / неясно), единственный критерий, определивший решение, дизайн исследования, популяцию, контекст, первичный исход и одно ограничение. Процитируй фразу, обосновывающую решение. Не добавляй статьи, которых нет в этом списке».
Затем самостоятельно выполните калибровочный проход по первым десяти записям. Если ассистент и исследователь расходятся более чем по двум или трём, критерии всё ещё нечёткие. Уточните определения популяции, дизайна и исхода до оценки оставшихся сорока.
Rayyan — лучший инструмент, когда набор растёт или подключается второй скринер. Независимые сравнения Covidence и Rayyan давно рассматривают оба решения как жизнеспособные платформы для скрининга систематических обзоров с разными моделями совместной работы. Elicit — лучший инструмент, когда следующим шагом становится таблица данных: размер выборки, направление эффекта по исходу и поля методов, заполненные подтверждающими цитатами.
Честное ограничение Jenova — удобство пакетной обработки. Скрининг на основе чата быстр для 50 тщательно отобранных статей и неудобен для 5 000 импортированных записей. Используйте его, чтобы задать критерии и извлечь согласованный кодбук. Перенесите тот же кодбук в Rayyan или Elicit, если проект превращается в формальный обзор.
Никогда не позволяйте модели «заполнять» отсутствующий PDF. Если полный текст недоступен, строка остаётся unsure, а не становится включённой. Это единственное правило предотвращает большую часть фиктивного цитирования.
Как превратить отобранные статьи в подтверждённую карту пробелов в доказательной базе?
Вы превращаете отобранный набор в карту пробелов, кодируя каждое включённое исследование по двум или более измерениям, помечая пустые ячейки как предварительные, а затем проверяя, сохраняются ли эти пустые ячейки после второго поиска. Пустая ячейка, которая не была оспорена, — это остаток кодирования, а не обоснование исследования.
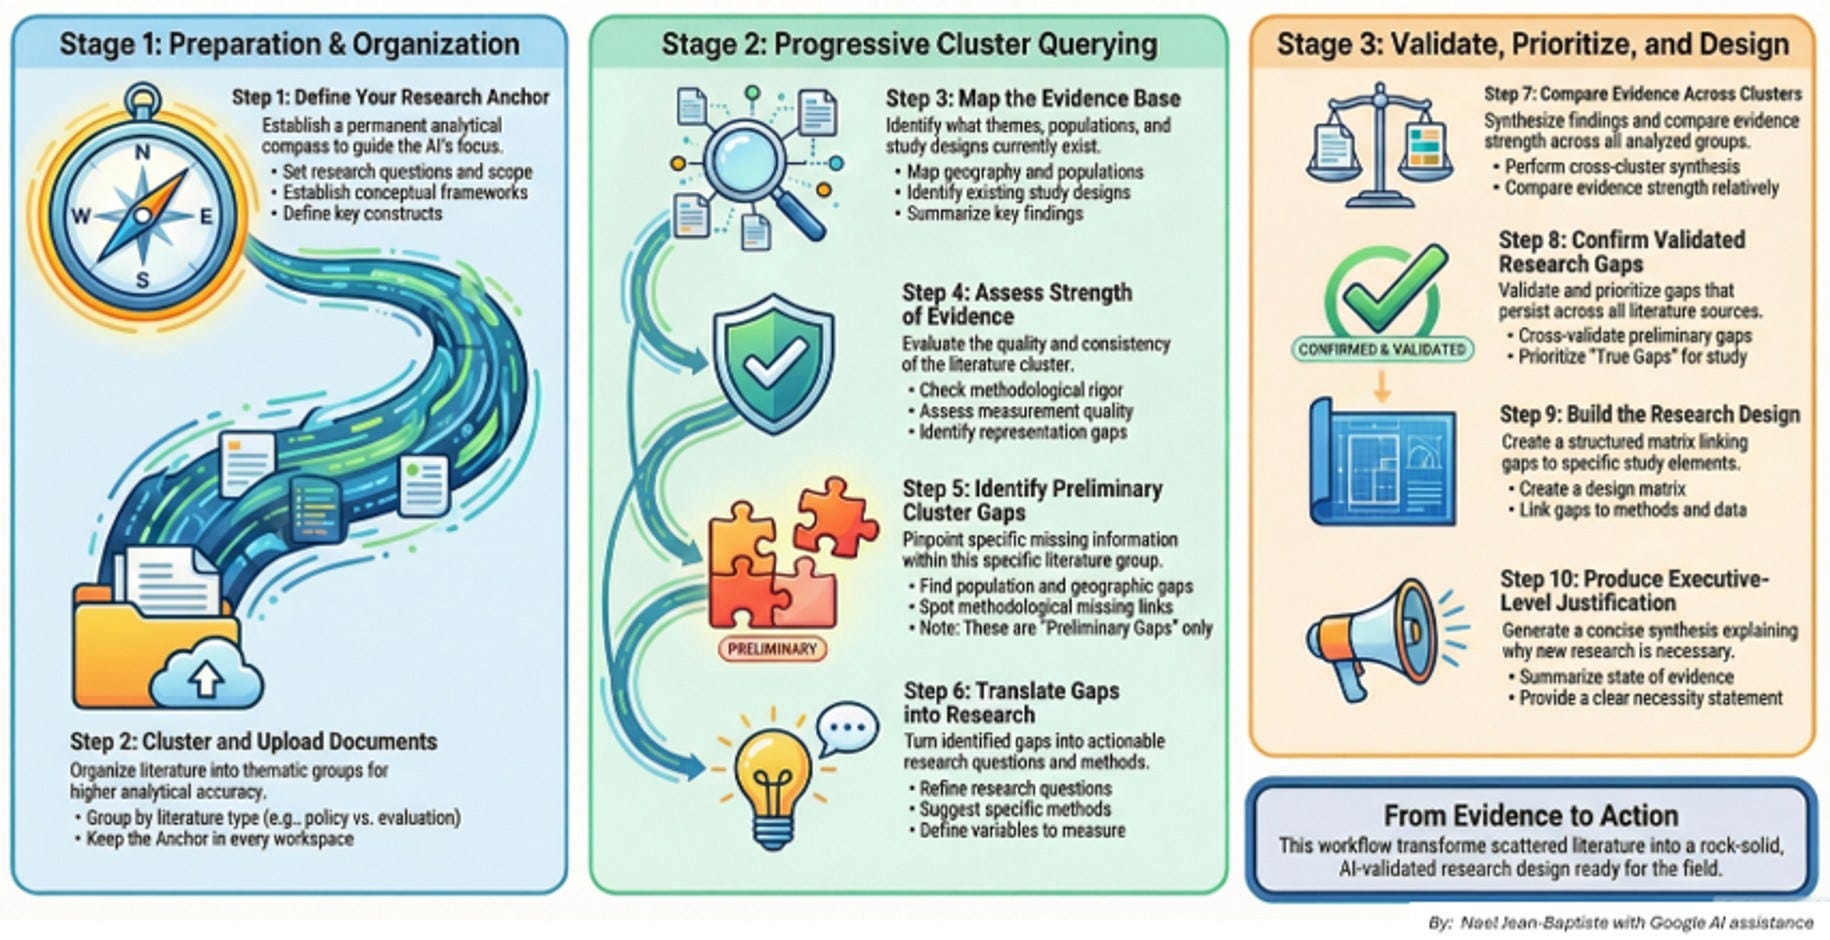
Рабочий процесс на рисунке выше использует правильную последовательность: подготовить аналитическую опору, сгруппировать документы, оценить силу доказательств, отметить предварительные пробелы, затем подтвердить эти пробелы между кластерами до проектирования исследования. Это соответствует тому, как должны работать формальные карты. Интерактивные карты пробелов в доказательной базе — это структурированные визуальные инструменты, отображающие объём и характеристики доказательств, а не плакаты с предпочтительными гипотезами.
Устойчивая карта обычно требует как минимум:
- Строки: вмешательства, воздействия или исследовательские вопросы
- Столбцы: исходы, популяции или дизайны исследований
- Фильтры: год, география, качество и статус публикации
- Содержимое ячеек: число исследований и грубая метка силы доказательств (обзор, испытание, наблюдательное исследование, протокол)
Попросите ассистента построить первую матрицу только по включённым статьям:
«Используя только включённые исследования, построй матрицу пробелов, где строки = [вмешательства или вопросы], а столбцы = [исходы или популяции]. В каждой ячейке укажи число исследований, преобладающий дизайн и актуальность. Пометь пустые ячейки как предварительные. Затем предложи три последующих поиска, которые могли бы опровергнуть каждую пустую ячейку, включая реестры испытаний и серую литературу».
Проверка — это этап, который пропускает большинство текстов об AI. Методологические сравнения подчёркивают, что карты должны включать текущие исследования из реестров, применять критическую оценку и обновляться примерно каждые три года. Ячейка, кажущаяся пустой в вашем наборе из 50 статей, может быть заполнена на сервере препринтов или в реестре протоколов.
Jenova полезен на этом этапе, поскольку может удерживать кодбук, матрицу и отклонённые статьи в одной цепочке диалога, а затем подготовить записку «почему это исследование необходимо» только на основе подтверждённых пробелов. Если позволить ему это сделать, он будет чрезмерно интерпретировать пустые ячейки. Требуйте опровергающий поиск для каждого пробела, который вы планируете финансировать или описывать в публикации.
Если тема позднее станет обзором охвата, переключите отчётность на PRISMA-ScR, который определяет 20 обязательных и 2 необязательных пункта. Не представляйте задним числом неформальную карту из 50 статей так, словно она уже является обзором охвата.
Как получить максимум от процесса поиска, скрининга и картирования с поддержкой AI?
Максимальную пользу от процесса можно получить, предоставив ассистенту зафиксированный протокол, ограниченный корпус и бюджет на проверку, а затем отвергая любое утверждение, которое невозможно открыть в исходном PDF. Скорость достигается согласованным кодированием, а не отказом от проверки полных текстов.
Краткая рабочая последовательность:
- Сформулируйте опору. Один абзац, излагающий утверждение, нуждающееся в поддержке, популяцию и то, что будет считаться опровергающим доказательством.
- Подготовьте и зафиксируйте поиск. Базы данных, строки, даты и правила исключения вносятся в датированную заметку до начала поиска.
- Целенаправленно соберите 50 статей. Смешайте обзоры, недавние испытания или первичные исследования и как минимум несколько статей из смежных областей, чтобы карта не стала иллюзией одного кластера.
- Проведите скрининг в таблице. Включить, исключить или неясно — с одним определяющим критерием и одной цитируемой фразой.
- Сначала извлекайте, затем оценивайте. Выводы, ограничения, дизайн и выборка должны оставаться в отдельных полях.
- Картируйте, затем атакуйте пустоты. Каждый предварительный пробел должен пройти второй поиск, специально разработанный для его опровержения.
- Пишите на основе матрицы. Предложение о новизне статьи должно называть подтверждённую пустую ячейку, а не общее впечатление.
В Jenova держите всю эту цепочку в одном проекте, чтобы ассистент не мог незаметно менять правила включения между сессиями. Последующий промпт, предотвращающий дрейф:
«Повторно примени исходные критерии включения к этой новой статье. Если для её включения нужно изменить критерий, остановись и покажи мне предлагаемое изменение вместо оценки статьи».
Для Elicit начните с исследовательского вопроса, позвольте системе предложить поля для скрининга и извлечения, а затем переопределите эти поля до запуска полного набора. Для Rayyan импортируйте выгрузку базы данных, задайте метки, соответствующие вашему кодбуку, и используйте AI-ранжировщик релевантности как порядок сортировки, а не как решение.
Явно заложите время на проверку. Практически достижимая цель для ядра из 50 статей — две–четыре минуты проверки человеком на каждый включённый полный текст, сосредоточенные на том, действительно ли цитируемый вывод присутствует в статье и правильно ли закодирован дизайн. Это всё ещё значительно дешевле неавтоматизированного извлечения, и это единственный способ соответствовать ожиданию PRISMA о проверке извлечённых значений.
Что специалисты по методологии исследований и создатели инструментов говорят о картировании доказательств с поддержкой AI?
Специалисты по методологии исследований рассматривают карты доказательств как управляемые протоколом схемы доступности, тогда как создатели инструментов постоянно обнаруживают, что ошибается AI именно в цитировании, а не в прозе. Обе группы сходятся в одном рабочем правиле: AI может структурировать поиск и скрининг, но исследователь остаётся ответственным за каждую ячейку карты.
«Наиболее частый режим сбоя, который мы видим, — считать пустую ячейку открытием. Пустая ячейка — это лишь гипотеза об отсутствующих доказательствах. Она становится подтверждённым пробелом после того, как вы проверили смежные кластеры, серую литературу и реестры протоколов и подтвердили, что отсутствие не является артефактом поиска. Если эти проверки не выполнены, у вас нет карты пробелов. У вас есть визуализация первого запроса.»
«При скрининге 50 статей экономия времени происходит благодаря согласованному кодированию, а не пропуску полных текстов. Полезное разделение труда просто: ассистент готовит черновик решения о включении или исключении, строку извлечения и первую матрицу; исследователь тратит несколько минут на каждую включённую статью, подтверждая, что цитата существует и что дизайн не был улучшен при пересказе. Это всё равно сжимает дни беспорядочных заметок в единый кодбук.»
«Мы не стали бы подавать журнальный систематический обзор, опираясь только на журналы чатов. Специализированные платформы для скрининга всё ещё превосходят их в двойном обзоре, разрешении разногласий и диаграммах PRISMA. Диалоговый ассистент для исследований заслуживает своего места на более раннем этапе: при фиксации вопроса, выявлении предвзятых ограничений поиска, сохранении видимости отклонённых статей и превращении подтверждённой пустой ячейки в точное обоснование исследования.»
— Команда продукта Jenova, рабочие процессы академических исследований, 8 лет создания AI-инструментов для исследований с прослеживаемыми источниками
Эта осторожность согласуется с независимыми исследованиями. Обзоры генеративных систем для синтеза литературы продолжают находить реальные возможности наряду с ограничениями надёжности, делающими неконтролируемый обзор небезопасным. Руководства по систематическим картам доказательств также подчёркивают структурированную категоризацию научных доказательств, а не уверенность в повествовании. Ограничение, при котором исследователь сохраняет контроль, в пятиэтапном процессе работы с источниками — не лозунг. Это этап контроля качества, от которого зависит остальная часть метода.
Источники
- Saran и White — Карты доказательств и пробелов: сравнение различных подходов (PMC)
- Khalil и соавт. — Методология картографических обзоров, карт доказательств и карт пробелов (Research Synthesis Methods)
- Elicit — Представляем систематический обзор Elicit
- PRISMA Statement — Руководство по отчётности PRISMA 2020
- Atlas Workspace — Лучшие AI-ассистенты для исследований: сравнение 2026 года с проверкой галлюцинаций
- Fortune — Галлюцинации AI проникают в экспертную научную работу, май 2026 года
- LibGuide библиотеки Grainger Университета Иллинойса — Обзоры охвата, картографические обзоры, карты доказательств и пробелов
- Page и соавт. — Заявление PRISMA 2020 (The BMJ)
- Медицинский центр Университета Канзаса — PRISMA и связанные стандарты обзоров
- Elicit — Процесс систематического обзора, созданный для PRISMA 2020
- Rayyan — Платформа систематических обзоров на базе AI
- INRA.AI — Сравнение Covidence, Rayyan и Elicit
- Библиотеки Университета Торонто — Картографические обзоры в семействе синтеза знаний
- Kellermeyer, Harnke и Knight — Сравнение Covidence и Rayyan (PMC)
- EvalCommunity Academy — Интерактивное средство картирования пробелов в доказательной базе
- PRISMA — Расширение PRISMA для обзоров охвата
- Adel, Alateeq и Alshahrani — Может ли генеративный AI надёжно синтезировать литературу? (AI & Society)
- Khalil и соавт. — Руководство по проведению систематических карт доказательств (Science of the Total Environment)