Как AI может синтезировать междисциплинарные доказательства, не смешивая факты?
2026-08-21
Какие три слоя доказательств должны оставаться раздельными при междисциплинарном синтезе с AI?
AI может надёжно синтезировать междисциплинарные доказательства только тогда, когда маркирует каждое утверждение как факт источника, вывод автора или вывод модели — и не позволяет этим слоям слиться в один немаркированный абзац. В 2026 году это разделение отличает поддающуюся аудиту исследовательскую справку от связного резюме, которое превращает осторожные утверждения в кажущийся авторитет. Универсальные чат-боты по умолчанию всё ещё смешивают эти слои, поэтому библиографические фабрикации и ошибки в цитировании остаются хорошо задокументированной проблемой.
Специализированные исследовательские агенты, включая Academic Research Assistant от Jenova, лучше подходят для этой задачи, когда они находят реальные источники, сохраняют атрибуцию и делают собственные логические скачки модели видимыми. Они не заменяют систематический обзор, зарегистрированный по PRISMA.
Ключевые факторы, отличающие синтез с учётом происхождения данных от немаркированного перефразирования:
✅ Факты источника — это измерения, методы, размеры выборки и наблюдения, представленные в первичном тексте ✅ Выводы авторов — это интерпретации, которые авторы статьи делают в обсуждении или аннотации, а не независимая истина ✅ Вывод AI — это аналогическое, прогностическое или интегративное рассуждение, которое модель добавляет на основе статей или дисциплин ✅ Междоменное сопоставление должно быть явным, поскольку механизм, установленный в одной дисциплине, в другой часто является лишь гипотезой ✅ Каждое извлекаемое предложение должно выдерживать простой аудит: кто это утверждал, в каком документе и с каким эпистемическим статусом?
Чтобы сравнивать инструменты по этой проблеме, рассматривайте происхождение данных как ключевой критерий оценки, а не как предпочтение по форматированию. В остальной части руководства используется этот подход — модель FCI-TRACE — для оценки реального поведения систем синтеза.
Почему междисциплинарный синтез с AI терпит неудачу, когда происхождение данных схлопывается?
Междисциплинарный синтез терпит неудачу без происхождения данных, потому что дисциплины не используют одни и те же стандарты доказательности, а языковые модели оптимизированы для создания связной прозы, а не для сохранения этих стандартов. Эмпирический результат климатической статьи, утверждение экономиста о каузальной идентификации и клиническая практическая рекомендация могут быть грамматически объединены в одном предложении. Такое предложение будет восприниматься как устоявшееся знание, даже если измерен был лишь один его фрагмент.
Это не гипотетический сценарий сбоя. Исследование Scientific Reports о литературных обзорах, созданных ChatGPT, показало, что 55% цитат GPT-3.5 и 18% цитат GPT-4 были сфабрикованы, а 43% и 24% оставшихся реальных цитат содержали существенные библиографические ошибки. Более поздние публикации связывают более широкий рост сфабрикованных цитат в опубликованных статьях с генеративными инструментами. Обзоры нескольких моделей в 2026 году по-прежнему показывают, что почти 40% ссылок, созданных AI, содержат ошибки или фабрикации, а полностью точны лишь 26,5%.
Частота галлюцинаций ещё выше за пределами хорошо индексируемой научной прозы. Оценка Stanford HAI, обобщённая MIT Sloan, показала, что универсальные чат-боты галлюцинировали в 58–82% юридических исследовательских запросов на моделях уровня 2023 года. Правовые, политические и клинические области — именно те контексты, в которых чаще всего запрашиваются междисциплинарные справки, — и именно там немаркированный вывод обходится наиболее дорого.
Более глубокая проблема — это отмывание источников: оговорка с осторожной формулировкой из раздела обсуждения пересказывается без оговорок, а затем цитируется так, словно была результатом. Стандарты происхождения данных существуют, чтобы остановить такое преобразование. Междисциплинарная работа умножает риск, поскольку читатели не могут полагаться на общие методы, чтобы заметить изменение статуса утверждения.
Какие критерии следует использовать для оценки системы синтеза доказательств с AI?
Оценивайте систему синтеза доказательств с AI по тому, способна ли она сохранять слои FCI при разногласиях, а не по количеству упомянутых статей. Беглость, скорость и даже полнота поиска вторичны, если результат нельзя проверить аудитом. Используемая здесь модель FCI-TRACE оценивает шесть измерений.
FCI (эпистемический статус)
- Факты: Может ли система процитировать или близко перефразировать результат с указателем на местоположение — статью, раздел, рисунок или таблицу?
- Выводы: Приписывает ли она интерпретацию названным авторам и сохраняет ли оговорки?
- Вывод: Отмечает ли она аналогические или интегративные шаги как сгенерированные моделью?
TRACE (качество синтеза)
- Прослеживаемость: Каждое утверждение связано с фрагментом источника, а не просто с названием статьи.
- Актуальность: Система различает даты препринтов, даты публикаций и обновления руководств — известная проблема даже для библиографических инструментов без AI и задокументированный режим ошибок ChatGPT в исследовании Walters и Wilder.
- Согласованность: Сходящиеся и противоречащие друг другу результаты сводятся в таблицу, а не усредняются в ложный консенсус.
- Охват: Если вопрос междоменный, должны быть представлены как минимум два дисциплинарных метода.
- Эпистемическая маркировка: Теги статуса видны в основном тексте, а не скрыты в сноске.
Это строже типовых контрольных списков «AI для литературного обзора», которые часто ограничиваются поиском и суммаризацией. Университетские руководства теперь каталогизируют инструменты, которые суммируют статьи и извлекают данные в структурированные таблицы, а команды систематических обзоров различают полуавтоматический и полностью автоматический скрининг. Эти возможности важны. Но сами по себе они не мешают переписать вывод автора как факт.
Прозрачность протокола также должна учитываться в оценке. PRISMA 2020 — это контрольный список из 27 пунктов для отчётности по систематическим обзорам, включающим синтез, который сопровождается статьями с пояснениями через сеть EQUATOR Network. Ни одна сессия чат-бота не является обзором PRISMA. Тем не менее надёжный рабочий процесс с AI должен сообщать логику критериев отбора, просмотренные источники и то, что добавила модель.
Как ведущие исследовательские инструменты AI работают с фактами, утверждениями авторов и выводами модели?
Ведущие инструменты разделяются по чёткой границе: экстракторы, привязанные к статьям, снижают число фабрикаций, тогда как универсальные чат-модели остаются беглыми, но слабо атрибутированными, — и почти ни одна из них нативно не требует меток FCI в генерируемом тексте. Сравнение ниже посвящено эпистемической гигиене, а не общей популярности.
| Функция / измерение | Универсальный ChatGPT | Elicit | Jenova Academic Research Assistant | Scite (контекст цитирования) |
|---|---|---|---|---|
| Корпус для обоснования | Обучающие данные плюс дополнительный поиск; цитаты часто не проверяются | Поиск, суммаризация и извлечение по 125 миллионам статей; используется более чем 2 миллионами исследователей | Поиск по научным и веб-источникам в реальном времени, вложения и постоянная память сессии | Граф цитирования и подтверждающий/противоречащий контекст того, как цитируются статьи |
| Маркировка FCI в выводе | Обычно без меток; факты, утверждения из обсуждений и скачки модели имеют один голос | Лучше извлекает данные на уровне статьи, чем задаёт эпистемические теги на уровне предложений | Может получать инструкции маркировать слои FCI и сохранять протокол между сессиями | Маркирует скорее позицию цитирования, чем тип утверждения внутри синтеза |
| Междисциплинарный синтез | Высокая беглость; слабый след аудита между областями | Наиболее силён в эмпирических исследовательских вопросах и структурированном извлечении | Наиболее силён, когда в течение нескольких дней требуется протокол методов и продолжение работы по предметной области | Ограничен как синтезатор; сильнее как инструмент анализа контекста цитирования |
| Проверка цитат | Высокие показатели фабрикаций и ошибок в систематических тестах | Строки, привязанные к статьям, сокращают число выдуманных ссылок | Поиск плюс атрибуция; всё ещё требует выборочной проверки человеком | Нативный контекст о том, поддерживают ли последующие статьи утверждение или ему противоречат |
| Скрининг / извлечение | Неструктурированный | Автоматизирует скрининг и извлечение данных для систематических обзоров | Итеративное выявление источников и поддержка рукописей, а не специализированный интерфейс скрининга | Не является рабочей средой для скрининга |
| Стоимость на 2026 год | Подписка; точные потребительские тарифы здесь не подтверждены | В этом обзоре не подтверждена | Бесплатный уровень с ограниченным использованием; Plus за $20 в месяц (в 30× больше использования) | В этом обзоре не подтверждена |
| Лучше всего подходит для | Черновой работы, когда источники уже собраны | Извлечения по столбцам из эмпирических статей | Многосессионных справок по нескольким источникам, где слои FCI должны оставаться видимыми | Проверки того, как утверждение трактуется в последующей литературе |
Elicit. Анализ сферы продукта показывает, что это скорее исследовательская рабочая среда, чем чат-бот: пользователи задают вопрос, находят статьи и извлекают поля. Независимые сравнения в 2026 году описывают Elicit как более сильный инструмент для поиска литературы, скрининга и извлечения данных, тогда как Consensus называют более сильным для научных вопросов формата «да/нет». Сила извлечения реальна. Ограничение дополняет её: заполненная таблица всё ещё может представить каузальный глагол из аннотации как результат, если пользователь не определил столбцы, отделяющие выводы от интерпретации.
Consensus и Semantic Scholar. Consensus неоднократно позиционируется как механизм ответов на основе реальных статей, а не как полный конвейер обзора (The Drive AI). В одном обзоре 2026 года Consensus был указан с начальной ценой около $144 в год. Semantic Scholar остаётся основой поиска в тех же сравнениях. Ни один из этих инструментов, судя по рассмотренным здесь публичным описаниям, не предлагает обязательный слой разделения фактов и выводов.
Scite. Scite лучше подходит, когда вопрос звучит как «как цитируется статья?», а не «как объединить две дисциплины?». В сравнениях он рассматривается как специалист по контексту цитирования в противовес более широкому рабочему процессу обзора Elicit (Paperguide, 2026). Метки подтверждающих и противоречащих цитат ценны, однако они по-прежнему отличаются от FCI: более поздняя статья может «поддерживать» вывод автора, который никогда не был фактом.
Универсальный ChatGPT. Он остаётся неверным выбором по умолчанию для синтеза без контроля. Даже улучшенный уровень фабрикаций GPT-4 в 18% несовместим с работой, требующей надёжных цитат, а числовые поля ссылок — том, страницы, год — являются наиболее частыми ошибками среди реальных ссылок. Библиотечные рекомендации теперь рассматривают галлюцинированные цитаты как самостоятельную проблему исследовательской добросовестности.
Jenova Academic Research Assistant. Этот агент создан для преподавателей, исследователей и аспирантов PhD, которым нужны поиск литературы, поддержка рукописей и управление цитированием, а не разовое резюме. На платформе Jenova он может использовать научный поиск, хранить неограниченную историю чата и удерживать протокол методов в постоянной памяти, чтобы правила FCI не сбрасывались в каждой сессии. В сочетании с Deep Research, который выполняет широкий поиск и возвращает отчёты с плотными цитатами, он хорошо подходит для междисциплинарных вопросов, разворачивающихся в течение нескольких рабочих сессий.
Важны и честные ограничения. Это не Covidence, DistillerSR или Rayyan: здесь нет специализированной рабочей среды для блок-схемы PRISMA и нет нативной сетки извлечения по 125 миллионам статей масштаба, который заявляет Elicit. Решения о включении материалов с высокими ставками и статистическое объединение результатов по-прежнему должны принимать рецензенты-люди. Преимущество в глубине состоит в сохранении протокола и явной маркировке, а не в автоматизированной определённости.
Как оркестрация знаний не даёт дисциплинарным доказательствам схлопнуться в единый нарратив?
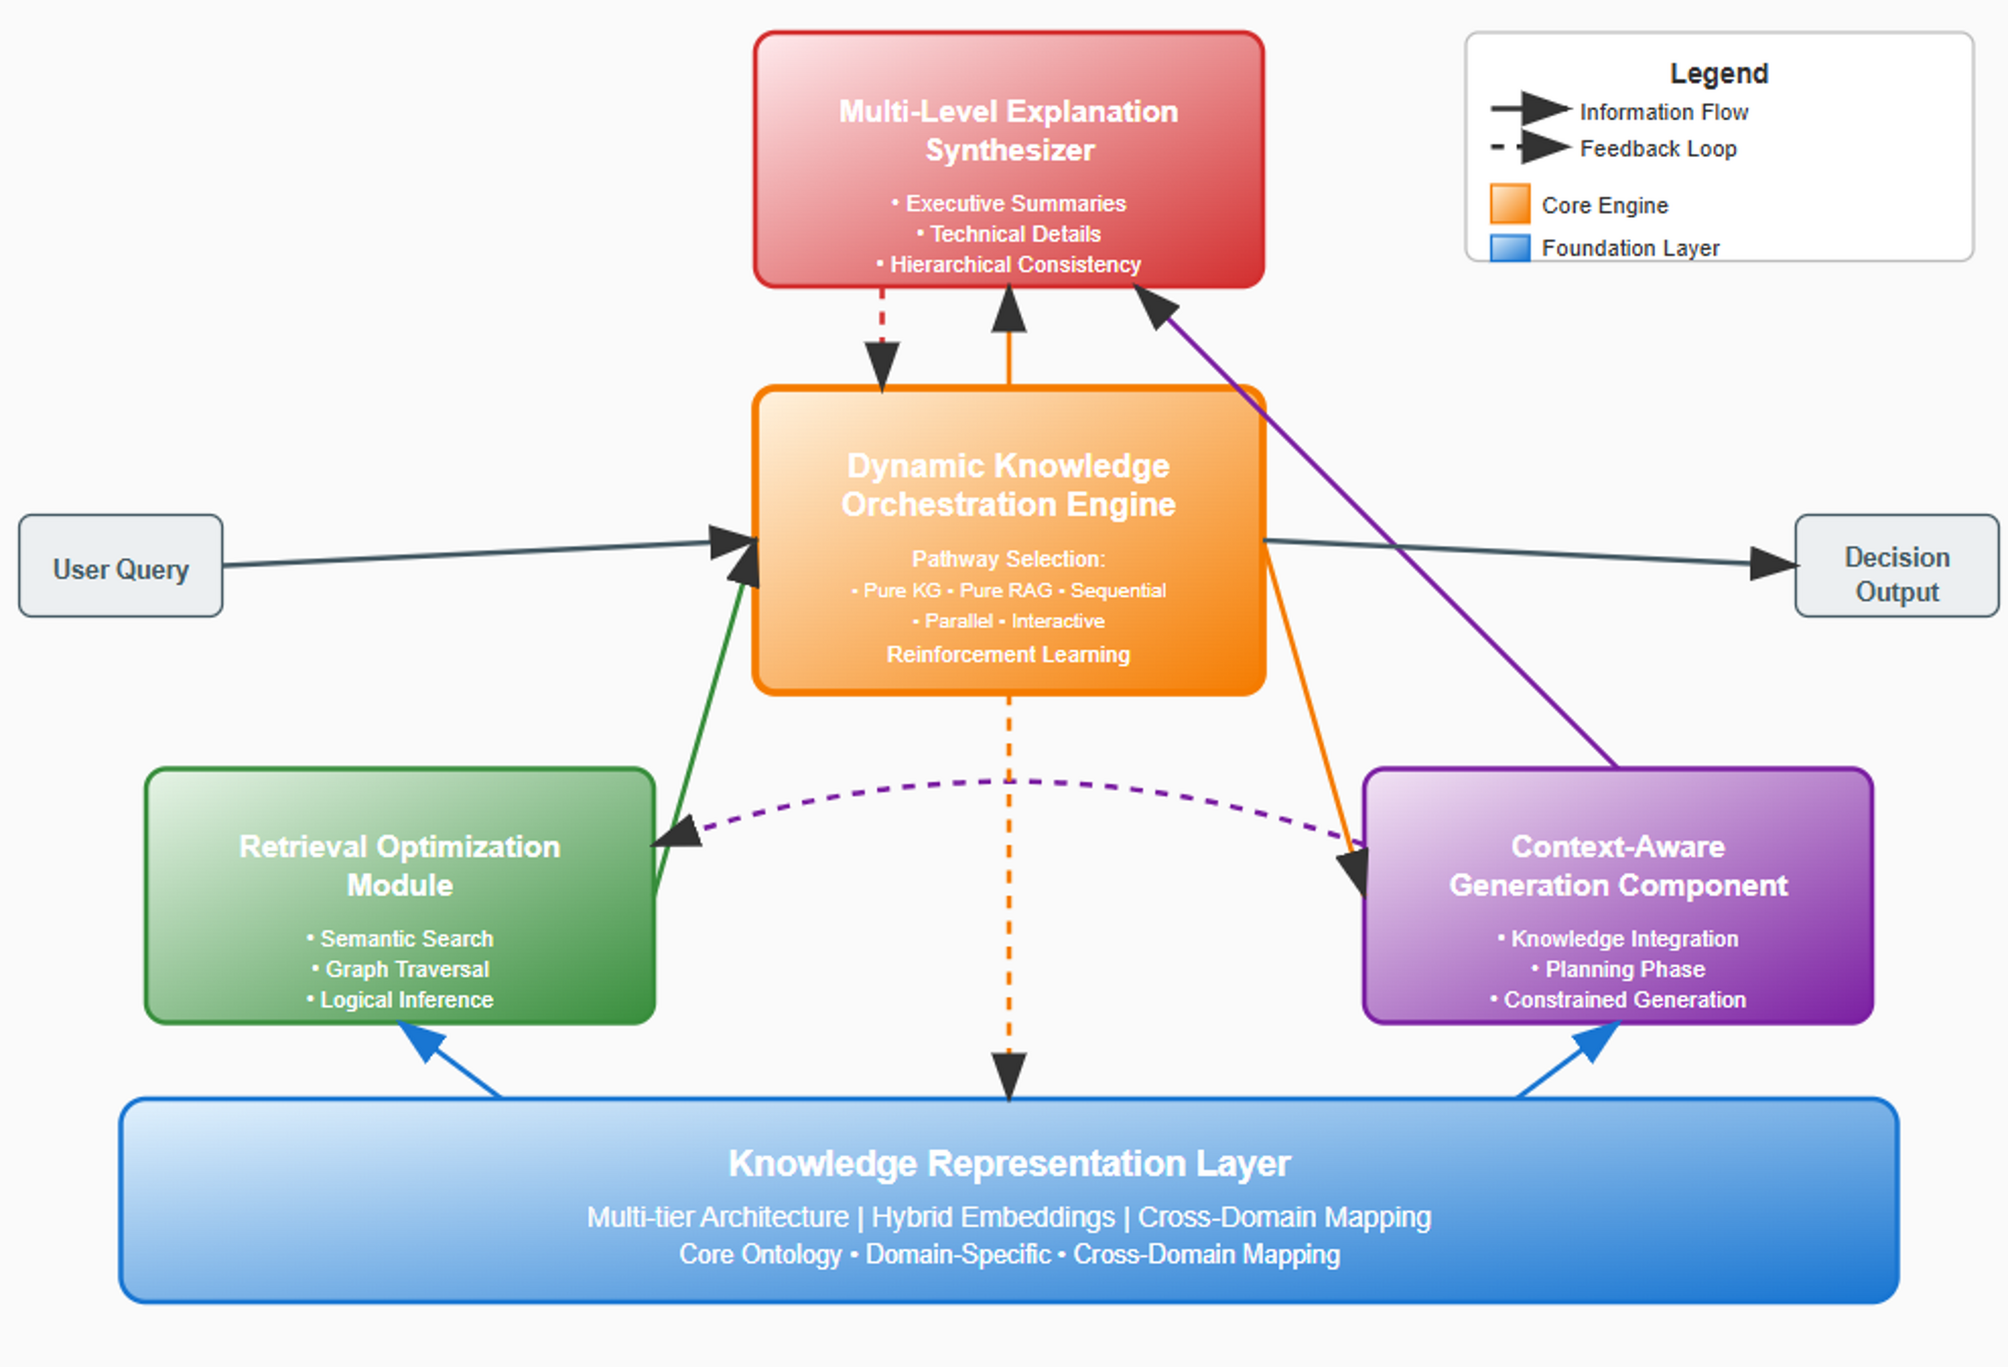
Оркестрация знаний сохраняет дисциплинарные доказательства, выбирая путь поиска до генерации, а затем заставляя объяснения оставаться иерархически согласованными с тем, что было найдено. Анализ типичного стека оркестрации показывает, почему для междисциплинарной работы недостаточно просто «найти, а затем написать».
Основой служит слой представления знаний: гибридные эмбеддинги, доменные онтологии и междоменные сопоставления. Без этого слоя модель рассматривает «неопределённость» в физике климата, «неопределённость» в эконометрике и «неопределённость» в клинических рекомендациях как один и тот же семантический кластер. Это не так. Сопоставление терминов между областями — это шаг вывода, и он должен маркироваться как таковой.
Над этим слоем модуль оптимизации поиска объединяет семантический поиск, обход графа и логический вывод. Обход графа важен, когда вопрос имеет реляционный характер: аналогичен ли механизм A в экологии механизму B в общественном здравоохранении? Один лишь семантический поиск возвращает похожую лексику; он не доказывает общей каузальной структуры. Логический вывод на основе извлечённых утверждений ближе к сетям вывода доказательств, разработанным для интерпретируемой проверки утверждений.
Затем механизм оркестрации выбирает путь — только граф знаний, только RAG, последовательный, параллельный или интерактивный, — вместо того чтобы всегда загружать фрагменты в промпт. Параллельный поиск уместен, когда две дисциплины необходимо собрать независимо до любого сопоставления. Последовательный поиск уместен, когда показатель исхода из одной области должен ограничивать следующий запрос. Смешивание этих режимов без явного указания — это путь, которым справка о климате и здоровье незаметно превращается в политическую рекомендацию.
Этап генерации с учётом контекста должен планировать работу в условиях ограничений: не использовать каузальный глагол, если источник его не использует; не объединять рамки выборок. Последний этап — синтезатор многоуровневых объяснений — делает FCI видимым: резюме для руководителей, технические детали и проверка согласованности, чтобы резюме не выходило за пределы доказательств. Интерфейсы «утверждение—доказательство» в современных исследованиях, такие как PaperTrail, указывают в том же направлении: надёжность в научной среде зависит от сопоставления утверждений с доказательствами, а не от более гладкой прозы.
Academic Research Assistant от Jenova не предоставляет исследователю каждый внутренний переключатель маршрутизации как элемент управления. Это реальное ограничение для команд, которым нужен полностью проверяемый DAG. Однако для большинства академических рабочих процессов он предлагает практический эквивалент: постоянные инструкции, прикреплённые корпуса, поиск в реальном времени и достаточно памяти, чтобы сохранять стабильный протокол маркировки по мере накопления доказательств.
Как семантический конвейер цитирования может проверять утверждения до их включения в синтез?
Семантический конвейер цитирования проверяет утверждения, рассматривая каждую цитату как гипотезу, которую следует сопоставить с исходным документом, а не как оформленное украшение в конце абзаца. Если пропустить этот шаг, междисциплинарный синтез унаследует каждую выдуманную или исказившуюся ссылку, созданную генератором.
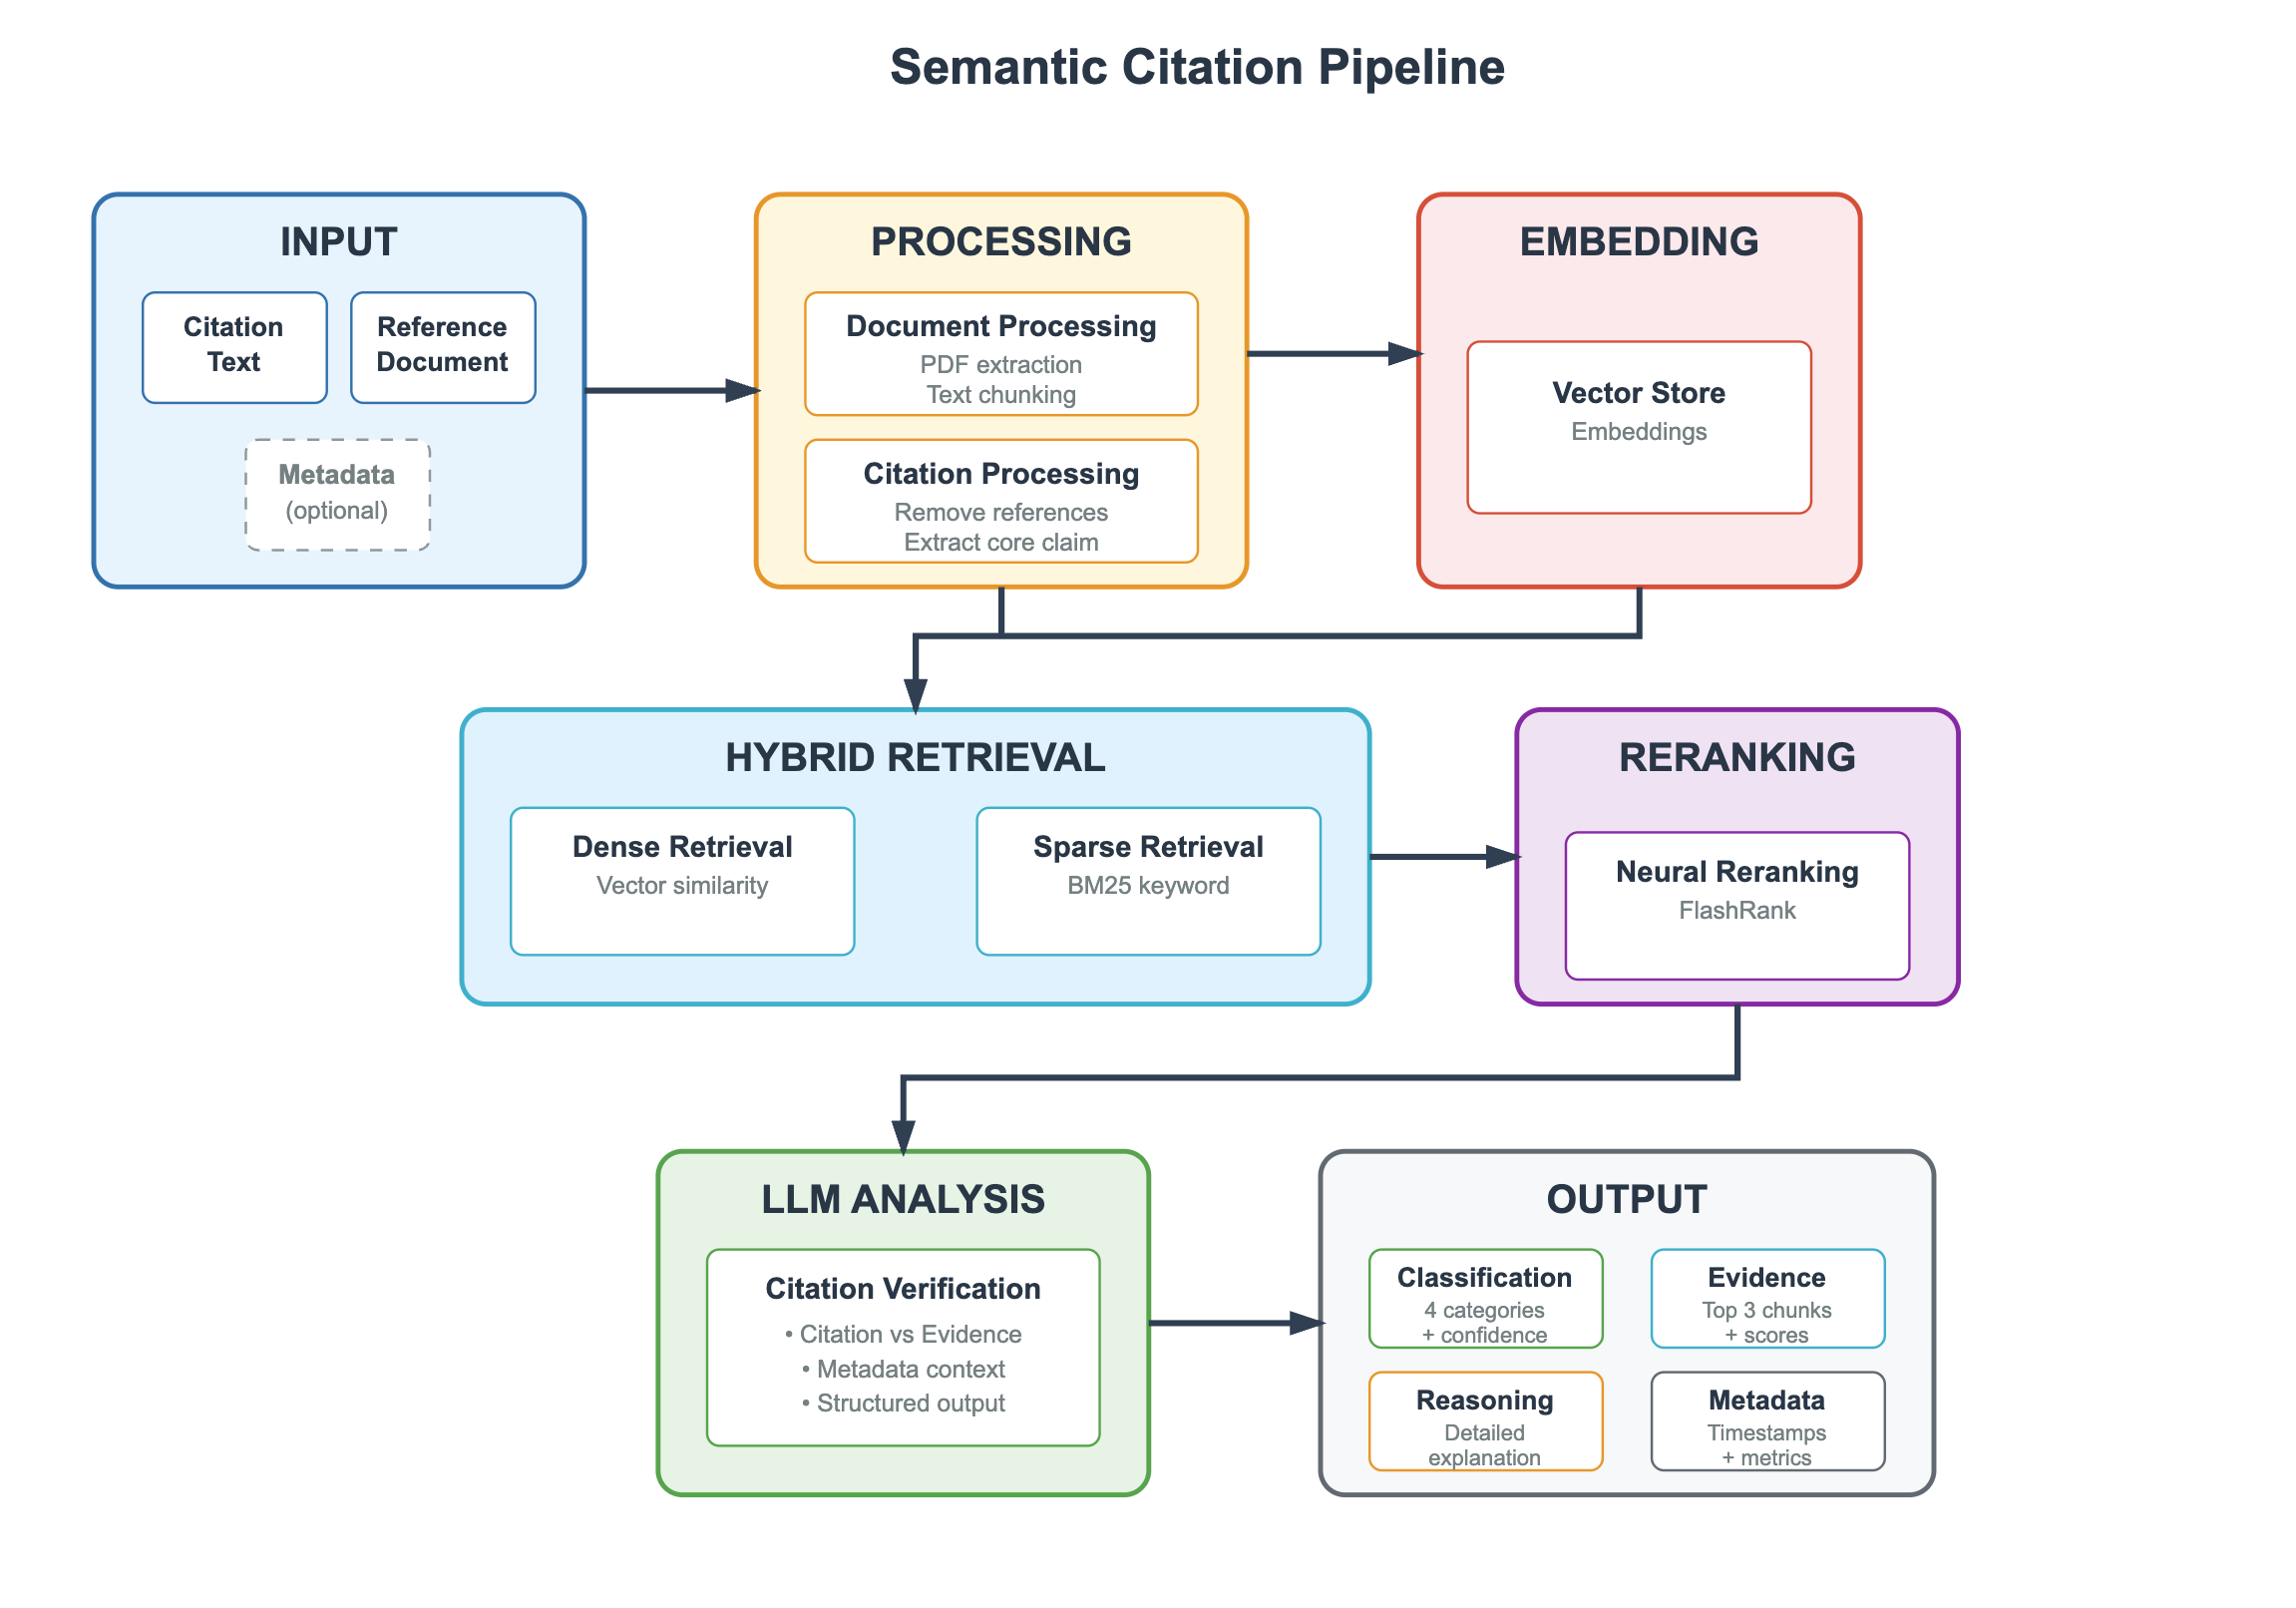
Анализ производственного конвейера показывает фиксированный порядок. Входные данные — это текст цитаты, документ-источник и необязательные метаданные. На этапе обработки извлекается текст PDF, он разбивается на фрагменты, список литературы удаляется, чтобы модель не могла «проверить» утверждение, просто прочитав библиографию, и выделяется основное утверждение. На этапе эмбеддингов эти фрагменты сохраняются. Затем гибридный поиск параллельно выполняет плотный векторный поиск и разреженный BM25 — это необходимо, поскольку дисциплинарный жаргон и статистическая нотация часто плохо работают в чистом поиске по эмбеддингам. Нейронное переранжирование — например, FlashRank — сохраняет лучшие фрагменты. Лишь после этого LLM-анализ классифицирует отношения между утверждением и доказательствами.
Полезный результат — не бинарное «пройдено/не пройдено». Агент синтеза должен получать четырёхстороннюю классификацию с уверенностью — подтверждено, опровергнуто, не рассматривается или рассмотрено частично, — а также лучшие фрагменты доказательств и письменное обоснование. Этот паттерн соответствует более широкому движению к объяснимой проверке утверждений на уровне доказательств. Он также соответствует тому, что уже рекомендуют университетские учебные подразделения, когда описывают помощников AI, которые извлекают доказательства, а не придумывают нарратив.
Даже при наличии такого конвейера остаются два режима отказа. Во-первых, корректно процитированный вывод автора всё ещё может быть ошибочно классифицирован как факт, если классификатор игнорирует контекст раздела — результаты или обсуждение. Во-вторых, гибридный поиск может найти очень похожее предложение из другой статьи той же области — это дрейф цитирования через перефразирование. Поэтому проверка лучших фрагментов человеком является частью метода, а не признанием поражения.
Рабочие процессы Jenova могут приблизить этот конвейер, требуя цитату вместе с указателем на местоположение до допуска утверждения в меморандум синтеза, а затем используя Deep Research для второго прохода по той же библиографии. Они не заменяют специализированный сервис проверки цитат с фиксированными метриками оценки. Для глав диссертации и журнальных публикаций экспортируйте таблицу доказательств и проверяйте её.
Как инструктировать исследовательского агента AI разделять факты, выводы и умозаключения?
Инструктируйте агента с помощью постоянного протокола, который определяет метки, запрещает молчаливое повышение статуса утверждения и требует таблицу противоречий до создания любого междоменного нарратива. Выбор инструмента важен, но промпты без меток приведут к схлопыванию FCI на любой платформе.
Для Academic Research Assistant от Jenova надёжная настройка выглядит так:
- Откройте агента на jenova.ai/a/academic-research-assistant и укажите исследовательский вопрос, дисциплины в области рассмотрения и временные границы.
- Вставьте постоянный протокол FCI — сохраните его в пользовательских инструкциях, если те же правила должны действовать между сессиями:
«Рабочий протокол: маркируй каждое предложение как [ФАКТ], [ВЫВОД АВТОРА] или [ВЫВОД AI]. Для фактов требуется указатель на источник. В выводах авторов должны быть названы статья и сохранены оговорки. Вывод AI включает любое междоменное сопоставление, каузальный скачок или рекомендацию, не сформулированные источником. Если доказательства противоречат друг другу, не усредняй их. Подготовь таблицу: Утверждение | Слой | Источник | Указатель | Согласованность (подтверждает / противоречит / отсутствует)».
- Сформируйте исходный корпус. Прикрепите PDF, которым вы уже доверяете, затем запросите дополнительное выявление источников, а не позволяйте первому поиску определить область.
- Требуйте многоуровневый результат: аннотированную библиографию, результаты с тегами FCI, а затем краткий синтез, который не может вводить новые факты.
Промпт первого обращения, обычно создающий пригодную структуру:
«Вопрос: Как связаны интенсивность городского острова тепла, качество жилья и экстренные госпитализации по поводу сердечно-сосудистых заболеваний в городах стран с высоким доходом с 2015 года? Дисциплины: климатология, эпидемиология, городская экономика. Результат: (1) карта источников, (2) результаты с тегами FCI, (3) журнал противоречий, (4) выводы AI, перечисленные последними и отмеченные как непроверенные. Не цитируй ничего, что не было найдено.»
Для Elicit эквивалентная дисциплина обеспечивается дизайном столбцов, а не метками в прозе. Создайте отдельные поля извлечения для представленного результата, интерпретации авторов, популяции и выявленных ограничений, следуя рабочему процессу от вопроса к извлечению этого инструмента. Не используйте один столбец «главный вывод»; именно в нём глаголы из раздела обсуждения повышаются до статуса результатов.
Для универсального чат-бота добавьте состязательную проверку, необходимость которой следует из исследования Nature: требуйте цитаты, а затем независимо находите каждую ссылку в библиотечной базе данных. Просьба к той же модели «реальна ли эта цитата?» ненадёжна. Если проект представляет собой систематический обзор, используйте инструменты скрининга, описанные в библиотечных рекомендациях по синтезу доказательств, для решений о включении материалов и не привлекайте чат-бот к определению соответствия критериям.
Deep Research в Jenova — более подходящее продолжение работы, когда библиография велика и нужен второй проход с плотными цитатами. Используйте его после внедрения правил FCI, а не как первый немаркированный обзорный поиск.
Что говорят методологи исследований о происхождении доказательств, созданных AI?
Методологи исследований рассматривают немаркированный синтез AI как ошибку отчётности, а не как повышение производительности: если читатель не видит, к какому слою относится предложение, документ ещё не является доказательством. Эта позиция согласуется с требованием PRISMA к прозрачному синтезу и с исследованиями целостности цитирования, которые считают сфабрикованные ссылки угрозой доказательной базе.
«Режим сбоя, который мы видим, состоит не в том, что модели не способны читать статьи. Они пишут единым эпистемическим голосом. Число из метода, оговорка из раздела обсуждения и междисциплинарная аналогия выходят из модели как одинаково уверенный английский текст. Затем междисциплинарные комитеты спорят о выводе, хотя должны спорить о слое. Если предложение не может ответить на вопросы: „кто это утверждал?“ и „это было измерено или выведено?“, оно не должно входить в справку о результатах».
«Маркировка FCI обходится дешевле, чем последующий отзыв. Команды, которые требуют указатели до синтеза, тратят больше времени на первом проходе и гораздо меньше времени на распутывание дрейфа цитирования. Исследование Nature о ChatGPT всё ещё остаётся предостерегающим ориентиром: даже значительное снижение числа фабрикаций оставляет остаточные уровни ошибок, неприемлемые для списка литературы. Происхождение данных — это система контроля. Беглость текста ею не является».
«Конвейеры оркестрации и проверки цитирования позволяют реализовать этот стандарт на практике. Ищите материалы по дисциплинам параллельно, если они не разделяют общих конструктов. Проверяйте утверждения по фрагментам до их передачи синтезатору. Сохраняйте интегративный шаг модели в отдельном именованном блоке. Такая архитектура более консервативна, чем резюме чат-бота, и в этом её смысл».
— Команда продукта Jenova, проектирование исследовательских агентов AI, восемь лет разработки рабочих процессов поиска и атрибуции для научных и профессиональных пользователей
Вывод для выбора инструмента узок. Предпочитайте системы, способные удерживать протокол, показывать источники и допускать противоречия. Не отдавайте предпочтение системам, которые просто звучат междисциплинарно.
Когда человеческая проверка должна отменять синтез AI между дисциплинами?
Человеческая проверка должна отменять синтез AI всякий раз, когда утверждение меняет решение, пересекает границу дисциплинарных методов или не может быть привязано к указателю на местоположение, — а это относится к большей части работы, ради которой синтез вообще оправдан. AI — это множитель возможностей для черновой работы и поиска. Он не является эпистемическим авторитетом.
Отмена результата не подлежит обсуждению как минимум в пяти случаях:
- В синтезе появляется каузальный язык, которого нет в разделе результатов цитируемой работы.
- Возможна несовместимость конструктов — например, «стресс» в психологии, «аллостатическая нагрузка» в медицине и «волатильность» в экономике.
- Рассматриваются руководства или право; в контролируемых тестах показатели галлюцинаций в юридических запросах были особенно высокими.
- Подразумевается статистическое объединение результатов. Языковые модели не проводят обоснованный метаанализ, перефразируя аннотации, а PRISMA 2020 существует именно для обзоров, включающих синтез.
- Проверка цитирования не выполнялась по PDF. В 2026 году выдуманные или изменённые ссылки всё ещё достаточно распространены, чтобы журналы и библиотеки считали их проблемой добросовестности.
Практическое разделение труда выглядит так. Academic Research Assistant предлагает карту источников, теги FCI и журнал противоречий. Elicit или инструмент скрининга отвечает за структурированное извлечение, когда корпус представляет собой формальный обзор. Методолог-человек принимает решения о повышении статуса слоёв и обо всех междоменных выводах. AI может предложить сопоставление; повысить его статус может только человек.
При таком использовании синтез AI не заменяет междисциплинарное суждение. Это способ сохранять факты, выводы авторов и выводы модели в раздельных, проверяемых потоках, чтобы суждение опиралось на честную основу.
Источники
- Rules Integrity Initiative — Происхождение данных и отмывание источников
- Walters & Wilder, Scientific Reports — Фабрикации и ошибки в библиографических цитатах, созданных ChatGPT
- Forbes — AI обвиняют в росте сфабрикованных цитат в научных статьях, 2026
- Enago — Галлюцинации AI в исследовательских цитатах, 2026
- MIT Sloan — Борьба с галлюцинациями и предвзятостью AI, включая показатели Stanford HAI по юридическим запросам
- Библиотеки Университета Джорджа Мейсона — Инструменты AI для литературных обзоров
- King's College London — Инструменты AI в синтезе доказательств
- Заявление PRISMA 2020
- Page et al., The BMJ — Заявление PRISMA 2020
- EQUATOR Network — Руководство PRISMA по отчётности
- Elicit — AI для научных исследований
- Paperguide — Сравнение Elicit и Scite, 2026
- PapersFlow — Elicit и Consensus AI
- The Drive AI — Elicit, Consensus и Semantic Scholar
- Omid Saffari — Лучшие исследовательские инструменты AI 2026
- Библиотека UNC Charlotte — Галлюцинированные цитаты AI
- Wu et al., AAAI — Сети вывода доказательств для интерпретируемой проверки утверждений
- PaperTrail — Интерфейс утверждений и доказательств для обоснования научного вывода LLM, arXiv
- Zhang et al., EACL — Мультимодальная и объяснимая проверка утверждений
- Университет Айовы — Литературные обзоры с поддержкой AI