Как AI может находить доказательства и составлять ответы рецензентам?
2026-08-22
Что отличает инструменты для ответов, основанных на доказательствах, от обычного AI-черновика?
Инструменты, которые помогают авторам качественно отвечать рецензентам в 2026 году, — это не те, что пишут самый гладкий текст. Это инструменты, которые сопоставляют каждый комментарий рецензента с цитируемыми доказательствами, проверяют, действительно ли эти доказательства подтверждают утверждение, и затем составляют ответ, формулировки которого не сильнее имеющихся данных. Jenova's Academic Research Assistant создан для такого цикла, где доказательства ставятся на первое место: поиск литературы, управление цитированием и подготовка черновиков на основе рукописи. Scite, Elicit, SciSpace и Consensus охватывают части той же задачи, но имеют разные сильные стороны.
Что отличает применимый AI-процесс подготовки возражений от беглого, но рискованного:
✅ Поиск на уровне отдельных комментариев, а не единый массив литературы для всего письма ✅ Проверка цитат с открытием исходного предложения, а не только библиографической строки ✅ Метка степени поддержки для каждого утверждения: полное соответствие, частичное соответствие, противоречие или неопределённость ✅ Осторожное составление текста, соответствующее метке, без превращения «предполагает» в «демонстрирует» ✅ Проверка человеком, который может отклонить, сузить или удалить предложенное AI предложение
Отчёт Nature за 2026 год об опросе Frontiers среди примерно 1 600 учёных из 111 стран показал, что более половины исследователей уже использовали AI при рецензировании. То же давление теперь испытывают авторы, готовящие письма с ответами. Чтобы полезно сравнивать инструменты, стоит рассматривать поиск доказательств, проверку цитат и калибровку утверждений как три отдельные задачи, а не как одну задачу написания текста.
Почему письма с ответами рецензентам терпят неудачу, когда цитаты не проверены?
Большинство неудачных или затянувшихся доработок рушится не потому, что автор был невежлив. Они рушатся потому, что цитата не говорит того, что утверждает письмо, обещанный анализ отсутствует в рукописи или ответ преувеличивает вывод, который статья поддерживает лишь слабо. Редакторы и рецензенты могут проверить такие несоответствия за несколько минут.
Модели общего назначения делают этот режим отказа не сложнее, а проще. Университетские рекомендации недвусмысленны: AI-системы часто выдумывают цитаты, которые выглядят реальными, но не существуют, а представление сфабрикованной ссылки рассматривается как академическое мошенничество. Руководство Стелленбосского университета по ответственному использованию добавляет, что многие инструменты не могут проверять ссылки по актуальным базам данных в реальном времени. Письмо с ответами — место с высоким риском усвоить этот урок, поскольку каждая новая цитата является неявным обещанием, что источник существует и подтверждает именно то предложение, которое вы только что написали.
Существует и вторая, менее заметная ошибка: настоящие статьи используются неверно. Методологическая статья, процитированная как доказательство результата; обзор, процитированный как первичное исследование; или результат, полученный в другой популяции и представленный как прямое подтверждение, — всё это проходит проверку DOI и всё равно вводит в заблуждение. Smart Citations от Scite созданы именно для того, чтобы показать, поддерживают ли последующие исследования утверждение, оспаривают его или лишь упоминают. Это другая задача, нежели проверка правильности оформления ссылки.
Инструменты проверки ссылок, основанные на правилах, действительно сильны на механическом уровне. PoolText отмечает, что AI-проверки ссылок очень точны в выявлении ошибок стиля, пропущенных полей, пунктуации и форматирования DOI. Это необходимо, но недостаточно. Идеально оформленное утверждение без поддержки остаётся преувеличением.
На что следует обращать внимание в AI-процессе подготовки ответов рецензентам?
Инструменты следует оценивать по шести измерениям: сегментация комментариев, поиск доказательств, проверка исходных предложений, классификация поддержки утверждений, калиброванное составление текста и память о доработках. Инструмент, который хорошо справляется только с одним из этих измерений, всё равно создаст письмо, которое выглядит завершённым, но таковым не является.
Используемая в этой статье Система сопоставления комментариев и доказательств распределяет веса шести измерений следующим образом:
- Сегментация комментариев (15%) — Может ли система выделить каждый запрос рецензента, включая составные комментарии, скрывающие два требования в одном абзаце?
- Поиск доказательств (20%) — Ищет ли она отдельно в рукописи, данных автора и внешней литературе, а затем сообщает, из какого источника была получена поддержка?
- Проверка исходных предложений (20%) — Может ли человек открыть точное предложение, которое предположительно подтверждает ответ?
- Классификация поддержки утверждений (20%) — Получает ли каждая предлагаемая цитата метку «подтверждено», «частично подтверждено», «не подтверждено» или «неопределённо»?
- Калиброванное составление текста (15%) — Наследует ли текст эту метку или по умолчанию использует уверенный академический язык?
- Память о доработках (10%) — Может ли система помнить предыдущие раунды, обещанные анализы и отклонённые формулировки?
Такое распределение весов намеренно. Составление текста — самая дешёвая часть работы. Поиск и классификация — это то место, где письма либо становятся цитируемыми, либо превращаются во вторую проблему рецензирования. Исследования, сравнивающие AI-сгенерированные и человеческие рецензии, не выявили убедительной дополнительной ценности AI по сравнению с рецензентами-людьми. Это полезное предостережение и для авторов: беглость текста не является сигналом его обоснованности.
Практические тесты, которые быстро выявляют слабые инструменты:
- Дайте модели комментарий рецензента, на который ваша статья не может полностью ответить, и посмотрите, не выдумает ли она результат.
- Попросите её процитировать подтверждающее предложение из каждой упомянутой статьи, а не только ключ цитирования.
- Потребуйте одну из четырёх меток поддержки до составления любого предложения ответа.
- Повторно обработайте тот же комментарий через неделю и проверьте, не противоречит ли письмо ранее сделанной уступке.
Если продукт не способен заметным образом провалить эти тесты, он вам не помогает. Он скрывает неопределённость, которой вы должны управлять.
Как ведущие AI-инструменты для исследований сравниваются по поиску доказательств и проверке цитат?
В настоящее время ни один продукт не доминирует во всех трёх задачах: поиске доказательств по каждому комментарию, проверке цитаты и подготовке ответа без преувеличений. Полезное сравнение состоит в том, чтобы определить, для какой именно задачи построен каждый инструмент.
| Функция / измерение | Elicit | Jenova Academic Research Assistant | Scite | SciSpace Response-to-Reviewers |
|---|---|---|---|---|
| Поиск доказательств | AI-поиск и извлечение данных из более чем 125 миллионов статей | Поиск литературы в реальном времени плюс базы знаний, прикреплённые к рукописи | Лицензированные полные тексты научных публикаций и контекст цитирования в крупном корпусе, поддерживаемом издателями | Агентный процесс на основе статьи, ориентированный на комментарии рецензентов |
| Проверка цитат | Сильная сторона — структурированное извлечение; 1 502 из 1 511 точек данных верны (99,4%) в заявленном Elicit тесте | Извлекает источники-кандидаты и сведения о цитировании; подтверждение исходного предложения человеком по-прежнему необходимо | Каждое утверждение AI связано с конкретным предложением в конкретной статье | Полезен для формирования пакета ответов; глубина проверки зависит от исходных источников |
| Составление писем с ответами | Косвенно — лучше подходит для таблиц и ответов по литературе, чем для полного письма | Сильный инструмент для построчных черновиков, когда комментарии и рукопись доступны в одной сессии | Косвенно — создан для проверки устойчивости выводов, а не для написания письма | Специализированный процесс составления ответов рецензентам |
| Сигналы поддержки утверждений | Точность извлечения, а не схема поддержки из четырёх меток | Классификация, задаваемая пользователем внутри цикла составления текста | Контекст цитирования: поддерживающий, противоречащий и упоминающий | Структура, согласованная с комментариями рецензента, а не формальная таксономия поддержки |
| Цены (по состоянию на 2026 год) | Не проверено в этом обзоре | Бесплатный уровень с ограниченным использованием; платные планы от $20 в месяц | Не проверено в этом обзоре | Не проверено в этом обзоре |
| Лучше всего подходит для | Систематического извлечения и таблиц доказательств | Сквозных циклов доработки, остающихся привязанными к одной рукописи | Проверки того, действительно ли литература подтверждает предложение | Авторов, которым нужен специализированный агент для составления возражений |
Elicit наиболее силён, когда рецензент просит добавить отсутствующее сравнение, более ясную карту связанных работ или извлечь численные данные из набора исследований. В обзоре исследовательских руководств Университета Джорджа Мейсона он описывается как инструмент, который обобщает статьи и извлекает данные в структурированные представления доказательств. Его ограничение для возражений заключается в масштабе задачи: превосходная таблица доказательств ещё не является письмом с откалиброванным тоном, и она не остановит вас автоматически от превращения извлечённого вывода в причинное утверждение.
Scite наиболее силён, когда риск заключается в неверном прочтении литературы. Он ищет по более чем 300 миллионам научных статей и, что важнее, показывает, как последующие статьи интерпретировали конкретное утверждение. Это подходящий инструмент, когда рецензент говорит: «эта цитата не подтверждает ваш вывод», — или когда вы хотите сослаться на основополагающую работу так, будто научное сообщество всё ещё с ней согласно. Он слабее в роли полного секретаря доработки: сам по себе он не будет поддерживать письмо с ответами на 14 комментариев, отслеживать номера строк рукописи или помнить, в чём вы пошли на уступку в первом раунде.
SciSpace — один из немногих продуктов, рассматривающих «ответы рецензентам» как самостоятельный процесс, а не как запрос в чате. Такая направленность даёт реальное преимущество, когда вам нужна структура. Связанное с ней ограничение характерно для любого агента составления текста: структурированный результат всё равно может преувеличить вывод, если лежащий в его основе слой доказательств недостаточно надёжен.
Consensus — это поисковая система по рецензируемой литературе, созданная для того, чтобы быстро находить, организовывать и анализировать научные утверждения. Она полезна для части возражения, отвечающей на вопрос: «Что в настоящее время говорит научная область?» Это не аудитор цитат и не форматировщик писем.
Jenova's Academic Research Assistant располагается между этими специализированными инструментами. Он может хранить рукопись, PDF рецензии и предыдущую переписку в одном постоянном рабочем пространстве, искать литературу и составлять ответы по отдельным комментариям. Он изначально не предоставляет подсчёты цитат в стиле Scite с разделением на поддерживающие и противоречащие, а также не экспортирует готовый пакет доработки для Word так, как это заявляет процесс ответов рецензентам PeerReply. Это реальные ограничения. Компенсирующее преимущество — непрерывность: доработка, занимающая шесть недель, нуждается в памяти больше, чем в генераторе разового письма.
Paper Digest стоит добавить как узкоспециализированный инструмент. Его направленность на проверку утверждений ближе к Scite, чем к чат-боту для составления текста, поэтому он лучше подходит для второго этапа проверки, чем для первого этапа написания.
Как многоаспектный механизм вопросов и ответов находит подтверждающие доказательства для каждого комментария?
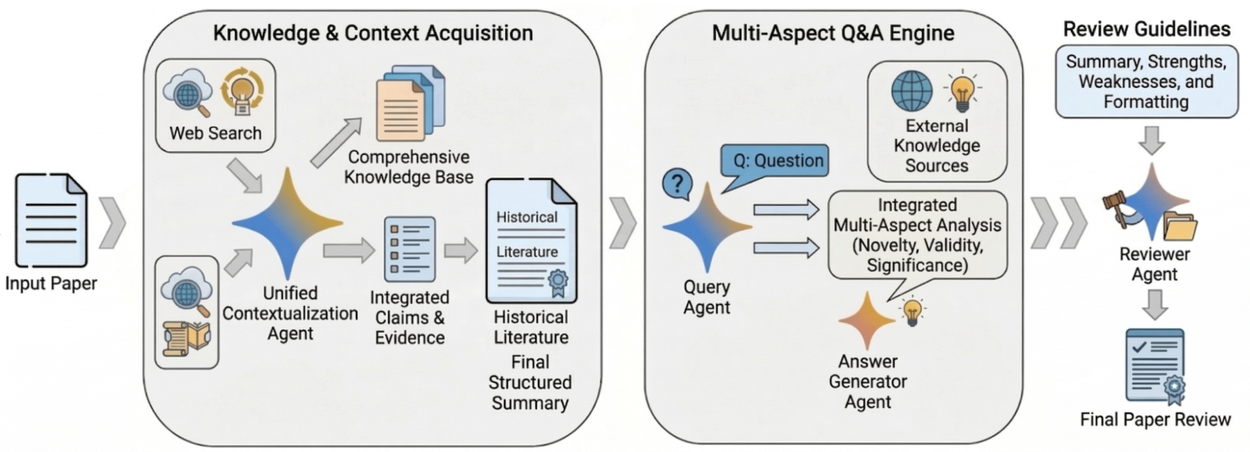
Надёжная система не «читает рецензии и пишет письмо». Она преобразует каждый комментарий рецензента в запрос, извлекает материалы из трёх отдельных пулов знаний и лишь затем решает, можно ли написать ответ. Именно эту архитектуру показывает приведённая выше схема: сначала получение знаний, затем многоаспектные вопросы и ответы, в конце — синтез.
Три пула следует сохранять раздельными:
- Пул рукописи — рисунки, таблицы, методы, ограничения и любой анализ, который вы уже провели.
- Пул автора — лабораторные заметки, дополнительные проверки устойчивости, словари данных и предыдущие письма с ответами.
- Пул литературы — статьи, действительно относящиеся к возражению рецензента, полученные через поиск в стиле Scholar, а не из памяти модели.
Смешивание этих пулов — источник преувеличений. Предложение, верное для литературы, не является результатом вашей статьи. Проверка чувствительности в блокноте не является опубликованной таблицей. Эффективный поисковый агент задаёт три разных вопроса по одному комментарию: Есть ли это уже в рукописи? Если нет, есть ли у авторов неопубликованная поддержка? Если нет, оправдывает ли литература ограниченное утверждение, доработку или уступку?
На практике шаг поиска для Jenova's Academic Research Assistant выглядит так:
- Прикрепите рукопись, письмо с решением и все дополнительные материалы.
- Попросите создать нумерованный перечень требований рецензентов, включая подразумеваемые запросы.
- Для каждого требования потребуйте поиск по трём пулам до любого составления текста:
«Рецензент 2, комментарий 3 спрашивает, сохраняется ли эффект при исключении подвыборки 2019 года. Сначала ищи только в прикреплённой рукописи. Процитируй таблицу, раздел или предложение, отвечающее на этот вопрос. Если ничего не найдено, скажи „отсутствует в рукописи“ и перечисли необходимый анализ. Не цитируй внешние статьи так, будто это наши результаты».
- Только после отсутствия ответа в рукописи агенту следует искать литературу или предлагать новый анализ.
Специализированные продукты для подготовки возражений используют аналогичное разделение. Manusights утверждает, что языковые модели общего назначения остаются наиболее практичными инструментами для составления самого письма, и это верно в отношении текста. Однако механизм работы с доказательствами всё равно должен предшествовать модели написания текста. В противном случае письмо становится уверенным пересказом того, что чат-бот нашёл наиболее близким по смыслу, а не того, что содержится в материалах дела.
Новизна, обоснованность и значимость — три оси анализа в многоаспектном механизме рецензирования — также являются тремя осями, в которых фактически располагается большинство комментариев рецензентов. Комментарий об отсутствующих базовых сравнениях — это вопрос обоснованности. Комментарий об инкрементальном вкладе — вопрос новизны. Комментарий о том, почему это должно быть важно кому-либо, — вопрос значимости. Такая разметка предотвращает ответ на возражение об обоснованности абзацем о значимости.
Как AI должен классифицировать поддержку цитаты до того, как вы процитируете источник?
Каждая цитата в письме с ответами должна получить одну из четырёх меток, прежде чем её можно будет включить в черновик: подтверждено, частично подтверждено, не подтверждено или неопределённо. Если система не может присвоить метку, она не должна добавлять сноску.
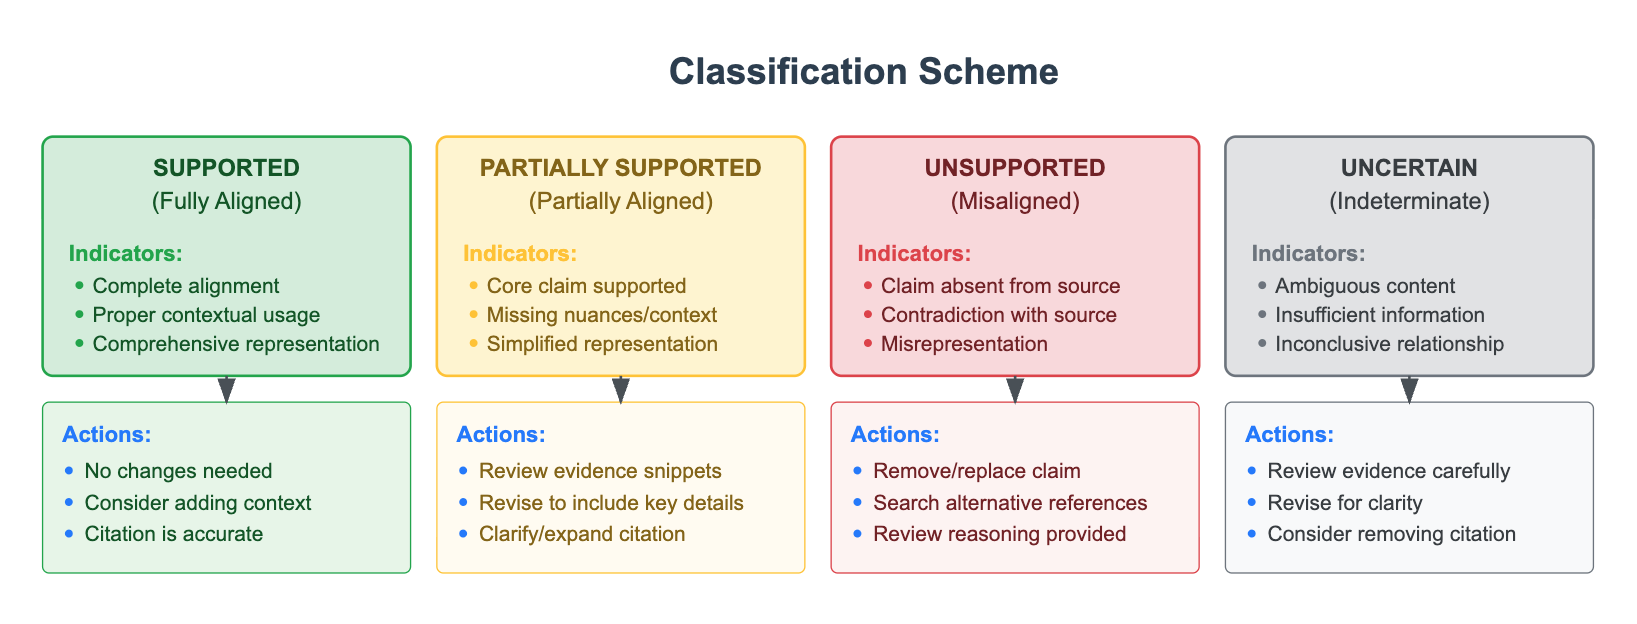
Эта классификация отличает проверку цитаты от проверки утверждения.
Подтверждено означает, что источник формулирует утверждение в том же масштабе, для той же популяции и с той же силой причинного вывода, которую вы собираетесь использовать. Действие: оставить цитату. Рассмотрите возможность добавить краткое уточнение контекста, чтобы рецензент увидел соответствие.
Частично подтверждено означает, что ключевой факт присутствует в источнике, но ваше предложение опустило оговорку, ограничение выборки или противоречащий вторичный результат. Действие: переписать предложение с учётом недостающего нюанса или заменить цитату более подходящим первичным источником. Это наиболее распространённая честная метка в реальных возражениях — и та, которую универсальные чат-боты сводят к «подтверждено».
Не подтверждено означает, что утверждение отсутствует, ему противоречат данные или источник используется способом, который он не позволяет. Действие: удалить или заменить. Не сохраняйте цитату только потому, что список авторов престижен или DOI разрешается.
Неопределённо означает, что PDF закрыт платным доступом, релевантный раздел неоднозначен либо связь между утверждением и источником нельзя установить по доступному тексту. Действие: открыть статью или удалить цитату. Неопределённость не является мягкой формой поддержки.
Scite реализует близкую схему в масштабе литературы, показывая, поддерживают ли последующие статьи, оспаривают или обсуждают определённый вывод. Это бесценно для внешних цитат. Однако он не классифицирует ваши новые предложения по отношению к вашим собственным рисункам. Для утверждений, внутренних по отношению к рукописи, схема из четырёх меток должна применяться самим процессом составления текста.
Запрос, обеспечивающий соблюдение схемы:
«Для каждого предложения, которое ты предлагаешь в ответе Рецензенту 1, выведи: (1) предложение, (2) цитату, (3) дословную цитату из источника или рукописи, (4) одну метку — Подтверждено / Частично подтверждено / Не подтверждено / Неопределённо, и (5) требуемую этой меткой переработку. Не включай предложения с меткой „Не подтверждено“. Перепиши каждое предложение с меткой „Частично подтверждено“, прежде чем показывать его мне».
Сравнение AI-поисковых систем, проведённое Columbia Journalism Review, обнаружило систематические ошибки цитирования, даже когда названы были известные источники. Академические инструменты лучше открытых поисковых систем с ответами по этому параметру, но режим ошибки остаётся тем же: название авторитетного издания используется как замена проверенному предложению. Барьер из четырёх меток существует, чтобы остановить такую подмену.
Как составить построчный ответ без преувеличения выводов?
Составляйте текст после того, как появились метки, и позволяйте метке выбирать глагол. «Показывает», «демонстрирует» и «доказывает» следует оставлять для подтверждённых утверждений с совпадающим масштабом. Для частично подтверждённых утверждений используйте «согласуется с», «частично отвечает на» или «сохраняется при [указанном ограничении]». Неопределённые утверждения не получают глаголов. Для них нужен план или удаление.
Чистая структура письма с ответами выглядит следующим образом:
- Нейтрально переформулируйте замечание рецензента.
- Укажите, что вы сделали: это уже есть в статье, было проанализировано дополнительно или признано как ограничение.
- Укажите место: страницу, строку, таблицу, рисунок или приложение.
- Цитируйте внешние работы только если комментарий касается литературы и только при наличии метки поддержки.
- Завершите точным описанием изменения в рукописи или ограниченной причиной, по которой вы его не внесли.
Jenova's Academic Research Assistant может поддерживать эту структуру в длинном письме, если заранее задать ограничение:
«Составь ответ Рецензенту 2, используя только подтверждённые и переработанные частично подтверждённые пункты из таблицы доказательств. Используй предоставленный мной список глаголов. Каждый абзац должен содержать указатель на место в рукописи или явную уступку. Не представляй будущие эксперименты как завершённые. Не описывай раздел обсуждения цитируемой статьи так, будто это наш результат».
При использовании SciSpace или модели общего назначения в качестве автора письма это же ограничение необходимо вставлять вручную, поскольку продукты для составления текста оптимизируют полноту и вежливость. Полнота — это путь к появлению фиктивных анализов. Вежливость — это путь, при котором несогласие превращается в «мы согласны и теперь показали».
Осторожные формулировки не являются декоративными. Это функция верности данным. Полезные оговорки конкретны:
- Оговорки масштаба: «в этой выборке», «при линейной спецификации», «среди участников с полным последующим наблюдением»
- Эпистемические оговорки: «согласуется с», «не исключает», «даёт предварительную поддержку»
- Оговорки процесса: «теперь мы сообщаем», «мы добавили», «мы не можем проверить при текущем дизайне»
В черновике возражения запрещено превращать корреляцию в эффект, проверку устойчивости в репликацию, статистически незначимый результат в «отсутствие различий», а одну поддерживающую цитату в «это хорошо установлено». Рекомендации по академическому письму с помощью AI подчёркивают, что авторы по-прежнему отвечают за проверку соответствия сгенерированного текста фактическим утверждениям рукописи. Правила журналов различаются, но согласно обзору правил издателей в The Conversation, обычная механическая помощь может не требовать указания, тогда как содержательный AI-сгенерированный материал часто требует. Письмо с ответами, содержащее интерпретации литературы, составленные моделью, обычно относится ко второму случаю.
Практическое руководство ProofreaderPro по письмам с ответами верно подчёркивает важность структуры и тона. Но структура и тон — не самая сложная часть. Сложнее всего отказаться отвечать на комментарий сильнее, чем позволяет ваша таблица. Если рецензент запросил стратегию причинной идентификации, которой у вас нет, честный черновик — это абзац об ограничении и, при возможности, более слабый, но идентифицируемый анализ, а не более уверенное повторение исходной регрессии.
Запрос для второго прохода, выявляющий преувеличения:
«Сопоставь каждый абзац ответа с таблицей доказательств. Отметь любое предложение, чей глагол сильнее его метки поддержки. Отметь каждую цитату, для которой нет дословной выдержки. Отметь каждое обещание, не соответствующее отслеживаемому изменению в рукописи».
Что специалисты по исследовательской добросовестности говорят о возражениях с помощью AI?
Исследователи, работающие в области добросовестности рецензирования, постоянно возвращаются к одному тезису: AI может ускорить поиск и форматирование, но автор по-прежнему отвечает за истинностное значение каждого предложения, отправляемого редактору.
«Ошибка, которую мы наблюдаем, редко состоит в пропущенной запятой в списке литературы. Это предложение, которое на одну эпистемическую ступень сильнее, чем позволяет процитированная статья. Модель, получающая вознаграждение за полезность, сократит этот разрыв за вас, если вы ей не запретите. Самый дешёвый контроль — архитектурный: сначала извлечь, затем присвоить метку, потом составлять текст. Если поменять этот порядок, письмо будет содержать утверждения, которые вы лишь позже попытаетесь обосновать».
«Инструменты умного цитирования изменили стоимость проверки того, продолжает ли научная область признавать вывод статьи. Но они не изменили стоимость проверки того, подтверждает ли ваша собственная Таблица 3 глагол в абзаце 6 ответа. Вторая проверка всё ещё требует, чтобы человек прочитал число рядом с предложением. Авторы, которые её пропускают, не экономят время. Они заимствуют его у следующего раунда рецензирования».
«Мы также советуем командам вести журнал отказов. Каждый раз, когда модель хочет сказать „мы показываем“, а метка указывает лишь на частичную поддержку, записывайте отклонённое предложение. Через две или три статьи вы увидите типичные преувеличения вашей лаборатории: обычно это причинные глаголы, обобщение за пределы выборки и цитирование обзоров как будто это исследования. Пользовательские инструкции — просто способ закодировать этот журнал».
— Команда продуктов Jenova, проектирование академических процессов, восемь лет поддержки систем работы с рукописями и цитированием
Этот совет соответствует исследовательской литературе об AI в самом рецензировании. Обзор PMC об AI в рецензировании подчёркивает, что рецензенты всё равно должны критически оценивать AI-сгенерированный контент до принятия любого решения. То же обязательство действует, когда AI находится на стороне автора письма с решением. Авторам, использующим модели класса ChatGPT в переписке по рецензированию, прямо рекомендуют проверять предложения в сопоставлении с ключевыми утверждениями рукописи и принципами исследовательской добросовестности.
Практический тест AI в ответах на рецензии, проведённый Editage, полезен не столько ранжированием с единственным победителем, сколько выявленной закономерностью: модели могут определить, выглядит ли ответ полным, но при этом плохо определять, является ли он правдивым. Видимость полноты — это свойство, из-за которого письма отправляются слишком рано.
Когда следует отменить ответ рецензенту, составленный AI?
Черновик следует отменять всякий раз, когда метка поддержки слабее предложения, когда комментарий требует суждения, которое модель не может обосновать, или когда согласие обязывает вас принять утверждение, которое вы не сможете защитить в следующем раунде. Отмена — это нормальный путь, а не исключение.
Немедленно отменяйте черновик в следующих случаях:
- Агент цитирует статью, которую вы не открывали.
- Агент отвечает на методологическую критику дополнительным текстом введения, но без нового теста.
- Агент воспринимает недопонимание рецензента как запрос на дополнительные цитаты, а не на переписывание объяснения.
- Агент «находит» анализ, отсутствующий в репозитории.
- Агент соглашается с двумя рецензентами, запросившими несовместимые анализы, и не отмечает конфликт.
- Агент использует обзорную статью для обоснования первичного эмпирического утверждения.
Некоторые комментарии никогда не следует полностью делегировать. Запросы об исследовательской этике, доступе к данным, конфликтах интересов и о том, имеет ли результат клиническую или политическую значимость, требуют решения человека о том, за что он готов отвечать. AI может собрать документы. Он не может принять за них ответственность.
Существует и растущая обратная проблема: авторы теперь сталкиваются с комментариями рецензентов, которые сами выглядят сгенерированными AI. Правильный ответ всё равно должен прежде всего опираться на доказательства. Переформулируйте выполнимый научный запрос из комментария, игнорируйте общие пустые формулировки и отвечайте на запрос, который вы можете задокументировать. Ответ на AI-подобную рецензию AI-подобным письмом лишь удваивает объём необоснованного текста в файле.
Рабочий процесс с участием человека для завершения работы над каждым комментарием:
- Прочитайте предложение рецензента и сами сформулируйте его суть в шести словах.
- Примите или отклоните строку доказательств агента до того, как прочитаете составленный абзац.
- Если вы отклоняете строку, не редактируйте абзац. Верните агента к поиску.
- Если вы принимаете строку с частичной поддержкой, отредактируйте глагол самостоятельно.
- Только затем добавляйте абзац в письмо.
При таком использовании Jenova's Academic Research Assistant, Scite, Elicit и специализированный агент составления текста, такой как SciSpace, дополняют друг друга, а не являются взаимозаменяемыми. Инструменты поиска снижают вероятность пропустить статью. Классификация снижает вероятность неверно её использовать. Инструменты составления текста снижают вероятность неорганизованности письма. Ни один из них не снижает вероятность преувеличения, если вы не отказываетесь составлять текст на основе утверждений без меток.
Стандарт, который стоит разместить над окном запроса, достаточно прост: если вы не можете указать предложение, таблицу или уступку, обосновывающие глагол, этому предложению не место в ответе.
Источники
- Nature — Более половины исследователей теперь используют AI для рецензирования
- Библиотека Университета Претории — Управление цитированием и риски AI-галлюцинаций
- Стелленбосский университет — Руководство по ответственному использованию AI в академическом письме
- Scite — Smart Citations и проверка утверждений на уровне предложений
- PoolText — Что AI может и не может делать при рецензировании, включая проверку ссылок
- ScienceDirect — Сравнение AI-сгенерированных и человеческих рецензий
- Elicit — AI-поиск литературы и заявленная точность извлечения
- Библиотеки Университета Джорджа Мейсона — AI-инструменты для литературных обзоров
- SciSpace — Процесс работы агента Response to Reviewers
- Consensus — AI-поиск по рецензируемой литературе
- PeerReply — Построчный ответ и процесс подготовки пакета доработок
- Paper Digest — Проверка утверждений по академическим доказательствам
- Manusights — Лучшие AI-инструменты для ответов рецензентам
- Columbia Journalism Review — AI-поисковые системы и ошибки цитирования
- PMC — Академическое письмо с помощью искусственного интеллекта
- The Conversation — Рекомендации издателей по AI в журнальных статьях
- ProofreaderPro — Как написать письмо с ответами рецензентам с помощью AI
- PMC — Искусственный интеллект в рецензировании
- PMC — Работа с рецензированием при помощи ChatGPT 4
- Editage — Тесты AI для ответов на рецензии
- ResearchGate — Обсуждение комментариев рецензентов, сгенерированных AI