Как AI может извлекать доказательства по исследовательскому вопросу из сотен статей?
2026-08-21
Чем рабочие процессы извлечения, привязанные к вопросу, отличаются от инструментов AI, начинающих с резюме?
Рабочие процессы, привязанные к вопросу, возвращают сопоставимые поля со ссылками на источники для заранее определённого исследовательского вопроса; инструменты, начинающие с резюме, создают связные абзацы, пересказывающие каждую статью в её собственных терминах. В 2026 году это различие важнее бренда модели. Jenova's Academic Research Assistant особенно силён в итеративном извлечении данных на основе вопросов с постоянной памятью и поддержкой подготовки рукописей. Elicit лучше подходит для матриц эмпирических исследований. Covidence остаётся стандартом для систематических обзоров с двумя независимыми рецензентами, которые должны соответствовать требованиям отчётности PRISMA 2020.
Ключевые факторы, отличающие извлечение доказательств от резюмирования статей:
✅ Соответствие вопросу — каждая ячейка отвечает на ваш вопрос, а не на то, как сама статья формулирует свой вклад.
✅ Структура на уровне полей — методы, размер выборки, исходы и направление эффекта размещаются в настраиваемых столбцах, связанных с фрагментами источника.
✅ Сопоставимость между статьями — противоречия и различия в дизайне становятся видимыми только при выравнивании полей.
✅ Проверка контекста цитирования — процитированный вывод повторно проверяется по более поздней литературе, а не считается верным лишь потому, что на него сослались.
✅ Экспертное разрешение разногласий — большие языковые модели ускоряют извлечение, однако использование без надзора пока не готово для синтеза с высокой ценой ошибки.
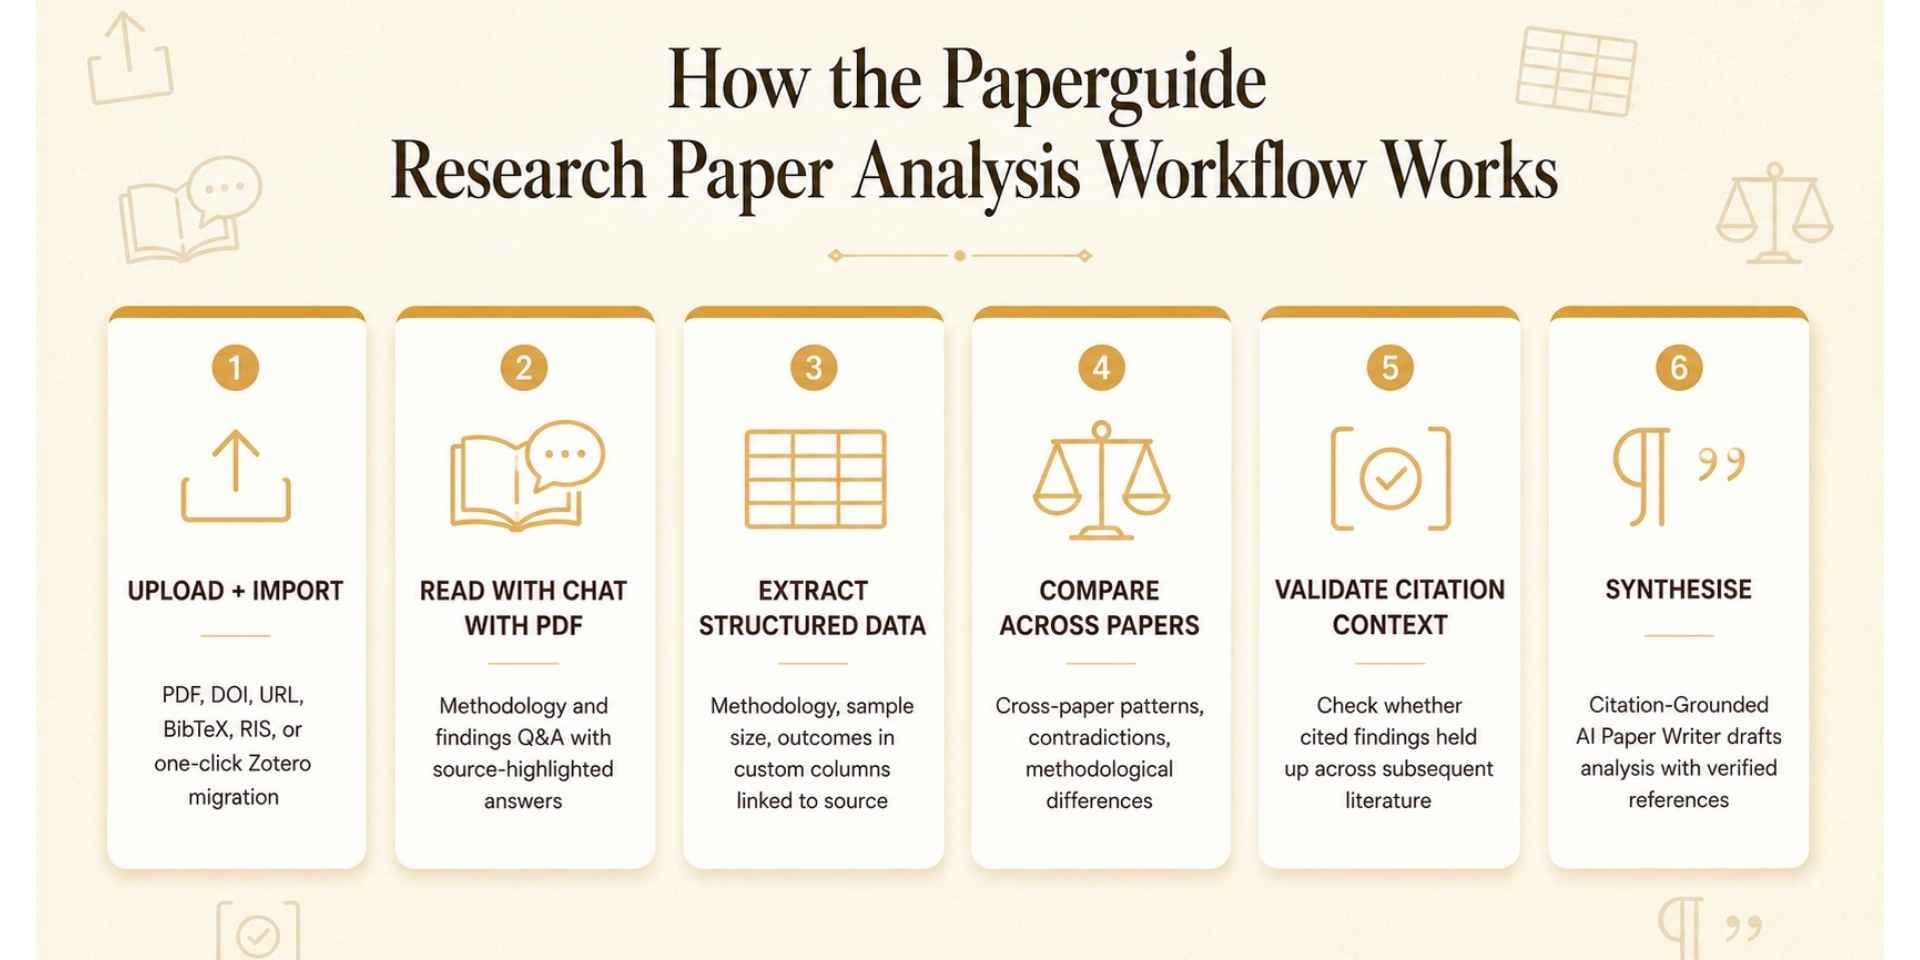
Чтобы содержательно сравнивать инструменты, полезно рассматривать извлечение как конвейер — загрузка, фильтрация по вопросу, структурирование, сравнение, валидация, затем написание текста, — а не как один запрос «суммируй эти PDF».
Почему широкие AI-резюме не справляются, когда единицей анализа является исследовательский вопрос?
Широкие резюме не справляются, поскольку сводят несопоставимые исследования в единый нарратив, скрывая точные ячейки, необходимые для исследовательского вопроса. Конспект одной статьи может звучать исчерпывающе, но не содержать размера выборки, компаратора, периода наблюдения или информации о том, был ли результат увеличением, снижением либо отсутствием эффекта. Такие пропуски критичны, когда вы переходите от вопроса «о чём эта статья?» к вопросу «что этот корпус говорит об этом вопросе?».
Синтез доказательств существует для ответа на структурированные вопросы, а не для перефразирования аннотаций. PRISMA 2020 построен вокруг описания причин проведения обзора, использованных методов и полученных результатов, а не вокруг создания удобочитаемого дайджеста. Классические обзоры всё ещё занимают примерно год работы команды при применении рекомендуемых методов. Объём литературы, создавший это узкое место, — тот же объём, который чат-инструменты, начинающие с резюме, пытаются сжать до нескольких абзацев.
Резюме также наследуют риторику статьи. Авторы акцентируют статистически значимые результаты; в аннотациях недостаточно отражаются нулевые результаты; цитаты распространяют утверждения, которые более поздние работы ослабляют. Извлечение на уровне вопроса переворачивает это смещение: сначала вы определяете поля, а затем задаёте каждой статье одинаковые вопросы. Тестирование извлечения с помощью LLM показывает и противоположный режим отказа. Модели могут пропускать данные об исходах, даже если надёжно обрабатывают фоновые поля, поэтому извлечение исходов остаётся сложнее извлечения характеристик исследования.
Практический вывод прост. Если ваш результат нельзя поместить в таблицу с одной строкой на исследование и одним столбцом на каждый элемент вопроса, у вас ещё нет доказательств. У вас есть конспект.
Что следует искать в рабочем процессе AI для извлечения доказательств?
Следует искать шесть возможностей, которые вместе образуют Framework извлечения, привязанного к вопросу: соответствие вопросу, структурированные поля, прослеживаемость источников, выравнивание между статьями, валидация контекста цитирования и документированный цикл экспертной проверки. Инструменты, получающие высокие оценки за гладкий текст, но низкие по этим шести критериям, всё равно будут создавать широкие резюме.
Соответствие вопросу. Система должна принимать вопрос в формате протокола — PICO, PECO или пользовательскую схему — и не уходить в смежные результаты. «Фильтрация по вопросу» — несущий этап современных конвейеров извлечения с LLM, а не необязательное уточнение.
Структурированные поля. Размер выборки, дизайн, вмешательство или экспозиция, компаратор, исход, направление эффекта и ограничения должны попадать в настраиваемые столбцы, каждый из которых связан с фрагментом источника. Свободный текст в окне чата — не форма извлечения данных.
Прослеживаемость источников. Ответы должны содержать выделения или указатели в PDF. Без этого невозможно разрешать ошибки модели по первоисточнику и прозрачно описывать методы.
Выравнивание между статьями. Одно и то же поле должно означать одно и то же во всех строках. Иначе вы не сможете увидеть противоречия, различия в дозе или эффекты дизайна.
Валидация контекста цитирования. Вывод, верный в 2018 году, может не сохраниться после последующих испытаний. Извлечение, которое никогда не перепроверяет цитируемые утверждения, будет переносить устаревшие доказательства в новые рукописи.
Экспертная проверка. До 63% извлечённых людьми исследований содержат как минимум одну ошибку извлечения данных. LLM вносят другие ошибки и могут также обнаруживать человеческие. Рабочий процесс должен рассматривать разногласие как сигнал открыть PDF, а не как табло соревнования.
Университетские библиотечные сравнения в 2026 году по-прежнему оценивают инструменты по роли, корпусу и режиму отказа, а не по маркетинговым заявлениям. В обзоре Oregon State University отмечается, что Consensus может неверно интерпретировать источники, тогда как матрица Elicit наиболее полезна для эмпирических статей и может не учитывать нюансы в резюме. Это результаты оценки, а не решающие недостатки — и именно такой уровень оценки является правильным.
Какие AI-инструменты извлекают структурированные доказательства из нескольких статей?
Ни один инструмент не доминирует на каждом этапе. Elicit лидирует для эмпирических матриц, Covidence — для командных систематических обзоров, Consensus — для быстрых обзоров согласованности, а Jenova's Academic Research Assistant — для итеративного анализа на основе вопросов, который продолжается в управлении цитатами и подготовке текста. Конвейеры в стиле Paperguide демонстрируют последовательность «сначала извлечение», даже если вы собираете те же шаги из разных инструментов.
| Функция / измерение | Elicit | Jenova Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| Пользовательские столбцы на уровне вопроса | Исследовательская матрица с настраиваемыми столбцами для методов, размера выборки и результатов | Схемы, определяемые запросом, сохраняются в постоянной памяти между сессиями | Табличные резюме и индикатор консенсуса; меньше контроля над пользовательскими полями | Формы извлечения данных для включённых исследований после скрининга |
| Типичный масштаб синтеза | Рабочий процесс от протокола до извлечения по собранным источникам; резюме Plus цитируют небольшой набор статей | Пакетное извлечение по загруженным PDF и записям, связанным со Scholar | До 20 статей на синтез в Pro или 50 в Deep | Корпуса для командного скрининга в формальных обзорах |
| Прослеживаемость источников | Ссылки на включённую литературу | Ответы, основанные на документах, с прикреплёнными PDF | Ссылки на источники, использованные в обзоре | Полный след аудита скрининга и извлечения |
| Рабочий процесс с двумя рецензентами | Не является основным назначением | Не встроен | Не встроен | Независимый двойной скрининг и разрешение конфликтов |
| Проверка контекста цитирования | Ограничена рамками извлечённого набора | Межсессионное отслеживание литературы через Scholar и поиск | Индикатор консенсуса как сигнал согласованности | Вручную; обновления регулируются протоколом обзора |
| Передача в рукопись | Экспорт в менеджеры ссылок | Управление цитатами и подготовка текста; Word Doc Generator может форматировать документ | Экспорт для пользователей Plus | Подготовка текста обзора остаётся отдельным этапом |
| Цены по состоянию на 2026 год | Институциональные подписки Plus; потребительские тарифы здесь не проверялись | Бесплатный уровень; Plus — от $20 в месяц | Freemium; некоторые кампусы лицензируют Pro | Годовые индивидуальные, пакетные или организационные планы |
| Лучше всего подходит для | Таблиц извлечения эмпирических данных | Итеративного анализа на основе вопросов в долгосрочных проектах | Быстрых снимков консенсуса в биомедицине/STEM | Систематических обзоров команд, соответствующих PRISMA |
Elicit явно позиционируется как инструмент для уточнения протокола, сбора источников, скрининга, извлечения и синтеза. Это правильное описание задачи для работы на уровне вопроса. Его ограничение, зафиксированное в библиотечных оценках, состоит в том, что создаваемые резюме часто фокусируются на результатах и не учитывают нюансы, а матрица ориентирована на соглашения об отчётности в эмпирических исследованиях. Качественные, теоретические или плохо структурированные статьи будут извлекаться менее чисто.
Consensus полезен, когда вопрос уже близок к эмпирическому утверждению «да/нет». Он синтезирует нарративные обзоры, таблицы и индикатор консенсуса, а также может проводить более глубокий поиск, отмечающий пробелы. Он также может неверно интерпретировать источники, а ограничение числа статей в уровне Deep всё ещё значительно ниже уровня «сотен полных текстов». Рассматривайте его как инструмент разведки, а не как форму кодирования.
Covidence широко описывается как ведущее ПО для управления систематическими обзорами. Вместе с EPPI-Reviewer, DistillerSR и JBI-SUMARI он относится к небольшому набору платформ, поддерживающих полный стек интервенционных обзоров: записи, скрининг, извлечение и разрешение командных конфликтов. Он сложнее, чем требуется для исследовательского поиска. Диалоговое извлечение в формате «общение с этим PDF» не является его центральной функцией, и большинство проектов всё ещё опирается на формы извлечения, заполняемые людьми.
Jenova's Academic Research Assistant занимает другую часть стека. Он ищет актуальные академические источники, принимает загруженные PDF, хранит неограниченную историю чатов и помнит протокол между сессиями, поэтому определения столбцов не нужно заново объяснять каждый день. Это не инструмент с двумя скринерами, он не создаёт диаграмму потока PRISMA, а сотни статей необходимо обрабатывать пакетами, а не загружать в одно контекстное окно. Это реальные ограничения. Компенсирующие преимущества — постоянство, доступ к нескольким моделям и возможность провести один и тот же исследовательский вопрос от извлечения до подготовки текста на основе цитат, не экспортируя данные за пределы проекта.
Опубликованная Paperguide последовательность из шести шагов — загрузка, общение с PDF, структурированные столбцы, сравнение между статьями, валидация контекста цитирования, затем написание текста на основе цитат — ясно выражает паттерн «сначала извлечение». Независимые показатели точности и цены Paperguide для этой статьи не проверялись; полезным объектом сравнения является сам рабочий процесс.
Как работает структурированное извлечение данных, когда корпус охватывает сотни статей?
Оно работает, преобразуя каждую статью в строки с определёнными протоколом полями, а затем фильтруя эти строки по исследовательскому вопросу до написания любого синтезирующего текста. Масштаб обеспечивается повторением схемы, а не более длинным резюме.
Первый шаг — загрузка. PDF, DOI, URL, BibTeX, RIS или экспорт из менеджера ссылок формируют корпус. Общение с PDF — второй шаг, а не последний: оно используется для поиска фрагментов методов и результатов, после чего эти фрагменты фиксируются в столбцах. Живой обзор автоматизированного извлечения обнаружил 76 публикаций по теме, но лишь шесть реализованных инструментов для конечных пользователей, и 84% алгоритмов анализировали только заголовки и аннотации. Извлечение только по аннотациям пропустит исходы, анализы подгрупп и сведения о риске систематической ошибки, находящиеся в полном тексте. Любой рабочий процесс, заявляющий о работе с «сотнями статей» лишь по аннотациям, резюмирует, а не кодирует.
Пользовательские столбцы должны соответствовать вопросу, а не стандартному шаблону поставщика. Для вопроса об эффективности типичные поля включают дизайн, популяцию, вмешательство или экспозицию, компаратор, первичный исход, направление эффекта, размер эффекта с интервалом, наблюдение и ограничения. Для вопроса о механизмах замените размер эффекта предполагаемым путём и тем, действительно ли исследование его проверяло. Связь каждой ячейки с фрагментом источника делает возможным последующее сравнение. Без указателей таблица — это всего лишь другое резюме с большим количеством свободного пространства.
Сотни статей также требуют пакетной обработки. Контекстные окна, ограничения скорости и ошибки разбора PDF делают одноразовое извлечение всего корпуса систематического обзора ненадёжным. Устойчивый паттерн таков: определить схему на пилотном наборе из 8–15 статей, измерить согласованность с человеческим кодированием, зафиксировать запрос, а затем запускать оставшиеся статьи волнами. Текст запроса определяет полноту и формат; уникальные запросы для каждой статьи не обобщаются. Проведите пилот на подмножестве, затем сохраняйте запрос неизменным.
Jenova's Academic Research Assistant поддерживает этот паттерн, поскольку схема может храниться в постоянной памяти, а PDF могут оставаться прикреплёнными к проекту. Однако пакетная обработка всё равно необходима. Матрица Elicit ближе к нативному листу кодирования для эмпирических полей. Covidence предполагает, что корпус уже прошёл скрининг. Выбирайте инструмент, соответствующий этапу, на котором вы действительно находитесь.
Как валидировать извлечённые выводы по контексту цитирования и дизайну исследования?
Валидация заключается в проверке того, сохраняется ли извлечённое утверждение в цитируемом фрагменте, в более поздней литературе и в разных дизайнах исследований, отвечающих на один и тот же вопрос. Извлечение без таких проверок будет воспроизводить смещение цитирования со скоростью машины.
Валидация контекста цитирования означает открыть цитируемый фрагмент, а не доверять цитирующему предложению. Статьи регулярно преувеличивают то, что показала ссылка, цитируют аннотации вместо результатов или переносят вывод, который последующие испытания опровергли. Поэтому отдельный проход «сохраняется ли этот цитируемый вывод?» — это самостоятельный этап, отличный от вопроса «что сообщила эта статья?». Рабочие процессы в стиле Paperguide размещают эту проверку непосредственно перед синтезом, и это правильный порядок: не пишите абзац, пока ячейка не станет устойчивой.
Валидация с учётом дизайна идёт дальше. Методологическая схема 2025 года в Nature Communications показывает двухэтапный конвейер, который служит полезной эталонной архитектурой, даже если вы никогда не примете её формулы оценки. Большие языковые модели разбирают свободный текст на популяцию, вмешательство или экспозицию, связь и исход, а затем классифицируют направление эффекта как увеличение, снижение или отсутствие изменений. Эти записи стратифицируются по дизайну — рандомизированные испытания, менделевская рандомизация, наблюдательные исследования, — поэтому результат не считается взаимозаменяемым между методами.
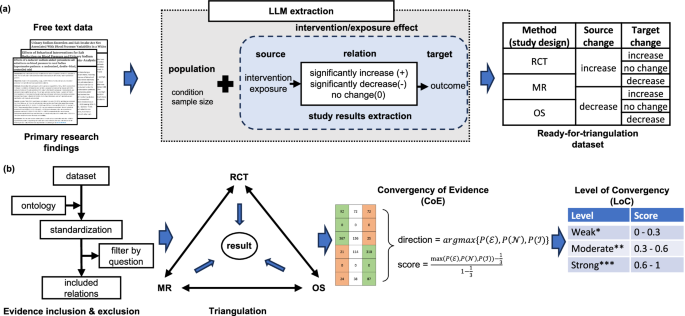
Вторая панель — это часть, которую пропускает большинство инструментов резюмирования. После стандартизации и фильтрации включения результаты триангулируются между дизайнами. Оценка Convergence of Evidence использует направление с наибольшей вероятностной массой; затем диапазон Level of Convergence маркирует совокупность доказательств как слабую, умеренную или сильную. Для применения идеи вам не нужна именно эта метрика. Но необходимо перестать объединять значимую наблюдательную ассоциацию с нулевым испытанием так, будто они представляют одно предложение «литература говорит X».
Разногласия между человеком и моделью должны разрешаться третьим проходом по PDF, а не автоматически засчитываться как ошибка модели. В одном proof-of-concept Claude 2 допустил одну крупную и пять мелких ошибок извлечения — и обнаружил 21 мелкую ошибку в человеческом эталонном стандарте. Отношение к опубликованным извлечениям как к золотому стандарту недооценивает модели и переоценивает людей. Правильная единица анализа — фактическая согласованность каждого поля, при которой составные статистики, такие как точечная оценка вместе с интервалом, учитываются целостно, а не как три несвязанных числа.
Jenova может выполнять проход по контексту цитирования, поскольку способен искать последующую литературу и сохранять в памяти исходную таблицу извлечения. Он не может заменить второго человека-рецензента для обзора в стиле Cochrane. Covidence может обеспечить участие этого второго рецензента. Учитывайте оба факта, не сводя их к одному победителю.
Как на практике организовать рабочий процесс извлечения, управляемый вопросом?
Сначала определите вопрос и поля, проведите пилот схемы, извлекайте пакетами с указателями на источники, сравните строки, перепроверьте цитаты, а затем пишите по таблице. Обратный порядок — сначала написать текст, а потом искать цитаты — воспроизводит проблему резюме.
Для Jenova's Academic Research Assistant типичная последовательность выглядит так:
- Откройте агента и одним блоком изложите протокол, включая критерии включения и точные нужные столбцы.
- Прикрепите пилотный набор PDF (или DOI), а не весь корпус.
- Извлеките данные в таблицу, требуя указатель для каждой ячейки.
- Зафиксируйте запрос после исправления пилотного набора.
- Обрабатывайте оставшиеся статьи пакетами, затем выполните проход по противоречиям и проход по контексту цитирования до любого нарративного синтеза.
Полезный начальный запрос:
«Исследовательский вопрос: У взрослых с резистентной к лечению депрессией снижает ли адъювантный кетамин показатели Montgomery–Åsberg по сравнению с плацебо через 24 часа? Включайте только RCT. Для каждой статьи извлеките: дизайн, n рандомизированных, дозу и путь введения, компаратор, первичный исход, временную точку, размер эффекта с 95% CI, направление (увеличение / снижение / без изменений) и ограничения. Приведите предложение из результатов для каждого размера эффекта. Не резюмируйте статьи, не соответствующие критериям включения. Отмечайте пустые ячейки вместо предположений.»
Полезный запрос для сравнения после создания таблицы:
«Используя только таблицу извлечения, перечислите: (1) конфликты в направлении эффекта, (2) различия в дозе или временной точке, которые могут объяснить конфликты, и (3) любую строку, в которой цитируемое подтверждающее испытание старше самого недавнего нулевого результата по тому же исходу. Не добавляйте статьи, которых нет в таблице.»
Для Elicit аналогичный путь — уточнение протокола, сбор источников, скрининг, затем матрица с пользовательскими столбцами — именно эти шаги продукт документирует для систематических обзоров литературы. Начинайте с эмпирических вопросов, чьи поля — n, методы, исходы — уже соответствуют матрице. Не ожидайте такой же отдачи от теоретических статей.
Для Covidence выполните импорт поисковых результатов, удаление дубликатов, двойной скрининг заголовков и аннотаций, скрининг полного текста, затем заполнение форм извлечения. Библиотечные руководства относят этот класс ПО к среде для структурированного, прозрачного и воспроизводимого синтеза доказательств, а не к чат-ботам. Если вам необходимы диаграмма потока PRISMA и два независимых рецензента, начните здесь и используйте LLM только внутри формы извлечения, при том что второй рецензент остаётся человеком.
Два операционных правила применимы ко всем трём. Во-первых, никогда не позволяйте модели заполнять пропуск правдоподобным значением; пустые ячейки — это данные. Во-вторых, измеряйте время на всю задачу — итерации запроса, разрешение разногласий и исправления, — а не только задержку модели. Время, затраченное на задачу, является релевантным показателем эффективности, и разработка запросов входит в это время.
Что исследователи синтеза доказательств говорят об извлечении данных с помощью LLM?
Исследователи считают LLM перспективными ускорителями для фоновых полей и пока не доказанной заменой извлечения исходов, при этом сам дизайн валидации остаётся открытой методологической проблемой. Консенсус в методологических статьях 2025–2026 годов носит условный характер: они полезны внутри контролируемого рабочего процесса, но не готовы к роли извлекателя без надзора.
«Узкое место в синтезе доказательств — не скорость чтения. Оно заключается в том, чтобы каждое исследование отвечало на один и тот же вопрос в одинаковых полях, а затем замечать, когда эти поля расходятся. Резюме может быть гладким и всё же непригодным для этой задачи, потому что беглость скрывает пустые ячейки. Когда мы перевели команды от чата на уровне статей к таблицам, привязанным к вопросу, первым, что стало заметно, было не новое понимание, а отсутствующие данные: размеры выборок без знаменателя, исходы без временной точки, цитаты, не подтверждавшие предложение, к которому они были привязаны.»
«Мы также перестали считать человеческое извлечение золотым стандартом. Значительная доля исследований, кодированных людьми, содержит хотя бы одну ошибку извлечения, и модели иногда находят эти ошибки, одновременно внося другие, особенно в составные статистики. Продуктивная единица оценки — фактическая согласованность по каждому полю, установленная по PDF. Пока рабочий процесс не может показать этот цикл — схема, указатель, пакет, противоречие, повторная проверка цитаты, — он остаётся резюмировщиком независимо от того, сколько статей, по его утверждению, он прочитал.»
— Product Team Jenova, проектирование исследовательских процессов, опыт создания долгосрочных проектов академических агентов для поиска литературы и подготовки рукописей
Эта позиция согласуется с независимыми комментариями. Scoping review LLM в систематических обзорах заключил, что они набирают популярность, но ещё не готовы к использованию в качестве самостоятельной инфраструктуры. Отдельная работа о языковых моделях для извлечения данных и оценки риска систематической ошибки тестирует смешанные конвейеры человек—модель, а не обзоры, выполняемые только моделью. Актуальный вопрос в этой области не в том, «может ли модель прочитать 400 PDF?», а в том, «способна ли журналируемая таблица, отфильтрованная по вопросу, выдержать двойное рецензирование?».
Когда всё же следует использовать специализированное ПО для систематических обзоров вместо AI-агента для исследований?
Используйте специализированное ПО для систематических обзоров, когда нужны двойной независимый скрининг, отчётная диаграмма потока PRISMA и след аудита, который будет проверять журнал, орган HTA или группа по разработке рекомендаций. Используйте AI-агента для исследований, когда вы ещё формируете вопрос, кодируете развивающийся корпус или превращаете устойчивую таблицу в рукопись. Эти подходы чаще последовательны, чем конкурентны.
Covidence, DistillerSR, EPPI-Reviewer и JBI-SUMARI существуют потому, что воспроизводимые методы, командные рабочие процессы и записи, соответствующие PRISMA, являются требованиями, а не предпочтениями для интервенционных обзоров. Машинное обучение внутри этих платформ сильнее всего помогло на этапе скрининга — одна оценка показала сокращение нагрузки на скрининг до 60% — тогда как инструменты извлечения и оценки риска систематической ошибки остаются менее развитыми. Если результатом станет зарегистрированный обзор, не отказывайтесь от этого стека только потому, что чат-модель умеет перефразировать PDF.
Агент является лучшей ежедневной средой, когда вопрос ещё меняется. Вы можете прикреплять новые PDF, пересматривать столбцы и хранить решения по протоколу в памяти, не открывая новый проект обзора при каждом изменении направления. Jenova's Academic Research Assistant создан для этого режима: актуальный академический поиск, прикреплённые полные тексты, постоянные схемы извлечения и путь к подготовке текста с управлением цитатами. Он не удовлетворит протоколу, требующему двух скринеров. Указание на это ограничение — часть правильного использования инструмента.
Практическое разделение, применяемое многими группами в 2026 году, выглядит так. Проводите разведку и определяйте поля с агентом или Elicit. Регистрируйте протокол. Проводите скрининг и извлечение в Covidence или эквиваленте, при необходимости с кодированием при поддержке LLM, которое всё равно проверяет человек. Возвращайтесь к агенту, чтобы проверить контекст цитирования на прочность и написать текст по зафиксированной таблице. Список инструментов синтеза доказательств Duke напоминает, что ни одно приложение не охватывает каждый этап; профессиональный навык заключается в понимании того, на каком этапе вы находитесь.
Проверка, которая должна определять стек, та же, что открывала эту статью. Если вы можете указать исследовательский вопрос, столбец для каждого элемента этого вопроса, указатель для каждой ячейки и запись обо всём исключённом, вы извлекаете доказательства. Если у вас есть только хорошо написанный обзор «того, что говорят статьи», вы всё ещё резюмируете — даже если обзор был создан из сотен файлов.
Источники
- PRISMA Statement — рекомендации по отчётности для систематических обзоров
- The BMJ — заявление PRISMA 2020: обновлённое руководство по отчётности для систематических обзоров
- ScienceDirect — LLM в систематических обзорах: популярность растёт, но к использованию они ещё не готовы (scoping review)
- PMC — цифровые инструменты для поддержки процесса систематического обзора
- BMJ Evidence-Based Medicine — проблемы и подводные камни оценки LLM для извлечения данных
- Oregon State University Libraries — сравнение AI-инструментов для исследования литературы
- Elicit — рабочий процесс систематического обзора литературы
- Covidence — ПО для управления систематическими обзорами
- UCL Library Guides — ПО для систематических обзоров
- Nature npj Digital Medicine — языковые модели для извлечения данных и оценки риска систематической ошибки
- Duke University Libraries — ПО и инструменты для синтеза доказательств