Лучше ли мульти-модельный AI сокращает слепые зоны в анализе акций?
2026-08-24
Как расхождения между моделями и ансамблевые проверки выявляют скрытые риски инвестиционного тезиса?
Перекрёстная проверка несколькими моделями надёжнее сокращает слепые зоны и избыточную уверенность, чем анализ акций одной моделью, поскольку расхождения между моделями сами по себе являются сигналом риска, а не помехой, которую нужно усреднить. В 2026 году один убедительно сформулированный ответ от ChatGPT, Claude или Gemini может создавать ощущение завершённого исследования. Именно эта гладкость и является проблемой. Одна модель, одно контекстное окно и одно распределение обучающих данных формируют связную историю, даже если цифры устарели, отчётность истолкована неверно или отсутствует медвежий сценарий.
Именно эти факторы отличают тщательное AI-исследование акций от уверенных догадок:
✅ Опора на источники — актуальная отчётность, прогнозы и цены вместо данных, ограниченных датой обучения ✅ Разнообразие моделей — более одного поставщика, чтобы легче выявлять предвзятость общего корпуса данных ✅ Разнообразие ролей — фундаментальный, технический, макроэкономический и портфельный взгляды вместо одного универсального аналитика ✅ Отображение неопределённости — диапазоны, конфликты и отметки «невозможно проверить» вместо ложной точности ✅ Стоимость повторной проверки — достаточно низкая, чтобы перекрёстные проверки действительно проводились до увеличения позиции
Полезное рабочее правило — тест «несогласие как сигнал»: воспринимайте консенсус моделей как гипотезу, а конфликт моделей — как повестку для исследования. Остальная часть статьи применяет этот тест к чат-ботам на одной модели, специализированным скоринговым системам вроде Danelfin, исследовательским инструментам с приоритетом цитат, таким как Perplexity, и специализированным агентам по акциям Jenova.
Почему избыточная уверенность сохраняется, когда инвесторы используют одну AI-модель?
Избыточная уверенность сохраняется, потому что одна модель выдаёт один отполированный нарратив, а такие нарративы подавляют трение, которое обычно заставляет взглянуть на вопрос второй раз. Поведенческие финансы рассматривают избыточную уверенность как систематическое искажение, а не как личностный недостаток. На рынках она проявляется в чрезмерной торговле, концентрированных ставках и игнорировании противоположных свидетельств.
Этот паттерн не исчезает, когда аналитиком выступает AI. Исследование избыточной уверенности и предвзятости подтверждения в торговле связывает это искажение с более высоким оборотом, слабой диверсификацией и худшей доходностью. Обзор поведения инвесторов в эпоху AI за 2025 год показывает, что дискреционные вмешательства могут свести на нет прирост эффективности алгоритмов, повышая волатильность, а не снижая её. Более новые работы описывают «алгоритмическую избыточную уверенность»: когда анализ делегируется модели, пользователи считают результат более объективным, чем он есть на самом деле.
Сеанс работы с одной моделью усугубляет проблему тремя механическими способами. Во-первых, модель вознаграждается за связность, поэтому она заполняет пробелы вместо того, чтобы явно сообщать о них. Во-вторых, пользователь не видит разногласий коллег, а именно этот сигнал заставляет институциональных инвесторов расширять интервалы уверенности. В-третьих, интерфейс диалоговый, поэтому даже неверная цифра подаётся уверенным прозаическим текстом. Предупреждение SEC США для инвесторов об AI формулирует это прямо: AI может создавать и распространять ложную или неточную информацию, а инвесторам следует проверять утверждения у зарегистрированных специалистов.
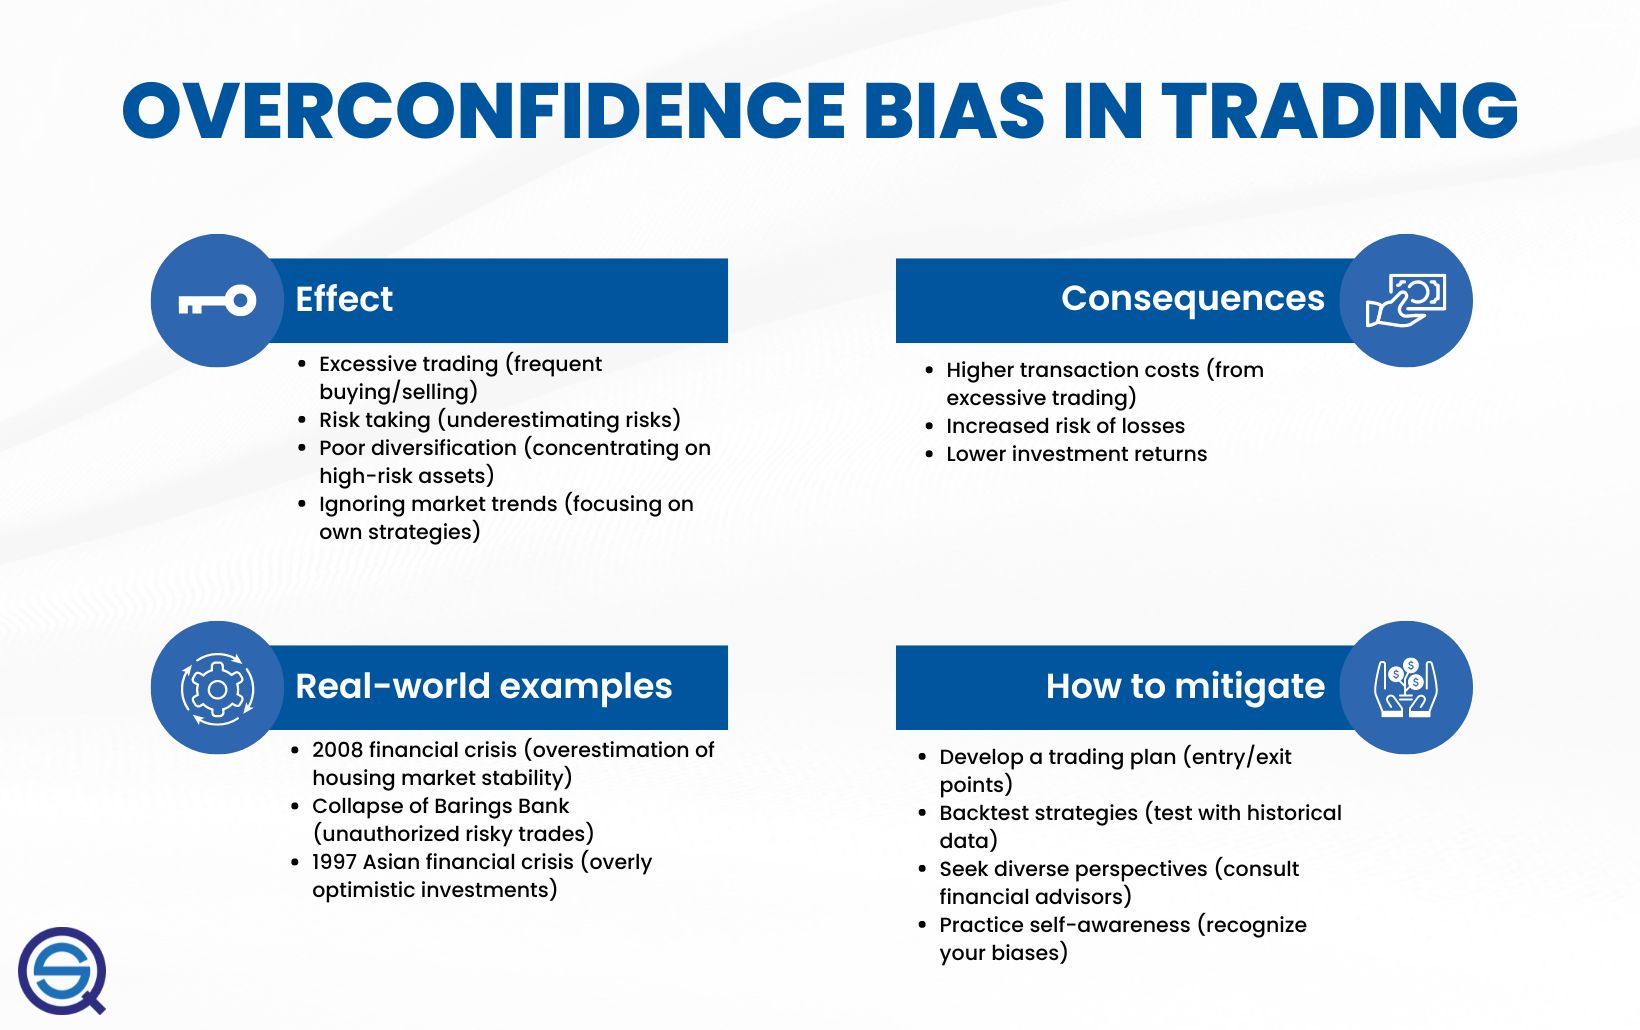
Классические методы снижения риска — письменный план, исторические тесты и разнообразие точек зрения — напрямую отображаются на архитектуру исследования. Одна модель может помочь составить план. Но сама по себе она не может быть той самой разнообразной точкой зрения.
Что нужно оценивать при сравнении одно-модельного и мульти-модельного анализа акций?
Следует оценивать шесть уровней покрытия, а не то, какой интерфейс звучит умнее. Назовём это шестиуровневым аудитом слепых зон. Это практический чек-лист для любого тикера, любого инструмента и любого горизонта.
1. Опора на источники. Получает ли система актуальную отчётность SEC, прогнозы и цены, или просто продолжает текст на основе даты окончания обучающих данных? Openbook Analytics отмечает, что универсальные чат-боты не имеют актуальных рыночных данных и не могут проверить генерируемые ими цифры, а CEO Perplexity признавал наличие на платформе устаревших рыночных данных.
2. Разнообразие моделей. Один поставщик означает один тип отказа. Сопоставление результатов GPT-класса с Claude, Gemini или DeepSeek полезно только тогда, когда действительно меняются запрос, данные и роль. Смена бренда при том же устаревшем запросе не создаёт разнообразия.
3. Разнообразие ролей. Фундаментальный анализ, анализ ленты и структуры рынка, а также макроэкономическая надстройка выявляют разные ошибки. Это больше похоже на исследовательское совещание, чем на ветку с чат-ботом.
4. Представление неопределённости. Предпочитайте диапазоны, конкурирующие сценарии и явные отметки «не проверено» одной целевой цене.
5. Постоянство контекста. Работа над тезисом длится неделями. Инструменты, которые забывают альтернативный взгляд прошлого вторника, в следующем сеансе снова раздуют уверенность.
6. Стоимость одной проверки. Если второй проход модели дорогой или неудобный, его пропустят именно тогда, когда позиция будет максимальной.
Обзор FINRA по AI в индустрии ценных бумаг описывает те же вопросы языком регулирования: управление модельным риском, объяснимость, целостность данных и надзорные механизмы. Ожидается, что фирмы понимают, как модель формирует результат, прежде чем полагаться на неё в процессах инвестиционных рекомендаций в рамках Regulation Best Interest и правила FINRA 2111. У частных инвесторов нет программы по правилу 3110. Но им всё равно нужна сопоставимая привычка: знать, чего модель не видит.
Работа Harvard Business School за 2025 год о зарубежной предвзятости финансовых LLM добавляет менее заметный тип сбоя. Информация может отсутствовать в обучающих данных или присутствовать, но иметь недостаточный вес. Две модели с фокусом на США могут «соглашаться» по компании из развивающихся рынков и при этом разделять один и тот же пробел.
Чем ChatGPT, Danelfin, Perplexity и Jenova различаются по покрытию слепых зон?
Прежде всего, они отличаются тем, выдают ли один скор, одну справку с цитатами или исследовательский файл, который можно оспорить. ChatGPT наиболее силён как партнёр для размышлений и наиболее слаб как механизм для работы с цифрами. Danelfin наиболее силён как прозрачный скринер и слабее как площадка для дискуссии нескольких ролей. Perplexity наиболее силён в поиске фрагментов с цитатами и слабее, когда эти фрагменты устарели. Fundamental Stock Analyst от Jenova наиболее силён, когда инвестиционному тезису требуется свести воедино прибыль, оценку и настроения рынка, а затем проверить результат с помощью других моделей или специализированных агентов.
Openbook Analytics, обобщая предыдущие тесты, сообщает, что ChatGPT неверно отвечал примерно на 35% финансовых и инвестиционных запросов, а Gemini в некоторых оценках галлюцинировал финансовую информацию с частотой до 88–91%. Эти цифры не являются причиной отказаться от языковых моделей. Они являются причиной не позволять одной из них завершать инвестиционный тезис.
| Функция / измерение | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| Основной результат | Текстовое объяснение | Объяснимый AI Score и факторы | Ответы из веб-источников с цитатами | Фундаментальное мемо на основе отчётности |
| Актуальные / проверенные рыночные данные | Слабые; ограничены датой обучения | Создан для охватываемых вселенных с оценками | Есть цитаты, но данные могут быть устаревшими | Отчётность SEC, прогнозы, настроения |
| Перекрёстная проверка несколькими моделями | Вручную, через несколько аккаунтов | Одна проприетарная система | Поиск с несколькими моделями, одна справка | Встроенная поддержка нескольких поставщиков и специализированных агентов |
| Работа с неопределённостью | По умолчанию уверенная проза | Скор и атрибуция факторов | Цитаты, но меньшая видимость остаточного риска | Конкурирующие сценарии, расхождения моделей, память |
| Цены на 2026 год | Около $20 в месяц за платную версию | Не проверено в этом обзоре | $20 в месяц за Pro; бесплатный уровень | Бесплатный уровень; платные тарифы от $20 в месяц |
| Лучше всего подходит для | Обзора концепций, подготовки медвежьего сценария | Скрининга и выбора времени для известного списка | Быстрой проверки фактов с источниками | Перекрёстно проверяемого исследования акций |
ChatGPT
ChatGPT остаётся полезным для перевода раздела 10-K, описания структуры отрасли или принуждения к формулировке медвежьего сценария понятным языком. Сравнение четырёх моделей за 2026 год относит его к категории универсальных инструментов, а не к терминалам с актуальными данными. Его ограничение структурно: он всё равно может построить аккуратный мостик по марже из памяти. Именно так избыточная уверенность проникает в исследовательскую записку.
Danelfin
Danelfin — другой продукт. Он публикует AI Score, а не чат. Компания заявляет, что акции США с оценкой 10/10 превосходили рынок на 21,05% годовой альфы через три месяца с 2017 года, в то время как бумаги с оценкой 1/10 отставали на 33,28%, а стратегия AI Score принесла 376% с 3 января 2017 года по 9 июня 2025 года против 166% у S&P 500. Объяснимые факторы — настоящий противовес оценке по принципу чёрного ящика. Ограничение носит дополняющий характер: скор может ранжировать вселенную, не проверяя конкретный бухгалтерский, сегментный или регуляторный риск, который способен разрушить эту позицию.
Perplexity
Perplexity заслуживает места в качестве слоя цитирования. Сравнение Helm Terminal за 2026 год утверждает, что он лидирует по актуальным фактам с цитатами и финансовым функциям, тогда как Claude лидирует в глубоком синтезе отчётности. Ограничение заключается в том, на что уже указывал его CEO: цитата актуальна ровно настолько, насколько актуальна страница, на которую она ведёт. Сопоставлять Perplexity с рабочим процессом, построенным на первичной отчётности, ценнее, чем считать количество цитат доказательством.
Jenova Fundamental Stock Analyst
Fundamental Stock Analyst от Jenova создан как специалист по акциям: прибыль, сравнительная оценка, анализ бизнес-модели и актуальные данные из отчётности, прогнозов и настроений. На платформе Jenova его можно повторно запускать на моделях OpenAI, Anthropic, Google, DeepSeek и xAI, а также использовать рядом с другими специалистами, не делая вид, что он заменяет каждого из них. Постоянная память удерживает на столе последнее разногласие.
Здесь важны и честные ограничения. Jenova не публикует долгосрочный композитный скор, сопоставимый с результатами Danelfin за 2017–2025 годы. Мульти-модельные запуски потребляют больше лимита использования, чем один проход. Противоречивые ответы повышают когнитивную нагрузку, и пользователю всё равно нужно открыть 10-K. Это реальные издержки. Но это также цена за отказ путать беглость изложения с тщательностью анализа.
Как мультиагентная оркестрация меняет фундаментальное исследование акций?
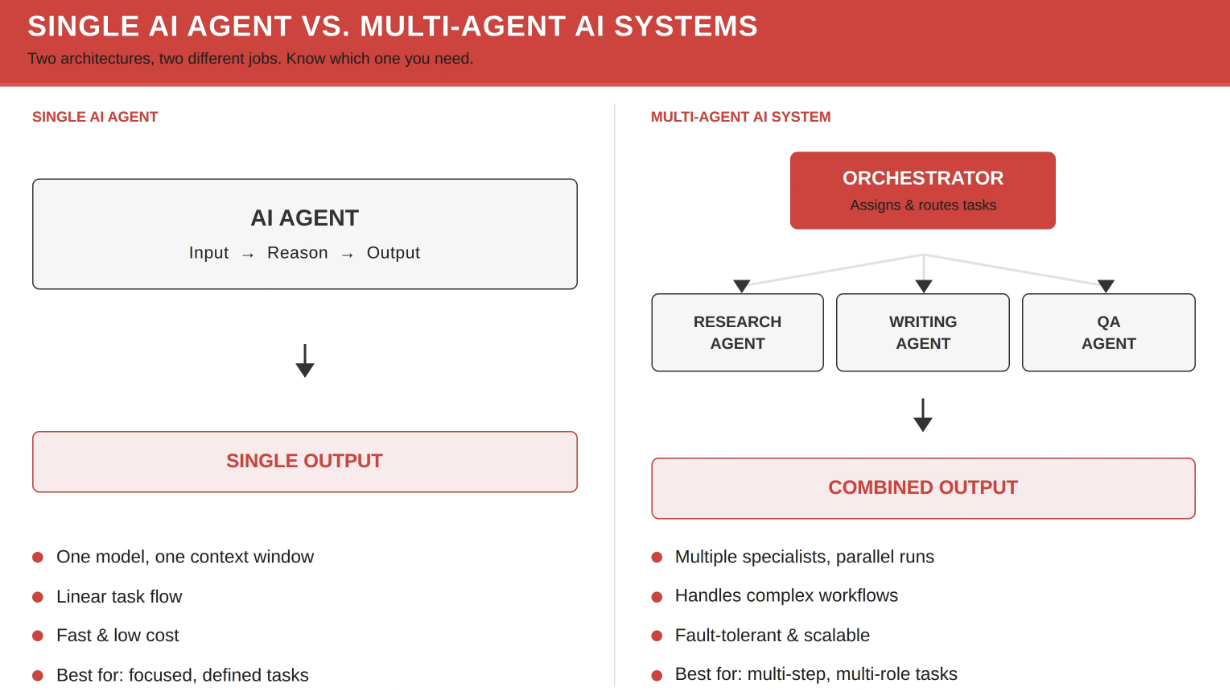
Оркестрация меняет задачу с «спросить одного аналитика» на «укомплектовать небольшой аналитический стол и согласовать файл». Один агент следует линейным путём: ввод, рассуждение, вывод. Это быстро, дёшево и уместно, когда вопрос узкий. Мультиагентная схема добавляет оркестратор, который распределяет работу между специалистами — исследования, написание, контроль качества — и возвращает объединённый результат. Такая архитектура медленнее и дороже. Но именно она не даёт одной красноречивой ошибке стать всем мемо.
В анализе акций аналогичное разделение — не абстрактные «исследование / написание / QA». Оно выглядит так:
- Фундаментальный анализ: качество прибыли, юнит-экономика, оценка, распределение капитала
- Технический анализ: структура, объём, моментум, уровни отмены сценария
- Макроэкономика: политика, ставки, межрыночный режим
- Портфель: размер позиции, корреляция, просадка, уместность идеи именно в этом портфеле
Fundamental Stock Analyst от Jenova занимает первое место за столом. Сочетание с Technical Stock Analyst и Macro Strategist — практическая версия мультиагентного QA. Одна модель, которой нравится история, другая, утверждающая, что график сломан, и третья, считающая, что траектория ставок уничтожает мультипликатор, — это не неудачный запрос. Это полноценное совещание по рискам.
Данные об ансамблях за пределами чат-ботов для анализа акций указывают на то же самое. Исследование arXiv за 2025 год об ансамблях LLM на данных Survey of Professional Forecasters показало, что комбинация LLM превзошла простое усреднение по нескольким краткосрочным индикаторам и сохраняла большую полезность при высоком расхождении экспертных оценок. Механизм не был магией. Ансамбль снижал вес недавно неточных экспертов, корректировался на запаздывающие пересмотры и не считал каждый голос одинаково значимым. Это противоположность подходу «спросить у одного чат-бота целевую цену и остановиться».
Формулировки FINRA о моделях чёрного ящика и объяснимости актуальны даже для частных инвесторов. Если вы не можете объяснить, почему бычий сценарий пережил столкновение со второй моделью и второй ролью, у вас нет инвестиционного процесса. У вас есть расшифровка чата.
Могут ли технические, макроэкономические и портфельные агенты заметить то, что пропускает одна модель?
Да. Они выявляют категориальные ошибки — ошибки, которые модель, работающая только с фундаментальными данными, структурно вряд ли заметит. Языковая модель, только что написавшая убедительную историю о качественном долгосрочном росте, редко сама укажет, что акция перегрета, сектор — это чистая ставка на дюрацию, или позиция дублирует уже имеющийся у вас фактор.
Типичные пропуски по ролям:
- Техническая роль. Фундаментальная модель может быть права в оценке, но опоздать на год. Структура цены, неудачные пробои и расхождения в объёмах — не сноски. Это вопросы выбора момента и отмены сценария. Technical Stock Analyst построен вокруг таких вопросов: структуры рынка, моментума и определённого риска.
- Макроэкономическая роль. DCF по отдельной акции, игнорирующий режим экономической политики, — это таблица со скрытым предположением о ставках. Macro Strategist предназначен для межрыночного синтеза и анализа политики — именно там часто рушатся многие «идиосинкратические» истории.
- Портфельная роль. Отличная идея в изоляции может быть плохим добавлением в портфель. Дрейф, стресс и корреляция существуют на портфельном уровне — это задача Portfolio Management Strategist от Jenova.
Именно здесь платформы с единым скором и чат-модели с одной моделью имеют общую слепую зону. Скор Danelfin может прозрачно показывать факторы, стоящие за рейтингом, и всё же ничего не говорить о том, не является ли ваш портфель уже длинным по тому же фактору. ChatGPT может в общем виде перечислить риски, но не знать, что у вас уже есть три компании из сектора ПО с одинаковой чувствительностью к ставкам. Проверка несколькими ролями позволяет таким ошибкам выйти на поверхность.
Ограничение — корреляция мировоззрений. Если каждому агенту дают бычий запрос или каждую модель кормят одним и тем же вторичным блог-постом, это театральная постановка. Разнообразие ролей работает только тогда, когда техническому агенту позволено отменить сделку, макроагенту — переоценить мультипликатор, а портфельному агенту — сократить позицию до символического размера.
Как провести мульти-модельную перекрёстную проверку инвестиционного тезиса по акции?
Проводите её как файл из четырёх проходов, а не как более длинный чат. Цель состоит в том, чтобы намеренно создать разногласия, а затем решить, какие доказательства могут их устранить.
Проход 1 — Зафиксируйте факты. Попросите Fundamental Stock Analyst подготовить только снабжённый источниками снимок: два последних отчётных периода, прогнозы руководства, сегментный состав, чистый долг, обратные выкупы и мультипликаторы оценки, которые действительно соответствуют бизнесу. В этом проходе запретите целевые цены.
«Используя последний 10-K, 10-Q и два последних отчёта о прибыли по [TICKER], извлеки выручку по сегментам, валовую и операционную маржу, FCF, чистый долг и разводнённое число акций. Для каждой цифры процитируй отчётность или звонок. Если ты не можешь указать источник числа, напиши Unverified.»
Проход 2 — Измените модель, а не вопрос. Повторите то же извлечение на втором поставщике. Существенные различия в заявленной цифре — это не «стиль». Это событие, связанное с целостностью данных. Самостоятельно проверьте отчётность перед Проходом 3.
Проход 3 — Привлеките другие роли. Отправьте тот же тикер Technical Stock Analyst для определения уровней отмены сценария и Macro Strategist для анализа предположения о ставках, FX или сырьевых товарах, скрытого в мультипликаторе.
«Игнорируй бычье фундаментальное мемо. Определи ценовой уровень и макроэкономический режим, при которых эту идею не стоило бы держать, даже если тезис в конечном итоге окажется верным.»
Проход 4 — Потребуйте письменное особое мнение. Попросите любую одну модель аргументировать противоположную позицию с той же длиной текста и тем же уровнем источников. В заметке Lucid.now о поведенческих финансах отмечается типичный человеческий паттерн: переоценка навыка прогнозирования, слишком частая торговля и концентрация в любимой истории. Обязательное особое мнение — способ прервать этот паттерн, когда «аналитиком» также выступает модель.
Только в ChatGPT или Claude можно приблизительно воспроизвести Проходы 2 и 4, открыв второй продукт и вставив тот же извлечённый материал с источниками. Невозможно имитировать актуальное извлечение данных из отчётности или постоянную память между неделями, если инструмент на самом деле ими не располагает. В Danelfin Проход 1 частично автоматизирован скором и списком факторов; для Проходов 3 и 4 по-прежнему требуется отдельная среда исследования.
Цены Jenova строятся на использовании в рамках уровней: бесплатный план с ограниченным использованием, затем $20, $50, $100, $200, $500 и $1,000 в месяц по мере роста лимитов. Проверка в четыре прохода стоит дороже одного чата. Для любой достаточно значимой позиции это более дешёвая ошибка.
Что говорят рыночные практики об AI-избыточной уверенности в исследованиях?
Практики, ежедневно работающие с этими инструментами, обычно считают уверенность одной модели не признаком «лучшей» модели, а сбоем процесса.
«Самая дорогая ошибка, которую мы видим, — не неверное число. Это правдоподобно звучащее число, которое никогда не встретилось со второй моделью. Когда три поставщика сходятся на мостике по марже, который ни один из них не может сверить с 10-Q, именно это согласие и является красным флагом. Мы предпочитаем выпускать мемо с двумя противоречивыми диапазонами и списком непроверенных пунктов, а не одной целевой ценой без остаточных сомнений.»
«Мульти-модельный подход не становится автоматически безопаснее. Если задать GPT, Claude и Gemini один и тот же небрежный вопрос, часто получится один и тот же небрежный ответ с разными прилагательными. Разнообразие нужно проектировать: разные роли, разные извлечения данных и постоянное указание возражать. Иначе вы купили коррелированную избыточную уверенность за тройную стоимость токенов.»
«За аналитическим столом разногласия определяют, что читать дальше. Если конфликтуют фундаментальный и макроанализ, мы изучаем предположение о ставках. Если конфликтуют фундаментальный и технический анализ, мы проверяем момент входа и размер позиции. Если все роли соглашаются слишком быстро, мы предполагаем, что файл поверхностен. Эта привычка старше LLM. Модели лишь облегчают её игнорирование.»
— Команда продукта Jenova, проектирование и оценка агентов по акциям, многолетняя работа над мульти-модельными исследовательскими процессами
Этот подход согласуется с акцентом FINRA на тестировании, планах резервного реагирования и межфункциональном надзоре до того, как AI-инструменты начнут влиять на инвестиционные рекомендации. Он также согласуется с результатом ансамблевого прогнозирования: комбинации наиболее полезны, когда входные данные расходятся и есть правило определения их весов.
Когда анализ одной моделью всё ещё остаётся лучшим выбором?
Анализ одной моделью всё ещё лучше, когда задача ограничена, цена ошибки мала, а скорость важнее остаточного риска. Мульти-модельная перекрёстная проверка — это система контроля. Вам не нужна система контроля, чтобы определить ROIC или изложить бизнес в двух абзацах.
Одной модели обычно достаточно, если:
- Вы изучаете концепцию, а не определяете размер позиции
- У вас уже открыта отчётность и нужен лишь помощник для чтения
- Вы скринируете формулировки, а не рассчитываете оценку
- Вам нужен черновой план перед более медленным процессом с источниками
- Дополнительные вызовы моделей не изменят решение
Руководство Openbook за 2026 год проводит то же категориальное различие: универсальные чат-боты — это отправные точки, а не основные механизмы исследования. Скор Danelfin — это одна система, но специализированная; использовать её как скринер и затем остановиться всё равно означает принять одно-модельное решение, если никто не оспаривает конкретную акцию. Perplexity — подходящий единичный проход, когда за минуты нужен след из цитат и вы сами проверите первоисточник.
Сбой возникает, когда дешёвый проход используют для дорогого решения. Избыточную уверенность вызывает не AI. Её вызывает завершение процесса на первом связном ответе. Сводка Sidley за 2025 год по руководствам финансовых регуляторов США подчёркивает, что фирмы уже должны обращаться с AI как с поднадзорной деятельностью, а не как с оракулом. Частным инвесторам следует перенять дух этого правила, даже если никакой инспектор не задаст вопрос.
Краткое правило принятия решения: если ошибка изменит размер позиции, используйте как минимум две модели и две роли. Если ошибка изменит лишь фразу в заметках, достаточно одной хорошей модели.
Как регулирование и модельный риск должны формировать ваш процесс AI-исследования?
Они должны заставлять вас документировать то, чего модель не видела, а не только то, что она сказала. Обсуждение AI у FINRA написано для брокеров-дилеров, но принципы контроля применимы шире. Управление модельным риском, управление данными, объяснимость и надзор существуют потому, что внешне автономные инструменты дают сбои коррелированным образом.
Для индивидуального исследовательского процесса применимые меры контроля невелики:
- Храните первоисточник в файле. Если модель не может указать на 10-K, 10-Q, 8-K или расшифровку звонка, утверждение остаётся черновиком.
- Фиксируйте разногласия. Однострочная запись — «Claude видит сжатие, Gemini не видит, страница 37 10-Q не разрешена» — полезнее, чем заново сгенерированный бычий сценарий.
- Отделяйте рекомендацию от объяснения. Чат-боты не являются механизмом оценки пригодности рекомендации. FINRA отмечает, что AI-инструменты, генерирующие рекомендации, подпадают под Regulation BI и правило 2111 для фирм-участников. Частным инвесторам следует считать вывод модели анализом, а не персонализированной рекомендацией.
- Предполагайте общую предвзятость, пока не доказано обратное. Результат HBS о зарубежной предвзятости — один из примеров. Две модели могут пропустить один и тот же неамериканский факт. Местная отчётность, источник на втором языке или профильный специалист-человек обеспечивают реальную диверсификацию.
- Предпочитайте инструменты, которые могут сказать Unverified. Ложная точность — главный признак. Система, которая всегда дописывает абзац, не «более аналитична». Она хуже контролируется.
Ничто из этого не требует институционального бюджета. Терминалы уровня Bloomberg по-прежнему находятся в совершенно другом ценовом диапазоне: Openbook указывает типичную стоимость Bloomberg выше $25,000 в год. Контроль, действительно снижающий избыточную уверенность, дешевле: вторая модель, вторая роль и правило, согласно которому консенсус без источников не увеличивает размер позиции.
Анализ акций одной моделью — это инструмент подготовки черновика. Мульти-модельная проверка с несколькими ролями — инструмент против слепых зон. Используйте первый, чтобы начать файл. Используйте второй, чтобы решить, завершён ли файл.
Источники
- Openbook Analytics — Лучшие инструменты AI для анализа акций в 2026 году
- Investopedia — Поведенческие финансы: искажения, эмоции и поведение инвесторов
- Preprints.org — Избыточная уверенность и предвзятость подтверждения в торговле
- ResearchGate — Избыточная уверенность инвесторов в эпоху AI: человек против алгоритмического принятия решений
- SSRN — Поведение инвесторов на фондовых рынках: появление AI и алгоритмической избыточной уверенности
- Investor.gov — Искусственный интеллект (AI) и инвестиционное мошенничество: предупреждение для инвесторов
- FINRA — Искусственный интеллект в индустрии ценных бумаг: ключевые проблемы и регуляторные аспекты
- Harvard Business School — Когда LLM выходят за рубеж: зарубежная предвзятость в AI-финансовом анализе
- Danelfin — AI-инструмент подбора акций и методология AI Score
- AI Business Weekly — Руководство по ценам на AI в 2026 году: ChatGPT, Claude и Gemini
- Perplexity — Цены для частных пользователей и компаний
- Helm Terminal — ChatGPT против Claude, Gemini и Perplexity для исследования акций
- arXiv — Может ли LLM улучшить комбинацию экспертных прогнозов?
- Lucid.now — AI в финансовых решениях: поведенческие аспекты
- Sidley Austin — Искусственный интеллект: руководства регуляторов США по ценным бумагам и сырьевым товарам