Генератор голосов персонажей: AI-голоса для игр, историй и кино
2026-09-06
Jenova помогает создавать самобытных персонажей, писать реплики, которые удобно произносить, и готовить промпты, пригодные для продакшена, для любого генератора голосов персонажей. В сентябре 2026 года системы AI-речи могут скопировать тембр за считаные секунды, однако большая часть результата по-прежнему звучит шаблонно, потому что у текста за ним нет индивидуальности. Студийная озвучка остаётся медленной и дорогой для независимых команд, а поверхностный синтез речи сводит каждую роль к одной и той же интонации.
- ✅ Личности персонажей остаются последовательными в длинных историях и игровых циклах
- ✅ Диалоги написаны для произнесения, а не только для чтения со страницы
- ✅ Промпты структурированы для современных голосовых моделей и локализации
- ✅ Поддержка сценариев, комиксов, музыки и ролевых игр в едином творческом процессе
Чтобы понять, почему это важно, стоит посмотреть, что создателям на самом деле нужно от генератора голосов персонажей: не очередной ползунок с надписью «радость», а голос, который кому-то принадлежит. Узким местом редко бывает рендерер. Обычно это работа над персонажем, подача реплики и этическая граница между оригинальным исполнением и несанкционированной имитацией.
Краткий ответ: что такое генератор голосов персонажей?
Генератор голосов персонажей — это AI-система, создающая различимую, привязанную к личности речь, благодаря которой каждая роль звучит как отдельный человек. Создатели используют его для игр, историй, видео и доступности — однако голос работает только тогда, когда сам персонаж уже ясно определён.
Ключевые возможности:
- Уникальный тембр, темп и эмоциональный диапазон для каждого персонажа
- Сценарии и промпты, которые выдерживают синтез речи и не звучат как GPS
- Ролевые игры с неизменной последовательностью персонажа ещё до нажатия кнопки генерации
- Рабочие процессы для оригинальных персонажей, исключающие клонирование реальных людей без согласия
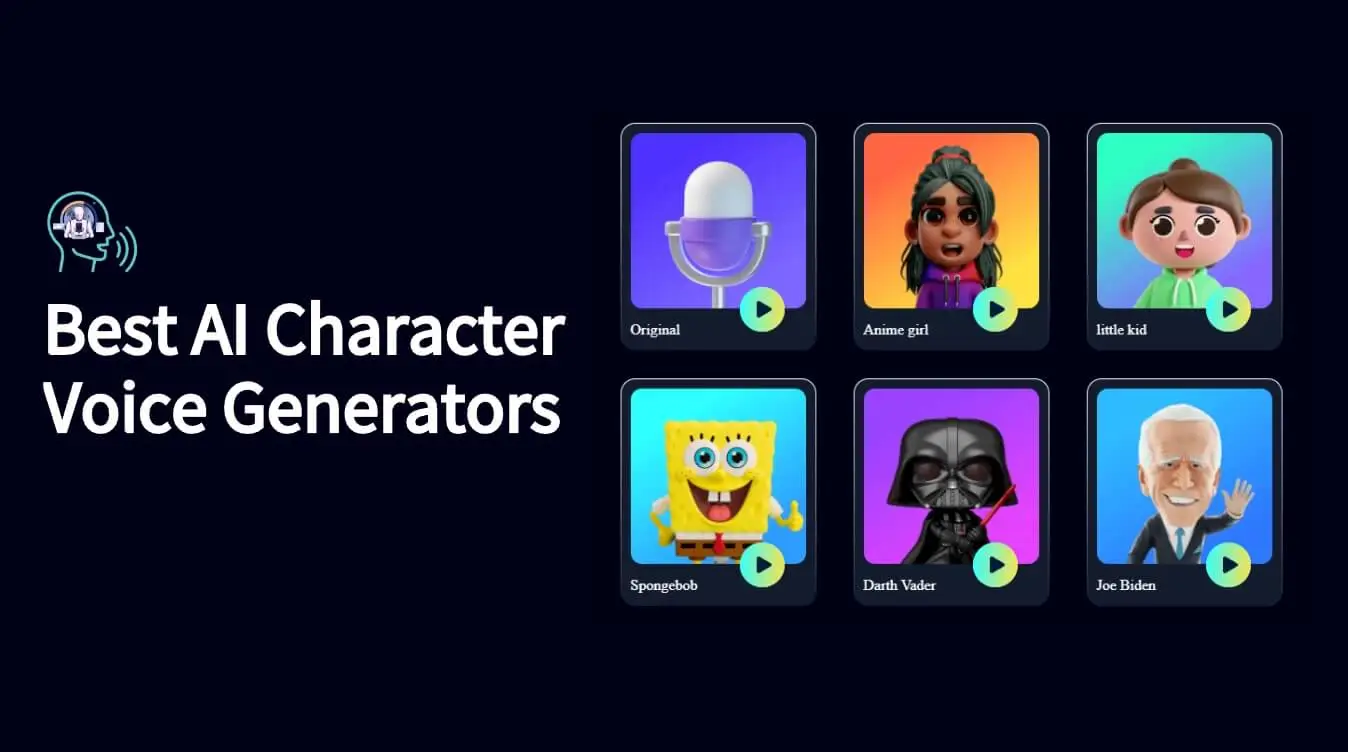
Почему большинство генераторов голосов персонажей всё ещё звучат шаблонно
Спрос на синтетическую речь больше не является экспериментальным. Исследовательские компании теперь отслеживают генерацию AI-голосов как отдельный рынок, а не как второстепенную функцию чат-ботов.
6,4 млрд USD — объём мирового рынка AI-генераторов голосов в 2025 году с прогнозом роста от 8,36 млрд USD в 2026 году
19,09 млрд USD — рынок распознавания речи и голоса в 2025 году с прогнозом 23,70 млрд USD в 2026 году
Эти расходы направляются в игры, локализацию, социальное видео и клиентское аудио. Использование голосового AI выросло в 9 раз в 2025 году, а 84 процента опрошенных организаций планировали увеличить бюджеты на голосовые технологии. Но покупка рендерера не означает покупку исполнения. Доступ к голосу, который запомнит аудитория, всё ещё оказывается удручающе сложным:
- Каждый персонаж наследует один и тот же ритм, схему дыхания и тон «полезного помощника»
- Студийные сессии слишком медленны и дороги для многочисленных второстепенных NPC, составов YouTube и еженедельных озвучек вебтунов
- Реплики, написанные для страницы, разваливаются при произнесении: придаточные накапливаются, шутки не работают, имена искажаются
- Клоны голосов знаменитостей и политиков создают юридические риски и подрывают доверие, даже если интерфейс позволяет сделать это в один клик
- Команды переключаются между автором, инженером промптов, композитором и голосовым инструментом без общей библии персонажей
Один голос, разные таблички с именами
Генератор голосов персонажей может менять высоту голоса и всё равно проваливаться в передаче индивидуальности. Слушатели улавливают отношение, а не только частоту: как злодей растягивает согласный, как ребёнок торопит шутку, как уставший капитан понижает громкость в конце доклада. Исследования эмоционально осведомлённой, специфичной для персонажей речи из комиксов и многоперсонажной генерации голоса на основе текста снова и снова приходят к одному выводу: модели нужен контекст персонажа, а не только целевой звуковой сигнал. Без прописанной личности получается костюм, а не исполнение.
Барьер затрат для независимых и средних команд
Люди-актёры по-прежнему ведут эмоционально сложные сцены. Проблема производства заключается в длинном хвосте: тысячах приветствий NPC, локализованных вариантах и произношении имени игрока. Отраслевой анализ этичного AI-голоса в играх описывает модель «человек плюс» — актёры в ключевых сценах, синтез для больших объёмов — и отмечает, что независимые команды теперь могут локализовать игры на десятки языков за недели, а не месяцы. Это помогает лишь в том случае, если исходные реплики удобны для произнесения, а лист персонажа стабилен. Иначе вы просто платите за тиражирование посредственного аудио.
Сценарии, которые никогда не предназначались для слуха
Романная проза и UI-копирайтинг конфликтуют с речью. Вложенные придаточные, необъяснённые акронимы и непроизносимые фэнтезийные имена загоняют модель в роботизированные схемы ударений. Генератор голосов персонажей добросовестно озвучит плохую реплику. Решение находится выше по процессу: более короткие смысловые отрезки, фонетическое написание, эмоциональные ремарки и диалог, который исполнитель действительно может сказать на одном дыхании.
Согласие, клонирование и платформы, провоцирующие проблемы
Системы zero-shot могут воспроизвести тембр примерно за три секунды. Такая скорость полезна для согласованных реплик и оригинальных персонажей. Она опасна, когда библиотека предлагает публичных персон или защищённых авторским правом маскотов в качестве пресетов. FTC прямо заявила, что AI не освобождает от действия существующего законодательства о защите потребителей, а также использовала конкурс по клонированию голосов и правило против имитации личности для пресечения вводящего в заблуждение аудио. В играх соглашение Interactive Media Agreement от июля 2025 года было принято с одобрением 95.04% и сделало письменное согласие обязательным условием для воспроизведения голоса. Если ваш процесс не может доказать наличие согласия, не генерируйте голос.
Именно для этого создана Jenova: для интеллектуальной работы с персонажем вокруг генератора, а не для обхода закона.
Решение Jenova
Генератор голосов персонажей превращает текст в аудио. Jenova делает этот текст достойным озвучки. Вы определяете, кто говорит, как этот персонаж мыслит, чего он никогда не скажет и как должна прозвучать реплика, — а затем передаёте чистый промпт и сценарий в любую используемую вами модель речи. Специализированные аудиоплатформы рендерят звуковые волны; эта платформа создаёт личность за звуковой волной.
| Традиционный подход | Jenova |
|---|---|
| Забронировать студию, ждать сессий, перезаписывать каждую правку | Библии персонажей и произносимые черновики за одну рабочую сессию |
| Один голос TTS с новым отображаемым именем | Личность, дикция и эмоциональные акценты прописываются для каждой роли |
| Клонировать известный голос и надеяться, что никто не заметит | Оригинальные персонажи, согласованные реплики и документированное использование |
| Автор в одной вкладке, заметки к промптам в другой, композитор в третьей | Связанные агенты для истории, промптов, комиксов, музыки и сдачи результата |
| Поверхностная локализация, игнорирующая юмор и тайминг | Реплики, структурированные под длину по слогам и культурную адаптацию |
Библии персонажей до работы с аудио
Начинайте с индивидуальности, а не с пресета. Name Generator создаёт культурно уместные и произносимые имена — это практический фильтр, который многие голосовые процессы пропускают, пока модель не столкнётся с группой согласных. Объедините его с Writing Assistant, чтобы закрепить дикцию: лексический потолок, запретные слова, повторяющиеся шутки и одну метафору, к которой персонаж всегда возвращается. Когда эти ограничения заданы, любому генератору голосов персонажей есть что конкретно исполнять.
Диалоги, созданные для речи
Film Screenwriter рассматривает реплики как поведение во времени: перебивания, молчание и подтекст. Это мастерство напрямую переносится на игровые реплики, вертикальные драмы и озвученные комиксы. Вы получаете ремарки, которым способна следовать голосовая модель, например «вполголоса, затем ярче», вместо расплывчатых ярлыков вроде «грустно». Для сериализованного мобильного сторителлинга Microdrama Screenwriter делает клиффхэнгеры достаточно короткими, чтобы их можно было озвучить без судорожного вдоха.
Пример указания, которое можно вставить в генератор:
«Прочитайте реплику голосом капитана Ильи Восс, за 50, хриплый низкий грудной тембр. Когда она злится, она никогда не повышает голос — она замедляется. Реплика: „Вы принесли карту. Вы не принесли погоду“. Пауза после слова „карту“. Не улыбаться».
Промпты, выдерживающие встречу с моделью
Большинство «плохих AI-голосов» — результат плохих инструкций. Prompt Generator превращает библию персонажа в готовый для модели текст: заметки об акценте, возраст, пространство записи, эмоциональная дуга и негативные промпты, например «без дикторской интонации, без улыбки на гласных». В этом разница между библиотечной карточкой с именем «Аниме-девушка» и человеком, который просто оказался анимированным.
Изображение, музыка и остальная сцена
Голос — лишь один слой. Graphic Designer создаёт лицо, которого ожидает слух. Manga Creator, Comic Creator и Webtoon Creator создают последовательное визуальное повествование, под движения губ и ритм панелей которого можно написать музыкальное сопровождение. Music Composition Assistant и Lyric Writer дают персонажам мотивы и строки, которые можно петь, чтобы разговорный голос и песня принадлежали одному миру.
Пока специализированные речевые API занимаются рендерингом аудио, Jenova специализируется на письме, промптинге и последовательности, которые решают, захочет ли кто-нибудь услышать это аудио во второй раз.
Специализированные AI-агенты для работы с голосами персонажей
Попробуйте Jenova бесплатно — кредитная карта не требуется. Эти агенты охватывают задачи, находящиеся непосредственно до и после работы генератора голосов персонажей.
Roleplay Game Master
Если вам нужно услышать персонажа в языке до синтеза, это ваша репетиционная комната. Неограниченная память сохраняет дикцию, секреты и отношения неизменными между сессиями, что является текстовым эквивалентом голосовой модели с зафиксированными параметрами.
- Проверяет коронные фразы на прочность, пока они не станут неизбежными
- Разделяет голоса группы и NPC в длинных кампаниях
- Создаёт реплики от лица персонажа, которые можно сразу перенести в генератор
Film Screenwriter
Используйте его, когда голос должен нести сюжет, а не только создавать атмосферу. Структура, цели сцен и мастерство диалога не дают исполнению превратиться в экспозицию с забавным акцентом.
- Ритм и конфликт, оправдывающие эмоциональные изменения в аудио
- Короткие реплики, удобные для дозаписи в играх и рекламе
- Развитие персонажа, выдерживающее озвучку двенадцати эпизодов
Prompt Generator
Голосовые модели настолько хороши, насколько хорош бриф. Этот агент пишет промпты для текстовых, визуальных, музыкальных и видеосистем — включая речевые модели, за которые вы уже платите.
- Последовательные блоки промптов для каждого персонажа, чтобы эпизоды совпадали
- Описания эмоций и пространства, которым модели действительно следуют
- Итеративная доработка, если дубль получается слишком ярким или слишком медленным
Writing Assistant
Рабочая лошадка для библий, закадрового текста и переписывания в стиле «это должно звучать как он или она». Он адаптируется к формату и аудитории, поэтому монолог с лором и тавернское оскорбление не получают одинаковый ритм фраз.
- Редакторская проверка на произносимость и сложность чтения
- Соответствие тона в текстах заданий, трейлерах и заметках к обновлениям
- Совместная работа, когда у вас уже есть почти удачный черновик
Music Composition Assistant
Генератор голосов персонажей работает с речью. Этот агент работает с основой под ней: мотивами, гармонией и заметками по аранжировке, которые можно передать в DAW или другой модели.
- Лейтмотивы, привязанные к конкретным ролям
- Темповые карты, оставляющие место для диалога
- Рекомендации с учётом теории музыки, чтобы тема злодея не конфликтовала с вокальным диапазоном
Public Speaking Coach
Когда исполнителем являетесь вы или вам нужно направлять исполнителя, этот агент прорабатывает подачу, тревожность и аудиторию. Это человеческая сторона синтетической речи: дыхание, паузы и акценты, которые затем можно закодировать в промпте.
- Отметки темпа и ударений, переносимые в теги TTS
- Репетиции Q&A и чтения в прямом эфире для гибридных трансляций
- Заметки о том, что реплика делает со слушателем, а не только о том, как она звучит
Как на самом деле работает процесс с генератором голосов персонажей
Сначала вам не нужна студия. Вам нужен человек на странице, реплика, которую можно сказать, и промпт, не противоречащий самому себе.
Шаг 1: Зафиксируйте человека, а не пресет
Опишите возраст, статус, тело и одно правило, которое персонаж никогда не нарушает. Создайте произносимое имя, затем библию на 150 слов. Если два персонажа могут поменяться репликами без того, чтобы кто-то это заметил, у вас ещё нет двух голосов.
«Создай библию персонажа для Рин Колдер, 17 лет, речной курьер, всегда вежлива с грузом и груба с капитанами. Короткие предложения. Никакого сленга, появившегося после того, как сожгли её деревню. Дай мне три реплики, которые она никогда бы не сказала».
Шаг 2: Пишите реплики для дыхания, а не для страницы
Перенесите сцену в Writing Assistant или Film Screenwriter. Уберите вложенные придаточные. Запишите сложные имена фонетически в скобках. Добавьте ремарку, которую модель сможет исполнить.
«Перепиши этот абзац с лором в шесть устных реплик для Рин, не более двенадцати слов в каждой, с отмеченной паузой перед последней репликой».
Шаг 3: Превратите библию в промпт для генератора
Передайте те же ограничения в Prompt Generator. Укажите пространство записи, расстояние до микрофона, эмоцию по шкале от 1 до 5 и то, чего следует избегать. Сохраняйте блок для каждого персонажа, чтобы к четвёртому эпизоду голос не начал дрейфовать.
«Преобразуй библию Рин в промпт для голосовой модели: подростковое контральто, сухой тембр, реверберация крытого склада, темп 1.05x, без улыбки, без дикторской концовки. Добавь негативный промпт».
Шаг 4: Согласуйте лицо, панели и музыкальное сопровождение
Передайте ту же библию визуальным и музыкальным агентам, чтобы изображение и подложка соответствовали голосу. Яркое мультяшное лицо поверх траурного прочтения — так аудитория решает, что аудио фальшивое, даже если модель точна.
Шаг 5: Отрепетируйте в телефоне, затем рендерьте
Jenova работает с полным паритетом функций в вебе, iOS и Android. Прочитайте реплику вслух в дороге, отметьте место, где запинаетесь, перепишите её и лишь затем вставляйте в генератор голосов персонажей. Самая дешёвая дозапись — та, которую никогда не пришлось записывать.
Результаты и варианты использования
🎮 NPC для независимой игры без бюджета на студию
Сценарий: Для RPG длительностью 12 часов нужно 4 000 реплик второстепенных персонажей, а также произношение имени игрока.
Традиционный подход: Профсоюзные сессии для главных ролей, тишина или повторяющиеся реплики для всех остальных, локализация в очереди на «когда-нибудь».
Jenova: Главные сцены остаются за людьми. Для длинного хвоста создаются библии, произносимые реплики и стабильные промпты, чтобы ваш генератор голосов персонажей мог озвучить встречающих, торговцев и NPC с слухами без клонирования знаменитости.
- Листы персонажей, не позволяющие кузнецу звучать как волшебник
- Короткие реплики, готовые к локализации
- Блоки промптов, которые можно версионировать как код
🎬 Озвучка вебтунов и комиксов
Сценарий: Еженедельному вертикальному сериалу нужны аудиоэпизоды без ожидания полного актёрского состава.
Традиционный подход: Фанатские озвучки с разными микрофонами или один рассказчик, исполняющий все роли.
Jenova: Webtoon Creator и Comic Creator поддерживают визуальную непрерывность, пока сценарист разделяет голоса по панелям. Каждая роль получает собственный промпт, поэтому генератору не приходится гадать.
- Реплики, синхронизированные с панелями, вместо объёмных прозаических блоков
- Различимые составы для главных ролей и массовки
- Музыкальные подсказки, оставляющие место для речи
📱 Языковая практика, звучащая как разговор с кем-то
Сценарий: Вы едете на работу и хотите разговора, а не голоса из учебника.
Традиционный подход: Упражнения в приложениях с одним синтетическим преподавателем, который не помнит ваших ошибок.
Jenova: Learn English Through Roleplay помещает вас в сцену с последовательным персонажем. Позже вы можете озвучить те же реплики в генераторе для тренировки восприятия на слух — по-прежнему с оригинальными персонажами, а не имитациями.
- Память, благодаря которой бариста не обнуляется в каждой сессии
- Идиомы в ситуациях, которые вы действительно будете повторно использовать
- Мобильные сессии, подходящие для поездки на поезде
🎙️ Брендированные подкасты и составы для социальных сетей
Сценарий: Каналу продукта каждую неделю нужны ведущий, скептически настроенный напарник и дисклеймер для чтения с листа.
Традиционный подход: Один и тот же голос основателя в каждом сегменте или фрилансер, который недоступен по четвергам.
Jenova: Social Media Content Generator создаёт сценарии под форматы платформ; агенты для текста и промптов не дают голосам ведущего и напарника слиться. Вы рендерите в лицензированном голосовом инструменте, а не с помощью несанкционированного клона публичной персоны.
- Повторяющиеся рубрики со стабильной дикцией
- Дисклеймеры, написанные для произнесения, а не беглого просмотра
- Зацепки нужной длины для Shorts, Reels и полных эпизодов
FAQ
Что такое генератор голосов персонажей?
Генератор голосов персонажей — это программное обеспечение, которое превращает текст в речь с выбранной индивидуальностью: возрастом, высотой голоса, акцентом и эмоцией, чтобы разные роли не разделяли одну интонацию. Аудиомодель даёт тембр. Работа с персонажем, ремарки и промпты дают личность. Инструменты Jenova находятся на стороне этой работы: библии, диалоги и готовые для модели инструкции, которые можно вставить в любую лицензированную речевую систему.
Можно ли пользоваться генераторами голосов персонажей бесплатно?
Многие речевые приложения предлагают ограниченный бесплатный тариф и взимают плату за длинные клипы, коммерческие права или клонированные голоса. У Jenova есть бесплатный план с основными функциями и платные уровни, если вам нужно больше использования. Планируйте две статьи расходов: творческую работу — сценарии, промпты, последовательность — и рендерер — минуты аудио, лицензии на голоса. Согласие и коммерческие условия для клонированных голосов не зависят от цены подписки: изучите и то и другое до публикации.
Как сделать AI-голоса персонажей уникальными?
Дайте каждой роли правило, лексический потолок и физическую привычку, затем пишите реплики, которыми персонажи не смогли бы поменяться. Каждый раз включайте эти ограничения в промпт: пространство, темп, эмоцию и негативный промпт против дикторской интонации. Prompt Generator создан именно для такого брифа. Если два персонажа всё ещё звучат одинаково после хорошего промпта, проблема в библии, а не в ползунке.
Законно ли клонировать голос реального человека?
Не по умолчанию и не в качестве шуточного пресета. Вам нужно чёткое, зафиксированное согласие на использование, которое вы действительно предполагаете, а также соблюдение норм о праве на публичный образ и авторском праве в вашей юрисдикции. FTC рассматривает вводящее в заблуждение клонирование AI-голоса как проблему защиты потребителей, а не как новинку. Соглашения в игровой и развлекательной индустрии всё чаще требуют письменного согласия и отчётности об использовании. Создавайте оригинальных персонажей или используйте лицензированные реплики. Не копируйте голос политика, актёра или певца только потому, что панель управления сделала это простым.
Можно ли использовать этот процесс на телефоне?
Да. Jenova создана для веба, iOS и Android с одинаковыми основными возможностями, включая преобразование речи в текст, когда в дороге удобнее продиктовать заметку, чем печатать. Напишите реплику в поезде, отточите её, создайте промпт, а затем выполните рендеринг в настольном голосовом инструменте, если именно там находятся ваши лицензированные модели.
Чем это отличается от обычного синтеза речи?
Обычный TTS зачитывает слова. Генератор голосов персонажей пытается сыграть роль. Исполнение всё равно зависит от текста: индивидуальности, конфликта и направления. Jenova не заменяет ваш лицензированный аудиорендерер. Она создаёт работу над персонажем, необходимую этому рендереру, с помощью таких агентов, как Roleplay Game Master и Film Screenwriter, чтобы вы не платили за возможность услышать одного и того же услужливого стажёра в шести костюмах.
Заключение
Генератор голосов персонажей хорош лишь настолько, насколько хорош персонаж, которого вы просите его создать. Рынки AI-речи быстро растут, модели могут зафиксировать тембр за секунды, а регуляторы уже отвергли идею, что «это сделала AI» служит защитой. Практический путь уже и лучше: оригинальные персонажи, согласованные реплики, произносимый текст и промпты, которые можно воспроизвести.
Создайте роль, напишите дыхание, затем генерируйте дубль. Начните с Jenova — а затем перенесите эти реплики в речевой инструмент, которому уже доверяете.
Изучите больше элементов того же процесса с Roleplay Game Master, Writing Assistant и Prompt Generator. Когда персонаж ясен, у голоса появляется основа.
Для разработчиков: Каждый агент из этой статьи программно доступен через Jenova API — интегрируйте библии персонажей, генерацию диалогов и промпты для голосовых моделей в своё приложение с помощью одной интеграции. Полная документация →