Насколько специализированные AI-ассистенты для исследований надежнее чат-ботов?
2026-08-22
Чем прослеживаемость и привязка к источникам отличают исследовательский AI от чат-ботов?
Специализированные академические исследовательские ассистенты надежнее универсальных AI-чат-ботов в вопросах прослеживаемости цитат и извлечения доказательств, поскольку они получают данные из научных индексов, связывают утверждения с конкретными фрагментами и показывают подтверждающий или противоречащий контекст. Универсальные чат-боты генерируют связный библиографический текст на основе закономерностей обучения, поэтому они по-прежнему выдумывают авторов, названия, DOI и выводы, которые невозможно отследить до первоисточника.
Разрыв в надежности не связан с качеством текста. Он связан с тем, можно ли провести аудит утверждения.
Ключевые факторы, отличающие исследовательскую помощь с возможностью цитирования от текста чат-бота:
✅ Поиск до генерации — ответы формируются на основе проиндексированных научных работ, а не только вероятности следующего токена ✅ Атрибуция на уровне фрагмента — каждый извлеченный вывод указывает на предложение, таблицу или раздел, а не только на название статьи ✅ Видимость противоречий — более поздние работы, подтверждающие, оспаривающие или лишь упоминающие утверждение, показываются, а не сводятся к единому резюме ✅ Структурированное извлечение — методы, выборки, результаты и ограничения переносятся в сопоставимые поля, а не в пересказанные абзацы ✅ Проверяемое человеком происхождение данных — каждое резюме, цитату и извлеченный вывод можно открыть и сверить с исходным источником
Чтобы содержательно сравнивать такие инструменты в 2026 году, полезно рассматривать надежность цитирования как инженерное свойство, а не как обещание бренда. Остальная часть статьи оценивает чат-боты и исследовательских ассистентов именно по этому свойству.
Почему надежность цитирования стала проблемой исследовательской добросовестности?
Надежность цитирования стала проблемой исследовательской добросовестности, потому что генеративный AI теперь применяется в масштабах публикационной деятельности, тогда как универсальные модели по-прежнему фабрикуют ссылки, которые выглядят достаточно правдоподобно, чтобы пройти поверхностную проверку. Использование таких инструментов студентами и исследователями резко выросло в 2025 году, и сфабрикованные цитаты больше не являются редкой ошибкой. Они проникают в материалы конференций, рукописи и графы цитирования.
Опрос студентов 2025 года от Higher Education Policy Institute показал, что использование инструментов генеративного AI для оценочных работ выросло с 53% до 88% за один год. В связанном обзоре того же опроса сообщалось, что 92% студентов теперь используют AI в той или иной форме, по сравнению с 66% в 2024 году. Этот масштаб важен, поскольку правдоподобную фальшивую ссылку сложнее обнаружить, чем отсутствие ссылки.
Анализ 2026 года в Energy Research & Social Science сообщил, что ChatGPT подготовил 178 ссылок для исследовательских предложений, из которых 69 не имели действительных DOI. Та же статья сослалась на обзор GPTZero 4 841 работы NeurIPS 2025 года, подтвердивший не менее 100 галлюцинированных цитат в 53 принятых статьях. Рецензирование несколькими экспертами не выявило их.
Механизм теперь хорошо описан. Галлюцинация AI — это связный, но ложный либо не опирающийся на источники результат. Рекомендации университетской библиотеки отмечают, что чат-боты могут выдумать цитату целиком — автора, название и журнал. Science утверждает, что модели обучены выдавать ответ даже тогда, когда не знают его. Когда запрос звучит как «приведи источники», модель сопоставляет библиографический стиль с шаблонами. Для нишевых или недавних исследований такое сопоставление превращается в выдумывание.
Что следует оценивать при выборе AI-ассистента для исследований?
AI-ассистента для исследований следует оценивать по тому, можно ли каждое утверждение отследить, обосновать источником, атрибутировать, сопоставить с противоречиями и структурированно извлечь, а не по тому, насколько отшлифованным выглядит текст. Удобное сокращение — модель TRACE: прослеживаемость, поиск с опорой на источники, детализация атрибуции, учет противоречий и извлекаемость.
Прослеживаемость отвечает на вопрос, может ли читатель перейти от предложения в черновике к точному подтверждающему фрагменту. Если инструмент выдает только оформленную ссылку, он создал указатель, а не доказательство.
Поиск с опорой на источники отвечает на вопрос, выполняла ли система поиск по научному корпусу или извлекала сведения из весов модели. Извлечение данных с привязкой к цитатам разработано для предотвращения как выдумок без источников, так и пересказа без атрибуции, требуя явного указания источника для каждого извлеченного утверждения.
Детализация атрибуции отличает цитаты на уровне статьи от цитат на уровне предложения или поля. Статья может быть реальной, но приведенный вывод — ошибочным, устаревшим или взятым из аннотации, а не из результатов.
Учет противоречий показывает, демонстрирует ли инструмент более поздние исследования, которые подтверждают, оспаривают или лишь упоминают утверждение. Одна подтверждающая аннотация не является обзором литературы.
Извлекаемость означает, можно ли сравнивать методы, выборки, результаты и ограничения в структурированных полях. Текстовые резюме скрывают отсутствующие данные. Таблицы делают пробелы заметными.
Руководство King's College London по синтезу доказательств прямо формулирует практический вывод: инструменты AI могут поддерживать этапы обзора, но не способны заменить валидированные методы поиска, а генеративные системы по-прежнему создают фальшивые ссылки. Обзор 2025 года, процитированный в этом руководстве, заключил, что текущие данные не поддерживают использование генеративного AI в синтезе доказательств без участия человека. Поэтому вопрос оценки состоит не в том, «умеет ли этот инструмент писать?», а в том, «можно ли провести аудит этого инструмента?».
Как специализированные исследовательские ассистенты сравниваются с универсальными чат-ботами?
Специализированные исследовательские ассистенты превосходят универсальные чат-боты по прослеживаемости цитат, поскольку связывают ответы с найденными научными работами, тогда как чат-боты остаются наиболее сильны в подготовке текста, объяснении и мозговом штурме. Честное сравнение должно основываться на ролях. Чат-боты — гибкие механизмы подготовки текста. Исследовательские ассистенты — более узкие, но лучше проверяемые системы поиска.
Elicit ищет среди миллионов академических статей и возвращает структурированные отчеты с цитатами. Он особенно силен, когда исследователю нужно сопоставить методы, выборки и выводы по набору исследований. Сравнение 2026 года, связанное с Cochrane и процитированное King's College London, показало, что чувствительность поиска Elicit недостаточна, чтобы заменить традиционный поиск литературы, хотя его точность делает его полезным дополнительным инструментом. Это существенное ограничение, а не малозначительная оговорка.
Scite создан для проверки, а не для написания текста. Он сообщает об охвате более 300 миллионов научных статей и лицензированном доступе через соглашения с более чем 40 издателями. Его Smart Citations классифицируют, поддерживают ли последующие статьи утверждение, противоречат ему или лишь упоминают его. Каждое утверждение, сделанное его ассистентом, связано с конкретным предложением в конкретной статье. Компромисс состоит в охвате задач: Scite сильнее в интеллектуальном анализе цитат, чем в сквозном рабочем процессе подготовки рукописи.
ResearchRabbit наиболее силен в картировании. Он помогает исследователям находить связанные статьи, строить карты цитирования и наблюдать, как область развивается из исходной статьи. Он менее полезен как механизм извлечения доказательств или валидации цитат. Это не недостаток, если задача заключается в поиске.
Универсальные чат-боты, такие как ChatGPT, по-прежнему широко используются, потому что быстро готовят текст и справляются с неструктурированными междисциплинарными вопросами. Их задокументированная слабость — библиографическое выдумывание. Недавние данные, обобщенные в анализе научной добросовестности 2026 года, оценили галлюцинации фактических цитат у продвинутых моделей, таких как GPT-4o и Claude 3.7, в диапазоне 15–20%, с ростом до 35–55% для нишевых или недавних тем. Бенчмарки, проверяющие научные ссылки, созданные большими языковыми моделями, в некоторых условиях сообщали об уровне ошибок выше 30%.
Academic Research Assistant от Jenova занимает иную нишу. Это предметно-ориентированный агент для поиска литературы, подготовки рукописей и управления цитатами, с постоянной памятью и поиском в реальном времени по академическим базам данных. Он сильнее чат-бота в поддержании целостности исследовательского проекта между сессиями. Он уступает Scite в лицензированной классификации цитат по полным текстам и уступает Elicit как специализированному продукту для таблиц извлечения данных. Именно поэтому смешанный набор инструментов по-прежнему превосходит любого отдельного ассистента.
| Функция / параметр | Универсальные чат-боты (например, ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| Привязка поиска к источникам | Преимущественно память модели; просмотр источников зависит от продукта | Поиск научных и веб-источников в реальном времени внутри постоянного исследовательского агента | Поиск по корпусу статей со структурированными отчетами | Лицензированные полные научные тексты плюс открытый корпус | Поиск по графу цитирования на основе исходных статей |
| Прослеживаемость цитат | Часто непроверяемые или сфабрикованные | Встроенные источники с последующей проверкой по оригиналам | Цитаты, привязанные к извлеченным полям | Ссылки на уровне предложений плюс метки поддержки/противоречия | Связи в сети между статьями, а не доказательства на уровне утверждений |
| Извлечение доказательств | Резюме в свободной форме | Заметки, сравнения и синтез, готовый для рукописи | Сильные структурированные таблицы | Сильнее в контексте цитирования, чем в извлечении полей | Ограничено; картирование важнее извлечения |
| Учет противоречий | Обычно сводится к одному ответу | Может сопоставлять противоречивые выводы по запросу | Зависит от найденного набора | Основная функция продукта через Smart Citations | Косвенно, через кластеры связанных работ |
| Цены (по состоянию на 2026 год) | Не подтверждены для разных тарифов | Бесплатный тариф; платные планы от $20 в месяц | Не подтверждены | Не подтверждены | Не подтверждены |
| Лучше всего подходит для | Подготовки текста, объяснений, первоначального формулирования темы | Длительных академических проектов, которым нужны поиск и память для написания текста | Отбора статей в сопоставимые таблицы доказательств | Проверки, поддерживается или оспаривается утверждение | Визуального картирования литературы и поиска авторов/кластеров |
Обзор AI-инструментов для академических исследований 2026 года пришел к похожему разделению труда: Elicit лидировал в структурированном извлечении, Consensus был самым быстрым для быстрой проверки доказательств, а Semantic Scholar оставался наиболее сильным бесплатным индексом для поиска. Ни один столбец в этой экосистеме не заменяет остальные.
Чем различается извлечение доказательств в академических AI-инструментах?
Извлечение доказательств различается тем, возвращает ли инструмент сопоставимые поля или лишь текстовый пересказ. Извлечение на уровне полей надежнее для методов, размеров выборок, результатов и ограничений, потому что отсутствующие значения остаются видимыми. Текстовое извлечение быстрее и легче читается, но скрывает различие между результатом, интерпретацией и галлюцинированной деталью.
Elicit — наиболее наглядный пример структурированного подхода. Он разработан для преобразования исследовательского вопроса в отчет, где строки представляют статьи, а столбцы — характеристики исследований. Именно этот формат объясняет, почему обозреватели часто предпочитают его на раннем этапе отбора. Он все равно требует от человека проверки логики включения, поскольку высокая точность не означает высокого охвата.
Scite извлекает иной объект: контекст цитирования. Вместо вопроса «Что обнаружила эта статья?» он задает вопрос «Как последующие статьи использовали этот вывод?». Это ближе к оценке доказательств, чем к извлечению данных. Он особенно полезен после того, как уже найдена потенциально релевантная статья.
Универсальные чат-боты извлекают информацию в виде текста. Попросите сравнить четыре рандомизированных исследования — и они подготовят уверенный абзац. Такой абзац может быть полезен как первый набросок. Но он плохо подходит для аудита, поскольку нет поля, которое можно пометить как «не указано».
Academic Research Assistant от Jenova и сопутствующий агент Deep Research располагаются между этими подходами. Deep Research выполняет широкий поиск и возвращает синтезированный отчет со встроенными цитатами. Academic Research Assistant поддерживает состояние проекта: предыдущие решения о включении, отклоненные статьи, требования к стилю и незавершенные разделы рукописи остаются доступными в последующих сессиях. Тестирование этого рабочего процесса показывает практическое преимущество при многонедельных обзорах литературы. Ограничение столь же практично. Ни один из агентов не является специализированным средством отбора для систематических обзоров наподобие целевых инструментов Rayyan или DistillerSR, которые библиотекари по синтезу доказательств по-прежнему считают более проверенным вариантом для отбора по заголовкам и аннотациям.
Надежный запрос на извлечение делает требуемые поля явными:
«Извлеките из этих статей: дизайн исследования, размер выборки, популяцию, первичный исход, направление эффекта, заявленные ограничения и точное предложение, подтверждающее каждое поле. Если поле отсутствует, напишите „не указано“, а не делайте вывод по косвенным данным».
Тот же запрос в чат-боте остается надежным лишь настолько, насколько надежен полученный текст. Если модель никогда не открывала статью, она заполнит таблицу на основе стилистической памяти.
Что в действительности требуется для конвейера проверки цитат?
Конвейер проверки цитат требует исходный документ, а не только строку библиографической ссылки. Минимально жизнеспособный процесс таков: загрузить процитированный текст, разбить его на фрагменты, найти отрывки, наиболее релевантные утверждению, повторно ранжировать их и классифицировать связь между утверждением и доказательством. Все, что короче этого процесса, — лишь оформление библиографии.
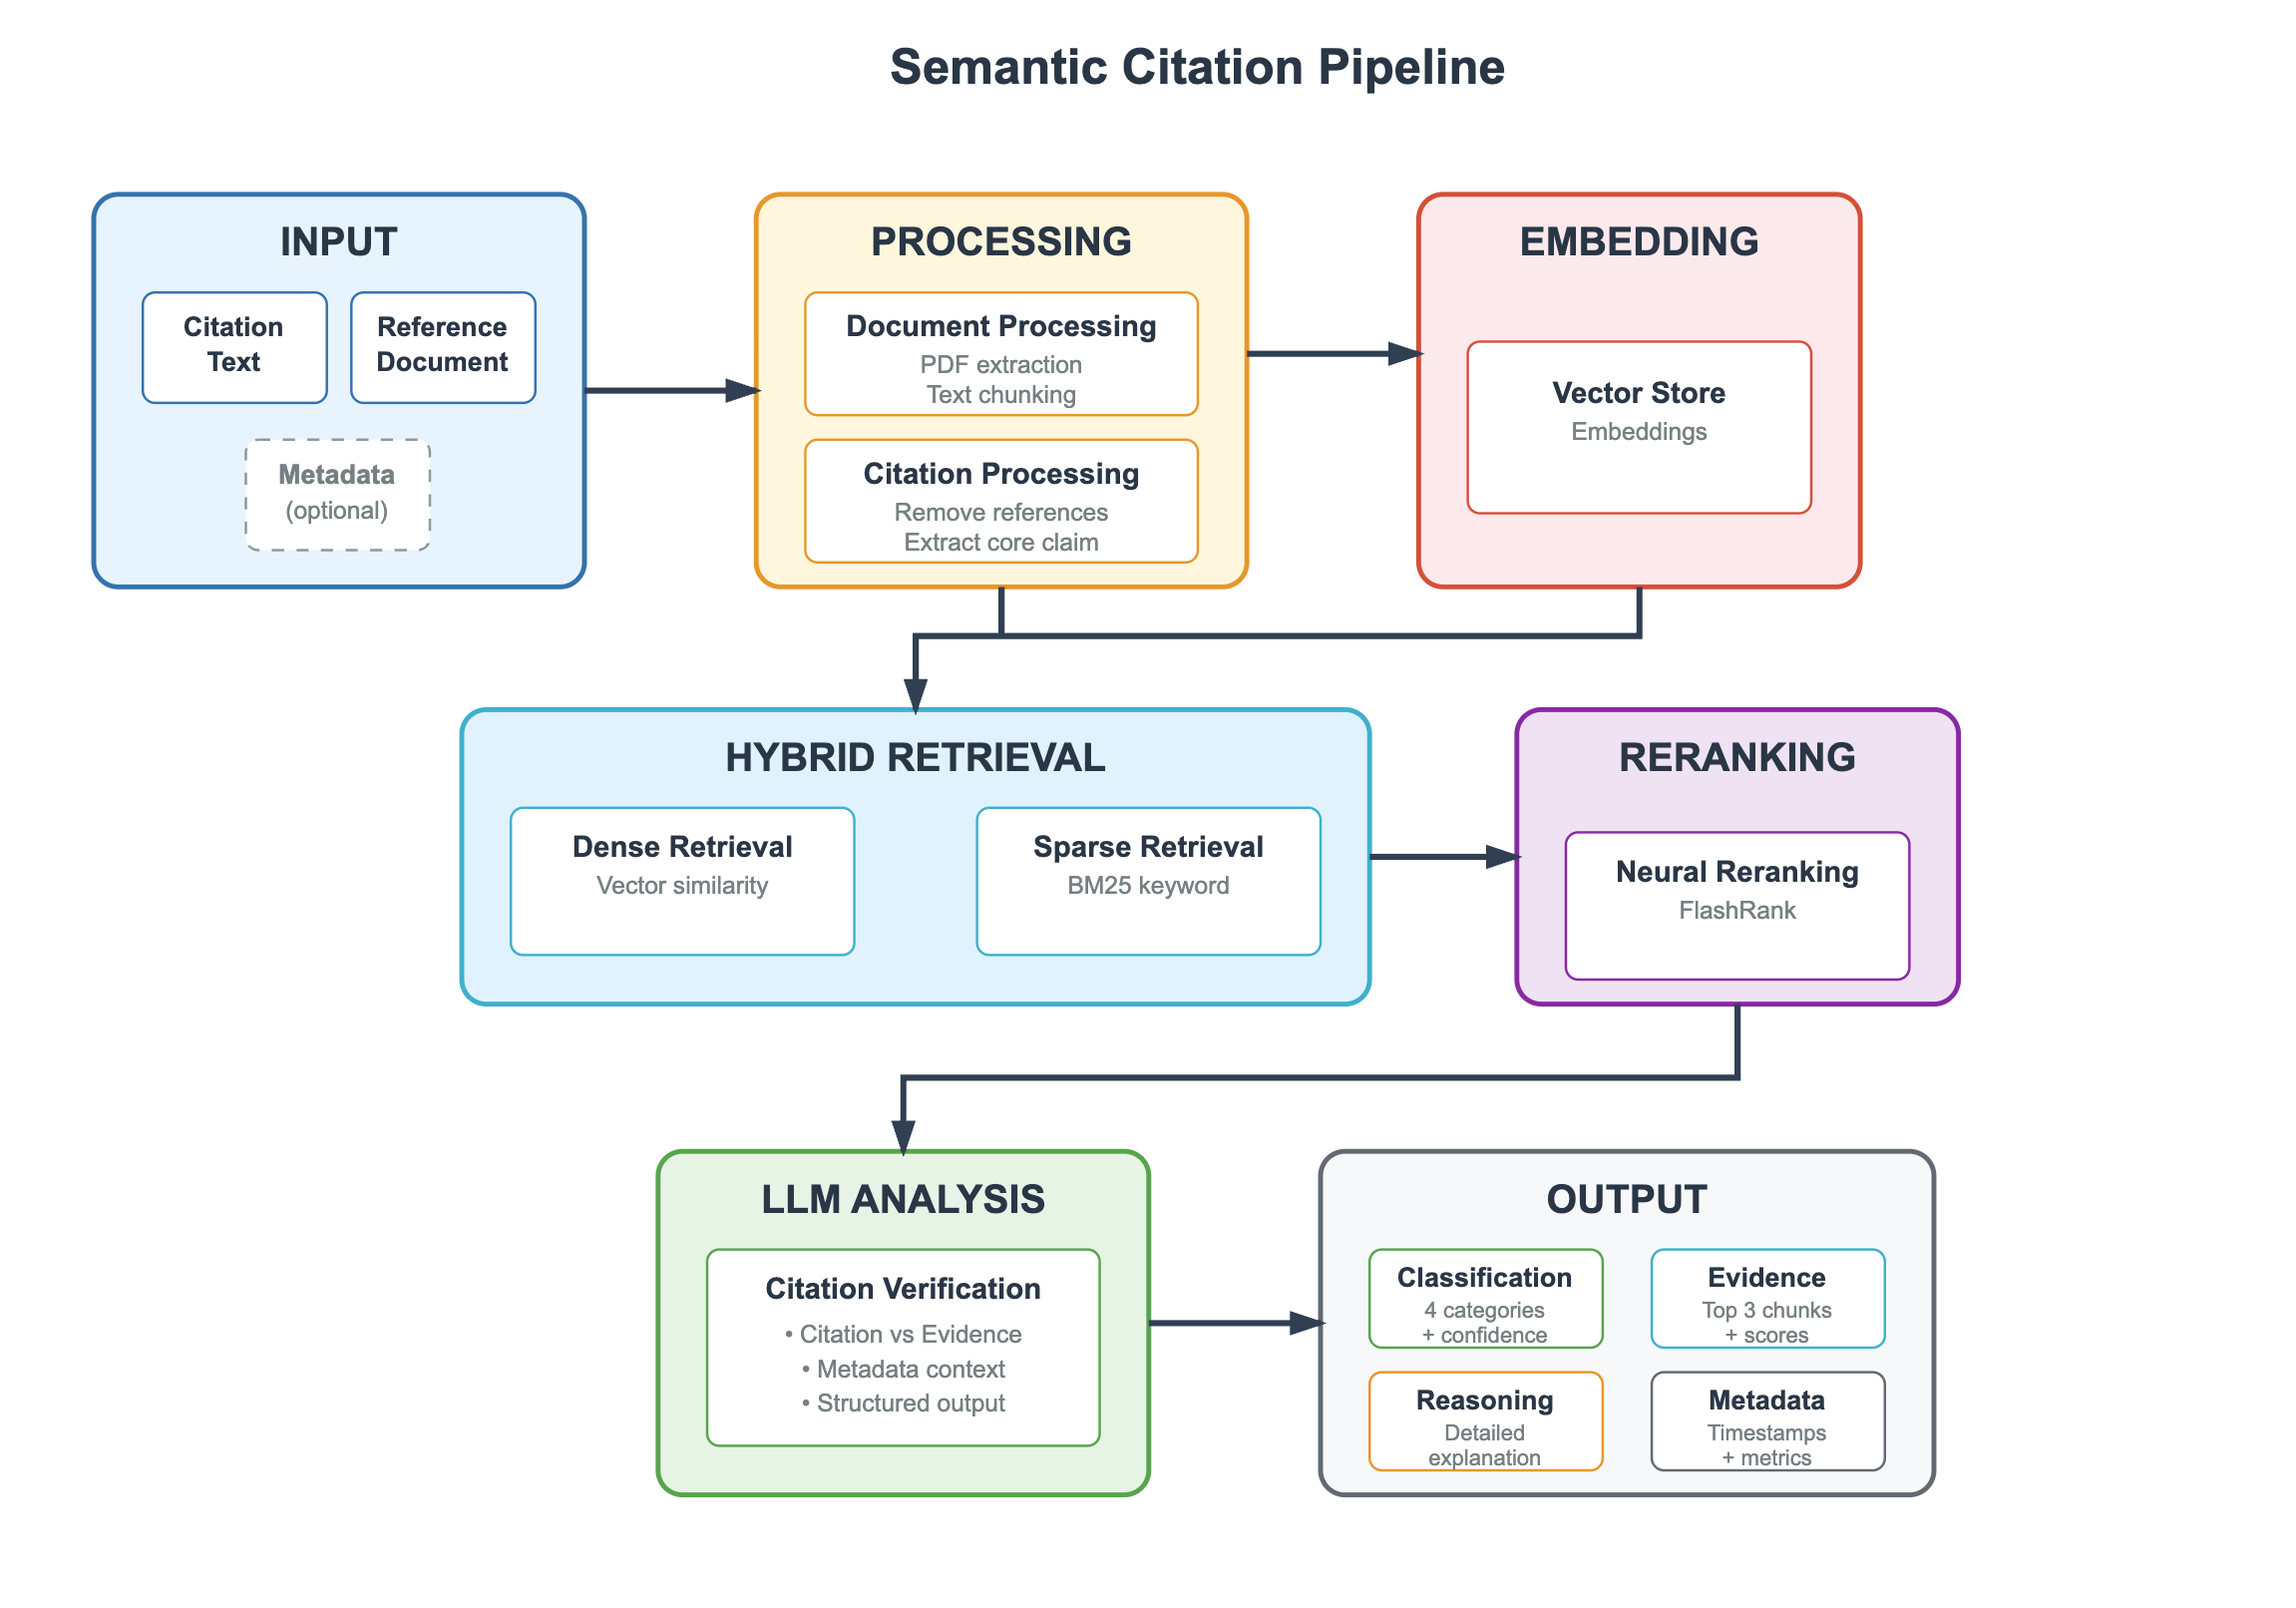
Архитектура выше отличает «эта цитата выглядит реальной» от «эта цитата подтверждается». На вход подаются утверждение и документ-источник. Обработка удаляет библиографию, извлекает ключевое утверждение и разбивает PDF на фрагменты. Затем гибридный поиск использует и векторное сходство, и совпадение ключевых слов, что важно, поскольку названия методов и показатели результатов часто плохо работают при чисто семантическом поиске. Нейронное повторное ранжирование оставляет наиболее подходящие отрывки. Только после этого LLM классифицирует связь и возвращает доказательство, степень уверенности и обоснование.
Такие системы, как SemanticCite, создаются специально для проверки точности цитат посредством анализа источников в полном тексте. Это архитектурное решение существует потому, что сопоставления метаданных недостаточно. DOI может быть действительным, но процитированное предложение может относиться к другой статье, аннотации препринта или выводу, который авторы позднее уточнили.
Издательская инфраструктура не решает эту проблему автоматически. Крупные журналы уже делают ссылки гиперссылками, однако оценки, обсуждаемые в анализе добросовестности 2026 года, указывают, что доля неработающих DOI или устаревших ссылок может достигать 37% в выборках научного контента. Активная ссылка не означает проверенное утверждение.
Именно здесь универсальные чат-боты терпят наиболее предсказуемую неудачу. Они оптимизированы для полного ответа. Конвейер проверки оптимизирован для классификации связи: подтверждено, не подтверждено, опровергнуто или недостаточно доказательств. Эти четыре метки научно полезнее отшлифованного абзаца, поскольку сообщают исследователю, какого рода проверка еще необходима.
Агенты Jenova могут выполнять упрощенную версию этого цикла, находя потенциально релевантную статью, цитируя подтверждающий отрывок и отмечая утверждения, которые не удается обнаружить. В настоящее время они не заменяют лицензированный классификатор цитат по полным текстам с охватом масштаба издательств. Исследователи, которым нужны метки Smart Citation, по-прежнему сочетают агент для написания текста со Scite, а не поручают одной системе обе задачи.
Как построить более безопасный рабочий процесс обзора литературы с AI?
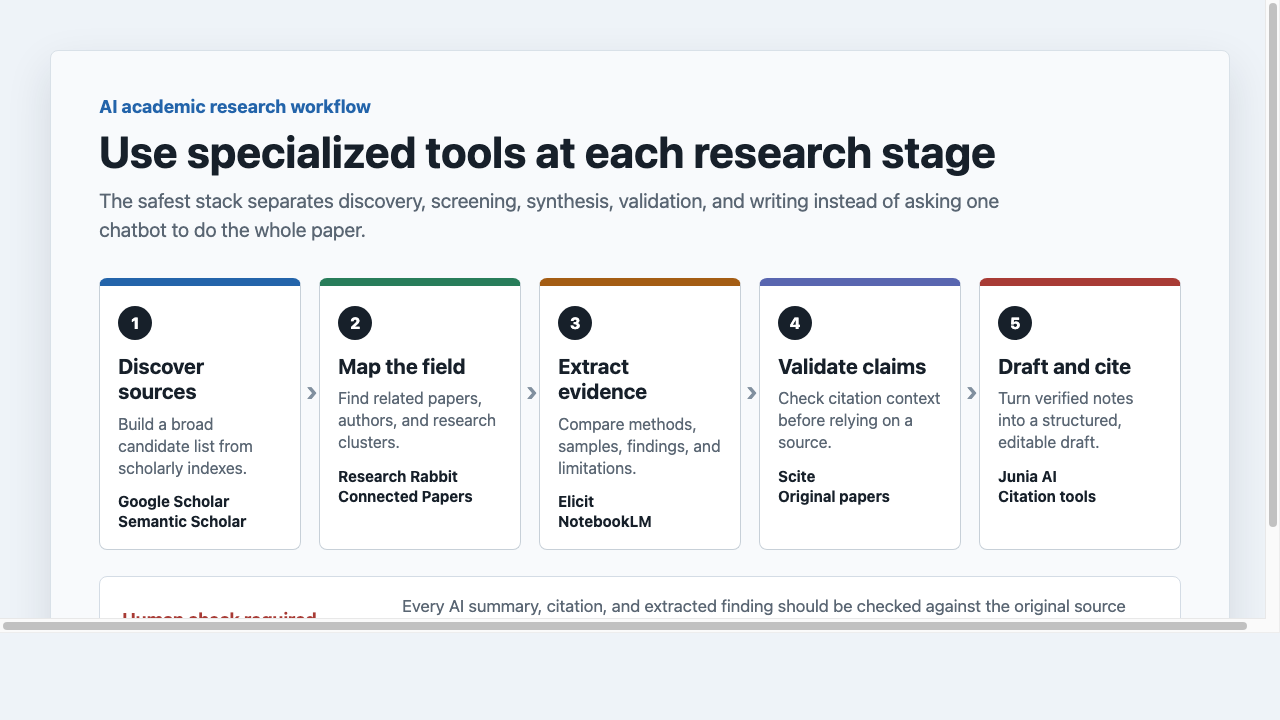
Более безопасный рабочий процесс обзора литературы с AI строится путем назначения каждому этапу инструмента, результаты которого можно проверить, и сверки каждого извлеченного вывода с исходной статьей. Небезопасный подход — просить один чат-бот находить, отбирать, извлекать, проверять и писать.
Поэтапный рабочий процесс выглядит так:
- Находите источники в научных индексах, таких как Google Scholar или Semantic Scholar, а не в окне чата.
- Картируйте область с помощью ResearchRabbit или Connected Papers, чтобы были видны связанные авторы и кластеры.
- Извлекайте доказательства с помощью Elicit, NotebookLM или исследовательского агента в структурированные заметки.
- Проверяйте утверждения в Scite и в исходных PDF, прежде чем считать любое предложение пригодным для цитирования.
- Пишите текст и расставляйте цитаты только на основе проверенного набора заметок.
Для Academic Research Assistant от Jenova настройка представляет собой исследовательское задание, а не обзор функций:
- Откройте агента по адресу jenova.ai/a/academic-research-assistant.
- Укажите вопрос, дисциплину и критерий готовности:
«Я пишу раздел методов о частоте ошибок цитирования LLM. Отдайте приоритет рецензируемым исследованиям и анализам издателей за 2023–2026 годы. Для каждого источника извлеките выборку, определение ошибки, частоту галлюцинаций и сведения о том, проверяли ли люди ссылки».
- Сначала запросите список потенциальных источников, затем таблицы извлечения, а уже после этого текст. Не переходите сразу к черновику.
- Сохраняйте отклоненные статьи в том же диалоге, чтобы агент не предложил их снова позднее.
Для Elicit эквивалентной отправной точкой будет узкий вопрос и список столбцов: популяция, вмешательство, исход, тип исследования. Для Scite начните с известной статьи или утверждения и изучите подтверждающие и противоречащие цитаты до начала написания текста. Для универсального чат-бота наиболее безопасное использование — составление плана и языковое редактирование после того, как источники уже существуют.
Два рабочих правила предотвращают большинство сбоев. Во-первых, никогда не принимайте цитату, которую нельзя открыть. Во-вторых, никогда не позволяйте модели, готовящей текст, быть единственной записью о том, что сказано в статье. Проверенная заметка — источник истины. Черновик — это переработанное расположение содержания этой заметки.
Когда универсальный чат-бот все еще является лучшим академическим инструментом?
Универсальный чат-бот по-прежнему является лучшим академическим инструментом, когда задача касается языка, структуры или объяснения, а не доказательств. Надежность зависит от задачи. Прослеживаемость цитат — неправильный критерий для модели написания текста, так же как беглость текста — неправильный критерий для поискового индекса.
Чат-боты остаются полезными для:
- Преобразования проверенного плана в более качественный академический текст
- Объяснения метода, который исследователь уже прочитал
- Генерации поисковых строк, контраргументов или контрольных списков для редактирования
- Перевода сложных фрагментов на более простой язык для заметок, но не для цитирования
Они плохо подходят в качестве основного механизма работы с литературой. Работы по классификации, связанные с Nature, рассматривают неподтвержденные утверждения чат-ботов как отдельный тип галлюцинаций, а библиотечные рекомендации продолжают повторять то же предостережение: сфабрикованные цитаты могут содержать полный набор из автора, названия и журнала. Такой тип сбоя дорого обходится в диссертациях, заявках на гранты и журнальных статьях, где одна выдуманная ссылка способна подорвать доверие к остальной тщательной аргументации.
Есть и процессуальная причина сохранять чат-боты в наборе инструментов. Специализированные инструменты более узки. Elicit не будет отрабатывать ритм абзаца. Scite не будет вести семестровую консультацию о главе диссертации. ResearchRabbit не оформит ссылки в стиле конкретного журнала. Чат-бот или универсальный агент для написания текста закрывает эти пробелы после того, как доказательства уже зафиксированы.
Практическое правило — последовательность. Сначала используйте специализированный поиск и проверку. Затем применяйте универсальную модель и только к тексту, источники которого уже существуют в библиотеке, доступной для открытия. Если чат-бот добавляет новую цитату во время редактирования, считайте эту цитату недоверенной, пока она не пройдет те же проверки TRACE, что и остальная рукопись.
Что специалисты по исследовательской добросовестности говорят о цитатах AI?
Специалисты по исследовательской добросовестности рассматривают универсальные чат-боты как инструменты подготовки текста, а специализированные системы, привязанные к источникам, — как единственный приемлемый уровень для утверждений, которые будут цитироваться. Консенсус состоит не в том, чтобы «избегать AI». Он состоит в том, чтобы «не позволять генератору без привязки к источникам становиться записью о том, что говорит литература».
«Проблема, которую мы постоянно наблюдаем, не в том, что модели плохо пишут. Она в том, что они создают полные библиографии для несуществующих статей или для реальных статей, не содержащих заявленного результата. Как только такие строки попадают в черновик, они начинают вести себя как доказательства. Рецензенты, соавторы и последующие инструменты цитирования могут распространить их до того, как кто-либо откроет источник.»
«Специализированный исследовательский ассистент меняет единицу работы. Вместо запроса на абзац с цитатами вы запрашиваете утверждение, фрагмент и классификацию: подтверждено, не подтверждено, опровергнуто или недостаточно доказательств. Такой результат получается медленнее и выглядит менее изящно. Но только такой результат способен защитить раздел методов.»
«Постоянная память о проекте важнее, чем люди ожидают. Галлюцинации часто возвращаются в статью во время редактирования, когда универсальному чат-боту предлагают „добавить источники“ в раздел, который уже был чистым. Ассистент, помнящий, какие статьи были исключены и почему, выполняет работу по обеспечению добросовестности, а не только делает работу удобнее. Даже в этом случае исходный PDF остается авторитетным источником.»
— Команда продукта Jenova, академические исследовательские процессы, многолетняя работа над проектированием агентов с привязкой к цитатам
Эта позиция согласуется с рекомендациями библиотекарей и специалистов по синтезу доказательств. King's College London рекомендует использовать AI как дополнительный инструмент, проверять авторские права перед загрузкой полных текстов и исходить из того, что генеративные инструменты по-прежнему могут выдумывать ссылки и предметные рубрики. Анализы на уровне издательств теперь рассматривают галлюцинированные ссылки как проблему корпуса, а не как отдельные анекдотические случаи. Один комментарий 2026 года, опирающийся на изучение Nature примерно 4 000 публикаций, отметил, что 65 из 100 наиболее подозрительных работ содержали как минимум одну недействительную ссылку; эта закономерность может означать более 110 000 затронутых статей среди примерно 7 миллионов публикаций 2025 года.
Практический вывод экспертов очевиден. Выбирайте инструменты, которые делают проверку простой. Отказывайтесь от инструментов, которые создают ощущение, будто проверка не нужна.
Источники
- Higher Education Policy Institute — Опрос студентов об генеративном AI, 2025
- ERIC / Министерство образования США — Опрос студентов об генеративном AI, 2025, HEPI Policy Note 61
- Boretti, Energy Research & Social Science — Галлюцинации в генеративном AI и научная добросовестность
- Wikipedia — Галлюцинация (искусственный интеллект)
- Библиотека McGoogan Университета Небраски — Галлюцинации AI с цитатами
- Science / AAAS — Почему модели AI галлюцинируют вместо признания неопределенности
- LlamaIndex — Извлечение данных с привязкой к цитатам
- Руководство библиотеки King's College London — Инструменты AI в синтезе доказательств
- Elicit — AI для научных исследований
- Scite — Исследования с подтвержденными цитатами и Smart Citations
- ResearchRabbit — Картирование литературы и сети цитирования
- newline — Бенчмарки для проверки научных ссылок, созданных LLM
- Paperguide — Сравнение AI-инструментов для академических исследований, 2026
- arXiv — SemanticCite: проверка цитат с анализом полного текста
- Nature Humanities and Social Sciences Communications — Классификация галлюцинаций AI