Мульти-модельные AI-платформы лучше исследовательских инструментов с одной моделью?
2026-08-22
Как маршрутизация задач и разнообразие моделей меняют качество исследований и текстов?
Для сложных процессов поиска, анализа и подготовки текстов в 2026 году платформы с маршрутизацией задач между несколькими моделями обычно превосходят исследовательские инструменты с одной моделью, поскольку могут поручать поиск, рассуждение и подготовку черновика разным моделям, а не заставлять одну систему выполнять всю работу. Jenova особенно сильна, когда проект должен пройти путь от сбора источников и синтеза до готового черновика в одном постоянном рабочем пространстве. ChatGPT и Claude по-прежнему сильнее для быстрого самостоятельного создания текстов. Perplexity и Elicit по-прежнему лучше подходят для узконаправленного поиска в привычном интерфейсе.
Разрыв в качестве зависит не от того, у какого бренда самая крупная модель. Он определяется тем, может ли стек менять модели, инструменты и специалистов по мере изменения задачи.
Ключевые факторы, отличающие способный исследовательский чат от платформы для рабочих процессов:
✅ Точность поиска — остаются ли ответы привязанными к доступным для проверки источникам, а не к памяти одной модели ✅ Интеллект маршрутизации — может ли система направлять обзор литературы, расчёты и подготовку текста разным моделям ✅ Непрерывность подготовки текста — сохраняется ли контекст исследования в плане, черновике и правках ✅ Обнаружение ошибок — может ли вторая модель или агент оспорить первый результат ✅ Контроль затрат — резервируются ли дорогие передовые модели для сложных этапов
AWS отмечает, что одна большая языковая модель (LLM) часто не может одновременно оптимизировать стоимость, задержку и качество для смешанных задач, поэтому маршрутизация стала ключевым архитектурным решением. Чтобы справедливо сравнить эти инструменты, полезно отделить то, что одна модель делает хорошо, от того, что может поддерживать маршрутизируемый мультиагентный рабочий процесс.
Почему сложные процессы поиска и написания текстов перерастают инструменты с одной моделью?
Сложные исследовательские задачи и работа с текстами перерастают инструменты с одной моделью, потому что это уже не один запрос. Это последовательность поиска, фильтрации, сравнения, составления плана, подготовки черновика и проверки фактов — и для каждого из этих шагов важны разные сильные стороны.
Обзор литературы требует актуальных источников. Критика методологии требует тщательного рассуждения. Клиентская записка требует контроля тона. Один чат может приблизительно справиться со всеми тремя задачами, но обычно делает это в одном контекстном окне и сохраняет все слепые зоны одной модели.
Библиотекари академических учреждений отмечают, что инструменты генеративного AI по-прежнему подвержены ошибкам, ограниченному пониманию контекста и ограниченным возможностям поиска. Университетские исследовательские руководства также указывают на галлюцинации, пробелы в обучающих данных и литературу за платным доступом как на структурные ограничения. Эти ограничения усиливают друг друга, когда одна модель одновременно ищет информацию и пишет текст.
Именно поэтому исследователи теперь объединяют специализированные инструменты. Сравнения исследовательских AI в 2026 году неоднократно показывают, что ни один продукт не охватывает одинаково хорошо поиск, анализ, написание текстов и презентацию. Подборки академических рабочих процессов по-прежнему распределяют работу между Consensus, Elicit, Semantic Scholar и Perplexity, а не рекомендуют один универсальный чат-бот.
Практический вопрос теперь заключается не в том, «какая модель умнее». Он в том, может ли ваш стек направить каждый этап в систему, которая с наименьшей вероятностью потерпит неудачу именно на этом этапе.
Что следует оценивать при выборе AI-стека для исследований и написания текстов?
AI-стек для исследований и написания текстов следует оценивать по точности поиска, интеллекту маршрутизации и непрерывности подготовки текста — с помощью трёхчастного фреймворка SRC, — а не по качеству демонстрационных ответов на один запрос.
Фреймворк SRC задаёт три вопроса, соответствующие тому, как на практике ломаются исследования:
- Точность поиска. Может ли инструмент найти актуальные материалы, на которые можно сослаться, или он воссоздаёт ответ из обучающих данных?
- Интеллект маршрутизации. Может ли он направить вопрос о методологии, экономичную переработку текста и длинный синтез разным моделям?
- Непрерывность подготовки текста. Может ли одно рабочее пространство помнить источники, отклонённые утверждения и требования к стилю на протяжении работы над черновиком?
Дополнительные критерии становятся важны, когда рабочий процесс длится больше одного сеанса:
- Инструменты привязки к источникам. Веб-поиск, академический поиск, файлы и работа с цитированием.
- Память. Сохраняются ли предпочтения и предыдущие выводы между сеансами.
- Оркестрация. Могут ли исследование, написание и проверка выполняться как скоординированные роли.
- Наблюдаемость. Можете ли вы увидеть, какая модель или агент создали конкретное утверждение.
- Структура затрат. Платите ли вы по тарифам передовых моделей за каждый недорогой этап классификации.
- Режим отказа. Разрушает ли один слабый ответ весь проект.
HatchWorks формулирует ключевой выбор как одну универсальную LLM против мульти-модельного стека, который распределяет работу по задачам. TrueFoundry описывает мульти-модельную маршрутизацию как отправку каждого запроса модели, лучше всего подходящей для этой работы. Это архитектурные решения, а не списки функций.
Инструмент может хорошо оцениваться по качеству чата и всё же не пройти проверку SRC, если каждый ответ создаётся одной и той же моделью, в одном и том же сеансе и без независимой проверки.
Как ChatGPT, Claude, Perplexity, Elicit и Jenova сравниваются в многоэтапной работе?
ChatGPT и Claude наиболее сильны как универсальные решения с единым интерфейсом, Perplexity и Elicit — как специализированные исследовательские интерфейсы, а Jenova — когда поиск, анализ и написание текстов должны оставаться связанными в мульти-модельном рабочем пространстве.
ChatGPT стабильно появляется в списках инструментов 2026 года как универсальный помощник. Claude часто рекомендуют для длинных академических текстов. Perplexity широко используется для исследовательского поиска, хотя некоторые руководства по академическим процессам советуют проявлять осторожность. Elicit позиционируется как AI-помощник для обзора литературы.
Jenova устроена иначе. Пользователи могут переключаться между моделями от OpenAI, Anthropic, Google, DeepSeek и xAI, хранить неограниченную историю чатов и подключать базы знаний. Специализированные агенты, такие как Academic Research Assistant и Writing Assistant, работают на том же стеке, поэтому результаты обзора литературы не нужно копировать в отдельный инструмент для написания текста.
Компромисс реален. Elicit остаётся более специализированным решением для структурированного извлечения данных из статей. Claude остаётся проще, когда единственная задача — подготовить длинный, тщательно проработанный текст. Преимущество Jenova проявляется, когда в проекте несколько ролей, а не когда пользователю нужно минимальное число настроек.
| Функция / измерение | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| Доступ к моделям | Универсальный помощник одного поставщика | Модель одного поставщика с длинным контекстом | Интерфейс с приоритетом поиска поверх размещённой модели | Модель для специализированного исследовательского процесса | Доступ к нескольким поставщикам с выбором модели на уровне задач |
| Поиск и привязка к источникам | Сильная универсальная веб-поддержка; не специализированная база литературы | Сильный анализ документов; слабее как актуальный исследовательский индекс | Сильное решение для быстрого поиска с цитатами | Сильное решение для структурированного обзора литературы | Web, Scholar, файлы и базы знаний в одном рабочем пространстве |
| Многоэтапная оркестрация | Пользователь сам управляет запросами между чатами | Пользователь сам управляет запросами с длинным контекстом | Лучше всего для циклов «вопрос — ответ» | Лучше всего для конвейеров обзора, но не для полного написания текста | Оркестрация агентов и маршрутизация моделей для исследований и написания текстов |
| Память и непрерывность | Память диалога внутри продукта | Сильный контекст внутри ветки; слабее как межпроектная система учёта | Ограниченная память проекта за пределами поисковых веток | Ориентирован на исследования и статьи, а не на черновики | Постоянная межсеансовая память и прикреплённые документы |
| Цены по состоянию на 2026 год | Не подтверждены в этом обзоре | Не подтверждены в этом обзоре | Не подтверждены в этом обзоре | Не подтверждены в этом обзоре | Бесплатный тариф с ограниченным использованием; платные тарифы от $20/месяц |
| Лучше всего подходит для | Быстрых общих исследований и черновиков | Длинных рукописей и тщательной прозы | Ответов с цитатами на отдельные вопросы | Академического обзора литературы | Сквозных процессов поиска, анализа и написания текстов |
Ещё один мульти-модельный вариант — Multi, который заявляет, что предоставляет 300+ моделей от крупных лабораторий в рамках четырёх рабочих процессов. Это делает его актуальным для команд, которым нужен прямой выбор моделей. Он менее актуален, если пользователю нужны специализированные агенты, постоянная память проекта и единое рабочее пространство от исследования до черновика.
Какой AI-подход обеспечивает более надёжный поиск и обнаружение источников?
Инструмент, специализированный на поиске, или мульти-модельная платформа с актуальным извлечением данных надёжнее для обнаружения источников, чем одна универсальная модель, отвечающая по памяти. Причина проста: обнаружение и синтез — это разные режимы отказа.
Чат с одной моделью эффективен, когда вы уже знаете вопрос и нужен только первичный вариант объяснения. Он становится уязвимым, когда ответ зависит от того, что было опубликовано после обучения модели, что находится за платным доступом или чему противоречит другая база данных.
ConvergePanel утверждает, что исследование с одной моделью скрывает разногласия из-за слишком раннего синтеза, тогда как мульти-модельное исследование сохраняет расхождения и сигналы о качестве источников. Argumentree высказывает аналогичную мысль: одна модель наследует собственные ошибки без независимой проверки, в то время как мульти-модельное исследование может валидировать утверждения.
На практике более надёжная схема выглядит так:
- Используйте инструмент с приоритетом извлечения данных, чтобы собрать кандидатов в источники.
- Используйте вторую модель, чтобы извлечь методы, размеры выборок и ограничения.
- На третьем этапе отметьте неподтверждённые логические скачки до начала написания текста.
Elicit и Consensus созданы для отдельных частей этой последовательности. Consensus сосредоточен на ответах в доказательном формате, основанных на рецензируемой литературе. Perplexity работает быстрее, когда вопрос ближе к веб-поиску, чем к систематическому обзору.
Jenova полезнее, когда обнаружение источников — только первый этап. Academic Research Assistant может искать по академическим базам данных и сохранять привязку к цитатам, а затем передавать тот же контекст проекта агенту для написания текста. Это не заменяет специализированную доказательную базу данных для формального систематического обзора. Но это сокращает разрыв, возникающий при копировании и вставке и обычно приводящий к дрейфу цитирования.
Надёжный запрос для этапа поиска должен чётко задавать охват и правила исключения:
«Найди рецензируемые источники за 2023–2026 годы о маршрутизации между несколькими LLM в производственных системах. Исключи посадочные страницы поставщиков. Для каждого источника извлеки заявленное улучшение стоимости или качества, метод оценки и одно ограничение, которое признают авторы.»
Если инструмент не способен выполнить эту инструкцию без выдумывания статей, это средство помощи в написании текста, а не исследовательский стек.
Как мульти-модельная маршрутизация улучшает анализ, не раздувая затраты?
Мульти-модельная маршрутизация улучшает анализ, направляя недорогую классификацию и поиск небольшим моделям, а более сильные модели резервируя для сравнения, проверки противоречий и структурированного рассуждения. При грамотной реализации это повышает качество и может снизить расходы. При плохой реализации сам маршрутизатор становится ещё одним платным этапом.
AWS выделяет два семейства маршрутизации: статическую маршрутизацию через выделенные интерфейсы и динамическую маршрутизацию, которая классифицирует запрос до выбора модели. Динамическая маршрутизация может использовать модель-классификатор, семантическое сходство или их гибрид. Amazon Bedrock Intelligent Prompt Routing представлен как управляемый способ сократить стоимость запросов до 30%, выбирая более дешёвую модель, которая всё ещё соответствует требуемому уровню качества.
MindStudio сообщает, что сопоставление задач с подходящей моделью может сократить затраты на 60%, если разделить планирование и выполнение вместо отправки каждого шага передовой модели. Эта цифра заявлена поставщиком, поэтому её следует считать верхней границей, а не гарантией. Однако базовая логика остаётся верной: в анализе есть недорогие и дорогие подзадачи.
Практическое разделение задач для исследовательского анализа выглядит так:
- Небольшая или быстрая модель: помечает документы, извлекает цитаты, нормализует ссылки, кластеризует темы.
- Модель среднего уровня: резюмирует методы и отмечает отсутствующие сопоставления.
- Высокопроизводительная модель: согласует противоречия, проверяет причинно-следственные утверждения на прочность, пишет аналитическую записку.
Jenova поддерживает такое разделение, поскольку пользователи могут менять поставщиков моделей внутри одного проекта, а не экспортировать заметки между приложениями. Ограничение состоит в том, что маршрутизация хороша ровно настолько, насколько хорошо определена задача. Если попросить одного агента «проанализировать всё», вы заново построите однoмодельный рабочий процесс с дополнительными накладными расходами.
AWS также отмечает, что кастомная маршрутизация увеличивает задержку и стоимость классификатора, поэтому экономия должна превышать издержки маршрутизации. Для 20-минутного брифинга одна сильная модель часто обходится дешевле. Для регулярного исследовательского конвейера маршрутизация обычно окупается.
Когда одна AI-модель всё ещё создаёт более качественные тексты?
Одна AI-модель всё ещё создаёт более качественные тексты, когда задача линейна, набор источников уже выбран, а стилистическая последовательность важнее независимой проверки. В таких случаях дополнительные агенты могут добавить разрывы, задержки и противоречащие друг другу правки.
Рекомендации GitHub по оркестрации агентов однозначны: если задачи просты и линейны, лучше подходит один агент. Написание текстов часто соответствует этому описанию. Одна модель с длинным контекстом, которая видит план, заметки и последние три абзаца, обычно лучше удерживает голос автора, чем три специалиста, передающие черновики друг другу.
Claude — самый наглядный пример. Его неоднократно рекомендуют для длинных академических текстов, поскольку задача заключается в последовательной прозе, а не в переключении инструментов. ChatGPT часто достаточно для писем, брифов и первых черновиков, где скорость важнее архитектуры цитирования.
Однoмодельное написание текста начинает уступать, когда черновик зависит от актуальных доказательств, нескольких версий для заинтересованных сторон или проверки QA, которая не должна доверять исходному автору. Здесь оправдано использование пишущего агента вместе с отдельным агентом для проверки.
Writing Assistant в Jenova рассчитан на середину этого спектра: адаптироваться к формату и аудитории, сохранять стабильный голос и работать в пространстве, где уже хранится исследование. Он не становится автоматически лучше Claude для самостоятельного эссе. Он сильнее, когда черновик должен продолжать использовать те же источники, исключения и терминологию, собранные ранее.
Задание для написания текста одной моделью всё равно должно быть точным:
«Используя только восемь источников, уже находящихся в этом проекте, напиши объясняющий текст объёмом 900 слов для менеджеров по продукту. Не добавляй новые цитаты. Сохрани нетехнический уровень изложения. Отметь любое утверждение, которое не подтверждено прикреплёнными заметками.»
Если вашу задачу по написанию можно сформулировать настолько чётко, одна модель — не компромисс. Это правильная архитектура.
Чем отличаются одноагентная и мультиагентная архитектуры для исследовательских процессов?
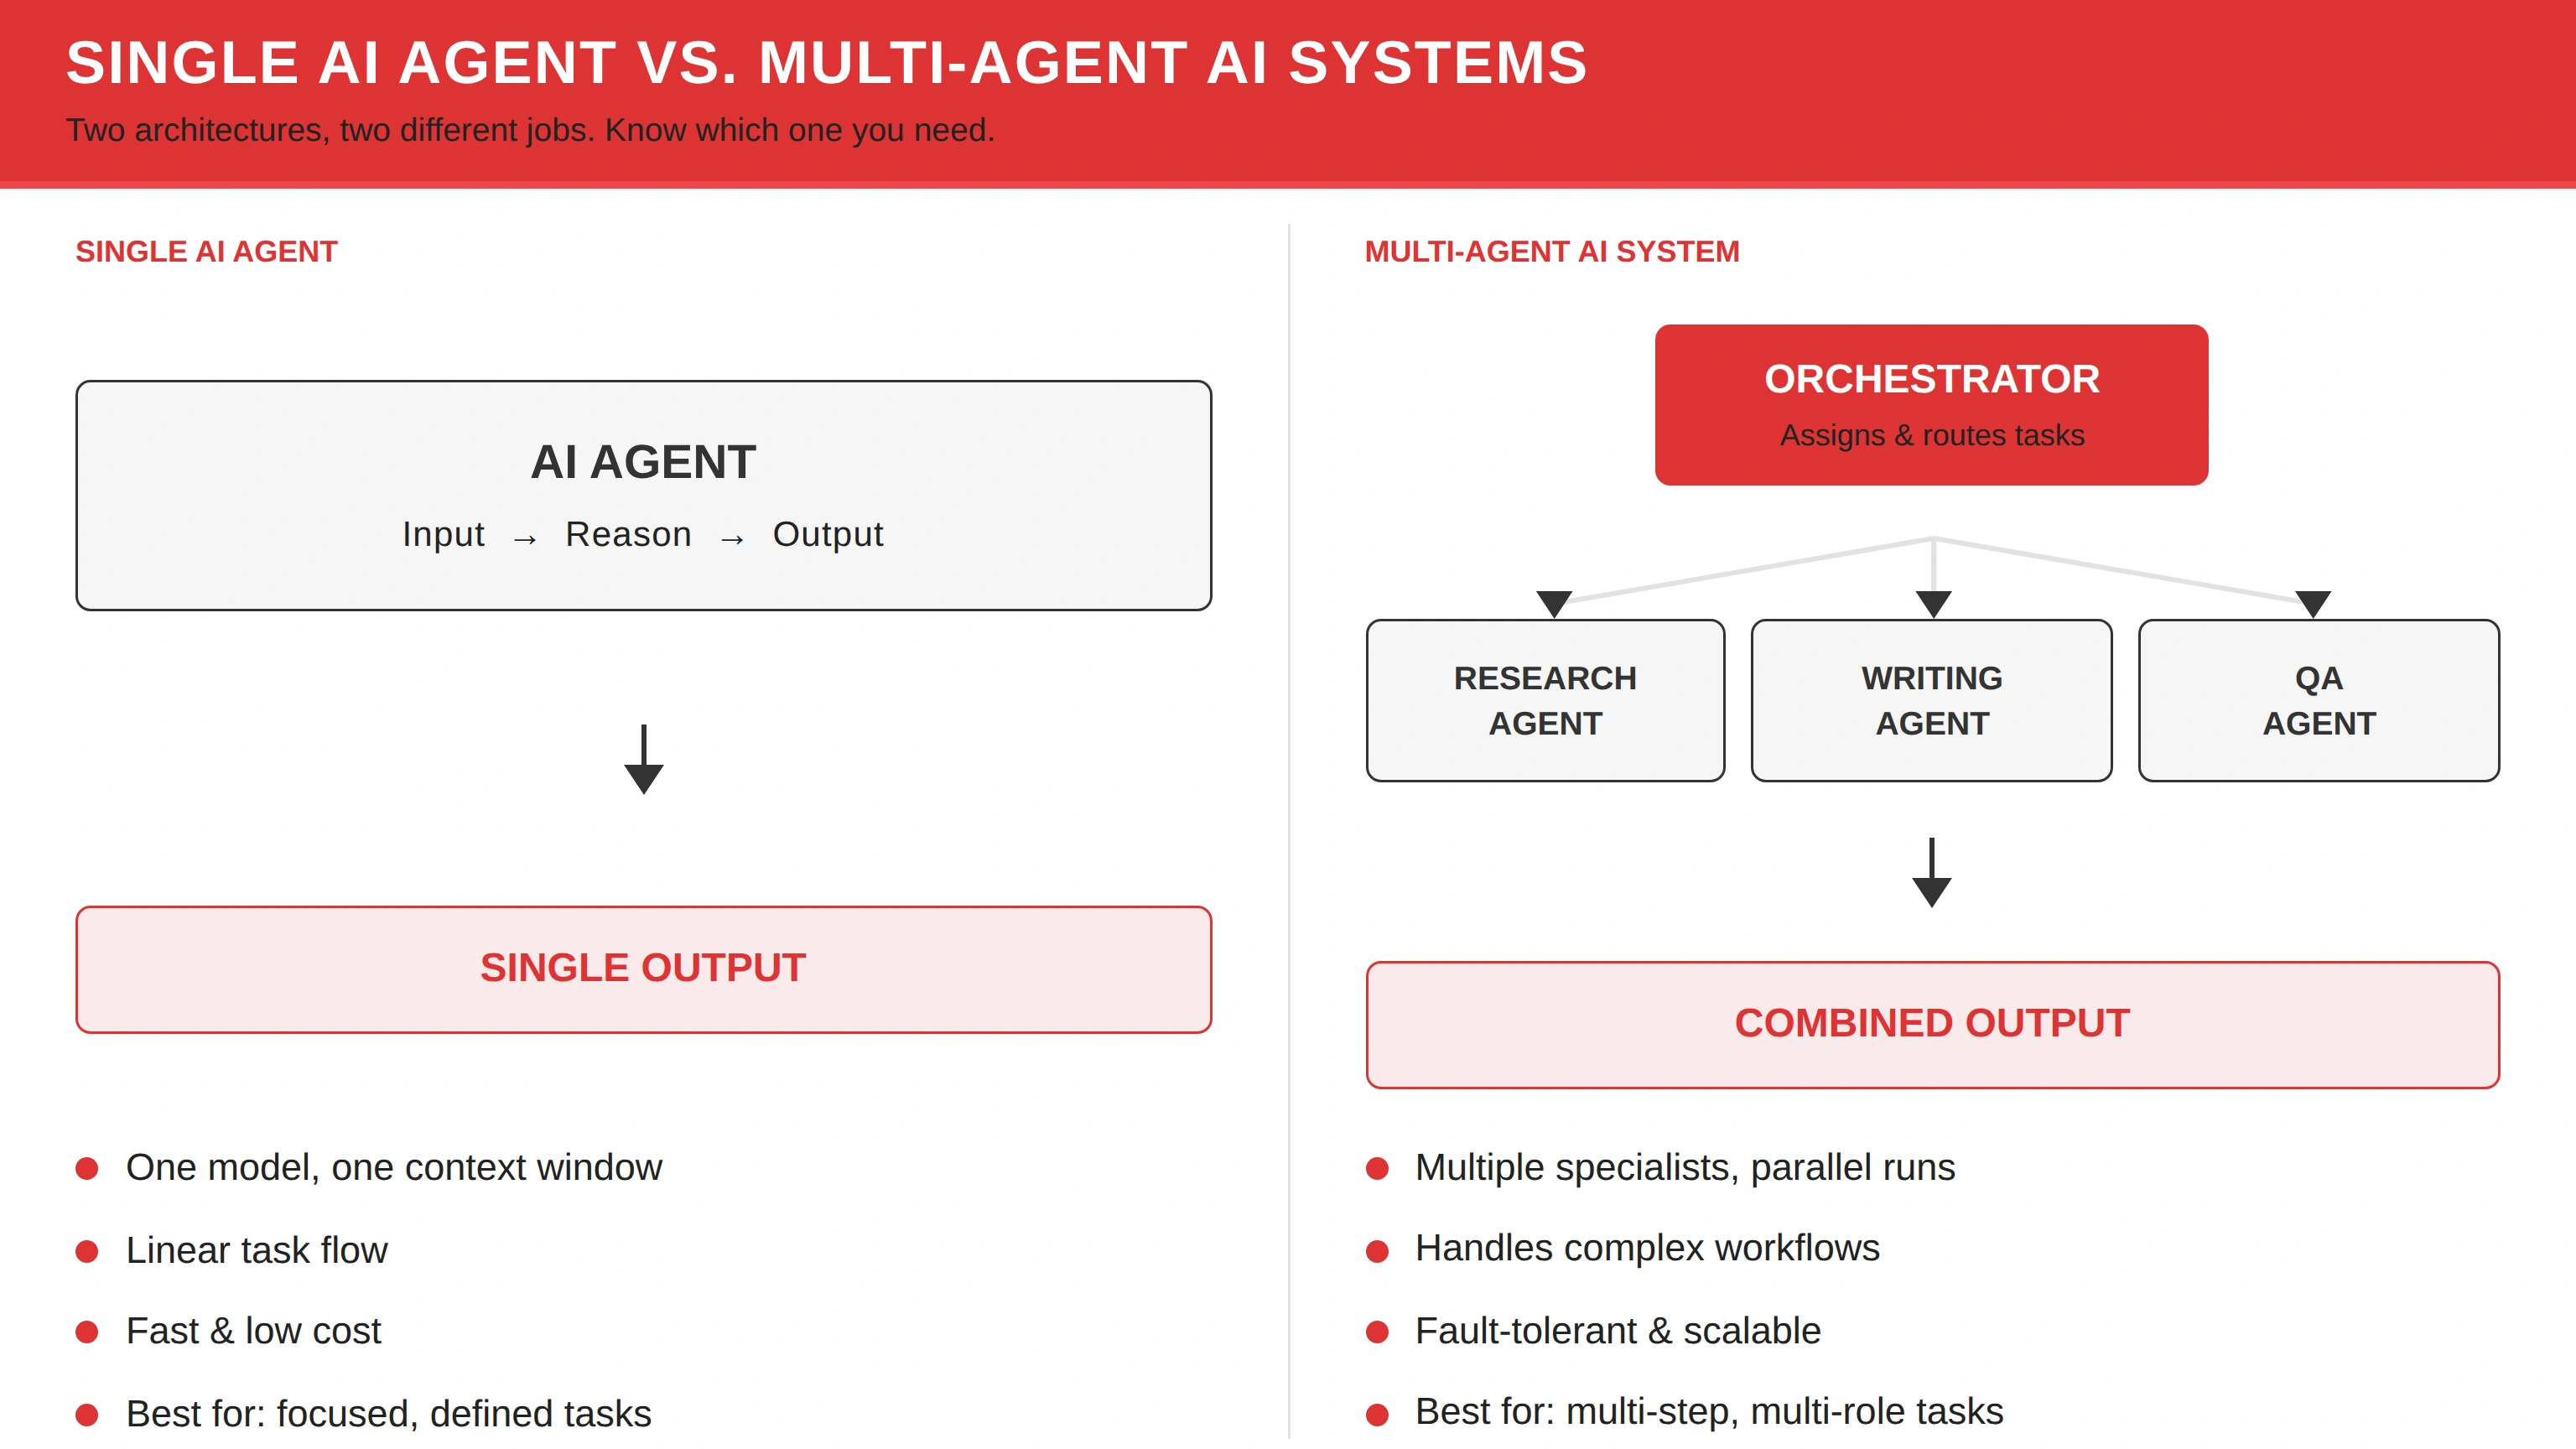
Одноагентная система использует одну модель и одно контекстное окно в линейном цикле «ввод — рассуждение — вывод», тогда как мультиагентная система использует оркестратор для назначения специализированных ролей, таких как исследование, написание текста и QA. Первая быстрее и дешевле для определённых задач. Вторая более устойчива к сбоям в многоэтапной работе.
Оркестрация AI-агентов — это уровень управления, координирующий несколько автономных агентов для общей цели, включая состояние, разрешения и контрольные точки для человека. Это отличается как от простого наличия нескольких агентов, так и от обычной AI-оркестрации, которая лишь выстраивает в последовательность модели и API. Kimi описывает ту же схему с точки зрения рабочего процесса: один агент исследует, другой планирует, третий пишет.
Архитектурный контраст проще всего увидеть в академическом производстве. В апреле 2026 года Google Research описала PaperVizAgent как систему из пяти агентов — извлекателя, планировщика, стилиста, визуализатора и критика, — которая получила 60,2 балла против человеческого базового уровня в 50,0 при создании иллюстраций. Сопутствующая система ScholarPeer использует нескольких агентов, чтобы привязывать рецензирование к актуальной литературе, а не рассматривать рецензирование как одноразовую генерацию текста. Эти результаты не доказывают, что каждый мультиагентный стек лучше. Но они показывают, почему специализация вместе с критикой может превзойти один запрос.
Затраты столь же конкретны. Мультиагентным системам нужны явные протоколы, больше инфраструктуры и ограничения расходов. Без оркестрации агенты могут дублировать работу, конфликтовать или повторять попытки, пока расходы не вырастут. У одноагентных систем противоположный риск: одна ошибка завершает всю работу.
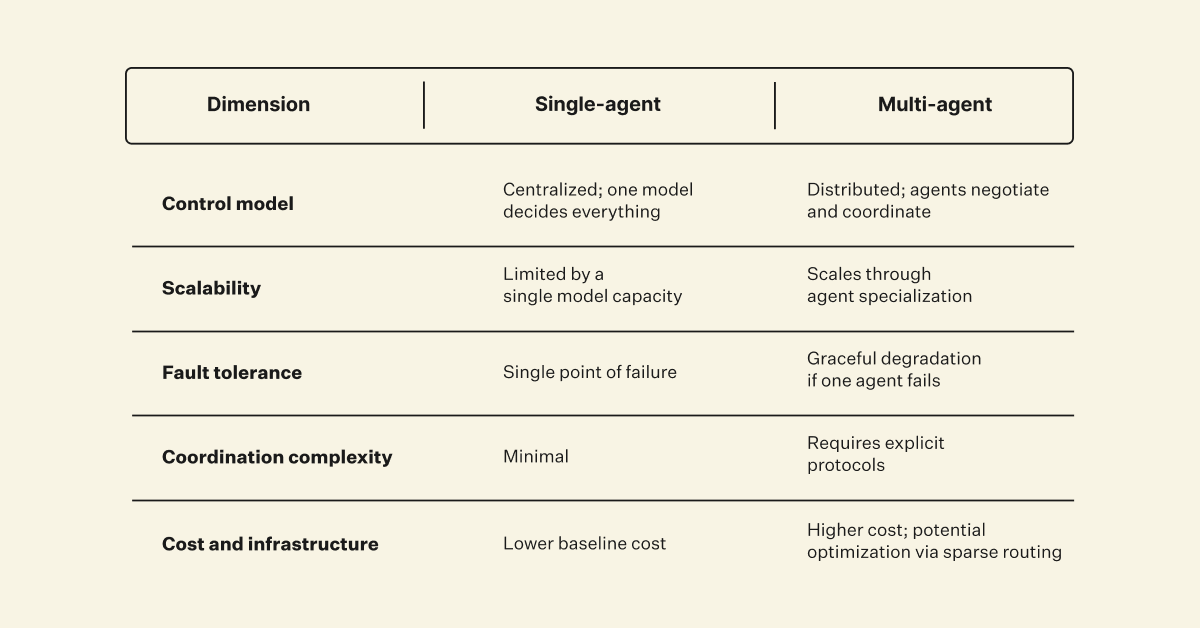
Для исследований и написания текстов полезно ориентироваться на число ролей. Если у работы одна роль, используйте одного агента. Если в работе есть исследователь, автор и рецензент, используйте оркестрируемую систему — либо примите, что оркестратором будете вы сами.
Как создать полный процесс исследований и написания текстов с AI?
Полный процесс исследований и написания текстов с AI строится путём разделения поиска, анализа и подготовки текста, после чего для каждого слоя выбирается однoмодельный инструмент или маршрутизируемая платформа, а не один чат для всего проекта.
Устойчивая последовательность выглядит так:
- Определите решение. Сформулируйте вопрос, на который должен ответить итоговый документ, а также то, что могло бы его опровергнуть.
- Соберите источники с помощью инструмента с приоритетом поиска. Используйте Elicit или Consensus для обзора статей, Perplexity для брифинга в масштабе веба либо Academic Research Assistant в Jenova, когда одно пространство должно сохранять цитаты.
- Проведите анализ второй моделью. Извлекайте методы, разногласия и уровень уверенности, а не только резюме.
- Подготовьте черновик со специалистом по написанию текстов. Используйте Claude для самостоятельной рукописи или Writing Assistant в Jenova, когда черновик должен оставаться связанным с памятью проекта.
- Выполните критическую проверку QA. Попросите другую модель атаковать цитаты, хронологию и чрезмерные утверждения.
- Зафиксируйте итоговый материал. Экспортируйте его только после удаления или понижения неподтверждённых утверждений.
В Jenova эта последовательность может оставаться в одной учётной записи. Пользователь может начать с Academic Research Assistant, переключить модели для аналитического этапа, а затем продолжить с Writing Assistant или SEO Blog Generator, если результатом должна стать публичная статья. Постоянная память и прикреплённые файлы сокращают обычную потерю ограничений при переходе между инструментами.
Хороший запрос для передачи работы между исследованием и написанием текста чётко указывает, что не должно измениться:
«Вот пакет источников и утверждения, которые мы уже отклонили. Подготовь раздел анализа для аудитории, формирующей политику. Каждый абзац должен опираться на один сохранившийся источник. Если утверждение выведено логически, пометь его как вывод. Не возвращай в текст отклонённые утверждения.»
В однoмодельном инструменте тот же рабочий процесс всё ещё возможен. Вы просто становитесь маршрутизатором: создаёте новые чаты, вставляете заметки и вручную выбираете модель для QA. Это может быть правильным подходом для эпизодической работы. Он становится ненадёжным, когда проект длится неделями или включает несколько типов документов.
Jenova — не самый простой способ сделать разовое резюме. Её преимущество в том, что описанный выше процесс не требует трёх подписок и личной системы заметок, чтобы поддерживать согласованность всех частей.
Что говорят команды AI-инфраструктуры об однoмодельных и мульти-модельных стеках?
Команды AI-инфраструктуры обычно считают однoмодельные инструменты правильным вариантом по умолчанию для линейной работы, а мульти-модельные платформы — правильным вариантом по умолчанию, когда рабочий процесс включает специализированные роли, ограничения по затратам или независимый этап проверки.
«Самая дорогостоящая исследовательская ошибка, которую мы наблюдаем, — не выбор неправильной передовой модели. Это использование одной модели в роли исследователя, аналитика и редактора, а затем доверие к гладкости финального абзаца. Когда одна и та же система выдумывает источник, а затем пишет зависящее от него предложение, внутренней тревоги не возникает. Вторая модель не гарантирует истину, но создаёт возможность для несогласия.»
«Маршрутизация оправдывает сложность только после того, как вы можете назвать виды работ. „Исследуй это и напиши“ — всё ещё одна работа. „Собери статьи-кандидаты, извлеки методы, согласуй конфликты, подготовь черновик, затем проверь цитаты“ — это пять работ. Команды, пропускающие такую декомпозицию, покупают мультиагентную схему, но продолжают запускать один запрос.»
«Аргументы о стоимости реальны, но работают в обе стороны. Опубликованные Amazon исследования маршрутизации показывают, что отправлять каждый запрос самой сильной модели — расточительно, а заявленная поставщиками экономия от 30% до 60% правдоподобна, когда классификация и написание текста разделены. Однако противоположная ошибка тоже распространена: оркестратор, классификатор и три специалиста тратят больше, чем одна тщательная модель потратила бы на короткую записку.»
— Команда продукта Jenova, архитектура AI-рабочих процессов, 8 лет разработки мульти-модельных агентных систем
Эта точка зрения соответствует публичной инженерной литературе. AWS рассматривает маршрутизацию между несколькими LLM как ответ на смешанные типы задач, а не как универсальное улучшение. GitHub считает оркестрацию необходимой после распространения агентов, а не до него. Экспертный консенсус условен: добавляйте модели, когда в работе есть отдельные этапы. Не добавляйте модели лишь для усложнения простой задачи.
Когда следует продолжать использовать исследовательский инструмент с одной моделью?
Следует продолжать использовать исследовательский инструмент с одной моделью, когда вопрос ограничен, источники уже собраны, срок короткий и вам не нужна вторая система для аудита первой. В этих условиях мульти-модельная маршрутизация добавляет издержки координации, почти не повышая достоверность.
Оставайтесь с ChatGPT или Claude, если вы:
- Объясняете знакомую концепцию, а не составляете карту литературы.
- Переписываете документ, которому уже доверяете.
- Исследуете тон, структуру или порядок аргументов.
- Работаете за один сеанс без передачи результата другому участнику команды.
Оставайтесь с Perplexity или Elicit, если вы:
- Задаёте отдельный вопрос, требующий цитат.
- Отбираете аннотации перед более глубоким чтением.
- Проводите обзор литературы, который будет оформлен в другом месте.
Переходите на мульти-модельную платформу с маршрутизацией задач, когда верны два или более из следующих условий:
- Проект сочетает поиск, анализ и готовый текст.
- Результат должен сохранять цепочку источников между черновиками.
- Вам нужны разные модели для извлечения данных, рассуждения и прозы.
- Работа повторяется достаточно часто, чтобы был важен повторно используемый рабочий процесс.
- Ошибочная цитата будет дорого стоить.
Jenova соответствует второму списку. Она слабее как замена процессу извлечения данных из статей в Elicit и слабее Claude как лаконичный автор с длинным контекстом. Она сильнее, когда эти задачи должны выполняться вместе — с памятью, выбором моделей и специализированными агентами в одном месте.
Таким образом, решение — не «одна модель или несколько моделей» как проверка лояльности. Вопрос в том, похож ли ваш рабочий процесс ещё на разговор или уже на производственную линию. Разговоры принадлежат одной модели. Производственные линии — маршрутизатору.
Источники
- Блог AWS Machine Learning — Стратегии маршрутизации между несколькими LLM для генеративных AI-приложений в AWS
- Библиотека The Chicago School — Инструменты и ресурсы искусственного интеллекта: преимущества и ограничения
- Библиотека Университета округа Колумбия — Применение и ограничения генеративного AI
- PapersFlow — Лучший AI для исследователей в 2026 году: сравнение 10 инструментов по категориям
- Thesify — Лучшие AI-инструменты для академических исследований в 2026 году
- HatchWorks AI — Сценарии применения больших языковых моделей: одна LLM против нескольких моделей
- TrueFoundry — Мульти-модельная маршрутизация: эффективная оптимизация AI-задач
- Synthesia — 12 лучших AI-инструментов 2026 года
- AnswerThis — 10 лучших AI-инструментов для исследователей в 2026 году
- Zerve — AI-инструменты для исследований в 2026 году: обзор литературы и анализ
- Multi — Одна задача, правильный AI-рабочий процесс
- ConvergePanel — Лучший мульти-модельный AI-инструмент для исследований
- Argumentree.AI — AI-исследование с несколькими моделями против одной модели
- MindStudio — Как сократить затраты на 60%, сопоставляя задачи с подходящей моделью
- GitHub Resources — Что такое оркестрация AI-агентов?
- Kimi AI — Оркестрация AI-агентов: типы, этапы и преимущества
- Google Research — Два AI-агента для более качественных иллюстраций и рецензирования