Лучше ли AI-рабочие пространства для систематического картирования доказательств?
2026-08-22
Чем отличаются постоянное состояние проекта и извлечение фрагментов по запросу?
Для систематического картирования доказательств исследовательское рабочее пространство, которое в начале каждого сеанса загружает решения, статус и артефакты, является более подходящей основной средой, чем суммаризатор отдельных статей или RAG-чат-бот, извлекающий «релевантные фрагменты» только по запросу. Картирование — это долгосрочный проект кодирования: критерии включения меняются, пограничные исследования перекодируются, а синтез зависит от памяти о том, почему источник был отсеян на прошлой неделе. Инструменты для работы с отдельными статьями, такие как Elicit, Consensus и NotebookLM, по-прежнему сильны в поиске, извлечении данных и ответах на вопросы по закрытому корпусу. Постоянное рабочее пространство, включая Academic Research Assistant от Jenova, лучше подходит, когда карта должна пережить недели изменений протокола, не переписывая незаметно вчерашние решения.
В 2026 году принципиальный вопрос состоит не в том, «какая модель пишет более красивую аннотацию». Важно, какая архитектура памяти способна удерживать живую карту доказательств.
Ключевые факторы, отличающие полезную инфраструктуру картирования от одноразового чата по статьям:
✅ Операционная память против справочной памяти — картам нужно состояние проекта: критерии, коды и исключения, а не только извлечённые фрагменты ✅ Происхождение решений — каждое решение о включении или исключении должно оставаться проверяемым между сеансами ✅ Структурированное извлечение — сопоставимые поля лучше разовых повествовательных резюме ✅ Соблюдение протокола под контролем человека — специалисты по доказательной базе по-прежнему рассматривают AI как дополнение, а не замену рецензенту ✅ Синтез с возможностью версионирования — отчёты, рисунки и списки источников должны накапливаться, а не создаваться заново с нуля
Для справедливого сравнения этих инструментов полезно рассматривать картирование доказательств как задачу непрерывности на четырёх уровнях, а не как соревнование по качеству резюмирования.
Почему систематическое картирование доказательств создаёт нагрузку для AI-инструментов по отдельным статьям?
Систематическое картирование доказательств создаёт нагрузку для суммаризаторов отдельных статей, потому что карта — это закодированный перечень литературы, а не последовательность изолированных заметок по чтению. Systematic Evidence Maps (SEMs) — это форма синтеза доказательств, которая классифицирует и организует научные выводы по заранее определённым измерениям — популяции, воздействию, исходу, методу, географии или пробелу в доказательствах, — чтобы рецензенты могли видеть, что существует, где данные концентрируются и чего не хватает.
Этот рабочий процесс конфликтует с тем, как функционирует большинство исследовательских продуктов на базе LLM. RAG или инструмент «чат с этим PDF» отвечает на текущий запрос, извлекая локально похожие фрагменты. Он не загружает автоматически схему кодирования, использованную в прошлый вторник, три исследования, отложенные в категорию «возможно», или решение о том, что модели на животных исключены из области исследования после ужесточения протокола. Обзоры картирования также требуют документированного процесса скрининга на соответствие критериям включения и исключения, а это отличается от создания гладкого абзаца об одной статье (методология обзоров картирования).
Ручной обзор по-прежнему достаточно медленный, чтобы такой путь казался соблазнительным. Один обзор инструментов для работы с литературой за 2026 год оценил традиционный цикл обзора в четыре—шесть недель скрининга, извлечения данных и очистки цитирований. Специализированные AI-инструменты для скрининга могут уменьшить эту нагрузку: система AIM Review сообщила о снижении рабочей нагрузки от 20% до 95% в шести реальных обзорах. Но скорость сама по себе не создаёт карту. Без постоянного состояния проекта более быстрый скрининг лишь создаёт большую стопку разрозненных резюме.
Библиотечные и методологические организации прямо указывают на сохраняющийся разрыв. Руководство по синтезу доказательств King’s College London утверждает, что AI-инструменты не могут заменить традиционные методы поиска, скрининга и извлечения данных и должны использоваться только при ясном понимании рисков предвзятости, ограничений авторского права и галлюцинаций. Систематический обзор генеративного AI 2025 года пришёл к тому же практическому выводу: текущие доказательства не поддерживают использование GenAI без участия или контроля человека.
На что следует обращать внимание в AI-процессе картирования доказательств?
Оценивать AI-инструменты картирования следует с помощью теста на непрерывность, а не теста на качество текста. Мы используем четырёхуровневую структуру — назовём её стеком CODE, — потому что каждый уровень предсказуемо даёт сбой по-своему, когда команды пытаются превратить чат по статьям в систематическую карту.
C — Охват. Может ли инструмент искать в реальном научном корпусе или только среди уже загруженных вами файлов? Elicit ищет среди более чем 138 миллионов статей и 545 000 клинических испытаний. NotebookLM по своей конструкции отвечает на основе источников в блокноте. Ошибки охвата на этом уровне превращаются в отсутствующие строки карты, а не просто в поверхностные абзацы.
O — Операционализация. Можно ли один раз задать критерии включения, измерения кодирования и поля извлечения, а затем применять их повторно? Суммаризатор, который заново интерпретирует «релевантность» в каждом запросе, на третий день закодирует одно и то же пограничное испытание иначе. Руководства по картированию рассматривают заранее определённые критерии как обязательные (методы обзоров картирования).
D — Происхождение решений. Можно ли восстановить, почему исследование было включено, исключено, отложено или отфильтровано? Группы, работающие в соответствии с принципами Cochrane, включая инициативу Responsible AI in Evidence Synthesis (RAISE), созданную совместно с Cochrane, Campbell и JBI, считают прозрачность требованием качества, а не приятным дополнением.
E — Извлекаемость. Можно ли помещать результаты в сопоставимые ячейки — выборка, дизайн, направление эффекта, ограничение, — а не в несовместимые описательные тексты? Дизайн продукта Elicit построен вокруг интерактивных таблиц и многоэтапного извлечения данных. Consensus быстрее определяет направление доказательств на уровне гипотезы, но не предназначен для структурированного написания обзоров.
Взвешивайте эти уровни по цели работы. Предварительный обзор может терпеть более слабое происхождение решений. Живая карта доказательств, на которую будут ссылаться, которую будут обновлять или передавать соавтору, — не может. Инструменты, сильные в охвате и извлекаемости, всё равно не справляются с картами, если операционализация и происхождение решений сбрасываются в каждом сеансе.
Как сравниваются Elicit, Consensus, NotebookLM и исследовательские рабочие пространства?
Elicit и Consensus представляют наиболее сильный уровень поиска и извлечения данных по статьям в этой категории, NotebookLM — наиболее сильный блокнот для закрытого корпуса, а постоянное исследовательское рабочее пространство — наиболее сильную среду для сохранения целостности многонедельной карты. Ни один продукт не выигрывает по всем уровням CODE, поэтому серьёзные команды по картированию обычно сочетают инструмент работы с корпусом со средой проектной памяти, а не ожидают, что один чат-бот возьмёт на себя весь обзор.
По состоянию на 2026 год опубликованные снимки функций и цен выглядят так:
| Функция / измерение | Elicit | NotebookLM | Consensus | Исследовательское рабочее пространство Jenova |
|---|---|---|---|---|
| Модель памяти | Библиотека сохранённых источников и настройка для каждого отчёта; не полноценный контейнер состояния проекта | Набор источников в рамках блокнота; ответы остаются внутри загруженных материалов | Память вопросов и списков вокруг запросов о гипотезах | Постоянная память между сеансами; контекст проекта можно загружать повторно, а не извлекать заново |
| Охват | 138 млн+ статей, 545 тыс. испытаний | Только загруженный корпус; 50 источников бесплатно, 300 в Plus | 200 млн+ статей, метки направления доказательств | Поиск в интернете и научных источниках в реальном времени, а также подключаемые базы знаний; не фиксированный индекс издателя |
| Структурированное извлечение | Таблицы, скрининг, точки данных в масштабе (до 1 000 статей / 20 000 точек данных) | Вопросы и ответы с привязкой к источникам и планы, но не сетки извлечения для систематических обзоров | Consensus Meter и краткие ответы по доказательствам | Отчёты по синтезу и аналитические записки с цитатами через Deep Research; слабее в качестве специализированного двойного скрининга |
| Сохранение решений | Источники можно хранить в библиотеке; состояние протокола не является ключевой функцией | Сохраняет файлы блокнота, но не закодированную логику включения/исключения | Закладки и списки на платных тарифах | История разговоров, память и прикреплённые файлы проекта сохраняются между сеансами |
| Цена (на 2026 год) | Plus примерно от $12 в месяц | Бесплатно; Plus через Google AI Pro примерно за $19,99 в месяц | Premium примерно $10 в месяц | Бесплатный тариф с ограниченным использованием; Plus — $20 в месяц за объём использования в 30× |
| Лучше всего подходит для | Массового скрининга и таблиц извлечения | Учебных наборов и уже собранных PDF | Быстрых проверок «поддерживает ли литература X?» | Живых карт, многосеансового кодирования и интеграции в рукописи |
Elicit — честный специализированный инструмент для скрининга в систематическом стиле. Он может автоматизировать скрининг и извлечение данных и заявляет об экономии времени до 80% на этих этапах. Сравнение методов Cochrane всё же показало, что чувствительность поиска Elicit недостаточна для замены традиционного поиска литературы, поэтому лучше всего он работает как высокоточное дополнение. Он также обычно ограничивается отчётами и таблицами; написание текста, версионирование и работа с живой рукописью, как правило, переносятся в другое место.
NotebookLM — честный специализированный инструмент для обоснованного чтения фиксированного набора материалов. Каждый ответ можно сверить с процитированным фрагментом, а Google добавила Deep Research и более широкий набор типов файлов. Он не может находить статьи, которые вы ещё не собрали, и не ведёт журнал решений в стиле PRISMA.
Consensus — честный специализированный инструмент для определения направления гипотезы. Его индикатор и маркировка поддержки/противоречий работают быстрее, чем создание сетки извлечения, когда нужно лишь понять, в какую сторону склоняется литература (сравнение инструментов). Это неподходящая основная система для закодированной карты.
Academic Research Assistant от Jenova наиболее силён, когда единицей работы является проект, а не PDF. Он может искать научные источники, сохранять контекст рукописи и цитирований и — поскольку базовая платформа хранит неограниченную историю чатов и память между сеансами — продолжать схему кодирования без повторной вставки протокола. Это не валидированная платформа двойного скрининга в смысле Covidence или Rayyan, и она не публикует показатели точности извлечения, подобные Elicit. Командам, которым нужны аудит-трейлы регуляторного уровня, следует по-прежнему держать в стеке специализированный скрининговый инструмент.
SciSpace и Scite решают более узкие смежные задачи. SciSpace неоднократно описывают как лучшую среду для глубокого анализа отдельных статей: у него очень большой корпус, но менее единый рабочий процесс обзора. 1,6 миллиарда Smart Citations Scite, классифицированных как поддерживающие, противоречащие или упоминающие утверждение, не имеют равных для аудита контекста цитирований и почти бесполезны сами по себе в качестве базы поиска или картирования.
Как операционная память меняет многосеансовый синтез литературы?
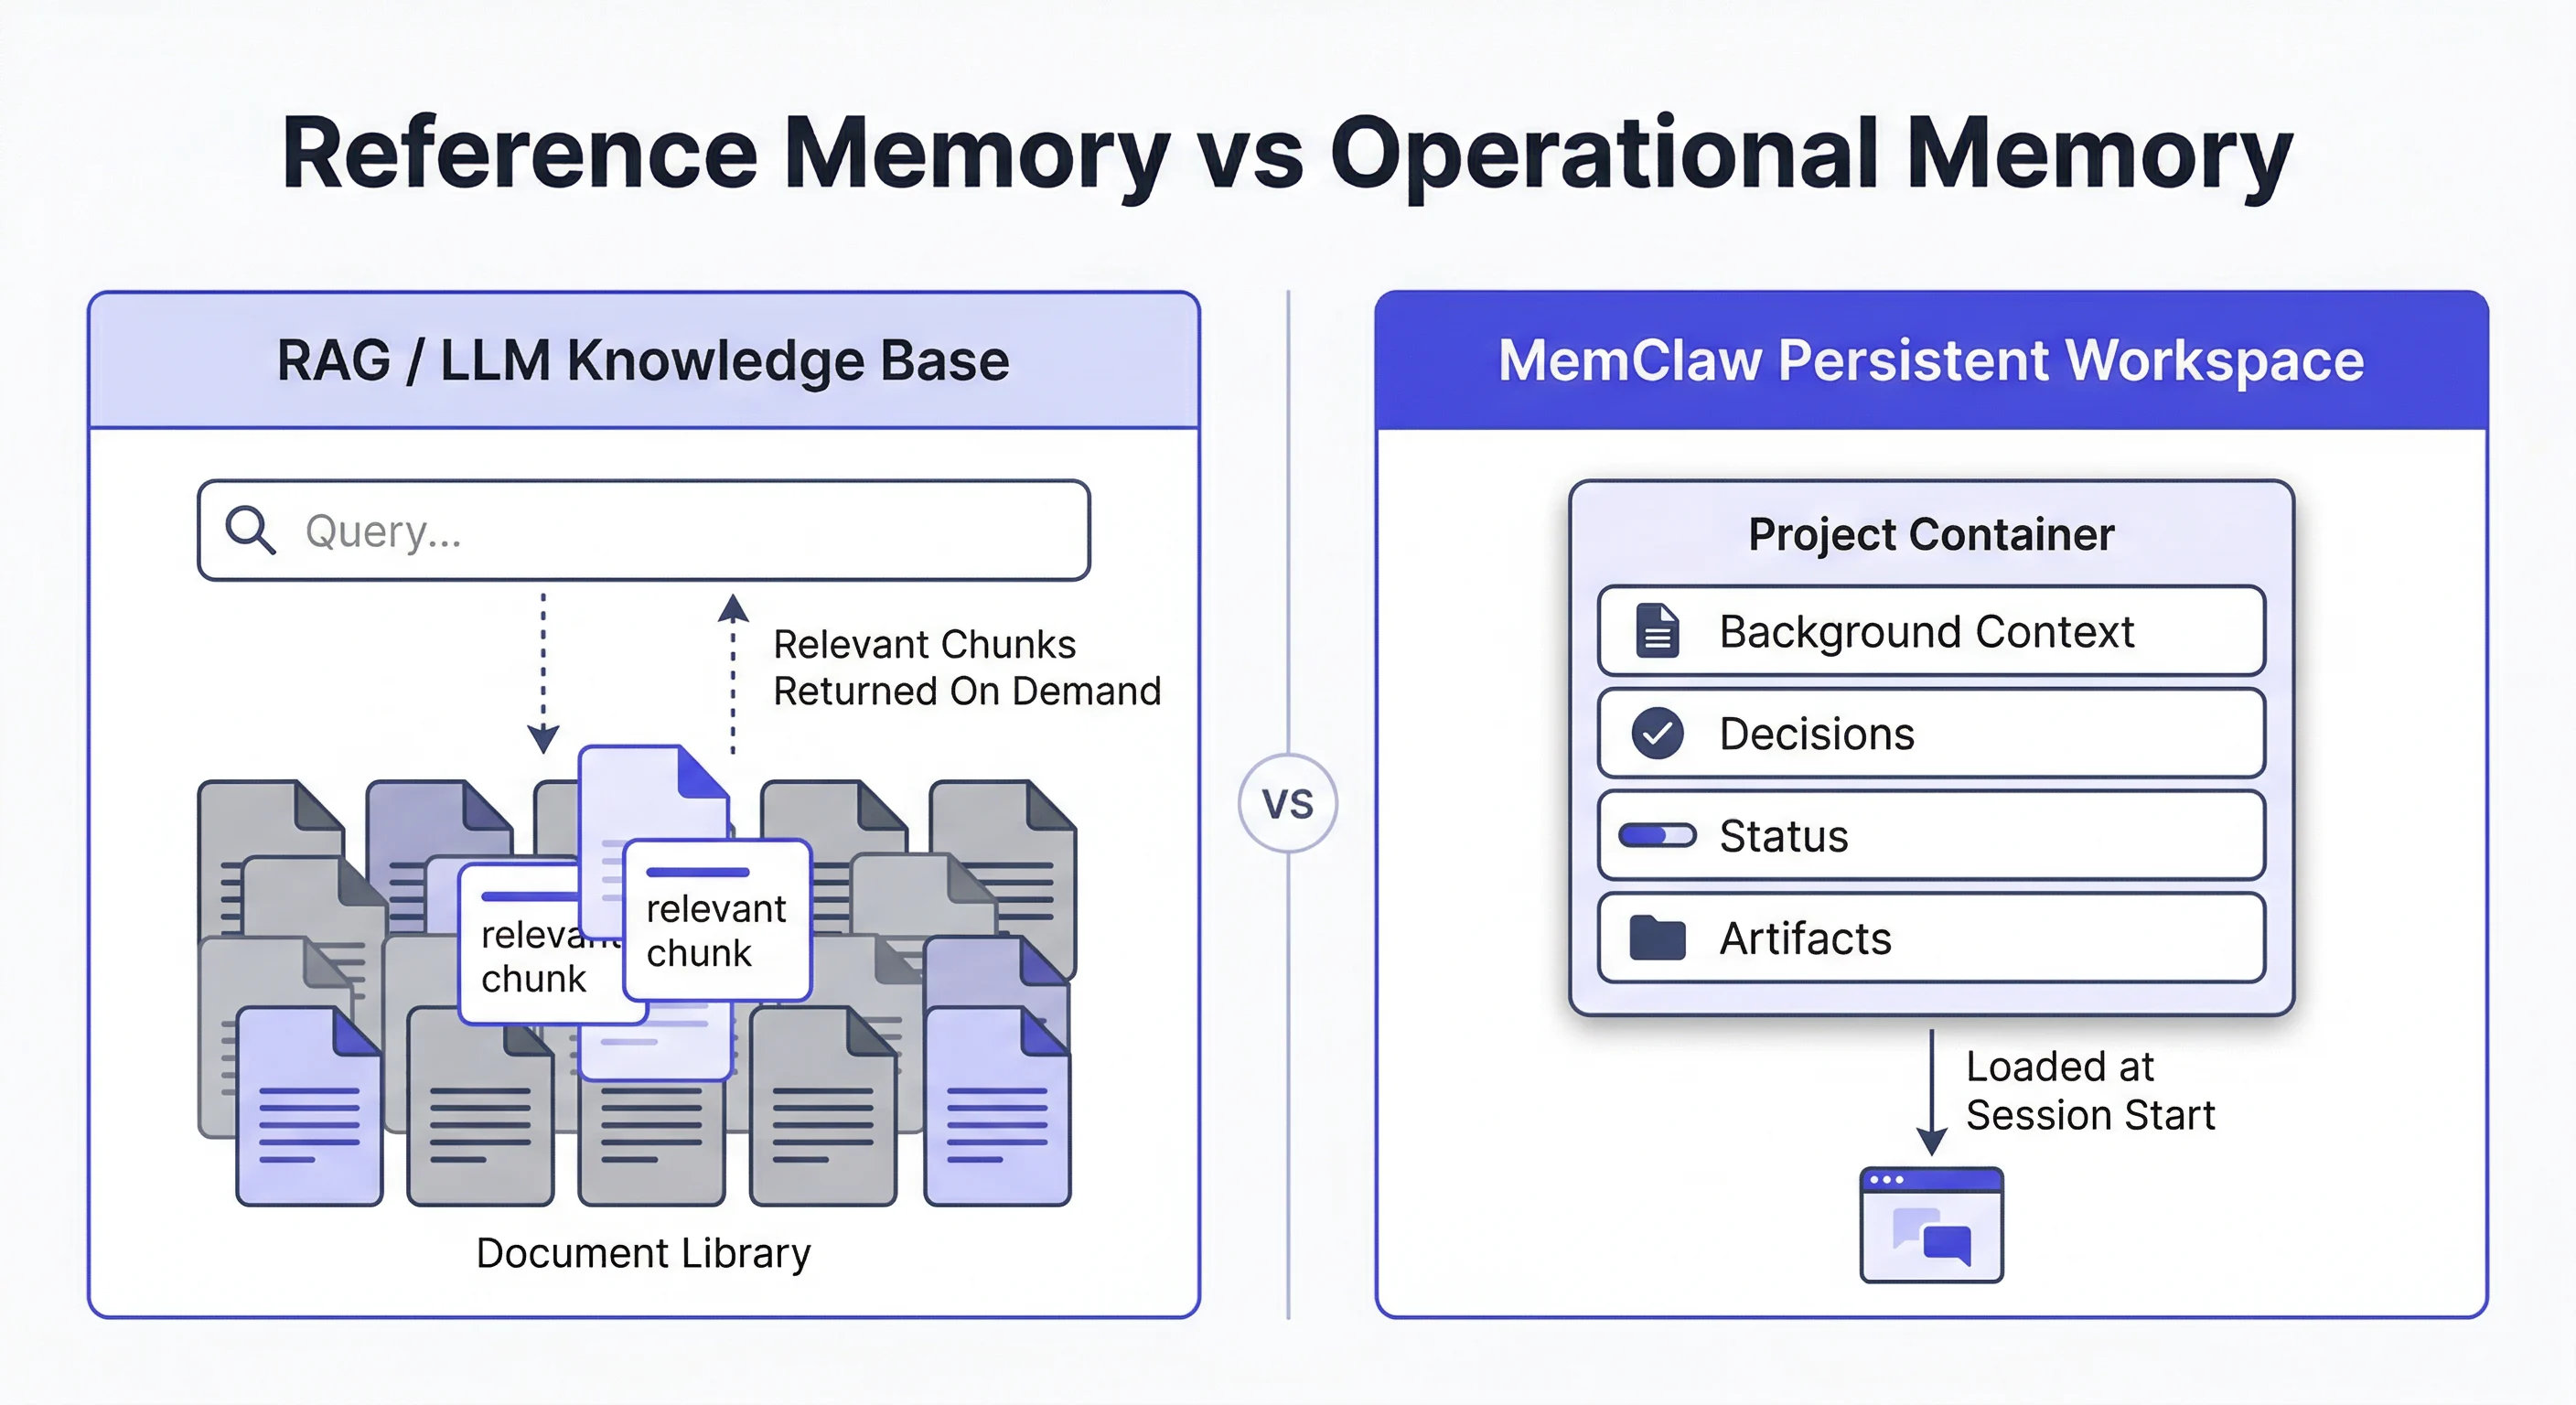
Операционная память меняет синтез, поскольку рассматривает контейнер проекта — фон, решения, статус и артефакты — как объект, загружаемый в начале сеанса, вместо того чтобы рассматривать литературу как стог сена, который нужно заново опрашивать. Справочная память спрашивает: «Какие фрагменты похожи на этот вопрос?» Операционная память спрашивает: «Что уже известно об этом проекте и для чего ещё нужны доказательства?»
Это различие проявляется в трёх режимах сбоя, которые суммаризаторы хорошо скрывают:
- Дрейф критериев. Если правило «только RCT на взрослых людях» существует в запросе, а не в состоянии проекта, последующий сеанс с немного более широким вопросом незаметно снова включит педиатрические исследования, которые вы уже отклонили.
- Осиротевшие “возможно”. Пограничные статьи, отложенные для обсуждения с соавтором, исчезают, если статус не является полем первого класса.
- Повторно сгенерированный синтез. Ответ RAG может быть локально верен сегодняшним извлечённым фрагментам и всё же противоречить прошлонедельной таблице пробелов, потому что ничто не обязывает новый ответ наследовать прежнее кодирование.
Постоянные рабочие пространства меняют порядок загрузки. Фоновый контекст, решения, статус и артефакты поступают до следующего запроса. Реализация этого паттерна на платформе Jenova — это память между сеансами плюс подключаемые базы знаний: ассистент может помнить измерения картирования, рабочее определение пробела в доказательствах и утверждения, для которых уже достаточно поддержки. Тестирование в сравнении с инструментами в стиле блокнота показывает ясный компромисс. Закрытый корпус NotebookLM безопаснее с точки зрения выдумывания информации вне источников (ответы с привязкой к источникам). Постоянное открытое рабочее пространство полезнее, когда корпус ещё растёт, а схема кодирования — дефицитный актив.
Практический вывод для SEM прост. Если ваш результат — односессионная аналитическая справка по 15 PDF, операционная память необязательна. Если ваш результат — карта пробелов, которую будут обновлять после следующего конференционного цикла, операционная память и есть продукт.
Как на практике выглядит сквозной агентный конвейер доказательств?
Сквозной конвейер картирования выглядит как поэтапный исследовательский спринт с контрольными точками, а не как один запрос «суммируй эти статьи». Иллюстрация ниже представляет полезную эталонную архитектуру: формирование вопроса, триаж литературы, выявление кандидатов, формализация гипотезы, валидация по нескольким источникам, версионируемая отчётность и пакет под контролем git.
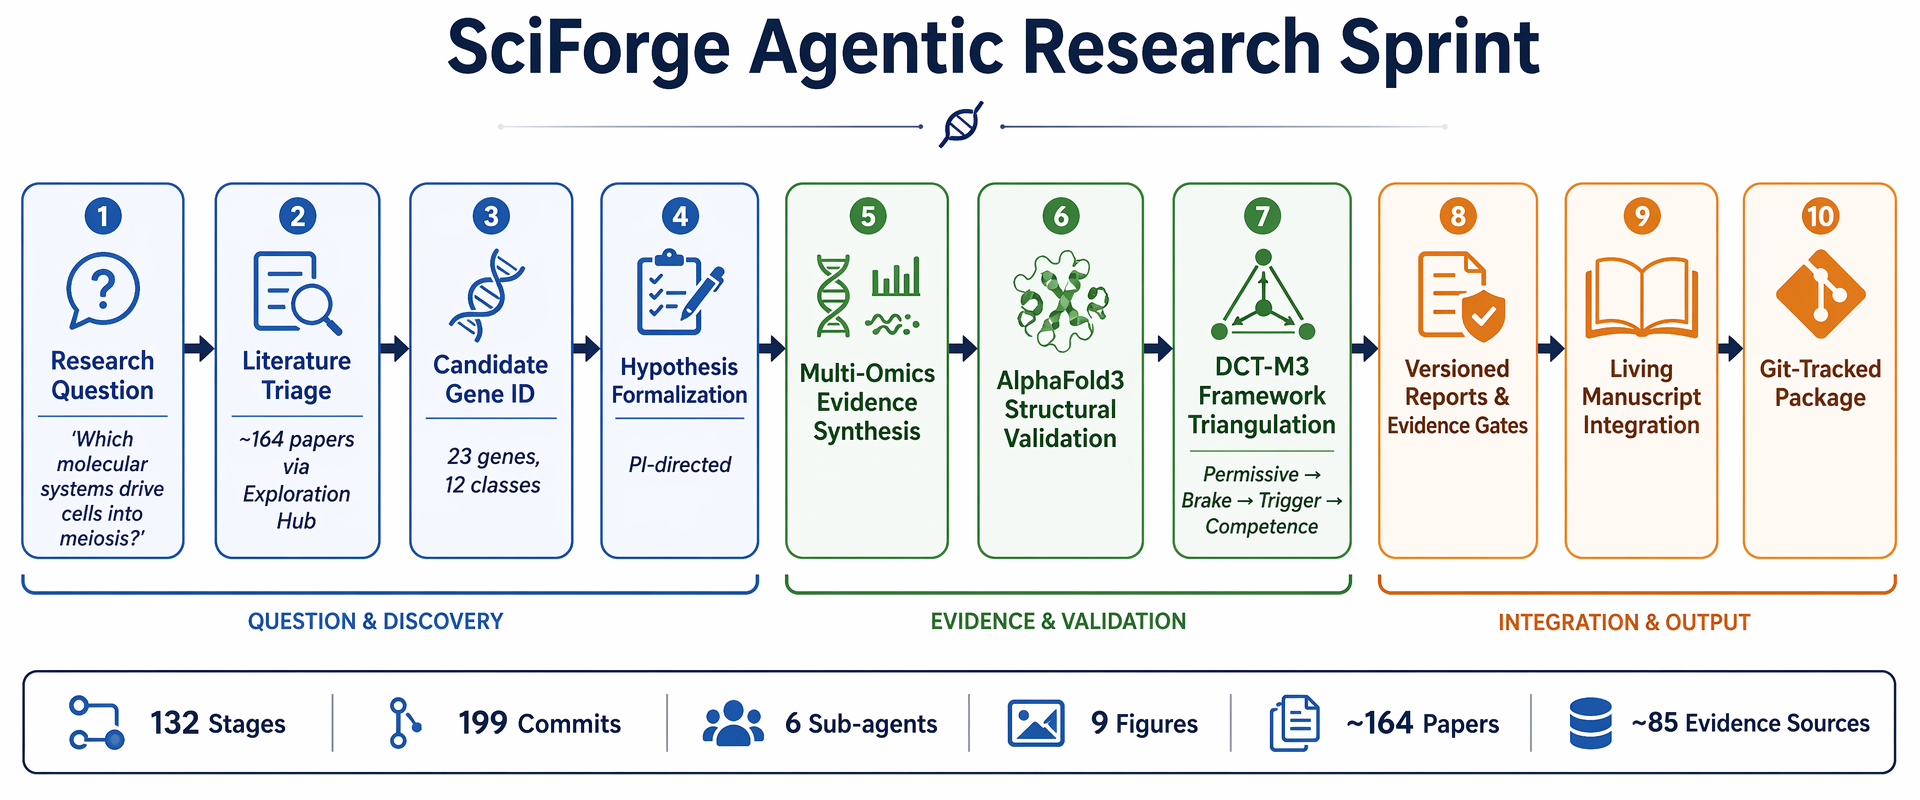
Пример спринта намеренно масштабный — порядка 164 статей, прошедших триаж, 132 этапов, 199 коммитов, шести субагентов и примерно 85 источников доказательств — поскольку именно на таком масштабе чат по статьям перестаёт работать. Суммаризатор способен описать статью 17. Он не может удерживать согласованность 10-этапной цепочки, когда на этапе 4 изменяется правило включения, которое уже было применено на этапе 2.
В этом конвейере важнее деталей предметной области три проектных решения:
- Поиск — это этап, а не продукт. Триаж литературы формирует идентификаторы кандидатов и формальную гипотезу. Остановка на резюме оставляет карту несобранной.
- Валидация мультимодальна. Синтез доказательств, структурные или количественные проверки и явная логика «разрешение → ограничитель → триггер» проводят утверждения через контрольные точки, а не усредняют их в абзац.
- Результат версионируется. Интеграция в живую рукопись и пакет под контролем git делают карту артефактом с историей. Это противоположность стенограмме чата, которую невозможно воспроизвести.
Jenova может приблизить этот паттерн, распределяя роли между агентами, а не заставляя один чат быть библиотекарем, кодировщиком и автором одновременно. Academic Research Assistant отвечает за поиск научных источников и контекст рукописи. Deep Research создаёт синтез с цитатами по множеству источников. Real-Time Search полезен, когда карта должна включать также препринты, репозитории или серую литературу вне журналов. Ограничение заключается в дисциплине оркестрации: человек по-прежнему отвечает за протокол, контрольные точки и решение о включении утверждения в живую рукопись. Методологические группы продолжают считать эту роль человека обязательной (руководство KCL / RAISE).
Универсальные платформы для обзоров в стиле Paperguide пытаются объединить планирование, поиск, скрининг, извлечение и генерацию в единый рабочий процесс одного поставщика, включая расширенные режимы, которые отсеивают 200 кандидатов и пишут текст на основе 50 лучших. Это ближе к рабочему пространству, чем Elicit плюс Word, но после экспорта сгенерированного обзора всё равно требуется внешний журнал решений, если для вас важна прослеживаемость происхождения.
Как получить максимум пользы от AI-карты доказательств?
Максимум пользы от AI-карты доказательств можно получить, если записать протокол в рабочее пространство до запроса на создание текста, а затем заставить каждый последующий сеанс наследовать этот протокол. Настройка похожа для разных инструментов; разница состоит в том, способен ли инструмент её запомнить.
Для карты, построенной вокруг Jenova, рабочая последовательность такова:
- Откройте Academic Research Assistant и в первом сообщении укажите название проекта, популяцию и измерения картирования.
- Закрепите протокол в формулировке, которую ассистент сможет повторно использовать:
«Создай систематическую карту доказательств исследований взрослых людей по теме X. Включай только RCT и проспективные когортные исследования. Кодируй каждое исследование по дизайну, выборке, вмешательству, первичному исходу, направлению эффекта и ограничениям. Отправляй исследования на животных и in-vitro в журнал исключений с однострочной причиной. Не пересоздавай коды, по которым решение уже принято.»
- Запустите Deep Research для первого прохода по корпусу, затем вставьте или прикрепите рабочую таблицу обратно в ту же ветку проекта, чтобы извлечение и повествовательный текст использовали общую память.
- После каждого сеанса запрашивайте три артефакта, а не одно эссе: обновлённую таблицу исследований, журнал исключений и список пробелов. Эти три файла и являются картой.
Для Elicit начните с исследовательского вопроса, создайте таблицу скрининга и рассматривайте библиотеку как источник истины (рабочий процесс систематического обзора Elicit). Не пропускайте обычный поиск в базах данных. Кейсы Cochrane показали, что Elicit полезен для высокоточного предварительного поиска и выявления уникальных дополнительных исследований, но не как единственная поисковая система.
Для NotebookLM сначала соберите PDF, работайте в рамках одного блокнота и задавайте вопросы по отдельным измерениям («Перечисли все исследования, сообщающие об исходе Y, с размером выборки и периодом наблюдения»), чтобы закрытый корпус не выходил за свои пределы. Лимиты загрузки — 50 источников на бесплатном тарифе и 300 в Plus — делают этот инструмент неподходящим для карты из 400 записей, если вы не провели предварительный скрининг в другом месте.
Два правила процесса применимы к любому стеку. Во-первых, не загружайте полнотекстовые PDF в потребительскую модель, если условия авторского права это запрещают: правообладатели в целом запрещают такое использование. Во-вторых, сохраняйте за человеком право принятия решений о включении и исключении. Скрининг с поддержкой AI — задача с наибольшим объёмом подтверждающих доказательств; неконтролируемый синтез — задача с наименьшим (обзор обзоров о готовности AI).
Что специалисты по синтезу доказательств говорят о картировании с поддержкой AI?
Специалисты всё чаще принимают AI для скрининга и извлечения данных под контролем человека, но по-прежнему отвергают AI как неконтролируемого картографа научной области. Полезный экспертный консенсус 2026 года уже, чем маркетинговые тексты поставщиков: автоматизируйте повторяющийся уровень, сохраняйте уровень решений и оставляйте за людьми ответственность за карту.
«Режим сбоя, который мы наблюдаем, состоит не в том, что модели не способны резюмировать статью. Проблема в том, что команды по картированию принимают хорошее резюме за закодированную запись. Систематическая карта доказательств — это набор обратимых решений: включено, исключено, отложено, отфильтровано, — привязанных к стабильным полям. Если эти решения существуют только в прошлогоднем запросе, карта уже испорчена, даже если каждый абзац по-прежнему звучит аккуратно.»
«Справочное извлечение и операционная память решают разные задачи. Извлечение помогает находить кандидатов в доказательства. Операционная память помогает не перекодировать одно и то же исследование трижды. Инструменты, отлично выполняющие первую задачу, регулярно развёртывают так, словно они выполняют вторую. Именно так появляется гладкий анализ пробелов, неспособный объяснить, почему исчезли 12 пограничных испытаний.»
«Наше рабочее правило простое. Используйте движок корпуса, чтобы заполнять строки. Используйте постоянное рабочее пространство, чтобы поддерживать жизнь кодбука, журнала исключений и таблицы пробелов. Используйте рецензента-человека на каждой контрольной точке, меняющей смысл карты. Любой продукт, продаваемый как систематическая карта в один клик, предлагает вам пропустить единственный уровень, который методологические группы всё ещё считают обязательным.»
— Команда продуктов Jenova, проектирование исследовательских процессов, 8 лет разработки систем знаний для многосеансовой аналитической работы
Эта позиция согласуется с формальными рекомендациями. NICE, рекомендации RAISE, связанные с Cochrane, и университетские библиотечные службы описывают AI как дополнение внутри существующих валидированных методов. Постоянно обновляемое руководство по использованию AI в поиске и скрининге литературы приводит те же аргументы в пользу эффективности — скрининг дорог, автоматизация помогает, — не утверждая, что генерация способна заменить протокол.
Когда суммаризаторы отдельных статей всё ещё являются правильным выбором?
Суммаризаторы отдельных статей остаются правильным выбором, когда корпус мал, уже собран и не кодируется в переиспользуемую карту. Если у вас есть 12 PDF, завтра заседание журнального клуба и нет необходимости обновлять перечень через три месяца, чат по статьям в стиле NotebookLM или SciSpace выполнит задачу с меньшей сложностью, чем проектный контейнер.
Они также лучше подходят для трёх других задач, которые ошибочно называют картированием:
- Объяснение механизма. «Разбери для меня рисунок 3» — это задача чтения. Блокнот с закрытым корпусом и кликабельными цитатами безопаснее открытого рабочего пространства, которое может смешивать статьи.
- Проверка контекста цитирований. Если вопрос заключается в том, поддерживают ли позднейшие работы утверждение или противоречат ему, классифицированные цитирования Scite являются специально созданным для этого уровнем (1,6 млрд+ Smart Citations).
- Точечная проверка гипотез. Consensus остаётся самым быстрым способом понять, имеет ли утверждение заметное разделение на поддержку и противоречия, прежде чем вкладываться в карту (обзор Elicit и Consensus).
Ошибка состоит в том, чтобы использовать эти сильные стороны вместо инфраструктуры SEM. Суммаризатор может быть превосходен локально и всё же оставаться неподходящей системой учёта. И наоборот, постоянное рабочее пространство может поддерживать жизнь неидеального кодбука и при этом быть неподходящим инструментом для двойного скрининга 5 000 записей, если требуется специализированное ПО для систематических обзоров. Институциональные руководства по-прежнему направляют команды к платформам скрининга, таким как Rayyan, Covidence и DistillerSR, для этого этапа (руководство CASRAI по AI для систематических обзоров; руководство Stony Brook по систематическим обзорам).
Таким образом, правило принятия решения, выдерживающее столкновение с реальными обзорами, основано на архитектуре, а не на бренде. Если результат работы — набор сопоставимых, обновляемых и объяснимых решений по кодированию, выбирайте исследовательское рабочее пространство с памятью проекта и держите рядом движок корпуса. Если результат работы — понимание уже лежащих перед вами статей, суммаризатор отдельных статей не является компромиссом. Это инструмент, правильно соответствующий масштабу задачи.
Источники
- ScienceDirect — Руководство по проведению систематических карт доказательств
- PubMed Central — Методология обзоров картирования, карт доказательств и карт пробелов
- Paperguide — 7 лучших AI-инструментов для обзора литературы в 2026 году
- King’s College London — AI-инструменты в синтезе доказательств
- Elicit — AI для научных исследований
- NotebookLM — AI-инструмент для исследований и интеллектуальный партнёр
- Блог Google — NotebookLM добавляет Deep Research, DOCX, Sheets и другое
- The Drive AI — Elicit, Consensus и Semantic Scholar: сравнение
- Omid Saffari — Лучшие AI-инструменты для исследований 2026: Elicit и Consensus
- Руководство по использованию AI в поиске и скрининге литературы
- CASRAI — AI-инструменты для систематических обзоров литературы
- Библиотеки Университета Stony Brook — Руководство по систематическим обзорам: искусственный интеллект