Лучше ли AI-ассистенты для исследований, чем поиск по ключевым словам, при поиске связанных статей?
2026-08-22
Когда семантическое сопоставление превосходит ранжирование по ключевым словам для концептуально связанных статей?
Семантические AI-ассистенты для исследований превосходят традиционный поиск по ключевым словам, когда нужные вам статьи описывают одну и ту же идею разной терминологией, тогда как ключевые поисковые системы остаются сильнее, если вы уже знаете точные фразы, авторов или кластер цитирований, на который хотите ориентироваться. В 2026 году практический ответ заключается не в отказе от Google Scholar, а в сочетании лексического ранжирования с поиском на основе смысла — с помощью таких инструментов, как Elicit, SciSpace, Undermind и Jenova's Academic Research Assistant.
Ключевые факторы, отличающие эффективное концептуальное обнаружение от сопоставления по ключевым словам:
✅ Гибкость терминологии — способен ли инструмент показать статью о «myocardial infarction», если в запросе использовалось «heart attack» ✅ Сигналы ранжирования — лексические оценки с учётом цитирований в сравнении с близостью эмбеддингов и оценкой релевантности посредством LLM ✅ Глубина индекса — метаданные заголовков и аннотаций в сравнении с полнотекстовым сопоставлением по сотням миллионов работ ✅ Инструменты точности — вложенные Boolean-операторы, ограничения по полям, фильтры качества журналов и лимиты экспорта ✅ Время до полезной подборки — мгновенные списки для первичного обзора в сравнении с итеративным поиском продолжительностью в несколько минут
Чтобы честно сравнить эти методы, полезно рассматривать несовпадение терминологии, смещение ранжирования и управляемость поиска как отдельные измерения, а не выяснять, какой инструмент лучше во всех случаях.
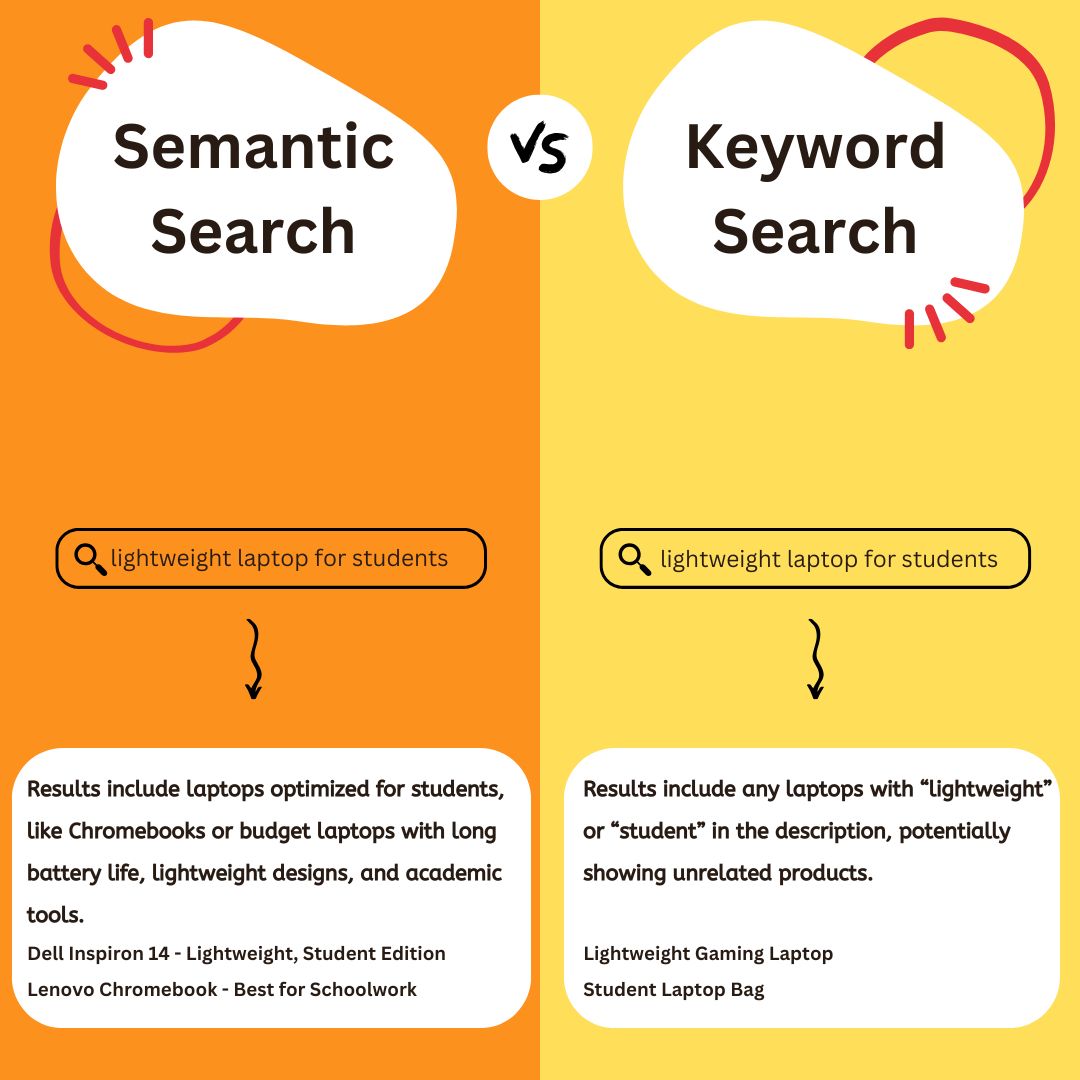
Почему несовпадение терминологии всё ещё нарушает традиционный академический поиск в 2026 году?
Несовпадение терминологии по-прежнему нарушает традиционный академический поиск, поскольку авторы, дисциплины и исторические периоды по-разному называют одно и то же явление, а лексические системы извлекают лишь документы, содержащие достаточно общих буквальных терминов с запросом. В статье по общественному здравоохранению может использоваться «physical activity», в кардиологической работе — «exercise capacity», а в социологическом исследовании — «leisure-time movement». Если искать только одну формулировку, два других кластера могут исчезнуть с первых нескольких страниц результатов.
Google Scholar остаётся стандартной точкой входа для большинства исследователей и всё ещё является самой широкой единой поверхностью академического поиска, включая полные тексты издателей и репозиториев. Аарон Тей, академический библиотекарь Сингапурского университета менеджмента, назвал его швейцарским армейским ножом научного поиска — инструментом, который он оставил бы себе, если бы мог выбрать только один. Однако его ранжирование по-прежнему лексическое. После совпадений в заголовках он сильно учитывает высокоцитируемые статьи, что превосходно для поиска основополагающих работ, но слабо для нахождения концептуально связанных статей, использующих иные формулировки или ещё не успевших накопить цитирования.
Проблема усугубляется, когда термин запроса распространён. Поскольку Google Scholar сопоставляет запросы по полному тексту, поиск инструмента или концепции с повседневным названием может выдать тысячи случайных совпадений. Тей отмечает, что поиск «Elicit» в Google Scholar почти бесполезен, если не добавить обходной приём с предметной областью, поскольку это слово постоянно встречается в разделах методов. Семантические системы снижают вероятность такого сбоя, оценивая смысл, а не совпадение строк, поэтому они стали дополнительным уровнем поиска, а не просто новинкой.
Что следует оценивать при сравнении поиска по ключевым словам и семантических AI-ассистентов?
Поиск по ключевым словам и семантических AI-ассистентов следует оценивать по шести измерениям, которые в этой статье названы фреймворком преодоления терминологических расхождений: гибкость терминологии, прозрачность ранжирования, покрытие индекса, контроль точности, сигналы авторитетности и время до полезной подборки. Инструмент, выигрывающий по одному измерению, часто уступает по другому, поэтому единый рейтинг «победителей» скорее вводит в заблуждение, чем помогает.
Гибкость терминологии отвечает на вопрос, способен ли поисковый механизм извлечь статью, в аннотации которой ваши термины запроса вообще не повторяются. Для этого предназначены плотные эмбеддинги и гибридные методы, такие как SPLADE, который Elicit использует как подход с обучаемыми разреженными эмбеддингами. Прозрачность ранжирования показывает, можете ли вы объяснить, почему появилась конкретная статья. Системы на базе Boolean-операторов и BM25 легче проверять; поиск ближайших соседей по эмбеддингам и LLM-переранжировщики сложнее воспроизводить.
Покрытие индекса — это не то же самое, что «заявленное число статей». OpenAlex сообщает о 517 миллионах записей работ и 66 миллионах полнотекстовых PDF, тогда как Elicit заявляет, что ищет, суммирует и извлекает данные более чем из 125 миллионов статей. Google Scholar не публикует сопоставимого официального числа, однако его широко считают крупнейшим полнотекстовым академическим поисковым индексом. Контроль точности охватывает вложенные Boolean-операторы, ограничения по полям, операторы близости и контролируемый словарь — возможности, в которых The Lens и OpenAlex превосходят Google Scholar.
Сигналы авторитетности включают количество цитирований, уровень журнала и отметки об отзыве публикации. Google Scholar и, в меньшей степени, Undermind склоняются к высокоцитируемым работам. Elicit и SciSpace обычно ранжируют по семантической близости и не учитывают вес цитирований, поэтому новые или менее цитируемые статьи поднимаются выше. Время до полезной подборки отделяет мгновенный поиск по ключевым словам от итеративных запусков в стиле Undermind, которые занимают не менее трёх минут. Оценивайте каждое измерение применительно к вашей фактической задаче — обнаружению, насыщенному синонимами, систематическому охвату или пятиминутной ориентации, — прежде чем выбирать основной поисковый механизм.
Как Google Scholar, Elicit, SciSpace, Undermind и Jenova сравниваются в концептуальном обнаружении?
Google Scholar наиболее силён для широкого исследования с учётом веса цитирований; Elicit и SciSpace — когда ключевые слова неясны; Undermind — для узких высокоточных поисков; а Jenova's Academic Research Assistant — когда обнаружение, синтез и работа с цитатами должны оставаться в одном непрерывном диалоге. Ни один из этих инструментов не доминирует во всех ячейках фреймворка преодоления терминологических расхождений.
| Возможность / измерение | Google Scholar | Elicit / SciSpace | Undermind | Jenova's Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| Метод сопоставления | Лексический / по ключевым словам, с учётом цитирований | Семантический или гибридный (Elicit использует SPLADE) | Гибридное извлечение плюс оценка релевантности LLM и итеративный поиск | Исследовательский агент на естественном языке, работающий с актуальными научными источниками, включая Google Scholar | Поиск по структурированным научным метаданным с расширенными операторами |
| Восстановление результатов при иной формулировке | Слабое, если не добавить синонимы или не использовать Related articles | Сильное для запросов, основанных на смысле | Сильное для конкретных запросов на естественном языке | Сильное благодаря разговорному переформулированию между сессиями | От слабого до умеренного; зависит от построения запроса |
| Смещение в сторону авторитетных работ | Отдаёт предпочтение высокоцитируемым статьям после совпадений в заголовках | Незначительное взвешивание цитирований; новые статьи поднимаются выше | Некоторое смещение в сторону основополагающих работ через поиск по цитированиям | Следует за подключёнными источниками и предоставленным вами брифом | Основано на метаданных; предназначено скорее для анализа, чем для семантического ранжирования |
| Возможности точного поиска | Нет вложенных Boolean-операторов, лимит 256 символов, ограниченный поиск по полям | Постфильтры качества журналов (например, уровни Scimago в SciSpace) | Спецификация на естественном языке вместо Boolean-операторов | Диалоговое сужение; не является поисковой системой с Boolean-синтаксисом | Вложенные Boolean-операторы, близость, поиск по полям, контролируемый словарь |
| Типичное время запроса | Мгновенно | Достаточно быстро для первичного обзора | Не менее ~3 минут на поиск | Интерактивно; последующие сообщения обрабатываются мгновенно | От мгновенного до зависящего от темпа API |
| Стоимость (по состоянию на 2026 год) | Бесплатно | Elicit Pro около $49/месяц; платные уровни SciSpace, по сообщениям, от $12 до $160/месяц | Бесплатный ознакомительный уровень; платные академические планы | Бесплатный уровень с ограниченным использованием; Plus от $20/месяц | Бесплатный веб-поиск; OpenAlex API имеет бесплатный уровень |
| Лучше всего подходит для | Основополагающих статей, переходов по Cited by, поиска полного текста | Неясных ключевых слов и запросов в форме вопросов | Поиска конкретного класса исследований с высоким охватом | Сквозной работы с литературой, памятью и поддержкой рукописи | Систематического, воспроизводимого и высококонтролируемого поиска |
Google Scholar
Google Scholar по-прежнему остаётся универсальным инструментом. Официальные справочные страницы подтверждают, что результаты обычно сортируются по релевантности, а не по дате, а исследователи могут переходить по Related articles и Cited by, когда у них уже есть исходная статья. Эти две возможности ближе всего подводят поиск по ключевым словам к концептуальному обнаружению, однако для них требуется хорошая исходная работа. Недостатки хорошо документированы: нет вложенных Boolean-операторов, нет поиска только по аннотациям, действует ограничение в 256 символов для запроса, потолок в 1 000 результатов и отсутствует массовый экспорт. Именно поэтому библиотекари регулярно исключают его из числа основных баз данных для систематических обзоров.
Elicit и SciSpace
Elicit позиционирует себя как AI для поиска, суммирования, извлечения данных из более чем 125 миллионов статей и общения с ними, которым пользуются свыше 2 миллионов исследователей. И Elicit, и SciSpace принимают вопросы на естественном языке и ранжируют результаты по семантической близости, поэтому они находят статьи, чья формулировка отличается от запроса. Компромисс состоит в смещении ранжирования в сторону, противоположную Google Scholar: они могут продвигать семантически близкие, но низкокачественные или малоцитируемые статьи. SciSpace в целом быстрее и лучше подходит для быстрого получения представления, чем для глубокого итеративного синтеза. Результаты также могут быть недетерминированными, поэтому один и тот же запрос не всегда возвращает один и тот же набор.
Undermind
Undermind — это специализированный инструмент. Он сочетает поиск по ключевым словам и семантическое извлечение, затем использует передовую модель, чтобы определить, действительно ли заголовок, аннотация и доступные метаданные отвечают брифу, и выполняет итерации с поиском по цитированиям. В одном тесте относительно набора включённых работ систематического обзора он нашёл 8 из 11 эталонных статей в первых 10 результатах (recall@10 72,7%) и 9 из 11 к позиции 50 (recall@50 81,8%). За это качество приходится платить временем, и такой подход плохо работает с расплывчатыми темами. Кроме того, он в основном видит заголовок и аннотацию, а также часть полнотекстовых материалов открытого доступа, поэтому утверждения, скрытые только в методах или результатах, могут быть упущены.
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant — это учитывающий дисциплину исследовательский партнёр, а не самостоятельный индекс статей. Он выполняет актуальный поиск литературы по научным источникам, а затем сопровождает проект на этапах синтеза, подготовки рукописи и управления цитированием. Постоянная память позволяет ему помнить, что ваш рабочий термин — «cognitive fatigue», тогда как в литературе также используются «ego depletion» и «need for recovery», и сохранять эти кластеры синонимов в рамках одного проекта между сессиями.
Честное ограничение заключается в архитектуре. Он не поставляется с собственным семантическим индексом на 125 миллионов статей и встроенными таблицами извлечения в смысле Elicit, а также не является многоминутным итеративным поисковиком в стиле Undermind с опубликованным эталоном recall@10. Его сильная сторона — оркестрация: бриф на естественном языке, актуальный поиск научных источников, уточняющие вопросы и поддержка написания текста в одной ветке. Исследователям, которым нужен воспроизводимый журнал Boolean-поиска, всё равно следует параллельно использовать The Lens или OpenAlex.
Как семантический поиск находит статьи, использующие другую формулировку одной и той же идеи?
Семантический поиск находит по-разному сформулированные статьи, кодируя запрос и коллекцию документов в общее пространство смыслов, а затем извлекая ближайших соседей вместо требования пересечения токенов. Если запрос звучит как «как медсёстры ночной смены восстанавливают внимание после нескольких последовательных смен», лексическая система ищет эти слова. Семантический механизм способен извлечь исследования с заголовками о «circadian disruption», «recovery sleep» или «occupational fatigue», даже если слова «nurses» или «attention» вообще не встречаются в заголовке.
Semantic Scholar, поисковый механизм литературы Allen Institute for AI, стал ранней публичной демонстрацией этой идеи: ранжировать научные статьи по понятому смыслу, а не по совпадению строк. Elicit и SciSpace применяют аналогичный принцип в масштабе веб-приложений. Тей описывает особенно чистый тест: вставьте газетный абзац, описывающий выводы исследования, и семантический механизм может показать лежащую в его основе журнальную статью, поскольку эмбеддинг новостной прозы находится близко к эмбеддингу статьи. Поиск по ключевым словам почти никогда не переживает такое перефразирование.
Есть и второй, менее заметный механизм: расширение запроса внутри ассистента. Разговорный агент может создавать наборы синонимов, связанные концепции в стиле MeSH, антонимы и дисциплинарные варианты, а затем явно искать эти варианты. Это не чистый векторный поиск. Это семантическое понимание, используемое для построения более качественной лексической сети. На практике рабочие процессы с наибольшим охватом используют оба подхода: эмбеддинги для нахождения неизвестных формулировок, а затем проверку точными фразами, именами авторов и ссылками на цитирования, чтобы набор оставался проверяемым.
Проверка на актуальном брифе обычно быстро выявляет разрыв. Запросите у поисковой системы по ключевым словам «teacher noticing», и вы главным образом получите статьи, использующие именно этот термин из исследований образования. Запросите у семантического ассистента «как учителя в моменте обнаруживают и интерпретируют неожиданное мышление учеников», и вы также найдёте работы, отнесённые к «professional vision», «formative assessment» или «in-the-moment decision making». Второй набор — это именно то, что скрыла бы терминологическая несогласованность.
Когда всё же следует использовать поиск по ключевым словам вместо семантического AI-ассистента?
Поиск по ключевым словам следует по-прежнему использовать, когда требуется найти известный документ, пройти по цепочке цитирований от исходной статьи, искать фразу в полном тексте или реализовать воспроизводимую Boolean-стратегию для систематического обзора. Семантическое ранжирование — неподходящий инструмент для задач «найти эту статью по названию», «найти всё, что цитирует это испытание» или «задокументировать поисковую строку, которую сможет повторно запустить рецензент».
Google Scholar — правильный первый шаг для трёх повседневных задач. Во-первых, поиск известного документа: заключите название в кавычки, как рекомендуют собственная справка Google и большинство библиотечных руководств. Во-вторых, картирование авторитетности: откройте знаковую статью и пройдите по Cited by, чтобы увидеть дальнейшее развитие области, или по Related articles, чтобы развернуть поиск от исходной работы. В-третьих, поиск фраз в полном тексте: если концепция представляет собой отличительное название метода, набор данных или шкалу, лексический полнотекстовый поиск найдёт упоминания, которые семантические индексы заголовков и аннотаций пропускают.
Для систематического или очень точного поиска не используйте ни Google Scholar, ни большинство семантических приложений как основную систему учёта. The Lens и OpenAlex поддерживают вложенные Boolean-операторы, операторы близости, поиск по полям и контролируемый словарь. OpenAlex — это открытый каталог с 517 миллионами работ, 5,8 миллиардами связей в графе и набором данных в общественном достоянии (CC0). В библиотечном обзоре 2026 года его покрытие оценивалось примерно в 474 миллиона публикаций с акцентом на открытый доступ и прозрачность. Google Scholar не может сравниться с такой проверяемостью: он ограничивает отображение 1 000 результатами и не предоставляет массового доступа.
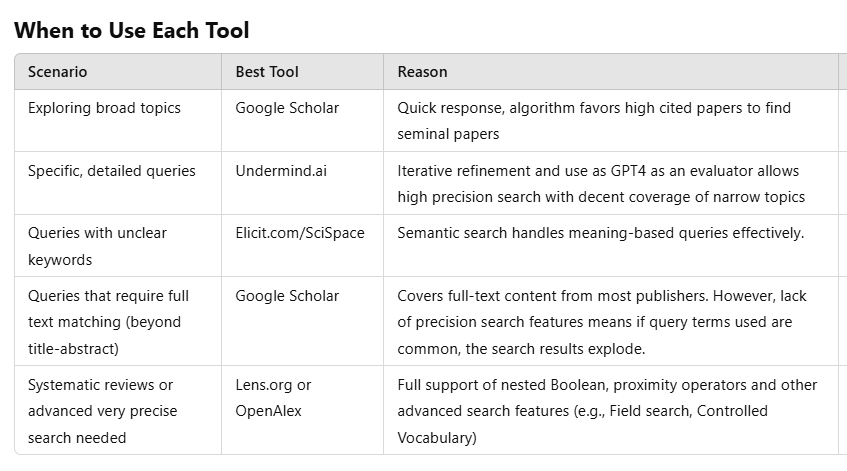
Используйте приведённую выше таблицу как правило маршрутизации, а не как проверку лояльности. Широкая ориентация и поиск основополагающих статей остаются за Google Scholar. Неясные формулировки отправляются в Elicit или SciSpace. Узкий вопрос о существовании — «есть ли RCT, в которых LLM используется как средство скрининга заголовков и аннотаций и сообщаются precision и recall?» — является брифом для Undermind. Воспроизводимые поиски с интенсивным использованием операторов следует выполнять в The Lens или OpenAlex.
Как провести поиск литературы, сочетающий оба подхода?
Комбинированный поиск начинается с концептуального брифа, затем семантически извлекает кандидатов с разнообразной терминологией, после чего фиксирует набор лексическими операторами, переходами по цитированиям и базой данных с высоким уровнем контроля. Последовательность имеет значение. Если начать в Google Scholar с одной фразы, вы унаследуете слепые зоны этой фразы. Если никогда не покидать семантически ранжированный список, вы унаследуете проблемы качества и воспроизводимости этого списка.
Практическая последовательность выглядит так:
- Сформулируйте информационную потребность так, как её услышал бы коллега, включая популяции, результаты и формулировки, нестабильность которых вам уже известна.
- Выполните этот бриф в семантическом ассистенте, чтобы собрать статьи-кандидаты и терминологию, которую они фактически используют.
- Постройте таблицу синонимов по этим заголовкам и аннотациям.
- Повторите расширенные термины в Google Scholar, используя кавычки,
author:, ограничения по датам, а также Cited by / Related articles. - Для всего, что должно быть исчерпывающим или проверяемым, заново постройте стратегию в The Lens или OpenAlex с вложенными Boolean-операторами и ограничениями по полям.
- Ведите журнал включения, чтобы недетерминированные повторные запуски семантического поиска незаметно не меняли доказательную базу.
В Jenova's Academic Research Assistant первым сообщением может быть концептуальный бриф, а не строка ключевых слов:
«Мне нужны эмпирические статьи о том, как удалённые работники умственного труда восстанавливаются после cognitive fatigue. Включите исследования, в которых вместо слова fatigue могут использоваться burnout, ego depletion, need for recovery, after-hours rumination или psychological detachment. Отдавайте предпочтение площадкам по организационной психологии и HCI начиная с 2018 года и указывайте синоним, который фактически использует каждая статья».
Следующий запрос затем преобразует таблицу синонимов ассистента в лексическую стратегию, которую можно вставить в Google Scholar или The Lens:
«Преобразуй кластеры синонимов в три запроса для Google Scholar и одну вложенную Boolean-строку, подходящую для OpenAlex или The Lens. Отдели запросы с ограничением по названию от полнотекстовых запросов».
В Elicit или SciSpace задавайте вопрос на естественном языке, а не ключевыми словами — Тей отмечает, что запросы на естественном языке обычно хуже работают в Google Scholar и лучше в этих семантических инструментах. В Undermind добавляйте ограничения, пока бриф не сможет соответствовать только конкретному дизайну исследования. После появления набора кандидатов агент Deep Research от Jenova лучше подходит для чтения по нескольким источникам и создания синтеза с цитатами, тогда как Jenova's Academic Research Assistant лучше сохраняет фокус внутри научного рабочего процесса обнаружения, цитирования и поддержки рукописи.
Одна предосторожность относится к каждому этапу с AI. Считайте ранжированные списки и сгенерированные резюме средствами извлечения, а не завершённым скринингом. Семантические первые десятки пропускают статьи. Оценки релевантности LLM часто, но не всегда совпадают с человеческими. Утверждения из полного текста по-прежнему необходимо проверять по PDF.
Что говорят исследовательские библиотекари и оценщики инструментов о семантическом AI-обнаружении?
Исследовательские библиотекари и независимые оценщики обычно рассматривают семантических AI-ассистентов как дополнение к Google Scholar, а не замену ему, и оценивают инструменты по качеству поиска для заявленного сценария использования, а не по маркетинговым категориям. Наиболее полезное опубликованное сравнение в этой области происходит из практико-ориентированных обзоров, а не из бенчмарков поставщиков.
«Если бы я заранее не знал, какой будет мой сценарий использования, и мог выбрать только один инструмент академического поиска, выбор Google Scholar был бы очевиден. Это не аргумент против AI-поиска. Это аргумент против притворства, будто одной функции ранжирования достаточно. Scholar по-прежнему универсален. Новые инструменты заслуживают своего места, когда запрос семантически неудобен или крайне специфичен.»
«Наиболее часто я наблюдаю несоответствие между типом запроса и поисковым механизмом. Люди вводят широкую тему в итеративный агент и ждут несколько минут набора, который оказывается уже необходимого. Или вводят абзац на естественном языке в лексический поисковик и делают вывод, что литературы не существует. Несовпадение терминологии обычно является ошибкой рабочего процесса ещё до того, как становится пробелом базы данных.»
«Семантическое ранжирование также меняет смысл слова „релевантный“. Если не учитывать вес цитирований, раньше появятся более новые и иногда более слабые статьи. Если учитывать вес цитирований, вы будете снова и снова находить один и тот же канон. Исследователям, которым нужны концептуально связанные работы с другой формулировкой, требуется первое поведение. Исследователям, которым нужны статьи, которые от них ожидают увидеть в списке литературы, требуется второе. Компетентный процесс использует оба подхода и фиксирует причины.»
— Команда Jenova по продукту, системы обнаружения литературы, 8 лет проектирования академических исследовательских процессов
Эта рамка соответствует публичным данным. Университетские руководства теперь перечисляют AI-инструменты поиска, используемые в литературных обзорах, а обзоры продуктов отличают более медленный итеративный проход Undermind от более быстрого семантического сканирования SciSpace. Экспертный консенсус носит методологический, а не племенной характер: выбирайте модель извлечения, соответствующую тому типу несовпадения, который вы пытаетесь преодолеть.
Какой инструмент подходит для систематических обзоров, а какой — для исследовательского картирования литературы?
Систематическим обзорам нужна лексическая инфраструктура с высоким уровнем контроля; исследовательскому картированию литературы нужны семантический охват и быстрые итерации; для большинства диссертаций и грантовых заявок необходим гибридный подход с письменным протоколом для каждого этапа. Смешение этих задач приводит к тому, что команды либо пропускают концептуально связанные исследования, либо создают невоспроизводимый набор доказательств.
Для исследовательского картирования — «что было написано об этой идее, под каким бы названием она ни фигурировала?» — начинайте семантически. Elicit, SciSpace и разговорный исследовательский ассистент созданы для такого вопроса. Google Scholar может внести вклад, когда у вас уже есть исходные статьи, через Related articles и Cited by, и он остаётся непревзойдённым для быстрого нахождения PDF и библиотечных ссылок. Jenova's Academic Research Assistant подходит для этого этапа, когда нужно, чтобы карта сохранялась: принятые решения о синонимах, исключённые направления и форматирование цитат для будущего текста.
Для систематических или обзорных исследований не позволяйте семантически ранжированному списку стать официальным поиском. Используйте The Lens или OpenAlex как воспроизводимую основу, документируйте каждый оператор и рассматривайте Elicit, Undermind или Jenova как вспомогательные средства для обнаружения цитат и скрининга. OpenAlex дополнительно предоставляет API, язык запросов, ориентированный на систематические обзоры, и полный снимок данных по лицензии CC0, что является противоположностью закрытой сортировки по релевантности. Лимит Google Scholar в 1 000 результатов и отсутствие массового доступа исключают его из роли основного документируемого поиска, хотя он остаётся полезен для проверки того, была ли вообще проиндексирована известная включённая работа.
Для узких вопросов о существовании — «существует ли такая статья?» — Undermind является специализированным инструментом, если вы готовы ждать и если достаточно свидетельств из заголовка и аннотации. Для подготовки рукописи после формирования набора сочетание Jenova поиска литературы и управления цитированием более уместно, чем ещё один интерфейс только для обнаружения, с оговоркой, что метаанализ с интенсивным извлечением данных всё же следует выполнять в специализированном инструменте извлечения, таком как Elicit.
Правило выбора достаточно простое для повторного использования. Если формулировки различаются и вы ещё не знаете жаргон области, сначала используйте семантический AI-ассистент для исследований. Если вам необходимо защитить поисковую строку, используйте инфраструктуру ключевых слов с расширенными операторами. Если необходимо и то и другое — а это обычная ситуация при поиске концептуально связанных статей с разной формулировкой, — используйте семантический охват, чтобы обнаружить язык области, а затем лексический контроль, чтобы охватить и задокументировать его.
Источники
- Аарон Тей — Google Scholar в сравнении с другими AI-инструментами поиска (Undermind, Elicit, SciSpace)
- Google Scholar — официальная справка по поиску
- Elicit — AI для научных исследований
- OpenAlex — открытый каталог глобальной исследовательской системы
- Paperguide — сравнение цен и возможностей Elicit и SciSpace (2026)
- Undermind — AI-соисследователь для работы с литературой
- Университет Альберты / JCHLA — обзор продукта Undermind.ai
- Paperpile — как использовать Google Scholar
- TUHH — OpenAlex как открытая альтернатива для академических исследований
- Semantic Scholar — исследовательский инструмент на базе AI
- UBC Wiki — AI-инструменты поиска, используемые в литературных обзорах и комплексном поиске
- SciSpace — сравнение Elicit и SciSpace
- The Lens — выпуск 8.5 и интеграция OpenAlex
- PMC / NIH — возможности OpenAlex и потенциал синтеза доказательств