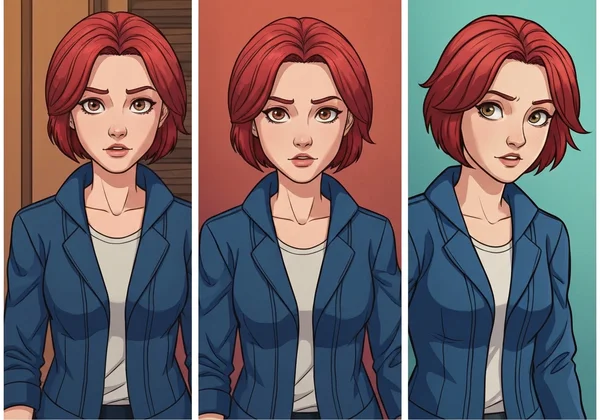
Por que o mesmo personagem de AI muda de rosto, roupa ou penteado entre os quadros?
2026-08-13
O Que Realmente Causa a Deriva de Identidade Entre Quadros — a Redação do Prompt ou a Arquitetura do Modelo?
A deriva de personagens em quadrinhos de AI é uma limitação arquitetural, não um erro de prompting — modelos de texto para imagem geram cada quadro como um evento de amostragem independente, sem memória de resultados anteriores. Portanto, uma descrição como “detetive ruivo de sobretudo marrom” se resolve em uma pessoa estatisticamente plausível a cada vez, e não na mesma pessoa. As correções mais confiáveis conduzem a identidade por imagens de referência e sistemas de ativos, em vez de texto: ferramentas como ComicInk, LTX Studio, Figma Weave e o Comic Creator da Jenova convergem para esse princípio por caminhos diferentes.
O que separa fluxos de trabalho resistentes à deriva daqueles propensos a ela:
✅ Geração ancorada em referência — a identidade é transportada por um ativo de imagem, não redescrita em prosa a cada quadro
✅ Desacoplamento de atributos — rosto, cabelo, vestuário e fundo são fixados de forma independente para que uma mudança de cena não reorganize o personagem
✅ Separação entre primeiro plano e fundo — pesquisas mostram que detalhes do fundo variam mesmo quando o rosto se mantém estável (CharaConsist, ICCV 2025)
✅ Disciplina de vocabulário — “sobretudo marrom” deve permanecer “sobretudo marrom”, nunca apenas “casaco” ou “jaqueta”
✅ Tolerância a movimento — métodos de consistência se degradam acentuadamente quando um personagem muda de pose ou ação
Para avaliar qualquer ferramenta ou fluxo de trabalho com honestidade, é útil entender primeiro os quatro mecanismos distintos de falha escondidos por trás do único sintoma de “meu personagem está diferente”.
Quais São as Quatro Causas Técnicas da Deriva de Personagens?
A deriva tem quatro causas separáveis, e cada uma exige uma solução diferente. Tratá-las como um único problema é o motivo pelo qual a maioria dos criadores fica alternando ajustes de prompt que nunca funcionam por completo.
1. Ausência de mecanismo de memória. Cada geração é um evento independente. A análise de engenharia do LTX Studio afirma isso diretamente: o modelo “não consegue ‘lembrar’ características de personagens geradas anteriormente”, então cada renderização recomeça a partir da descrição textual. Um prompt é uma distribuição de probabilidade, não uma especificação — “olhos verdes, entre 30 e 35 anos” descreve milhões de rostos válidos.
2. Entrelaçamento entre estilo e identidade. Os modelos têm dificuldade para separar quem é o personagem de como a imagem aparenta ser. Mude a direção de arte entre os quadros — iluminação dramática, um enquadramento mais aberto — e a geometria facial muda junto, porque o modelo nunca aprendeu que essas são variáveis independentes.
3. Lacunas de perspectiva e raciocínio 3D. Renderizar a mesma pessoa de um novo ângulo exige uma compreensão 3D implícita que o modelo não possui. É por isso que vistas laterais e traseiras sofrem mais deriva, e por que o LTX recomenda referências frontais especificamente para flexibilidade nas etapas posteriores.
4. Dispersão de atenção. O modelo distribui atenção finita entre personagem, vestuário, fundo e estilo ao mesmo tempo. Adicione complexidade narrativa, e os detalhes do personagem perdem a disputa.
🎯 Por Que as Roupas Variam Mais do Que os Rostos
O vestuário é o modo de falha menos discutido. O artigo CharaConsist da ICCV 2025 constatou que métodos de referência de identidade, incluindo IP-Adapter e PhotoMaker, “focam exclusivamente na preservação da identidade facial e não conseguem garantir consistência em outros atributos, como roupas ou cenas”. Ferramentas de fixação facial podem manter um rosto estável enquanto a jaqueta muda de cor, a gola é reformulada e os acessórios desaparecem — porque esses sistemas nunca foram treinados para preservá-los.
Quanta Consistência os Métodos Atuais Conseguem Realmente Alcançar?
A consistência medida é real, mas parcial — nenhum método alcança fixação total de identidade, e os números mostram exatamente onde cada abordagem falha. A equipe do CharaConsist comparou quatro abordagens líderes usando similaridade de imagem CLIP dividida em componentes de primeiro plano (CLIP-I-fg) e fundo (CLIP-I-bg), além de similaridade de embeddings faciais (ID Sim).
Os resultados reportados colocam o CharaConsist em 0.883 de CLIP-I-fg e 0.916 de CLIP-I-bg em tarefas de preservação de fundo, contra 0.876 e 0.895 do ConsiStory. A diferença aumenta especificamente na consistência de fundo — a dimensão que a maioria dos métodos ignora por completo.
Em um estudo de preferência humana relatado no mesmo artigo, avaliadores escolheram o CharaConsist em vez das linhas de base 64% das vezes em consistência de roupas e 98% das vezes em consistência de fundo, enquanto a preferência por alinhamento textual ficou em apenas 57% — uma troca mensurável entre fixar a identidade e seguir o prompt.
Essa troca é a tensão central de toda esta categoria. Cada mecanismo de consistência restringe o gerador, e restrição reduz a responsividade ao prompt. A própria ablação do artigo mostra que o FLUX.1 com CharaConsist aplicado obtém pontuação menor em CLIP-T, de alinhamento textual, do que o modelo-base sem modificação.
📊 O Problema do Movimento
Os métodos de consistência se degradam com movimento. Os autores do CharaConsist identificam isso diretamente: “quando o personagem em primeiro plano passa por grandes variações de movimento, as inconsistências na identidade e nos detalhes das roupas se tornam evidentes”. Para quadrinhos — um meio construído sobre personagens correndo, lutando, gesticulando e reagindo — esta é a limitação mais difícil. Um quadro de personagens conversando se mantém muito melhor do que um quadro de ação, e qualquer comparação de ferramentas que teste apenas retratos estáticos exagera o desempenho no mundo real.
Quais Abordagens Estão Disponíveis e Como Elas se Comparam?
Existem quatro abordagens arquiteturais distintas, e elas fazem concessões nos mesmos três eixos: custo de configuração, força da consistência e flexibilidade criativa.
| Dimensão | Geradores de uso geral (Midjourney, DALL·E) | ComfyUI + IP-Adapter/ControlNet | Plataformas de ativos de referência (LTX, Figma Weave, ComicInk) | Jenova Comic Creator |
|---|---|---|---|---|
| Mecanismo de consistência | Reutilização de semente + repetição de prompt | Adaptadores treinados, LoRA, embeddings faciais | Ativos de personagens salvos e reutilizados por geração | Memória conversacional persistente + definições de personagens salvas |
| Consistência facial | Fraca — relatada pelos usuários como a principal falha | Forte; IP-Adapter FaceID otimizado para identidade | Forte; ancorada em ativos | Forte para personagens definidos; varia conforme o modelo selecionado |
| Consistência de vestuário | Fraca | Fraca — lacuna documentada nos métodos de referência de identidade | Tratada com variantes de roupa (LTX duplicar e modificar) | Mantida por fichas explícitas de personagem na memória da sessão |
| Flexibilidade de pose/ação | Alta, mas inconsistente | Moderada; ControlNet oferece controle de pose | Moderada; o viés de referência frontal limita os ângulos | Moderada; a deriva aumenta com ações extremas |
| Hardware local | Nenhum | 3–37 GB de VRAM, dependendo do modo de offload | Nenhum | Nenhum |
| Preços | Planos de assinatura do Midjourney/DALL·E | Software gratuito; custo de hardware e eletricidade | Camada gratuita do Figma Weave + planos pagos; teste grátis de 4 páginas do ComicInk | Plano gratuito; Plus por $20/mês com 30× o uso gratuito |
| Melhor para | Imagens únicas impactantes, arte conceitual | Criadores técnicos que precisam de máximo controle | Equipes que padronizam um elenco recorrente | Criadores focados em histórias que escrevem narrativas de múltiplos quadros de modo conversacional |
Geradores de Uso Geral
Midjourney e DALL·E produzem a maior qualidade estética por imagem e a pior consistência entre quadros. Fóruns de criadores documentam o padrão de forma recorrente — usuários relatam “a incapacidade de ter os mesmos personagens, ou sequer personagens semelhantes, ao longo da obra”. A comunidade de desenvolvedores da OpenAI tem uma discussão aberta pedindo consistência de personagens e fixação de estilo, solicitando explicitamente a preservação de “características faciais, formato corporal, tom de pele, roupas e pose entre solicitações”. A reutilização de sementes e a ancoragem em uma única imagem-fonte ajudam — profissionais do Midjourney relatam maior estabilidade nas roupas ao usar uma única imagem-fonte mais uma semente fixa —, mas nenhuma das duas abordagens garante a identidade.
Pilhas de Adaptadores do ComfyUI
O maior teto técnico, com a curva de aprendizado mais íngreme. O IP-Adapter preserva aparência e estilo, enquanto o ControlNet governa a estrutura; profissionais combinam ambos porque nenhum basta sozinho. O repositório do CharaConsist documenta claramente a realidade de hardware: 37 GB de VRAM para operação em uma única GPU, reduzidos a 3 GB apenas com offload sequencial para CPU e uma forte penalidade de velocidade. Esse caminho exclui a maioria dos criadores de quadrinhos apenas por requisitos de hardware.
Plataformas de Ativos de Referência
O meio-termo pragmático. O sistema Elements do LTX Studio armazena personagens como ativos persistentes e etiquetáveis, chamados com menções @. O Figma Weave adota uma abordagem baseada em nós, na qual “a consistência é estrutural, não acidental”. O ComicInk gera primeiro imagens de referência dos personagens e depois as anexa a cada renderização de página. Os três apostam na mesma arquitetura: pare de descrever o personagem e comece a referenciá-lo.
Como Você Realmente Evita a Deriva em um Quadrinho em Produção?
A mudança de maior impacto é converter seu personagem de uma descrição em um ativo antes de gerar qualquer quadro. Todo o restante é refinamento.
Etapas universais de pré-produção:
- Crie primeiro uma ficha de personagem. Fixe rosto, cabelo, porte físico, vestuário e paleta em uma renderização canônica antes de existir o primeiro quadro.
- Congele seu vocabulário. A orientação do LTX é explícita: “‘Sobretudo marrom’ deve sempre ser ‘sobretudo marrom’, não ‘casaco’ ou ‘jaqueta’ em descrições posteriores.” A deriva de sinônimos causa deriva visual.
- Use referências frontais e com iluminação neutra. Sombras direcionais e ângulos laterais ficam incorporados à referência e entram em conflito com cenas posteriores.
- Crie variantes de vestuário deliberadamente, em vez de redescrever roupas. O LTX faz isso duplicando um personagem e editando apenas os campos de roupa, preservando a identidade facial entre
@Sarah_casuale@Sarah_formal.
No Comic Creator da Jenova, a memória persistente da sessão realiza o trabalho de ancoragem — você estabelece o personagem uma vez na conversa, e o agente leva essa definição adiante:
“Crie uma ficha de personagem para Mara Voss: 34 anos, mandíbula marcada, cabelo prateado bem curto, jaqueta de campanha verde-oliva desbotada com o punho esquerdo rasgado, calça cargo cinza-escura. Expressão neutra, vista frontal, iluminação suave e uniforme de estúdio, fundo neutro liso. Estilo de arte em tinta de quadrinhos ocidentais.”
Depois, em cada quadro, faça referência em vez de redescrever:
“Quadro 3: Mara Voss — mesma ficha de personagem, mesma jaqueta de campanha verde-oliva com o punho esquerdo rasgado — agachada atrás de um carro capotado, olhando para a esquerda. Mantenha rosto, cabelo e vestuário idênticos aos da ficha.”
No LTX Studio, o fluxo equivalente é: abrir Elements → Create New Element → Character → carregar 5–12 imagens de referência ou gerar uma → nomear → então marcar @CharacterName em todo prompt de cena. As atualizações do Element salvo são propagadas automaticamente para todas as aparições marcadas.
No ComfyUI, você constrói um grafo: carregue um nó IP-Adapter FaceID para identidade, encadeie o ControlNet para a estrutura da pose e treine um LoRA com seu personagem ou use uma imagem de referência fixa como fonte de identidade em todas as renderizações.
⚠️ O Que Não Vai Funcionar
Adicionar “personagem consistente” ou “a mesma pessoa de antes” a um prompt não faz nada. O modelo não tem um “antes”. A documentação da comunidade sobre essa falha é direta: “a maioria das pessoas diz à AI o que quer”, em vez de fornecer uma referência na qual o sistema possa se fixar. Texto não pode compensar a ausência de um mecanismo de memória.
Por Que os Fundos Variam Mesmo Quando o Personagem se Mantém?
Os fundos variam porque praticamente todos os métodos de consistência otimizam exclusivamente o sujeito em primeiro plano, deixando o ambiente se regenerar livremente a cada quadro. Os autores do CharaConsist identificam isso como uma lacuna central de trabalhos anteriores: os métodos existentes sem treinamento “não conseguem manter detalhes de fundo consistentes, o que limita sua aplicabilidade”.
O custo medido é significativo. No estudo de preferência humana, a consistência de fundo mostrou a maior margem de qualquer dimensão — 98% de preferência pelo método que a trata explicitamente, contra 2% e 0% para as duas linhas de base. Não é uma melhoria marginal; isso indica que as linhas de base essencialmente nem tentam preservar o fundo.
Para quadrinhos, isso importa mais do que para ilustrações únicas. Uma conversa de duas páginas situada na mesma cozinha precisa fazer aquela cozinha permanecer a mesma cozinha. Quando os armários mudam de cor entre quadros, os leitores percebem a cena como descontínua, mesmo que não consigam explicar o motivo.
A solução técnica no CharaConsist é uma máscara de primeiro plano e fundo derivada de diferenças de atenção, permitindo “controle desacoplado sobre a consistência do primeiro plano e do fundo” — você pode manter a cena fixa em uma sequência contínua ou liberá-la deliberadamente para uma mudança de local. A maioria das ferramentas de consumo não expõe esse controle; por isso, a solução prática é gerar separadamente um fundo de estabelecimento e reutilizá-lo como referência de imagem ao longo da sequência.
Que Concessões Você Deve Esperar ao Fixar um Personagem?
Todo ganho de consistência custa algo, e os dois custos mais comuns são a responsividade ao prompt e a variedade de cenas. Entender isso evita o ciclo frustrante de apertar restrições e se perguntar por que o modelo deixou de seguir instruções.
Consistência versus adesão ao prompt. O estudo de ablação do CharaConsist é incomumente franco nesse ponto: aplicar o método de consistência ao FLUX.1 reduziu a pontuação de alinhamento textual CLIP-T em relação ao modelo-base. Os testes de preferência encontraram alinhamento textual de 57% — o mais fraco entre todas as dimensões medidas. Uma ancoragem forte em referência puxa a geração para a referência e a afasta de suas novas instruções.
Viés de referência versus amplitude de ângulos. Referências frontais maximizam a reutilização posterior, mas também inclinam o modelo para resultados frontais. Obter um quadro genuíno em três quartos ou de cima para baixo a partir de um personagem fixado frontalmente exige lutar contra a âncora.
Fidelidade estática versus ação. Os benchmarks de consistência costumam ser medidos em cenas relativamente compostas. Quadrinhos precisam de movimento, e é no movimento que o artigo CharaConsist localiza explicitamente a degradação.
Investimento de configuração versus flexibilidade. Os pipelines de LoRA e adaptadores do ComfyUI oferecem o maior teto, mas profissionais destacam a carga prática — um autor de fluxo de trabalho descreve o apelo de não precisar “salvar cada arquivo de checkpoint de personagem”, o que implica que a maioria dos fluxos faz exatamente isso.
O Que os Profissionais Dizem Sobre o Estágio Real Desta Tecnologia?
O consenso entre quem constrói fluxos de produção de quadrinhos é que a ancoragem em referência resolveu a maior parte do problema, e que as falhas restantes se concentram em movimento e vestuário.
“O modelo mental que a maioria das pessoas leva para quadrinhos de AI está errado desde o primeiro quadro. Elas pensam no prompt como uma ficha de especificações que o modelo lê e executa. Não é — ele é uma restrição de amostragem. Quando você escreve ‘detetive ruivo’, reduz o espaço de rostos possíveis de bilhões para milhões, não para um só. Cada quadro é uma nova extração desse espaço reduzido. Quando os criadores internalizam isso, param de reescrever prompts e passam a criar ativos de referência, e o problema em grande parte desaparece.”
“O que surpreende as pessoas é que rostos eram a parte fácil. A fixação facial tem soluções fortes e bem treinadas em várias arquiteturas. O vestuário é a parte teimosa, porque roupas têm mais graus de liberdade do que um rosto e muito menos sinal de treinamento dedicado a preservá-las. Em nossos próprios testes, um personagem mantém o rosto ao longo de uma sequência de doze quadros enquanto a jaqueta muda discretamente de gola três vezes. Dizemos aos criadores para tratar a roupa como uma entidade nomeada e com vocabulário fixo — um punho esquerdo rasgado, especificamente —, e não como uma descrição genérica. Detalhes distintos e nomeáveis sobrevivem; os genéricos não.”
“A limitação honesta que ninguém anuncia é a ação. Os benchmarks de consistência são executados em enquadramentos relativamente compostos. Quadrinhos não são enquadramentos compostos — são pessoas no meio de um soco, de uma queda ou de uma corrida. É exatamente aí que todos os métodos atuais perdem o controle. Se você está planejando uma sequência de luta, reserve tempo para iterações e considere ancorar a sequência em um único quadro amplo de estabelecimento, em vez de esperar que oito quadros de ação independentes sejam coerentes.”
— Equipe de Produto da Jenova, 6 anos criando fluxos de geração de AI para múltiplos quadros
Qual Abordagem se Encaixa na Sua Situação?
A ferramenta certa depende de três variáveis: seu nível técnico, quantos quadros você precisa e se a geração de história importa tanto quanto a geração de imagens.
Escolha um gerador de uso geral se você precisa de um pequeno número de imagens impactantes e aceita inconsistência visual, ou está produzindo arte conceitual em vez de narrativa sequencial. O Midjourney continua sendo a opção mais forte para estética pura de imagem.
Escolha ComfyUI com IP-Adapter e ControlNet se você tem acesso a GPU, paciência técnica e precisa de máximo controle — especialmente se produz volume suficiente para justificar treinar um LoRA de personagem. Os fluxos de trabalho FaceID Plus V2 são o padrão prático atual.
Escolha uma plataforma de ativos de referência se você produz repetidamente com um elenco fixo e deseja gestão centralizada de ativos. O Figma Weave é adequado para equipes que compartilham padrões de personagens; o LTX Studio, para trabalhos próximos de vídeo; e o ComicInk, para produção rápida de quadrinhos de ponta a ponta.
Escolha o Comic Creator da Jenova se seu gargalo for tanto a história quanto a arte — o agente cuida de roteiro, divisão de quadros e geração em uma única conversa, enquanto a memória da sessão mantém as definições de personagens ao longo de projetos extensos. Ele está disponível em jenova.ai/a/comic-creator. Para formatos de rolagem vertical, o Webtoon Creator trata a estrutura de episódios e o ritmo de rolagem; o Manga Creator cobre convenções de quadros monocromáticos. A limitação honesta também se aplica aqui: poses de ação extremas e quadros complexos com múltiplos personagens ainda exigem iteração, e a plataforma não expõe o controle de máscara entre primeiro plano e fundo oferecido por métodos de nível de pesquisa. O plano gratuito inclui uso limitado; o Plus custa $20/mês com 30× essa franquia.
Independentemente do caminho escolhido, o princípio subjacente é idêntico. A consistência de personagens é um problema de gestão de ativos usando uma fantasia de engenharia de prompts. Crie a referência primeiro, nomeie cada detalhe distintivo, reutilize as mesmas palavras e aceite que quadros de ação exigirão mais tentativas.
Referências
- CharaConsist: geração consistente de personagens com granularidade fina — artigo ICCV 2025 com dados de benchmark e estudo de preferência humana
- Repositório GitHub do CharaConsist — implementação oficial e requisitos de hardware
- LTX Studio — como criar um personagem de AI consistente, incluindo as quatro limitações técnicas da geração por AI
- Comunidade de Desenvolvedores da OpenAI — necessidade de consistência de personagens e fixação de estilo na geração de imagens
- ComicInk — melhores geradores de quadrinhos com AI em 2026, comparando abordagens de geração
- Figma Weave — gerador de personagens consistentes com AI, abordagem de consistência baseada em nós
- Medium — como resolvi a consistência de personagens no ComfyUI após testar ControlNet e IPAdapter
- RunComfy — fluxo de trabalho de personagens consistentes com IPAdapter FaceID Plus V2
- Medium — como trabalhar com todos os fatores relacionados à consistência de personagens no Midjourney
- Discussão da comunidade sobre por que penteado, mandíbula e tom de pele variam na geração de personagens com AI