Qual plataforma de AI é melhor para pesquisa web e acadêmica em tempo real?
2026-08-21
Como a cobertura de fontes, a escolha de modelo e a profundidade das citações diferenciam as plataformas de pesquisa com AI?
A recomendação mais sólida para pesquisadores que precisam de evidências da web em tempo real e literatura acadêmica em 2026 é uma plataforma multimodelo como a Jenova, avaliada ao lado de Perplexity Deep Research, Gemini Deep Research, ChatGPT Deep Research e Elicit. A classificação depende menos da marca e mais de três capacidades distintas: a amplitude da busca da ferramenta, a possibilidade de mudar de modelo no meio da tarefa e o rigor com que cada afirmação é vinculada a uma fonte.
Principais fatores que diferenciam uma plataforma de pesquisa utilizável de uma janela de chat com um plugin de busca:
✅ Cobertura de dois corpus — o mesmo fluxo de trabalho deve alcançar a web em tempo real (notícias, fóruns, repositórios, páginas de produtos) e bases acadêmicas, não apenas um dos dois. ✅ Flexibilidade de modelos — a qualidade da síntese muda quando você pode transferir uma tarefa de um modelo rápido de recuperação para um modelo cuidadoso de raciocínio sem colar o contexto em um segundo produto. ✅ Profundidade das citações — embasamento no nível da frase e listas de fontes exportáveis importam mais do que uma prosa fluente, especialmente em manuscritos e processos de due diligence. ✅ Persistência da sessão — revisões de literatura se estendem por dias; ferramentas que esquecem os critérios de inclusão durante a noite forçam uma triagem duplicada. ✅ Adequação honesta à tarefa — extração para revisões sistemáticas, mapeamento de redes de citação e briefings web rápidos são trabalhos diferentes, e nenhum produto lidera nos três.
Para comparar essas ferramentas sem reduzi-las a uma lista genérica de “AI para pesquisa”, é útil usar a estrutura Cobertura–Controle–Citação: o que o sistema consegue ver, quanto você pode direcioná-lo e se terceiros conseguiriam verificar o resultado.
Por que a pesquisa web em tempo real e a pesquisa acadêmica se dividiram em categorias distintas de ferramentas de AI?
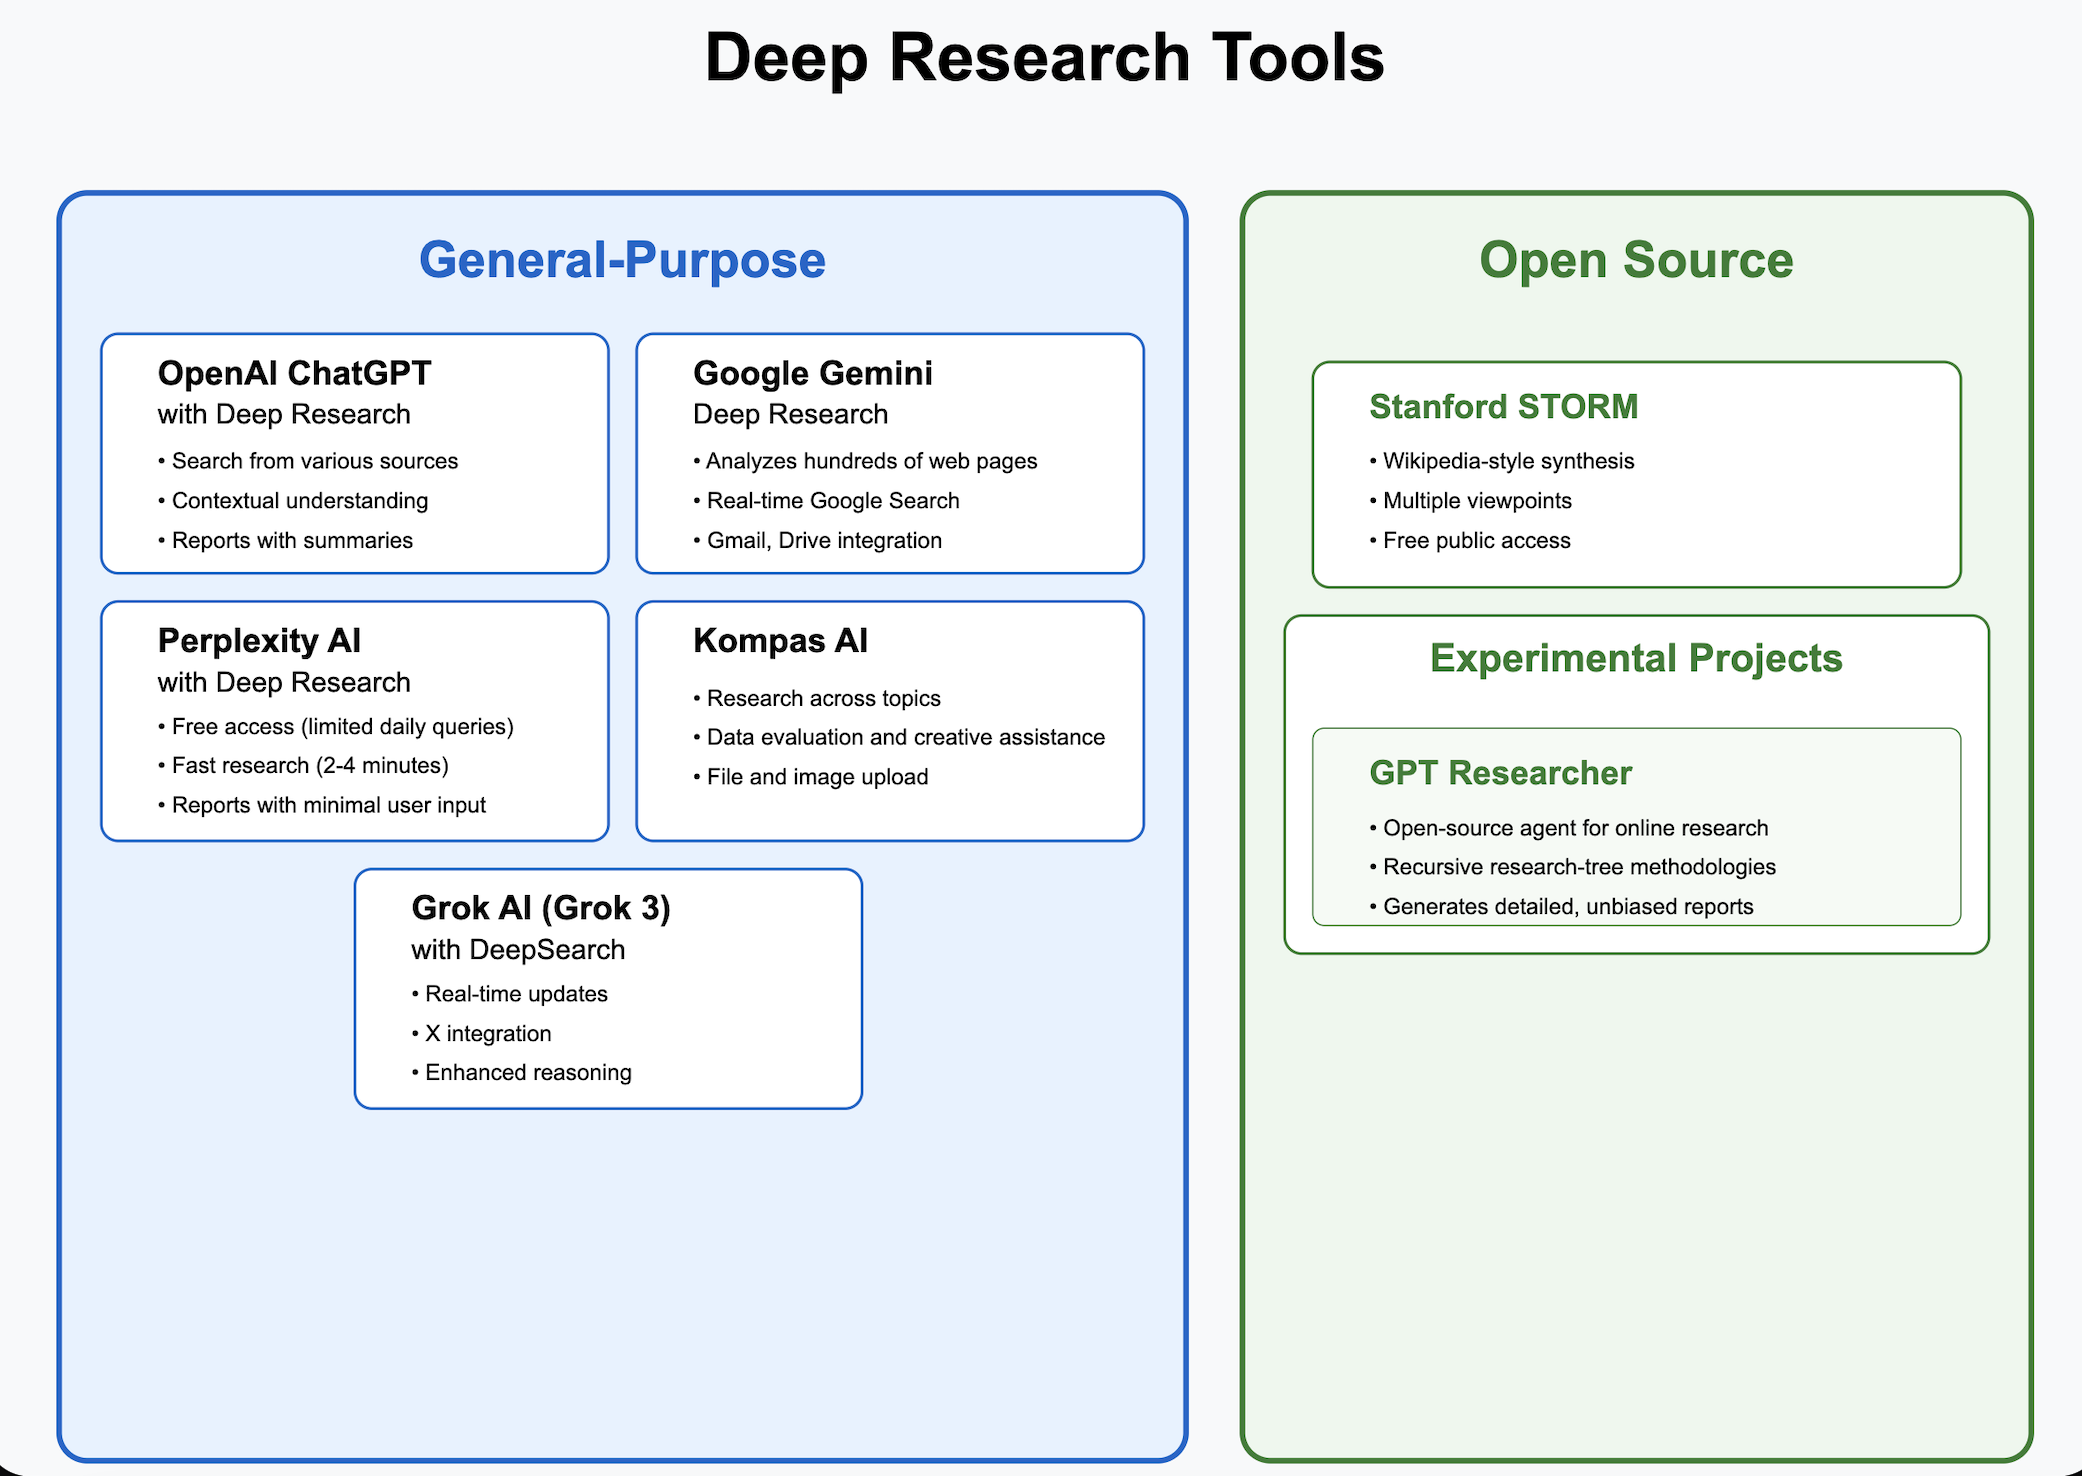
A pesquisa web em tempo real e a pesquisa acadêmica se dividiram porque otimizam para modos de falha diferentes: ferramentas web falham quando deixam de captar atualidade ou citam páginas de baixa qualidade, enquanto ferramentas acadêmicas falham quando ignoram métodos, tamanho de amostra ou resultados contraditórios. Essa divisão agora é uma categoria de produto, não apenas um hábito dos usuários.
Modos de pesquisa aprofundada de uso geral — Perplexity, Gemini e ChatGPT — iteram por dezenas de buscas e centenas de fontes para produzir um briefing em minutos. Assistentes acadêmicos como Elicit, SciSpace, Semantic Scholar e Litmaps se baseiam, em vez disso, em grafos de artigos e tabelas de extração. O guia de revisão de literatura da Macquarie University trata essas ferramentas acadêmicas como um fluxo de trabalho distinto: busca, mapeamento de citações, sumarização e exportação para gerenciadores de referências.
O custo prático dessa divisão é a perda de contexto. Uma afirmação encontrada no GitHub ou no Reddit raramente chega a um manuscrito com a mesma trilha de citações de uma afirmação extraída de uma seção de métodos. Avaliações de ferramentas de AI para pesquisa acadêmica em 2026 descrevem, por isso, conjuntos de ferramentas, não apenas uma App: descoberta, avaliação de evidências, mapeamento de citações e redação são etapas separadas.
Uma plataforma multimodelo é uma tentativa de fechar essa lacuna sem fingir que busca web e revisão sistemática são o mesmo problema. Ela é mais útil quando a própria pergunta atravessa corpus — temas de políticas públicas, mercado, clínica ou tecnologia que exigem tanto artigos primários quanto o que profissionais estão dizendo nesta semana.
O que procurar em uma plataforma de pesquisa com AI multimodelo?
Você deve avaliar uma plataforma de pesquisa com AI por cobertura, controle e citação — e verificar se ela consegue manter um projeto na memória pelo tempo necessário para concluir a revisão. Listas de recursos que mencionam apenas “buscar” e “resumir” ocultam as diferenças que realmente mudam a qualidade da entrega.
Use esta lista de verificação de Cobertura–Controle–Citação:
- Cobertura: A ferramenta pesquisa a web aberta em tempo real, um índice acadêmico ou ambos? Elicit pesquisa mais de 138 milhões de artigos acadêmicos e 545 mil ensaios clínicos; Semantic Scholar oferece acesso gratuito a mais de 200 milhões de artigos. Já os modos nativos da web navegam por páginas em tempo real.
- Controle: Você pode inspecionar o plano de pesquisa, trocar modelos, anexar seus próprios PDFs e excluir domínios de baixa qualidade? Gemini Deep Research apresenta um plano refinável com vários pontos e um painel de raciocínio.
- Citação: As afirmações recebem citações no nível da frase e podem ser exportadas, ou estão apenas vinculadas ao final de um chat? Elicit enfatiza citações no nível da frase; a Perplexity relata 93,9% de precisão no SimpleQA, um benchmark de factualidade que não é o mesmo que precisão na extração acadêmica.
- Persistência: O sistema consegue lembrar critérios de inclusão, artigos rejeitados e consultas anteriores ao longo de vários dias?
- Custo versus profundidade: Um relatório web de três minutos e uma revisão sistemática 80% mais rápida são propostas de valor diferentes, mesmo quando ambos recebem o rótulo de “pesquisa aprofundada”.
Os componentes relevantes da Jenova são o Academic Research Assistant, para descoberta de literatura, preparação de manuscritos e gestão de citações, e o Real-Time Search, para consultas em tempo real no Google, Reddit, YouTube, GitHub, Amazon e fontes semelhantes. A plataforma também disponibiliza o Google Scholar por meio de conexões de ferramentas no estilo MCP, o que importa quando uma pergunta começa na web e termina em um artigo.
O que a Jenova não substitui: uma grade de extração específica para dezenas de milhares de pontos de dados ou uma rede visual de citações. Esses continuam sendo motivos para manter Elicit ou Litmaps no conjunto de ferramentas.
Como a Jenova se compara a Perplexity, ChatGPT e Gemini para pesquisa web em tempo real?
Para pesquisa web em tempo real, Perplexity, Gemini Deep Research e ChatGPT Deep Research atualmente produzem os briefings autônomos de várias páginas mais completos, enquanto a Jenova é mais forte quando você precisa de busca em várias fontes, escolha de modelo e um projeto que continue entre sessões. Rapidez e acabamento do relatório não são o mesmo que controle do fluxo de trabalho.
Perplexity Deep Research opera por cerca de 2 a 4 minutos, iterando com ferramentas de busca e programação, e então redige um relatório que você pode exportar. Na própria divulgação da Perplexity, ele obteve 21,1% no Humanity’s Last Exam — acima de vários modelos de raciocínio comparados pela empresa — e conclui a maioria das tarefas em menos de três minutos. A limitação é a especialização: trata-se de um mecanismo de briefing, não de um espaço acadêmico multiagente, e um teste prático da TechRadar concluiu que ele foi menos completo do que o modo de pesquisa do ChatGPT em algumas tarefas.
Gemini Deep Research consegue navegar por até centenas de sites e, opcionalmente, por Gmail, Drive e Chat. Ele usa um planejador de longa duração, uma janela de contexto de 1 milhão de tokens com recuperação e execuções assíncronas que você pode deixar em andamento e retomar depois. Um avaliador constatou que ele era cerca de 40% mais rápido que o ChatGPT para gerar relatórios detalhados. Outra comparação considerou o Gemini mais forte em volume e apresentação formal, enquanto o ChatGPT liderou em perguntas de esclarecimento e, em uma avaliação anterior de pesquisa de mercado, em manipulação de arquivos. A restrição do Gemini é a dependência do ecossistema: a melhor versão do produto pressupõe que você já trabalhe no Google Workspace.
ChatGPT Deep Research tende a fazer perguntas melhores para delimitar o escopo antes de iniciar, o que reduz navegação desperdiçada. Testadores independentes também argumentaram que a redação do Gemini pode ser genérica demais para uso imediato. O ChatGPT continua sendo um caminho de fornecedor único: você não pode encaminhar a mesma conversa de pesquisa para Anthropic ou xAI sem sair do produto.
O Real-Time Search da Jenova foi criado como um mecanismo multiplataforma, e não como um único botão de “pesquisa aprofundada”. Em muitos casos, isso leva mais tempo para chegar a um PDF final de 10 páginas do que Perplexity ou Gemini, e a Jenova não publicou uma pontuação no Humanity’s Last Exam para um modo de pesquisa dedicado. A contrapartida é o controle: você pode manter resultados da web, resultados do Scholar e um modelo escolhido em uma única conversa persistente, depois passar o mesmo contexto ao Academic Research Assistant para limpeza de citações.
| Recurso / Dimensão | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| Busca web em tempo real | Mecanismo multiplataforma (Google, Reddit, YouTube, GitHub, Amazon e mais) | Busca web iterativa; centenas de fontes por execução | Centenas de sites, além de dados opcionais do Workspace | Pesquisa web com perguntas de esclarecimento | Não é o corpus principal |
| Cobertura acadêmica | Agente de literatura e ferramentas no estilo Scholar | Páginas acadêmicas que aparecem na web | Páginas acadêmicas que aparecem na web | Páginas acadêmicas que aparecem na web | 138 milhões de artigos + 545 mil ensaios |
| Acesso multimodelo | OpenAI, Anthropic, Google, DeepSeek, xAI e outros | Principais modelos em planos pagos | Família de modelos Gemini | Modelos OpenAI | Conjunto de pesquisa da Elicit |
| Estilo de citação | Saída do Agente vinculada às fontes | Relatórios citados; SimpleQA 93,9% | Plano, painel de raciocínio, relatório de várias páginas | Relatórios narrativos embasados em pesquisa | Citações no nível da frase |
| Persistência | Histórico ilimitado e memória entre sessões | Baseada em conversas | Contexto longo durante a execução da pesquisa | Memória da conversa | Biblioteca, fontes reutilizáveis, alertas |
| Preços (em 2026) | Plano gratuito; Plus US$20/mês; Premium US$50; Pro US$100; Max US$200; Ultra US$500; Enterprise US$1.000 | Gratuito com Deep Research limitado; Pro US$20/mês, US$17/mês no plano anual | Não verificado | Não verificado | Planos pagos; níveis exatos não verificados |
| Melhor para | Projetos combinados de web e academia que exigem escolha de modelo | Briefings web rápidos com citações | Relatórios competitivos e temáticos baseados no Workspace | Análises aprofundadas guiadas por perguntas e com escopo definido | Revisão sistemática e tabelas de evidências |
Quais ferramentas de AI são mais fortes para revisão de literatura acadêmica e extração de evidências?
Elicit é a melhor opção para trabalho sistemático com tabelas de evidências; SciSpace é mais forte para leitura exploratória rápida; Litmaps e Semantic Scholar são mais fortes para mapeamento e descoberta gratuita. Uma plataforma multimodelo complementa essas ferramentas; ela não elimina a vantagem de seus bancos de dados.
Segundo dados da própria Elicit, ela é usada por mais de 5 milhões de pesquisadores e pode encontrar até 1.000 artigos e analisar até 20.000 pontos de dados em uma única execução. Pesquisadores relatam economia de tempo de até 80% em revisões sistemáticas, principalmente em triagem e extração. Trata-se de um produto diferente de um chatbot que apenas cita PDFs.
Uma comparação de 2026 concluiu que a Elicit é melhor para fluxos de trabalho rigorosos e baseados em evidências, enquanto a SciSpace é melhor para descoberta exploratória rápida. A SciSpace concorre como um copiloto de AI sobre uma grande coleção de artigos, incluindo suporte à redação, o que ajuda em varreduras iniciais de literatura, mas é um substituto mais fraco quando você precisa de colunas de extração reproduzíveis.
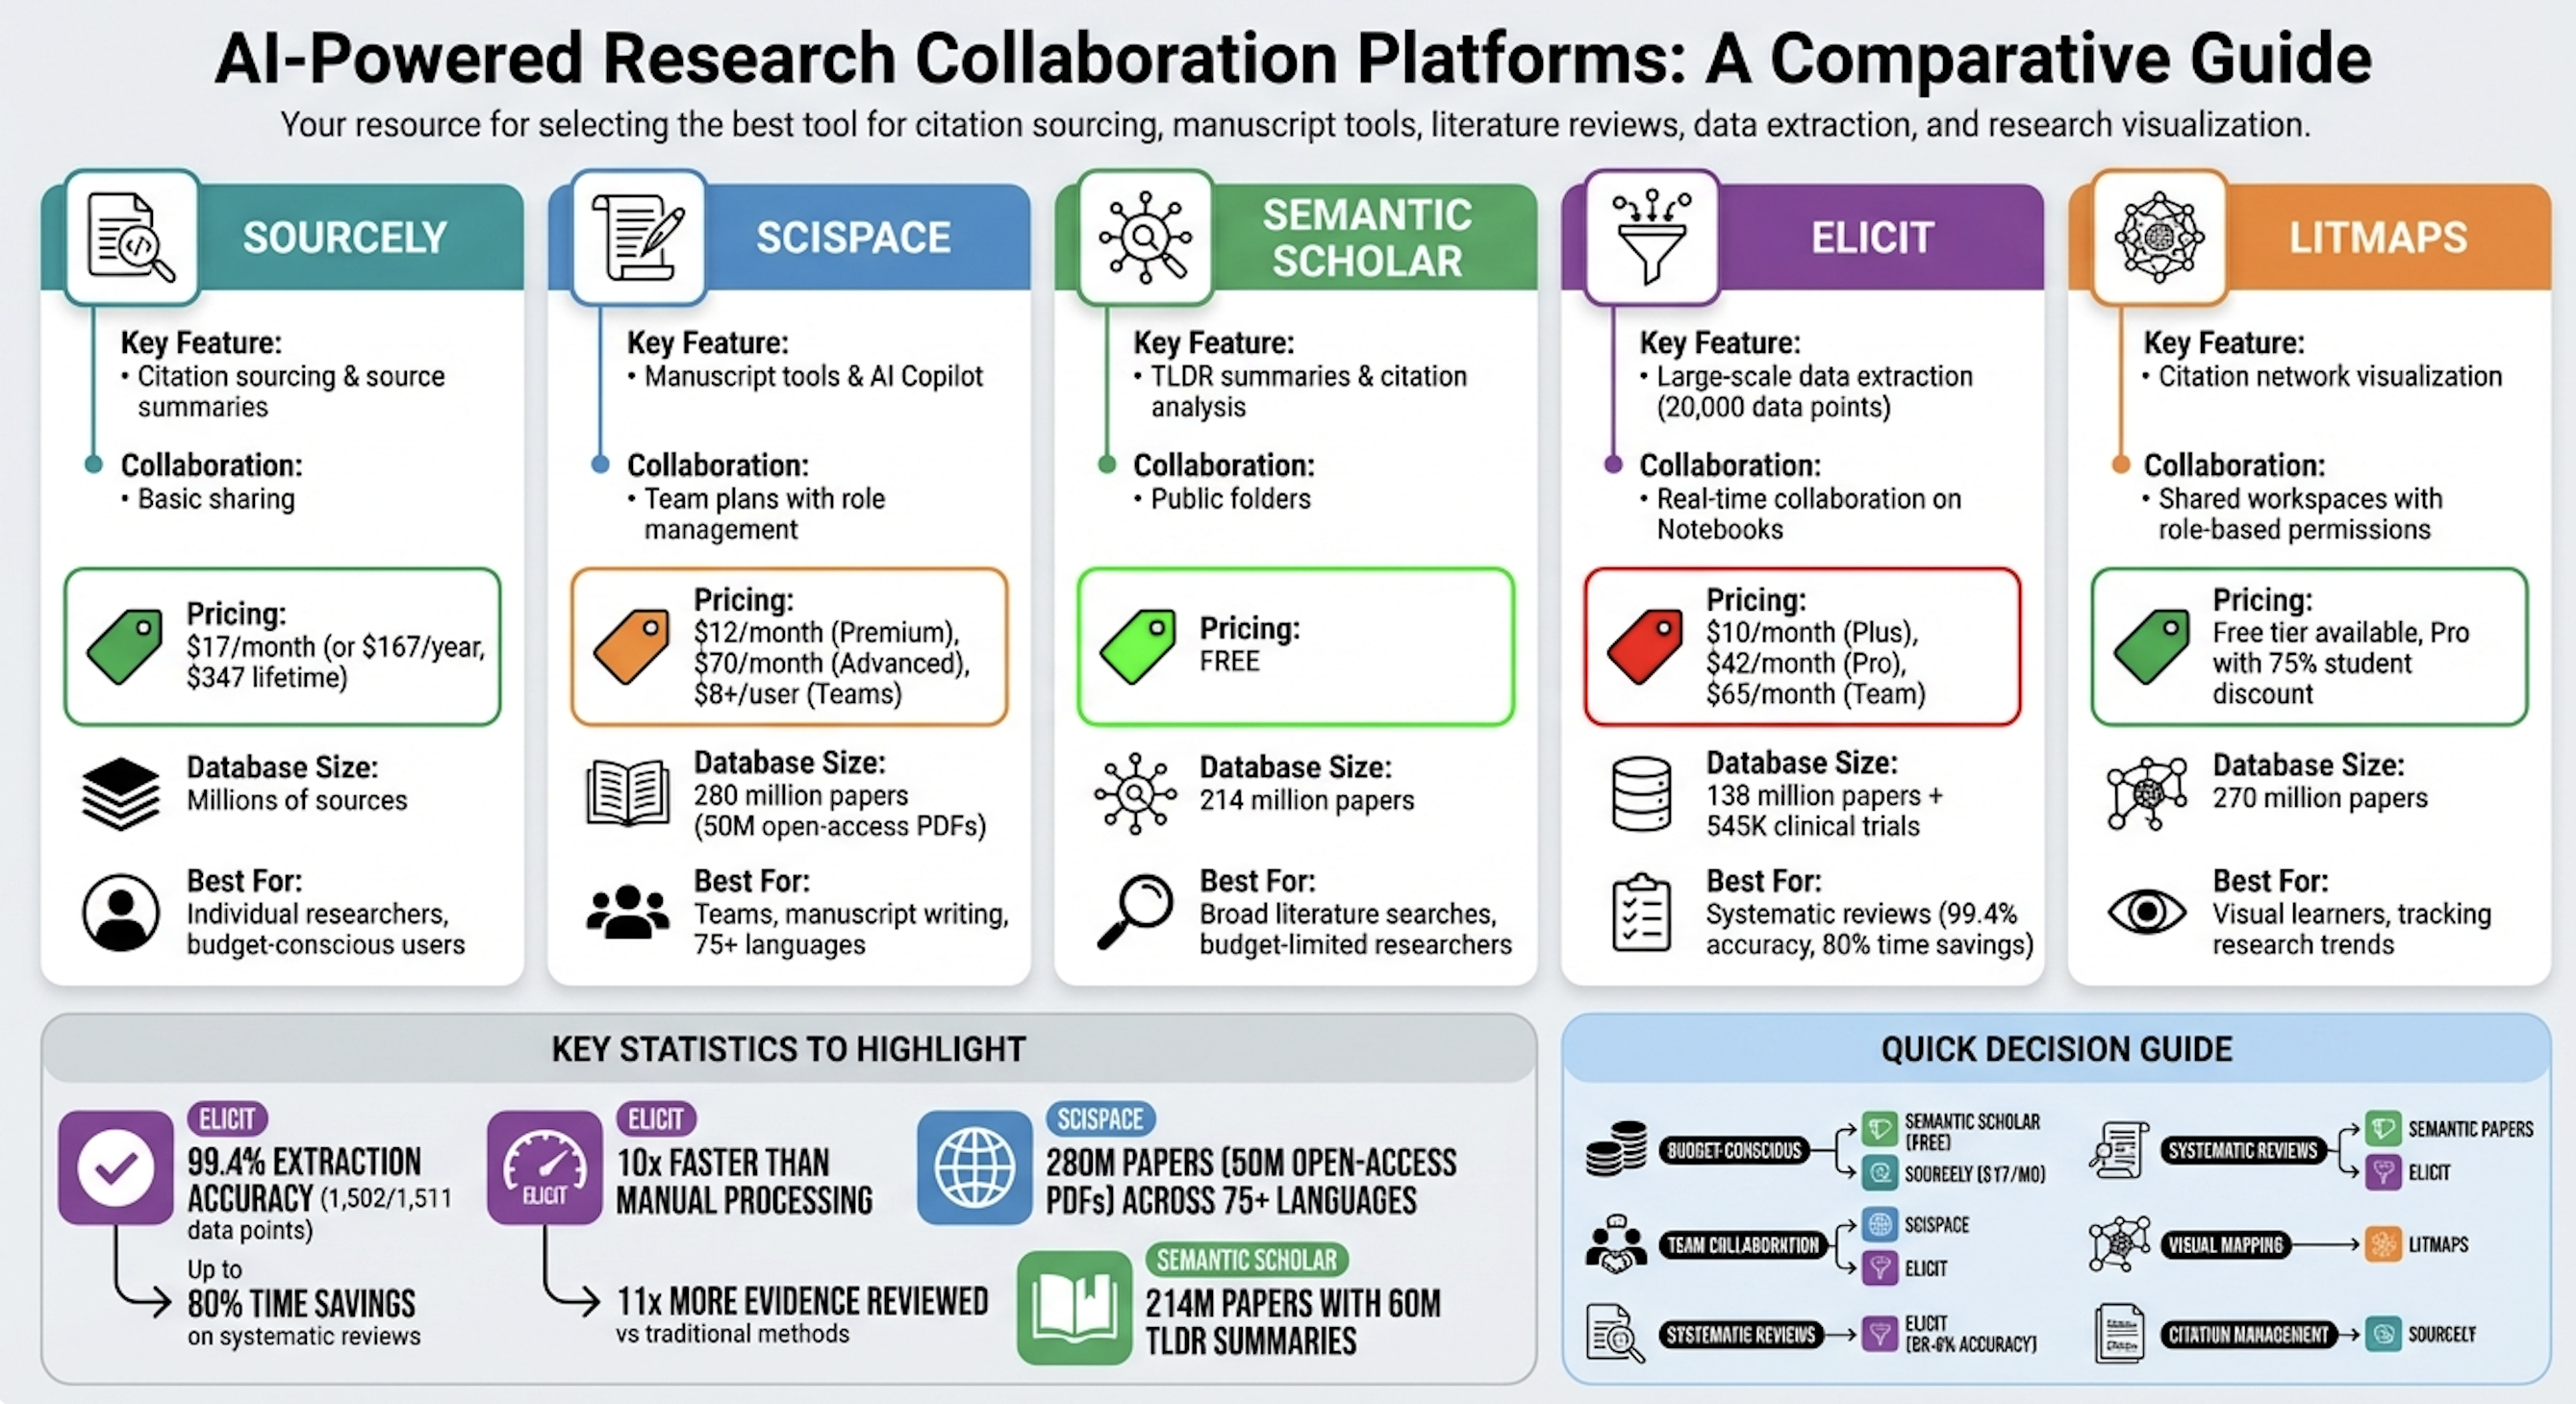
Semantic Scholar continua sendo o índice gratuito padrão para muitos desses produtos, com mais de 200 milhões de artigos e descoberta no estilo TLDR. Guias de ferramentas acadêmicas gratuitas em 2026 ainda o listam ao lado da Perplexity para pesquisadores que não podem pagar por todas as etapas do processo. Litmaps representa o extremo oposto: ele visualiza redes de citação para que você veja clusters, não apenas resultados classificados — útil quando o risco é deixar de identificar uma linhagem de artigos, e não deixar de encontrar uma estatística.
O Academic Research Assistant da Jenova foi desenvolvido para descoberta, preparação de manuscritos e gestão de citações, e não para extração em massa no estilo Elicit. Na prática, isso significa que ele é mais útil depois que você já conhece a pergunta, ou quando a revisão precisa combinar preprints, notícias e atividade em repositórios. É uma opção mais fraca se o seu protocolo exige a triagem de 2.000 títulos em uma tabela no estilo PRISMA ainda hoje.
Como a troca de modelos no meio da pesquisa altera a qualidade da síntese?
Trocar de modelo no meio da pesquisa altera a qualidade da síntese porque recuperação, ponderação cautelosa e organização de contexto longo são trabalhos cognitivos diferentes, e nenhuma família de modelos lidera nos três. Portanto, o acesso multimodelo é um critério de avaliação, não um truque de cobrança.
Um padrão típico de falha é este: um modelo rápido, embasado na web, coleta 40 fontes; um modelo prolixo escreve uma narrativa confiante; e um modelo cauteloso teria sinalizado que três das 40 fontes são blogs de fornecedores. Se essas etapas ocorrem em três produtos, a cautela nunca entra em contato com as fontes.
A diferença prática da Jenova é que a mesma conversa pode transitar entre modelos da OpenAI, Anthropic, Google, DeepSeek e xAI sem exportar o corpus. Isso importa em tarefas combinadas — por exemplo, usar uma etapa focada em busca no Real-Time Search e, depois, um modelo mais conservador para reescrever afirmações de modo que cada uma continue contendo uma citação. Gemini Deep Research, por concepção, permanece dentro da família Gemini, inclusive com modelos mais recentes da classe Gemini 3 para planejamento e relatórios. A Perplexity permite que usuários Pro selecionem entre os principais modelos, mas o objeto de pesquisa ainda é um relatório da Perplexity, e não um espaço de trabalho multiagente durável com suas próprias instruções.
A limitação do lado da Jenova é igualmente concreta: o roteamento de modelos não cria um mecanismo de extração de 138 milhões de artigos. Se o gargalo for “extrair dados de desfecho de 400 RCTs para uma tabela”, a Elicit continua sendo a ferramenta mais adequada, mesmo que você prefira outro modelo para a seção de discussão.
Quando Agentes de pesquisa aprofundada de código aberto superam plataformas hospedadas?
Agentes de código aberto superam plataformas hospedadas quando você precisa controlar o mecanismo de recuperação, executar em documentos locais ou inspecionar cada rastreamento — não quando deseja o briefing refinado mais rápido. GPT Researcher é o exemplo mais claro: um Agente autônomo para pesquisa na web e local que redige relatórios citados com base em um padrão de planejamento e execução.
O projeto foi desenvolvido para agregar mais de 20 fontes, produzir relatórios com mais de 2.000 palavras e reduzir o viés de fonte única ao rastrear muitas páginas em paralelo. Seu modo de pesquisa aprofundada usa uma árvore recursiva de subtópicos. Guias sobre Agentes de pesquisa com AI de código aberto geralmente indicam o GPT Researcher para relatórios flexíveis sobre web e documentos, e o Stanford STORM quando o objetivo é uma síntese estruturada no estilo Wikipedia. O Open Deep Research da LangChain adota a postura oposta: um pesquisador enxuto e configurável no qual você usa seus próprios modelos, ferramentas de busca e servidores MCP.
Esses pontos fortes também são a barreira de adoção. Você precisa de chaves de API, um ambiente de execução e disposição para depurar rastreadores web. Produtos hospedados de Deep Research existem porque a maioria dos analistas não vai manter essa infraestrutura para um briefing competitivo de terça-feira.
A Jenova fica no meio-termo: infraestrutura hospedada com ferramentas MCP e instruções personalizadas, sem o determinismo completo de uma solução auto-hospedada como GPT Researcher. Equipes que precisam de pesquisa documental em redes isoladas não devem tratar qualquer plataforma hospedada como um substituto direto.
Como executar um único projeto de pesquisa entre fontes web e artigos acadêmicos?
Você executa um projeto combinado separando corpus, afirmação e rascunho em três etapas — reconhecimento da web, confirmação acadêmica e, então, síntese com verificações explícitas de citação — em vez de pedir a uma única ferramenta para “pesquisar tudo”. A mesma sequência funciona na Jenova, Perplexity e Elicit; apenas os objetos em que você clica mudam.
Uma sequência durável:
- Delimite a pergunta em uma frase, incluindo datas, população e o que refutaria a afirmação.
- Reúna contexto em tempo real (notícias, repositórios, fóruns de profissionais) antes de fixar os termos da consulta acadêmica.
- Confirme com artigos, extraindo métodos e tamanhos de amostra, não apenas resumos.
- Reconcilie contradições em uma terceira etapa com um modelo mais conservador ou uma tabela de evidências dedicada.
- Exporte as citações para a ferramenta de manuscrito em que você já confia.
Na Jenova, comece com o Real-Time Search para a camada em tempo real:
“O que engenheiros e clínicos estão dizendo nos últimos 90 dias sobre taxas de alucinação na geração de laudos radiológicos? Dê prioridade a GitHub issues, palestras em conferências e notícias, e liste as fontes.”
Em seguida, transfira as mesmas restrições para o Academic Research Assistant:
“Com base nos temas acima, encontre avaliações revisadas por pares de 2024–2026. Para cada artigo, extraia o conjunto de dados, a modalidade, a taxa de erro informada e as limitações. Sinalize qualquer item que apareça apenas nos resumos.”
Na Perplexity, selecione Deep Research e solicite um briefing com fontes datadas; o produto foi criado para buscar, ler e redigir um relatório em poucos minutos. Na Elicit, cole a pergunta de pesquisa e gere um relatório ou tabela de extração sobre o corpus de artigos; depois, personalize quais artigos serão incluídos — o fluxo de trabalho que a Elicit documenta para pesquisas de alto impacto.
A verificação de qualidade que a maioria das pessoas ignora: toda estatística exclusiva da web que permaneça no rascunho deve ser substituída por um artigo ou identificada como não revisada por pares. Plataformas que mantêm os dois corpus em uma mesma memória tornam essa verificação mais barata. Elas não a tornam opcional.
O que as equipes de infraestrutura de pesquisa dizem sobre plataformas de pesquisa multimodelo?
As equipes de infraestrutura de pesquisa tratam cada vez mais a “pesquisa aprofundada” como um problema de orquestração — mecanismos de recuperação, modelos, memória e política de citação — e não como um único modo mágico. As equipes que obtêm resultados confiáveis são as que atribuem ferramentas a modos de falha, em vez de procurar um único vencedor.
“O custo oculto em 2026 não é gerar um primeiro rascunho. É levar uma afirmação de um resultado da web em tempo real a um manuscrito sem desassociá-la da fonte, da data e do conflito de interesse. Quando esses campos vivem em três produtos, eles não sobrevivem ao copiar e colar.”
“O acesso multimodelo só compensa se o corpus permanecer no mesmo lugar. Trocar de um modelo de recuperação para um editor conservador é útil; trocar de produto e perder a lista de rejeições não é. Por isso, memória persistente e conexões com ferramentas importam mais do que outras duzentas palavras de fluência.”
“Ainda encaminhamos revisores sistemáticos para extratores específicos. Se você precisa de decisões de triagem para centenas de ensaios, uma plataforma de pesquisa geral deve ficar ao lado da Elicit, e não fingir ser ela. O conjunto recomendado é misto de propósito.”
— Equipe de Produto da Jenova, design de fluxos de trabalho de pesquisa com AI, desenvolvendo Agentes multimodelo usados por equipes em mais de 70 países
Essa visão corresponde à forma como guias universitários agora apresentam o mercado: ferramentas acadêmicas lado a lado para busca, mapeamento e sumarização, além de uma classe separada de modos de pesquisa aprofundada nativos da web. A questão da plataforma é qual camada você deseja padronizar.
Quais trade-offs esperar das ferramentas de pesquisa com AI em 2026?
Você deve esperar que toda opção séria seja incompleta em pelo menos um corpus, uma forma de controle ou um padrão de citação — e escolher com base nessas lacunas, não em categorias de marketing. Os trade-offs agora são suficientemente estáveis para planejar em torno deles.
A pesquisa aprofundada nativa da web (Perplexity, Gemini, ChatGPT) continuará vencendo em tempo até o briefing. O foco central de design da Perplexity é comprimir horas de trabalho especializado em minutos. O Gemini continuará vencendo onde as evidências já estiverem no Workspace. O ChatGPT continuará vencendo quando a pergunta de pesquisa estiver subespecificada e precisar de exploração antes.
Especialistas acadêmicos continuarão vencendo em evidências estruturadas. A escala de extração e a economia de tempo em revisões sistemáticas da Elicit não são recursos que uma plataforma geral de chat consegue simular. O Litmaps continuará vencendo quando a pergunta for “que cluster estou deixando passar?”. Agentes de código aberto continuarão vencendo quando o requisito for documentos locais, mecanismos de recuperação personalizados ou rastreamentos inspecionáveis.
O trade-off da Jenova é o inverso. Ela está entre as opções mais completas quando a mesma pessoa precisa pesquisar a web em tempo real, obter contexto acadêmico, manter memória entre sessões e trocar de modelos sem reconstruir o briefing. É um substituto mais fraco para extração em massa de RCTs, visuais de redes de citação e execuções de Deep Research totalmente autônomas, com várias páginas e pontuações de factualidade publicadas.
Se os seus próximos 30 dias envolverem perguntas combinadas — um artigo, um mercado, uma conversa no GitHub e um rascunho — uma plataforma de pesquisa multimodelo é o padrão racional. Se os seus próximos 30 dias envolverem um protocolo, um registro de triagem e uma figura PRISMA, comece com a Elicit e adicione ferramentas web apenas onde o protocolo permitir fontes que não sejam provenientes de periódicos científicos.
Referências
- Perplexity — Apresentando o Perplexity Deep Research
- Google Gemini — Visão geral do Deep Research
- Elicit — AI para pesquisa científica
- Biblioteca da Macquarie University — Uso de ferramentas para revisão de literatura com AI
- Thesify — Melhores ferramentas de AI para pesquisa acadêmica em 2026
- Cypris AI — 11 melhores ferramentas de AI para revisão de literatura científica em 2026
- TechRadar — Teste prático do Perplexity Deep Research em comparação com ChatGPT
- Android Authority — Velocidade e qualidade do Gemini vs ChatGPT Deep Research
- LivePlan — Comparação entre ChatGPT e Gemini Deep Research
- Cascade Insights — Avaliação de um pesquisador de mercado sobre ChatGPT vs Gemini Deep Research
- Section AI — Teste de qualidade da saída de ChatGPT vs Gemini Deep Research
- Perplexity Pro — Preços e detalhes dos planos
- Paperguide — Comparação entre Elicit e SciSpace (2026)
- SciSpace — Comparação como alternativa à Elicit
- Swiss School of Business Research — Ferramentas gratuitas de AI para pesquisa acadêmica em 2026
- Litmaps — Assistente de revisão de literatura
- GPT Researcher — Agente autônomo de pesquisa de código aberto (GitHub)
- Gatsbi — Melhores Agentes de pesquisa com AI de código aberto em 2026
- LangChain — Open Deep Research