Qual plataforma de AI extrai melhor desenho de estudo, resultados e limitações?
2026-08-21
Como Avaliar Ferramentas de AI pela Extração Rastreável de Quatro Campos, e Não por Resumos Genéricos de Artigos?
Para extrair desenho do estudo, amostra, resultados e limitações em uma tabela de evidências verificável, um Agente de pesquisa flexível como o Jenova's Academic Research Assistant é mais indicado quando os artigos são heterogêneos e as limitações exigem interpretação, enquanto Elicit e Paperguide são mais fortes quando você precisa de extração orientada por modelos em grandes conjuntos de ensaios relativamente padronizados. SciSpace e Consensus são úteis para descoberta e respostas rápidas sobre evidências, mas são menos eficazes como mecanismos principais de extração.
A distinção relevante em 2026 não é “qual ferramenta resume PDFs”. É qual ferramenta consegue preencher quatro campos — métodos, amostra, desfechos e limitações — com proveniência que você pode auditar.
Fatores-chave que diferenciam evidências extraíveis de uma síntese fluente:
✅ Fidelidade ao esquema — a ferramenta retorna desenho do estudo, n, população, desfechos e limitações como campos separados, e não como um parágrafo combinado. ✅ Vinculação à fonte — cada célula cita uma frase, tabela, figura ou página, e não apenas o título de um artigo. ✅ Inteligência sobre limitações — viés, generalização e lacunas de relato são classificados, e não copiados das ressalvas dos autores. ✅ Estrutura entre artigos — os resultados ficam alinhados lado a lado para que você possa comparar, em vez de reler. ✅ Fluxo de trabalho verificável por humanos — você pode rejeitar, corrigir e reutilizar a tabela sem começar do zero.
Para comparar essas plataformas com honestidade, ajuda avaliá-las com base nesse padrão de quatro campos, em vez de apenas pela qualidade dos resumos.
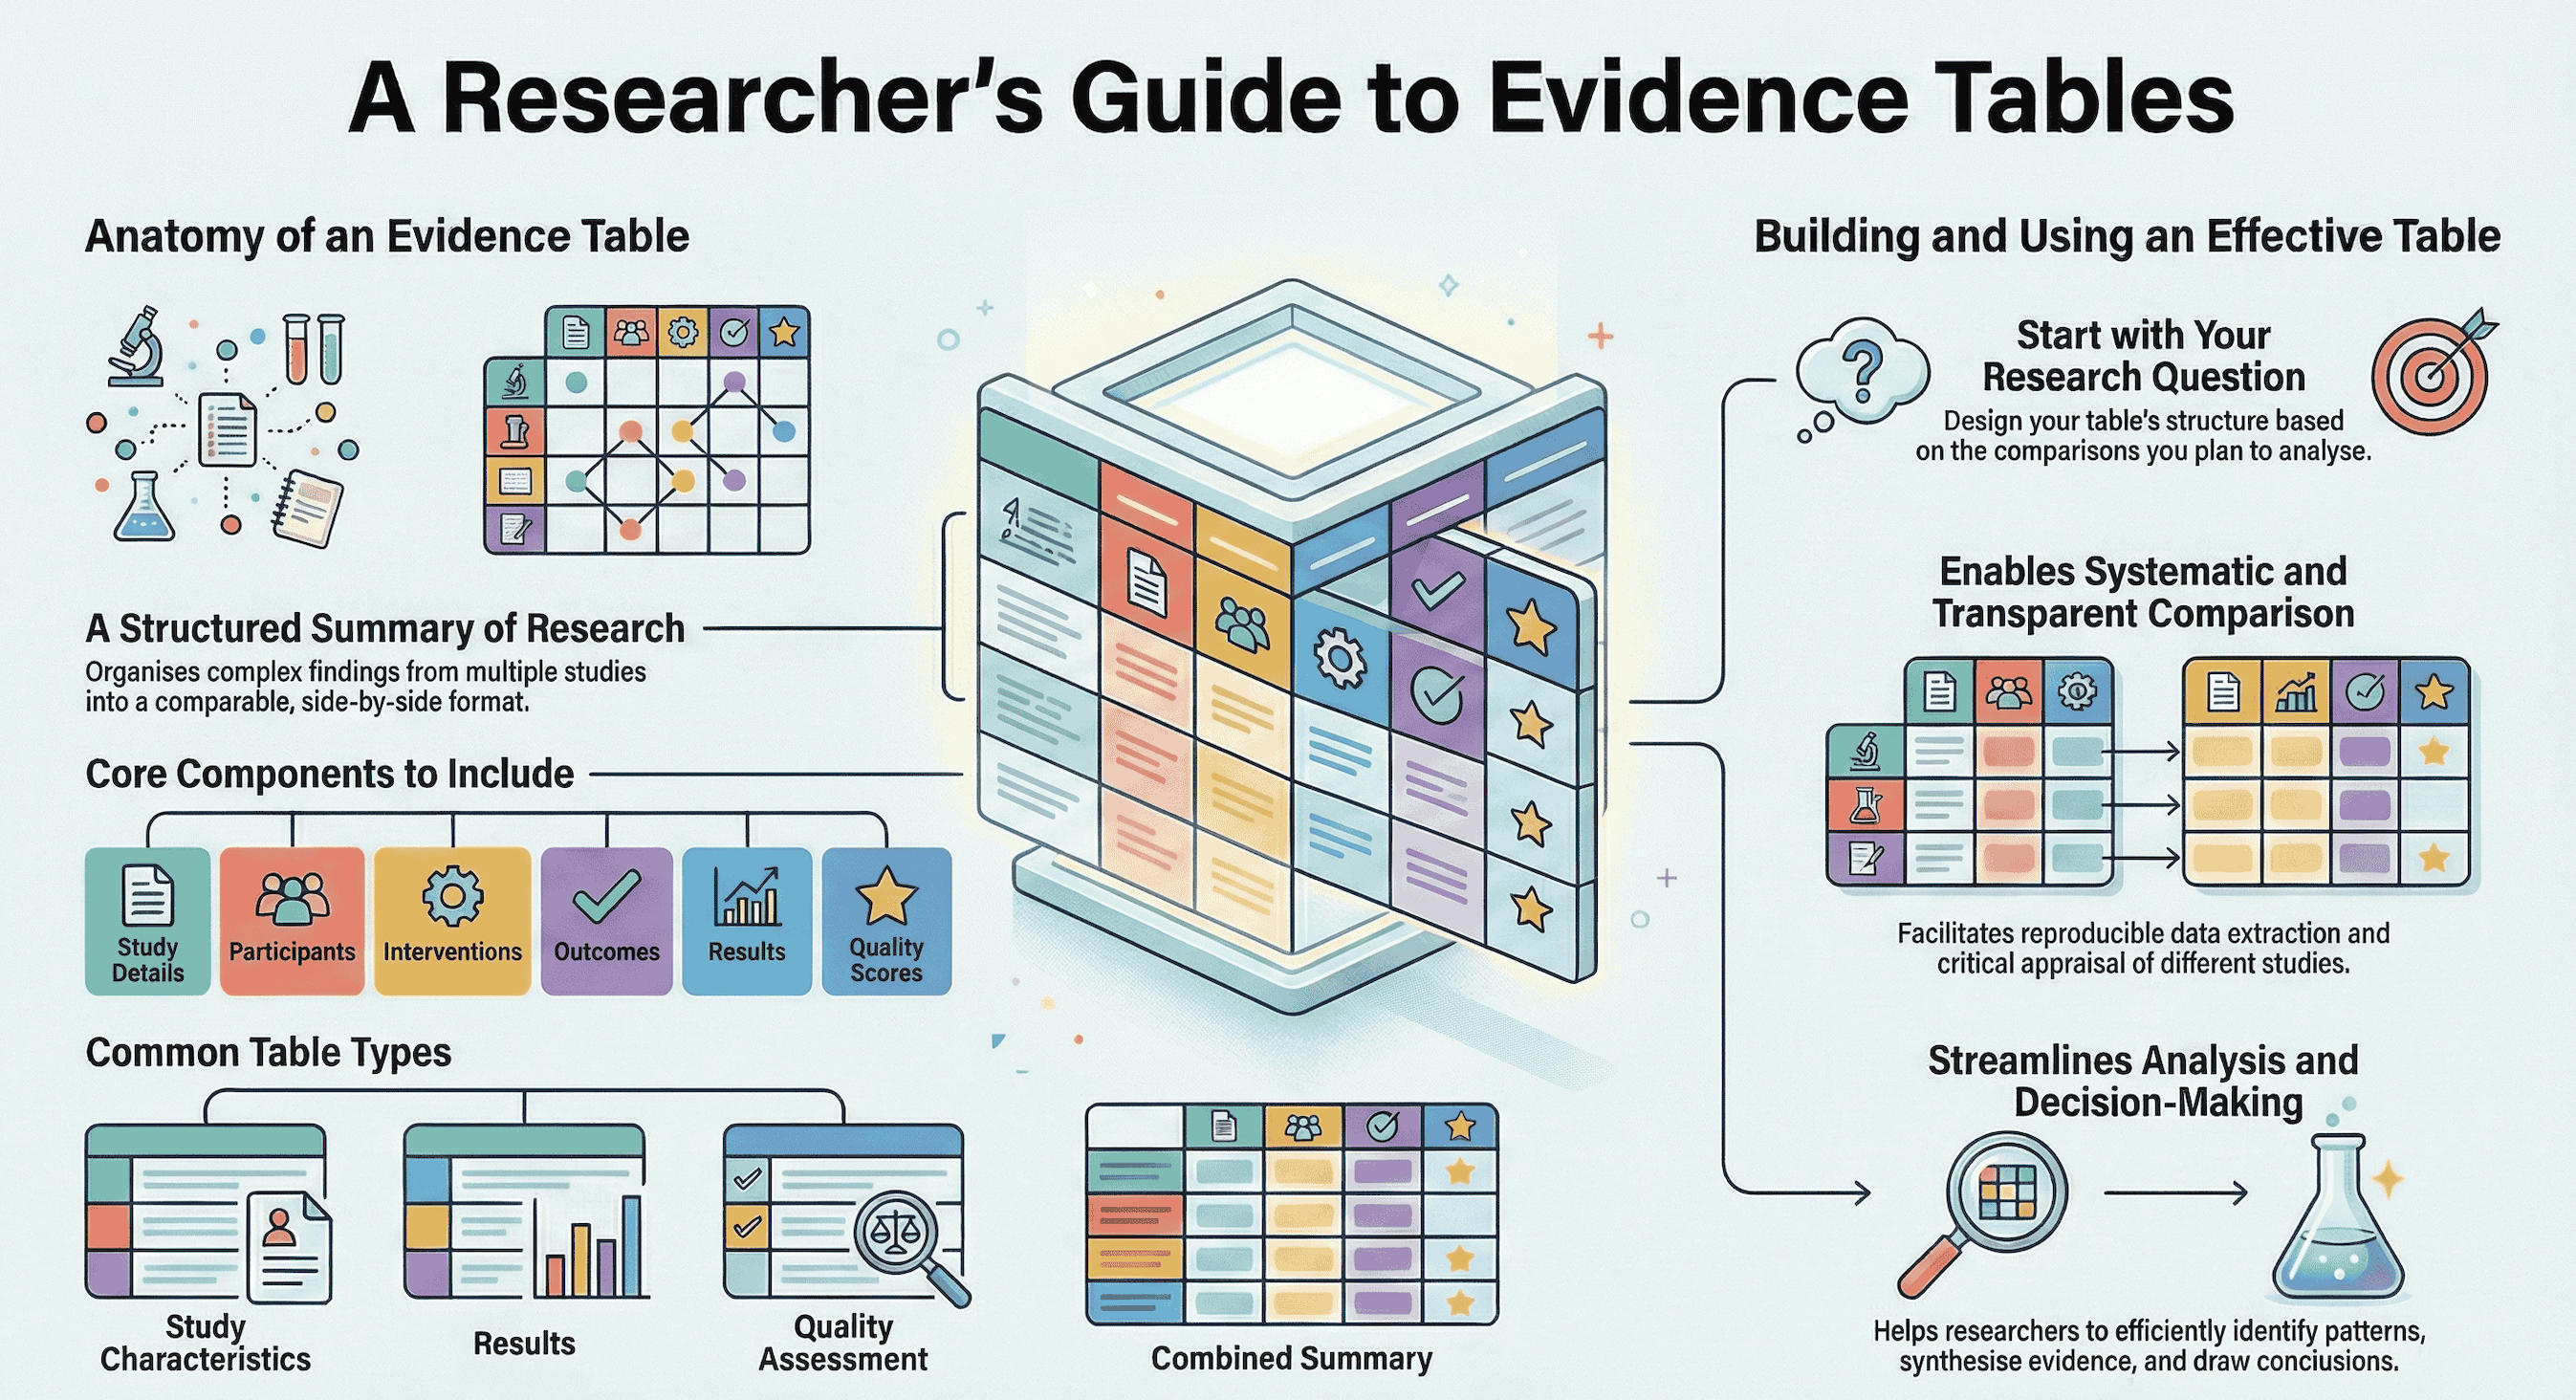
Por Que Extrair Desenho de Estudo e Limitações se Tornou um Gargalo para Pesquisadores?
A extração manual de dados continua sendo uma das etapas mais lentas e sujeitas a erros da síntese de evidências, motivo pelo qual pesquisadores agora recorrem à AI para reunir métodos, amostras, resultados e limitações em tabelas comparáveis. O PRISMA 2020 pede que revisores relatem o que foi feito, como os estudos foram selecionados, o que foi encontrado e como o risco de viés foi avaliado. Esse padrão de relato pressupõe uma etapa estruturada de extração que a maioria das equipes ainda realiza manualmente.
O gargalo é o volume somado à heterogeneidade. Um estudante de pós-graduação pode precisar comparar dez artigos por desenho e n. Uma equipe de revisão sistemática pode precisar triar centenas de registros e depois extraí-los para formulários predeterminados. A orientação tradicional trata a extração de dados como a seleção e organização de características dos estudos a partir dos relatórios, o que parece simples até que cada artigo esconda o tamanho da amostra em uma nota de rodapé e as limitações em um único parágrafo defensivo.
A AI altera o custo da primeira passagem. Um estudo dentro de uma revisão de 2026 constatou que a extração assistida pelo Elicit não foi inferior em precisão à extração exclusivamente humana, foi cerca de 25 minutos mais rápida por extrator e menos dispendiosa em 50 RCTs. Comentários mais amplos sobre síntese de evidências agora estimam a redução de carga de trabalho com AI entre 50% e 75% nas etapas de revisão. Velocidade não é o mesmo que uma tabela citável. O problema de pesquisa em 2026 é extrair métodos, amostras, resultados e limitações de PDFs em um formato que outro revisor possa verificar.
O Que Torna um Fluxo de Extração com AI Confiável o Suficiente para Tabelas de Evidências?
Um fluxo de extração confiável com AI é aquele que retorna campos completos e comparáveis com proveniência no nível de citação ou página, mantendo o humano responsável pela inclusão e interpretação. Fluência não é o teste. Uma tabela de evidências é.
Usamos um padrão de quatro campos — chamado MSOL (Métodos, Amostra, Desfechos, Limitações) — e avaliamos as ferramentas em seis dimensões:
- Fidelidade ao esquema — o resultado mantém desenho, amostra, resultados e limitações em colunas distintas?
- Fundamentação — cada valor pode ser rastreado até uma frase, tabela, figura ou página?
- Inteligência sobre limitações — a ferramenta classifica fragilidades, como viés, generalização e relato, ou apenas repete a seção de Limitações dos autores?
- Alinhamento entre estudos — é possível comparar n, desenho e desfechos sem reformatar?
- Auditabilidade — a trilha resistiria à revisão de um segundo avaliador, de um orientador ou a um parágrafo de métodos PRISMA?
- Adequação ao corpus — a ferramenta foi criada para ensaios padronizados, métodos mistos ou reextração conversacional?
Esse mapeamento não é arbitrário. O PRISMA 2020 exige que revisores relatem métodos de avaliação de risco de viés, e o RoB 2 avalia randomização, desvios das intervenções pretendidas, dados de desfechos ausentes, mensuração e seleção do resultado relatado. Uma ferramenta que extrai valores de p, mas não consegue identificar viés de amostragem ou confundimento, está incompleta para trabalhos de revisão.
Daí decorrem duas regras práticas. Primeiro, as variáveis padronizadas, como rótulo do desenho, n e nomes dos braços, são onde a AI atual é mais forte; uma avaliação relacionada à Cochrane constatou desempenho alto e semelhante ao de revisores humanos na extração por AI, especialmente em variáveis padronizadas. Segundo, limitações e ressalvas qualitativas ainda exigem revisão humana. A orientação de síntese de evidências do King’s College London trata a AI como útil em múltiplas etapas, e não como substituta não supervisionada de revisores.
Quais Ferramentas de AI Produzem as Tabelas de Evidências Mais Úteis a Partir de Artigos Acadêmicos?
Elicit e Paperguide atualmente produzem as tabelas de evidências mais semelhantes a modelos prontos em escala, enquanto o Jenova's Academic Research Assistant é mais eficaz quando você precisa de campos personalizados, classificação de limitações e perguntas de acompanhamento em PDFs enviados. SciSpace e Consensus ajudam a encontrar artigos e a se orientar sobre eles; são secundários para a extração MSOL.
Comparações independentes em 2026 confirmam essa divisão. Avaliadores geralmente colocam o Elicit à frente para descoberta de literatura e extração de dados, e o Consensus à frente para perguntas científicas de sim/não. Comparações de recursos também consideram o Elicit mais forte para fluxos rigorosos de evidências e o SciSpace mais forte para descoberta exploratória e redação rápidas. Guias de bibliotecas universitárias agora listam ferramentas de literatura com AI como complementos para resumos, redes e extração, e não como substitutos completos da avaliação crítica.
| Recurso / dimensão | Elicit | Jenova's Academic Research Assistant | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| Extração de desenho do estudo e amostra | Forte; colunas personalizadas mais extração de tabelas e figuras | Forte em PDFs enviados por meio de esquemas MSOL orientados por prompt | Forte; colunas definidas pelo usuário em todos os artigos selecionados | Moderada; melhor para orientação por artigo do que para esquemas rígidos | Fraca como extrator principal; otimizado para respostas no nível de alegações |
| Extração de resultados | Forte, incluindo desfechos numéricos de tabelas | Forte quando PDFs são anexados e os campos são especificados | Forte, com links por célula para as fontes | Moderada; resumos úteis, menos voltado a tabelas | Moderada para achados principais, não para grades com múltiplos braços |
| Profundidade em limitações / risco de viés | Boa para campos relatados; menos classificatória e interpretativa | Forte para classificar viés versus generalização com referências de página | Boa quando você define colunas de limitação | Limitada; exploratória, não centrada primeiro na avaliação crítica | Limitada; não foi criado para tabelas estruturadas de fragilidades |
| Proveniência | Citações no nível de frase ou figura para alegações | Citações de página ou trechos em tabelas estruturadas quando solicitado | Cada valor extraído vinculado à sua declaração de fonte | Vinculação no nível do artigo, típica de ferramentas de busca e revisão | Respostas respaldadas por fontes, não tabelas de evidências no nível de célula |
| Triagem / fluxo de revisão | Criado para triagem de SLR, inclusive grandes conjuntos e auditoria no estilo PRISMA | Revisão conversacional de artigos selecionados; não é um triador de 40.000 registros | Revisão dupla e relato PRISMA no mesmo espaço de trabalho | Busca de literatura e Deep Review para exploração | Panorama rápido de consenso entre artigos |
| Preços, em 2026 | Plus cerca de $12/mês; Pro cerca de $49/mês; Enterprise personalizado | Camada gratuita com uso limitado; Plus $20/mês (30×); níveis superiores ampliam o uso | Espaço de trabalho por assento; preço público de tabela não verificado aqui | Camada paga inicial de cerca de $12/mês no plano anual, com planos superiores que incluem redação | Há planos Pro pagos; preço de tabela exato de 2026 não verificado aqui |
| Melhor para | Revisões sistemáticas orientadas por protocolo de relatórios de estudos relativamente padronizados | Tabelas personalizadas de quatro campos, avaliação de limitações e extração iterativa em um conjunto de artigos de trabalho | Extração auditável mais redação em uma única biblioteca | Mapeamento inicial, leitura e apoio à elaboração de manuscritos | Perguntas rápidas do tipo “o que a literatura diz?” |
Elicit
Elicit é o especialista em extração criado especificamente para essa finalidade neste conjunto. O produto busca, resume, extrai informações e conversa sobre um corpus que o Elicit declara ter mais de 125 milhões de artigos, além de relatar uso por mais de 2 milhões de pesquisadores. Seu fluxo de revisão sistemática enfatiza extração de tabelas e figuras, células apoiadas por citações, triagem em escala muito grande e relatórios com artefatos de métodos no estilo PRISMA.
Esse foco é uma força real para corpora semelhantes a RCTs. Também é uma limitação: você paga por uma máquina de revisão, e o trabalho interpretativo, como reclassificar limitações ou perguntar “o que eles deixaram de controlar?”, continua com o revisor. O preço do nível Pro é elevado para estudantes que precisam de tabelas apenas ocasionalmente.
Jenova's Academic Research Assistant
O Jenova's Academic Research Assistant foi criado como parceiro de pesquisa, e não como uma fábrica de triagem. Ele descobre literatura, apoia trabalhos com manuscritos e citações e, na plataforma Jenova, consegue ler PDFs anexados, manter memória persistente entre sessões e usar ferramentas de busca acadêmica. Você define as colunas MSOL em linguagem natural e então itera quando um artigo esconde n em um diagrama CONSORT ou dispersa limitações pela Discussão.
A limitação honesta é arquitetural. Ele não oferece uma fila de triagem por dupla de revisores para dezenas de milhares de registros e não publicou um estudo de precisão no estilo SWAR comparável ao do Elicit. A qualidade da extração depende do prompt, dos arquivos anexados e da verificação humana. Para um capítulo de tese com 12 artigos, essa flexibilidade é justamente o ponto. Para uma revisão PRISMA com 2.000 registros, os modos de revisão do Elicit ou do Paperguide são mais adequados.
Paperguide
Paperguide fica entre biblioteca, extrator e ferramenta de redação. Ele indexa mais de 200 milhões de artigos, permite definir colunas de extração, vincula cada valor à declaração de fonte e pode exportar tabelas para CSV ou Excel. Seu modo de revisão sistemática destaca revisão dupla, decisões finais humanas e diagramas PRISMA baseados em contagens reais.
Ponto forte: proveniência e um único espaço de trabalho, da biblioteca à tabela. Limitação: sua postura de conformidade ainda está em consolidação — a própria empresa sinaliza GDPR, SOC 2 e ISO 27001 como recursos futuros — e preços públicos estáveis são mais difíceis de confirmar do que os níveis amplamente divulgados do Elicit. Equipes que precisam de uma trilha de auditoria nominal em um único produto valorizarão mais esse espaço de trabalho do que a flexibilidade de chat.
SciSpace
SciSpace é um espaço de trabalho amplo para pesquisa: busca, leitura, redação e ferramentas de referências, com uma camada paga inicial mais barata que o Elicit Pro. As comparações o apresentam de forma consistente como melhor companheiro para exploração e redação, e não como o extrator mais rigoroso. Use-o para mapear um campo rapidamente. Não espere que seja o sistema de registro para colunas MSOL em uma revisão.
Consensus
Consensus é otimizado para uma pergunta diferente: em que a literatura concorda? Isso é valioso para uma orientação inicial e respostas no nível de alegações. É a ferramenta primária errada se sua entrega for uma tabela com desenhos, tamanhos de amostra, estimativas de efeito e limitações classificadas. Combine-o com um extrator, em vez de substituí-lo por um.
Com Que Precisão a AI Pode Extrair Desenho do Estudo e Características da Amostra?
As evidências atuais indicam que a AI pode igualar extratores humanos em muitos campos padronizados de métodos e amostra, embora ainda deixe de identificar ou interprete incorretamente relatos irregulares. A precisão é alta o bastante para uma primeira passagem. Não é alta o bastante para dispensar a verificação.
A comparação direta mais objetiva até agora é a SWAR de não inferioridade de 2026 em 50 RCTs de doenças crônicas: a precisão geral não diferiu entre a extração assistida pelo Elicit e a extração exclusivamente humana, enquanto o braço assistido por AI foi mais rápido e mais barato. Os resultados dos subgrupos não foram uniformemente idênticos; o braço assistido por AI foi mais preciso em alguns descritores de intervenção e controle. Os tipos de erros, como omissões e erros menores, pareceram semelhantes. Isso é um argumento para substituir um extrator humano por um extrator assistido por AI, não para uma extração sem supervisão.
Os números informados por fornecedores são mais altos e devem ser lidos como tal. O Elicit afirma que uma revisão alemã de política educacional extraiu corretamente 1.502 de 1.511 pontos de dados, ou 99,4%, e que comparações da CSIRO encontraram quase nenhum falso negativo em informações-chave. Testes independentes em bibliotecas também relataram extração por modelos de linguagem de grande porte com cerca de 96% de precisão em 160 elementos de dados quando PDFs foram fornecidos. Esses números são animadores para rótulos de desenho, n, braços e desfechos primários. Dizem pouco sobre se a ferramenta percebeu amostragem intencional ou fatores de confusão não controlados.
Na prática, o desenho do estudo e a amostra falham de formas previsíveis:
- O desenho é relatado como “randomizado” sem detalhes de alocação.
- n é o número triado, e não o número analisado.
- A população é um rótulo de clínica, e não os critérios de inclusão.
- O contexto, como rural, terciário ou somente por App, é omitido, o que depois compromete a generalização.
Uma boa passagem com AI sinaliza essas lacunas como células vazias. Uma passagem ruim inventa um nome de desenho organizado. Células vazias são mais científicas do que suposições fluentes.
Como as Ferramentas de AI Devem Lidar com Resultados Versus Limitações Declaradas pelos Autores?
Os resultados devem ser extraídos como desfechos relatados, com números e pontos temporais; as limitações devem ser reavaliadas, e não transcritas. Essa é a maior lacuna de qualidade entre as plataformas de pesquisa com AI.
A extração de resultados é a metade mais fácil. Os desfechos frequentemente estão em tabelas, e o Elicit divulga especificamente a extração de tabelas e figuras porque é onde se encontram muitos endpoints clínicos. O modelo do Paperguide — colunas personalizadas mais retorno por clique à frase de apoio — é o padrão correto de verificação para tamanhos de efeito, intervalos de confiança e contagens de respondentes. Se um resultado não pode ser apontado na fonte, ele não pertence à tabela de evidências.
A extração de limitações é uma tarefa diferente. Os autores subnotificam. Mencionam tamanho de amostra e ignoram confundimento. Mencionam “pesquisas futuras” e ignoram o método de amostragem. A avaliação de risco de viés deve ser específica para um resultado e classificada, por exemplo, como baixo risco, algumas preocupações ou alto risco no RoB 2. Copiar o parágrafo de Limitações não atende a esse padrão.
Um resultado mais útil se parece com uma tabela estruturada de fragilidades: artigo, categoria — viés, generalização ou relato —, a fragilidade em uma frase e uma página ou citação. Esse formato obriga o modelo a decidir que tipo de limitação encontrou.
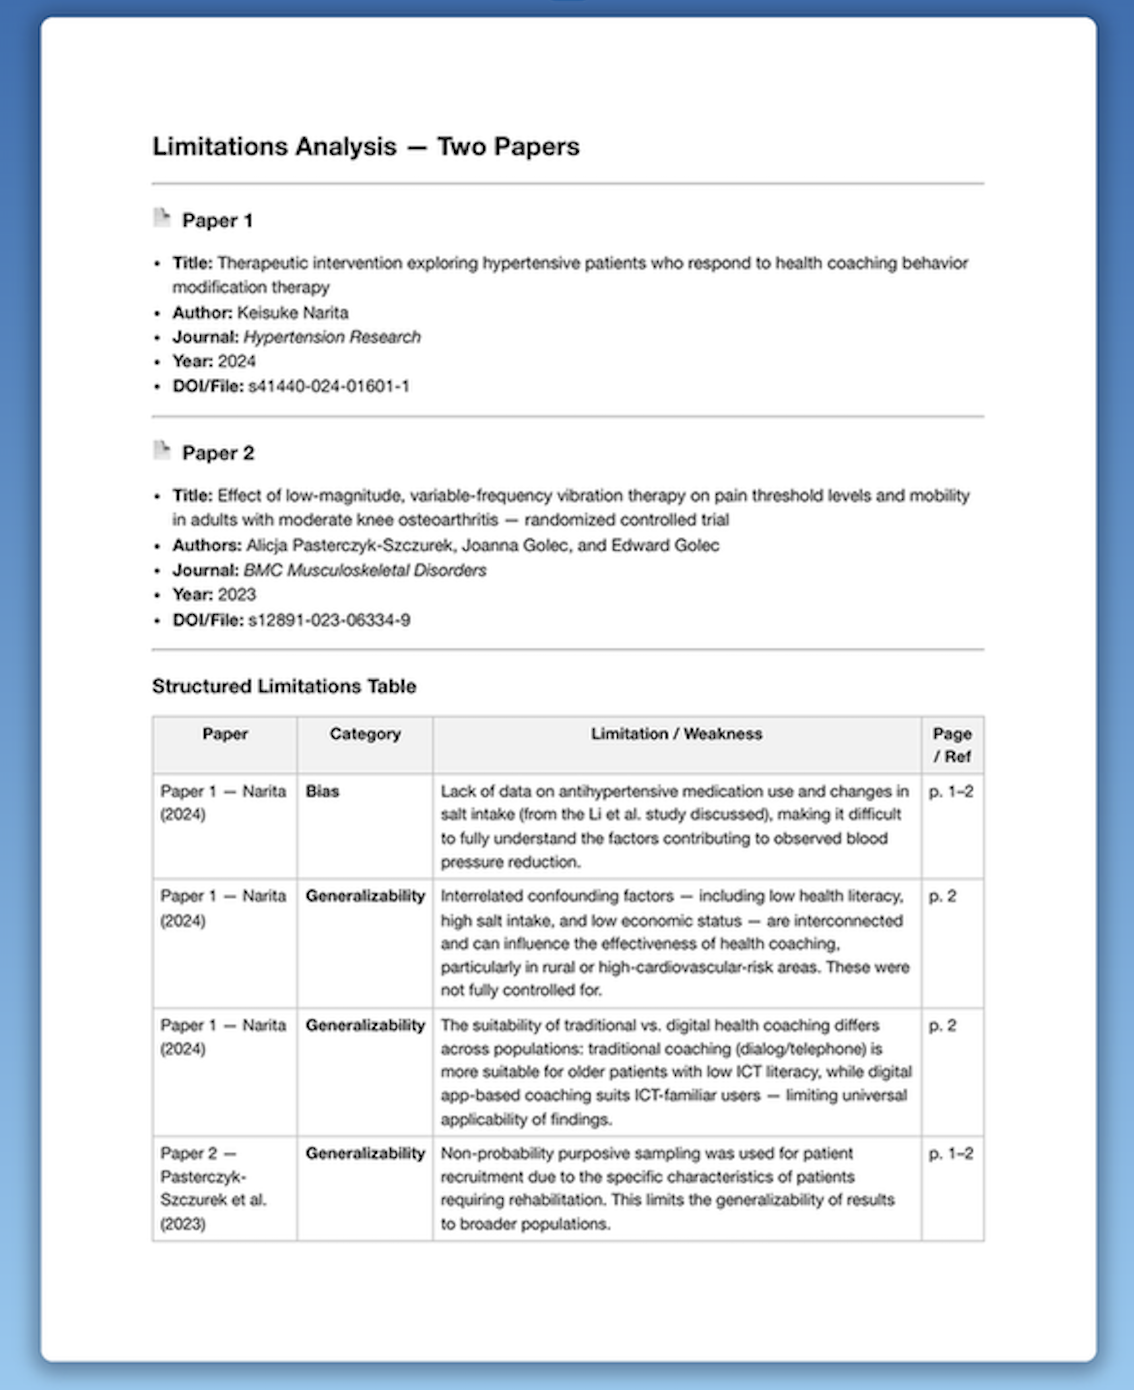
Examinar esse layout mostra por que um chat genérico não é suficiente. Um ensaio de acompanhamento para hipertensão pode reduzir a pressão arterial sem relatar o uso de anti-hipertensivos ou a ingestão de sal — um problema de viés. O mesmo artigo pode misturar letramento em saúde, dieta e renda, de modo que os achados não possam ser generalizados — um problema de generalização. Um ensaio de terapia por vibração pode usar amostragem intencional de pacientes de reabilitação — novamente generalização, e não simplesmente “os autores observaram uma amostra pequena”. Ferramentas que apenas resumem a Discussão deixarão de perceber essa taxonomia.
O Jenova's Academic Research Assistant é comparativamente forte nesse ponto porque você pode exigir a taxonomia no prompt e mantê-la estável em uma pilha de PDFs. Elicit e Paperguide capturarão campos de limitação se você adicionar colunas; eles não pensarão, por padrão, como um revisor de métodos. Consensus dirá se os estudos “mostram um efeito”. Ele não construirá essa tabela.
Como Executar uma Extração de Quatro Campos em uma Pilha de PDFs?
Comece com um esquema fixo, extraia cada artigo para os mesmos quatro campos e então verifique os números e reclassifique as limitações antes de sintetizar. O esquema importa mais do que a marca do chatbot.
Um esquema MSOL funcional é:
- Métodos: desenho, randomização/cegamento, quando houver, intervenção, comparador e acompanhamento.
- Amostra: n analisado, população, contexto e método de amostragem.
- Desfechos: resultado primário com estatística, ponto temporal e direção.
- Limitações: viés, generalização e relato — cada um com um localizador.
Para o Jenova's Academic Research Assistant, uma sequência típica é:
- Abra o Agente e anexe os PDFs, ou uma pasta de artigos que você pretende comparar.
- Fixe o esquema na primeira mensagem para que cada artigo subsequente use as mesmas colunas.
- Peça localizadores em cada célula:
“Crie uma tabela de evidências para estes artigos. Colunas: referência, desenho do estudo, amostra (n analisado, população, contexto, amostragem), resultados primários com tamanhos de efeito e pontos temporais, e limitações classificadas como Viés, Generalização ou Relato. Todas as células devem incluir uma página ou citação. Deixe uma célula em branco se o artigo não relatar a informação. Não parafraseie a seção Limitações dos autores sem reclassificá-la.”
- Verifique por amostragem n, desenho e qualquer tamanho de efeito em relação ao PDF. Corrija a tabela na conversa; a memória persistente mantém o esquema para o próximo lote.
- Se você precisar de um documento compartilhável, passe a tabela verificada para o Word Doc Generator, em vez de reformatá-la manualmente.
- Para uma narrativa que se apoie na tabela, o Deep Research é a melhor etapa seguinte, em vez de pedir ao extrator que se transforme em uma segunda revisão sistemática.
Para o Elicit, o caminho paralelo é: reúna artigos em uma visualização de revisão sistemática ou extração, aceite ou edite as colunas sugeridas, extraia com apoio de citações e então trate a AI como o segundo par de olhos. O próprio fluxo de revisão sistemática do Elicit é construído em torno de modelos editáveis, células apoiadas por citações ou figuras e concordância humana sobre critérios de triagem. Para o Paperguide, defina as colunas uma vez, extraia em todo o conjunto selecionado e exporte CSV/Excel quando a grade estiver estável.
Dois antipadrões devem ser evitados. Não extraia 40 artigos com 40 prompts ligeiramente diferentes. Não deixe o modelo preencher lacunas com “provável RCT” ou “amostra adequada”. Em branco é um achado.
O Que Especialistas em Síntese de Evidências Dizem Sobre a Extração de Dados com AI?
Metodologistas tratam cada vez mais a AI como um segundo extrator legítimo para campos padronizados, desde que cada valor permaneça inspecionável e a avaliação de limitações continue sendo liderada por humanos. O consenso emergente é restrito e prático, não utópico.
“A discussão sobre precisão está praticamente resolvida para as colunas fáceis — rótulo do desenho, n, nomes dos braços, desfecho primário conforme relatado. Comparações controladas agora mostram que a extração assistida por AI pode igualar extratores humanos nesses campos e terminar mais rápido. O modo de falha restante é interpretativo: modelos copiam as ressalvas dos autores e chamam isso de avaliação crítica. Isso não é avaliação de risco de viés, e o PRISMA ainda espera que você explique como o viés foi avaliado.”
“O que buscamos em uma plataforma não é um resumo mais bonito. É uma política de células vazias, um localizador em cada número e um esquema de limitações capaz de registrar confundimento, amostragem e validade externa mesmo quando o artigo nunca usa essas palavras. Se você não consegue clicar de um tamanho de amostra de volta para uma frase, não tem extração. Tem um rascunho.”
“Escolha a ferramenta que corresponde ao formato do corpus. Produtos dedicados de extração vencem em grandes conjuntos homogêneos de ensaios. Agentes de pesquisa conversacionais vencem quando os artigos são mistos, os PDFs são desorganizados e a pergunta científica é ‘o que não podemos concluir?’. A maioria dos projetos reais de pós-graduação e clínica pertence ao segundo tipo.”
— Jenova Product Team, design de fluxos de trabalho de pesquisa acadêmica, com experiência na criação de agentes de AI para revisão de literatura e tabelas de evidências
Essa visão é consistente com o registro externo: extração assistida não inferior em uma SWAR de 2026, alto desempenho em variáveis padronizadas em estudos no estilo de revisão por pares e orientações de bibliotecas que mantêm os humanos na decisão final.
Quando um Agente de Pesquisa Flexível É Mais Adequado do Que uma Plataforma de Extração Dedicada?
Um Agente de pesquisa flexível é mais adequado quando seu conjunto de artigos é pequeno ou médio, os desenhos são mistos e a habilidade escassa é interpretar limitações — não triar 10.000 títulos. Uma plataforma dedicada é mais adequada quando protocolo, revisão dupla e contagens PRISMA são o produto.
Escolha um extrator dedicado, Elicit ou Paperguide, quando:
- Você está conduzindo uma revisão sistemática ou de escopo com protocolo pré-registrado.
- A maioria dos estudos incluídos são ensaios ou outros relatórios altamente padronizados.
- Você precisa de registros de triagem, motivos de exclusão e um diagrama de fluxo.
- Vários revisores precisam resolver conflitos nos mesmos registros.
Escolha o Jenova's Academic Research Assistant quando:
- Você está escrevendo um capítulo de tese, fundamentação de projeto, journal club ou uma varredura rápida de evidências.
- Os artigos combinam RCTs, estudos observacionais e trabalhos qualitativos.
- Você se importa mais com limitações classificadas do que com colunas PICO sugeridas automaticamente.
- Você já trabalha com modelos, PDFs enviados e perguntas de acompanhamento em uma única conversa.
O uso híbrido é comum e racional. Mapeie a questão no SciSpace ou Consensus, extraia os campos MSOL no Jenova ou Elicit e mantenha o controle PRISMA no módulo de revisão que sua instituição aceitar. As comparações entre SciSpace e Consensus descrevem exatamente essa divisão de trabalho: Consensus para uma leitura rápida do grau de concordância e SciSpace para recuperação mais densa. Nenhuma dessas combinações elimina a verificação humana de n, desfechos e viés.
A limitação do Jenova nessa escolha é a escala e a formalidade. Ele não substituirá um pipeline corporativo de triagem. A limitação do Elicit é o inverso: grades excelentes, com menos suporte nativo ao trabalho argumentativo e desorganizado de explicar por que um achado não deve ser generalizado. Se sua entrega é uma tabela de evidências que um orientador possa auditar, avalie primeiro as ferramentas pela completude MSOL e pela proveniência, e só depois por marca ou preço mensal.
Referências
- PRISMA statement — orientação de relato para revisões sistemáticas
- DistillerSR — ferramentas e técnicas de extração de dados para revisões sistemáticas
- medRxiv — precisão e eficiência da extração de dados assistida por AI usando Elicit, SWAR de 2026
- Paperguide — ferramentas de AI para revisão sistemática e redução relatada de carga de trabalho
- The BMJ — declaração PRISMA 2020
- PubMed Central — explicação e detalhamento do PRISMA 2020, incluindo domínios do RoB 2
- Wiley / Cochrane Evidence Synthesis and Methods — ferramentas de AI como segundos revisores na extração de dados
- King’s College London — ferramentas de AI em síntese de evidências
- PapersFlow — comparação entre Elicit e Consensus AI
- Paperguide — comparação de recursos e preços entre Elicit e SciSpace, 2026
- George Mason University — ferramentas de AI para revisões de literatura
- Elicit — AI para pesquisa científica, corpus e números de uso
- Elicit — fluxo de revisão sistemática da literatura, alegações de precisão de extração e triagem
- SciSpace — comparação entre SciSpace e Elicit, incluindo níveis de preços de 2026
- Paperguide — documentação da plataforma para colunas de extração personalizadas e valores vinculados à fonte
- Himmelfarb Health Sciences Library — qualidade de relato e risco de viés
- Birmingham City University — observações sobre a precisão de extração de dados com AI
- Paperguide — comparação entre SciSpace e Consensus