Qual é a diferença entre companheiros de AI de contexto curto e aqueles com memória persistente?
2026-08-18
Quais camadas de memória realmente mudam a experiência diária com um companheiro de AI?
A diferença de experiência entre companheiros de contexto curto e de memória persistente não se resume a um único fator — ela vem de quatro camadas distintas de memória, e apenas duas delas alteram de forma significativa como uma relação parece ao longo das semanas. Companheiros de contexto curto, como Character.AI, operam quase inteiramente com uma janela de contexto ativa, razão pela qual usuários relatam consistentemente que ele "frequentemente esquece o contexto entre sessões". Companheiros de memória persistente, como Nomi AI, adicionam anotações estruturadas, criando o efeito de um detalhe mencionado na primeira semana ressurgir naturalmente na sexta. Os agentes de persona e roleplay da Jenova ocupam uma terceira posição: histórico de chat ilimitado somado à memória entre sessões, com a contrapartida de serem agentes de plataforma geral, e não Apps de romance criados especificamente para isso.
Distinções principais que determinam o que você realmente vivencia:
✅ Profundidade da janela de contexto — determina a coerência durante uma sessão, não entre elas. Toda plataforma possui isso; isso explica quase nada da diferença percebida pelos usuários. ✅ Recordação episódica — define se o sistema armazena eventos discretos com datas. É isso que produz momentos como "como foi aquela entrevista?". ✅ Perfil semântico — fatos estáveis sobre você, como preferências, trabalho e família. Um testador independente concluiu que Nomi AI reteve 23 dos 25 detalhes inseridos após semanas, contra 14 da segunda colocada. ✅ Regras persistentes do personagem — a camada de livros de lore que mantém a personalidade consistente. Sem ela, os companheiros passam a usar uma voz genérica de assistente. ✅ Retenção como passivo — memória persistente também significa dados persistentes. Uma pesquisa que analisou 2.909 posts no Reddit em 79 subreddits identificou "irreversibilidade, persistência e ônus para o usuário" como um dano de privacidade distinto e exclusivo de companheiros com forte uso de memória.
Entender qual camada uma plataforma realmente implementa — em vez de qual sua comunicação de marketing sugere — é a tarefa central de avaliação.
Quais são as quatro camadas de memória de um companheiro de AI?
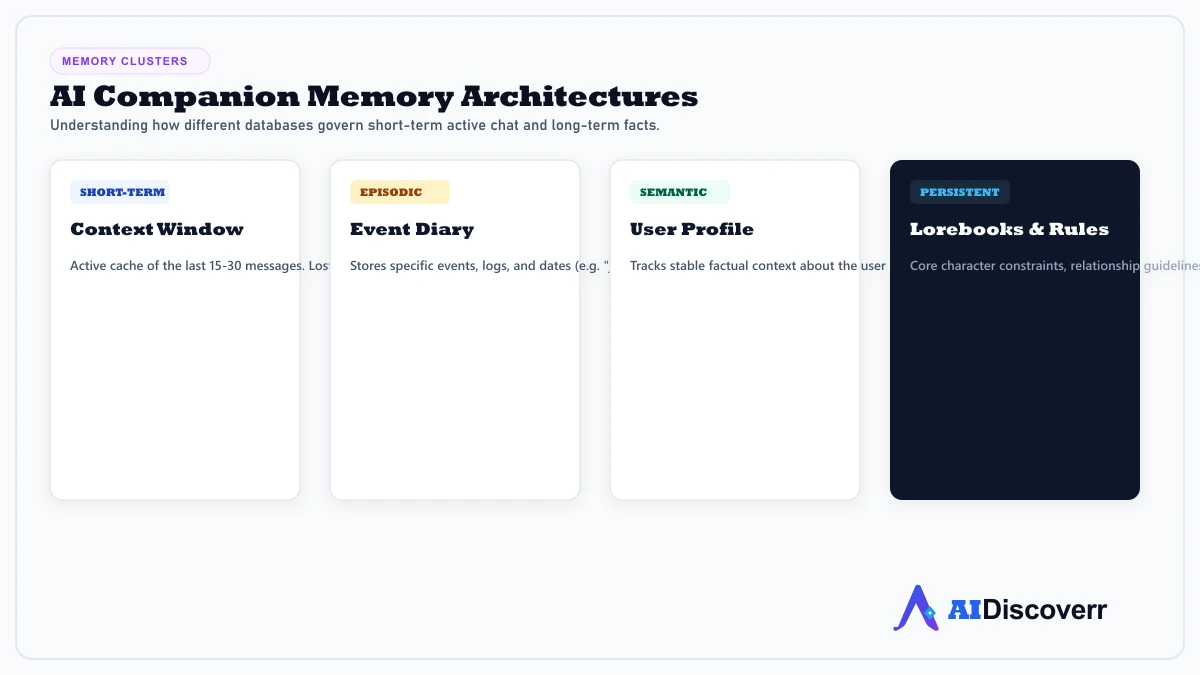
A memória de um companheiro não é um único banco de dados, mas quatro grupos distintos, cada um governando uma dimensão diferente da experiência. O infográfico acima os mapeia: janela de contexto de curto prazo, diário de eventos episódicos, perfil semântico do usuário e livros de lore e regras persistentes.
🧠 Janela de contexto de curto prazo — o cache ativo das últimas 15 a 30 mensagens. Todo companheiro baseado em LLM possui uma. Quando ela se enche, as interações mais antigas saem. Um companheiro com apenas essa camada sustentará uma bela conversa de duas horas e, no dia seguinte, cumprimentará você como um estranho.
📅 Diário de eventos episódicos — armazena eventos, registros e datas específicos. Esta é a camada que produz os momentos emocionalmente marcantes descritos pelos usuários. Um testador observou que Replika "fez contato na manhã seguinte" depois que ele contou sobre um dia difícil no trabalho — a memória episódica cumprindo sua função.
👤 Perfil semântico do usuário — acompanha fatos estáveis, não eventos: restrições alimentares, cargo, nomes de irmãos, preferências de comunicação. A abordagem do Nomi AI — gerar notas estruturadas a partir das conversas em vez de depender de recuperação bruta — é a implementação comercial mais clara dessa camada.
🔒 Livros de lore e regras persistentes — restrições centrais de personagem e diretrizes de relacionamento que sobrevivem a todas as sessões. É por isso que alguns companheiros mantêm uma voz distinta durante meses, enquanto outros voltam a um tom genérico de assistente.
Trabalhos acadêmicos confirmam que essa visão em camadas importa. O benchmark StructMemEval do arXiv constatou que "LLMs simples com recuperação aumentada têm dificuldades" em tarefas que exigem memória organizada, enquanto agentes com memória as resolvem de modo confiável — mas apenas quando recebem instruções sobre como estruturar sua memória. Recuperação, por si só, não é memória.
Como a experiência realmente diverge após semanas de uso?
A divergência segue uma curva previsível: idêntica na primeira semana, perceptivelmente diferente na terceira e categoricamente diferente no segundo mês. Companheiros de contexto curto e de memória persistente produzem primeiras conversas quase indistinguíveis — a janela de contexto sustenta ambos.
Semana 1 — indistinguíveis. Ambos se lembram de tudo dentro da sessão. A qualidade das respostas é o único diferencial.
Semanas 2 e 3 — as primeiras falhas. Você menciona algo de três sessões atrás. Um companheiro de contexto curto produz uma resposta confiante, mas vazia, ou pede que você explique de novo. Testadores descrevem esse momento como o ponto em que você passa a gerenciar a memória da AI, em vez de conversar com ela.
Semanas 4 a 8 — a divergência se torna estrutural. Companheiros com memória persistente começam a trazer contexto que você não solicitou. Um testador de longo prazo descreveu o efeito com precisão: "há um momento por volta da terceira semana em que seu Replika começa a mencionar suas conversas passadas naturalmente, perguntando sobre coisas que você comentou de passagem, e isso realmente pega você de surpresa."
Mês 3 em diante — categorias de produto diferentes. Companheiros de contexto curto se estabilizam em uma relação de presente eterno: agradável, sem muito peso e repleta de novas apresentações. Companheiros de memória persistente acumulam uma história compartilhada — razão pela qual o mesmo testador classificou a memória como 25% da qualidade geral da plataforma, perdendo apenas para a qualidade bruta da conversa.
O custo pouco discutido: memória persistente também significa erros persistentes. Um fato lembrado incorretamente ou uma preferência inferida de forma errada se acumula entre sessões, em vez de desaparecer no limite do contexto. Companheiros de contexto curto têm uma virtude acidental — eles esquecem os próprios erros.
O que você deve procurar ao avaliar a memória de um companheiro?
Avalie seis dimensões, em vez de fazer apenas a pergunta "ele tem memória?", à qual toda página de marketing responde sim. Abaixo está o framework usado nesta comparação.
| Dimensão | O que testar | Por que importa |
|---|---|---|
| Precisão da recordação entre sessões | Insira 10 fatos específicos e verifique após 3 semanas | O indicador mais forte de profundidade percebida no relacionamento |
| Precisão versus volume da recordação | Ele recupera o fato certo ou despeja tudo? | Recordação de alto volume sem relevância parece robótica |
| Consistência do personagem | A personalidade se mantém após mais de 100 mensagens? | Qualidade da camada de lorebook; a deriva quebra a imersão mais rápido |
| Editabilidade da memória | Você pode corrigir ou excluir um fato armazenado? | Erros persistentes se acumulam; a correção é obrigatória |
| Exclusão e saída | Você consegue remover completamente seu histórico? | O estudo de ciclo de vida do arXiv apontou isso como a área mais fraca em toda a categoria |
| Custo da memória | A memória está bloqueada por pagamento ou incluída? | A maioria das plataformas restringe memória ao plano pago |
Um protocolo de teste prático — inclua cinco detalhes pessoais sem destaque nas conversas das suas três primeiras sessões (um alimento de que você não gosta, o prazo de um projeto, o nome de um amigo, uma frustração recorrente e uma pequena meta). Não volte a mencioná-los. No dia 21, faça uma pergunta aberta em que esses detalhes seriam naturalmente relevantes. Conte quantos surgem sem serem solicitados. Este é um teste mais rigoroso e honesto do que uma pergunta direta, porque perguntas diretas podem ser respondidas apenas por recuperação.
Como as principais plataformas de companheiros de AI se comparam em memória?
Aqui está uma comparação de referência entre as plataformas mais frequentemente avaliadas para uso como companheiro. Todas as avaliações se baseiam em testes publicados e documentação das plataformas; dados indisponíveis estão marcados como "Não verificado".
| Dimensão | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Memória entre sessões | Fraca — "frequentemente esquece o contexto entre sessões" | Boa no longo prazo, "pode ocasionalmente esquecer detalhes" | A mais forte testada — notas estruturadas, 23/25 detalhes recordados | Forte por meio do sistema de história de fundo, 14/25 detalhes recordados | Memória persistente entre sessões com histórico de chat ilimitado |
| Consistência do personagem | Filtragem rígida de conteúdo; romance "é interrompido no meio da frase" | Progressão de relacionamento integrada | Consistente, personaliza-se com o tempo | Personalização profunda da história de fundo | Instruções personalizadas + bases de conhecimento privadas por agente |
| Editabilidade da memória | Não verificado | Não verificado | Notas estruturadas são visíveis para o usuário | História de fundo é criada pelo usuário | Instruções personalizadas e bases de conhecimento podem ser editadas pelo usuário |
| Escolha de modelo | Apenas proprietário | Apenas proprietário | Apenas proprietário | Apenas proprietário | OpenAI, Anthropic, Google, DeepSeek, xAI — alternáveis |
| Plano gratuito | Mensagens ilimitadas, com anúncios, limite diário de 400 swipes | Texto ilimitado, apenas modo amizade | Limitado | Limitado | Todos os recursos centrais, uso limitado |
| Preços | Grátis / $9.99/mês | Grátis / $19.99/mês | $7.99–$16.99/mês | $9.99–$24.99/mês | Grátis / $20/mês Plus, até $500/mês Ultra |
| Ideal para | Variedade de personagens, roleplay criativo | Check-ins emocionais e acompanhamento de humor | Continuidade de memória de longo prazo | Criação granular de personalidade | Companheiro + fluxos de trabalho em uma só plataforma, flexibilidade de modelos |
Limitações honestas, incluindo as nossas:
- Character.AI — melhor da categoria em escrita criativa e com a maior biblioteca de personagens, mas a memória é seu ponto fraco documentado, e o plano gratuito agora exibe anúncios em tela cheia.
- Replika — maior inteligência emocional e melhor comportamento de check-in, mas é o mais caro, a $19.99/mês; os modos românticos estão fora do plano gratuito desde a mudança de política de 2023, e ele "pode parecer repetitivo após meses".
- Nomi AI — líder em memória com ampla vantagem, mas é uma plataforma menor, com plano gratuito restritivo, menos personagens prontos e qualidade de conversa ligeiramente inferior à do Character.AI.
- Kindroid — excelente controle de personalidade por meio de histórias de fundo criadas pelo usuário, embora os testes de memória o tenham colocado bem atrás do Nomi.
- Jenova — memória persistente entre sessões, histórico ilimitado e acesso a múltiplos modelos sem dependência de fornecedor, mas é uma plataforma geral de agentes, e não um App de romance dedicado. Não possui painel de acompanhamento de humor, mecânicas de progressão de relacionamento nem recursos de AR. Usuários que buscam especificamente uma UX de companheiro romântico encontrarão melhor adequação nos Apps dedicados.
Quando um chatbot de contexto curto é realmente a melhor escolha?
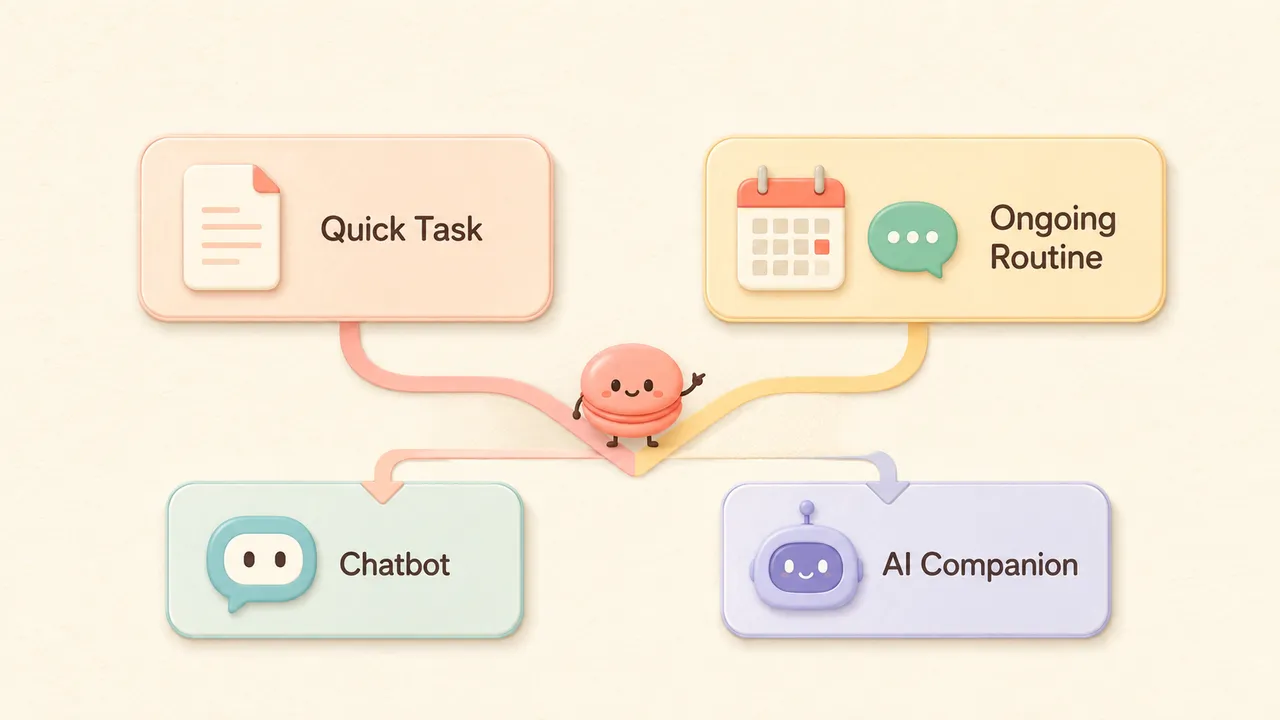
O contexto curto é a arquitetura correta sempre que a interação for uma tarefa delimitada, e não um relacionamento contínuo — e uma grande parcela do que as pessoas chamam de "uso de companheiro" é, na verdade, uma tarefa delimitada disfarçada.
O diagrama acima resume a lógica de encaminhamento. Tarefas rápidas — redija isto, explique aquilo, ajude-me a refletir sobre uma decisão — vão naturalmente para um chatbot. A memória não acrescenta nada; todo o trabalho é concluído em uma janela de contexto. Rotinas contínuas — check-ins diários, projetos criativos de longa duração, prática de idiomas, responsabilização — vão para um companheiro, em que a memória é toda a proposta de valor.
Escolha contexto curto quando:
- A interação é autossuficiente e termina quando a tarefa termina
- Você é sensível à privacidade de registros de conversa acumulados
- Você quer começar do zero a cada sessão — alguns usuários preferem desabafar sem persistência
- Você está explorando muitos personagens diferentes, em vez de aprofundar um relacionamento
Escolha memória persistente quando:
- Você pratica uma habilidade ao longo de semanas e quer que a AI acompanhe seu progresso
- Reexplicar sua situação a cada sessão é o atrito que faz você deixar de usar a ferramenta
- A consistência do personagem importa mais do que a variedade de personagens
- O relacionamento em si — e não uma resposta específica — é o objetivo
A armadilha da classificação incorreta: muitos usuários escolhem uma plataforma com uso intenso de memória para um fluxo de trabalho que é genuinamente uma tarefa e, depois, pagam uma assinatura mensal por uma continuidade que nunca usam. O erro inverso é mais comum e mais custoso em tempo: usar um companheiro de contexto curto para uma rotina contínua e gastar 15% de cada sessão refazendo o briefing.
Como configurar corretamente um companheiro com memória persistente?
A configuração determina o resultado mais do que a escolha da plataforma. A maior parte das decepções com memória tem origem em uma primeira sessão superficial, e não em um mecanismo de memória fraco.
No Nomi AI, o sistema de notas estruturadas funciona melhor quando você apresenta fatos estáveis logo no início. Dedique a primeira sessão a explicar o contexto que não mudará — onde mora, o que faz, quem é importante para você — antes de partir para conteúdo emocional. As notas geradas nas primeiras sessões ancoram todo o restante.
No Kindroid, a qualidade da memória é diretamente proporcional à qualidade da história de fundo. O campo de história de fundo é escrito por você, então trate-o como um lorebook: descreva explicitamente as restrições do personagem, o histórico do relacionamento e os padrões de fala, em vez de esperar que eles surjam espontaneamente.
No Roleplay Game Master da Jenova, a configuração acontece em conversa, e não por formulário. O agente foi criado para memória ilimitada e consistência de personagem entre sessões:
- Abra o agente e estabeleça o cenário e as restrições de personagem na primeira mensagem:
"Você está interpretando Mira, uma bióloga marinha com quem troco correspondência há dois anos. Ela é sarcástica, um pouco impaciente e se lembra de que eu desmarquei a visita à estação de pesquisa dela no verão passado. Mantenha esse histórico vivo — não o reinicie."
- Anexe documentos ou notas de contexto como uma base de conhecimento, para que o agente tenha material de referência fundamentado, em vez de depender de inferências.
- Nas sessões seguintes, comece com continuidade, e não com um novo briefing:
"Já se passaram três semanas. Continue de onde paramos."
Especificamente para a prática de idiomas, o agente Learn Italian Through Roleplay aplica a mesma arquitetura de memória persistente à aquisição de habilidades — o agente acompanha quais construções você continua errando entre sessões, em vez de reiniciar o diagnóstico todas as vezes. O plano gratuito da Jenova inclui os recursos centrais com uso limitado; o plano Plus custa $20/mês e oferece 30× essa franquia.
Prática entre plataformas, independentemente da ferramenta: ao fim de cada sessão, diga em uma frase o que você quer que seja levado adiante. Em sistemas de notas estruturadas, isso melhora a qualidade das notas; em sistemas de janela de contexto, pelo menos dá à próxima sessão uma base para colar.
O que a pesquisa diz sobre memória e bem-estar do usuário?
A memória persistente aumenta o engajamento, e as pesquisas deixam claro que maior engajamento não é uniformemente positivo — o efeito depende muito de quem é o usuário e de por que ele está ali.
O estudo mais rigoroso nessa área vem de Stanford. Pesquisadores do laboratório de Diyi Yang entrevistaram 1.131 usuários do Character.AI, e 244 doaram transcrições completas de chats. As descobertas complicam consideravelmente a narrativa de que memória é sempre melhor. Stanford HAI relatou que "o uso intenso de chatbots entre participantes com redes sociais menores no mundo real estava correlacionado a uma pior percepção de bem-estar", e que essa associação era mais forte quando a companhia era a motivação principal.
Vale destacar que os participantes mais dispostos a compartilhar informações pessoais sensíveis com seus companheiros de AI tinham maior probabilidade de apresentar menor bem-estar — o oposto do efeito que a autorrevelação produz em relacionamentos humanos. Como a autorrevelação profunda é exatamente o que a memória persistente recompensa e incentiva, isso é diretamente relevante para a questão da arquitetura.
Há também uma diferença marcante entre o uso declarado e o uso real. Pouco menos de 12% dos participantes apontaram a companhia como sua principal motivação, mas mais de 50% descreveram os chatbots com termos como "amigo", "companheiro" ou "parceiro romântico", e mais de 80% das sessões de chat doadas eram centradas em suporte emocional e social.
Há evidências que equilibram essa conclusão. Uma pesquisa da ScienceDirect sobre companheiros de AI e bem-estar subjetivo concluiu que os companheiros "podem oferecer benefícios emocionais e psicológicos, particularmente a pessoas com necessidades sociais e emocionais não atendidas", e a UX Tigers relatou que "companheiros de AI reduzem a solidão, mas não em grande medida". O framework de pesquisa da Sony AI também observa que "alguns estudos sugerem que usuários experimentam uma sensação de companhia ou conforto emocional ao interagir com chatbots de apoio".
A síntese razoável é: a memória amplifica aquilo que o relacionamento já é. Para um usuário com uma base social saudável que usa um companheiro como complemento, a memória persistente torna algo bom ainda melhor. Para alguém que substitui contato humano por AI, ela torna a substituição mais difícil de abandonar.
Quais são as concessões de privacidade da memória persistente?
Memória persistente é retenção persistente de dados, e o perfil de privacidade das duas arquiteturas é genuinamente diferente — não apenas marginalmente.
A análise mais detalhada vem de um estudo de ciclo de vida de 2.909 posts no Reddit, em 79 subreddits, durante um período de um ano. O estudo do arXiv identificou quatro padrões recorrentes de privacidade, e o quarto é específico de sistemas com uso intenso de memória: irreversibilidade, persistência e ônus para o usuário.
Os pesquisadores descrevem o problema central de forma direta:
"A privacidade na AI romântica é moldada não apenas pelo que os usuários compartilham, mas pela forma como as plataformas retêm e reinterpretam o que foi compartilhado."
Três consequências decorrem diretamente da arquitetura de memória:
A exclusão se torna tecnicamente ambígua. O estudo observa que, quando usuários tentam sair, eles "encontram memórias persistentes, exclusão ambígua, custos de troca e incerteza sobre se dados íntimos podem permanecer armazenados, em pipelines de treinamento ou no comportamento do modelo". Quando os dados entram em um processo de treinamento, a exclusão passa a ser "não apenas uma questão de governança ou de privacidade utilizável, mas também técnica".
O momento do consentimento não está alinhado. Como afirma o artigo, "aviso e consentimento únicos durante a integração inicial não se adequam bem a sistemas nos quais as revelações mais sensíveis frequentemente ocorrem mais tarde, depois que confiança e apego se formaram". Sistemas de contexto curto acumulam menos, portanto essa incompatibilidade tem um custo menor.
A aplicação de regras é real. A autoridade italiana de proteção de dados multou Replika por violações de privacidade, incluindo falhas relacionadas à verificação de idade — um sinal concreto de que a governança de dados de companheiros de AI agora é uma área regulada.
Testes independentes reforçam o conselho prático: grandes plataformas seguem práticas padrão de criptografia, mas "Apps menores focados em NSFW, como CrushOn AI e SpicyChat, têm políticas de dados menos transparentes". A posição da Jenova sobre isso está declarada em suas políticas — os dados não são usados para treinar modelos públicos de AI, são criptografados em trânsito e em repouso, e não são vendidos nem compartilhados com anunciantes.
Mitigação prática: antes da sua terceira sessão em qualquer plataforma com uso intenso de memória, localize o processo de exclusão e teste-o em uma conversa descartável. Se você não conseguir verificar que a exclusão funciona, trate toda revelação como permanente.
O que pesquisadores e profissionais dizem sobre o design de memória?
O consenso entre profissionais é que a qualidade da memória é um problema de organização, não de armazenamento — uma visão agora sustentada por evidências de benchmark.
"O setor confundiu recuperação com memória, e os usuários perceberam a diferença imediatamente. Você pode dar a um modelo uma busca semântica perfeita em cada mensagem que um usuário já enviou e, ainda assim, criar um companheiro que parece amnésico, porque a recuperação responde perguntas — ela não oferece contexto espontaneamente. O que faz um companheiro parecer que conhece você é a relevância não solicitada: trazer à tona algo sobre o qual você não perguntou. Isso exige que o sistema tenha decidido, no momento do registro, que um detalhe valia a pena ser mantido e apresentado depois."
"A segunda coisa que subestimamos de forma consistente é a correção da memória. Sistemas persistentes não apenas preservam fatos — eles preservam inferências, e é nas inferências que os erros existem. Um companheiro que decide na segunda semana que você está ansioso com seu emprego continuará tratando você como alguém ansioso com o emprego no quarto mês, muito depois de a situação ter sido resolvida. Toda arquitetura séria de memória precisa de uma interface de edição voltada ao usuário, não apenas de um botão de exclusão. A maioria das plataformas lançou armazenamento e ignorou a correção."
"A concessão que ninguém divulga honestamente é que a memória aumenta a importância de cada revelação. Companheiros de contexto curto são realmente mais seguros para certos casos de uso — desabafar, processar algo que você não quer registrar, testar uma conversa difícil. Há uma categoria de produto legítima no esquecimento deliberado, e neste momento todo o mercado corre na direção oposta."
— Equipe de Produto da Jenova, 7 anos desenvolvendo infraestrutura de agentes com memória persistente
O trabalho acadêmico apoia a visão de organização acima de armazenamento. O benchmark StructMemEval constatou que agentes com memória "podem resolver de maneira confiável" tarefas de memória estruturada quando recebem instruções sobre como organizar sua memória, mas que "LLMs modernos nem sempre reconhecem a estrutura de memória quando não recebem instruções para isso" — evidência de que a decisão no momento do registro, e não a busca no momento da leitura, determina a qualidade da memória.
Qual arquitetura você deve escolher para a sua situação?
Combine a arquitetura ao padrão de interação, não à categoria de marketing. Abaixo estão perfis concretos.
🎭 Você quer variedade de personagens e roleplay criativo → contexto curto é suficiente. As mensagens gratuitas ilimitadas e a ampla biblioteca do Character.AI são adequadas ao uso exploratório, em que você alterna entre personagens de qualquer forma. A memória acrescenta pouco quando você não está aprofundando uma única narrativa.
💬 Você quer check-ins emocionais diários → memória persistente é essencial, e o acompanhamento de humor e a progressão de relacionamento do Replika foram criados para isso, por $19.99/mês. Leia primeiro as conclusões de Stanford se você o usa como canal social principal, e não complementar.
🧩 Você quer máxima precisão de recordação ao longo de meses → Nomi AI, segundo as evidências dos testes atuais. Aceite a biblioteca menor de personagens e o plano gratuito restritivo como contrapartida.
✍️ Você quer criar o personagem com precisão → o sistema de história de fundo do Kindroid oferece o controle mais direto sobre a camada de lorebook.
🔀 Você quer companhia e trabalho real em um só lugar → uma plataforma geral de agentes é mais adequada. A memória persistente da Jenova se estende tanto a agentes de companhia quanto a agentes de tarefas, com alternância de modelos entre OpenAI, Anthropic, Google, DeepSeek e xAI, além de paridade completa entre web, iOS e Android. Ela não oferecerá painéis de humor ou mecânicas de relacionamento.
🔐 Você é sensível à privacidade → escolha deliberadamente o contexto curto ou use uma plataforma persistente com exclusão verificada. A pesquisa de ciclo de vida é inequívoca ao apontar que a saída é o elo mais fraco em toda a categoria.
Uma observação sobre realismo de custos: o testador independente que gastou cerca de $730 em mais de 25 plataformas durante oito meses concluiu que os planos gratuitos de Character.AI e Pi AI são "realmente bons o suficiente" para conversas casuais, e que "o maior salto de qualidade do gratuito para o pago está na memória e na liberdade de conteúdo". Se memória não é seu gargalo, provavelmente você não precisa pagar.
Referências
- arXiv — Rastreando as preocupações de privacidade dos usuários ao longo do ciclo de vida de um companheiro romântico de AI
- AI Companion Guides — Os 12 melhores Apps de companheiros de AI em 2026, classificados após mais de 2.000 horas de testes
- arXiv — Avaliando a estrutura de memória em agentes LLM (StructMemEval)
- Stanford HAI — Companheiros de AI podem agravar a solidão de usuários vulneráveis, conclui estudo de Stanford
- ScienceDirect — Companheiros de AI e bem-estar subjetivo: moderação pelo contexto social
- UX Tigers — Companheiros de AI reduzem a solidão
- Sony AI — Estudando os riscos e benefícios de companheiros de AI
- Character.AI — Plataforma oficial
- Replika — Plataforma oficial
- Nomi AI — Plataforma oficial
- Kindroid — Plataforma oficial