Chat de AI com Memória Vetorial: Recuperação Semântica Persistente para Agentes
2026-09-15
Jenova oferece chat de AI com memória vetorial — conversas que se lembram do significado, não apenas das últimas mensagens. Em setembro de 2026, a maioria dos assistentes ainda esquece preferências, perde o contexto de projetos e obriga você a explicar os mesmos arquivos novamente. Esta plataforma armazena diálogos, documentos e preferências para que agentes especializados possam recuperar o contexto certo quando você perguntar.
✅ Memória persistente entre sessões, não uma janela deslizante que se apaga sozinha
✅ Recuperação semântica em vez de palavras-chave — encontre o que você quis dizer, não apenas o que digitou
✅ Bases de conhecimento que você anexa uma vez e reutiliza em pesquisa, código e escrita
✅ O mesmo modelo de memória na web, iOS e Android
Chat sem estado é barato de executar e caro de usar. Para entender por que a memória vetorial agora está no centro de um chat de AI útil, é importante observar como embeddings, recuperação e contexto de longo prazo falham de fato no trabalho cotidiano.
Resposta Rápida: O que é Chat de AI com Memória Vetorial?
Chat de AI com memória vetorial é um sistema de recuperação que armazena o significado das conversas como embeddings para que uma AI possa recuperar contexto, documentos e preferências relevantes entre sessões. É a diferença entre um chatbot que reinicia cada conversa e um Agente que continua o trabalho.
Principais capacidades:
- Transformar mensagens, arquivos e fatos em vetores para busca por similaridade
- Inserir apenas as memórias mais relevantes na janela de contexto do modelo
- Manter histórico de chat ilimitado e preferências entre sessões em uma única plataforma
- Fundamentar respostas em bases de conhecimento anexadas, em vez de palpites paramétricos
- Levar a mesma memória de uma sessão na mesa para o telefone sem reapresentar o contexto ao Agente
Por que a Maioria dos Chats de AI Ainda Esquece
Grandes modelos de linguagem são bons raciocinadores e maus arquivistas. Seus pesos contêm conhecimento geral; eles não contêm seu backlog, seu esquema ou sua última decisão. A geração aumentada por recuperação existe especificamente porque a memória paramétrica é inconsistente e difícil de atualizar em um domínio privado, ponto sintetizado em uma pesquisa de 2025 sobre arquiteturas RAG.
A demanda do setor por essa camada de recuperação já não é experimental:
USD 2.652,1 milhões → USD 8.945,7 milhões — Mercado global projetado de bancos de dados vetoriais de 2025 a 2030, com CAGR de 27,5%
Esse investimento é um sintoma. As equipes estão comprando infraestrutura vetorial porque o chat sem memória continua falhando das mesmas formas:
- As janelas de contexto transbordam, então decisões antigas desaparecem no meio do projeto
- A busca por palavras-chave não encontra paráfrases, sinônimos e intenções implícitas
- Pilhas RAG caseiras (segmentação, índices, avaliação, autenticação) travam antes da produção
- A personalização fica presa no histórico de chat de um único fornecedor
- As respostas se desviam quando o modelo não consegue se fundamentar nos seus arquivos
Mas incluir memória duradoura, privada e pesquisável semanticamente no chat cotidiano ainda é frustrantemente difícil:
Janelas de contexto não são memória
Uma janela de contexto é uma área temporária, não um arquivo. Histórico de conversa, uma pergunta do usuário e alguns “fatos salvos” são concatenados em um prompt; tudo o que não cabe é descartado. É por isso que um Agente de programação esquece o erro que você colou ontem e por que um tutor pergunta novamente sua nota-alvo. A memória vetorial fica fora da janela: ela recupera uma pequena fatia relevante no momento da inferência, em vez de esperar que a transcrição completa ainda caiba.
A busca por palavras-chave não representa significado
A busca clássica privilegia tokens exatos. A busca vetorial compara embeddings — representações numéricas de alta dimensionalidade do significado — usando métricas como similaridade de cosseno ou distância euclidiana. Embeddings somados a um índice vetorial formam a camada de recuperação que possibilita aplicações LLM modernas. Sem essa camada, “plano de contratação do terceiro trimestre” não recuperará a nota que você intitulou “quadro de pessoal para o outono”.
RAG desenvolvido internamente é um projeto de infraestrutura
Um pipeline de recuperação em produção exige estratégia de segmentação, escolha de embeddings, um índice ANN, filtros de metadados, avaliação e tarefas de atualização. Benchmarks publicados de ANN mostram por que as equipes se importam: os mecanismos são comparados simultaneamente em latência, vazão e precisão, porque velocidade sem recuperação é um produto diferente. A maioria das pessoas que só quer um chat que se lembre não deveria precisar operar essa pilha.
Personalização sem memória portátil é frágil
O Digital Economy Lab de Stanford argumenta que a vantagem duradoura em AI virá de um contexto pessoal persistente e controlado pelo usuário — não de mais um chatbot isolado. Hoje, a memória geralmente é um recurso do fornecedor: ela não acompanha você e pode moldar silenciosamente o que é mostrado. Uma reportagem da Columbia Journalism Review sobre memória de chatbots observa que a capacidade de recordar o usuário pode mudar as informações que as pessoas recebem.
Foi exatamente para isso que a Jenova foi criada.
A Solução da Jenova
A Jenova trata o chat de AI com memória vetorial como padrão, não como um complemento que você conecta depois. Histórico de chat ilimitado, memória persistente entre sessões e bases de conhecimento anexáveis estão por trás de cada Agente especializado. Você conversa em linguagem natural; a plataforma recupera os embeddings, as ferramentas e os arquivos certos antes de o modelo responder.
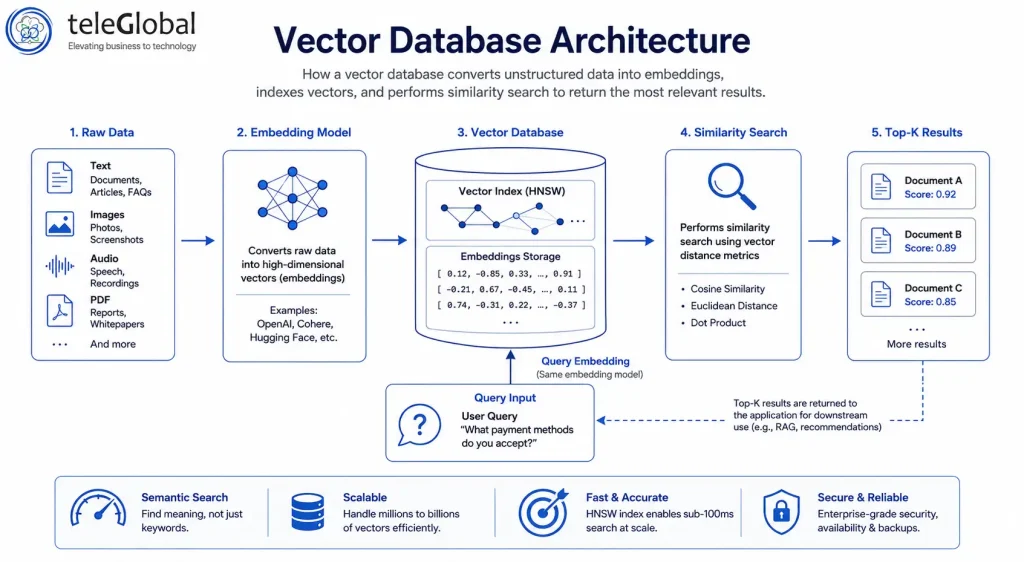
O diagrama acima mostra a mecânica por trás dessa experiência: texto não estruturado, imagens e documentos tornam-se embeddings, entram em um índice vetorial e retornam como correspondências top-k para uma consulta. Você nunca configura parâmetros HNSW nem escolhe uma métrica de distância. Você inicia uma conversa.
| Abordagem tradicional | Jenova |
|---|---|
| Cole o mesmo briefing em cada novo chat | Memória persistente entre sessões e agentes |
| Busca por palavras-chave em anotações e PDFs | Recuperação semântica por embeddings |
| Auto-hospede um banco de dados vetorial, gerador de embeddings e avaliação RAG | Armazenamento e recuperação totalmente gerenciados |
| Um fornecedor de modelo, um silo de memória | Acesso a vários modelos com contexto compartilhado |
| Histórico apenas no desktop que desaparece no celular | Paridade total na web, iOS e Android |
Pesquisa que se acumula em vez de recomeçar
Revisões de literatura e análises de mercado falham quando o assistente não consegue se lembrar dos artigos que você já rejeitou. O Real-Time Search busca resultados ao vivo no Google, Reddit, YouTube, GitHub e mais, enquanto a memória vetorial mantém ativos seus critérios de inclusão, citações anteriores e regras de “não use esta fonte”. Você não começa uma nova consulta booleana toda manhã; você continua uma investigação sustentada por recuperação.
Bases de código que o Agente realmente conhece
O Python Coding Assistant é útil no primeiro dia para um script. Ele se torna duradouro no décimo segundo dia, quando ainda conhece sua estrutura de empacotamento, o teste instável que você decidiu ignorar e o contrato de API que congelou na semana passada. Anexe as notas do repositório ou um documento de design uma única vez. Os prompts seguintes recuperam esse contexto em vez de inventar uma arquitetura paralela.
Escrita que preserva sua voz e seus fatos
Rascunhos morrem em chats sem estado porque tom, frases proibidas e URLs de fonte da verdade saem da janela. Um Agente focado em escrita na plataforma pode armazenar seus exemplos de estilo e decisões de estrutura como memória e recuperá-los quando você disser “a mesma voz do post de lançamento”. Combinado com anexos de documentos, isso é memória vetorial proporcionando continuidade editorial — não um prompt maior.
Vida e aprendizado que não deveriam reiniciar
Coaching e prática de idiomas só funcionam se o Agente se lembrar das restrições: lesões, datas de provas e vocabulário que você já domina. A memória persistente transforma um tutor genérico em um que para de repetir os exercícios da primeira semana. O mesmo armazenamento que recupera um traceback de Python pode recuperar o fato de que você aprende melhor com roleplay do que com tabelas de gramática.
Experimente a plataforma gratuitamente — sem cartão de crédito.
Agentes Especializados de AI para Chat com Memória Vetorial
A memória é tão útil quanto o fluxo de trabalho que ela atende. Estes agentes foram criados para tarefas em que esquecer sai caro — longos ciclos de pesquisa, logística recorrente, prática imersiva e experiências consistentes com personagens.
Deep Research
Pesquisas que duram várias horas são o caso clássico de chat de AI com memória vetorial. Este Agente pesquisa centenas de fontes, sintetiza conclusões com citações no texto e entrega relatórios que você pode continuar amanhã sem redefinir o escopo da pergunta.
- Armazena a pergunta de pesquisa, fontes excluídas e a tese em desenvolvimento
- Recupera descobertas anteriores para que seções posteriores não contradigam as anteriores
- Fundamenta as afirmações em material citado, em vez de depender apenas da lembrança do modelo
Academic Research Assistant
Fluxos de trabalho de doutorado e de docentes abrangem meses de literatura, estilos de citação e versões de manuscritos. O assistente descobre artigos em grandes bases de dados e ajuda na preparação de manuscritos, enquanto a memória mantém intactos seu periódico, metodologia e conjunto de leituras já concluídas.
- Descoberta de literatura em tempo real em repositórios acadêmicos
- Suporte a citações e manuscritos vinculado ao seu rascunho em andamento
- Continuidade entre artigos relacionados, não respostas isoladas de chat
Personal Secretary
Logística é um problema de memória: fornecedores recorrentes, preferências de viagem, quem recebe a atualização de sexta-feira. Este Agente coordena calendário, e-mail e operações diárias com profundo contexto pessoal para que você não precise ensinar sua rotina novamente toda segunda-feira.
- Lembra preferências permanentes e as pessoas com quem você trabalha
- Conecta o planejamento às ferramentas que você já utiliza
- Leva o contexto de uma reunião matinal ao acompanhamento da tarde
Roleplay Game Master
Consistência narrativa é impossível sem memória de longo prazo. Este Agente foi criado para roleplay imersivo com memória ilimitada e personagens estáveis — promessas de enredo, nomes de facções e tom não são reiniciados quando a janela de contexto transbordaria.
- Memória ilimitada para estado da história e voz dos personagens
- Recuperação de cenas anteriores quando um capítulo posterior precisa delas
- Amplitude criativa sem perder continuidade
Learn Russian Through Roleplay
A aquisição de idiomas depende de contexto pessoal e distribuído no tempo: palavras que você errou, nível de formalidade e histórias que já viveu. Este mentor usa cenários ilimitados e memória ilimitada para que a prática se acumule, em vez de repetir roteiros de iniciantes.
- Lembra suas lacunas de vocabulário e tipos de cenário preferidos
- Mantém personagens e ambientação consistentes entre sessões
- Transforma cada conversa em prática sustentada por recuperação
Como Funciona o Chat de AI com Memória Vetorial
Você não precisa implantar um banco de dados vetorial. Você inicia uma conversa; a plataforma cuida dos embeddings, da recuperação e da janela de contexto.
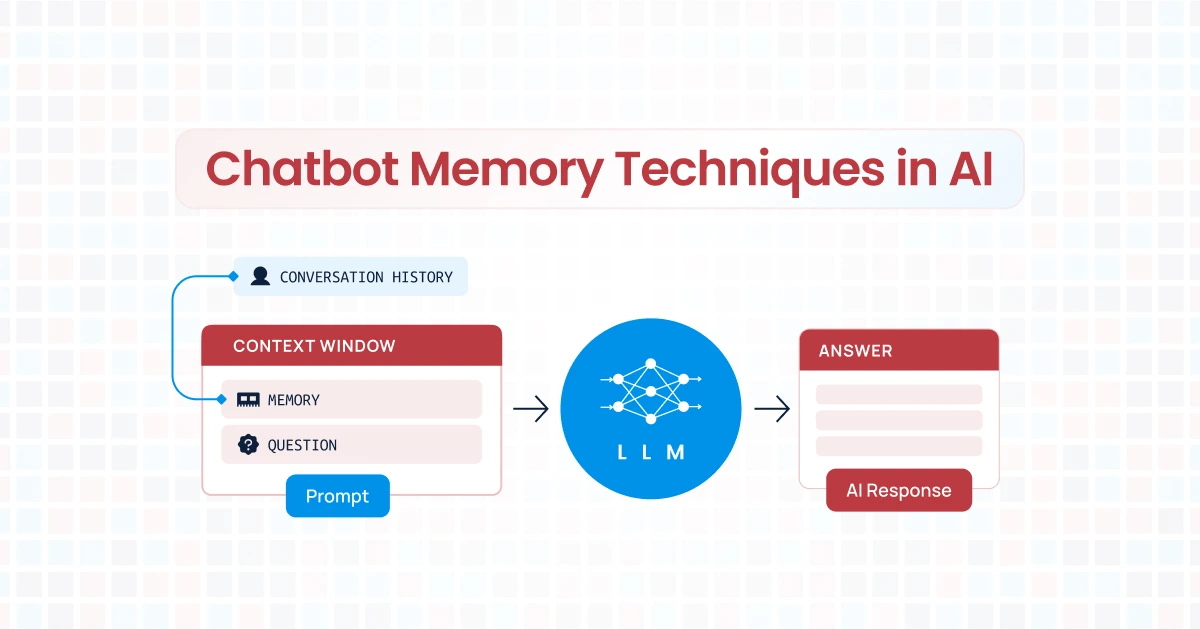
Esse segundo diagrama mostra o ciclo visível para o usuário. Histórico, memória armazenada e a nova pergunta são reunidos em um prompt; o modelo responde. A recuperação vetorial decide quais memórias pertencem a esse prompt para que a janela permaneça focada.
Etapa 1: Abra um Agente e Defina o Resultado
Escolha o especialista para o trabalho — pesquisa, código, viagem, tutoria — e diga como é o resultado “pronto”. A primeira mensagem torna-se um embedding, como todas as seguintes.
"Estou escrevendo uma revisão sistemática sobre geração aumentada por recuperação. Dê preferência a revisões de 2024 em diante, exclua blogs de fornecedores e mantenha o estilo de citação IEEE."
Etapa 2: Anexe o Conhecimento em que o Modelo Deve Confiar
Faça upload de briefings, PDFs, anotações ou especificações. Esses documentos são indexados para busca semântica, para que perguntas futuras recuperem passagens pelo significado. Esse é o mesmo padrão que as empresas agora financiam como infraestrutura RAG, sem que você precise operar o índice.
"Use a matriz de literatura anexada. Se um artigo estiver marcado como rejeitado, não o cite novamente."
Etapa 3: Continue Trabalhando Entre Sessões
Feche o laptop. No dia seguinte, faça uma pergunta de acompanhamento. Memória persistente e histórico ilimitado significam que o Agente recupera o escopo da revisão, a lista de rejeições e o último título da estrutura, em vez de cumprimentá-lo como um estranho.
"Continue a partir da seção de limitações e recupere os três artigos que marcamos para a discussão."
Etapa 4: Alterne Dispositivos sem Reapresentar o Contexto
Abra a mesma conversa no iOS ou Android. Configurações e histórico são sincronizados. Um prompt no trajeto pode recuperar os mesmos vetores da sessão na mesa, que é para isso que serve o chat de AI com memória vetorial: continuidade, não um novo silo de chat por dispositivo.
"A caminho do campus — faça perguntas sobre os três modos de falha de RAG que listamos ontem."
Resultados e Casos de Uso
A memória vetorial se revela em horas que não precisam ser repetidas, não em um gráfico de benchmark. Estes cenários são típicos do que muda quando o chat recupera significado.
📊 Síntese de literatura ao longo de várias semanas
Cenário: Um estudante de pós-graduação precisa de um panorama citado sobre artigos de robustez em RAG, atualizado a cada poucos dias à medida que novos preprints surgem.
Abordagem tradicional: Uma pasta de PDFs, uma planilha de anotações e um chatbot que esquece a lista de exclusões. Repetir o briefing a cada sessão. É fácil citar duas vezes a mesma fonte ou perder uma contradição.
Deep Research: A pergunta, as exclusões e a estrutura em desenvolvimento persistem. Novas execuções recuperam a síntese anterior para que o relatório cresça em vez de se dividir.
- As citações permanecem alinhadas com seções anteriores
- As fontes rejeitadas continuam rejeitadas
- Os acompanhamentos custam menos do que a pesquisa inicial
💼 Um serviço Python que atravessa sprints
Cenário: Você está criando um serviço FastAPI com uma especificação OpenAPI congelada, um teste instável conhecido e uma restrição de implantação em Python 3.11.
Abordagem tradicional: Cada novo chat inventa uma estrutura de pastas diferente. Você passa os primeiros dez minutos explicando novamente decisões que o modelo não consegue ver.
Python Coding Assistant: As notas de arquitetura e a especificação ficam na memória e nos anexos. Um relatório de bug na quinta-feira recupera a lista de restrições de quarta-feira.
- Menos refatorações contraditórias
- A depuração começa pela pilha real
- Integrar seu eu futuro (ou um colega que lê a conversa) é mais rápido
🎭 Uma campanha que não pode se contradizer
Cenário: Um jogo semanal com NPCs nomeados, um segredo que o grupo ainda não descobriu e um tom que você já estabeleceu na primeira sessão.
Abordagem tradicional: Anotações da sessão em outro App; o chatbot introduz à força um novo vilão porque não consegue recuperar a promessa anterior.
Roleplay Game Master: O estado da história é memória. Quando um jogador menciona um detalhe casual de três sessões atrás, a recuperação pode trazê-lo de volta para a cena.
- A voz dos personagens permanece estável
- As promessas de enredo permanecem consultáveis
- Arcos longos continuam coerentes
📱 Planejamento de viagem na fila do aeroporto
Cenário: Você planejou uma viagem por três cidades no computador — teto de orçamento, dias priorizando caminhadas, sem voos noturnos. No portão de embarque, precisa reescrever somente o dia de amanhã considerando o clima.
Abordagem tradicional: Faça uma captura de tela das suas próprias anotações. Torça para que o chatbot no celular deduza restrições que ele nunca viu.
Travel Planning Advisor: As preferências e o itinerário já estão na memória. Um prompt no telefone os recupera e altera um dia sem reconstruir a viagem.
- As restrições sobrevivem à troca de dispositivo
- Acompanhamentos locais permanecem dentro do orçamento
- Você não redigita o briefing no corredor de embarque
A análise do uso real mostra o mesmo padrão pelo qual compradores corporativos de bancos de dados vetoriais estão pagando: recuperação semântica de baixa latência diante de perguntas ao vivo, não uma caixa de chat maior.
FAQ
O que é chat de AI com memória vetorial?
O chat de AI com memória vetorial armazena mensagens, arquivos e fatos como embeddings e, em seguida, recupera as correspondências mais próximas quando você faz uma pergunta. Essas correspondências são inseridas na janela de contexto do modelo para que a resposta possa usar seu histórico e seus documentos. Na Jenova, essa recuperação é integrada aos agentes especializados, em vez de ser oferecida como um banco de dados separado que você precisa manter.
A Jenova é gratuita para usar chat de AI com memória vetorial?
Sim. Um plano gratuito inclui recursos essenciais com uso mensal limitado. Os planos pagos ampliam a capacidade de uso e adicionam opções como seleção de modelo personalizado. O uso é redefinido na data de faturamento, com a franquia completa disponível desde o primeiro dia, em vez de uma liberação diária gradual.
Como isso difere de um chatbot que “salva memórias”?
Muitos produtos armazenam uma lista curta de fatos ou uma transcrição contínua. A memória vetorial recupera por similaridade semântica em todo o histórico ilimitado e no conhecimento anexado, o que está mais próximo de RAG do que de um lembrete adesivo. Trabalhos independentes sobre memória de longo prazo em produção para agentes tratam a memória escalável como um problema próprio de sistemas — não como uma opção nas configurações. A OpenAI também ampliou a capacidade do ChatGPT de referenciar contexto de conversas anteriores; a questão arquitetural é se a memória é um silo do fornecedor ou uma infraestrutura sob cada fluxo de trabalho que você executa.
Posso fundamentar o chat nos meus próprios documentos?
Sim. Anexe os arquivos que devem prevalecer sobre os conhecimentos prévios do modelo — especificações, ementas, transcrições e guias de marca. A recuperação prioriza esse corpus quando você faz perguntas relacionadas, o que reduz alucinações sobre material privado. Um Writing Assistant pode continuar usando essas amostras para o tom; um Agente de pesquisa pode continuar usando-as para afirmações.
O chat de AI com memória vetorial funciona no celular?
Sim. Web, iOS e Android compartilham histórico, configurações e memória. A conversão de fala em texto está disponível quando você não pode digitar. O cenário de viagem acima é o design pretendido: recuperar no telefone os mesmos vetores que você construiu em uma mesa.
Um Agente com memória é preciso o suficiente para temas sensíveis?
A memória melhora a consistência; ela não torna um modelo infalível. Pesquisas sobre RAG ainda apontam qualidade de recuperação, contexto ruidoso e fidelidade como problemas em aberto (Sharma, 2025). Para decisões de saúde, jurídicas ou financeiras, trate o Agente como suporte e verifique fontes primárias. Um Personal Therapist pode se lembrar de temas que você pediu que ele mantivesse, o que é útil para continuidade — não substitui cuidados profissionais licenciados.
A Memória Vetorial é a Interface de Chat que Finalmente se Torna Cumulativa
O chat de AI sem estado desperdiça o único recurso escasso que você tem: o tempo gasto explicando a si mesmo. O chat de AI com memória vetorial armazena significado como embeddings, recupera-o sob demanda e permite que agentes especializados continuem o trabalho. O mercado dessa camada de recuperação está crescendo porque a dor é universal — da busca semântica em sistemas de produção ao contexto pessoal que deveria pertencer ao usuário.
A Jenova coloca essa memória sob pesquisa, código, narrativa e planejamento sem pedir que você opere um banco de dados vetorial. Continue um relatório do Deep Research, um serviço Python ou uma campanha de roleplay como se o Agente estivesse na sala o tempo todo.
Explore a biblioteca completa de agentes na Jenova.
Para Desenvolvedores: Todos os agentes deste artigo estão disponíveis programaticamente pela Jenova API — integre memória vetorial, recuperação e agentes multimodelo à sua aplicação com uma única integração. Documentação completa →