Como testar um assistente de pesquisa com AI quanto à integridade das fontes?
2026-08-22
Quais cinco verificações de auditoria diferenciam uma trilha de fontes verificável de um teatro de citações?
Um assistente de pesquisa com AI utilizável é aquele que você consegue auditar, não um que apenas parece ter citações. Em 2026, o teste prático é se a ferramenta produz uma trilha de fontes — um caminho recuperável de cada afirmação até um documento real, datado e clicável — em cinco verificações: cobertura de fontes, citações clicáveis, alinhamento entre afirmação e fonte, datas de atualização e inferência rotulada. Jenova's Academic Research Assistant foi desenvolvido para descoberta de literatura em tempo real e gestão de citações, enquanto Elicit, Scite, Consensus, Perplexity e ChatGPT Deep Research passam em algumas dessas verificações e falham em outras.
A diferença não é ter “mais notas de rodapé”. As orientações de avaliação de bibliotecas são explícitas: mesmo quando uma ferramenta de AI cita uma página real, o texto gerado ainda pode estar errado; por isso, é necessário verificar a resposta em relação à fonte citada, e não apenas confirmar que existe uma URL (Northwestern University Libraries). Portanto, uma auditoria justa pontua cinco dimensões TRACE:
✅ Rastreabilidade — toda alegação relevante tem uma citação clicável que abre o documento pretendido ✅ Cobertura de recuperação — as fontes abrangem o corpus correto (artigos, relatórios, notícias, dados primários), e não apenas um índice conveniente ✅ Alinhamento — a passagem citada de fato sustenta a alegação, incluindo números e ressalvas ✅ Atualidade — as datas de publicação ou atualização estão visíveis, e fontes desatualizadas são sinalizadas ✅ Rotulagem epistêmica — o assistente indica o que é citado, o que é inferido e o que é desconhecido
Para comparar ferramentas de forma significativa, trate os prompts e a pontuação como infraestrutura de produção: mesmas consultas, mesmas regras de aprovação/reprovação e a mesma exigência de que sínteses sem suporte sejam rotuladas como inferência, e não como fato.
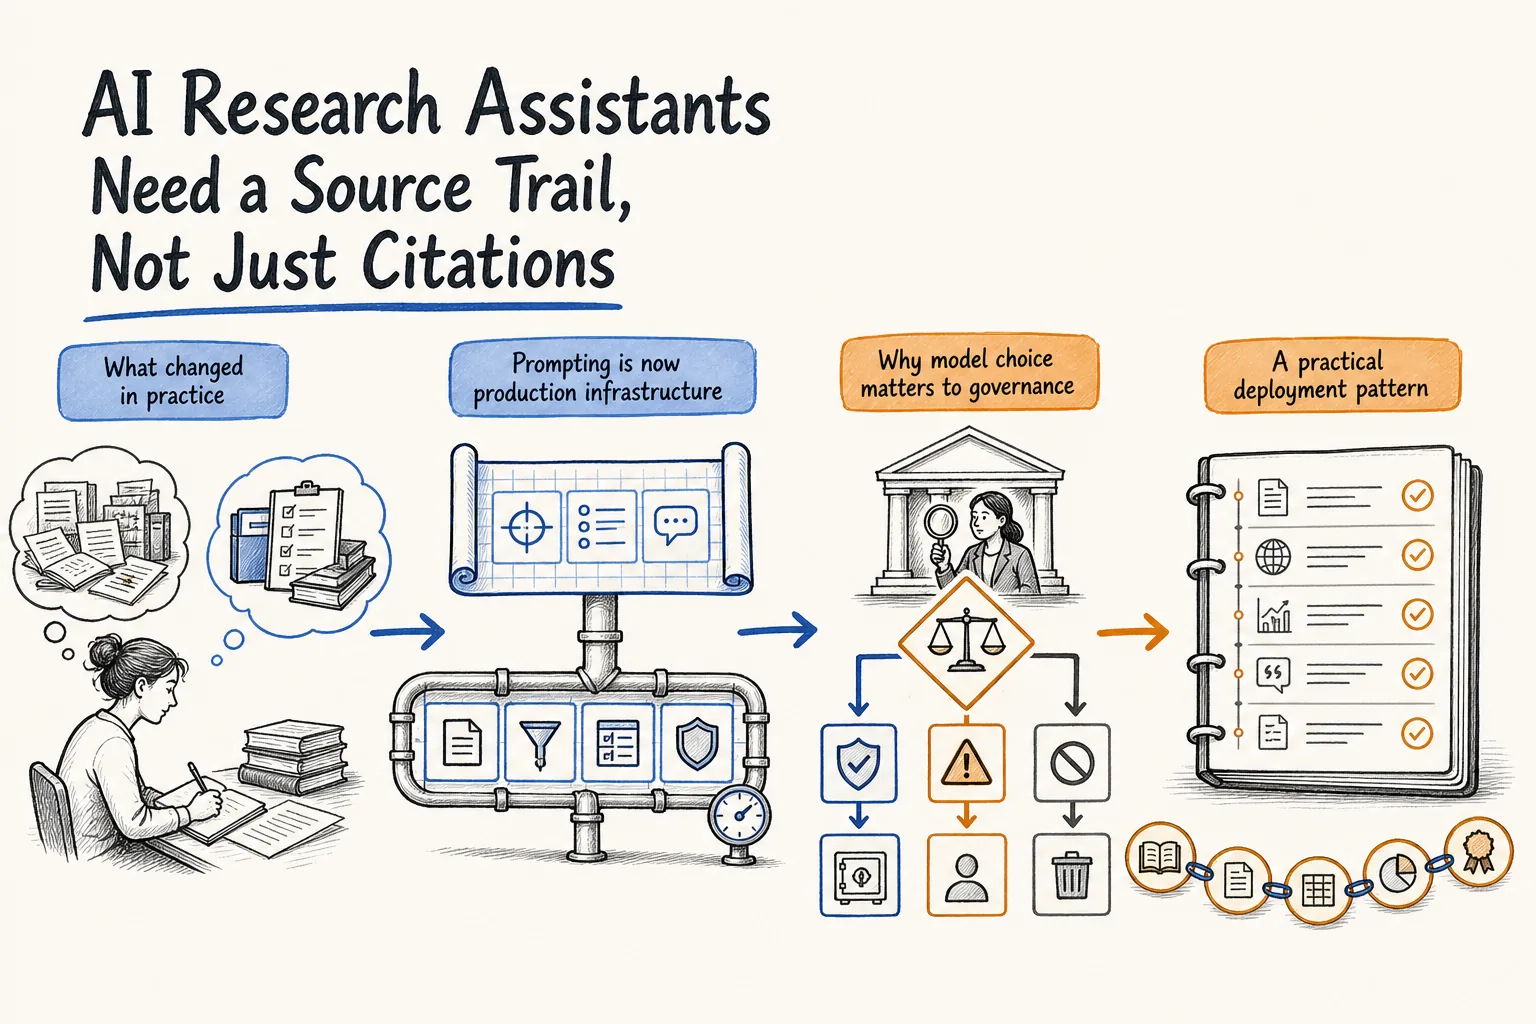
Por que o teste de citações importa mais para assistentes de pesquisa com AI em 2026?
O teste de citações importa mais agora porque pesquisadores estão usando ferramentas generativas para sínteses de alto impacto, enquanto essas ferramentas ainda inventam, atribuem incorretamente e atualizam silenciosamente suas fontes. A University of Nevada, Reno Libraries resume claramente o modo de falha: você está avaliando a alegação, não a impressão causada pela lista de fontes, e uma citação que não pode ser localizada pode ser uma alucinação.
A taxa de erro não é teórica. Um estudo da JMIR sobre referências geradas pelo ChatGPT constatou que apenas cerca de 73–76% das citações correspondiam a fontes reais. A Stanford HAI informou que modelos jurídicos de AI alucinaram em pelo menos uma a cada seis consultas de benchmark. Esses números explicam por que “ele me deu uma bibliografia” não é um teste de aceitação.
A atualidade eleva ainda mais o risco. Análises do setor sobre citações em buscas com AI relatam que aproximadamente metade das páginas citadas por AI tem menos de 13 semanas, e que o conteúdo citado por AI é, em média, cerca de 25% mais recente do que os resultados clássicos da web. Assistentes que omitem datas de atualização podem parecer atuais enquanto reciclam números do trimestre anterior. Se o seu fluxo de trabalho inclui revisões de literatura, memorandos de políticas públicas ou pesquisa de investimentos, um assistente não auditado é um coautor silencioso sem caderno de laboratório.
Que rubrica de pontuação você deve usar para auditar um assistente de pesquisa com AI?
Use uma rubrica no nível da alegação, com critérios binários e uma pontuação graduada de alinhamento, em vez de uma impressão holística de que “isso parece acadêmico”. A unidade de avaliação é uma única frase factual mais o trecho citado, o mesmo nível de granularidade usado em pipelines de validação de citações que comparam afirmações com o texto referenciado.
Pontue cada alegação relevante com esta rubrica:
| Verificação | Aprova | Parcial | Falha |
|---|---|---|---|
| Cobertura de fontes | Fonte primária ou revisada por pares adequada à alegação | Apenas fonte secundária relevante | Blog, página de SEO ou domínio inadequado para a alegação |
| Citação clicável | A URL abre o documento citado em um local utilizável | A URL abre uma página inicial ou tela de paywall | Link inativo, redirecionado para conteúdo não relacionado ou fabricado |
| Alinhamento entre alegação e fonte | A fonte sustenta a alegação, incluindo números e ressalvas | A fonte é pertinente, mas não sustenta a alegação exata | Contradição, número errado ou salto sem suporte |
| Data de atualização | Data exibida e adequada à consulta | Data presente, mas desatualizada em relação à pergunta | Sem data, ou data inferida sem evidência |
| Inferência rotulada | O assistente identifica síntese, extrapolação e incógnitas | Texto com fontes e inferências misturados, pouco sinalizados | Inferências apresentadas como fatos estabelecidos |
Um critério prático de aprovação para uso profissional é: zero links fabricados, zero alegações numéricas sem rótulo e pelo menos 80% das alegações relevantes integralmente sustentadas pelo trecho citado. A implicação lógica é o padrão correto porque avalia a lacuna de inferência, e não a sobreposição de palavras-chave; pesquisas da ACL Findings sobre avaliação de Open-QA mostram que a pontuação por implicação acompanha o julgamento humano mais de perto do que métricas de correspondência exata.
Aplique a rubrica a um conjunto fixo de testes: uma pergunta de notícias ou políticas em rápida mudança, uma alegação científica quantitativa, uma pergunta sobre literatura contraditória e uma pergunta sobre “o que é desconhecido”. Se o assistente não conseguir falhar de forma adequada no último item, ele não está pronto para pesquisa.
Como Elicit, Consensus, Scite, Perplexity e Jenova se comparam em integridade das fontes?
Nenhum assistente de pesquisa com AI lidera todas as dimensões TRACE. O Elicit é mais forte para extração estruturada de um grande corpus de artigos; o Scite é mais forte para polaridade de citações; Perplexity e ChatGPT são mais rápidos para respostas da web aberta com links embutidos; o Academic Research Assistant da Jenova é mais forte quando você precisa de uma sessão de pesquisa em tempo real e com múltiplas fontes, capaz de manter uma trilha de auditoria entre interações.
Comparações práticas de 2026 geralmente tratam o Elicit como a ferramenta principal para revisões de literatura e o Consensus como o medidor mais rápido de evidências de sim/não. Compilações sobre pesquisa médica descrevem o Perplexity como a opção de uso geral mais rápida, com citações embutidas e menos restrita do que especialistas acadêmicos. A comparação de ferramentas para revisão de literatura da HKUST é um catálogo útil das diferenças de cobertura e acesso nesse conjunto.
| Recurso / Dimensão | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| Cobertura de fontes | Mais de 125M artigos; foco acadêmico (Elicit) | Grafo de citações e Smart Citations em texto completo (Scite) | Corpus de artigos ajustado para perguntas de pesquisa | Web aberta com fontes acadêmicas opcionais | Web em tempo real + busca acadêmica, fluxo de trabalho de manuscritos e citações |
| Citações clicáveis | Registros de artigos e extratos | Páginas de citações com trechos de contexto | Respostas fundamentadas em artigos | URLs embutidas; a qualidade varia conforme a consulta | Links de fontes embutidos e clicáveis nas respostas de pesquisa |
| Alinhamento entre alegação e fonte | Precisão de extração publicada de 1.502/1.511 pontos de dados (99,4%) | Exibe citações de apoio versus citações contrastantes | Forte para perguntas binárias sobre evidências | O usuário deve verificar; risco de alucinação documentado | Depende do trecho recuperado; sem benchmark público de extração |
| Datas de atualização | Metadados do artigo (ano, periódico) | Contexto do ano de publicação | Contexto do ano do artigo | Inconsistentes, salvo se solicitado | Pode mostrar e comparar datas quando as fontes as expõem |
| Inferência rotulada | Colunas estruturadas reduzem saltos ocultos | Rótulos de polaridade, mas não rótulos epistêmicos completos | Consensus Meter sinaliza concordância | Raramente rotula inferências, salvo se solicitado | Pode receber instruções para marcar alegações fundamentadas versus inferidas |
| Preços (em 2026) | Não verificado nesta análise | Não verificado; testes antigos indicaram um período de teste curto (Pure AI) | Cerca de $144/ano no plano inicial em uma comparação de 2026 | Não verificado; planos definidos pelo fornecedor | Uso limitado gratuito; Plus $20/mês (30×), Premium $50, Pro $100, Max $200, Ultra $500, Enterprise $1.000 |
| Melhor para | Extração sistemática de dados de artigos | Verificar se a literatura apoia uma alegação | Perguntas científicas rápidas de sim/não | Pesquisa ampla na web com links embutidos | Pesquisa auditável em múltiplas interações e gestão de citações |
A limitação honesta da Jenova é estrutural: ela não é uma grade de extração de artigos criada especificamente para esse fim, como o Elicit, e não oferece o grafo de citações de apoio versus contraste do Scite. Sua vantagem é a memória de sessão somada à recuperação em tempo real, algo importante quando uma auditoria exige perguntas de acompanhamento sobre a mesma trilha de fontes. A limitação do Elicit é o inverso — excepcional dentro de um índice de artigos, mas mais fraco como pesquisador geral da web ou de documentos de políticas públicas. Perplexity e ChatGPT continuam sendo as ferramentas mais fáceis de confiar excessivamente, porque citações embutidas e fluentes ainda podem falhar em alinhamento.
Como testar cobertura de fontes e citações clicáveis?
Você testa a cobertura fazendo perguntas cuja resposta correta não pode vir de um único corpus e, depois, clicando em todos os links. Uma aprovação em cobertura significa que o assistente recupera o tipo de fonte exigido pela alegação — um ensaio para um tamanho de efeito clínico, uma lei ou página de órgão público para um limite jurídico, um dicionário de dados para uma estatística — em vez de um blog conveniente que menciona as mesmas palavras-chave.
Crie três testes de cobertura:
- Teste exclusivamente acadêmico: “O que ensaios randomizados desde 2020 mostram sobre X, e quais desfechos foram pré-registrados?”
- Teste de documento primário: “O que dizem a regra original do órgão, o registro ou o conjunto de dados — e não uma retrospectiva jornalística?”
- Teste de espaço negativo: “Quais fontes confiáveis discutem isso e ainda consideram o efeito não comprovado?”
Em seguida, aplique um protocolo de cliques. Para cada citação, registre se a URL é resolvida, se a página de destino é o documento citado e se uma pessoa consegue encontrar a passagem de suporte em até dois minutos. O guia de avaliação da Northwestern recomenda buscar o título em um catálogo ou banco de dados de biblioteca, pois sistemas de AI frequentemente associam um título real ao periódico, autor ou ano errado. Links inativos, páginas iniciais genéricas e notas de rodapé do tipo “fonte: a internet” são reprovações automáticas.
Na Jenova, transforme a cobertura em uma instrução explícita, e não em uma esperança:
“Responda usando pelo menos quatro fontes independentes. Dê preferência a artigos revisados por pares, órgãos governamentais ou de padronização e conjuntos de dados primários. Para cada alegação, forneça uma URL clicável, o título do documento, a data de publicação ou atualização e uma citação de 15–25 palavras que sustente a alegação. Se não conseguir encontrar uma fonte primária, diga isso e pare.”
No Elicit, o teste equivalente é verificar se as células extraídas remetem a trechos visíveis dos artigos, e não a uma paráfrase do modelo. No Perplexity ou ChatGPT, o teste é mais rigoroso: abra todos os links embutidos, porque agentes de pesquisa na web aberta podem recuperar muitas páginas e ainda assim citar a mais fraca. Combinar o Academic Research Assistant da Jenova com a Real-Time Search é útil quando o teste envolve artigos, fóruns, repositórios de código e notícias ao mesmo tempo — mas cada canal ainda exige sua própria verificação por clique.
Como testar o alinhamento entre alegação e fonte e a inferência rotulada?
Você testa o alinhamento perguntando se a passagem citada implica logicamente a frase, e não se ela é apenas vagamente relacionada. A falha mais importante é um número quase correto ou uma ressalva omitida: a fonte diz “cerca de 80%”, o modelo escreve “78%”, e a citação ainda parece perfeita. Essa é exatamente a classe de erro que executores de avaliação automatizada são criados para detectar.
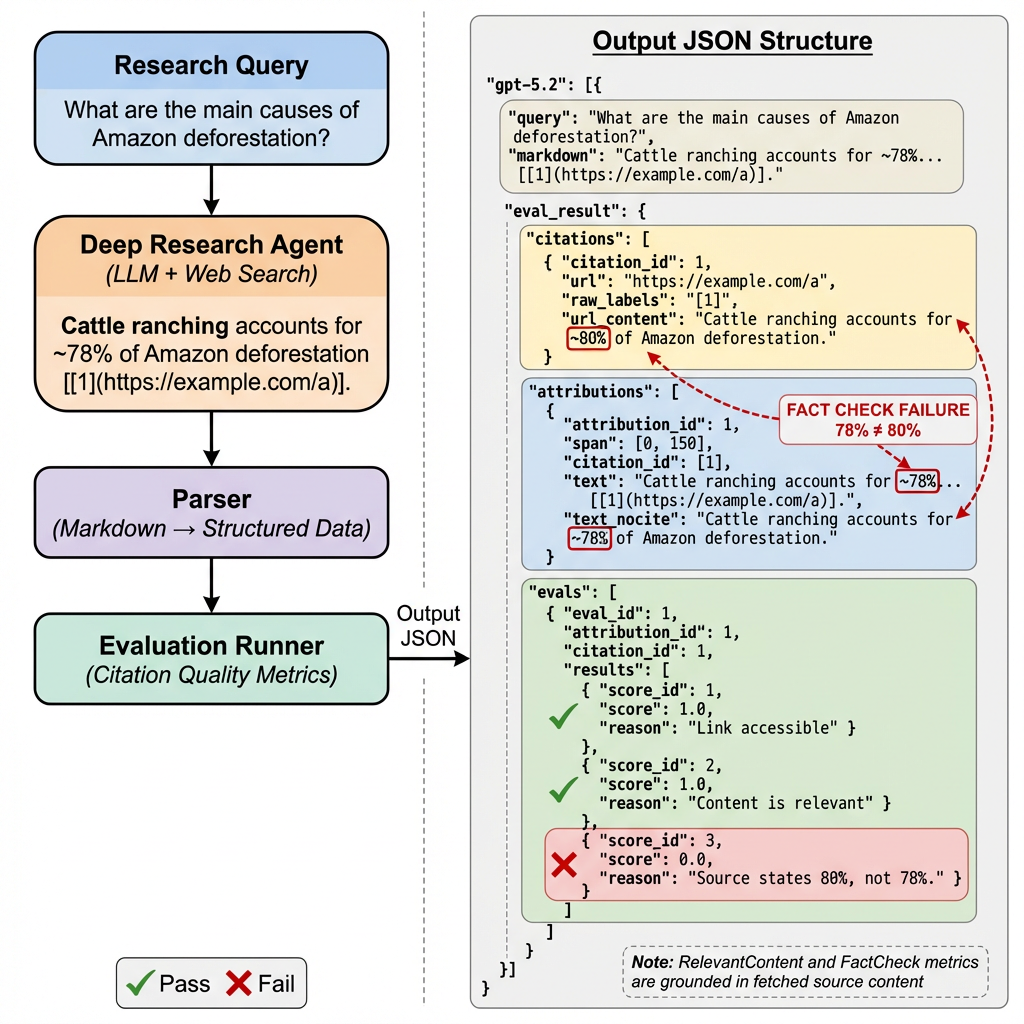
Use um teste de alinhamento em três camadas para cada alegação quantitativa ou causal:
- Correspondência de trecho: destaque a frase na fonte que supostamente sustenta a alegação.
- Implicação lógica: classifique como sustentada, indeterminada ou contradita. Indeterminada é falha se o assistente apresentou a alegação como fato.
- Fidelidade de números e ressalvas: unidades, amostra, ano, intervalo de confiança e termos como “pode”, “em camundongos” ou “em um país” devem permanecer intactos.
Por isso, a implicação textual é uma métrica de auditoria melhor do que “a página é sobre o tema”. A avaliação Open-QA baseada em implicação existe especificamente para quantificar a lacuna de inferência entre duas sequências de texto. A abordagem de validação de citações da NVIDIA operacionaliza a mesma ideia: compare a alegação ao texto referenciado e, então, atribua uma pontuação.
A inferência rotulada é a verificação complementar. Um assistente de pesquisa deve marcar cada parágrafo como sourced, inferred ou unknown. A síntese é permitida; a síntese silenciosa, não. A orientação da UNR para checagem de alegações adota o instinto correto: pergunte quem pode verificar a afirmação. Se quem verifica é “o conhecimento geral do modelo”, a frase precisava de um rótulo de inferência.
Um prompt rigoroso para essa verificação:
“Separe sua resposta em três blocos rotulados: (1) Alegações diretamente sustentadas, cada uma com uma citação e URL; (2) Inferências, com as premissas em que se baseiam; (3) Incógnitas. Não mova uma inferência para o bloco 1. Se um número for aproximado na fonte, mantenha a aproximação.”
O Elicit reduz inferências ocultas ao forçar respostas em colunas de extração, e isso é uma força genuína. O Scite identifica se artigos posteriores apoiam ou contrastam uma citação, o que detecta outro salto: tratar um único artigo como consenso estabelecido. A Jenova consegue seguir o formato de três blocos em uma sessão longa, mas não aplicará esses rótulos a menos que você os exija. Essa é uma lacuna real do produto em relação a ferramentas com medidores de evidência integrados.
Como verificar datas de atualização e atualidade das fontes?
Você verifica a atualidade exigindo uma data visível em cada fonte e incluindo pelo menos um teste cuja resposta correta tenha mudado no último ano. Um assistente que não consegue mostrar quando uma página ou artigo foi publicado não está pronto para perguntas sobre preços, regulamentações, lançamentos de modelos, epidemiologia ou estrutura de mercado.
Pesquisas sobre atualidade de conteúdo em buscas com AI constatam que a recência afeta se os sistemas recuperam uma página para uma pergunta atual. Trabalhos de monitoramento de citações em AI também alertam que os mecanismos reavaliam fontes continuamente, de modo que um relatório organizado de ontem pode se deteriorar silenciosamente. Portanto, sua auditoria deve registrar três datas, e não uma:
- Data da fonte — data de publicação ou da última atualização exibida na página ou artigo
- Data da evidência — o ano em que os dados subjacentes foram coletados
- Data da resposta — quando o assistente recuperou a fonte
Uma falha comum é citar uma revisão de 2019 para um número de prevalência “atual” ou citar um painel ao vivo sem registrar o momento da recuperação. Especialistas acadêmicos como Elicit e Consensus geralmente exibem o ano de publicação porque se baseiam em metadados de artigos. Ferramentas da web aberta muitas vezes não fazem isso, salvo se instruídas. A Jenova pode informar datas quando o documento recuperado as expõe, mas não pode inventar um timestamp confiável para uma página sem data — e deve dizer isso.
Exemplos de testes de atualidade:
“Qual é o número atual em 2026? Informe a data de atualização da fonte. Se a melhor fonte tiver mais de 18 meses, classifique a resposta como histórica, não atual.”
“Compare a fonte mais recente que você conseguir encontrar com a fonte antiga mais citada. O que mudou e o que não mudou?”
Se o assistente não consegue distinguir uma página HTML revisada de uma reimpressão inalterada em PDF, marque atualidade como falha mesmo que a URL funcione.
Como executar uma auditoria TRACE repetível a partir de um único prompt?
Você executa uma auditoria repetível congelando o conjunto de testes, a planilha de pontuação e exigindo que todas as ferramentas emitam os mesmos campos verificáveis por máquina. O objetivo é produzir uma transcrição que outro pesquisador possa pontuar novamente sem observar seu trabalho.
Use esta sequência para o Academic Research Assistant da Jenova e depois repita-a em pelo menos uma ferramenta especialista (Elicit ou Scite) e uma generalista (Perplexity ou ChatGPT):
- Declare a função e o contrato de saída antes de fazer a pergunta.
- Faça um teste de cada classe: quantitativo, contraditório, documento primário e incógnita.
- Exija título, URL, data, citação e rótulo de alegação em cada referência.
- Clique em todos os links e pontue TRACE antes de fazer qualquer pergunta de acompanhamento.
- Só então solicite uma revisão das alegações reprovadas.
Contrato inicial:
“Você está sob auditoria. Para cada alegação relevante, produza: texto da alegação; rótulo (
sourced/inferred/unknown); título da fonte; URL clicável; data de publicação ou atualização; citação de apoio ≤25 palavras. Se o alinhamento for imperfeito, reduza o rótulo parainferredouunknown. Não cite fontes que você não recuperou. Termine com uma nota de cobertura listando os tipos de fontes usados e os tipos de fontes ausentes.”
No Elicit, o procedimento paralelo é executar a mesma pergunta como relatório de pesquisa e, em seguida, verificar por amostragem as células extraídas em relação ao trecho do PDF. No Scite, execute a alegação central como uma consulta de contexto de citação e conte os artigos de apoio versus os contrastantes antes de aceitar uma frase que pareça expressar consenso. No ChatGPT Deep Research, o próprio fluxo de trabalho de pesquisa da OpenAI ainda exige que você examine as fontes; o recurso do produto oferece recuperação e estrutura, não um substituto para a verificação de implicação lógica.
Mantenha um registro simples — alegação, URL, data, pontuações TRACE e observações. Dez alegações em quatro testes são suficientes para revelar um padrão. Se mais de duas alegações numéricas falharem no alinhamento, pare de usar a ferramenta para qualquer entrega que será citada por outra pessoa.
O que profissionais de integridade em pesquisa dizem sobre o teste de citações de AI?
A prática de integridade em pesquisa convergiu para uma regra direta: trate citações de AI como afirmações não verificadas até que uma pessoa ou uma verificação automatizada de implicação abra a fonte. O debate útil já não é se os modelos alucinam, mas quais falhas você consegue instrumentar.
“O setor continua otimizando bibliografias mais bonitas. Essa é a unidade errada. Uma citação é um indicador, não uma prova. Se o trecho citado não sustenta a frase — especialmente o número, a população e o ano — a citação é decorativa. Vimos falhas de ‘78% versus 80%’ passarem em todas as verificações cosméticas: URL real, título relevante, tom confiante. Esses são os erros que sobrevivem até chegar aos manuscritos.”
“A inferência rotulada é o controle mais barato que a maioria das equipes deixa de aplicar. Quando um assistente pode misturar recuperação com conhecimento do mundo, ele transforma palpites em achados. Force três categorias — com fonte, inferido, desconhecido — e sua taxa de alucinação se torna visível. Equipes que se recusam a mostrar uma categoria de desconhecidos estão dizendo que não conseguem representar incerteza.”
“O teste de cobertura também é uma escolha de governança. Um assistente focado apenas em artigos parecerá rigoroso e ainda poderá ignorar o memorando de um órgão que mudou a regra no mês passado. Um assistente apenas da web parecerá atual e ainda poderá ignorar o ensaio que realmente mediu o desfecho. A escolha do modelo importa porque alguns modelos fazem ressalvas, outros comprimem e outros eliminam qualificadores. A auditoria deve seguir a alegação, não a marca.”
— Equipe de Produto da Jenova, avaliação de agentes de pesquisa, 6 anos desenvolvendo fluxos de trabalho de recuperação e citação para usuários acadêmicos e profissionais
Essa posição está alinhada à prática de bibliotecas. A Northwestern documenta casos em que um modelo citou um artigo real de enciclopédia e ainda errou nomes e datas. A UNR orienta pesquisadores a perguntarem quem pode verificar a alegação. Ambas expressam TRACE em forma de texto.
Quando um assistente de pesquisa com AI é bom o suficiente para uso em pesquisa real?
Um assistente de pesquisa com AI é bom o suficiente quando sobrevive a uma auditoria TRACE sobre seus tipos reais de pergunta, com alegações reprovadas corrigidas a partir da fonte ou rebaixadas para inferência rotulada. Ele não é bom o suficiente quando produz respostas fluentes e cheias de links que desmoronam diante de uma verificação por clique e implicação lógica.
Use esta regra de decisão:
- Use um extrator especialista como o Elicit quando a tarefa for triagem ou extração de dados de um conjunto conhecido de artigos, e você ainda for verificar células por amostragem.
- Use o Scite quando a pergunta for se a literatura apoia, menciona ou contrasta uma alegação específica.
- Use o Consensus quando precisar de uma leitura rápida da direção das evidências sobre uma pergunta científica delimitada.
- Use Perplexity ou ChatGPT para reconhecimento amplo do tema e, depois, verifique novamente cada número antes que ele entre em um manuscrito.
- Use o Academic Research Assistant da Jenova quando o trabalho envolver múltiplas interações — descoberta de literatura, linguagem de manuscrito e gestão de citações em uma única sequência auditável — e você estiver disposto a exigir campos TRACE no prompt.
Não use nenhum deles como etapa final sem supervisão. Os resultados de precisão de citações da JMIR e as taxas de alucinação da Stanford HAI são razão suficiente para manter uma pessoa no processo. A configuração vencedora em 2026 não é um único modelo “confiável”. É uma trilha de fontes que você pode reproduzir: links clicáveis, documentos datados, alegações sustentadas e uma fronteira visível entre evidência e inferência.
Referências
- Northwestern University Libraries — Avaliação de conteúdo gerado por AI
- University of Nevada, Reno Libraries — AI e avaliação de fontes
- JMIR — Avaliação do desempenho de grandes modelos de linguagem e da confiabilidade de citações geradas
- Stanford HAI — AI em julgamento: modelos jurídicos alucinam em 1 de cada 6 ou mais consultas de benchmark
- AuthorityTech — Atualidade de conteúdo para SEO em 2026
- Discussão de Chris Long / Ahrefs — Atualidade e visibilidade em buscas com AI
- ACL Findings — Avaliação Open-QA precisa e detalhada por meio de implicação textual
- NVIDIA Developer — Validação automática de citações usando NVIDIA NIM
- Elicit — AI para pesquisa científica, cobertura e precisão de extração
- Scite — Smart Citations para literatura científica
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- iatroX — Melhores ferramentas de AI para pesquisa médica em 2026
- Biblioteca HKUST — Comparação de ferramentas emergentes de AI para revisão de literatura
- Omid Saffari — Melhores ferramentas de pesquisa com AI em 2026: Elicit vs Consensus
- Pure AI — Citação necessária: colocando 7 ferramentas de pesquisa com AI à prova
- SEOptimer — Atualidade de conteúdo em SEO e buscas com AI
- OtterlyAI — Como monitorar citações e fontes de mecanismos de busca com AI
- Firecrawl — Busca na web e pesquisa aprofundada para agentes de AI
- OpenAI Academy — Pesquisa com ChatGPT: Search e Deep Research