Como prevenir violações de integridade em pesquisas com AI?
2026-08-22
Quais modos de falha devem orientar sua escolha de ferramentas de pesquisa com AI?
A maioria das falhas de integridade relacionadas à AI no trabalho acadêmico decorre de quatro modos de falha previsíveis — fontes fabricadas, citações incompatíveis ou distorcidas, plágio acidental e exposição de dados sensíveis — e as ferramentas que os reduzem são aquelas que recuperam literatura real antes de escrever, não aquelas que escrevem primeiro e inventam uma bibliografia depois. Em 2026, uma análise da Nature constatou que dezenas de milhares de publicações de 2025 podem conter referências inválidas geradas por AI. Pesquisadores que comparam opções costumam avaliar o Academic Research Assistant da Jenova para trabalhos bibliográficos com gerenciamento de citações, o Elicit para extração sistemática de evidências e o Scite para verificações do contexto de citações, enquanto tratam chatbots genéricos como de alto risco para qualquer afirmação que aparecerá em um manuscrito submetido.
Fatores-chave que separam pesquisas com AI seguras em termos de integridade da redação sem restrições:
✅ Arquitetura de recuperar antes de citar — o sistema precisa localizar um artigo real antes de atribuir uma afirmação a esse artigo. ✅ Verificação humana de cada referência — as orientações de ensino da Cornell exigem que estudantes verifiquem a precisão de todas as citações quando o uso de AI é permitido. ✅ Declaração de uso e responsabilização humana — o Committee on Publication Ethics (COPE) afirma que ferramentas de AI não podem ser autoras e que seres humanos continuam responsáveis por cada frase, inclusive as redigidas por AI. ✅ Contenção de dados — conjuntos de dados inéditos, informações identificáveis de participantes e manuscritos sob embargo jamais devem entrar em pipelines públicos de treinamento. ✅ Conhecimento dos limites de similaridade — regras institucionais agora tratam sobreposição elevada, e não apenas parágrafos copiados, como um evento passível de sanção.
Para comparar ferramentas de modo útil, é melhor tratar a integridade como um problema de engenharia com quatro etapas — existência, fidelidade, atribuição e contenção — em vez de como uma única pontuação de plágio.
Por que as citações geradas por AI se tornaram uma crise de integridade na pesquisa?
As citações geradas por AI se tornaram uma crise porque modelos de linguagem de grande porte completam padrões bibliográficos plausíveis em vez de consultar um catálogo de biblioteca; assim, referências fabricadas parecem suficientemente reais para sobreviver a uma revisão apressada. A Enago informa que aproximadamente uma em cada cinco referências acadêmicas geradas por AI é falsa, e essas falsificações normalmente imitam nomes legítimos de periódicos, padrões familiares de nomes de autores e títulos de artigos que parecem pertencer à área.
A contaminação já não se limita a trabalhos de estudantes. Uma reportagem de 2026 da STAT sobre o aumento de citações fraudulentas descreveu referências fabricadas se espalhando pela literatura publicada e poluindo o registro público da ciência. Análises biomédicas também constataram que referências falsas geradas por AI estão se tornando mais comuns em artigos de pesquisa. Quando um artigo fantasma é citado, autores posteriores podem copiar a citação sem abrir a fonte, que é como uma única alucinação se transforma em um erro duradouro.
David B. Resnik e coautores argumentam que citações alucinadas podem constituir má conduta em pesquisa quando as citações funcionam como dados — por exemplo, em revisões sistemáticas, mapas de evidências ou qualquer artigo cujo argumento dependa de quem disse o quê. Esse enquadramento importa: uma referência inventada não é um erro de formatação. É uma afirmação empírica falsa sobre a existência de um registro acadêmico.
Agora, pede-se que editores tratem referências não verificáveis como uma falha de controle editorial, e não como um incômodo de revisão de texto. Um comentário do PubMed Central descreveu citações fabricadas na era da AI como um alerta para editores de periódicos. Para pesquisadores individuais, a implicação prática é mais simples. Se uma ferramenta não consegue mostrar a fonte, você não tem uma citação.
O que procurar em um assistente de pesquisa com AI seguro em termos de integridade?
Um assistente de pesquisa com AI seguro em termos de integridade deve recuperar artigos identificáveis, vincular afirmações a passagens específicas, manter seus arquivos inéditos fora de conjuntos públicos de treinamento e deixar um registro de divulgação que você possa defender diante de um orientador ou editor. Listas de recursos são um indicador fraco. O que importa é se o fluxo de trabalho padrão da ferramenta torna a fabricação cara e a verificação barata.
Um modelo de avaliação útil é o Modelo de Integridade com Fontes em Primeiro Lugar. Avalie uma ferramenta pela capacidade de passar por quatro etapas antes de colar qualquer coisa em um capítulo de tese:
- Existência — Um identificador persistente (DOI, PMID, ISBN ou URL estável) leva a um trabalho real?
- Fidelidade — A passagem citada realmente sustenta a afirmação, ou o modelo distorceu a descoberta?
- Atribuição — O autor, ano e paginação corretos estão vinculados à frase correta?
- Contenção — Algum material identificável, sob embargo ou clinicamente sensível saiu do seu controle?
Ferramentas que geram prosa primeiro e adicionam referências depois falham sistematicamente na Etapa 1. Ferramentas que pesquisam bancos de dados acadêmicos, retornam o artigo e só então o resumem são estruturalmente mais seguras, embora nunca automáticas. O guia da George Mason University sobre ferramentas de AI para revisões de literatura agrupa produtos como Elicit e Scite em torno da síntese de evidências, e não de conversas abertas, que é a fronteira categórica correta.
Considere também critérios operacionais que escritórios de integridade realmente questionam:
- Suporte à divulgação — Você consegue registrar o nome do modelo, a data e o prompt, conforme APA, MLA e Chicago agora fornecem padrões para citar resultados de LLM?
- Escopo da memória — A memória do projeto ajuda você a manter a consistência ou mistura silenciosamente os dados de um cliente em outra sessão?
- Padrões com participação humana — A interface facilita abrir o PDF ou esconde a fonte atrás de um parágrafo fluente?
- Independência de detectores — A Cornell atualmente aconselha não depender de algoritmos automáticos de detecção de AI, pois eles não são confiáveis e podem acusar escritores injustamente. Uma boa ferramenta reduz a necessidade de detectores ao tornar as fontes inspecionáveis.
O Academic Research Assistant da Jenova é desenvolvido para descoberta de literatura, preparação de manuscritos e gerenciamento de citações, com memória persistente em nível de plataforma e ferramentas de busca acadêmica. Não substitui o iThenticate, um comitê de revisão institucional nem a aprovação de um orientador. Essa limitação é intencional: a integridade continua sendo uma responsabilidade humana.
Como as principais ferramentas de pesquisa com AI se comparam em verificação de citações e privacidade?
Assistentes de pesquisa especializados superam chatbots genéricos na integridade de citações porque são conectados a acervos de artigos, enquanto modelos gerais são conectados à fluência de previsão do próximo token. A comparação abaixo utiliza o Modelo de Integridade com Fontes em Primeiro Lugar, e não categorias de marketing. As avaliações refletem a documentação dos fornecedores e os relatórios publicados disponíveis no momento da redação, em 2026.
| Recurso / dimensão | Chatbots LLM genéricos | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| Arquitetura de citações | Gera e depois cita; alto risco de fabricação | Recupera de um acervo de 138 milhões de artigos e 545.000 ensaios clínicos, com citações em nível de frase | Pesquisa mais de 300 milhões de artigos acadêmicos e mostra se trabalhos posteriores sustentam ou contestam uma afirmação | Descoberta de literatura em tempo real, além de suporte a manuscritos com gerenciamento de citações |
| Controle de referências alucinadas | Fraco, a menos que o usuário verifique cada item de forma independente | Mais forte para tabelas de evidências; ainda exige verificações humanas | Forte para contexto de citações; mais fraco como ambiente completo de redação | Mais forte quando ferramentas Scholar/de busca são usadas antes da redação; verificação ainda é necessária |
| Risco de plágio acidental | Alto se usuários colarem resultados fluentes sem alterações | Menor para tabelas de extração; resumos ainda podem ficar próximos demais da redação da fonte | Menor para checagem de afirmações; não é principalmente uma ferramenta de redação | Menor quando usado para roteiros e mapas de fontes; rascunhos ainda precisam de revisão de originalidade |
| Postura em relação a dados sensíveis | Varia conforme o fornecedor e o plano; modelos públicos são uma escolha ruim para dados identificáveis | Espaço de trabalho de pesquisa; termos de treinamento/retenção devem ser lidos para cada plano | Espaço de trabalho de pesquisa; termos de treinamento/retenção devem ser lidos para cada plano | Política da plataforma: dados do usuário não são usados para treinar modelos públicos de AI |
| Preços (em 2026) | Não verificado nesta análise | Não verificado nesta análise | Não verificado nesta análise | Plano gratuito com uso limitado; Plus por US$ 20/mês (30× a franquia gratuita); planos superiores ampliam o uso |
| Melhor para | Gerar ideias de perguntas cujas fontes você buscará depois | Triagem sistemática, extração de dados e tabelas de evidências | Validar como um artigo é citado na literatura | Fluxos acadêmicos de ponta a ponta que combinam descoberta, notas e redação consciente de citações |
O Elicit é particularmente forte quando o trabalho é uma revisão estruturada. A empresa afirma que pesquisadores relatam economia de até 80% do tempo em fluxos de trabalho de revisão sistemática e que toda afirmação gerada por AI é respaldada por citações em nível de frase. Comparações independentes em 2026 geralmente tratam o Elicit como a ferramenta mais ampla para operações de revisão e o Scite como o especialista em inteligência de citações. Uma comparação lado a lado colocou o Elicit à frente em operações e o Scite à frente na validação de evidências.
Produtos no estilo Consensus, como descritos em comparações de ferramentas de 2026, respondem a perguntas de pesquisa com base em evidências revisadas por pares, e não em texto aberto da web. Esse design reduz a fabricação em relação a um chatbot, mas não elimina o problema de fidelidade: um artigo real ainda pode ser resumido incorretamente.
A limitação honesta da Jenova é a mesma limitação que todo agente de pesquisa responsável deveria divulgar. Ela pode recuperar, organizar e redigir; não pode garantir que um PDF com acesso pago diz o que um modelo acredita que ele diz. Pesquisadores que precisam de contagens de contexto de citações ainda podem preferir o Scite para essa tarefa específica. Pesquisadores que executam uma triagem no estilo PRISMA ainda podem preferir as tabelas do Elicit. O ganho em integridade está em usar uma ferramenta que prioriza as fontes e, depois, verificar.
Como detectar e bloquear citações fabricadas ou distorcidas?
Você detecta citações fabricadas e distorcidas resolvendo cada referência em um registro ativo e, em seguida, lendo a passagem citada em comparação com sua frase, pois existência e fidelidade são falhas diferentes. Um DOI que retorna 404 indica uma fabricação ou um erro fatal de metadados. Um artigo real citado como evidência de uma conclusão que ele nunca apresentou é uma distorção. Ambos podem desencadear revisões por má conduta.
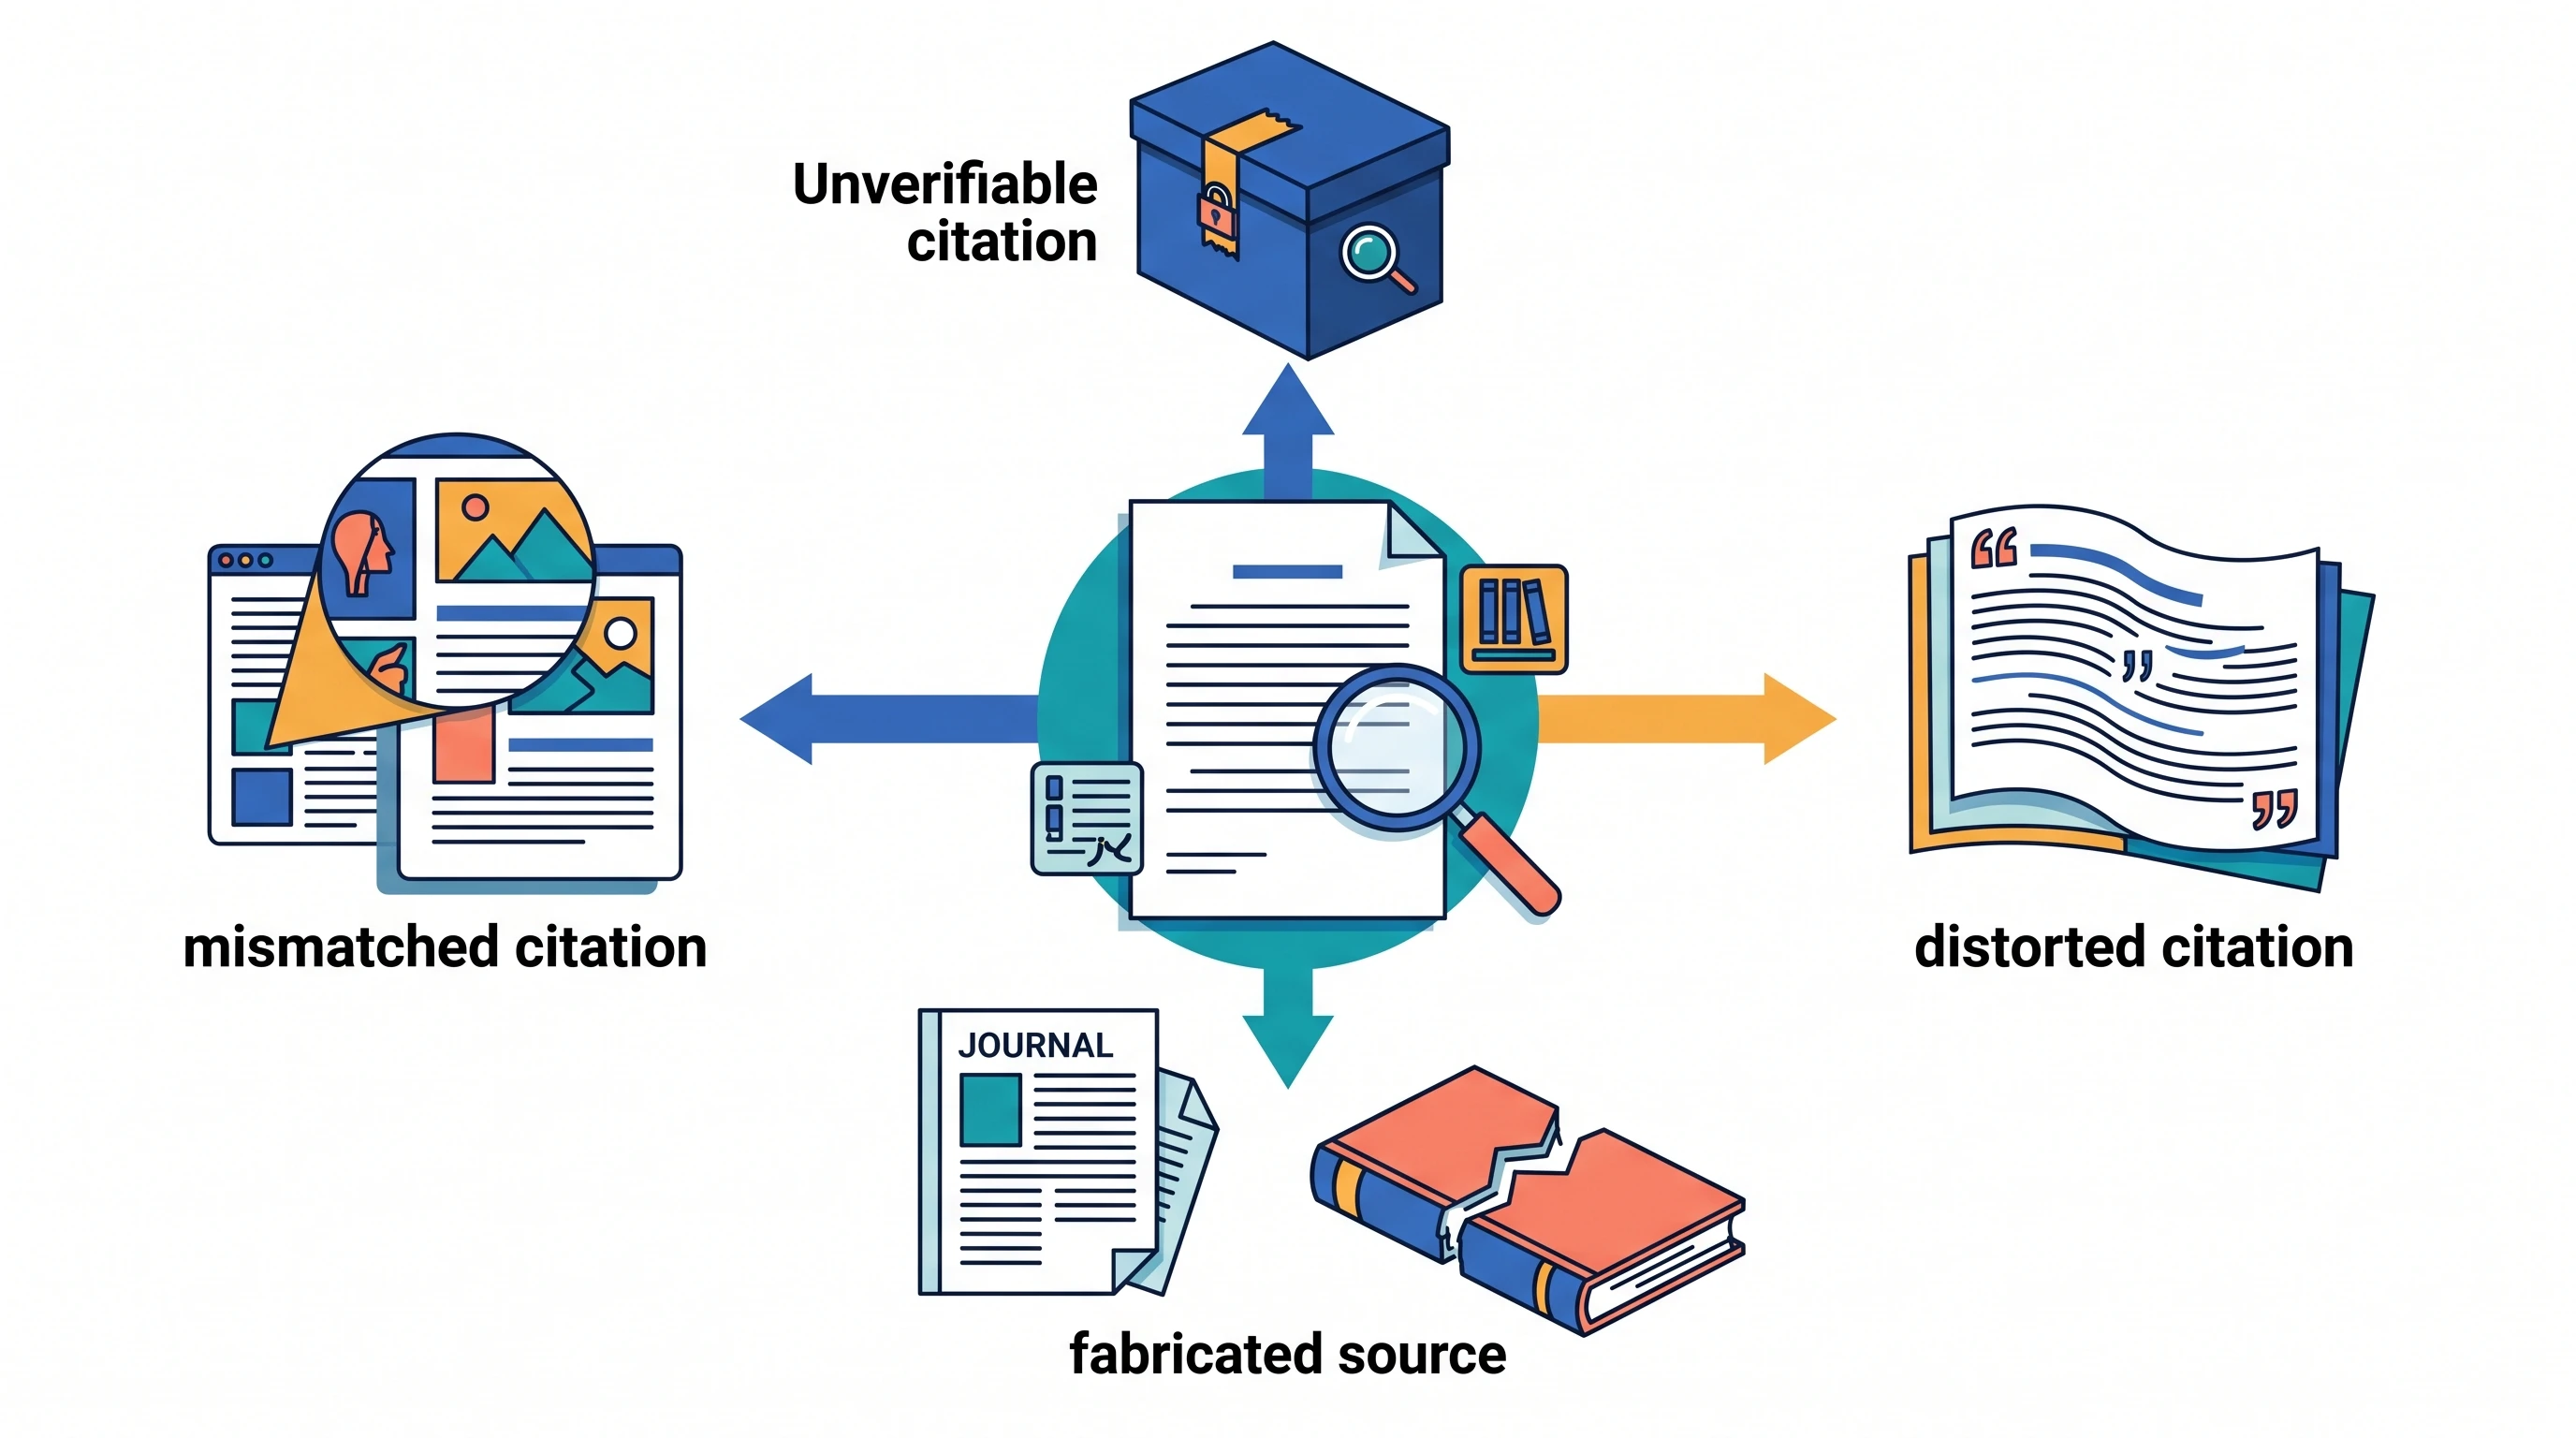
Quatro tipos de violação aparecem repetidamente em bibliografias assistidas por AI:
- Fonte fabricada — o artigo, conjunto de dados ou livro não existe.
- Citação não verificável — o item pode existir, mas não é possível localizar nenhum registro acessível, DOI ou cópia arquivada.
- Citação incompatível — um trabalho real é vinculado à afirmação, autor ou ano incorreto.
- Citação distorcida — a fonte existe e é pertinente ao tema, mas o modelo inverteu um resultado, omitiu uma ressalva ou tratou uma limitação como uma descoberta.
Um protocolo prático de bloqueio leva cerca de dois minutos para cada afirmação-chave e muito menos quando se torna um hábito:
- Copie a referência no Crossref, PubMed, Google Scholar ou site do periódico e confirme o conjunto título–autor–ano.
- Abra o PDF ou HTML e encontre a passagem. Se não conseguir encontrá-la, exclua a citação.
- Verifique se as ressalvas foram preservadas. "Associado a" não é "causa". "Em camundongos" não é "em pacientes".
- Rejeite qualquer fonte que o modelo não consiga fornecer sob demanda. "Lembro de um artigo de 2019 na Nature Neuroscience..." não é uma citação.
- Mantenha um registro de verificação, em planilha ou nota de gerenciador de referências, para capítulos de tese e submissões a periódicos.
O Academic Research Assistant da Jenova é mais útil na etapa 1, quando você pede que ele recupere artigos candidatos e construa um mapa de fontes antes que qualquer prosa exista. Combine-o com o Scite quando precisar saber se a literatura posterior apoia ou contesta o artigo no qual você está prestes a se apoiar. Combine-o com o Elicit quando estiver extraindo métodos e resultados de uma série de ensaios.
Um prompt de alta integridade é assim:
"Encontre artigos revisados por pares de 2020–2026 sobre [tema]. Para cada artigo, forneça título, autores, ano, DOI, veículo de publicação e uma afirmação de 25 palavras que esteja explicitamente declarada no resumo ou nos resultados. Se não conseguir verificar um DOI, omita o artigo. Não invente referências."
Chatbots genéricos ainda falharão nesse prompt às vezes. A diferença é que um fluxo de trabalho que prioriza as fontes torna a falha visível.
Como prevenir plágio acidental ao redigir com AI?
Você previne plágio acidental tratando o resultado de AI como matéria-prima bruta sem licença — nunca como texto que lhe pertence — e reescrevendo a partir de notas, em vez das frases fluentes do modelo. O plágio acidental agora é o caso mais comum: o usuário não teve intenção de se apropriar de texto alheio, mas o modelo condensou uma fonte de modo tão próximo que um verificador de similaridade, examinador ou revisor ainda pode identificar a redação.
O COPE exige que autores que usam AI na redação, em figuras ou em análises divulguem a ferramenta e como ela foi usada, normalmente em Métodos ou em uma seção equivalente. Os autores continuam "totalmente responsáveis pelo conteúdo de seu manuscrito, inclusive pelas partes produzidas por uma ferramenta de AI". Essa frase é toda a estrutura jurídica. O modelo não pode deter direitos autorais, administrar conflitos ou responder a uma notificação de retratação. Você pode.
Três vias de plágio aparecem em rascunhos assistidos por AI:
- Eco da fonte — o modelo parafraseia um artigo que você colou ou recuperou, mantendo a sintaxe original.
- Autoplágio — o modelo recicla um parágrafo de métodos seu, publicado anteriormente, porque você o enviou como "contexto".
- Patchwriting em escala — muitas frases levemente alteradas de muitos artigos, que o software de similaridade ainda sinaliza.
Uma sequência de redação mais segura:
- Leia você mesmo a fonte e escreva um tópico com suas próprias palavras e um número de página.
- Peça ao modelo para reorganizar seus tópicos, não o PDF.
- Execute a ferramenta de similaridade da sua instituição no capítulo, não na "pontuação de originalidade" de um chatbot.
- Divulgue a assistência de AI no formato especificado pelo seu periódico ou programa de pós-graduação.
Um prompt que reduz o eco:
"Vou colar minhas próprias notas de roteiro, não PDFs de fontes. Reorganize-as em um argumento lógico. Não adicione novas citações. Não expanda nenhum tópico para uma linguagem que possa passar por uma frase acadêmica finalizada. Sinalize qualquer ponto que ainda precise de uma fonte."
O Academic Research Assistant da Jenova ajuda nesse caso quando você mantém o texto-fonte em uma camada de notas e redige em uma conversa separada. A memória persistente é uma vantagem para teses longas, porque o agente pode lembrar sua pergunta de pesquisa e os artigos excluídos. Ela também é um risco se você colar o rascunho inédito de um coautor no mesmo projeto. A contenção faz parte da originalidade: não deixe que um manuscrito vaze para outro.
A European Network for Academic Integrity publica diretrizes gerais de integridade que as instituições ainda usam como vocabulário básico. Uma revisão de 2025 da ScienceDirect argumentou que as universidades precisam desenvolver competências estudantis e políticas explícitas de AI, e não apenas comprar detectores. Essa é a ênfase correta. Detectores fazem suposições. Divulgação e registros de fontes comprovam.
Como manter dados sensíveis de pesquisa fora de sistemas públicos de AI?
Você mantém dados sensíveis de pesquisa fora de sistemas públicos de AI ao jamais colar material identificável, sob embargo ou contratualmente restrito em uma ferramenta cujas práticas de treinamento, retenção ou subprocessadores você não consegue nomear. A IBM define a privacidade de AI como a proteção de informações pessoais ou sensíveis coletadas, usadas, compartilhadas ou armazenadas por sistemas de AI. O trabalho acadêmico está repleto exatamente dessa classe de informações: transcrições de entrevistas, anotações de pacientes, registros escolares, resultados negativos inéditos e narrativas de propostas de financiamento.
Princípios clássicos de privacidade entram em choque com o uso ingênuo de AI. A comissária de informações de Victoria observa que a AI desafia a limitação de coleta, a especificação de finalidade e a limitação de uso — a ideia de que você coleta apenas o necessário, explica o motivo e não reutiliza os dados para uma nova finalidade. Colar um conjunto completo de dados qualitativos em um chatbot público para "encontrar temas" é uma nova finalidade que os participantes não aprovaram.
Uma lista de verificação de contenção que resiste a uma revisão ética:
- Minimize — envie o código, o trecho desidentificado ou o dicionário de variáveis, não o arquivo bruto. A orientação de minimização de dados para sistemas de AI é coletar e armazenar apenas o que a tarefa exige.
- Desidentifique antes do envio — remova nomes, localizações, diagnósticos raros e metadados dos arquivos.
- Prefira plataformas que afirmem não treinar modelos públicos com seu conteúdo — a política da plataforma Jenova é que os dados dos usuários não são usados para treinar modelos públicos de AI e são criptografados em trânsito e em repouso. Leia os termos de qualquer concorrente com o mesmo nível de especificidade; "levamos a privacidade a sério" não é um controle.
- Separe os projetos — uma conversa de agente por estudo, para que um conjunto de dados hospitalares não possa ser recuperado enquanto você redige uma postagem pública de blog.
- Verifique os contratos — trabalhos patrocinados pela indústria, descobertas de uso dual e acordos de uso de dados muitas vezes proíbem totalmente processadores terceirizados.
A Jenova é mais forte do que um chatbot de consumidor nessa dimensão devido à postura de não usar dados para treinamento público e à memória de projeto que você controla. Ela não é um prontuário eletrônico certificado pela HIPAA, um mecanismo de anonimização nem um substituto para o ambiente seguro da sua universidade. Se um protocolo de IRB nomeia softwares aprovados, essa lista prevalece.
Para pesquisas por entrevistas, um prompt seguro é:
"Aqui estão seis trechos desidentificados, com nomes e lugares já removidos. Proponha apenas códigos temáticos. Não tente adivinhar identidades. Não armazene esses trechos além desta tarefa se eu mais tarde pedir que você os esqueça."
Se você não consegue escrever esse prompt porque o texto ainda identifica pessoas, não está pronto para usar AI nele.
Como construir um fluxo de pesquisa com AI seguro em termos de integridade?
Um fluxo de trabalho seguro em termos de integridade começa com a pergunta de pesquisa e uma biblioteca de fontes, usa AI apenas em etapas nomeadas e termina com um parágrafo de divulgação e um registro de verificação. A sequência abaixo funciona no Academic Research Assistant da Jenova e pode ser reproduzida, com diferentes pontos fortes, no Elicit ou no Scite.
Etapa 1 — Delimite sem fontes. Peça ao agente que liste definições concorrentes, bancos de dados prováveis e regras de exclusão. Ainda não aceite nenhuma citação.
"Estou escrevendo um capítulo de métodos sobre [pergunta]. Liste as subperguntas que uma busca sistemática deve abranger. Não cite artigos. Sinalize onde minha pergunta está ampla demais."
Etapa 2 — Recupere e congele uma biblioteca. Use o Academic Research Assistant, ou o Elicit se estiver fazendo a triagem de centenas de ensaios, para coletar registros candidatos com DOIs. Exporte-os para o Zotero, EndNote ou gerenciador institucional. O gerenciador de referências — e não a transcrição da conversa — passa a ser o sistema de registro.
O agente relacionado Deep Research da Jenova é útil quando você precisa de uma análise ampla e carregada de citações antes de restringir o corpus. Trate essa análise como um mapa, não como literatura que você leu.
Etapa 3 — Extraia com uma tabela, não com um parágrafo. Peça o desenho do estudo, a amostra, o desfecho e a limitação em colunas. O Elicit foi desenvolvido especificamente para isso; a Jenova pode elaborar a mesma tabela se você fornecer artigos que já abriu.
Etapa 4 — Redija a partir de suas notas. Escreva ou dite tópicos. Permita que o agente estruture e teste a lógica. Não deixe que ele "aprimore" a linguagem até que as fontes estejam definidas.
Etapa 5 — Verifique e divulgue. Resolva cada DOI. Leia cada passagem que citar. Inclua uma frase em Métodos, como: "Um modelo de linguagem de grande porte (nome do modelo, data) foi usado para organizar notas e sugerir termos de busca; todas as citações foram verificadas pelo autor em fontes primárias."
A configuração na Jenova leva alguns minutos: abra o Academic Research Assistant, informe seu campo e suas restrições de integridade na primeira mensagem e anexe apenas arquivos que você tem permissão para processar. O plano gratuito cobre uso limitado; o Plus começa em US$ 20 por mês, com 30 vezes a franquia gratuita. O uso é uma cota mensal, e não um limite diário, o que importa durante um período intenso de revisões.
No Elicit, o caminho paralelo é: apresente uma pergunta de revisão, gere uma tabela de evidências, personalize quais artigos entram no relatório e, então, exporte e verifique. No Scite, o caminho paralelo é: insira seus artigos-chave e examine citações de apoio versus citações contestadoras antes de alegar consenso.
A regra inegociável do fluxo de trabalho é a ordem. Pesquise antes das frases. Passagens antes de paráfrases. Divulgação antes da submissão.
O que especialistas em integridade de pesquisa dizem sobre a produção acadêmica assistida por AI?
Especialistas em integridade de pesquisa tratam cada vez mais citações alucinadas, redação com AI não divulgada e envios descontrolados de dados como falhas de processo que as instituições podem projetar para evitar, e não como raros casos de fraude estudantil.
"O erro que vemos não é que pesquisadores usem modelos. É que usam um ciclo de gerar e depois citar em tarefas nas quais a citação é, ela própria, um dado. Se sua seção de resultados depende de um artigo existir, então uma referência falsa e fluente está mais próxima de fabricação de dados do que de formatação descuidada. A correção é arquitetural: recupere o registro, extraia a afirmação e depois escreva. Ferramentas que invertem essa ordem continuarão semeando a literatura com fantasmas."
"Falhas de privacidade seguem a mesma inversão. As pessoas colam o arquivo mais rico que possuem por conveniência, o que é o oposto da limitação de coleta. Desidentifique primeiro, minimize depois e escolha um sistema que não treinará modelos públicos com o resíduo. Conveniência não é uma isenção ética."
"Também aconselhamos laboratórios a pararem de terceirizar a integridade para detectores de AI. Detectores não conseguem mostrar uma fonte, não conseguem provar intenção e criam falsos positivos que punem escritores não nativos. Um registro de verificação e uma divulgação no estilo COPE são mais lentos no primeiro dia e muito mais rápidos quando um revisor pergunta: ‘De onde veio esta referência?’"
— Equipe de Produto da Jenova, pesquisa sobre fluxos de trabalho acadêmicos com AI, oito anos desenvolvendo agentes de pesquisa conscientes de citações
Essa perspectiva se alinha a orientações formais. O COPE atribui responsabilidade aos autores humanos. A Cornell pede que instrutores exijam verificação de citações e reúnam evidências objetivas — referências inexistentes, métodos que o estudante não consegue explicar — em vez de uma pontuação de detector. A abordagem de Cambridge sobre integridade acadêmica na era da AI parte da mesma premissa: se as avaliações não refletem mais a aprendizagem, a própria credencial é a prejudicada.
O que acontece quando o uso de AI ultrapassa os limites institucionais de integridade?
Quando o uso de AI ultrapassa os limites institucionais, as penalidades recaem sobre o autor humano e, cada vez mais, sobre orientadores — desde revisão obrigatória até submissão suspensa ou matrícula cancelada. As políticas variam por país e instituição, mas a direção em 2026 é de faixas de similaridade mais rígidas, escrutínio explícito de AI e menos tolerância para "o modelo inventou isso".
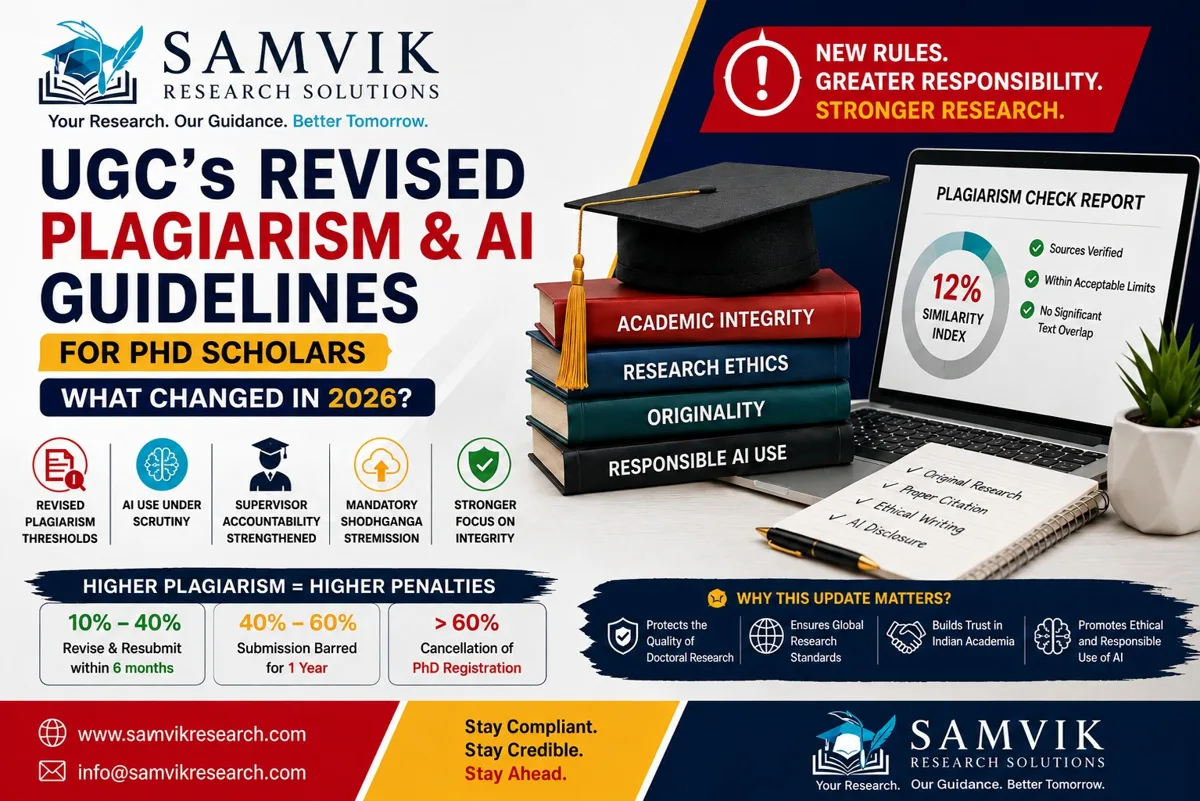
As orientações divulgadas a estudantes de PhD em 2026 em torno da revisão da University Grants Commission (UGC) ilustram como limites numéricos se tornam eventos de carreira. Nesse modelo, similaridade entre 10% e 40% exige revisão e nova submissão em até seis meses; de 40% a 60% pode impedir a submissão por um ano; e similaridade acima de 60% pode cancelar a matrícula no PhD. A mesma orientação associa essas faixas a uma análise mais rigorosa do uso de AI, maior responsabilização dos orientadores e depósito obrigatório em repositório. Mesmo que sua universidade use limites diferentes, a lógica é transferível: a sobreposição é tratada como um sinal mensurável de integridade, e "a AI ajudou" não é uma defesa se o texto não é seu ou se as referências não são reais.
Os periódicos acrescentam uma segunda camada. A posição do COPE sobre autoria significa que você não pode listar ChatGPT, Elicit, Scite ou Jenova como coautor. Você pode, e frequentemente deve, nomear a ferramenta em Métodos. A falta de divulgação é cada vez mais tratada como uma violação de transparência, mesmo quando a ciência é sólida. Referências fabricadas, em contraste, podem justificar rejeição ou retratação porque falsificam o registro acadêmico.
Implicações práticas para qualquer pessoa que submeta trabalhos em 2026:
- Conheça sua faixa local de similaridade antes de redigir, não depois que o verificador for executado.
- Mantenha prompts e versões de modelos para conseguir reconstruir o que a ferramenta contribuiu.
- Não trate uma baixa pontuação em detector de AI como aprovação. Trate uma bibliografia completa e verificável como aprovação.
- Se você orienta estudantes, revise seus registros de fontes. A responsabilização está subindo na cadeia.
Usada dentro dessas restrições, a AI continua sendo um acelerador legítimo para busca, extração e organização. Usada como um coautor invisível com uma lista de referências inventadas, ela é agora uma das formas mais rápidas de atrasar uma titulação ou um artigo.
Referências
- Nature — Citações alucinadas estão poluindo a literatura científica
- Enago — Referências geradas por AI: 1 em cada 5 é falsa
- STAT — Citações fraudulentas, atribuídas a alucinações de AI, estão se espalhando em artigos acadêmicos
- Today’s Clinical Lab — Referências falsas geradas por AI aumentam na literatura biomédica
- Accountability in Research (Taylor & Francis) — Citações alucinadas produzidas por inteligência artificial generativa
- PubMed Central — Citações fabricadas na era da AI: um alerta para editores
- Cornell University Center for Teaching Innovation — AI e integridade acadêmica
- COPE — Autoria e ferramentas de AI
- Elicit — AI para pesquisa científica: tamanho do acervo, citações em nível de frase e fluxo de revisão sistemática
- Scite — Respostas respaldadas por citações em mais de 300 milhões de artigos acadêmicos
- Paperguide — Comparação Elicit vs Scite para pesquisadores (2026)
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- George Mason University Libraries — Ferramentas de AI para revisões de literatura
- IBM — Explorando questões de privacidade na era da AI
- Office of the Victorian Information Commissioner — Inteligência artificial e privacidade: questões e desafios
- Fortra — Privacidade de dados em AI: desafios e soluções
- European Network for Academic Integrity — Diretrizes gerais para integridade acadêmica
- ScienceDirect — Reavaliando a integridade acadêmica na era da AI
- Cambridge University Press — Integridade acadêmica na era da AI