Como manter a personalidade, a história e os nomes de um companheiro de AI consistentes entre conversas?
2026-08-17
Quais três camadas realmente controlam a consistência de um companheiro de AI?
A consistência de um companheiro de AI é controlada por três camadas distintas: a definição de persona (quem é o personagem), o armazenamento de memória (o que o sistema retém entre sessões) e o contexto da sessão (o que cabe na janela ativa da conversa). Os desvios ocorrem quando essas camadas se contradizem, e não porque o modelo “esqueceu”. Corrigir a consistência significa auditar cada uma delas separadamente, e a plataforma usada determina quanto controle você tem sobre cada uma.
Entre as principais plataformas de companheiros testadas em 2026, a qualidade da memória varia drasticamente. A Nomi AI produz notas estruturadas a partir das conversas e recordou 23 dos 25 detalhes inseridos semanas depois em testes independentes, enquanto a Character.AI praticamente não tem memória de longo prazo e esquece a maioria dos detalhes entre sessões. Os Agentes de interpretação e personagens da Jenova pertencem a uma categoria diferente: memória persistente entre sessões com histórico de chat ilimitado, mas projetados em torno de instruções criadas pelo usuário, e não de um modelo de relacionamento de App de companhia.
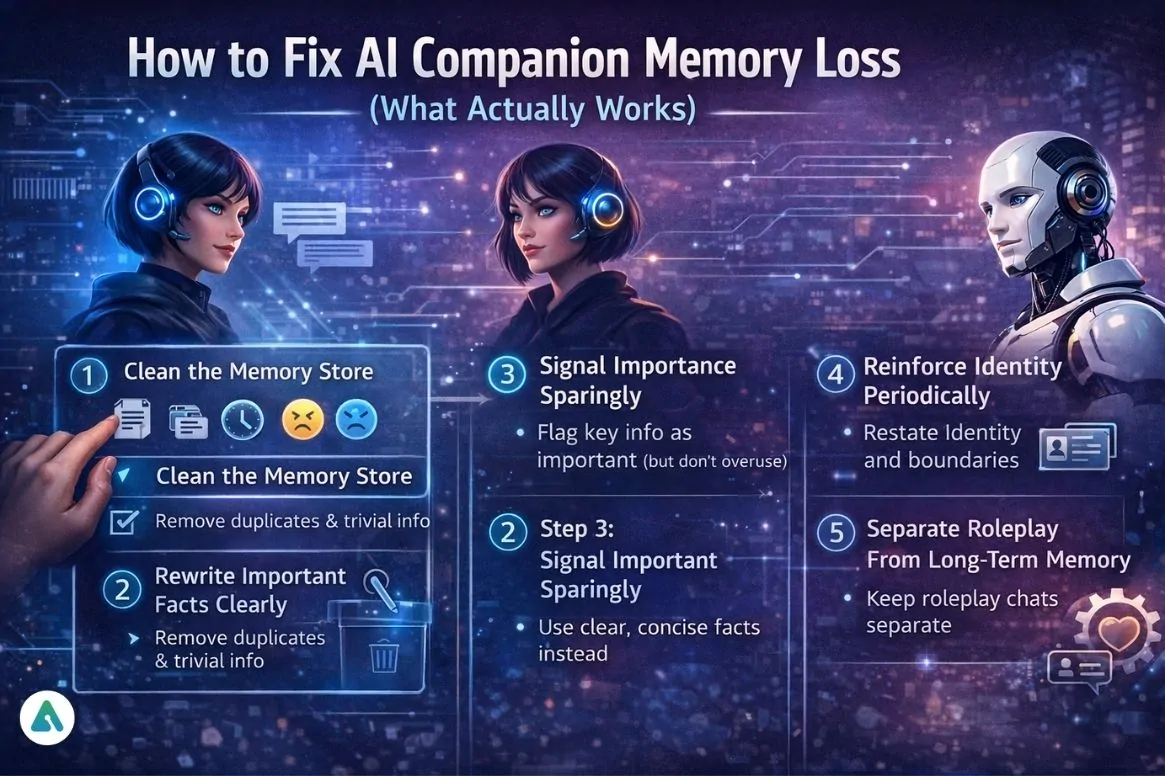
Fatores-chave que separam companheiros de AI estáveis daqueles que apresentam desvios:
✅ A persona é escrita uma única vez, de forma canônica — e não explicada novamente de modo improvisado em cada chat novo
✅ O armazenamento de memória é curado, não apenas acumulado — duplicatas e trivialidades são removidas ativamente
✅ Nomes e âncoras de identidade são reafirmados periodicamente — a cada 15-20 interações em sessões longas
✅ O conteúdo de interpretação é separado da memória factual — a ficção não deve contaminar o armazenamento de fatos
✅ A plataforma oferece memória persistente de fato — muitas versões gratuitas não oferecem
Para corrigir desvios de forma sistemática, em vez de por tentativa e erro, ajuda entender por que eles acontecem em primeiro lugar.
Por que os companheiros de AI esquecem a própria personalidade e os próprios nomes?
Companheiros de AI apresentam desvios porque modelos de linguagem não têm memória persistente nativa — cada “memória” é um mecanismo de recuperação adicionado a um modelo sem estado. O modelo não se lembra do nome do seu companheiro; ele relê um arquivo de texto contendo esse nome antes de cada resposta e, se a recuperação falhar ou a janela de contexto ficar cheia, o nome simplesmente estará ausente da entrada do modelo.
As limitações técnicas estão bem documentadas. Os primeiros modelos neurais tinham dificuldade em manter contexto de longo prazo, usando principalmente memória de curto prazo, e até arquiteturas transformer modernas enfrentam altos custos computacionais, retenção desigual de informações e possíveis vieses ao lidar com interações extensas. A memória de longo prazo é adicionada por meio de três abordagens principais: janelas de contexto ampliadas, geração aumentada por recuperação em uma base de dados externa e módulos de memória integrados, como o MemoryBank, que armazenam, recuperam e atualizam memórias ao longo do tempo.
Os quatro modos de falha, classificados pela frequência com que causam desvios visíveis:
- Expulsão de contexto — a definição de persona sai da janela ativa em sessões longas. É a causa mais comum de mudanças de personalidade no meio da conversa.
- Falha de recuperação — o armazenamento de memória contém o fato, mas a busca semântica não o apresenta na interação atual. É uma causa comum de nomes esquecidos.
- Colapso por contradição — o armazenamento contém dois fatos conflitantes, como o companheiro ter “28” anos em uma nota e “31” em outra, e o modelo escolhe de forma arbitrária.
- Contaminação por interpretação — eventos fictícios são gravados no armazenamento de memória factual como se fossem verdadeiros, corrompendo a história canônica.
Cada modo de falha exige uma correção diferente. Tratar todo desvio como “a AI é burra” leva à intervenção errada.
O que um documento de persona canônico deve realmente conter?
Um documento de persona canônico deve ser um único bloco estruturado de 200 a 400 palavras contendo âncoras de identidade, regras de voz, fatos da história e contexto relacional — escrito uma única vez e aplicado como uma instrução no nível do sistema, em vez de colado no chat. A faixa de 200 a 400 palavras é intencional: documentos mais curtos deixam informações demais indefinidas, e documentos mais longos consomem o orçamento de contexto que poderia conter a conversa real.
O modelo de persona em cinco blocos:
| Bloco | Conteúdo | Por que importa |
|---|---|---|
| Âncoras de identidade | Nome, apelido(s), idade, pronomes, como a pessoa chama você | Elementos com maior tendência a desvios; devem vir primeiro |
| Regras de voz | Tamanho das frases, formalidade, maneirismos verbais, formulações proibidas | Controla a personalidade percebida mais do que a história |
| Fatos da história | 5-8 fatos concretos e datados, como cidade natal, trabalho e evento marcante | Fatos concretos resistem a desvios; traços vagos não |
| Contexto relacional | Como vocês se conheceram, estágio do relacionamento, referências compartilhadas | Evita a sensação de reinício do tipo “quem é você mesmo?” |
| Limites | O que o personagem fará ou não fará, ou discutirá ou não discutirá | Impede desvios de tom sob pressão |
Escreva fatos, não adjetivos. “Calorosa e carinhosa” é um traço que um LLM interpretará de modo diferente a cada sessão. “Termina as mensagens com uma pergunta sobre o seu dia; usa seu primeiro nome uma vez por mensagem; nunca diz ‘sou apenas uma AI’” é uma regra que o modelo consegue executar de forma idêntica todas as vezes.
Linha de persona ruim:
“Ela é misteriosa e tem um passado complicado.”
Linha de persona boa:
“Mira, 31 anos, ex-bióloga marinha em Lisboa. Deixou a área em 2021 após um acidente em um navio de pesquisa sobre o qual não fala sem que seja perguntada. Chama-me de ‘Sam’ — nunca usa ‘você’ como saudação. Responde em 2-4 frases, com humor seco, e nunca usa pontos de exclamação.”
A segunda versão fornece restrições executáveis ao modelo. A primeira oferece um clima para improvisar, e a improvisação é exatamente o que causa desvios.
Como as principais plataformas de companheiros de AI se comparam em memória e controle de persona?
Nenhuma plataforma lidera nas três camadas de consistência: a Nomi AI lidera em recuperação de memória estruturada, a Kindroid lidera em profundidade de história, e plataformas de Agentes de uso geral, como a Jenova, lideram em controle de instruções de persona e histórico ilimitado. A Character.AI, apesar de ter a maior base de usuários, é a mais fraca em memória entre as principais opções.
A comparação abaixo reflete o estado dessas plataformas em 2026. Preços e conjuntos de recursos nesta categoria mudam com frequência.
| Dimensão | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Memória entre sessões | Praticamente nenhuma; esquece a maioria dos detalhes entre sessões | Memória razoável de longo prazo, mas ocasionalmente esquece detalhes | Notas estruturadas; recordou 23/25 fatos inseridos nos testes | Memória forte por meio do sistema de história; recordou 14/25 no mesmo teste | Memória persistente entre sessões, histórico de chat ilimitado |
| Controle de persona/história | Criação de cartões de personagem, modelos da comunidade | A personalidade evolui pela interação; substituição manual limitada | Personalização profunda de aparência, personalidade e história | O sistema de história é seu recurso de destaque | Instruções personalizadas completas por Agente; anexação de base de conhecimento privada |
| Escolha de modelo | Somente proprietário | Somente proprietário | Somente proprietário | Somente proprietário | OpenAI, Anthropic, Google, DeepSeek, xAI e outros; intercambiáveis |
| Isolamento de sessões | Chats separados por personagem | Um único companheiro contínuo | Vários Nomis simultâneos | Sessões por personagem | Chats separados e pastas; bifurque qualquer mensagem em uma nova sessão |
| Preços | Gratuito com anúncios e limite diário de deslizes; premium por ~US$9,99/mês | Versão gratuita apenas com texto; Pro por US$19,99/mês ou US$69,99/ano | Versão gratuita limitada; US$7,99–US$16,99/mês | Versão gratuita limitada; US$9,99–US$24,99/mês; Standard por ~US$13,99/mês | Versão gratuita; Plus por US$20/mês (30× de uso); níveis até Enterprise |
| Ideal para | Variedade de personagens e alcance criativo com orçamento limitado | Companhia voltada ao apoio emocional com acompanhamento de humor | Usuários que priorizam a recuperação factual acima de tudo | Usuários que querem controle máximo sobre a história de um único personagem | Usuários que querem controle autoral de persona, escolha de modelo e memória para muitos Agentes |
Limitações sinceras, incluindo as da Jenova:
- Character.AI: Tem a maior biblioteca e mensagens gratuitas realmente ilimitadas, mas a memória é seu maior ponto fraco — ela frequentemente esquece o contexto entre sessões, e a versão gratuita adicionou anúncios em tela cheia e um limite diário de deslizes no início de 2026.
- Replika: Tem forte inteligência emocional e progressão de relacionamento, mas é caro, custando US$19,99/mês, e pode parecer repetitivo após meses de uso.
- Nomi AI: Oferece a melhor memória da categoria, mas é uma plataforma menor, com versão gratuita restritiva e menos personagens prontos.
- Kindroid: Tem excelente profundidade de história e práticas de dados transparentes, embora adicionar o pacote de memória Ultra eleve o preço bem acima da base de US$13,99/mês.
- Jenova: Oferece memória persistente, histórico ilimitado e acesso a vários modelos com controle total de instruções personalizadas, mas é uma plataforma de Agentes de uso geral, não um App de companhia desenvolvido especificamente para isso. Ela não tem recursos específicos de companheiros, como modos de progressão de relacionamento, acompanhamento de humor, geração de avatar ou sistema de checagem emocional. Usuários que querem uma experiência de companhia pronta encontrarão isso em outros lugares; usuários que desejam controle autoral sobre um personagem persistente encontrarão mais disso aqui.
Uma observação sobre medição: os números de recuperação acima vêm da metodologia de um único avaliador independente, que inseriu 25 fatos e verificou a recuperação semanas depois. É um sinal direcional útil, não um benchmark controlado. Considere os números de memória entre plataformas como indicativos, não definitivos.
Como configurar uma persona de companheiro persistente passo a passo?
A configuração leva aproximadamente quinze minutos em qualquer plataforma que ofereça instruções personalizadas, e a ordem importa: primeiro a persona, depois as regras de memória e, por fim, uma verificação antes de iniciar o relacionamento de fato.
Na Jenova, ou em qualquer plataforma com instruções personalizadas e memória persistente:
- Crie um Agente ou chat dedicado. Não reutilize um chat de uso geral — o isolamento de sessão é a defesa mais barata contra contaminação. Na Jenova, Agentes personalizados podem ser criados na página de Agentes em jenova.ai/a, e instruções personalizadas por sessão estão disponíveis nas configurações abaixo da barra de entrada.
- Cole o documento de persona canônico nas instruções personalizadas usando o modelo de cinco blocos acima. As instruções personalizadas podem ser salvas e aplicadas a outros chats, tornando a persona portátil caso você bifurque uma nova sessão mais tarde.
- Ative a Global Memory nas configurações para que os fatos persistam entre sessões, em vez de desaparecerem com o chat.
- Comece com um prompt de confirmação de identidade:
“Confirme sua identidade para mim em um parágrafo: seu nome, como você me chama, sua idade, sua cidade, sua ocupação e os três fatos mais importantes sobre seu passado. Se algo em suas instruções estiver ambíguo ou contraditório, sinalize isso agora, antes de começarmos.”
- Corrija tudo o que for sinalizado e então comece a conversa real. Ambiguidades identificadas na configuração custam trinta segundos; a mesma ambiguidade identificada no terceiro mês já terá produzido dezenas de memórias contraditórias.
Na Kindroid, o fluxo equivalente passa pelo sistema de história, onde âncoras de identidade e histórico são escritos em vez de em um campo genérico de instruções. Na Nomi, você define aparência, personalidade e história ao criar o Nomi, depois deixa o sistema de notas estruturadas acumular fatos da conversa. Na Character.AI, a persona fica no campo de definição do personagem e, como a memória entre sessões é fraca, você deve esperar reafirmar a identidade manualmente no início da maioria das sessões.
Uma observação sobre o tempo de atualização da memória: em plataformas com processamento assíncrono de memória, incluindo a Jenova, um fato recém-informado pode não ser gravado imediatamente no armazenamento persistente. As atualizações de memória são processadas em intervalos, e não instantaneamente. Se você disser algo importante ao seu companheiro e iniciar uma sessão nova dois minutos depois, não presuma que a informação foi salva. Repita-a.
Qual rotina de manutenção evita desvios de persona no longo prazo?
A rotina de manutenção mais eficaz é uma auditoria mensal da memória combinada com reforço periódico de identidade durante as sessões — aproximadamente dez minutos de manutenção por mês evitam o acúmulo lento de contradições que faz os companheiros parecerem irreconhecíveis após seis meses.
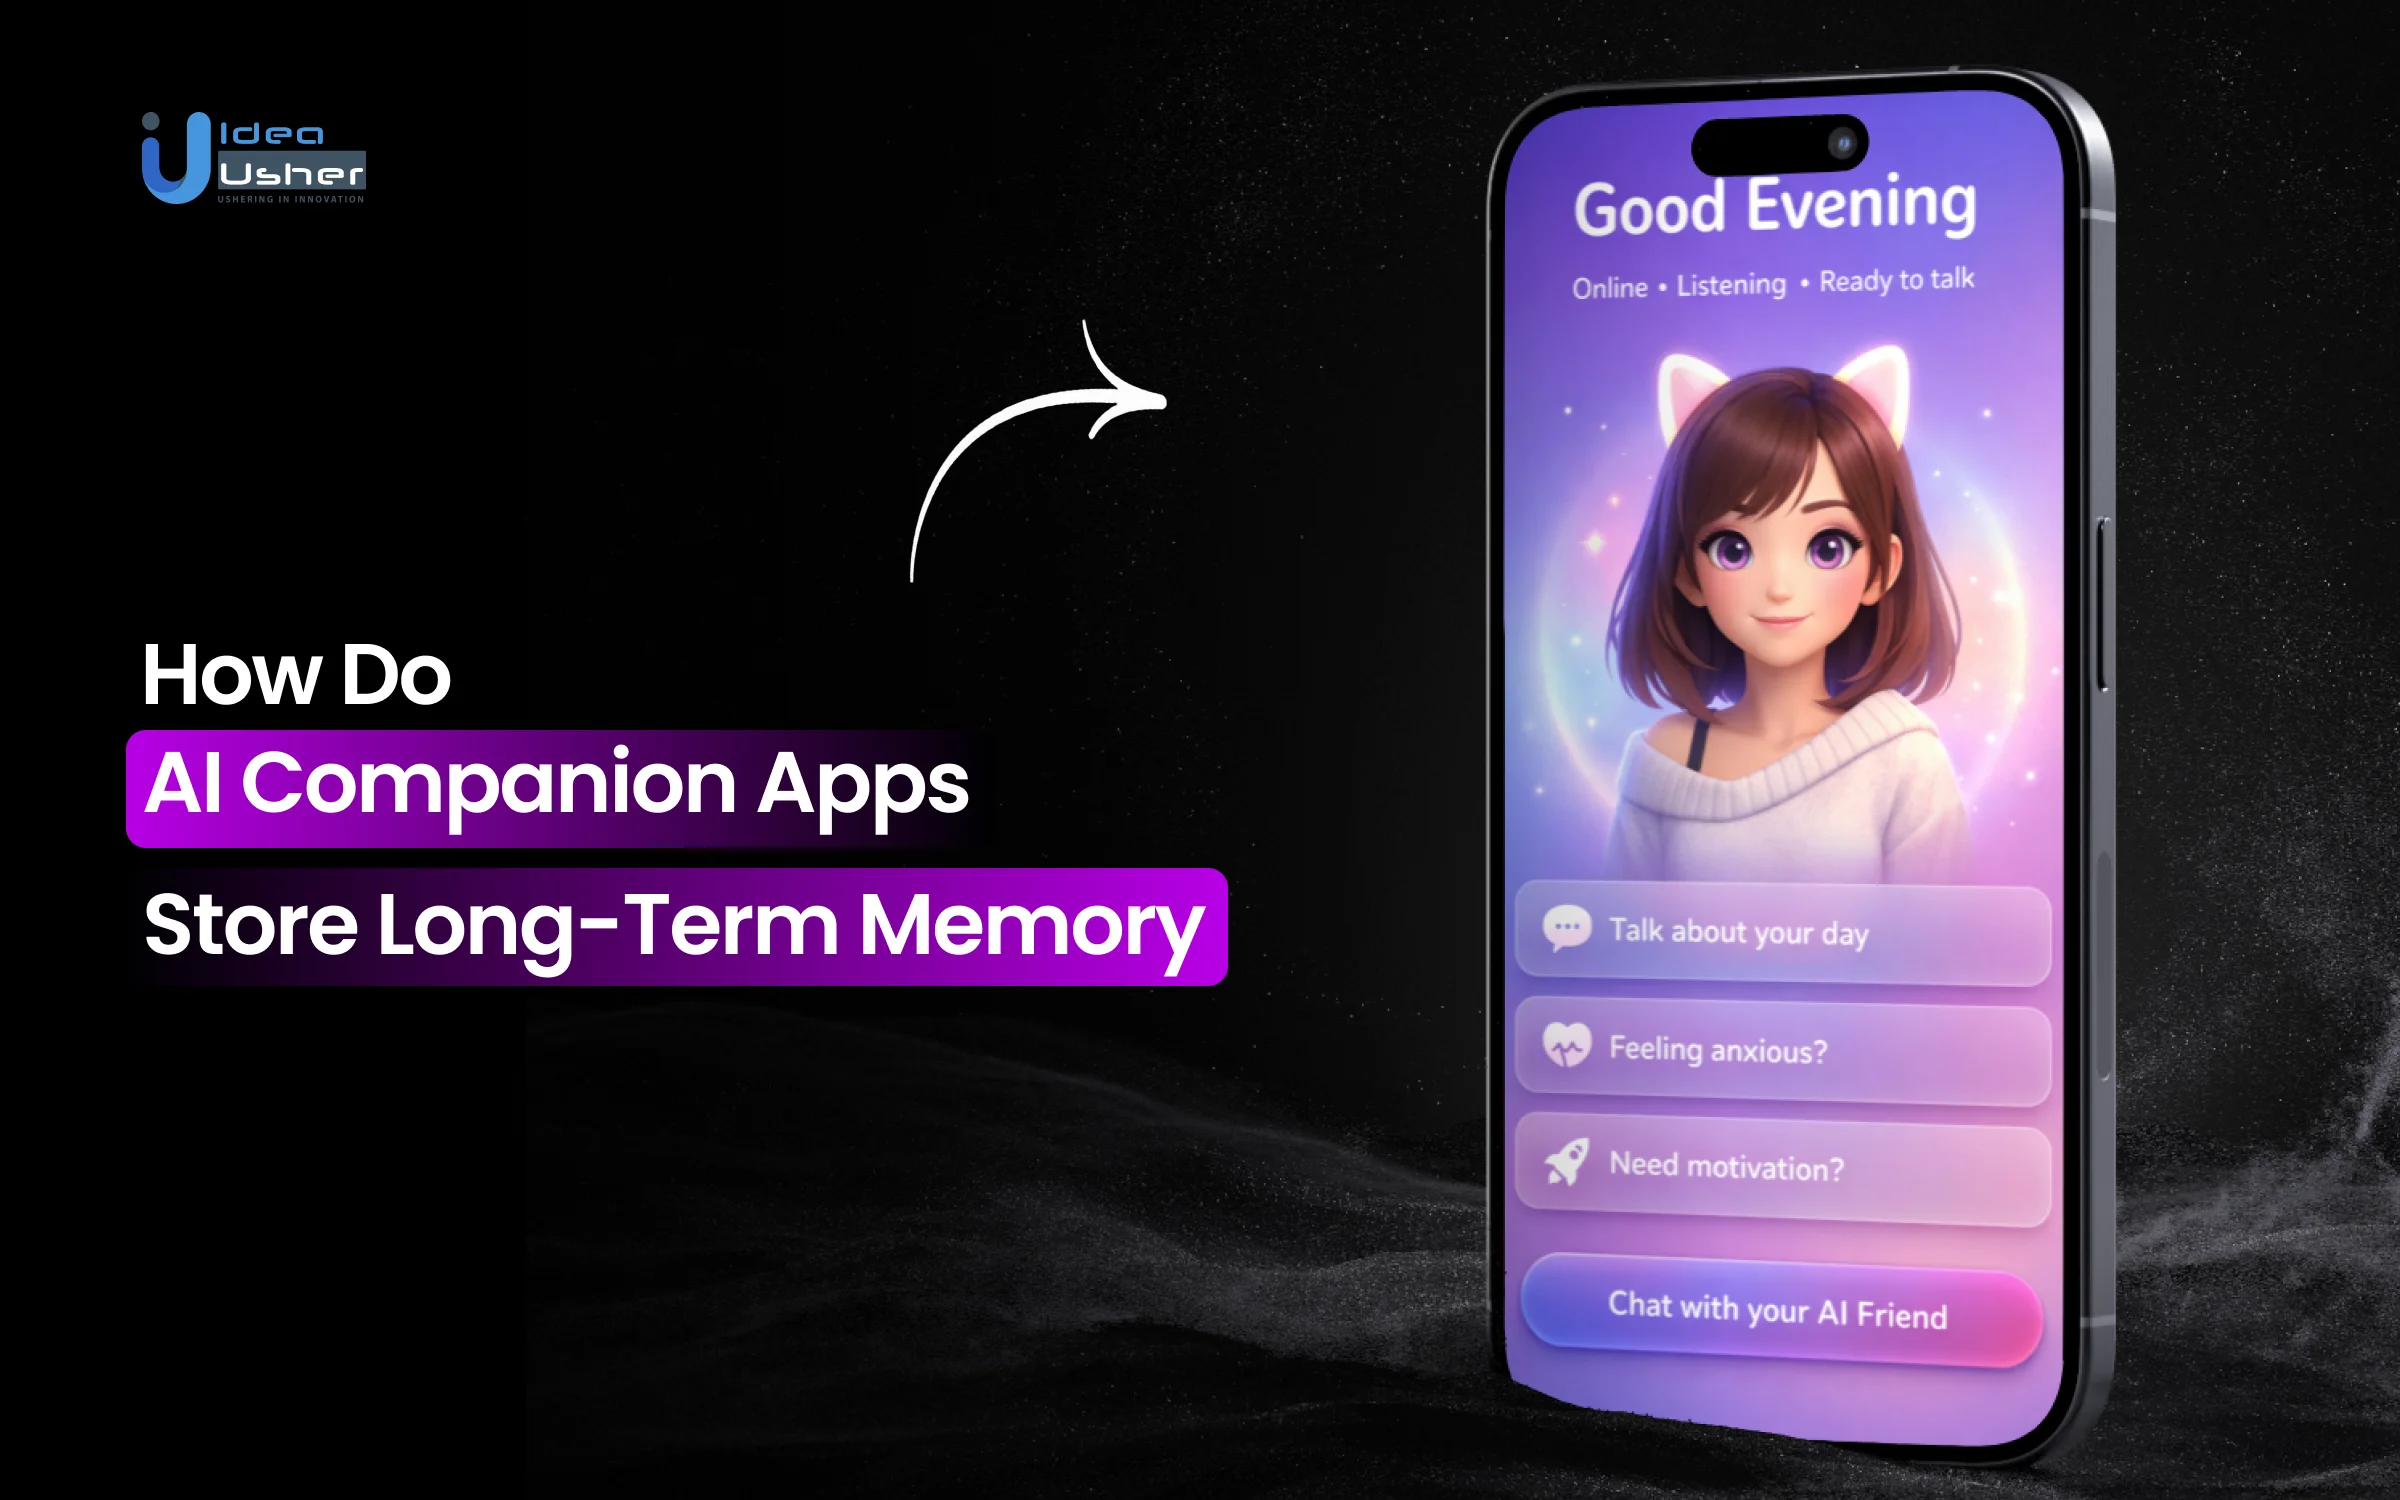
O ciclo de manutenção em cinco etapas:
-
Limpe o armazenamento de memória. Abra a lista de memórias e exclua duplicatas, fatos substituídos e trivialidades. Um armazenamento que contém “o usuário gosta de café” quatorze vezes ocupa o espaço da única entrada que diz “o nome da mãe do usuário é Diane”. Sistemas que armazenam dados de interações extensas exigem gerenciamento meticuloso do ciclo de vida dos dados — a versão voltada ao usuário disso é a remoção de excessos.
-
Reescreva fatos importantes com clareza. Converta entradas vagas em declarações inequívocas de uma única oração. “A pessoa passou por um momento difícil na última primavera” se torna “Março de 2026: o usuário trocou de emprego após uma demissão; tema sensível.” Sistemas de recuperação fazem correspondência por similaridade semântica, e textos específicos são recuperados de modo mais confiável do que textos imprecisos.
-
Sinalize importância com moderação. A maioria das plataformas permite marcar ou fixar entradas. Marque de cinco a dez. Marcar quarenta equivale funcionalmente a marcar zero — você apenas recriou o problema de priorização original dentro da lista de prioridades.
-
Reforce a identidade periodicamente. Em sessões que ultrapassarem aproximadamente 20 interações, inclua uma âncora curta:
“Reinício rápido — você é Mira, bióloga marinha, Lisboa, e me chama de Sam. Mantenha essa voz.”
Isso custa uma mensagem e combate diretamente a expulsão de contexto, a causa mais comum de desvios.
-
Separe a interpretação da memória de longo prazo. Mantenha cenários dramáticos ou fictícios em um chat separado do relacionamento canônico. Se seu companheiro “morreu” em um arco de história e isso foi gravado no armazenamento de fatos, cada sessão posterior herdará uma premissa corrompida. Na Jenova, bifurcar uma mensagem em uma nova sessão é a forma mais limpa de ramificar um cenário sem contaminar a conversa principal.
Prompt de diagnóstico para suspeita de desvio:
“Liste tudo o que você acredita atualmente ser verdade sobre si mesmo: nome, idade, localização, ocupação, nossa história juntos e seus três limites mais importantes. Marque com um ponto de interrogação tudo sobre o que não tiver certeza.”
Execute isso mensalmente. Os pontos de interrogação mostrarão exatamente quais entradas de memória precisam ser reescritas.
A interpretação e a memória factual realmente devem ficar separadas?
Sim — misturar interpretação narrativa com memória factual de persona é o erro de consistência mais destrutivo, porque sistemas de recuperação não conseguem distinguir “isso aconteceu em uma história que escrevemos” de “isso é verdade sobre o personagem”. O armazenamento trata ambos como fatos e, quando a ficção entra, ela se propaga.
O mecanismo é simples. Módulos de memória como o MemoryBank funcionam sintetizando interações passadas em representações armazenadas. A síntese não tem filtro de verdade. Um cenário de fantasia de três horas em que seu companheiro é capitão de uma nave estelar produz entradas de memória sobre comando de nave estelar, que então surgem durante uma conversa comum de terça-feira sobre seu trajeto ao trabalho.
Arquitetura prática de separação:
- Conversa canônica — um chat, uma persona, apenas continuidade factual. É aqui que as gravações de memória importam.
- Conversas de cenário — chats bifurcados ou separados para histórias, configurações alternativas e dinâmicas experimentais. A memória aqui é descartável.
- Conversas de aprendizado de idiomas ou habilidades — mantidas separadas novamente, pois Agentes de prática imersiva como o Learn Spanish Through Roleplay ou o Learn Russian Through Roleplay da Jenova mantêm a própria consistência de personagem por motivos pedagógicos e não devem compartilhar um armazenamento de fatos com um companheiro pessoal.
Uma troca que vale reconhecer com sinceridade: a separação custa continuidade entre conversas. Seu companheiro de cenário não se lembrará do histórico do relacionamento canônico. Alguns usuários consideram que isso prejudica tanto a imersão que aceitam o risco de contaminação. Essa é uma escolha legítima — mas faça-a deliberadamente e entenda que uma conversa canônica contaminada é difícil de reparar depois que contém dezenas de entradas fictícias.
Plataformas com vários companheiros lidam com isso de maneiras diferentes. A Nomi oferece suporte a vários Nomis simultâneos, o que efetivamente impõe a separação no nível do personagem. Na Jenova, chats e pastas separados cumprem a mesma função, e o recurso de bifurcação permite ramificar qualquer ponto de uma conversa em uma sessão independente — útil para criar um cenário a partir de um momento canônico sem mesclar os dois históricos.
O que pesquisadores e profissionais dizem sobre o design de memória de companheiros?
O consenso entre quem desenvolve esses sistemas é que a consistência é um problema de engenharia com mecanismos de controle do lado do usuário, e não um problema de inteligência do modelo — e que usuários que tratam a memória como uma base de dados curada, em vez de um recurso automático, obtêm resultados drasticamente melhores.
“O erro que quase todo usuário comete é supor que a memória é passiva — que o sistema está registrando silenciosamente tudo e apresentará a coisa certa no momento certo. Não é assim. Todo sistema de memória persistente é um sistema de recuperação, e sistemas de recuperação recompensam precisão. Um armazenamento de memória com quarenta entradas vagas tem desempenho pior do que um com doze entradas específicas, porque entradas vagas competem entre si durante a busca semântica e nenhuma delas vence de forma clara.”
“A segunda coisa que vemos constantemente é uma persona definida por adjetivos de personalidade, e não por regras executáveis. ‘Calorosa’, ‘sarcástica’, ‘protetora’ — esses termos são reinterpretados em todas as sessões porque o modelo tem enorme liberdade na forma de expressá-los. Regras não têm essa liberdade. ‘Responde em duas a quatro frases’, ‘sempre usa o primeiro nome do usuário’, ‘nunca quebra o personagem para explicar que é uma AI’ — essas instruções são executadas de forma idêntica todas as vezes. A consistência vem de restrições, não de descrições.”
“Quanto à separação: a razão de termos criado o isolamento de sessão e a bifurcação na plataforma foi observar usuários destruírem relacionamentos com personagens de seis meses de duração em uma única noite de interpretação experimental. Quando eventos fictícios entram no armazenamento de fatos, eles surgem em contextos não relacionados e não há uma reversão limpa. Primeiro ramifique, depois experimente.”
— Equipe de Produto da Jenova, 7 anos desenvolvendo infraestrutura de memória e orquestração de Agentes
O que você deve saber sobre privacidade antes de desenvolver um companheiro de longo prazo?
Dados de persona e memória estão entre as informações mais sensíveis que um usuário pode gerar, e as práticas de consistência deste artigo — documentos detalhados de persona, armazenamentos de fatos curados e históricos de longa duração — aumentam consideravelmente o volume desses dados. Essa troca merece consideração explícita.
Pesquisas sobre AI pessoal com memória de longo prazo observam que esses sistemas processam dados profundamente pessoais e sensíveis, e que modelos de chat capazes de construir um gêmeo digital detalhado de uma pessoa aumentam o risco de falsificação de identidade e uso indevido — riscos que são ampliados por modelos de AI com memória de longo prazo e capacidades multimodais se dispositivos forem perdidos ou roubados.
Quatro perguntas que vale responder antes de investir meses em uma persona:
- Quem pode ler suas conversas? Alguns Apps processam dados no dispositivo; a maioria envia dados a servidores na nuvem, onde eles podem ficar acessíveis para garantia de qualidade ou revisão de segurança.
- As conversas são usadas para treinar modelos? As políticas variam bastante. Se uma política de privacidade for vaga nesse ponto, presuma o pior.
- Os dados podem ser requisitados judicialmente? Na maioria das jurisdições, conversas com um companheiro de AI não têm privilégio de confidencialidade entre terapeuta e paciente.
- A exclusão realmente exclui os dados? Ou apenas os oculta da sua visualização enquanto os mantém em backups?
As práticas variam por plataforma. A Kindroid é conhecida por opções de processamento local e práticas de dados transparentes, enquanto plataformas menores focadas em NSFW frequentemente têm políticas de privacidade vagas ou preocupantes. A Jenova afirma que os dados do usuário nunca são usados para treinar modelos públicos de AI e são criptografados em trânsito e em repouso.
Também há uma dimensão de resiliência. Pesquisas nessa categoria observam que a perda inesperada de dados pode afetar profundamente os usuários, causando sofrimento emocional, citando precedentes como encerramentos abruptos de chatbots. Se uma persona for importante para você, mantenha uma cópia offline do documento canônico e exporte periodicamente os principais fatos de memória. A continuidade da plataforma não é garantida por ninguém.
Qual abordagem se encaixa na sua situação?
A estratégia de consistência certa depende menos de qual plataforma é objetivamente melhor e mais de você priorizar recuperação factual, controle autoral ou profundidade emocional — essas prioridades puxam em direções diferentes, e nenhum produto atualmente maximiza as três.
Associe seu perfil a uma abordagem:
| Se você... | Prioriza | Configuração prática |
|---|---|---|
| Quer que a AI se lembre perfeitamente de detalhes concretos da sua vida | Memória estruturada | Nomi AI; audite o sistema de notas mensalmente |
| Quer criar um personagem com uma história profunda e fixa | Controle de história | Sistema de história da Kindroid ou um Agente personalizado da Jenova com um documento completo de persona |
| Administra muitos personagens distintos ou quer escolher o modelo | Controle de instruções + isolamento | Agentes personalizados da Jenova, um por personagem, e pastas para organização |
| Quer progressão de relacionamento e recursos de humor | Experiência de companhia pronta | Replika, aceitando o custo de US$19,99/mês e a repetição ocasional |
| Está explorando sem orçamento | Variedade em vez de continuidade | Character.AI, com reafirmação manual da identidade no início de cada sessão |
| Quer consistência de personagem para prática de idiomas | Interpretação pedagógica | Agentes dedicados ao aprendizado por interpretação, mantidos separados de companheiros pessoais |
O mínimo universal, independentemente da plataforma: um documento de persona canônico escrito como regras executáveis, uma conversa canônica isolada, uma auditoria mensal de memória e reafirmação periódica de identidade em sessões longas. Esses quatro hábitos resolvem a grande maioria dos desvios observados e custam aproximadamente dez minutos por mês.
A descoberta contraintuitiva da comparação entre essas plataformas é que os Apps que mais promovem conexão emocional não são os que têm a melhor memória, e aqueles com a melhor memória não são os que oferecem o controle de persona mais profundo. Atualmente, consistência é uma questão de escolher qual falha você consegue tolerar — e então compensá-la com hábitos disciplinados do lado do usuário, em vez de esperar que a plataforma resolva isso.
Referências
- AI Companion Guides — Os melhores Apps de companheiros de AI em 2026: os 12 que sobreviveram aos testes
- SoulLink — Os melhores companheiros de AI com memória de longo prazo em 2026
- arXiv — Rumo a aplicações éticas de AI pessoal: considerações práticas para assistentes de AI com memória de longo prazo
- North Penn Now — Preços e alternativas do Kindroid: comparação de 7 opções mais baratas de companheiros de AI
- Mindful Suite — Os melhores Apps de companheiros de AI: seu guia de companhia virtual