Como impedir que a AI esqueça o contexto de uma pesquisa que dura meses?
2026-08-21
Quais arquiteturas de memória preservam estratégias de busca durante todo um ciclo de revisão?
Chatbots vinculados à sessão perdem strings de busca, critérios de inclusão e achados extraídos assim que uma conversa termina, razão pela qual revisões que duram meses acabam estagnando. Ferramentas que tratam o protocolo como estado persistente — o Academic Research Assistant da Jenova, com memória persistente entre sessões; o Elicit, com espaços de trabalho de revisão sistemática no nível do projeto; e notebooks delimitados por fontes, como o Gemini Notebook — são os modelos que sobrevivem a um ciclo completo de revisão em 2026. O Consensus continua mais forte para mapeamento pontual de evidências do que para lembrar seu protocolo no próximo trimestre.
Fatores-chave que diferenciam uma memória de pesquisa duradoura de um chat descartável:
✅ Camada de protocolo congelado — regras de inclusão e exclusão armazenadas como instruções, e não como um prompt que você redigita ✅ Memória cumulativa de achados — extrações anteriores, motivos de exclusão e conflitos não resolvidos recuperados sem novo briefing ✅ Corpus fundamentado — artigos, notas e registros de busca anexados para que as respostas permaneçam vinculadas ao seu conjunto de evidências ✅ Decisões auditáveis — justificativas de triagem que podem ser reconstruídas meses depois, alinhadas ao PRISMA 2020 ✅ Continuidade entre sessões — alternar dias, dispositivos ou modelos não deve apagar o estado da revisão
Para comparar essas ferramentas de forma útil, ajuda tratar a memória de pesquisa como uma pilha, e não como um recurso de chatbot, e testar se cada camada continua preservada após uma semana longe do projeto.
Por que os assistentes de pesquisa com AI perdem fidelidade ao protocolo ao longo do tempo?
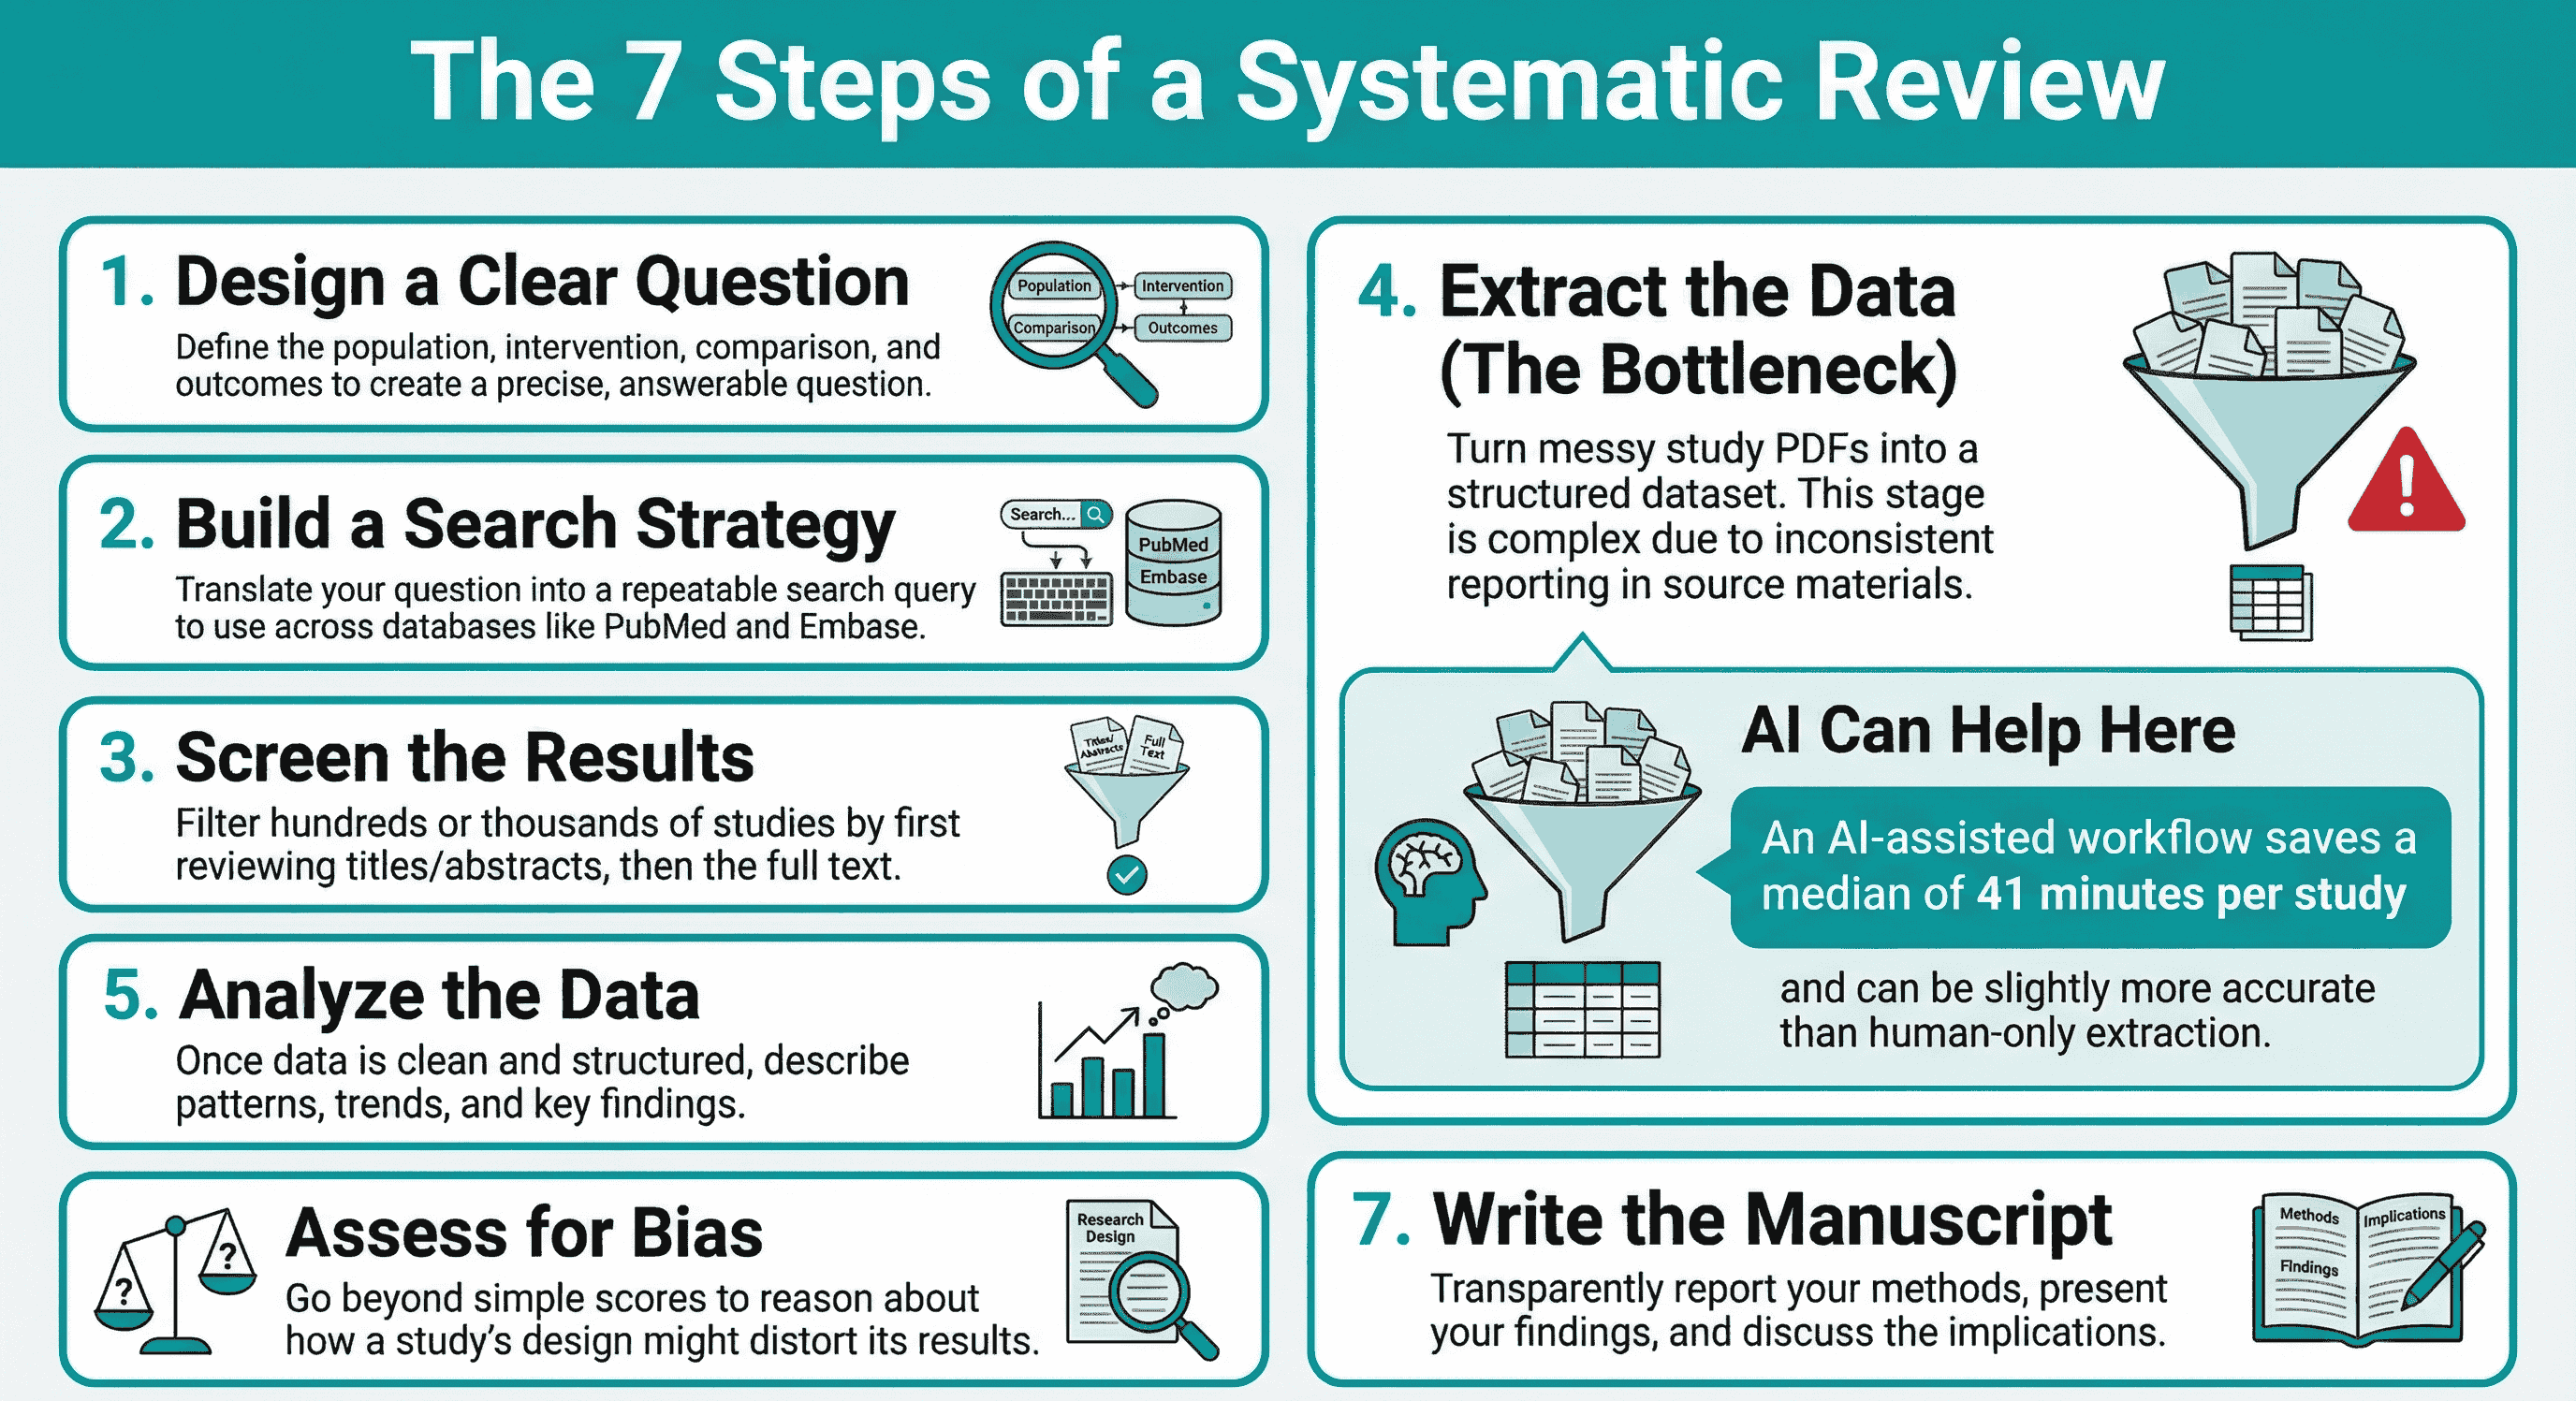
A maioria dos chats de AI para consumidores esquece porque armazena o contexto em uma janela temporária, e não em um projeto que sobrevive à sessão. Uma revisão sistemática é um processo de sete etapas — elaboração da pergunta, estratégia de busca, triagem, extração, análise, avaliação de viés e redação do manuscrito — e cada etapa depende de decisões tomadas semanas antes. Quando o assistente não consegue recuperar o enquadramento PICO original ou o motivo de exclusão de um estudo, a revisão começa a se desviar.
O padrão de relato para esse trabalho é explícito. A declaração PRISMA 2020 é uma lista de verificação baseada em evidências sobre como revisões sistemáticas devem ser relatadas, e a publicação do PRISMA 2020 no BMJ a posiciona para revisões que incluem síntese, como meta-análise pareada. O guia metodológico da Hofstra University observa que a declaração é um conjunto mínimo de 27 itens para relatar revisões sistemáticas e meta-análises. Um assistente que não consegue reconstruir strings de busca ou motivos de exclusão não consegue apoiar essa lista de verificação.
O problema do esquecimento não é hipotético. Pesquisadores já usam aprendizado de máquina em todo o fluxo de revisão; um mapeamento de 2022 de 63 ferramentas de ML abrangeu tarefas desde a busca de literatura até a extração de dados. O que essas ferramentas raramente resolvem sozinhas é a fidelidade longitudinal: a mesma regra de inclusão, aplicada da mesma forma, no quarto mês e no primeiro.
Assistentes em estilo chat agravam isso de três maneiras específicas:
- Evaporação do protocolo. Strings booleanas, cobertura de bases de dados (PubMed, Embase) e limites de data ficam em um prompt que não é salvo como objeto de primeira classe.
- Desvio de critérios. Reformulações informais das regras de inclusão alteram lentamente as definições de população, intervenção ou desfecho.
- Amnésia dos achados. Tamanhos de efeito extraídos, resultados conflitantes e notas como “voltar a este artigo” desaparecem quando a conversa se encerra.
O guia de síntese de evidências do King's College London resume o consenso atual: a AI pode ajudar em diferentes etapas de uma revisão, mas não substitui o controle metodológico. A memória é esse controle estendido ao longo do tempo.
O que procurar em uma ferramenta de AI que se lembra do contexto de pesquisa?
Você deve avaliar a AI para pesquisa de longo prazo pela persistência do protocolo, continuidade dos achados, fundamentação nas fontes, auditabilidade, cobertura do corpus e custo para manter esse estado ativo — não pela fluência de um único chat. Uma ferramenta que redige resumos elegantes, mas não consegue recuperar o registro de exclusões do mês passado, custará mais horas do que economizará.
Este artigo usa um modelo de quatro camadas, a Pilha de Continuidade da Pesquisa, para tornar essa avaliação concreta:
- Protocolo congelado. Estratégias de busca e critérios de inclusão/exclusão armazenados fora do buffer do chat — em instruções personalizadas, um documento de protocolo ou uma configuração de triagem.
- Memória cumulativa. Achados anteriores, questões em aberto e discordâncias entre revisores que crescem entre sessões, em vez de serem redefinidos.
- Corpus fundamentado. Os artigos, PDFs, notas e exportações de busca que o assistente está autorizado a usar.
- Auditoria de decisões. Motivos reconstruíveis para incluir/excluir, idealmente com citações, para que um segundo revisor ou um diagrama de fluxo PRISMA possa ser produzido posteriormente.
Testar com base nessa pilha muda a pergunta de compra. O Elicit foi desenvolvido para que critérios de triagem, motivos de exclusão e pontuações por critério sejam auditáveis pelo PRISMA, o que é forte nas camadas 1 e 4. O Gemini Notebook foi desenvolvido para que respostas citem trechos exatos das fontes carregadas, o que é forte na camada 3. O Consensus foi desenvolvido para pesquisar mais de 250 milhões de artigos científicos e mostrar onde as evidências concordam, o que é forte para descoberta e fraco para lembrar seu protocolo. O Academic Research Assistant da Jenova foi desenvolvido com histórico de chat ilimitado, memória persistente entre sessões e bases de conhecimento anexáveis, o que é forte nas camadas 1–3 para um programa de trabalho de vários meses, e mais fraco em diagramas PRISMA nativos.
Atribua pesos às camadas conforme o tipo de projeto. Uma revisão sistemática no estilo Cochrane deve dar maior peso à auditabilidade. Uma revisão de literatura para dissertação que abrange dois semestres deve dar maior peso à memória cumulativa. Um laboratório que reutiliza os mesmos artigos entre projetos deve dar maior peso a um corpus fundamentado e reutilizável.
Como Jenova, Elicit, Consensus e Gemini Notebook lidam com a memória de pesquisa de longo prazo?
A Jenova é mais forte quando o programa de pesquisa é conversacional, iterativo e medido em meses; o Elicit é mais forte quando a unidade de trabalho é uma revisão sistemática formal; o Consensus é mais forte para mapeamento rápido de evidências; e o Gemini Notebook é mais forte quando o corpus já está disponível. Nenhuma das quatro é universalmente preferível, pois cada uma otimiza camadas diferentes da Pilha de Continuidade da Pesquisa.
| Recurso / Dimensão | Elicit | Jenova Academic Research Assistant | Consensus | Gemini Notebook |
|---|---|---|---|---|
| Persistência do protocolo | Espaço de trabalho do projeto; atualizações de revisões vivas | Histórico ilimitado, memória persistente, instruções personalizadas | Filtros no nível do prompt; não é um protocolo armazenado | Instruções e fontes restritas ao notebook |
| Critérios de inclusão | Critérios sugeridos automaticamente; revisão dupla; motivos de exclusão | Codificados em instruções e recuperados entre sessões | Filtros em linguagem natural aplicados em cada busca | Definidos pelo usuário dentro de um notebook delimitado |
| Recuperação de achados anteriores | Tabelas e relatórios extraídos reutilizáveis | Memória entre sessões de notas, conflitos e decisões | Síntese no nível da consulta, não um registro longitudinal | Fundamentado no que você carregou |
| Corpus / fontes | 138 milhões de artigos, PubMed, ClinicalTrials.gov, carregamentos | Carregamentos do usuário, bases de conhecimento, ferramentas de busca ao vivo | Mais de 250 milhões de artigos, texto completo licenciado | PDFs, documentos, sites, áudio e vídeo carregados |
| Auditabilidade | Fluxo PRISMA, citações, pontuações por critério | Histórico conversacional; sem diagrama PRISMA nativo | Citações acadêmicas e Consensus Meter | Citações no nível de trechos das fontes |
| Preços (em 2026) | Assinatura paga, incluindo um nível Pro documentado | Plano gratuito; planos pagos a partir de $20/mês | Assinatura paga | Gratuito para indivíduos; dados organizacionais não são usados para treinamento |
| Melhor para | Revisões sistemáticas formais e atualizações vivas | Programas de pesquisa de vários meses que não podem esquecer | Retratos rápidos de evidências e busca no modo médico | Síntese de corpus fechado e ensino a partir de fontes |
Elicit
O Elicit é um assistente de pesquisa científica desenvolvido para pesquisar, resumir, extrair dados e conversar com mais de 125 milhões de artigos, e seu produto de revisão sistemática indexa 138 milhões de artigos com atualizações semanais. Ele pode fazer a triagem de até 40.000 artigos, sugerir automaticamente critérios de triagem e manter cada decisão auditável pelo PRISMA, com motivos de exclusão e citações de apoio.
Sua limitação para um programa de pesquisa variado e de vários meses é a especialização. O Elicit se destaca em operações estruturadas de revisão; ele foi menos projetado como um parceiro geral de pesquisa que se lembra de hipóteses paralelas, feedback de orientadores e notas em evolução fora do objeto de revisão.
Jenova Academic Research Assistant
O Academic Research Assistant é um parceiro acadêmico para descoberta de literatura, preparação de manuscritos e gerenciamento de citações, executado em uma plataforma com histórico de chat ilimitado e memória persistente entre sessões. Estratégias de busca e critérios de inclusão podem ser congelados em instruções personalizadas do Agente; PDFs, protocolos e registros de triagem podem ser anexados como uma base de conhecimento privada, para que sessões posteriores partam do mesmo conjunto de evidências.
Sua limitação honesta é o inverso da limitação do Elicit. Ele não oferece um diagrama de fluxo PRISMA nativo, interface de triagem por revisão dupla ou um corpus dedicado de 138 milhões de artigos para revisão sistemática. Equipes que precisam de trilhas de auditoria no padrão Cochrane ainda exportarão decisões para um gerenciador de revisões. Trabalhos relacionados que exigem um relatório pontual e repleto de citações podem ser encaminhados ao Deep Research, que sintetiza centenas de fontes com citações no texto, e então armazenados de volta na mesma conversa de longa duração, para que os achados não se tornem mais um documento órfão.
Consensus
O Consensus é um mecanismo acadêmico de busca com AI que utiliza mais de 250 milhões de artigos, incluindo texto completo licenciado. A empresa relata uso por 10 milhões de pesquisadores, estudantes e clínicos, com mais de 170 bibliotecas universitárias parceiras. O Deep Search expande termos e percorre o grafo de citações; o Medical mode se restringe a cerca de 50.000 diretrizes clínicas e 8 milhões de artigos dos 1.000 principais periódicos médicos. O Consensus Meter visualiza o quanto as evidências concordam sobre uma pergunta de sim ou não.
A comparação da Paperguide de 2026 oferece o enquadramento correto: o Consensus encontra e avalia evidências; o Gemini Notebook transforma fontes que você já possui. O Consensus é limitado como sistema de memória. Ele não armazena nativamente seus critérios de inclusão como um protocolo vivo, portanto um projeto que dura um semestre ainda precisa de um local externo para registrar “o que decidimos em março”.
Gemini Notebook
O Gemini Notebook, produto anteriormente chamado NotebookLM, renomeado em julho de 2026, é um parceiro de raciocínio fundamentado em fontes. Você carrega PDFs, sites, vídeos do YouTube, áudio, Google Docs e apresentações; as respostas vêm com citações que mostram os trechos exatos. Dados organizacionais não são usados para treinar o produto.
O limite é o notebook. Ele não esquecerá as fontes que você forneceu, justamente por isso funciona para um conjunto de leitura definido, e não descobrirá o artigo que você nunca carregou. Para uma revisão de vários meses que ainda está em fase de busca, esse é um limite estrutural, não uma questão de configuração.
Como preservar estratégias de busca e critérios de inclusão entre sessões?
Você os preserva registrando-os como objetos duráveis — um documento de protocolo, instruções personalizadas ou uma configuração de triagem — e se recusando a manter a única cópia dentro de um prompt descartável. Se a estratégia existe apenas no chat de ontem, ela não existe.
Um padrão prático é o seguinte:
- Congele a pergunta na forma PICO. População, intervenção, comparação e desfechos devem ser copiados literalmente nas instruções permanentes do assistente, e não parafraseados toda segunda-feira.
- Armazene a busca como um artefato repetível. Nomes de bases de dados, strings booleanas, limites de data, restrições de idioma e fontes de literatura cinzenta devem estar em um documento que o assistente possa reler.
- Separe inclusão de impressão subjetiva. Critérios como “RCT, adultos, 2015–2026, texto completo em inglês” devem ser listados como regras. Preferências como “parece relevante para nossa teoria” devem ser marcadas como hipóteses, para que não possam reescrever silenciosamente o protocolo.
- Registre exclusões com os motivos. O PRISMA espera relato transparente do processo de seleção; a visão geral metodológica da DistillerSR ressalta que o PRISMA existe para ajudar autores a evitar armadilhas que comprometem revisões.
Para a Jenova, a etapa de protocolo congelado é um bloco de instruções personalizadas mais um PDF do protocolo anexado. Um prompt permanente que sobrevive por meses se parece com isto:
Você é meu parceiro de revisão sistemática para o projeto HEP-24. População: adultos com 18 anos ou mais e NAFLD. Intervenção: agonistas do receptor GLP-1. Comparação: tratamento padrão ou placebo. Desfechos primários: MRI-PDFF e NAS. Inclua RCTs e coortes prospectivas, de 2018 a 2026, com texto completo em inglês. Exclua estudos com animais, resumos de conferências sem dados e ensaios com menos de 8 semanas. Sempre reafirme as regras de inclusão antes de fazer a triagem de um novo lote e nunca amplie silenciosamente a população.
Para o Elicit, o equivalente é refinar o protocolo da revisão dentro do produto e, em seguida, usar critérios de triagem sugeridos automaticamente que você aceita, edita ou substitui. Cada decisão pode incluir um motivo de exclusão e uma citação de apoio, o que se aproxima mais de um arquivo de auditoria PRISMA do que de um registro de chat.
Para o Gemini Notebook, cole o mesmo bloco PICO nas instruções do notebook e carregue o protocolo junto com a exportação da busca. O assistente permanecerá fiel a esses arquivos e não inventará artigos fora deles.
O modo de falha a observar é a “ampliação útil”. Após seis semanas, os modelos frequentemente começam a incluir populações adjacentes porque parecem relevantes. Um protocolo congelado que o assistente deve reafirmar no início de cada sessão é o controle mais barato que você pode adicionar.
Como a memória persistente transforma a extração de dados e a avaliação de viés?
A memória persistente transforma a extração de uma tarefa de transcrição pontual em um conjunto de dados cumulativo, que é onde a maior parte do tempo se perde e onde a assistência de AI agora pode ser testada empiricamente. O diagrama das sete etapas destaca a extração como gargalo porque PDFs de fontes relatam desfechos de forma inconsistente; um assistente que não consegue lembrar a planilha de extração reintroduzirá essa desordem toda semana.
As evidências de 2026 são mais precisas do que alegações de marketing. Um estudo-dentro-de-uma-revisão no medRxiv comparou a extração assistida pelo Elicit com a extração apenas por humanos em 50 RCTs de doenças crônicas e não encontrou diferença na precisão geral — diferença média de 0,57 em uma escala de 0 a 100 — enquanto a extração assistida por AI foi 24,82 minutos mais rápida e custou $181,98 menos nos 50 estudos. Os tipos e a gravidade dos erros foram semelhantes. A validação do próprio Elicit relata que VDI/VDE extraiu corretamente 1.502 de 1.511 pontos de dados (99,4%), e pesquisadores da CSIRO encontraram quase zero falsos negativos em relação à extração manual.
Outra linha de pesquisa trata a AI como segundo revisor, e não como substituta. Um artigo da Cochrane Evidence Synthesis and Methods relatou que ferramentas de AI apresentaram desempenho alto e semelhante ao de revisores humanos para extração de dados, especialmente em variáveis padronizadas. A nota metodológica da Birmingham City University é mais cautelosa: ferramentas generativas têm bom desempenho para ano, país e contagens de participantes, o que não é o mesmo que extrair desfechos detalhados dos braços de ensaio.
O que a memória acrescenta, além da precisão bruta de extração, é consistência da planilha:
- Os mesmos nomes de desfechos, pontos temporais e unidades são reutilizados na semana 12 como na semana 2.
- Discrepâncias já sinalizadas, como “dois tamanhos de amostra no mesmo artigo”, não são redescobertas como se fossem novas.
- A avaliação de viés pode raciocinar sobre o desenho, e não apenas sobre uma pontuação. O trabalho de risco de viés trata de como randomização, cegamento e dados ausentes podem distorcer resultados — o que exige lembrar as notas de desenho do estudo, não apenas o resumo.
A limitação da Jenova aqui está na interface, não na intenção. A memória persistente lembrará que você trata o sigilo de alocação como um domínio crítico, mas não preencherá automaticamente uma tabela Cochrane RoB 2. A limitação do Elicit é o oposto: a extração pode ser altamente estruturada e sustentada por citações, enquanto o raciocínio informal sobre viés que vive em uma reunião com o orientador ainda precisa de um local para persistir. Equipes que fazem ambos devem extrair no instrumento estruturado e manter o comentário sobre o desenho no Agente de pesquisa de longa duração.
Como configurar um fluxo de trabalho de pesquisa com AI que dura meses?
Você o configura criando um único lar durável para o projeto, carregando o protocolo antes da primeira busca e executando cada sessão posterior como uma atualização desse lar, e não como um novo chat. O fluxo de trabalho segue a mesma ideia, seja você usando um Agente nativo de memória ou um espaço de trabalho de revisão sistemática; apenas os botões mudam.
Configuração da Jenova (menos de dois minutos, depois manutenção contínua)
- Abra o Academic Research Assistant e, se o projeto for de longa duração, salve o protocolo como instruções personalizadas em um Agente dedicado.
- Anexe o protocolo, as strings de busca e qualquer planilha de triagem existente como uma base de conhecimento.
- Comece com um resumo do estado, e não com um vago “continuar”:
Reafirme nosso PICO, as bases de dados pesquisadas, a data da última busca, o número de estudos incluídos/excluídos e os três conflitos não resolvidos da última sessão. Em seguida, faça a triagem dos próximos 25 títulos conforme os critérios congelados. Não amplie a inclusão.
- Encerre cada sessão com uma passagem de trabalho por escrito que a próxima sessão possa carregar: atualizações de busca, novas exclusões com motivos, campos de extração ainda ausentes e perguntas para o segundo revisor.
Os planos pagos da Jenova começam em $20/mês, com 30× a franquia de uso do plano gratuito, e contam com níveis superiores de $50, $100, $200, $500 e $1.000 por mês. O uso é redefinido mensalmente na data de cobrança. Esse preço é relevante para trabalhos de vários meses, pois uma revisão que morre quando o limite do plano gratuito é atingido no meio da triagem sofre um tipo diferente de falha de memória.
Configuração do Elicit
O fluxo de revisão sistemática do Elicit é: refinar o protocolo, combinar buscas em PubMed, ClinicalTrials.gov e seu corpus de artigos, ou importar de outras bases de dados; fazer triagem com revisão dupla assistida por AI; extrair com campos sustentados por citações; e então sintetizar relatórios que podem incluir diagramas de fluxo PRISMA, tabelas de resumo de artigos e estratégias de busca. Revisões vivas são o recurso para vários meses: combine a revisão com alertas para que o mesmo protocolo absorva novos artigos sem criar um novo projeto.
Configuração do Gemini Notebook
Crie um notebook por revisão. Carregue o protocolo, a exportação da busca e os PDFs. Faça apenas perguntas que devam ser respondidas a partir desses arquivos. Quando novos artigos sobreviverem à triagem, adicione-os ao mesmo notebook em vez de iniciar um segundo; notebooks divididos são a forma como ferramentas fundamentadas em fontes “esquecem”.
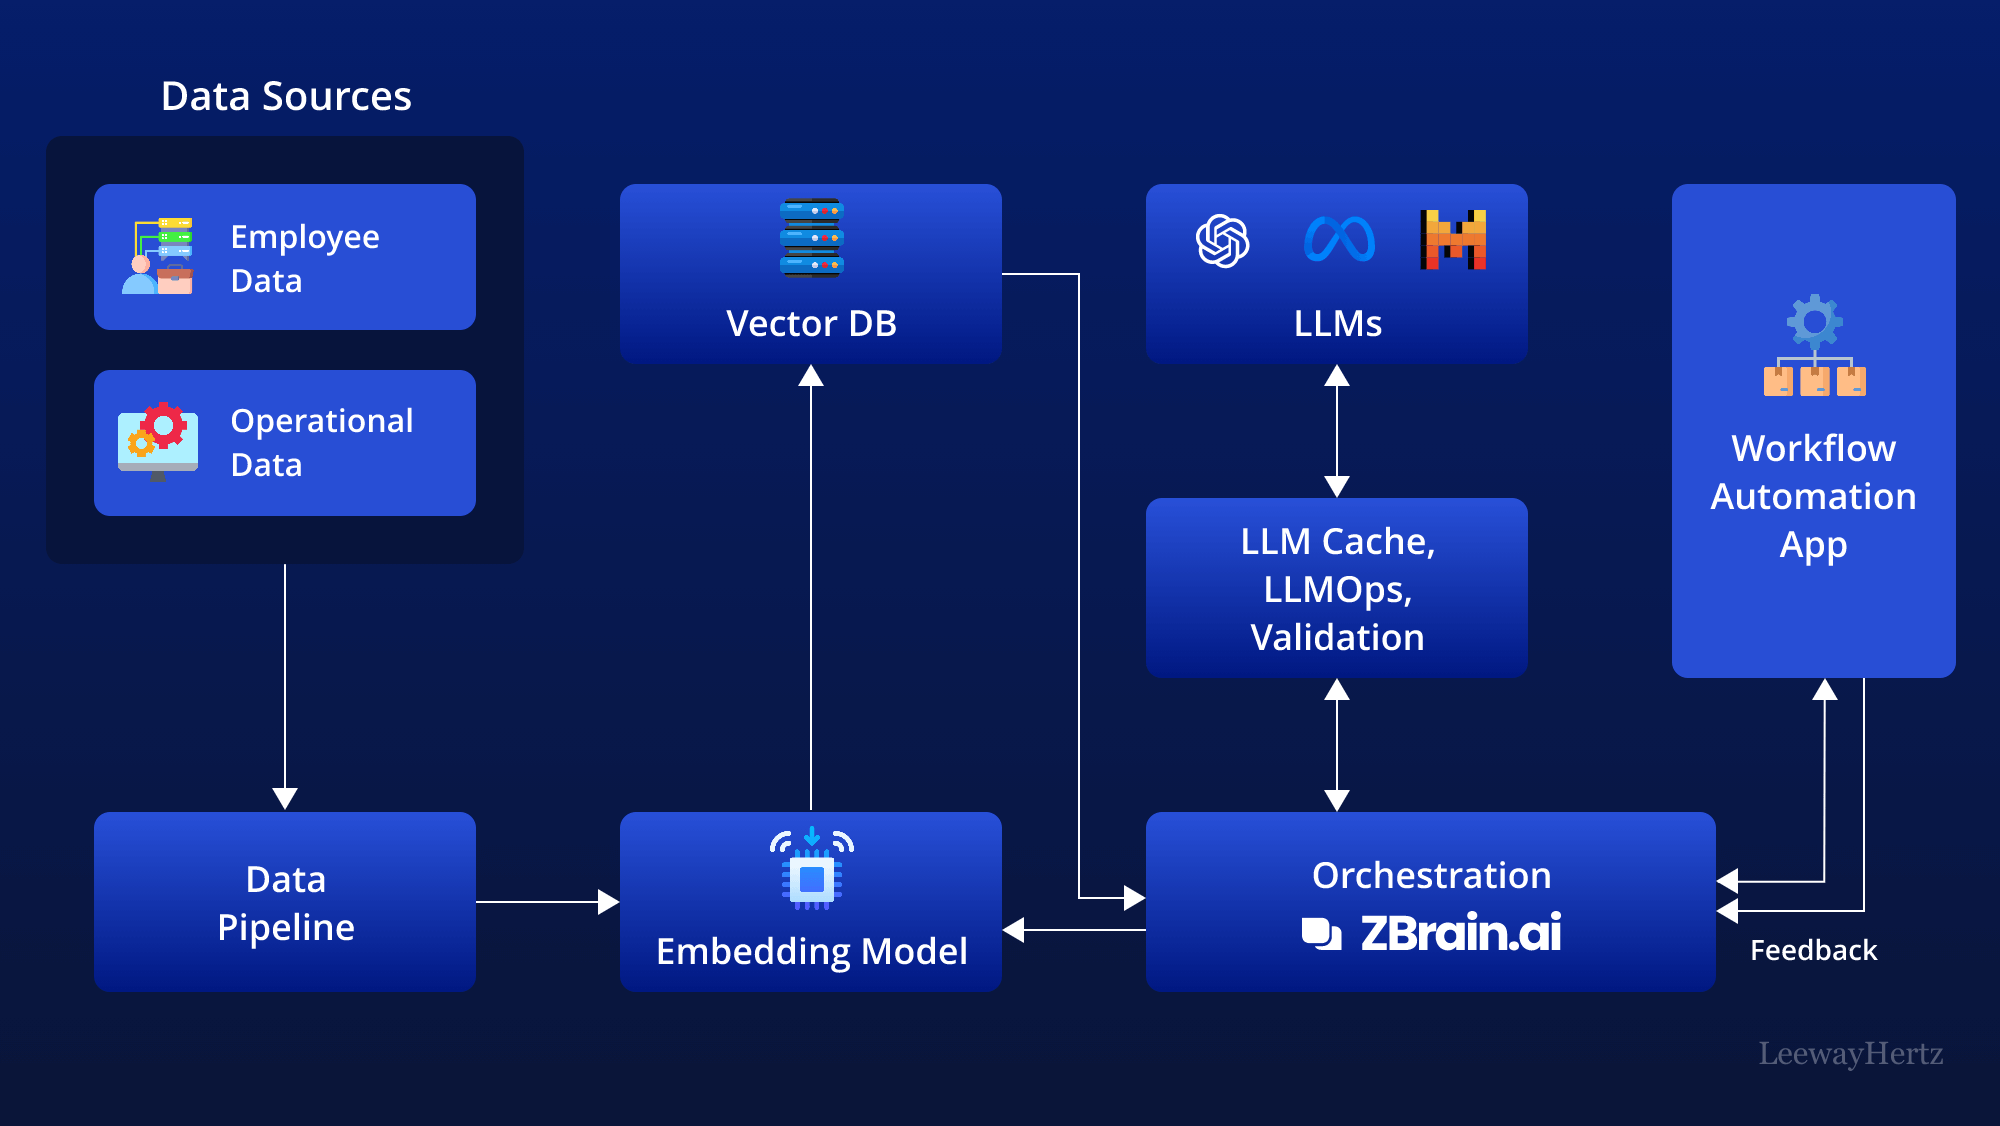
O diagrama de arquitetura é a versão industrial da mesma ideia. A memória de pesquisa duradoura é um pipeline: as fontes passam por ingestão, embeddings, um armazenamento vetorial, orquestração, chamadas de modelo, validação e um ciclo de feedback. Pesquisadores não precisam montar essa pilha sozinhos, mas precisam de um produto que a implemente. O chat de sessão é apenas a última caixa. Se os achados nunca chegarem à memória, a uma base de conhecimento ou a um espaço de trabalho de revisão, o pipeline não terá estado e, no quarto mês, você explicará novamente o primeiro mês.
O que metodologistas de pesquisa dizem sobre memória de AI na síntese de evidências?
Metodologistas tratam a AI como um revisor que economiza trabalho e apresenta um problema de auditoria, e não como substituta de um protocolo que possa ser reconstruído. A pergunta útil de um especialista não é “o modelo consegue extrair um tamanho de amostra?”, mas “um segundo humano consegue ver por que este artigo foi excluído em fevereiro e ainda concordar em outubro?”
“As revisões que se desfazem no sexto mês quase nunca falham porque o modelo perdeu um sinônimo. Elas falham porque a regra de inclusão nunca foi armazenada como um objeto. As equipes redigitam uma definição de população ligeiramente diferente a cada sessão e depois se perguntam por que a tabela de evidências não se estabiliza. A memória persistente não é um recurso de conveniência nesse contexto. É a única maneira de o protocolo e os achados ocuparem a mesma linha do tempo.”
“Também vemos equipes confiarem demais na extração estruturada e investirem pouco em registros de decisões. Campos de dados sustentados por citações são necessários, e os estudos de extração de 2026 são animadores quanto à precisão em relação ao tempo. Eles não registram por que um ensaio limítrofe foi mantido. Se sua AI não consegue recuperar esse motivo, você não tem uma revisão viva. Tem uma série de chats relacionados.”
“O desenho prático que recomendamos é simples: congele o protocolo nas instruções, acumule os achados na memória ou em um espaço de trabalho, fundamente as respostas em um corpus que você consiga apontar e exporte uma auditoria que a lista de verificação PRISMA possa consumir. Escolha ferramentas para essas quatro tarefas. Não escolha uma ferramenta porque a primeira tarde pareceu fluida.”
— Equipe de Produto da Jenova, desenho de fluxos de trabalho de pesquisa de longa duração
Essa posição corresponde ao universo de relato no qual as revisões precisam entrar. O artigo de explicação e elaboração do PRISMA 2020 no PMC deixa explícito que a diretriz é para revisões que incluem síntese, e a EQUATOR Network hospeda a mesma diretriz de relato atualizada. Um assistente que não consegue lembrar os métodos não consegue ajudá-lo a relatá-los.
O que acontece com a reprodutibilidade quando um assistente de AI não consegue recuperar as exclusões do mês passado?
A reprodutibilidade vira encenação: você ainda pode gerar uma seção de trabalhos relacionados fluente, mas não consegue mais defender o conjunto de estudos. Um projeto de vários meses produz centenas de decisões de inclusão/exclusão. Se essas decisões não forem recuperáveis, um novo responsável pela triagem, um orientador ou um revisor de periódico não conseguirá distinguir uma exclusão guiada pelo protocolo de uma exclusão guiada pelo humor da sessão.
Revisões sistemáticas vivas tornam a falha visível. O Elicit descreve revisões vivas como a combinação da revisão concluída com alertas, para que novas informações possam ser incorporadas a cada ano ou conforme necessário, e permite compartilhar um link para todo o processo e os resultados intermediários. Isso só funciona se as exclusões do último trimestre fizerem parte do objeto que está sendo atualizado. Um chatbot que “lembra o tema”, mas não o registro de exclusões, voltará a incluir artigos que você já rejeitou ou voltará a rejeitar artigos dos quais você já extraiu dados.
Três verificações de reprodutibilidade expõem rapidamente a lacuna:
- Teste de reprodução. Após uma semana longe do projeto, peça ao assistente que liste as últimas 20 exclusões com os motivos. Se ele inventar justificativas ou misturar projetos, a camada de auditoria está ausente.
- Teste de ampliação. Dê a ele um resumo fora do escopo que seja tematicamente tentador. Se ele argumentar pela inclusão sem citar os critérios congelados, a persistência do protocolo falhou.
- Teste de transferência. Um colega deve conseguir continuar a partir do último resumo de estado do assistente sem uma explicação verbal. Se não conseguir, a memória é pessoal, não científica.
A Jenova lida com os testes de reprodução e transferência quando instruções, bases de conhecimento e memória de sessão são de fato usadas; ela ainda exige que você exporte um registro no formato PRISMA se um periódico quiser um diagrama de fluxo. O Elicit lida de forma mais nativa com o teste de auditoria e ainda exige que você mantenha o julgamento científico informal em outro lugar. O Consensus e o Gemini Notebook, usados isoladamente, falham em verificações diferentes: o Consensus não reproduzirá suas exclusões, e o Gemini Notebook não reproduzirá artigos que nunca foram carregados.
Portanto, o problema da pesquisa de vários meses não é “qual modelo é mais inteligente em 2026”. É se estratégias de busca, critérios de inclusão e achados anteriores estão armazenados em uma pilha que ainda existe quando você retorna. Escolha a ferramenta que preserva esses três objetos e faça o assistente reafirmá-los no início de cada sessão, para que qualquer desvio aconteça às claras.
Referências
- Declaração PRISMA 2020 — Lista de verificação, diagramas de fluxo e orientação de relato para revisões sistemáticas
- Declaração PRISMA — Visão geral da principal diretriz de relato para revisões sistemáticas
- The BMJ — A declaração PRISMA 2020: uma diretriz atualizada para relatar revisões sistemáticas
- LibGuides da Hofstra University — Lista de verificação PRISMA de 27 itens para revisões sistemáticas e meta-análises
- ScienceDirect — Ferramentas de AI para revisões sistemáticas de literatura e meta-análises, incluindo um mapeamento de 63 ferramentas de ML
- King's College London — Ferramentas de AI na síntese de evidências
- Elicit — Revisões sistemáticas de literatura: triagem, extração, auditoria PRISMA, revisões vivas e resultados de validação
- Elicit — Visão geral do produto e preços, incluindo tamanho do corpus e base de pesquisadores
- Consensus — Mecanismo acadêmico de busca com AI, tamanho do corpus, Deep Search e Medical mode
- Paperguide — Consensus vs NotebookLM: descoberta de evidências versus transformação de fontes (2026)
- Gemini Notebook, anteriormente NotebookLM — Notebooks fundamentados em fontes, citações no nível de trechos e política de uso de dados
- DistillerSR — Diretrizes PRISMA e armadilhas que comprometem revisões sistemáticas
- medRxiv — Precisão e eficiência da extração de dados assistida por AI com Elicit em comparação com extração apenas por humanos (2026)
- Wiley / Cochrane Evidence Synthesis and Methods — Ferramentas de AI como segundos revisores para extração de dados
- Birmingham City University — Desempenho de AI generativa na extração de dados de revisões de literatura
- PubMed Central — Explicação e elaboração do PRISMA 2020
- EQUATOR Network — Registro da diretriz de relato PRISMA 2020