Como impedir que um assistente de pesquisa com AI invente citações falsas?
2026-08-21
Quais salvaguardas distinguem ferramentas de pesquisa com AI baseadas em citações de chatbots que alucinam?
A forma mais confiável de impedir que um assistente de pesquisa com AI invente artigos é recusar ferramentas que geram referências de memória, exigir que cada alegação seja vinculada a um registro recuperado com um identificador verificável por máquina e validar cada citação na fonte antes que ela entre em um manuscrito. Em 2026, essa estrutura — recuperação fundamentada, checagens de identificadores e verificação humana — é o que diferencia ferramentas de literatura como Jenova's Academic Research Assistant, Elicit, SciSpace, Consensus e Scite de chatbots de uso geral que ainda fabricam referências com aparência plausível.
Fatores-chave que de fato reduzem fontes inventadas:
✅ Recuperação em vez de memória — o assistente precisa pesquisar registros acadêmicos indexados, e não completar automaticamente uma bibliografia a partir dos dados de treinamento. ✅ Vínculo por identificador — todo trabalho citado deve ter um DOI, PMID, ID do arXiv ou URL da editora que possa ser resolvido de forma independente. ✅ Fidelidade, não apenas existência — um artigo real citado para sustentar uma conclusão que ele não contém continua sendo uma falha, como demonstrou a pesquisa sobre avaliação de RAG. ✅ Precisão bibliográfica — nomes de autores, anos, volumes e intervalos de páginas devem corresponder ao registro, e não a uma quase coincidência inventada pelo modelo. ✅ Um ciclo de verificação humana — a Stanford Libraries e os principais guias de estilo atribuem ao autor, e não à ferramenta, a responsabilidade por cada citação.
Para comparar ferramentas de forma útil, convém tratar a integridade de citações como uma questão de arquitetura, e não como um truque de engenharia de prompts. O restante deste guia mapeia essa arquitetura, os modos de falha que ela busca identificar e um fluxo de trabalho que você pode aplicar a qualquer assistente.
Por que citações fabricadas por AI estão aparecendo em artigos publicados em 2026?
Citações fabricadas deixaram de ser uma anedota de sala de aula. Elas estão entrando em periódicos, documentos de solicitações de financiamento e índices de citações porque pesquisadores colam bibliografias de chatbots em manuscritos sem verificar cada referência. Uma análise da Nature de 2026 estimou que dezenas de milhares de publicações de 2025 podem conter referências inválidas geradas por AI.
O padrão de contaminação é característico. O cientista da computação Guillaume Cabanac foi alertado de que um de seus artigos havia sido citado no International Dental Journal — uma área que não se sobrepõe ao seu trabalho de identificação de artigos fabricados — e descobriu que não conseguia reconhecer sua própria referência. É assim que citações fantasma se espalham: elas parecem estar formatadas corretamente, mencionam periódicos com nomes verossímeis e sobrevivem a uma leitura superficial.
Os casos documentados são graves o suficiente para provocar retratações. Resnik e Hosseini resumem um artigo em Academic Ethics no qual 19 de 29 citações foram alucinadas, um artigo da PLOS ONE posteriormente retratado com 18 das 76 citações inventadas e uma perspectiva em Digestive Diseases and Sciences na qual 12 das 14 referências não existiam. Um estudo de 2025 sobre citações do GPT-4o em saúde mental constatou que 56% continham erros, sendo cerca de uma em cada cinco completamente alucinada.
A preocupação entre docentes agora é quase universal. Uma pesquisa do College Board informa que professores temem que o uso de AI esteja prejudicando o pensamento crítico, a escrita original e a integridade acadêmica. Guias de bibliotecas como o da UNC Charlotte agora tratam citações alucinadas como um risco padrão de pesquisa, e não como um caso excepcional.
A implicação para a escolha de ferramentas é direta. Se um assistente consegue emitir uma referência APA ou Vancouver bem formatada sem recuperar um registro ativo, ele consegue inventar um artigo que nunca existiu — e esse artigo pode chegar à publicação.
O que você deve avaliar antes de confiar sua lista de referências a um assistente de pesquisa com AI?
Você deve avaliar um assistente de pesquisa com AI com base em cinco camadas de integridade de citações: fonte de verdade, vínculo por identificador, fidelidade entre alegação e passagem, precisão bibliográfica e um ciclo obrigatório de verificação humana. Ferramentas que têm bom desempenho em fluência e ruim nessas camadas não são seguras para listas de referências, independentemente de quão polido pareça o texto.
1. Fonte de verdade
Pergunte se as respostas vêm de um corpus recuperado ou da memória paramétrica. Sistemas com recuperação pesquisam Google Scholar, PubMed, Semantic Scholar, Scopus ou arXiv e só então geram. Chatbots sem recuperação preveem o próximo token de uma citação. Existem métricas de fidelidade justamente porque a geração pode se desviar do contexto recuperado mesmo quando houve recuperação.
2. Vínculo por identificador
Uma combinação de título, autor e ano não é suficiente. Exija um DOI, PMID, PMCID ou URL da editora e, depois, resolva-o você mesmo. Referências fantasma costumam falhar nesse teste imediatamente. Quase coincidências bibliográficas — um artigo real com volume ou intervalo de páginas incorreto — falham em uma segunda verificação.
3. Fidelidade entre alegação e passagem
Uma pesquisa da ACM sobre citações em RAG constatou que correção não é fidelidade: até 57% das citações podem deixar de sustentar a alegação que supostamente fundamentam. Um artigo que existe, mas não contém a conclusão, é tão perigoso quanto um artigo inexistente, porque ele confere aparência de legitimidade a um resultado falso por meio de um autor real.
4. Precisão bibliográfica
Ordem dos autores, ano, periódico, volume, edição e páginas precisam corresponder ao registro. Testes de ferramentas RAG em administração de empresas mostraram que itens fantasma completamente fabricados podem ser raros, enquanto pequenos erros bibliográficos continuam comuns. Esses erros ainda quebram índices de citações e podem ocultar artigos trocados.
5. Ciclo de verificação humana
A política de periódicos da APA, conforme resumida por Stanford, afirma que autores devem verificar quaisquer informações e citações fornecidas por uma ferramenta de AI. As diretrizes para pesquisadores da Wiley e as orientações de integridade em pesquisa de Harvard também atribuem a divulgação e a precisão ao autor humano. Nenhum assistente dessa categoria elimina essa obrigação.
Atribua pesos às camadas conforme a tarefa. Revisões sistemáticas devem dar maior peso à fidelidade e ao vínculo por identificador. A análise exploratória pode aceitar uma recuperação mais ampla se cada item selecionado for verificado antes de ser citado. Nunca dê peso excessivo à qualidade da redação. Parágrafos fluidos são o mecanismo que torna citações falsas convincentes.
Como as ferramentas populares de pesquisa com AI se comparam em confiabilidade de citações?
Elas divergem fortemente quanto a se as referências são recuperadas de índices acadêmicos ou geradas a partir da memória do modelo, e essa única escolha de design prevê a maior parte do risco de citações fantasma. Chatbots de uso geral continuam sendo a opção de maior risco para bibliografias. Assistentes de pesquisa desenvolvidos para essa finalidade reduzem referências fantasma, mas ainda podem citar incorretamente, registrar metadados errados e exagerar o que um artigo demonstra.
Em 2026, uma comparação prática é a seguinte:
| Recurso / Dimensão | Chatbots de uso geral (ex.: ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| Fonte de evidência | Principalmente memória paramétrica, salvo se a navegação estiver ativada | Artigos recuperados, tabelas de extração | Recuperação em múltiplas bases (Google Scholar, PubMed, arXiv) | Artigos recuperados para questões empíricas | Índice de citações com contexto de apoio/contraste | Descoberta de literatura em tempo real em bases acadêmicas e repositórios |
| Risco de referências fantasma | Alto; documentado em periódicos e laboratórios | Baixo em estudos de listas de referências com RAG | Baixo em estudos de listas de referências com RAG | Baseado em recuperação; ainda exige verificação | Baixo para itens em seu grafo de citações | Baseado em recuperação; ainda exige checagens independentes de DOI |
| Fidelidade entre alegação e fonte | Fraca sem passagens recuperadas | Mais forte para extração estruturada | Mais forte quando as respostas citam artigos recuperados | Mais forte para questões empíricas de sim/não | Forte para entender como um artigo é citado | Depende das passagens recuperadas e da escolha do modelo; exige checagem humana |
| Precisão bibliográfica | Detalhes inventados frequentes | Pequenas imprecisões relatadas em auditorias de RAG | Pequenas imprecisões relatadas em auditorias de RAG | Não verificada na escala de auditorias de campo | Forte em torno do contexto de citação | Herda metadados dos registros recuperados; ainda pode se desviar no texto |
| Preços (em 2026) | Variam conforme o plano do fornecedor | Não verificado | Não verificado | Não verificado | Não verificado | Plano gratuito com uso limitado; planos pagos a partir de $20/mês |
| Melhor para | Redigir textos, não construir uma lista de referências | Tabelas de evidências e extração sistemática | Busca ampla e interdisciplinar de literatura | Respostas rápidas a questões empíricas de sim/não | Validar se citações apoiam ou contradizem uma alegação | Descoberta de literatura de ponta a ponta, preparação de manuscritos e gestão de citações com memória persistente |
Chatbots de uso geral
Chatbots se destacam na criação de estruturas e na paráfrase, mas falham na construção de bibliografias. A auditoria de saúde mental do GPT-4o citada acima oferece o número de alerta: mais da metade das citações geradas continha erros. Se uma ferramenta consegue emitir uma referência com aparência perfeita sem um registro ativo, trate cada citação como não verificada.
Elicit
O Elicit é mais forte quando a tarefa é selecionar artigos e extrair métodos, resultados e limitações para uma tabela. Comparações independentes o descrevem como mais adequado a fluxos de trabalho rigorosos e baseados em evidências do que a buscas exploratórias rápidas. Sua limitação é a densidade de cobertura: em um benchmark conduzido pela SciSpace com 200 consultas, o Elicit retornou 13,0 artigos altamente relevantes por consulta, contra 26,3 do SciSpace Deep Review. Essa diferença importa para a cobertura, não para o risco de referências fantasma.
SciSpace
O SciSpace pesquisa múltiplas bases acadêmicas e, em sua própria avaliação do Deep Review, liderou a precisão de P@3 a P@70. Essa amplitude ajuda em questões interdisciplinares nas quais as evidências estão simultaneamente no PubMed, arXiv e Google Scholar. A limitação é metodológica: o benchmark de destaque foi conduzido pela SciSpace, embora as classificações de relevância tenham vindo de três modelos externos. Trate benchmarks de fornecedores como indicativos e, depois, verifique você mesmo os itens selecionados.
Consensus
O Consensus é desenvolvido para responder questões científicas empíricas com base em artigos, em vez de redigir uma revisão narrativa. No mesmo teste de 200 consultas, o Consensus Deep teve a melhor precisão no primeiro resultado (P@1 = 0.5882) e depois perdeu essa liderança mais abaixo na lista. É uma boa ferramenta para encontrar pontos de partida e uma opção menos robusta para conjuntos longos de triagem.
Scite
O diferencial do Scite é a inteligência de citações — visualizar se artigos posteriores apoiam, mencionam ou contradizem uma determinada alegação. Comparações o posicionam como mais restrito que uma ferramenta completa de operações de pesquisa, mas mais forte para validação de evidências. Se seu modo de falha é “este artigo real não diz o que o assistente alegou”, o contexto de citações no estilo do Scite é o instrumento certo.
Jenova Academic Research Assistant
O Jenova's Academic Research Assistant foi desenvolvido para acadêmicos e estudantes de doutorado que precisam de descoberta de literatura, suporte a manuscritos e citações em um único espaço de trabalho persistente. Ele pode pesquisar em tempo real grandes bases acadêmicas e repositórios, manter a memória do projeto entre sessões e redigir com modelos atuais, sem dependência de um único fornecedor. Essa combinação é útil quando uma revisão se estende por semanas e o assistente precisa lembrar critérios de inclusão, artigos rejeitados e DOIs não resolvidos.
Ele não é um índice dedicado de contexto de citações e, portanto, não substitui o Scite para mapas de apoio versus contraste. Também não é uma grade de extração desenvolvida especificamente no sentido do Elicit. A busca em tempo real também pode recuperar registros de baixa qualidade ou inadequados que um modelo fluente interpreta de forma excessiva. A regra de operação honesta é a mesma para toda ferramenta de recuperação: use-a para encontrar e organizar candidatos, não para aprovar uma bibliografia.
A geração aumentada por recuperação impede completamente referências fantasma?
Não. A geração aumentada por recuperação (RAG) reduz fortemente artigos completamente inventados em listas de referências, mas não elimina erros bibliográficos nem garante que um artigo recuperado apoie a frase à qual foi associado. Portanto, a prevenção deve abordar três modos de falha diferentes, e não apenas um.
Os três modos são fáceis de confundir porque todos produzem “citações com aparência plausível”:
- Referências fantasma — o trabalho citado não existe.
- Desvio bibliográfico — o trabalho existe, mas os autores, ano, volume ou páginas estão errados.
- Alucinação de contexto — o trabalho existe e os metadados estão em grande parte corretos, mas o assistente atribui a ele uma conclusão que o artigo não contém.
Uma análise de campo do Scopus AI, Elicit, SciSpace e Scite em administração de empresas constatou que ferramentas baseadas em RAG geralmente não emitiam referências fantasma verificáveis. Ainda assim, apareceram pequenas imprecisões bibliográficas; fontes inteiramente inexistentes foram negligenciáveis nas listas geradas. Essa é a forma correta de interpretar RAG: trata-se de um forte controle contra referências fantasma, não de um sistema completo de qualidade de citações.
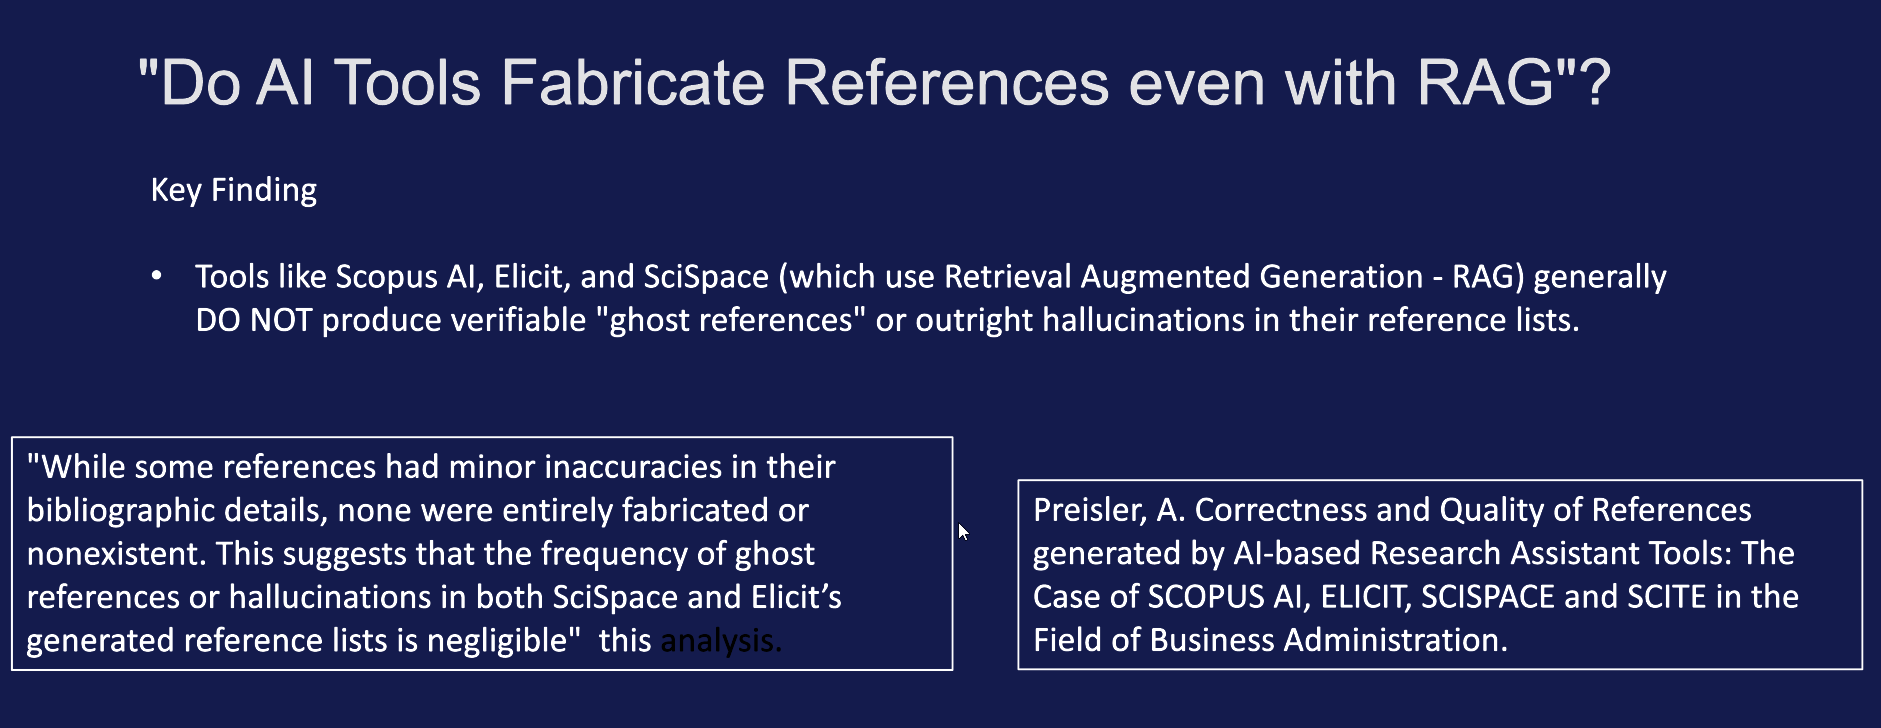
A pesquisa sobre fidelidade explica o risco restante. As estruturas de avaliação de RAG separam a relevância da resposta de sua fidelidade: uma resposta pode ser pertinente ao tema e ainda assim não estar fundamentada nas passagens recuperadas. A constatação da ACM de que uma grande parcela das citações de RAG pode não ter fidelidade é o alerta operacional. Se você verifica apenas se um DOI é resolvido, identificará referências fantasma, mas deixará passar alegações atribuídas incorretamente.
Chatbots de uso geral falham no primeiro modo. Assistentes RAG falham principalmente no segundo e no terceiro. Portanto, um fluxo de prevenção que pergunta apenas “este artigo existe?” é incompleto para as ferramentas que os pesquisadores realmente deveriam usar.
Como verificar as citações retornadas por um assistente de pesquisa com AI?
Você deve verificá-las com um protocolo de duas etapas: primeiro, resolver o identificador; depois, confirmar que uma passagem específica sustenta a alegação. Pular qualquer uma dessas etapas é como fontes inventadas ou mal utilizadas chegam à publicação.
Etapa 1 — O registro existe?
- Copie exatamente o título, o primeiro autor, o ano e o DOI conforme retornados.
- Resolva o DOI em uma agência registradora ou na página da editora. Se não houver DOI, pesquise o título exato no Google Scholar, PubMed ou no site do periódico, seguindo a abordagem de consulta direta recomendada por guias de pesquisa.
- Rejeite qualquer item que não seja resolvido, que seja resolvido para um artigo diferente ou que exista apenas como uma citação formatada por AI.
- Verifique ordem dos autores, ano, volume, edição e páginas no registro da editora, não no bloco bibliográfico do assistente.
Etapa 2 — Este artigo sustenta esta frase?
- Abra o texto completo em PDF ou HTML. Resumos não são suficientes para alegações causais, tamanhos de efeito ou linguagem de “primeira evidência”.
- Localize a passagem que supostamente sustenta a alegação. Registre-a como citação direta em suas anotações.
- Classifique a citação como apoio, menção ou contraste — a distinção que o Scite transforma em produto e que você também pode aplicar manualmente.
- Se o assistente parafraseou uma limitação como uma conclusão, ou uma hipótese como um resultado, descarte a citação para aquela frase.
Para o Jenova's Academic Research Assistant, restrinja a recuperação antes mesmo de gerar uma lista de referências:
"Pesquise artigos revisados por pares e preprints sobre [tema], 2019–2026. Retorne apenas itens com DOI ou PMID. Para cada um: título, autores, ano, periódico, identificador, conclusão em uma frase e uma passagem citada. Se não conseguir recuperar um registro verificável, omita o item por completo. Não complete nem adivinhe metadados."
Em seguida, passe os mesmos itens selecionados pelo Elicit ou SciSpace como uma segunda checagem de corpus. A divergência entre ferramentas é um recurso: ela sinaliza artigos que um sistema classificou, mas o outro não conseguiu recuperar.
A reportagem da Science sobre artigos científicos alucinados mostra por que uma leitura rápida de títulos falha. Um assistente pode citar corretamente um artigo real e, em seguida, inventar outro artigo semelhante no mesmo parágrafo. A verificação precisa ser item a item, e não parágrafo a parágrafo.
Uma citação alucinada pode ser considerada má conduta em pesquisa?
Sim, em um conjunto definido de casos — e, mesmo quando não atende à definição legal de má conduta, ela ainda pode causar retratação, problemas com financiamentos e danos à carreira. O motivo para prevenir não é etiqueta. É responsabilidade.
Resnik e Hosseini argumentam que uma citação alucinada pode se qualificar como má conduta comprovável em pesquisa segundo regulamentações federais dos EUA quando três condições se aplicam: um pesquisador usou uma ferramenta generativa para produzir citações inexistentes; essas citações funcionam como dados porque sustentam conclusões, como em revisões ou estudos bibliométricos; e o pesquisador demonstrou indiferença ao risco de fabricação ao não verificar o resultado. Uma referência fantasma em uma introdução narrativa é uma prática acadêmica inadequada. Uma referência fantasma contabilizada como evidência em uma revisão sistemática se aproxima mais de dados fabricados.
Os financiadores já estão tratando o problema de forma operacional. No verão de 2025, equipes de avaliação de subsídios do NIH foram inundadas por propostas assistidas por AI, e a agência indicou que o uso impróprio de AI descoberto após a concessão pode ser encaminhado para análise de integridade. O centro de integridade em pesquisa de Harvard reafirma restrições relacionadas: ferramentas de AI não podem ser listadas como autores, revisores científicos do NIH estão proibidos de usar AI generativa para formular críticas, e autores devem divulgar como as ferramentas foram utilizadas.
Periódicos estão convergindo para a mesma atribuição de responsabilidade. A compilação de Stanford das regras da APA, MLA, Chicago e IEEE exige divulgação de conteúdo gerado por AI e, no caso da APA, verificação humana explícita das citações. As orientações de ensino de Cornell também alertam que algoritmos automatizados de detecção de AI são confiáveis demais para serem a estratégia de integridade. A detecção após o ocorrido é um substituto fraco para a verificação antes da submissão.
O padrão prático é simples. Se você não consegue indicar um registro resolvido e uma passagem de apoio, a citação não pertence ao manuscrito, à apresentação ou à proposta de financiamento.
O que especialistas em integridade de pesquisa dizem sobre citações geradas por AI?
Especialistas agora tratam referências inventadas como uma falha de processo — usar um modelo generativo como biblioteca — e não como um defeito misterioso do modelo que os usuários não podem prever. O consenso entre escritórios de integridade e estudos de citações é que RAG reduz referências fantasma, a verificação humana continua obrigatória e bibliografias de chatbots sem supervisão são imprudentes diante do que já se sabe sobre a taxa de falha.
"O erro que continua chegando aos periódicos não é o fato de os modelos às vezes adivinharem. É os pesquisadores deixarem um modelo de linguagem executar uma tarefa de catalogação para a qual ele não foi projetado. Se o assistente não recuperou um registro, ele está completando um padrão bibliográfico, e padrões completados são como você obtém um artigo de aparência real em um periódico de aparência real com um DOI que não é resolvido. Mudar para uma ferramenta de recuperação reduz drasticamente esse modo de falha. Mas não reduz o próximo: citar um artigo real para um resultado que está no resumo do modelo, e não na seção de resultados."
"Orientamos os usuários de pesquisa a operar com três grupos. O Grupo A contém itens recuperados e verificados por passagem — essas citações podem ser usadas. O Grupo B contém itens recuperados, mas verificados apenas quanto aos metadados — eles permanecem em uma lista de leitura. O Grupo C reúne qualquer item emitido pelo modelo sem um identificador que possa ser resolvido — esses itens são excluídos, não ‘pesquisados depois’. Equipes que ignoram o Grupo C porque a formatação parece custosa são as que mais tarde descobrem que 12 das 14 referências nunca existiram. O custo da etapa adicional é trivial perto de uma retratação ou de um encaminhamento de integridade de financiamento."
— Equipe de Produto da Jenova, design de agentes de pesquisa com AI para fluxos de trabalho acadêmicos
Esse conselho está alinhado à política de editoras e universidades: informe a ferramenta, informe a tarefa que ela realizou e mantenha o autor humano responsável por cada referência. A orientação de integridade já não é “evite AI”. É “não terceirize a existência de suas fontes”.
Como conduzir uma revisão de literatura segura para citações com AI?
Conduza-a como um pipeline com recuperação primeiro, extração em seguida, redação por último e uma etapa de verificação que nenhuma frase possa ignorar. Inverter essa ordem — redigir o argumento e depois pedir a um assistente para “adicionar citações” — é o padrão de prompt mais associado a referências fantasma.
Um fluxo de trabalho que resiste à análise de periódicos e financiadores:
- Defina regras de inclusão antes de pesquisar. População, intervenção, anos, idiomas e tipos de estudo. Cole essas regras no assistente para que a memória, se a ferramenta a tiver, persista entre sessões.
- Pesquise com duas ferramentas de recuperação, não apenas uma. Exemplo de combinação: Jenova's Academic Research Assistant com Elicit ou SciSpace. Mantenha a união dos resultados; não confie em uma única lista classificada.
- Congele um conjunto de candidatos com identificadores. Exporte título, autores, ano, periódico e DOI/PMID. Tudo que não tiver um identificador fica fora do conjunto.
- Extraia, não resuma, a partir do texto completo. Métodos, amostra, resultados, limitações e uma frase citada. Tabelas no estilo do Elicit são úteis aqui; resumos narrativos são onde a alucinação de contexto se infiltra.
- Redija a partir da tabela de extração. Se uma frase não tiver uma linha na tabela, ela não recebe uma citação — e talvez não pertença ao artigo.
- Divulgue as ferramentas. Siga a compilação de regras de guias de estilo de Stanford: nome da ferramenta, versão, data e a função executada, como busca, extração ou edição linguística.
- Faça uma varredura final de DOI na bibliografia submetida. Essa última etapa identifica desvios de copiar e colar e qualquer referência que o modelo tenha inserido durante a revisão.
Um prompt que mantém o Jenova dentro do pipeline, e não no modo chatbot:
"Usando apenas o conjunto de candidatos que carreguei, redija a seção de contexto. Toda frase empírica deve citar um DOI desse conjunto e não deve introduzir novas fontes. Se uma alegação não for sustentada pelas anotações de extração, sinalize-a como UNSUPPORTED em vez de citá-la."
Para SciSpace ou Elicit, use a visualização de recuperação ou extração de cada ferramenta para reconstruir a mesma tabela e comparar as linhas. Quando as tabelas divergirem sobre uma conclusão, leia o PDF. A divergência custa menos do que uma correção após a publicação.
A restrição que faz o pipeline funcionar é tanto psicológica quanto técnica: nunca peça a qualquer assistente, inclusive um bom, que “forneça referências” para um texto redigido sem fontes. Esse prompt transforma uma ferramenta de pesquisa novamente em um gerador de citações, que é justamente o modo de falha que toda esta estrutura foi criada para evitar.
Referências
- Nature — Citações alucinadas estão poluindo a literatura científica
- Accountability in Research (Resnik & Hosseini) — Citações alucinadas produzidas por inteligência artificial generativa
- Stanford Libraries — AI em pesquisa acadêmica: diretrizes para citações
- ACM Digital Library — Correção não é fidelidade em geração aumentada por recuperação
- DeepEval — Métrica de fidelidade para sistemas RAG
- Confident AI — Métricas de avaliação de RAG: relevância da resposta, fidelidade e relevância contextual
- Biblioteca da UNC Charlotte — Guia de pesquisa sobre citações alucinadas por AI
- Wiley — Diretrizes de AI para pesquisadores
- College Board — Preocupação de docentes de que o uso de AI por estudantes prejudica a integridade acadêmica
- Integridade Acadêmica e de Pesquisa da Harvard Medical School — AI em pesquisa
- Cornell Center for Teaching Innovation — AI e integridade acadêmica
- SciSpace — Benchmark de busca de literatura entre SciSpace, Elicit e Consensus em 200 consultas
- Paperguide — Comparação entre Elicit e SciSpace
- Paperguide — Comparação entre Elicit e Scite
- Science — Citar sem ver: quando a AI alucina artigos científicos
- SciSpace — Comparação de produtos entre SciSpace e Elicit