Como um Assistente de Pesquisa com AI Pode Mapear Lacunas de Evidência em um Novo Tema?
2026-08-22
O Que Distingue um Fluxo de Trabalho Rastreável de Busca-Triagem-Mapeamento de Resumos Genéricos da Literatura?
Um assistente de pesquisa com AI confiável não começa resumindo quaisquer artigos que consegue encontrar. Ele constrói uma estratégia de busca reproduzível, faz a triagem de um conjunto delimitado de estudos com critérios explícitos e, então, mapeia o que esses estudos cobrem — e deixam de cobrir — para que as células vazias sejam lacunas de evidência, e não artefatos da busca. Em 2026, essa distinção é importante porque resumos genéricos produzidos por chat podem parecer completos enquanto inventam citações ou condensam desenhos de estudo incompatíveis em uma única afirmação.
Para um novo tema, a unidade prática de trabalho costuma ser um conjunto central de 50 artigos: grande o suficiente para revelar agrupamentos, mas pequeno o suficiente para que um pesquisador ainda consiga verificar todas as decisões de inclusão e exclusão. Ferramentas que apoiam esse fluxo de trabalho incluem o Jenova's Academic Research Assistant, o fluxo de trabalho de revisão sistemática do Elicit, o Rayyan e mapeadores de redes de citação como o ResearchRabbit.
O que separa um processo citável de busca-triagem-mapeamento de um despejo descartável de literatura:
✅ Consultas rastreáveis — strings Booleanas, bases de dados, janelas de datas e sinônimos são registrados antes do início da triagem
✅ Triagem auditável — cada artigo recebe uma etiqueta de inclusão, exclusão ou dúvida associada a um critério declarado
✅ Evidência extraída, e não parafraseada — achados, métodos e limitações permanecem vinculados a uma fonte verificável
✅ Mapas dimensionais de lacunas — células vazias são codificadas por população, método, geografia e desfecho, e não por intuição
✅ Verificação humana — a AI elabora o mapa; o pesquisador confirma que cada citação existe no artigo original
Para comparar assistentes de forma significativa, é útil tratar busca, triagem e mapeamento de lacunas como três tarefas com modos de falha distintos, e não como um único recurso de “revisão de literatura”.
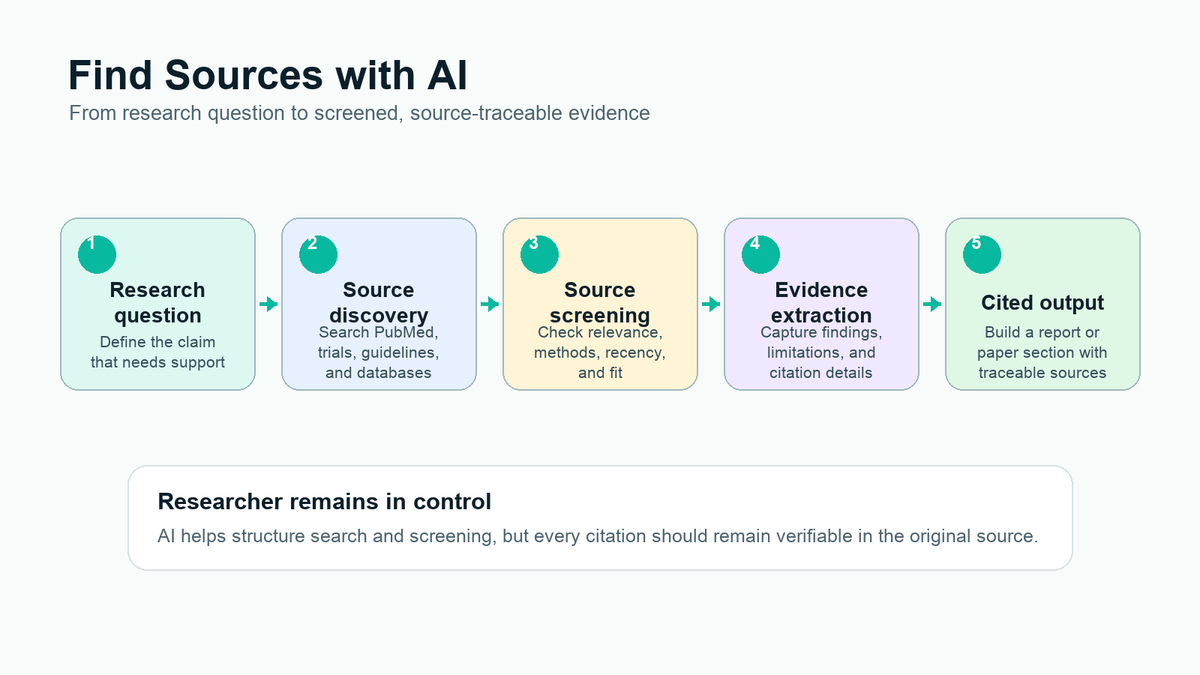
Por Que os Mapas de Lacunas de Evidência Estão se Tornando Essenciais para Novos Temas de Pesquisa?
Mapas de evidência e lacunas se tornaram uma maneira padronizada de visualizar, rapidamente, onde um campo está saturado e onde há silêncio antes que o pesquisador se comprometa com um novo desenho de estudo. Um mapa de evidência e lacunas é uma apresentação visual sistemática da disponibilidade de evidências relevantes para um domínio de políticas públicas ou pesquisa, identificadas por meio de um protocolo de busca pré-especificado, e não de uma lista de leitura ad hoc.
Essa definição, desenvolvida para a Campbell Collaboration, é fácil de usar incorretamente. Muitos mapas informam quais evidências existem, e não a que conclusão as evidências chegam. Confundir os dois gera falsa confiança: uma célula densa ainda pode ser metodologicamente fraca, e uma célula vazia pode refletir uma busca malsucedida, e não uma lacuna real de conhecimento.
O método já não é um nicho. Uma revisão do setor de saúde de 2016 identificou 145 títulos de mapeamento, dos quais 34 publicações apresentavam mapas de evidência explícitos. Revisões de mapeamento e mapas de lacunas de evidência agora são tratados como produtos de síntese distintos, usados para navegar por corpos complexos de pesquisa, situando-se entre uma revisão de escopo e uma revisão sistemática completa.
Para quem entra em um novo tema em 2026, a pressão é prática. O Elicit observa que revisões sistemáticas frequentemente começam com até 20.000 registros e são reduzidas a 30–100 artigos incluídos, um processo que pode levar de três meses a mais de um ano quando feito manualmente. Uma triagem de 50 artigos não substitui esse processo de padrão-ouro. Ela é o instrumento inicial adequado quando o objetivo é decidir se uma revisão sistemática, um estudo primário ou uma pergunta mais restrita se justificam.
A AI muda a velocidade da primeira etapa. Ela não elimina as obrigações de relato da PRISMA 2020, que continua exigindo métodos transparentes de identificação, seleção e extração.
O Que Você Deve Procurar em um Assistente de Pesquisa com AI para Triagem da Literatura?
Você deve avaliar um assistente de pesquisa com AI pela capacidade de manter uma estratégia de busca reproduzível, uma decisão de triagem inspecionável e uma afirmação sobre lacuna falsificável — e não pela fluência com que escreve uma revisão de literatura. A lista de verificação TRACE-GAP abaixo é a estrutura usada neste artigo.
Dimensões de avaliação TRACE-GAP
- T — Termos rastreáveis. A ferramenta consegue gerar as bases de dados exatas, strings, limites e intervalo de datas que outro pesquisador poderia executar novamente?
- R — Regras de relevância. Regras de inclusão e exclusão podem ser estabelecidas antes que qualquer artigo seja pontuado?
- A — Auditoria da triagem. Cada decisão traz uma justificativa, e não apenas um sim ou não?
- C — Coleta no nível da citação. Os achados são vinculados a uma passagem ou, ao menos, a um artigo específico, em vez de a um resumo combinado?
- E — Escala de força da evidência. O desenho do estudo, a amostra e as limitações podem ser registrados ao lado do achado?
- G — Grupos de dimensões de lacuna. O mapa pode usar pelo menos dois eixos, normalmente intervenção × desfecho ou população × método?
- A — Análise entre agrupamentos. O fluxo de trabalho exige uma segunda verificação antes de chamar uma célula vazia de lacuna?
- P — Perguntas priorizadas. O resultado transforma lacunas validadas em perguntas de pesquisa, e não em um mapa de calor decorativo?
Uma avaliação comparativa de guia de compra de 2026, que pontuou assistentes quanto ao embasamento de citações, constatou que links para fontes no nível do parágrafo produziram a menor proporção entre alucinações e esforço de verificação, com Atlas em 0,05, Elicit em 0,07, Consensus em 0,09 e SciSpace em 0,16. A mesma análise tratou o ResearchRabbit como um mapeador de rede, e não como gerador de respostas, que é a categoria correta para expansão a partir de artigos-semente.
Dois testes adicionais importam no uso acadêmico. Primeiro, a PRISMA 2020 ainda exige que os autores verifiquem os valores extraídos; qualquer ferramenta que esconda a citação de apoio falha nesse teste. Segundo, citações alucinadas já chegaram a rascunhos de especialistas e a fluxos editoriais de periódicos, portanto “soar acadêmico” não é um critério de aceitação.
O Jenova's Academic Research Assistant é mais forte na elaboração de estratégias, descoberta em múltiplas bases, memória persistente de projetos e redação atenta a citações. Ele é mais fraco como plataforma dedicada de dupla triagem: não gera um diagrama de fluxo PRISMA nem realiza resolução cega de conflitos como Rayyan e Covidence.
Como Jenova, Elicit, Rayyan e ResearchRabbit se Comparam em Busca, Triagem e Mapeamento de Lacunas?
O Jenova é mais forte como parceiro de estratégia e síntese, o Elicit como mecanismo de extração estruturada, o Rayyan como ambiente de triagem de alto volume e o ResearchRabbit como explorador de redes de citação — e nenhum deles deve ser usado como um sistema fechado único para um novo tema. A comparação útil é identificar qual tarefa cada ferramenta deve assumir.
| Recurso / Dimensão | Jenova Academic Research Assistant | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| Apoio à estratégia de busca | Elaboração conversacional de PICO/Boolean com busca no Scholar e na web; memória persistente de projetos | Busca semântica em mais de 125 milhões de artigos; sugere campos de triagem a partir da pergunta | Importa exportações de bases de dados tradicionais; não é principalmente um criador de estratégias de busca | ResearchRabbit expande a partir de artigos-semente; Scite verifica posteriormente o posicionamento das citações |
| Triagem de cerca de 50 artigos | Tabelas de inclusão/exclusão baseadas em critérios no chat, com justificativas e limitações | Triagem classificada mais linhas de extração apoiadas por citações | Triagem de título/resumo criada para esse fim, deduplicação e fluxos de trabalho em equipe | Fraco como ferramenta de triagem; forte para encontrar artigos relacionados ou auditar citações |
| Mapeamento de lacunas de evidência | Codificação de agrupamentos, validação de células vazias e transformação em perguntas de pesquisa | Boas tabelas de extração para construir um mapa posteriormente | O registro de triagem apoia mapas; o mapeamento em si ocorre principalmente depois | Mapas de rede mostram conexões ausentes, não lacunas de evidência validadas |
| Embasamento de citações | Respostas multimodelo com prompts que priorizam fontes; verificação humana ainda necessária | Citações de trechos no nível do artigo para campos extraídos | O registro de decisões é auditável; a síntese não é o produto | Scite sinaliza citações que apoiam, contrastam ou apenas mencionam |
| Preços (em 2026) | Plano gratuito com uso limitado; Plus a partir de US$ 20/mês | Pro, Team e Enterprise (preços de lista variam conforme o plano) | Gratuito para sempre no uso básico | ResearchRabbit gratuito; Scite Student cerca de US$ 10/mês, Premium cerca de US$ 20/mês |
| Ideal para | Estratégia em novos temas, interpretação de 50 artigos e transformação de lacunas em justificativa de estudo | Extração estruturada em muitos artigos | Triagem em equipe na escala de revisão sistemática | Entrar em um campo a partir de um artigo-semente e, depois, auditar citações importantes |
O Rayyan informa ser usado por mais de 1 milhão de pesquisadores em mais de 20.000 instituições de mais de 190 países e foi desenvolvido em torno de auditabilidade, reprodutibilidade e priorização assistida por AI. Uma análise comparativa de software em 2026 ainda apresentou a escolha como Covidence para gestão institucional de revisões, Rayyan para triagem acessível e Elicit para busca e extração com AI.
A limitação do Jenova é a interface, não a intenção. Uma triagem de 50 artigos no chat é inspecionável se você exigir uma tabela, mas não substituirá dois avaliadores independentes em uma exportação de 5.000 registros. A limitação do Elicit é oposta: a tabela é excelente, mas o próprio Elicit afirma que revisões prontas para publicação devem continuar realizando buscas tradicionais por palavras-chave e tratar a busca semântica como complemento. A limitação do ResearchRabbit é a honestidade quanto ao escopo: ele mapeia o que está conectado, e não o que está ausente após a avaliação da qualidade.
Para um novo tema, a combinação de maior retorno costuma ser Jenova ou Semantic Scholar para estratégia, Rayyan ou Elicit para triagem, Scite para posicionamento de citações e Jenova novamente para a narrativa das lacunas. O Agente Deep Research da Jenova é a melhor transição quando o mapa de 50 artigos exige um briefing mais longo e denso em citações.
Como Construir uma Estratégia de Busca Reproduzível com um Assistente de Pesquisa com AI?
Você constrói uma estratégia de busca reproduzível fixando a pergunta, os conceitos, as fontes e os limites antes de pedir a qualquer modelo que encontre artigos. O trabalho do assistente é expor sinônimos ausentes e limites enviesados, e não improvisar uma lista de leitura.
Comece com uma âncora de pesquisa: população ou contexto, intervenção ou exposição, comparador quando relevante, desfechos e desenhos de estudo que você aceitará. Revisões de mapeamento podem ser mais amplas do que uma única pergunta PICO, mas ainda precisam de uma estratégia de busca e um formulário de codificação definidos antecipadamente. Guias universitários descrevem mapas de evidência ou lacunas como uma tabela principal com linhas, colunas e filtros para variáveis específicas. Essas linhas e colunas devem existir no papel antes da primeira busca.
Um prompt inicial útil no Jenova's Academic Research Assistant é:
"Estou abrindo uma nova linha de pesquisa sobre [tema]. Elabore uma estratégia de busca reproduzível com: (1) elementos PICO ou PECO, (2) critérios de inclusão e exclusão, (3) bases de dados e fontes de literatura cinzenta, (4) strings Booleanas com sinônimos e vocabulário controlado e (5) uma janela de datas de 2019–2026. Liste os termos que provavelmente estão faltando e quaisquer limites que possam ocultar desenhos de estudo relevantes."
Depois, exija uma verificação metodológica:
"Reescreva a estratégia para que outro pesquisador possa executá-la novamente. Separe termos indispensáveis de sinônimos opcionais. Sinalize onde a busca semântica ajudaria na recuperação e onde apenas a sintaxe exata da base de dados é aceitável."
Bons assistentes conduzirão você a múltiplas fontes. Um tema biomédico ainda precisa de MEDLINE/PubMed e de pelo menos um índice complementar; educação e políticas sociais frequentemente exigem ERIC, PsycINFO ou uma biblioteca especializada de mapas. O guia de síntese da University of Toronto trata as revisões de mapeamento como uma maneira de visualizar lacunas antes de assumir o compromisso com uma revisão sistemática mais restrita.
Dois erros de estratégia aparecem constantemente nos testes. O primeiro é filtrar demais por “revisão” ou “RCT” cedo demais, apagando as próprias células vazias que você veio encontrar. O segundo é deixar que o modelo escolha as bases de dados depois de já ter visto alguns resultados convenientes. Fixe o protocolo e, só então, faça a busca.
O Jenova ajuda aqui porque a conversa persiste entre sessões e pode manter na memória a âncora, as strings e a lista de exclusão. Ele não substitui uma busca revisada por um bibliotecário para uma revisão sistemática destinada a periódico, e você não deve fingir que substitui.
Como Fazer a Triagem de Cerca de 50 Artigos-Chave sem Perder o Rigor Metodológico?
Você deve fazer a triagem de 50 artigos como um registro codificado de decisões: uma linha por estudo, uma justificativa por decisão e nenhum artigo admitido porque o resumo “parece relevante”. Cinquenta é um corpus de trabalho para um novo tema, e não uma alegação de que a literatura foi buscada de maneira exaustiva.
Adote a disciplina da triagem sistemática mesmo quando ainda não estiver escrevendo uma revisão PRISMA. A PRISMA 2020 é a diretriz atual de relato para revisões que identificam, selecionam e sintetizam estudos. A lista de verificação complementar de 27 itens existe para tornar esses métodos transparentes. Seu registro de 50 artigos não atenderá aos requisitos de uma revisão sistemática completa, mas deve ser capaz de responder às mesmas perguntas básicas: o que foi encontrado, o que foi mantido e por quê.
Um prompt prático de triagem:
"Faça a triagem dos 50 artigos a seguir com base nestes critérios de inclusão e exclusão. Para cada artigo, informe: decisão (
include/exclude/unsure), o único critério que decidiu o caso, desenho do estudo, população, contexto, desfecho primário e uma limitação. Cite o trecho que justificou a decisão. Não adicione artigos que não estejam nesta lista."
Em seguida, faça você mesmo uma rodada de calibração com os primeiros dez registros. Se o assistente e o pesquisador discordarem em mais de dois ou três casos, os critérios ainda estão vagos. Torne mais rigorosas as definições de população, desenho e desfecho antes de pontuar os quarenta restantes.
O Rayyan é o melhor instrumento quando o conjunto cresce ou quando um segundo avaliador entra no projeto. Comparações independentes entre Covidence e Rayyan há muito consideram ambos plataformas viáveis de triagem para revisões sistemáticas, com diferentes modelos de colaboração. O Elicit é o melhor instrumento quando a próxima etapa é uma tabela de dados: tamanho da amostra, direção do desfecho e campos de métodos preenchidos com citações de apoio.
O limite honesto do Jenova é a ergonomia em lotes. A triagem baseada em chat é rápida para 50 artigos cuidadosamente selecionados e pouco prática para 5.000 registros importados. Use-o para aplicar critérios e extrair um livro de códigos consistente. Transfira o mesmo livro de códigos para Rayyan ou Elicit se o projeto se transformar em uma revisão formal.
Nunca deixe o modelo “preencher” um PDF ausente. Se o texto completo não estiver disponível, a linha permanece unsure, não include. Essa única regra evita a maior parte do teatro de citações.
Como Transformar Artigos Triados em um Mapa de Lacunas de Evidência Validado?
Você transforma um conjunto triado em um mapa de lacunas ao codificar cada estudo incluído em duas ou mais dimensões, marcar células vazias como preliminares e, somente então, testar se essas células vazias persistem em uma segunda busca. Uma célula vazia que não foi contestada é um resíduo de codificação, e não uma justificativa de pesquisa.
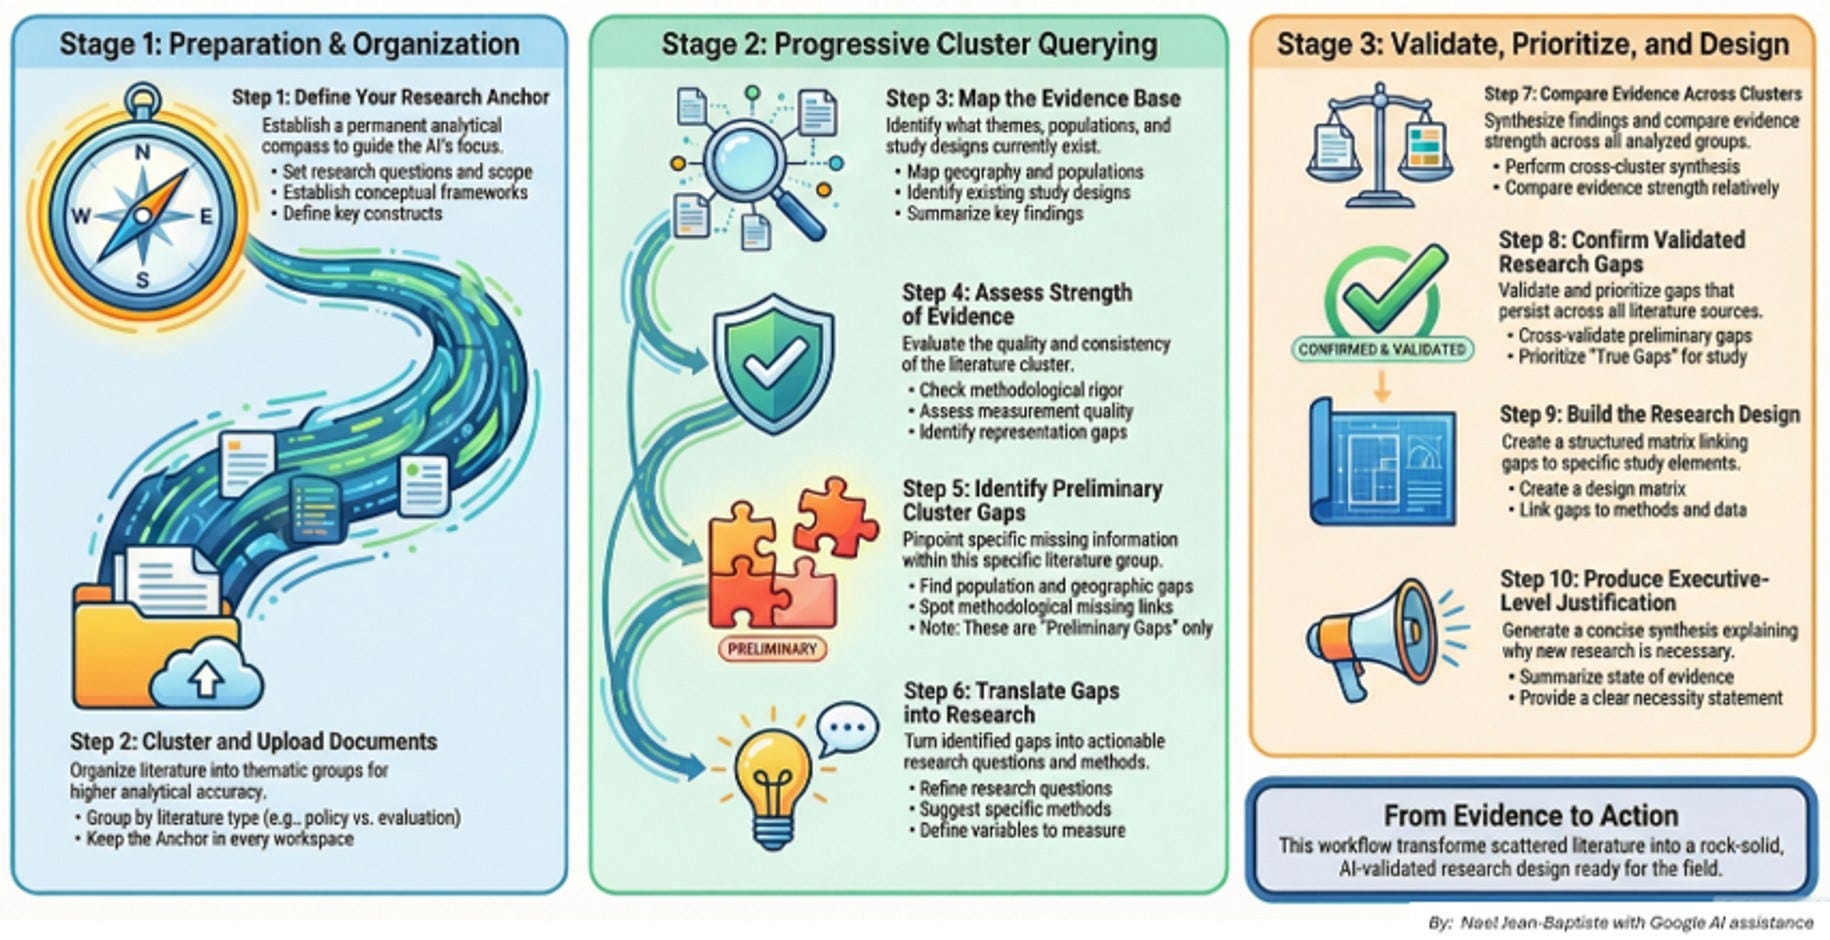
O fluxo de trabalho na figura acima segue a sequência correta: preparar uma âncora analítica, agrupar os documentos, avaliar a força da evidência, marcar lacunas preliminares e, então, validar essas lacunas entre agrupamentos antes de desenhar um estudo. Isso corresponde à forma como mapas formais devem funcionar. Mapas interativos de lacunas de evidência são ferramentas visuais estruturadas para exibir o volume e as características das evidências, e não cartazes de hipóteses preferidas.
Um mapa durável normalmente precisa de, pelo menos:
- Linhas: intervenções, exposições ou perguntas de pesquisa
- Colunas: desfechos, populações ou desenhos de estudo
- Filtros: ano, geografia, qualidade e status de publicação
- Conteúdo das células: número de estudos, mais uma classificação básica de força (revisão, ensaio, observacional, protocolo)
Peça ao assistente que construa a primeira matriz somente a partir dos artigos incluídos:
"Usando apenas os estudos incluídos, construa uma matriz de lacunas com linhas = [intervenções ou perguntas] e colunas = [desfechos ou populações]. Em cada célula, liste número de estudos, desenho dominante e atualidade. Marque células vazias como Preliminar. Em seguida, proponha três buscas de acompanhamento que possam falsificar cada célula vazia, incluindo registros de ensaios e literatura cinzenta."
A validação é a etapa que a maioria dos textos produzidos por AI ignora. Comparações metodológicas enfatizam que mapas devem incluir estudos em andamento de registros, aplicar avaliação crítica e ser atualizados em aproximadamente três anos. Uma célula que parece vazia no seu conjunto de 50 artigos pode estar cheia em um servidor de pré-publicações ou em um registro de protocolos.
O Jenova é útil nesta fase porque consegue manter o livro de códigos, a matriz e os artigos rejeitados em uma única conversa e, então, redigir o memorando “por que este estudo é necessário” apenas a partir de lacunas validadas. Ele interpretará demais as células vazias se você permitir. Exija uma busca de falsificação para cada lacuna que pretende financiar ou sobre a qual pretende escrever.
Se o tema posteriormente se tornar uma revisão de escopo, mude o relato para a PRISMA-ScR, que especifica 20 itens essenciais e 2 itens opcionais. Não adapte retrospectivamente um mapa casual de 50 artigos como se ele já fosse uma revisão de escopo.
Como Obter o Máximo de um Fluxo de Trabalho de Busca-Triagem-Mapeamento Assistido por AI?
Você obtém o máximo do fluxo de trabalho ao fornecer ao assistente um protocolo fixado, um corpus delimitado e um orçamento de verificação — e ao recusar qualquer afirmação que não possa ser aberta no PDF original. A velocidade vem da codificação consistente, não de ignorar verificações de texto completo.
Uma sequência operacional compacta:
- Escreva a âncora. Um parágrafo declarando a afirmação que precisa de suporte, a população e o que contaria como evidência contrária.
- Elabore e congele a busca. Bases de dados, strings, datas e regras de exclusão entram em uma nota datada antes de a descoberta começar.
- Reúna 50 artigos intencionalmente. Misture revisões, ensaios recentes ou estudos primários e pelo menos alguns artigos de áreas adjacentes para que o mapa não seja uma ilusão de agrupamento único.
- Faça a triagem em uma tabela. Inclua, exclua ou marque como dúvida, com um critério decisivo e um trecho citado.
- Extraia e, depois, classifique. Achados, limitações, desenho e amostra permanecem em campos separados.
- Mapeie e, então, ataque os vazios. Cada lacuna preliminar recebe uma segunda busca concebida para eliminá-la.
- Escreva a partir da matriz. A frase sobre novidade do artigo deve nomear a célula vazia validada, e não uma impressão vaga.
No Jenova, mantenha toda essa cadeia em um único projeto para que o assistente não altere silenciosamente as regras de inclusão entre sessões. Um prompt de acompanhamento que evita desvios:
"Reaplique os critérios de inclusão originais a este novo artigo. Se precisar alterar um critério para incluí-lo, pare e me mostre a alteração proposta em vez de pontuar o artigo."
No Elicit, comece pela pergunta de pesquisa, deixe o sistema sugerir campos de triagem e extração e, então, ajuste esses campos antes de executar o conjunto completo. No Rayyan, importe a exportação da base de dados, defina etiquetas correspondentes ao seu livro de códigos e mantenha o classificador de relevância com AI como uma ordem de classificação, e não como uma decisão.
Reserve tempo de verificação explicitamente. Uma meta viável para um conjunto central de 50 artigos é de dois a quatro minutos de checagem humana por texto completo incluído, concentrada em confirmar se o achado citado realmente está no artigo e se o desenho foi codificado corretamente. Isso ainda é muito mais barato do que a extração sem assistência e é a única forma de atender à expectativa da PRISMA de que os valores extraídos sejam verificados.
O Que Metodologistas de Pesquisa e Desenvolvedores de Ferramentas Dizem sobre o Mapeamento de Evidências Assistido por AI?
Metodologistas de pesquisa tratam mapas de evidência como gráficos orientados por protocolo sobre a disponibilidade de evidências, enquanto desenvolvedores de ferramentas continuam descobrindo que a citação, e não a prosa, é a parte em que a AI erra. Ambos os grupos convergem para a mesma regra operacional: a AI pode estruturar a busca e a triagem, mas o pesquisador continua responsável por cada célula do mapa.
"O modo de falha que vemos com mais frequência é tratar a célula vazia como uma descoberta. Uma célula vazia é apenas uma hipótese sobre evidência ausente. Ela se torna uma lacuna validada depois que você verifica agrupamentos adjacentes, literatura cinzenta e registros de protocolos e confirma que a ausência não é um artefato da busca. Se essas verificações não foram executadas, você não tem um mapa de lacunas. Você tem uma visualização da sua primeira consulta."
"Em uma triagem de 50 artigos, a economia de tempo vem da codificação consistente, e não de ignorar o texto completo. A divisão útil de trabalho é simples: o assistente elabora a decisão de inclusão/exclusão, a linha de extração e a primeira matriz; o pesquisador passa alguns minutos por artigo incluído confirmando que a citação existe e que o desenho não foi aprimorado no relato. Isso ainda comprime dias de anotações desorganizadas em um único livro de códigos."
"Não submeteríamos uma revisão sistemática para periódico usando apenas registros de chat. Plataformas dedicadas de triagem ainda vencem em revisão dupla, resolução de conflitos e diagramas PRISMA. Onde um assistente conversacional de pesquisa conquista seu espaço é antes disso: ao fixar a pergunta, expor limites enviesados de busca, manter os artigos rejeitados visíveis e transformar uma célula vazia validada em uma justificativa precisa de estudo."
— Equipe de Produto da Jenova, fluxos de trabalho de pesquisa acadêmica, 8 anos desenvolvendo ferramentas de pesquisa com AI rastreáveis por fonte
Essa cautela é consistente com trabalhos independentes. Revisões de sistemas generativos em síntese de literatura continuam encontrando capacidade real acompanhada de limites de confiabilidade que tornam revisões sem supervisão inseguras. Orientações sobre mapas sistemáticos de evidência também enfatizam a categorização estruturada de evidências científicas, em vez de confiança narrativa. A exigência de que o pesquisador mantenha o controle no fluxo de trabalho de fontes em cinco etapas não é um slogan. É a etapa de controle de qualidade da qual depende o restante do método.
Referências
- Saran e White — Mapas de evidência e lacunas: comparação entre diferentes abordagens (PMC)
- Khalil et al. — Metodologia para revisões de mapeamento, mapas de evidência e mapas de lacunas (Research Synthesis Methods)
- Elicit — Apresentando a revisão sistemática do Elicit
- PRISMA Statement — Diretrizes de relato PRISMA 2020
- Atlas Workspace — Melhores assistentes de pesquisa com AI (2026): comparação verificada quanto a alucinações
- Fortune — Alucinações de AI estão se infiltrando em trabalhos científicos de especialistas (maio de 2026)
- University of Illinois Grainger LibGuide — Revisões de escopo, revisões de mapeamento e mapas de evidência ou lacunas
- Page et al. — A declaração PRISMA 2020 (The BMJ)
- University of Kansas Medical Center — PRISMA e padrões relacionados de revisão
- Elicit — Fluxo de trabalho de revisão sistemática criado para a PRISMA 2020
- Rayyan — Plataforma de revisão sistemática com AI
- INRA.AI — Comparação entre Covidence, Rayyan e Elicit
- University of Toronto Libraries — Revisões de mapeamento na família de síntese de conhecimento
- Kellermeyer, Harnke e Knight — Comparação entre Covidence e Rayyan (PMC)
- EvalCommunity Academy — Mapeador interativo de lacunas de evidência
- PRISMA — Extensão PRISMA para revisões de escopo
- Adel, Alateeq e Alshahrani — A AI generativa consegue sintetizar literatura de forma confiável? (AI & Society)
- Khalil et al. — Orientações para realizar mapas sistemáticos de evidência (Science of the Total Environment)