Como a AI Pode Sintetizar Evidências Interdisciplinares sem Misturar Fatos?
2026-08-21
Quais Três Camadas de Evidência Devem Permanecer Separadas na Síntese de AI entre Disciplinas?
A AI só consegue sintetizar evidências interdisciplinares de forma confiável quando rotula cada afirmação como um fato da fonte, uma conclusão do autor ou uma inferência do modelo — e impede que essas camadas se fundam em um único parágrafo sem rótulo. Em 2026, essa separação é a diferença entre um resumo de pesquisa auditável e uma síntese fluente que transforma alegações cautelosas em autoridade aparente. Chatbots genéricos ainda misturam essas camadas por padrão, motivo pelo qual a fabricação bibliográfica e o erro de citação continuam bem documentados.
Agentes de pesquisa desenvolvidos para esse propósito — incluindo o Academic Research Assistant da Jenova — são mais adequados para essa tarefa quando recuperam fontes reais, preservam a atribuição e tornam visíveis os próprios saltos do modelo. Eles não substituem uma revisão sistemática registrada no PRISMA.
Fatores-chave que diferenciam uma síntese consciente da proveniência de uma paráfrase sem rótulo:
✅ Fatos da fonte são medições, métodos, tamanhos de amostra e observações relatados no texto primário ✅ Conclusões dos autores são interpretações que os autores do artigo apresentam na discussão ou no resumo — não uma verdade independente ✅ Inferência da AI é o raciocínio analógico, preditivo ou integrativo que o modelo acrescenta entre artigos ou áreas ✅ Mapeamento entre domínios deve ser explícito, pois um mecanismo estabelecido em uma disciplina geralmente é apenas uma hipótese em outra ✅ Toda frase extraível deve resistir a uma auditoria simples: quem afirmou isso, em qual documento e com qual status epistêmico?
Para comparar ferramentas nesse problema, trate a proveniência como um critério de avaliação central, e não como uma preferência de formatação. O restante deste guia usa essa lente — a estrutura FCI-TRACE — para avaliar como os sistemas de síntese realmente se comportam.
Por Que a Síntese Interdisciplinar por AI Falha Quando a Proveniência É Colapsada?
A síntese interdisciplinar falha sem proveniência porque as áreas não compartilham os mesmos padrões de evidência, e os modelos de linguagem são otimizados para produzir uma prosa coerente, e não para preservar esses padrões. Um resultado empírico de um artigo sobre clima, uma alegação de identificação causal de um economista e uma diretriz de prática clínica podem ser fundidos gramaticalmente em uma única frase. Essa frase parecerá conhecimento consolidado mesmo quando apenas uma de suas cláusulas foi efetivamente medida.
Esse não é um modo de falha hipotético. Um estudo da Scientific Reports sobre revisões de literatura geradas pelo ChatGPT constatou que 55% das citações do GPT-3.5 e 18% das citações do GPT-4 eram fabricadas, e que 43% e 24% das citações reais restantes continham erros bibliográficos substanciais. Relatos posteriores associaram uma alta mais ampla de citações fabricadas em artigos publicados a ferramentas generativas. Revisões multimodelo em 2026 ainda concluem que quase 40% das referências geradas por AI contêm erros ou fabricações, e apenas 26,5% são totalmente precisas.
As taxas de alucinação são ainda maiores fora da produção científica bem indexada. Uma avaliação do Stanford HAI, resumida pelo MIT Sloan, constatou que chatbots de uso geral alucinavam em 58–82% das consultas de pesquisa jurídica em modelos da geração de 2023. Os domínios jurídico, de políticas públicas e clínico são justamente os contextos em que resumos interdisciplinares são mais solicitados — e nos quais uma inferência sem rótulo tem o maior custo.
O problema mais profundo é a lavagem de fontes: uma cláusula cautelosa em uma seção de discussão é reescrita sem as ressalvas e, então, citada como se fosse um resultado. Padrões de proveniência existem para impedir essa transformação. O trabalho interdisciplinar multiplica o risco porque os leitores não podem recorrer a métodos compartilhados para perceber quando uma alegação mudou de status.
Quais Critérios Você Deve Usar para Avaliar um Sistema de Síntese de Evidências por AI?
Você deve avaliar um sistema de síntese de evidências por AI com base em sua capacidade de manter as camadas FCI intactas diante de discordâncias, e não pelo número de artigos que ele menciona. Fluência, velocidade e até cobertura são secundárias se o resultado não puder ser auditado. A estrutura FCI-TRACE usada aqui pontua seis dimensões.
FCI (status epistêmico)
- Fatos: O sistema consegue citar ou parafrasear muito proximamente um resultado com um localizador, como artigo, seção, figura ou tabela?
- Conclusões: Ele atribui a interpretação a autores nomeados e preserva as ressalvas?
- Inferência: Ele sinaliza passos analógicos ou integrativos como gerados pelo modelo?
TRACE (qualidade da síntese)
- Rastreabilidade: Cada afirmação é mapeada a um trecho da fonte, e não apenas ao título de um artigo.
- Recência: O sistema diferencia datas de preprints, datas de publicação e atualizações de diretrizes — uma falha conhecida até em ferramentas bibliográficas não baseadas em AI e um modo de erro documentado do ChatGPT no estudo de Walters e Wilder.
- Concordância: Achados convergentes e conflitantes são tabulados, e não reduzidos a uma falsa média de consenso.
- Cobertura: Pelo menos dois métodos disciplinares são representados quando a questão cruza domínios.
- Rotulagem epistêmica: As etiquetas de status são visíveis na prosa, e não escondidas em uma nota de rodapé.
Isso é mais rigoroso do que checklists genéricos de “AI para revisão de literatura”, que frequentemente param na busca e na sumarização. Guias universitários agora catalogam ferramentas que resumem artigos e extraem dados para tabelas estruturadas, e equipes de revisão sistemática diferenciam triagem semiautomática de triagem totalmente automática. Essas capacidades são importantes. Por si só, porém, não impedem que uma conclusão do autor seja reescrita como fato.
A transparência do protocolo também deve fazer parte da pontuação. O PRISMA 2020 é uma lista de verificação de 27 itens para revisões sistemáticas que incluem síntese, mantida com artigos explicativos pela EQUATOR Network. Nenhuma sessão de chatbot é uma revisão PRISMA. Ainda assim, um fluxo de trabalho de AI defensável deve informar a lógica de elegibilidade, as fontes pesquisadas e o que o modelo acrescentou.
Como as Principais Ferramentas de Pesquisa por AI Lidam com Fatos, Alegações dos Autores e Inferência do Modelo?
As principais ferramentas se dividem por uma linha clara: extratores fundamentados em artigos reduzem a fabricação, enquanto modelos de chat de uso geral continuam fluentes, mas com atribuição fraca — e quase nenhum impõe nativamente rótulos FCI na prosa gerada. A comparação abaixo trata de higiene epistêmica, e não de popularidade geral.
| Funcionalidade / Dimensão | ChatGPT de uso geral | Elicit | Jenova Academic Research Assistant | Scite (contexto de citação) |
|---|---|---|---|---|
| Corpus de embasamento | Dados de treinamento mais navegação opcional; citações frequentemente não verificadas | Busca, resumo e extração em 125 milhões de artigos; usado por mais de 2 milhões de pesquisadores | Recuperação acadêmica e da web em tempo real, anexos e memória persistente de sessão | Grafo de citações e contexto favorável/contrário sobre como artigos são citados |
| Rotulagem FCI na saída | Geralmente sem rótulo; fatos, alegações de discussão e saltos do modelo compartilham a mesma voz | Mais forte na extração em nível de artigo do que em etiquetas epistêmicas em nível de frase | Pode ser instruído a etiquetar camadas FCI e manter o protocolo entre sessões | Rotula a postura da citação mais do que o tipo de alegação dentro de uma síntese |
| Síntese interdisciplinar | Alta fluência; trilha de auditoria fraca entre áreas | Mais forte em questões de pesquisa empírica e extração estruturada | Mais forte quando é necessário um protocolo de métodos com acompanhamento de domínio ao longo de dias | Limitado como sintetizador; mais forte como lente de contexto de citação |
| Verificação de citações | Altas taxas de fabricação e erro em testes sistemáticos | Linhas fundamentadas em artigos reduzem referências inventadas | Recuperação com atribuição; ainda exige verificações pontuais humanas | Contexto nativo para determinar se artigos posteriores apoiam ou contradizem uma alegação |
| Triagem / extração | Não estruturada | Automatiza a triagem e a extração de dados para revisões sistemáticas | Descoberta iterativa e suporte a manuscritos, não uma interface dedicada de triagem | Não é uma bancada de triagem |
| Preços, em 2026 | Assinatura; níveis exatos para consumidores não verificados aqui | Não verificado nesta análise | Plano gratuito com uso limitado; Plus por US$ 20/mês, com 30× mais uso | Não verificado nesta análise |
| Melhor uso | Redação quando as fontes já estão disponíveis | Extração em colunas a partir de artigos empíricos | Resumos multissource entre sessões que precisam manter visíveis as camadas FCI | Verificar como uma alegação é tratada na literatura posterior |
Elicit. O escopo do produto revela um ambiente de trabalho para pesquisa, e não um chatbot: os usuários apresentam uma pergunta, recuperam artigos e extraem campos. Comparações independentes em 2026 descrevem o Elicit como mais forte para descoberta de literatura, triagem e extração de dados, enquanto o Consensus é descrito como mais forte para questões científicas de sim/não. Essa força de extração é real. A limitação é complementar: uma tabela preenchida ainda pode apresentar o verbo causal de um resumo como se fosse um resultado, a menos que o usuário defina colunas que separem achados de interpretação.
Consensus e Semantic Scholar. O Consensus é repetidamente posicionado como um mecanismo de respostas sobre artigos reais, e não como um pipeline completo de revisão (The Drive AI). Uma lista de 2026 apresentou o Consensus por cerca de US$ 144 por ano como ponto de entrada. O Semantic Scholar continua sendo uma base de descoberta nas mesmas comparações. Nenhuma das ferramentas, segundo as descrições públicas analisadas aqui, oferece uma camada obrigatória de distinção entre fatos e inferências.
Scite. O Scite é mais adequado quando a pergunta é como um artigo é citado, e não como integrar duas disciplinas. Comparações o tratam como o especialista em contexto de citações frente ao fluxo de revisão mais amplo do Elicit (Paperguide, 2026). Etiquetas de citações favoráveis versus contrastantes são valiosas e ainda distintas do FCI: um artigo posterior pode “apoiar” uma conclusão do autor que nunca foi um fato.
ChatGPT de uso geral. Ele continua sendo a escolha inadequada para síntese sem supervisão. Mesmo a taxa de fabricação de 18% do GPT-4 é incompatível com trabalhos que exigem rigor de citação, e os campos numéricos das citações, como volume, páginas e ano, são os erros mais comuns entre referências reais. Orientações de bibliotecas agora tratam citações alucinadas como um tema próprio de integridade em pesquisa.
Jenova Academic Research Assistant. Esse agente foi desenvolvido para acadêmicos e estudantes de PhD que precisam de descoberta de literatura, suporte a manuscritos e gerenciamento de citações, e não de um resumo pontual. Na plataforma Jenova, ele pode usar busca acadêmica, reter histórico ilimitado de chat e manter um protocolo de métodos em memória persistente para que as regras FCI não sejam redefinidas a cada sessão. Em conjunto com o Deep Research — que pesquisa amplamente e retorna relatórios densos em citações — é adequado para questões interdisciplinares que se desenvolvem ao longo de várias sessões.
Limitações honestas são importantes. Ele não é Covidence, DistillerSR ou Rayyan: não há uma bancada dedicada de fluxograma PRISMA nem uma grade nativa de extração de 125 milhões de artigos na escala anunciada pelo Elicit. Decisões críticas de inclusão e agregação estatística ainda pertencem a revisores humanos. A vantagem de profundidade está na persistência do protocolo e na rotulagem explícita, não na certeza automatizada.
Como a Orquestração de Conhecimento Impede que Evidências Disciplinares se Fundam em uma Única Narrativa?
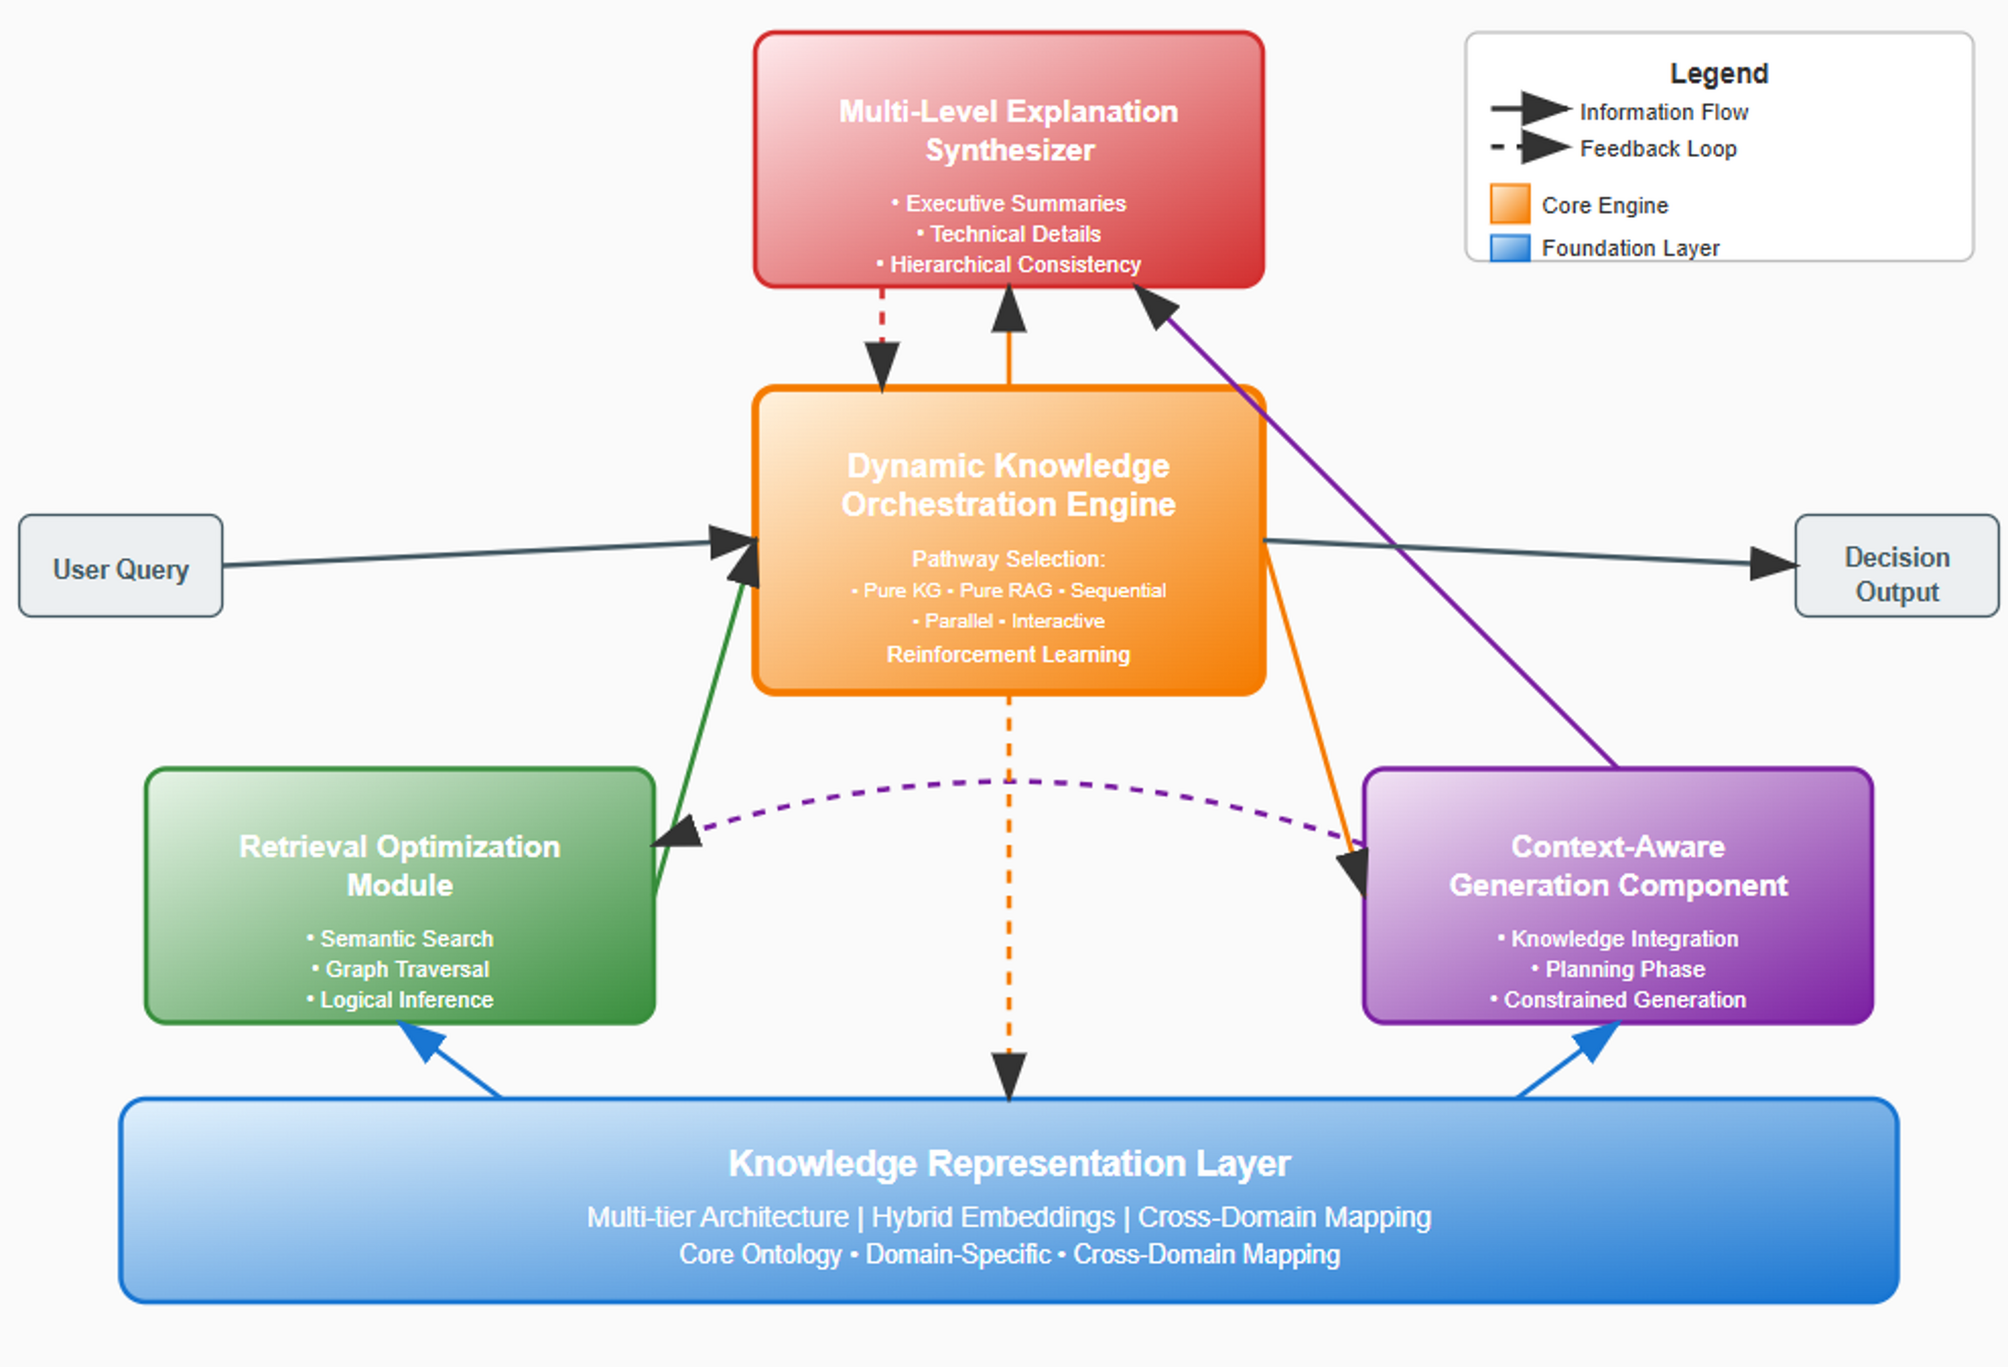
A orquestração de conhecimento mantém a integridade das evidências disciplinares ao escolher um caminho de recuperação antes da geração e, então, forçar as explicações a permanecerem hierarquicamente consistentes com o que foi recuperado. Examinar uma pilha típica de orquestração mostra por que “simplesmente recupere e escreva” não basta para o trabalho interdisciplinar.
A base é uma camada de representação do conhecimento: embeddings híbridos, ontologias de domínio e mapeamento entre domínios. Sem essa camada, um modelo trata “incerteza” na física climática, “incerteza” na econometria e “incerteza” em diretrizes clínicas como a mesma vizinhança de tokens. Não são. Mapear termos entre áreas é uma etapa de inferência e deve ser rotulado como tal.
Acima dessa camada, um módulo de otimização de recuperação combina busca semântica, travessia de grafos e inferência lógica. A travessia de grafos é importante quando a questão é relacional, como: o mecanismo A na ecologia é análogo ao mecanismo B na saúde pública? A busca semântica, por si só, retorna linguagem semelhante; ela não prova uma estrutura causal compartilhada. A inferência lógica sobre alegações extraídas está mais próxima de redes de inferência de evidências desenvolvidas para verificação interpretável de alegações.
O mecanismo de orquestração então seleciona um caminho — somente grafo de conhecimento, somente RAG, sequencial, paralelo ou interativo — em vez de sempre despejar trechos em um prompt. A recuperação paralela é apropriada quando duas disciplinas precisam ser coletadas de maneira independente antes de qualquer mapeamento. A recuperação sequencial é apropriada quando a medida de desfecho de uma área deve restringir a próxima consulta. Misturar esses modos sem informar isso é como um resumo sobre clima e saúde se torna silenciosamente uma recomendação de política pública.
Uma etapa de geração consciente do contexto deve planejar sob restrições: não gere um verbo causal se a fonte não o usa; não combine universos amostrais. A última etapa, um sintetizador de explicações em múltiplos níveis, é onde o FCI se torna visível — resumo executivo, detalhe técnico e uma verificação de consistência para que o resumo não ultrapasse as evidências. Interfaces de alegação-evidência na pesquisa atual, como o PaperTrail, apontam na mesma direção: a confiabilidade em ambientes acadêmicos depende de associar alegações às evidências, e não de uma prosa mais fluida.
O Academic Research Assistant da Jenova não expõe cada opção interna de roteamento como um controle voltado ao pesquisador. Essa é uma limitação real para equipes que precisam de um DAG totalmente inspecionável. O que ele oferece é o equivalente prático para a maioria dos fluxos de trabalho acadêmicos: instruções persistentes, corpora anexados, recuperação em tempo real e memória suficiente para manter estável um protocolo de rotulagem enquanto as evidências se acumulam.
Como um Pipeline Semântico de Citações Pode Verificar Alegações Antes que Elas Entrem em uma Síntese?
Um pipeline semântico de citações verifica alegações ao tratar cada citação como uma hipótese a ser confrontada com o documento-fonte, e não como um ornamento formatado ao fim de um parágrafo. Se essa etapa for ignorada, a síntese interdisciplinar herda toda referência inventada ou desviada que o gerador produz.
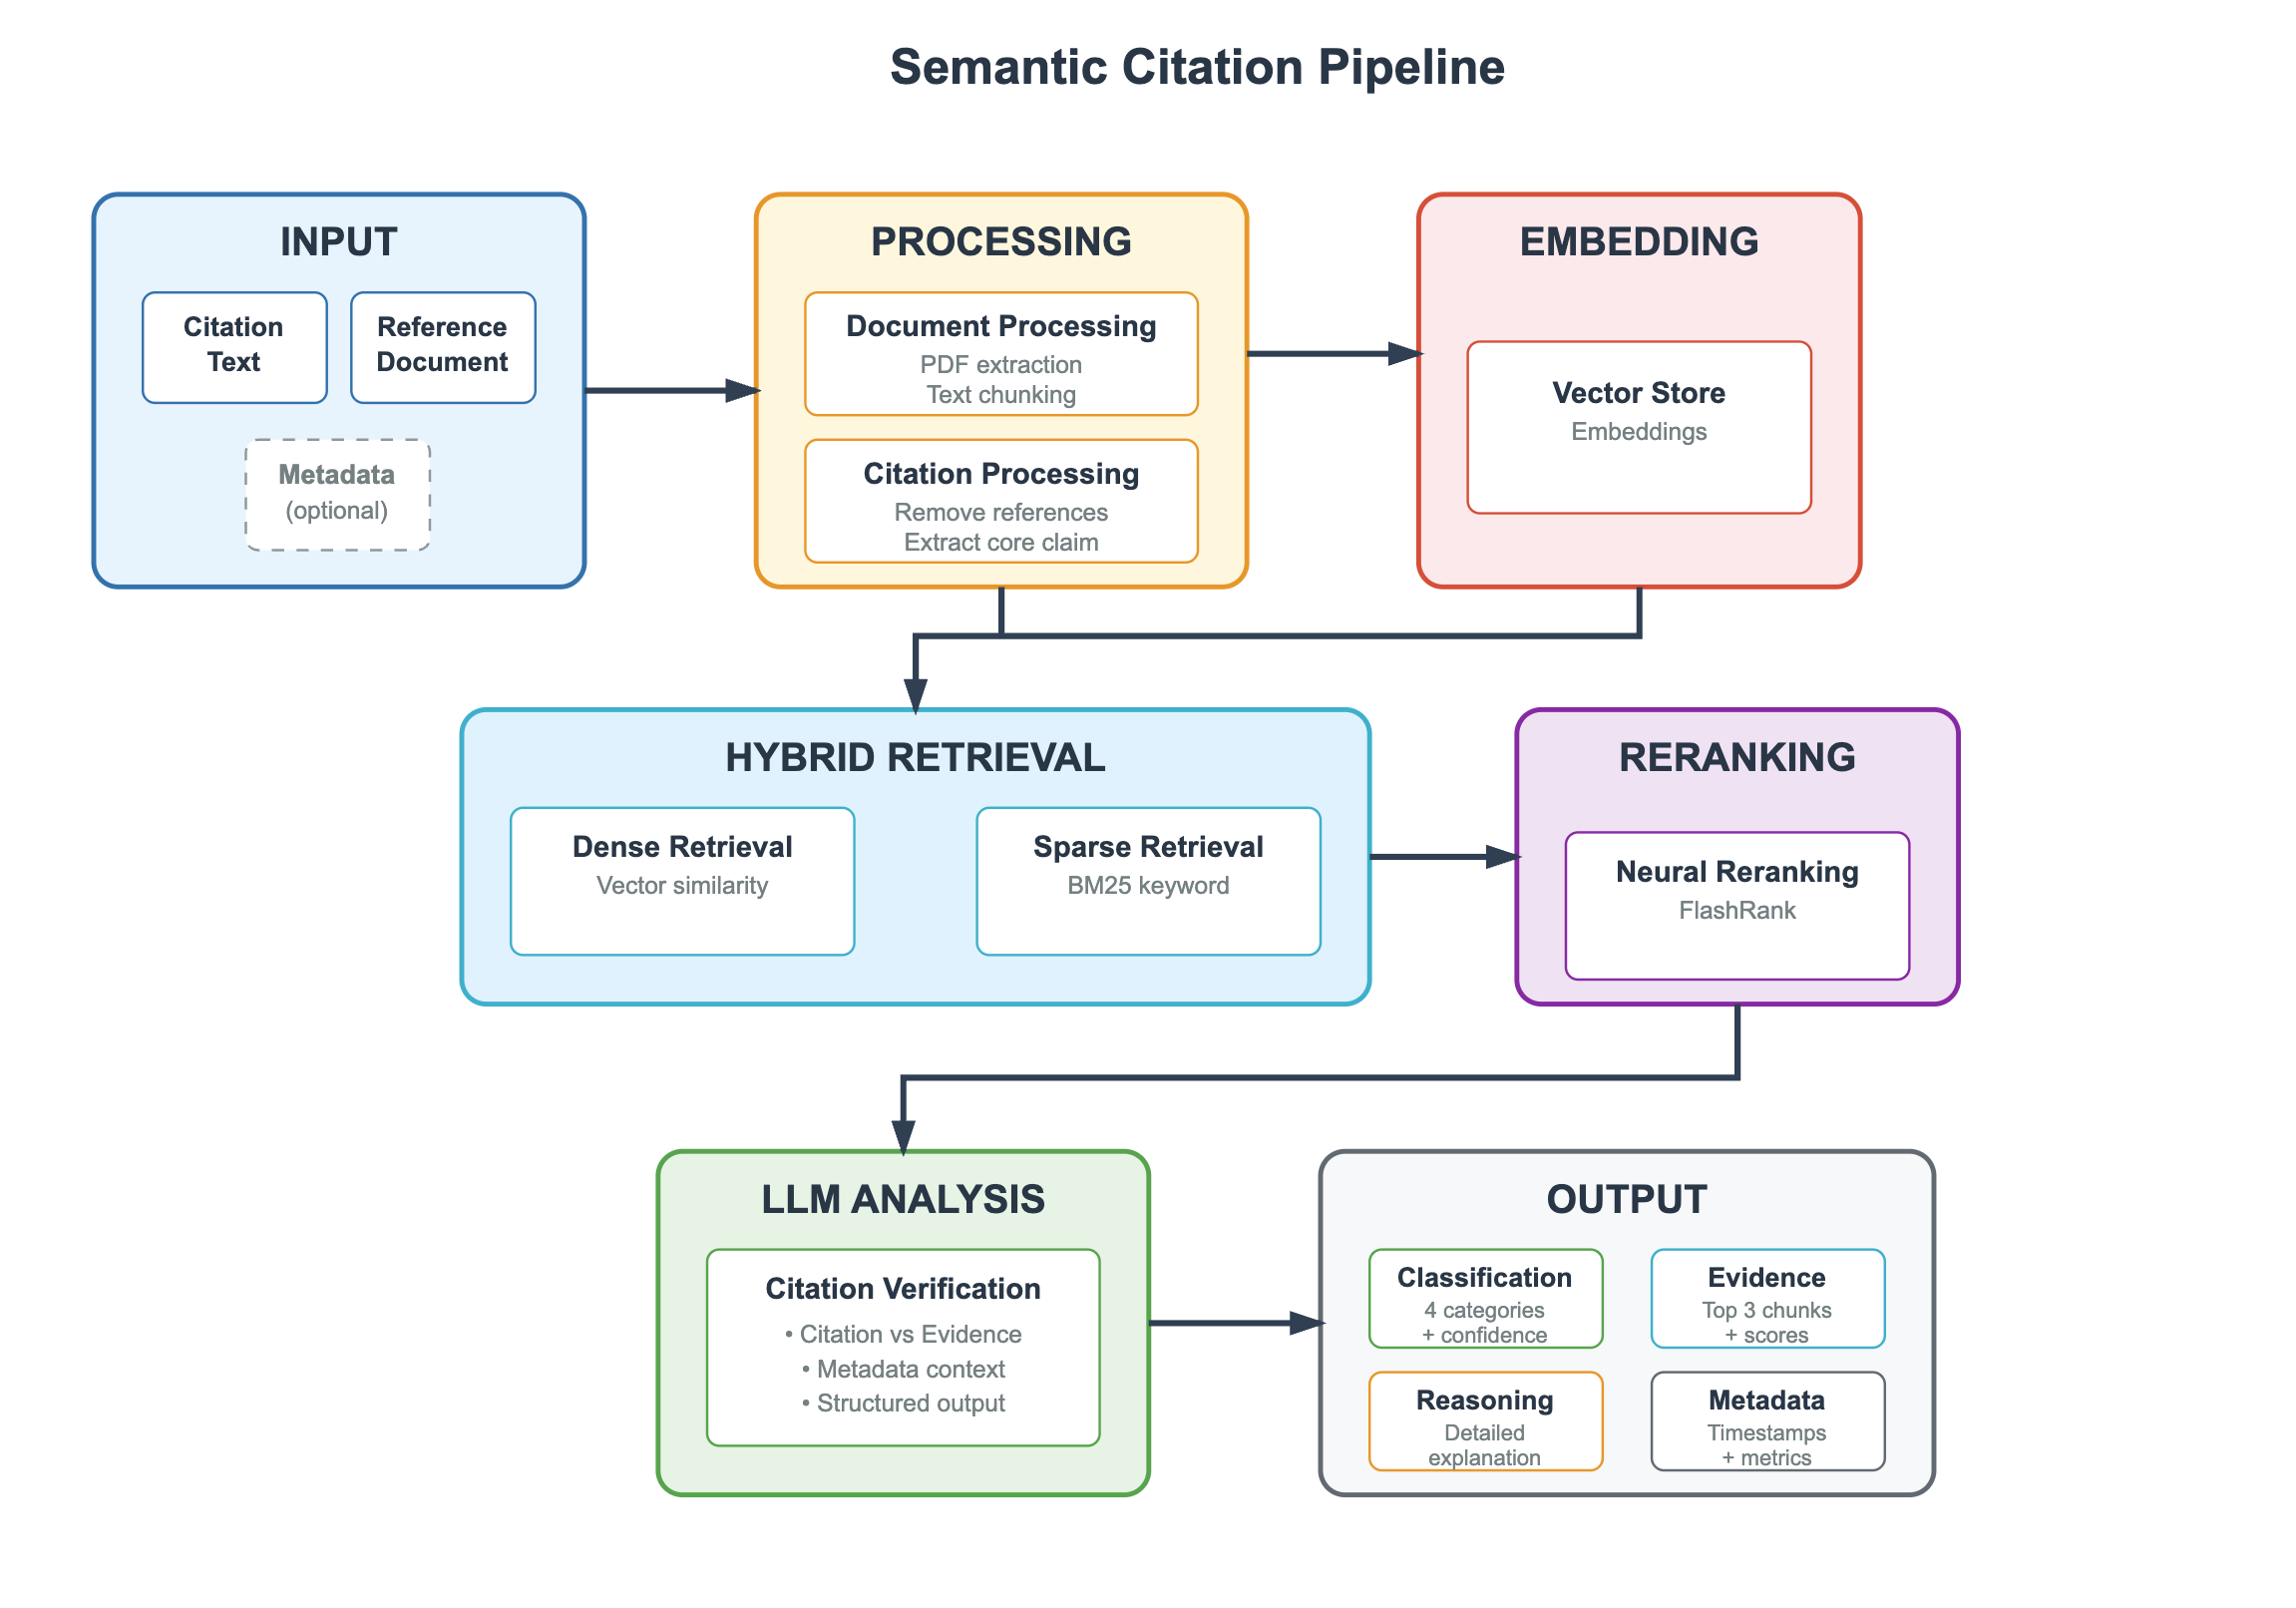
Examinar um pipeline de produção mostra uma ordem fixa. A entrada consiste no texto da citação, no documento de referência e em metadados opcionais. O processamento extrai texto do PDF, divide-o em trechos, remove a lista de referências para que o modelo não possa “verificar” uma alegação lendo a bibliografia e isola a alegação central. A vetorização armazena esses trechos. A recuperação híbrida então executa em paralelo uma busca vetorial densa e BM25 esparso — necessário porque o jargão disciplinar e a notação estatística frequentemente falham na busca pura por embeddings. O reranqueamento neural, por exemplo com FlashRank, mantém os principais trechos. Só então a análise por LLM classifica a relação entre a alegação e a evidência.
A saída útil não é uma aprovação binária. Uma classificação em quatro vias com confiança — apoiada, contradita, não abordada ou parcialmente abordada — somada aos principais trechos de evidência e a uma justificativa escrita, é o que um agente de síntese deve receber. Esse padrão acompanha o movimento mais amplo rumo à verificação explicável de alegações em nível de evidência. Ele também corresponde ao que unidades universitárias de ensino já recomendam ao descrever assistentes de AI que extraem evidências em vez de inventar narrativas.
Dois modos de falha permanecem mesmo com um pipeline. Primeiro, uma conclusão do autor corretamente citada ainda pode ser classificada equivocadamente como fato se o classificador ignorar o contexto da seção, como resultados versus discussão. Segundo, a recuperação híbrida pode apresentar uma frase muito semelhante de outro artigo no mesmo campo — deriva de citação por paráfrase. A revisão humana dos principais trechos, portanto, faz parte do método, e não é uma admissão de derrota.
Os fluxos de trabalho da Jenova podem aproximar esse pipeline ao exigir citação mais localizador antes que uma alegação seja permitida em um memorando de síntese e, então, executar o Deep Research como uma segunda passagem sobre a mesma bibliografia. Eles não substituem um serviço dedicado de verificação de citações com métricas de avaliação fixas. Para capítulos de tese e submissões a periódicos, exporte a tabela de evidências e inspecione-a.
Como Você Instrui um Agente de Pesquisa por AI a Separar Fatos, Conclusões e Inferência?
Você instrui o agente com um protocolo permanente que define rótulos, proíbe elevações silenciosas do status de uma alegação e solicita uma tabela de contradições antes de qualquer narrativa entre domínios. A escolha da ferramenta importa, mas prompts sem rótulo colapsarão o FCI em todas as plataformas.
Para o Academic Research Assistant da Jenova, uma configuração duradoura é esta:
- Abra o agente em jenova.ai/a/academic-research-assistant e informe a questão de pesquisa, as disciplinas incluídas e os limites de data.
- Cole um protocolo FCI permanente, salvando-o nas instruções personalizadas caso as mesmas regras devam se aplicar entre sessões:
“Protocolo de trabalho: Rotule cada frase como [FATO], [CONCLUSÃO DO AUTOR] ou [INFERÊNCIA DA AI]. Fatos exigem um localizador da fonte. Conclusões dos autores devem nomear o artigo e preservar as ressalvas. A inferência da AI inclui qualquer mapeamento entre domínios, salto causal ou recomendação não declarada por uma fonte. Se as evidências entrarem em conflito, não calcule uma média. Produza uma tabela: Alegação | Camada | Fonte | Localizador | Concordância (apoia / contradiz / ausente).”
- Inicie o corpus. Anexe PDFs nos quais você já confia e, depois, solicite descoberta adicional, em vez de deixar que a primeira busca defina o campo.
- Exija uma entrega em camadas — bibliografia anotada, achados etiquetados com FCI e, então, uma síntese curta que não possa introduzir novos fatos.
Um prompt inicial que geralmente produz uma estrutura utilizável:
“Pergunta: Como a intensidade da ilha de calor urbana, a qualidade habitacional e as internações cardiovasculares de emergência se relacionam em cidades de alta renda desde 2015? Disciplinas: climatologia, epidemiologia e economia urbana. Saída: (1) mapa de fontes, (2) achados etiquetados com FCI, (3) registro de contradições, (4) inferências da AI listadas por último e marcadas como não testadas. Não cite nada que você não tenha recuperado.”
No Elicit, a disciplina equivalente está no desenho das colunas, e não nos rótulos da prosa. Crie campos de extração separados para resultado relatado, interpretação dos autores, população e limitações identificadas, seguindo o fluxo de pergunta à extração da ferramenta. Não use uma única coluna de “achado principal”; é nessa coluna que verbos da discussão são promovidos a resultados.
Para um chatbot de uso geral, acrescente uma verificação adversarial que o estudo da Nature indica ser necessária: exija citações e, então, valide de forma independente cada referência em uma base de dados de biblioteca. Perguntar ao mesmo modelo “essa citação é real?” é pouco confiável. Se o projeto for uma revisão sistemática, use ferramentas de triagem descritas em orientações de bibliotecas sobre síntese de evidências para decisões de inclusão e mantenha o chatbot fora das decisões de elegibilidade.
O Deep Research da Jenova é o melhor acompanhamento quando a bibliografia é grande e você precisa de uma segunda passagem densa em citações. Use-o depois que as regras FCI estiverem em vigor, e não como a primeira varredura sem rótulo.
O Que os Metodologistas de Pesquisa Dizem Sobre a Proveniência de Evidências por AI?
Metodologistas de pesquisa tratam a síntese de AI sem rótulo como uma falha de relato, e não como ganho de produtividade: se o leitor não consegue ver qual camada uma frase ocupa, o documento ainda não é evidência. Essa visão é consistente com a exigência do PRISMA por síntese transparente e com estudos de integridade de citações que tratam referências fabricadas como uma ameaça ao registro evidencial.
“O modo de falha que observamos não é que os modelos não consigam ler artigos. É que eles escrevem em uma única voz epistêmica. Um número metodológico, uma cláusula de cautela de uma seção de discussão e uma analogia entre áreas saem do modelo em inglês com igual confiança. Comitês interdisciplinares então discutem a conclusão quando deveriam discutir a camada. Se uma frase não puder responder ‘quem afirmou isso, e isso foi medido ou inferido?’, ela não deve entrar em um relatório de resultados.”
“A rotulagem FCI é mais barata do que a retratação posterior. Equipes que exigem localizadores antes da síntese gastam mais tempo na primeira passagem e muito menos tempo desfazendo deriva de citação. O estudo da Nature sobre o ChatGPT continua sendo a linha de base de cautela: mesmo grandes reduções na fabricação deixam taxas de erro residuais inaceitáveis em uma lista de referências. A proveniência é o sistema de controle. A fluência não é.”
“Pipelines de orquestração e verificação de citações são como você operacionaliza esse padrão. Recupere disciplinas em paralelo quando elas não compartilham construtos. Verifique alegações contra trechos antes que cheguem ao sintetizador. Mantenha a etapa integrativa do modelo em um bloco separado e identificado. Essa arquitetura é mais conservadora do que um resumo de chatbot, que é justamente o objetivo.”
— Equipe de Produto da Jenova, design de agentes de pesquisa por AI, oito anos desenvolvendo fluxos de recuperação e atribuição para usuários acadêmicos e profissionais
A implicação para a escolha da ferramenta é restrita. Prefira sistemas que consigam manter um protocolo, mostrar fontes e tolerar contradições. Não prefira sistemas que apenas pareçam interdisciplinares.
Quando a Revisão Humana Deve Substituir a Síntese de AI entre Disciplinas?
A revisão humana deve substituir a síntese de AI sempre que uma alegação muda uma decisão, cruza uma fronteira de métodos disciplinares ou não pode ser rastreada até um localizador — isto é, na maior parte do trabalho que justifica a síntese em primeiro lugar. A AI é um multiplicador de redação e recuperação. Ela não é a autoridade epistêmica.
A substituição é inegociável em pelo menos cinco condições:
- Linguagem causal aparece na síntese, mas não na seção de resultados do trabalho citado.
- Há possibilidade de incompatibilidade de construtos, como “estresse” na psicologia versus “carga alostática” na medicina versus “volatilidade” na economia.
- Diretrizes ou legislação estão em jogo; as taxas de alucinação em consultas jurídicas foram especialmente altas em testes controlados.
- Está implícita uma agregação estatística. Modelos de linguagem não realizam uma meta-análise defensável ao parafrasear resumos, e o PRISMA 2020 existe especificamente para revisões que incluem síntese.
- A verificação de citações não foi executada contra o PDF. Referências inventadas ou modificadas continuam comuns o suficiente em 2026 para que periódicos e bibliotecas as tratem como um problema de integridade.
Uma divisão prática de trabalho é esta: o Academic Research Assistant propõe o mapa de fontes, as etiquetas FCI e o registro de contradições. O Elicit ou uma ferramenta de triagem é responsável pela extração estruturada quando o corpus é uma revisão formal. Um metodologista humano decide sobre elevações de camada e todas as inferências entre domínios. A AI pode sugerir o mapeamento; somente o humano pode elevá-lo.
Usada dessa forma, a síntese por AI não substitui o julgamento interdisciplinar. Ela é uma maneira de manter fatos, conclusões dos autores e inferência do modelo em fluxos separados e inspecionáveis, para que o julgamento tenha algo honesto com que trabalhar.
Referências
- Rules Integrity Initiative — Proveniência e lavagem de fontes
- Walters & Wilder, Scientific Reports — Fabricação e erros em citações bibliográficas geradas pelo ChatGPT
- Forbes — AI responsabilizada pelo aumento de citações fabricadas em artigos de pesquisa, 2026
- Enago — Alucinações de AI em citações de pesquisa, 2026
- MIT Sloan — Como lidar com alucinações e vieses de AI, incluindo taxas do Stanford HAI em consultas jurídicas
- Bibliotecas da George Mason University — Ferramentas de AI para revisões de literatura
- King's College London — Ferramentas de AI em síntese de evidências
- Declaração PRISMA 2020
- Page et al., The BMJ — A declaração PRISMA 2020
- EQUATOR Network — Diretriz de relato PRISMA
- Elicit — AI para pesquisa científica
- Paperguide — Comparação entre Elicit e Scite, 2026
- PapersFlow — Elicit versus Consensus AI
- The Drive AI — Elicit versus Consensus versus Semantic Scholar
- Omid Saffari — Melhores ferramentas de pesquisa por AI em 2026
- Biblioteca da UNC Charlotte — Citações alucinadas por AI
- Wu et al., AAAI — Redes de inferência de evidências para verificação interpretável de alegações
- PaperTrail — Uma interface de alegação-evidência para fundamentar saídas acadêmicas de LLM, arXiv
- Zhang et al., EACL — Verificação multimodal e explicável de alegações
- University of Iowa — Revisões de literatura assistidas por AI