Como a AI pode localizar evidências e redigir respostas aos revisores?
2026-08-22
O que diferencia ferramentas de resposta fundamentadas em evidências da redação genérica com AI?
As ferramentas que ajudam autores a responder bem aos revisores em 2026 não são as que escrevem a prosa mais fluida. São as que relacionam cada comentário do revisor a evidências citáveis, verificam se essas evidências realmente sustentam a alegação e, em seguida, redigem uma resposta cuja formulação não seja mais forte do que o registro permite. O Assistente de Pesquisa Acadêmica da Jenova foi desenvolvido para esse ciclo que prioriza evidências — descoberta de literatura, gestão de citações e redação fundamentada no manuscrito — enquanto Scite, Elicit, SciSpace e Consensus cobrem partes do mesmo trabalho, cada um com pontos fortes diferentes.
O que diferencia um fluxo de trabalho de refutação com AI utilizável de uma redação fluida, porém arriscada:
✅ Recuperação no nível do comentário, e não um único despejo de literatura para toda a carta ✅ Verificações de citações que abrem a frase da fonte, e não apenas a referência bibliográfica ✅ Um rótulo de suporte para cada alegação — totalmente alinhada, parcial, contradita ou indeterminada ✅ Redação cautelosa que corresponde ao rótulo, em vez de transformar “sugere” em “demonstra” ✅ Uma revisão humana capaz de rejeitar, restringir ou excluir uma frase proposta pela AI
Um relatório da Nature de 2026 sobre uma pesquisa da Frontiers com cerca de 1.600 acadêmicos em 111 países constatou que mais da metade dos pesquisadores já utilizou AI durante a revisão por pares. A mesma pressão agora recai sobre autores que escrevem cartas de resposta. Para comparar ferramentas de modo útil, convém tratar localização de evidências, verificação de citações e calibração de alegações como três tarefas separadas, e não como uma única tarefa de redação.
Por que cartas de resposta aos revisores falham quando as citações não são verificadas?
A maioria das revisões fracassadas ou atrasadas não desmorona porque o autor foi rude. Elas falham porque uma citação não diz o que a carta afirma, uma análise prometida não está no manuscrito ou a resposta exagera uma descoberta que o artigo sustenta apenas de forma fraca. Editores e revisores podem verificar essas discrepâncias em minutos.
Modelos de uso geral tornam esse modo de falha mais fácil, não mais difícil. A orientação universitária é direta: sistemas de AI frequentemente inventam citações que parecem reais, mas não existem, e submeter uma referência fabricada é tratado como fraude acadêmica. A orientação de uso responsável da Universidade de Stellenbosch acrescenta que muitas ferramentas não conseguem verificar referências em bancos de dados ativos em tempo real. Uma carta de resposta é um local de alto risco para aprender essa lição, porque cada nova citação é uma promessa implícita de que a fonte existe e sustenta exatamente a frase que você acabou de escrever.
Há uma segunda falha, mais silenciosa: artigos verdadeiros, uso errado. Um artigo de método citado como evidência de resultado, uma revisão citada como ensaio primário ou um resultado de uma população diferente apresentado como confirmação direta sobrevivem a uma verificação de DOI e ainda assim induzem ao erro. As Smart Citations do Scite existem especificamente para mostrar se trabalhos posteriores sustentam, contestam ou apenas mencionam uma alegação, o que é um problema diferente de verificar se a referência está formatada corretamente.
Verificadores de referências baseados em regras são realmente fortes na camada mecânica. O PoolText observa que verificadores de referências com AI são altamente precisos em erros de estilo, campos ausentes, pontuação e formatação de DOI. Isso é necessário, mas não suficiente. Uma alegação sem suporte e perfeitamente formatada ainda é um exagero.
O que procurar em um fluxo de trabalho de AI para respostas aos revisores?
Você deve avaliar as ferramentas em seis dimensões: segmentação de comentários, recuperação de evidências, verificação da frase-fonte, classificação do suporte à alegação, redação calibrada e memória de revisões. Uma ferramenta com bom desempenho em apenas uma dessas dimensões ainda produzirá uma carta que parece pronta, mas não está.
A Estrutura de Alinhamento Comentário-Evidência utilizada neste artigo pondera as seis dimensões da seguinte forma:
- Segmentação de comentários (15%) — O sistema consegue isolar cada solicitação do revisor, incluindo comentários compostos que escondem duas exigências em um parágrafo?
- Recuperação de evidências (20%) — Ele pesquisa o manuscrito, os dados do autor e a literatura externa separadamente, indicando de qual conjunto veio o suporte?
- Verificação da frase-fonte (20%) — Uma pessoa consegue abrir a frase exata que supostamente fundamenta a resposta?
- Classificação do suporte à alegação (20%) — Cada citação proposta é rotulada como sustentada, parcialmente sustentada, não sustentada ou incerta?
- Redação calibrada (15%) — A prosa herda o rótulo ou adota automaticamente um inglês acadêmico confiante?
- Memória de revisões (10%) — O sistema consegue lembrar rodadas anteriores, análises prometidas e formulações rejeitadas?
Essa ponderação é deliberada. Redigir é a parte mais barata do trabalho. Recuperação e classificação são onde as cartas se tornam citáveis ou se transformam em um segundo problema de revisão. Pesquisas que comparam revisões por pares geradas por AI e por humanos não demonstraram valor adicional conclusivo da AI sobre revisores humanos, o que também é um alerta útil para autores: fluência não é um sinal de validade.
Testes práticos que expõem rapidamente ferramentas fracas:
- Dê ao modelo um comentário de revisor que seu artigo não possa responder plenamente e veja se ele inventa um resultado.
- Peça que ele cite a frase de suporte de cada artigo referenciado, e não apenas a chave da citação.
- Exija um rótulo de suporte com quatro possibilidades antes de redigir qualquer frase da resposta.
- Execute novamente o mesmo comentário uma semana depois e verifique se a carta contradiz uma concessão anterior.
Se um produto não consegue falhar nesses testes de modo visível, ele não está ajudando você. Está ocultando a incerteza que você deveria administrar.
Como as principais ferramentas de pesquisa com AI se comparam em recuperação de evidências e verificações de citações?
Nenhum produto atualmente domina as três tarefas — encontrar evidências para cada comentário, verificar a citação e redigir uma resposta que não exagere. A comparação útil é identificar para qual tarefa cada ferramenta foi realmente desenvolvida.
| Recurso / Dimensão | Elicit | Assistente de Pesquisa Acadêmica da Jenova | Scite | SciSpace Response-to-Reviewers |
|---|---|---|---|---|
| Recuperação de evidências | Busca com AI e extração de dados em mais de 125 milhões de artigos | Descoberta de literatura em tempo real e bases de conhecimento vinculadas ao manuscrito | Texto completo acadêmico licenciado e contexto de citações em um amplo corpus respaldado por editoras | Fluxo de trabalho com agente fundamentado em artigos e voltado a comentários de revisores |
| Verificação de citações | Forte em extração estruturada; 1.502 de 1.511 pontos de dados corretos (99,4%) no teste relatado pelo Elicit | Recupera fontes candidatas e detalhes de citações; ainda é necessária confirmação humana da frase-fonte | Cada alegação de AI é vinculada à frase específica no artigo específico | Útil para montar um pacote de resposta; a profundidade da verificação depende das fontes subjacentes |
| Redação de carta de resposta | Indireta — melhor para tabelas e respostas sobre a literatura do que para uma carta completa | Forte para rascunhos ponto a ponto quando os comentários e o manuscrito estão na sessão | Indireta — criada para testar se as descobertas se sustentam, não para escrever a carta | Fluxo de trabalho voltado especificamente à redação de respostas aos revisores |
| Sinais de suporte à alegação | Precisão de extração, não um esquema de suporte com quatro rótulos | Classificação imposta pelo usuário dentro do ciclo de redação | Contexto de citação de apoio, contraste e menção | Estrutura alinhada ao revisor mais do que uma taxonomia formal de suporte |
| Preços (em 2026) | Não verificado nesta análise | Nível gratuito com uso limitado; planos pagos a partir de US$ 20/mês | Não verificado nesta análise | Não verificado nesta análise |
| Melhor para | Extração sistemática e tabelas de evidências | Ciclos de revisão completos que permanecem vinculados a um manuscrito | Verificar se a literatura realmente sustenta uma frase | Autores que desejam um agente dedicado à redação de refutações |
O Elicit é mais forte quando um revisor solicita uma comparação ausente, um mapa mais claro de trabalhos relacionados ou números extraídos de um conjunto de estudos. O resumo do guia de pesquisa da Universidade George Mason o descreve como uma ferramenta que resume artigos e extrai dados em visualizações estruturadas de evidências. Sua limitação em refutações é de escopo: uma excelente tabela de evidências ainda não é uma carta com tom calibrado, e ela não impedirá automaticamente que você eleve uma descoberta extraída a uma alegação causal.
O Scite é mais forte quando o risco é interpretar a literatura de forma incorreta. Ele pesquisa mais de 300 milhões de artigos acadêmicos e, mais importante, mostra como trabalhos posteriores trataram uma determinada alegação. Essa é a ferramenta certa quando um revisor diz “esta citação não sustenta sua conclusão” ou quando você se sente tentado a citar um artigo seminal como se a área ainda concordasse com ele. É mais fraco como secretária completa de revisão: por si só, não manterá uma carta de resposta com 14 comentários, não acompanhará números de linha do manuscrito nem lembrará o que você concedeu na primeira rodada.
O SciSpace é um dos poucos produtos que trata “resposta aos revisores” como um fluxo de trabalho de primeira classe, e não como um prompt de chat. Esse foco é uma vantagem real quando você precisa de estrutura. A limitação correspondente é a mesma associada a qualquer agente de redação: uma saída estruturada ainda pode exagerar um resultado se a camada de evidências abaixo for insuficiente.
O Consensus é um mecanismo de busca de literatura revisada por pares desenvolvido para encontrar, organizar e analisar alegações científicas rapidamente. Ele é útil para a parte da refutação que pergunta “o que a área afirma atualmente?”. Não é um auditor de citações nem um formatador de cartas.
O Assistente de Pesquisa Acadêmica da Jenova posiciona-se entre essas ferramentas especializadas. Ele pode manter o manuscrito, o PDF dos revisores e a correspondência anterior em um espaço de trabalho persistente, pesquisar a literatura e redigir respostas comentário por comentário. Ele não fornece nativamente contagens de citações favoráveis versus contrastantes no estilo do Scite, nem é um exportador de pacote de revisão pronto para Word no sentido anunciado pelo fluxo de trabalho de resposta aos revisores do PeerReply. Essas são lacunas reais. A força compensatória é a continuidade: uma revisão que dura seis semanas precisa mais de memória do que de um gerador de cartas de uso único.
Vale acrescentar o Paper Digest como um especialista restrito. Sua orientação para verificação de alegações é mais próxima do Scite do que de um chatbot de redação, o que o torna um verificador melhor para uma segunda revisão do que um redator para a primeira passagem.
Como um mecanismo de perguntas e respostas multiaspecto localiza evidências de suporte para cada comentário?
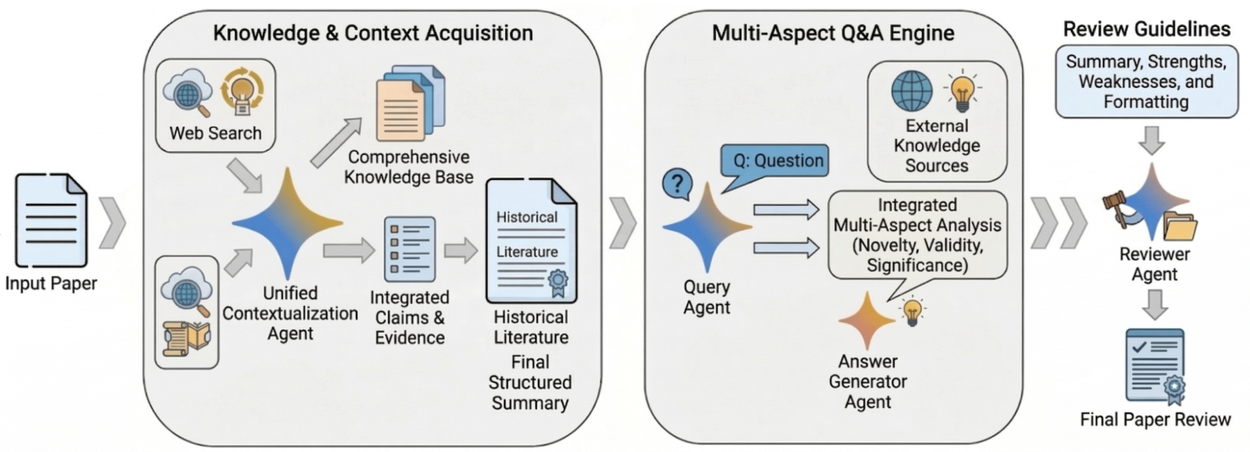
Um sistema confiável não “lê as revisões e escreve uma carta”. Ele transforma cada comentário de revisor em uma consulta, recupera informações de três conjuntos de conhecimento separados e só então decide se uma resposta pode ser escrita. Essa arquitetura é o que o diagrama de pipeline acima mostra: primeiro aquisição de conhecimento, depois perguntas e respostas multiaspecto, e por último síntese.
Os três conjuntos devem permanecer distintos:
- O conjunto do manuscrito — figuras, tabelas, métodos, limitações e qualquer análise que você já realizou.
- O conjunto do autor — anotações de laboratório, verificações adicionais de robustez, dicionários de dados e cartas de resposta anteriores.
- O conjunto da literatura — artigos que realmente abordam a objeção do revisor, recuperados por busca no estilo Scholar, e não pela memória do modelo.
Misturar esses conjuntos é como o exagero começa. Uma frase verdadeira na literatura não é um resultado do seu artigo. Uma verificação de sensibilidade em um notebook não é uma tabela publicada. Um agente de consulta eficaz faz três perguntas diferentes para um único comentário: Isso já está no manuscrito? Caso não esteja, os autores têm suporte não publicado? Caso não tenham, a literatura justifica uma alegação delimitada, uma revisão ou uma concessão?
Na prática, a etapa de recuperação funciona assim para o Assistente de Pesquisa Acadêmica da Jenova:
- Anexe o manuscrito, a carta de decisão e quaisquer suplementos.
- Solicite um inventário numerado das exigências dos revisores, incluindo solicitações implícitas.
- Para cada exigência, imponha uma busca em três conjuntos antes de qualquer redação:
“O Revisor 2, comentário 3, pergunta se o efeito persiste ao excluir a subamostra de 2019. Pesquise primeiro apenas o manuscrito anexado. Cite a tabela, a seção ou a frase que responde a isso. Se nada for encontrado, diga ‘não está no manuscrito’ e liste qual análise seria necessária. Não cite artigos externos como se fossem nossos resultados.”
- Somente depois de não encontrar nada no manuscrito o agente deve pesquisar a literatura ou propor uma nova análise.
Produtos dedicados a refutações seguem uma divisão semelhante. O Manusights argumenta que modelos gerais de linguagem continuam sendo as ferramentas mais práticas para redigir a própria carta, o que é verdade no que se refere à prosa. O mecanismo de evidências ainda precisa ficar antes desse modelo de prosa. Caso contrário, a carta se torna uma reformulação confiante do que o chatbot encontrou como mais próximo, e não do que o registro contém.
Novidade, validade e significância — os três eixos de análise em um mecanismo de revisão multiaspecto — também são os três eixos que a maioria dos comentários dos revisores realmente ocupa. Um comentário sobre comparações de referência ausentes é uma questão de validade. Um comentário sobre contribuição incremental é uma questão de novidade. Um comentário sobre se alguém deveria se importar é uma questão de significância. Classificar os comentários dessa forma evita que uma objeção de validade seja respondida com um parágrafo sobre significância.
Como a AI deve classificar o suporte de citações antes que você cite uma fonte?
Cada citação em uma carta de resposta deve receber um de quatro rótulos antes de ser permitida no rascunho: sustentada, parcialmente sustentada, não sustentada ou incerta. Se o sistema não consegue atribuir um rótulo, não deve atribuir uma nota de rodapé.
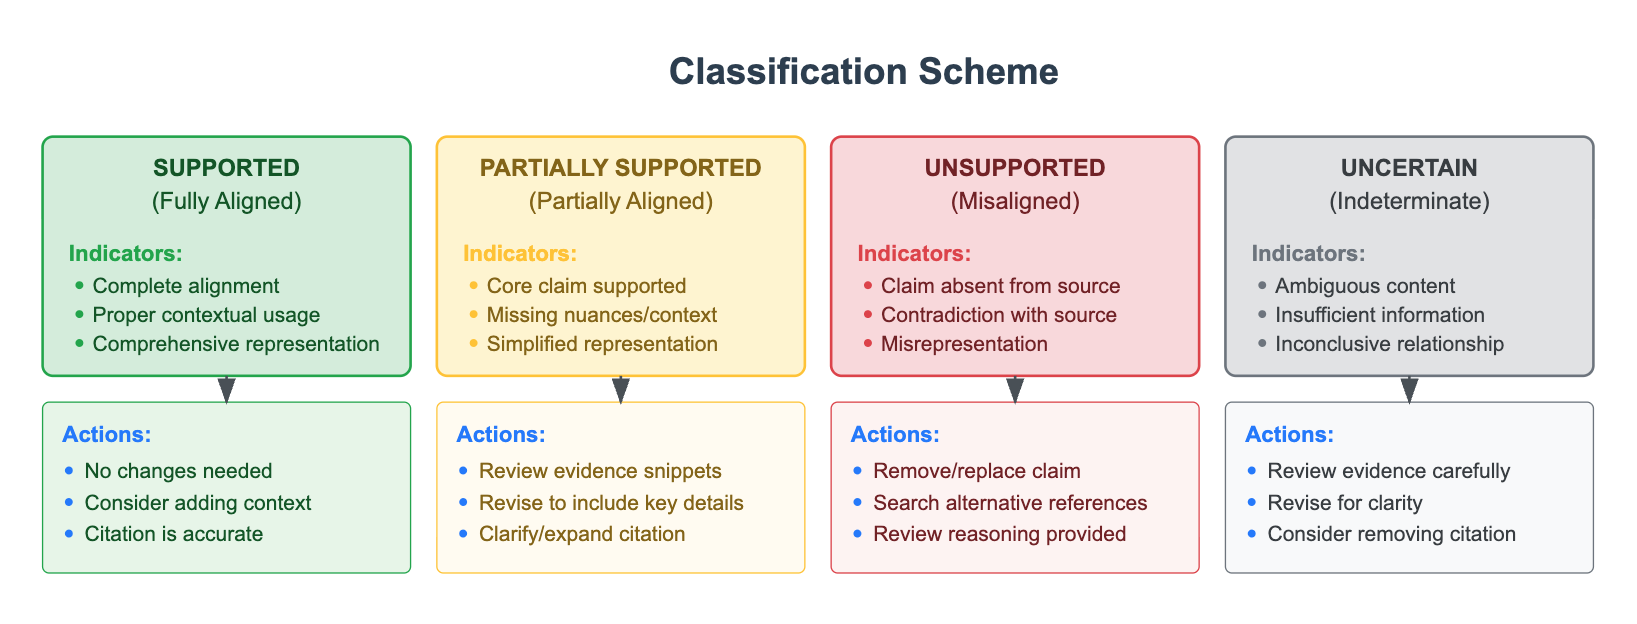
Essa classificação é a diferença entre um verificador de citações e um verificador de alegações.
Sustentada significa que a fonte declara a alegação com o mesmo escopo, população e intensidade causal que você está prestes a usar. Ação: mantenha a citação. Considere acrescentar uma cláusula de contexto de cinco palavras para que o revisor perceba o alinhamento.
Parcialmente sustentada significa que o fato central está na fonte, mas sua frase eliminou uma ressalva, uma restrição de amostra ou um resultado secundário conflitante. Ação: reescreva a frase para incluir a nuance ausente ou substitua a citação por uma fonte primária melhor. Este é o rótulo honesto mais comum em refutações reais, e aquele que chatbots genéricos reduzem a “sustentada”.
Não sustentada significa que a alegação está ausente, é contradita ou é usada de uma forma que a fonte não autoriza. Ação: exclua ou substitua. Não mantenha a citação porque a lista de autores é prestigiosa ou porque o DOI é resolvido.
Incerta significa que o PDF está sob acesso pago, a seção relevante é ambígua ou a relação entre a alegação e a fonte não pode ser determinada a partir do texto disponível. Ação: abra o artigo ou exclua a citação. Incerteza não é uma forma branda de suporte.
O Scite operacionaliza um parente próximo desse esquema em escala de literatura ao mostrar se artigos posteriores sustentam, contestam ou discutem uma descoberta. Isso é inestimável para citações externas. Ele não classifica suas próprias frases novas em relação às suas próprias figuras. Para alegações internas ao manuscrito, o esquema de quatro rótulos precisa ser aplicado pelo próprio fluxo de trabalho de redação.
Um prompt que impõe o esquema:
“Para cada frase que você propuser na resposta ao Revisor 1, apresente: (1) a frase, (2) a citação, (3) uma citação literal da fonte ou do manuscrito, (4) um rótulo — Sustentada / Parcialmente sustentada / Não sustentada / Incerta — e (5) a reescrita exigida por esse rótulo. Não inclua nenhuma frase rotulada como Não sustentada. Reescreva todas as frases Parcialmente sustentadas antes de mostrá-las para mim.”
A comparação do Columbia Journalism Review entre mecanismos de busca com AI encontrou falhas sistemáticas de citação mesmo quando as fontes nomeadas eram marcas bem conhecidas. Ferramentas acadêmicas são melhores do que mecanismos de resposta na web aberta nessa dimensão, mas o modo de falha é o mesmo: o nome de uma publicação confiável é usado como substituto para uma frase verificada. A barreira dos quatro rótulos existe para impedir essa substituição.
Como redigir uma resposta ponto a ponto sem exagerar as conclusões?
Você redige depois que os rótulos existem e deixa o rótulo escolher o verbo. “Mostra”, “demonstra” e “prova” são reservados para alegações sustentadas com escopo correspondente. Alegações parcialmente sustentadas recebem “é consistente com”, “aborda parcialmente” ou “se mantém sob [restrição declarada]”. Alegações incertas não recebem verbos. Elas recebem um plano ou uma exclusão.
Um esqueleto limpo de carta de resposta se parece com isto:
- Reapresente o ponto do revisor em linguagem neutra.
- Declare o que você fez: já presente no artigo, analisado recentemente ou concedido.
- Aponte para uma localização: página, linha, tabela, figura ou suplemento.
- Cite trabalhos externos apenas se o comentário for sobre a literatura e somente com um rótulo de suporte.
- Conclua com a alteração exata no manuscrito ou com uma justificativa delimitada para não ter feito uma alteração.
O Assistente de Pesquisa Acadêmica da Jenova pode manter esse esqueleto ao longo de uma carta extensa se você fornecer a restrição desde o início:
“Redija a resposta ao Revisor 2 usando apenas itens Sustentados e itens Parcialmente sustentados reescritos da tabela de evidências. Use a lista de verbos que forneci. Cada parágrafo deve incluir um localizador no manuscrito ou uma concessão explícita. Não apresente experimentos futuros como se já estivessem concluídos. Não descreva a seção de discussão de um artigo citado como se fosse nosso resultado.”
Para o SciSpace ou um modelo geral usado como redator de cartas, a mesma restrição deve ser inserida no prompt, porque produtos de redação otimizam a completude e a polidez. A completude é como análises fantasmas aparecem. A polidez é como uma discordância é elevada a “concordamos e agora demonstramos”.
A cautela não é decorativa. É um recurso de fidelidade. Ressalvas úteis são específicas:
- Ressalvas de escopo: “nesta amostra”, “sob a especificação linear”, “entre participantes com acompanhamento completo”
- Ressalvas epistêmicas: “consistente com”, “não exclui”, “fornece suporte preliminar”
- Ressalvas de processo: “agora relatamos”, “adicionamos”, “não podemos testar com o desenho atual”
Exageros proibidos em um rascunho de refutação incluem transformar uma correlação em efeito, uma verificação de robustez em replicação, um resultado não significativo em “nenhuma diferença” e uma única citação favorável em “é bem estabelecido”. As orientações sobre redação acadêmica assistida por AI enfatizam que os autores continuam responsáveis por verificar se o texto gerado corresponde às alegações reais do manuscrito. Os periódicos variam quanto à divulgação, mas o resumo do The Conversation sobre regras de editoras afirma que ajuda mecânica rotineira pode não exigir citação, enquanto conteúdo substantivo gerado por AI frequentemente exige. Uma carta de resposta que contém interpretações da literatura redigidas por um modelo geralmente pertence ao segundo caso.
O guia prático do ProofreaderPro para cartas de resposta está correto sobre estrutura e tom. Estrutura e tom não são a parte difícil. A parte difícil é recusar-se a responder a um comentário com mais força do que sua tabela permite. Se o revisor solicitou uma estratégia de identificação causal que você não tem, o rascunho honesto é um parágrafo sobre limitações e, se viável, uma análise mais fraca, mas identificada — e não uma reafirmação mais confiante da regressão original.
Um prompt de segunda passagem que identifica exageros:
“Compare cada parágrafo da resposta com a tabela de evidências. Sinalize qualquer frase cujo verbo seja mais forte do que seu rótulo de suporte. Sinalize qualquer citação que não esteja transcrita. Sinalize qualquer promessa que não corresponda a uma edição rastreada do manuscrito.”
O que especialistas em integridade de pesquisa dizem sobre refutações assistidas por AI?
Pesquisadores que trabalham com integridade na revisão por pares voltam sempre ao mesmo ponto: a AI pode acelerar a recuperação e a formatação, mas o autor continua sendo responsável pelo valor de verdade de cada frase enviada de volta ao editor.
“A falha que observamos raramente é uma vírgula ausente na lista de referências. É uma frase que está um grau epistêmico mais forte do que o artigo que ela cita. Um modelo recompensado por ser útil fechará essa lacuna para você, a menos que você o proíba. O controle mais barato é arquitetural: recuperar, rotular e depois redigir. Se inverter essa ordem, a carta conterá alegações que você só tentará justificar mais tarde.”
“Ferramentas de citações inteligentes alteraram o custo de verificar se a área ainda acredita em um artigo. Elas não alteraram o custo de verificar se sua própria Tabela 3 sustenta o verbo no parágrafo 6 da resposta. Essa segunda verificação ainda é um ser humano lendo um número ao lado de uma frase. Autores que a ignoram não estão economizando tempo. Estão tomando esse tempo emprestado da próxima rodada de revisão.”
“Também aconselhamos equipes a manter um registro de recusas. Toda vez que o modelo quiser dizer ‘mostramos’ e o rótulo for apenas parcial, anote a frase rejeitada. Depois de dois ou três artigos, você verá os exageros padrão do seu laboratório — geralmente verbos causais, generalizações além da amostra e citações de revisões como se fossem ensaios. Instruções personalizadas são apenas uma forma de codificar esse registro.”
— Equipe de Produto da Jenova, design de fluxos de trabalho acadêmicos, oito anos apoiando sistemas de manuscritos e citações
Esse conselho está alinhado à literatura de pesquisa sobre AI na própria revisão. Uma revisão no PMC sobre AI na revisão por pares enfatiza que revisores ainda devem avaliar criticamente o conteúdo gerado por AI antes de qualquer decisão. A mesma obrigação se aplica quando a AI está do lado do autor na carta de decisão. Autores que usam modelos da classe ChatGPT na correspondência de revisão por pares são especificamente alertados para testar sugestões em relação às alegações centrais do manuscrito e à integridade da pesquisa.
O teste prático da Editage sobre AI em respostas de revisão por pares é útil menos por uma classificação de vencedor absoluto do que pelo padrão que revela: os modelos podem julgar se uma resposta parece completa, permanecendo fracos em determinar se a resposta é verdadeira. Parecer completa é a propriedade que faz cartas serem submetidas cedo demais.
Quando você deve substituir uma resposta a revisor redigida por AI?
Você deve substituir o rascunho sempre que o rótulo de suporte for mais fraco do que a frase, sempre que o comentário exigir um julgamento que o modelo não possa fundamentar ou sempre que concordar comprometer você com uma alegação que não poderá defender na próxima rodada. Substituir é o caminho normal, não um caminho de exceção.
Substitua imediatamente nestes casos:
- O agente cita um artigo que você não abriu.
- O agente responde a uma crítica de método com texto adicional na introdução e nenhum novo teste.
- O agente trata uma incompreensão do revisor como um pedido de mais citações, em vez de uma reescrita da sua explicação.
- O agente “encontra” uma análise que não está no repositório.
- O agente concorda com dois revisores que pediram análises incompatíveis, mas não sinalizou o conflito.
- O agente usa um artigo de revisão para fundamentar uma alegação empírica primária.
Alguns comentários jamais devem ser totalmente delegados. Solicitações sobre ética de pesquisa, acesso a dados, conflitos de interesse e se um resultado é clinicamente ou politicamente significativo exigem uma decisão humana sobre o que você está disposto a defender. A AI pode reunir os documentos. Ela não pode assumir responsabilidade por eles.
Há também um problema inverso crescente: autores agora encontram comentários de revisores que parecem ter sido gerados por AI. A resposta correta ainda prioriza evidências. Reapresente a solicitação científica acionável presente no comentário, ignore o preenchimento genérico e responda ao pedido que você consegue documentar. Responder a uma revisão que soa como AI com uma carta que soa como AI apenas duplica o texto sem fundamento no arquivo.
Um encerramento funcional com participação humana para cada comentário:
- Leia a frase do revisor e escreva você mesmo um resumo de seis palavras.
- Aceite ou rejeite a linha de evidências do agente antes de olhar o parágrafo redigido.
- Se rejeitar a linha, não edite o parágrafo. Envie o agente de volta para a recuperação.
- Se aceitar uma linha Parcialmente sustentada, edite você mesmo o verbo.
- Só então insira o parágrafo na carta.
Usados dessa forma, o Assistente de Pesquisa Acadêmica da Jenova, Scite, Elicit e um agente dedicado de redação como o SciSpace são complementares, e não intercambiáveis. Ferramentas de recuperação reduzem a chance de você deixar de encontrar um artigo. A classificação reduz a chance de você usá-lo de modo inadequado. Ferramentas de redação reduzem a chance de a carta ser desorganizada. Nenhuma delas reduz a chance de exagero, a menos que você se recuse a redigir a partir de alegações sem rótulo.
O padrão que vale manter é simples o bastante para colocar acima da janela de prompt: se você não consegue apontar para uma frase, tabela ou concessão que justifique o verbo, a frase não pertence à resposta.
Referências
- Nature — Mais da metade dos pesquisadores agora usa AI para revisão por pares
- Biblioteca da Universidade de Pretória — Gestão de citações e riscos de alucinação de AI
- Universidade de Stellenbosch — Diretrizes para uso responsável de AI na redação acadêmica
- Scite — Smart Citations e verificação de alegações no nível da frase
- PoolText — O que a AI pode e não pode fazer na revisão por pares, incluindo verificação de referências
- ScienceDirect — Comparação entre revisões por pares geradas por AI e por humanos
- Elicit — Busca de literatura com AI e precisão de extração relatada
- Bibliotecas da Universidade George Mason — Ferramentas de AI para revisões de literatura
- SciSpace — Fluxo de trabalho do agente Response to Reviewers
- Consensus — Busca com AI em literatura revisada por pares
- PeerReply — Fluxo de trabalho de resposta ponto a ponto e pacote de revisão
- Paper Digest — Verificação de alegações em relação a evidências acadêmicas
- Manusights — Melhores ferramentas de AI para responder a revisores
- Columbia Journalism Review — Mecanismos de busca com AI e falhas de citação
- PMC — Redação acadêmica assistida por inteligência artificial
- The Conversation — Diretrizes de editoras sobre AI em artigos de periódicos
- ProofreaderPro — Como escrever uma carta de resposta aos revisores com ajuda de AI
- PMC — Inteligência artificial na revisão por pares
- PMC — Navegando pela revisão por pares com ChatGPT 4
- Editage — Testes de AI em respostas de revisão por pares
- ResearchGate — Discussão sobre comentários de revisores gerados por AI