Como a IA Pode Extrair Evidências por Pergunta de Pesquisa de Centenas de Artigos?
2026-08-21
Como os Fluxos de Trabalho de Extração Ancorados em Perguntas Diferem das Ferramentas de IA que Priorizam Resumos?
Fluxos de trabalho ancorados em perguntas retornam campos comparáveis e vinculados às fontes para uma pergunta de pesquisa predefinida; ferramentas que priorizam resumos retornam parágrafos fluentes que reformulam cada artigo conforme seus próprios termos. Em 2026, essa distinção importa mais do que a marca do modelo. Jenova's Academic Research Assistant é mais indicado para extração iterativa orientada por perguntas, com memória persistente e suporte à elaboração de manuscritos. O Elicit é mais forte para matrizes de pesquisas empíricas. O Covidence continua sendo o padrão para revisões sistemáticas com dois revisores que precisam seguir as diretrizes de relato do PRISMA 2020.
Fatores-chave que separam a extração de evidências da sumarização por artigo:
✅ Fidelidade à pergunta — cada célula responde à sua pergunta, não ao enquadramento que o próprio artigo faz de sua contribuição.
✅ Estrutura no nível de campo — métodos, tamanho da amostra, desfechos e direção do efeito ficam em colunas personalizadas vinculadas a trechos da fonte.
✅ Comparabilidade entre artigos — contradições e diferenças de delineamento tornam-se visíveis apenas quando os campos estão alinhados.
✅ Verificações de contexto de citação — uma conclusão citada é testada novamente diante da literatura posterior, e não assumida como verdadeira apenas porque foi citada.
✅ Adjudicação humana — modelos de linguagem de grande porte aceleram a extração, mas o uso sem supervisão ainda não está pronto para sínteses de alto impacto.
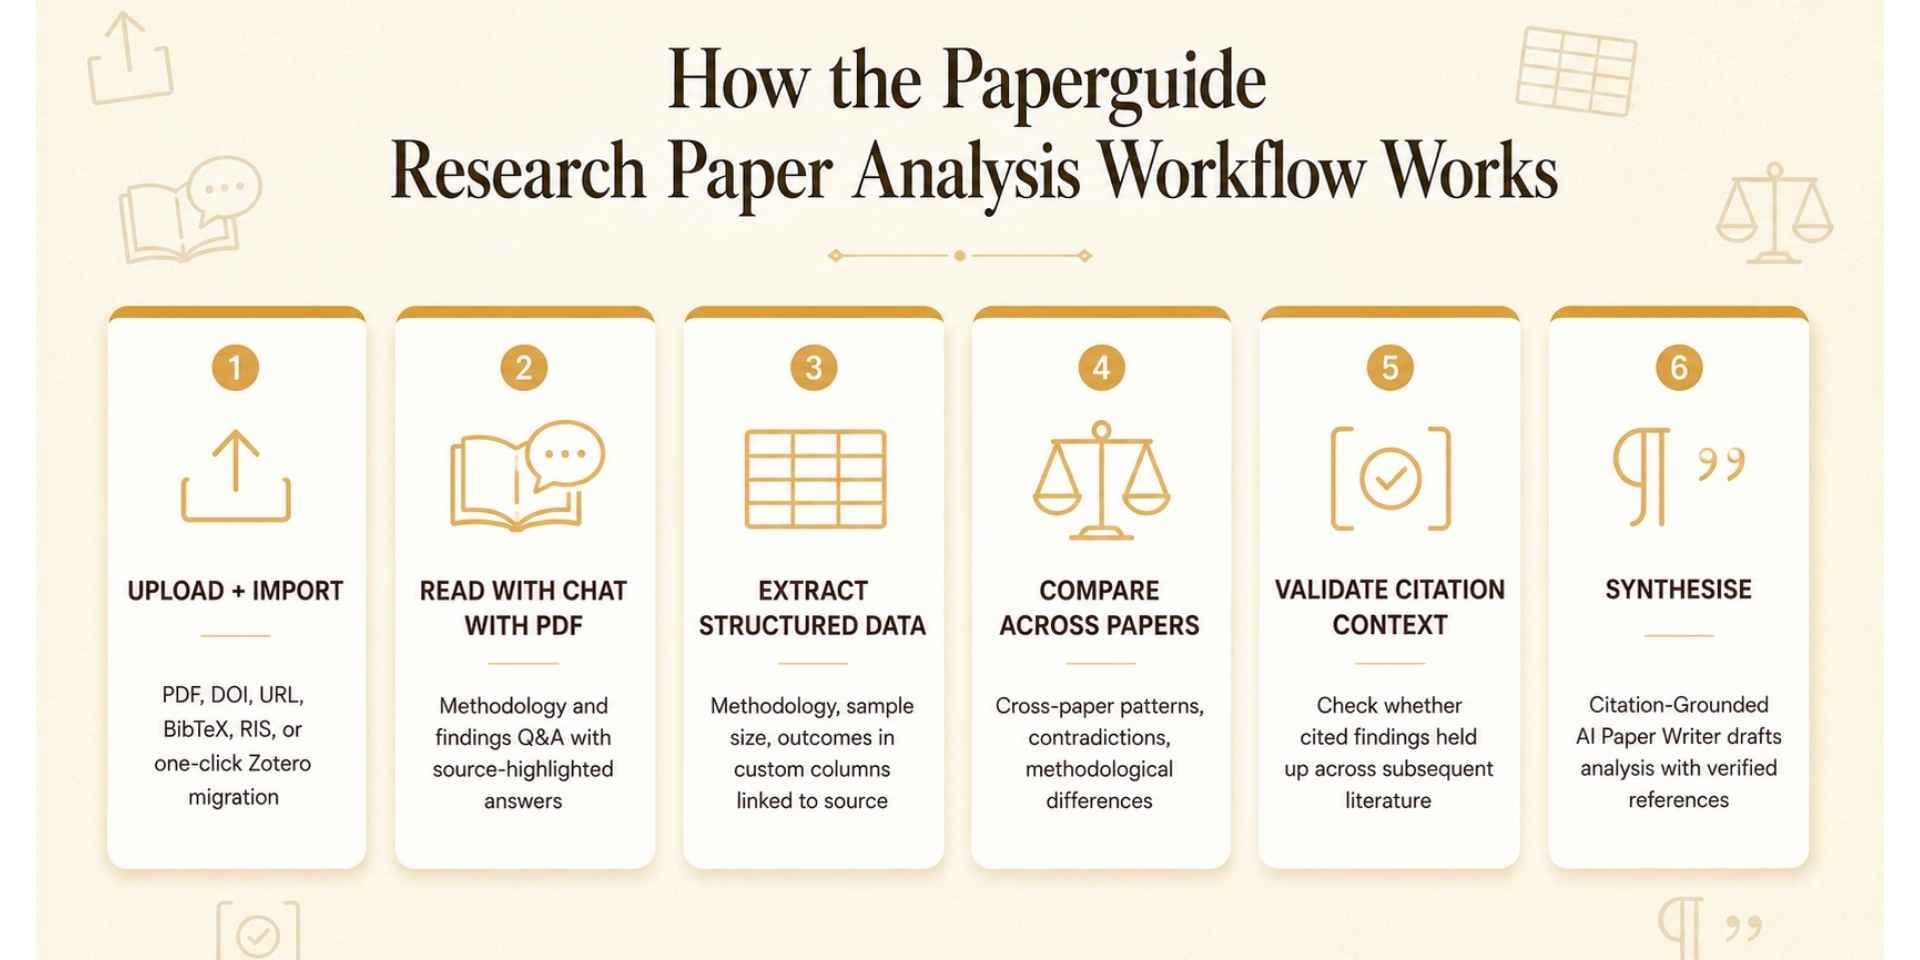
Para comparar ferramentas de forma significativa, é útil tratar a extração como uma cadeia de etapas — ingestão, filtro por pergunta, estruturação, comparação, validação e redação — em vez de como um único comando do tipo “resuma estes PDFs”.
Por Que Resumos Amplos de IA Falham Quando a Unidade de Análise É uma Pergunta de Pesquisa?
Resumos amplos falham porque condensam estudos não comparáveis em uma narrativa, ocultando as células exatas de que uma pergunta de pesquisa precisa. Uma sinopse de um artigo pode soar completa enquanto omite tamanho da amostra, comparador, período de acompanhamento ou se o resultado foi um aumento, uma redução ou nulo. Essas omissões são fatais quando você sai de “sobre o que é este artigo?” para “o que este corpus diz sobre esta pergunta?”.
A síntese de evidências existe para responder a perguntas estruturadas, não para parafrasear resumos. O PRISMA 2020 foi elaborado para relatar por que uma revisão foi realizada, quais métodos foram usados e o que foi encontrado — não para gerar um resumo agradável de ler. Revisões clássicas ainda levam aproximadamente um ano para uma equipe quando os métodos recomendados são aplicados. O volume de literatura que criou esse gargalo é o mesmo que ferramentas de conversa focadas em resumos tentam comprimir em poucos parágrafos.
Os resumos também herdam a retórica do artigo. Autores enfatizam achados significativos; resumos relatam pouco os resultados nulos; citações propagam alegações que trabalhos posteriores enfraquecem. A extração no nível da pergunta inverte esse viés: você define os campos primeiro e, em seguida, faz as mesmas perguntas a cada artigo. Testes de extração por LLMs também mostram o modo de falha oposto. Os modelos podem não captar dados de desfecho mesmo quando lidam de forma confiável com campos contextuais, razão pela qual a extração de desfechos continua mais difícil do que a extração de características de estudos.
A implicação prática é simples. Se seu resultado não puder ser inserido em uma tabela com uma linha por estudo e uma coluna por elemento da pergunta, você ainda não tem evidência. Você tem uma sinopse.
O Que Procurar em um Fluxo de Trabalho de Extração de Evidências com IA?
Você deve procurar seis capacidades que, juntas, formam uma Estrutura de Extração Ancorada em Perguntas: fidelidade à pergunta, campos estruturados, rastreabilidade da fonte, alinhamento entre artigos, validação do contexto de citações e um ciclo documentado de verificação humana. Ferramentas que obtêm bons resultados em escrita fluente, mas ruins nesses seis critérios, ainda produzirão resumos amplos.
Fidelidade à pergunta. O sistema precisa aceitar uma pergunta em formato de protocolo — PICO, PECO ou um esquema personalizado — e evitar desviar para achados adjacentes. “Filtrar pela pergunta” é a etapa estrutural dos fluxos modernos de extração com LLMs, não um refinamento opcional.
Campos estruturados. Tamanho da amostra, delineamento, intervenção ou exposição, comparador, desfecho, direção do efeito e limitações devem ir para colunas personalizadas, cada uma vinculada a um trecho da fonte. Texto livre em uma janela de conversa não é um formulário de extração de dados.
Rastreabilidade da fonte. As respostas precisam de destaques ou localizadores no PDF. Sem isso, você não consegue adjudicar erros do modelo em relação ao registro original nem relatar os métodos de forma transparente.
Alinhamento entre artigos. O mesmo campo deve significar a mesma coisa em todas as linhas. Caso contrário, você não conseguirá identificar contradições, diferenças de dose ou efeitos de delineamento.
Validação do contexto de citação. Um achado que era verdadeiro em 2018 pode não se manter após ensaios posteriores. Uma extração que nunca verifica novamente alegações citadas incorporará evidências desatualizadas em novos manuscritos.
Verificação humana. Até 63% dos estudos extraídos por humanos contêm pelo menos um erro de extração de dados. LLMs introduzem erros diferentes e também podem identificar erros humanos. O fluxo de trabalho deve tratar a discordância como um sinal para abrir o PDF, não como uma competição de pontuação.
Comparações de bibliotecas universitárias em 2026 ainda avaliam ferramentas por função, corpus e modo de falha, e não por alegações de marketing. A análise da Oregon State University observa que o Consensus pode interpretar fontes de modo incorreto, enquanto a matriz do Elicit é mais útil para artigos empíricos e pode não ter nuances nos resumos. Esses são achados de avaliação, não fatores impeditivos — e constituem o nível correto de análise.
Quais Ferramentas de IA Extraem Evidências Estruturadas de Vários Artigos?
Nenhuma ferramenta domina todas as etapas. O Elicit lidera para matrizes empíricas, o Covidence para revisões sistemáticas em equipe, o Consensus para panoramas rápidos de concordância e o Jenova’s Academic Research Assistant para análises iterativas orientadas por perguntas que prosseguem até o gerenciamento de citações e a redação. Fluxos de trabalho no estilo Paperguide ilustram a sequência centrada na extração, mesmo quando você reúne as mesmas etapas em ferramentas diferentes.
| Recurso / Dimensão | Elicit | Jenova Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| Colunas personalizadas no nível da pergunta | Matriz de pesquisa com colunas personalizáveis para métodos, tamanho da amostra e achados | Esquemas definidos por instruções retidos na memória persistente entre sessões | Resumos tabulares e um medidor de consenso; menor controle sobre campos personalizados | Formulários de extração de dados para estudos incluídos após a triagem |
| Escala típica de síntese | Fluxo do protocolo à extração sobre fontes reunidas; resumos Plus citam um pequeno conjunto de artigos | Extração em lotes de PDFs enviados e registros vinculados ao Scholar | Até 20 artigos (Pro) ou 50 (Deep) por síntese | Corpora de triagem em escala de equipe para revisões formais |
| Rastreabilidade da fonte | Links de volta para a literatura incluída | Respostas fundamentadas em documentos, com PDFs anexados | Links para fontes utilizadas no panorama | Trilha completa de auditoria de triagem e extração |
| Fluxo de trabalho com dois revisores | Não é o foco do produto | Não incorporado | Não incorporado | Triagem dupla independente e resolução de conflitos |
| Verificações de contexto de citação | Limitadas além do conjunto extraído | Acompanhamento da literatura entre sessões via Scholar e busca | Medidor de consenso como sinal de concordância | Manual; o protocolo da revisão orienta as atualizações |
| Transferência para manuscrito | Exportação para gerenciadores de referências | Gerenciamento de citações e redação; o Word Doc Generator pode formatar o texto | Exportação para usuários Plus | A redação da revisão permanece uma etapa separada |
| Preços (em 2026) | Assinaturas institucionais Plus; níveis para consumidores não verificados aqui | Plano gratuito; Plus a partir de $20/mês | Freemium; alguns campi licenciam Pro | Planos anuais individuais, em pacote ou organizacionais |
| Mais indicado para | Tabelas de extração empírica | Análise iterativa orientada por perguntas em projetos de longa duração | Panoramas rápidos de consenso em biomedicina/STEM | Revisões sistemáticas em equipe em conformidade com PRISMA |
O Elicit é explicitamente posicionado para refinar um protocolo, reunir fontes, fazer triagem, extrair e sintetizar. Essa é a descrição de trabalho correta para análises no nível da pergunta. Sua limitação, registrada em avaliações de bibliotecas, é que os resumos gerados frequentemente se concentram nos achados e não têm nuances, e a matriz é ajustada às convenções de relato empírico. Artigos qualitativos, teóricos ou mal estruturados terão extração menos limpa.
O Consensus é útil quando a pergunta já se aproxima de uma alegação empírica de sim ou não. Ele sintetiza panoramas narrativos, tabelas e um medidor de consenso, além de poder executar buscas mais profundas que sinalizam lacunas. Também pode interpretar fontes de modo incorreto, e o limite de artigos do nível Deep ainda está muito abaixo de “centenas de textos completos”. Trate-o como um instrumento de prospecção, não como um formulário de codificação.
O Covidence é amplamente descrito como software líder para gerenciamento de revisões sistemáticas. Junto com EPPI-Reviewer, DistillerSR e JBI-SUMARI, ele pertence ao pequeno grupo de plataformas que sustentam toda a pilha de revisão de intervenções — registros, triagem, extração e resolução de conflitos em equipe. É mais robusto do que a pesquisa exploratória exige. A extração conversacional do tipo “conversar com este PDF” não é seu foco, e a maioria dos projetos ainda depende de formulários de extração preenchidos por humanos.
O Jenova’s Academic Research Assistant ocupa outra parte da pilha. Ele busca fontes acadêmicas em tempo real, aceita PDFs enviados, mantém histórico ilimitado de conversas e lembra o protocolo entre sessões, para que as definições de colunas não precisem ser reaprendidas todos os dias. Não é uma ferramenta de triagem dupla, não gera um diagrama de fluxo PRISMA, e centenas de artigos precisam ser processados em lotes em vez de despejados em uma única janela de contexto. Esses são limites reais. Os pontos fortes compensadores são a persistência, o acesso a múltiplos modelos e a capacidade de levar a mesma pergunta de pesquisa da extração à redação fundamentada em citações, sem exportar o conteúdo para fora do projeto.
A sequência publicada de seis etapas do Paperguide — envio, conversa com PDF, colunas estruturadas, comparação entre artigos, validação do contexto de citações e redação fundamentada em citações — é uma descrição clara do padrão que prioriza a extração. Dados independentes de precisão e preço do Paperguide não foram verificados para este artigo; o próprio fluxo de trabalho é o objeto útil de comparação.
Como Funciona a Extração de Dados Estruturados Quando o Corpus Abrange Centenas de Artigos?
Ela funciona convertendo cada artigo em linhas de campos definidos pelo protocolo e, em seguida, filtrando essas linhas pela pergunta de pesquisa antes que qualquer texto de síntese seja escrito. A escala vem da repetição de um esquema, não de um resumo mais longo.
A primeira etapa é a ingestão. PDFs, DOIs, URLs, BibTeX, RIS ou uma exportação de gerenciador de referências estabelecem o corpus. A conversa com PDF é a segunda etapa, não a última: você a usa para localizar trechos de métodos e resultados e, depois, fixa esses trechos em colunas. Uma revisão contínua de extração automatizada encontrou 76 publicações sobre o tema, mas apenas seis ferramentas implementadas para usuários finais, e 84% dos algoritmos extraíam apenas títulos e resumos. A extração baseada apenas em resumos deixará de fora desfechos, análises de subgrupos e detalhes de risco de viés que estão no texto completo. Qualquer fluxo de trabalho que afirme lidar com “centenas de artigos” usando apenas resumos está resumindo, não codificando.
As colunas personalizadas devem corresponder à pergunta, não ao modelo padrão do fornecedor. Para uma pergunta de efetividade, os campos típicos são delineamento, população, intervenção ou exposição, comparador, desfecho primário, direção do efeito, tamanho de efeito com intervalo, acompanhamento e limitações. Para uma pergunta sobre mecanismos, substitua o tamanho de efeito pela via hipotetizada e por uma indicação de se o estudo realmente a testou. Vincular cada célula a um trecho da fonte é o que torna a comparação posterior possível. Sem localizadores, uma tabela é apenas outro resumo com mais espaço em branco.
Centenas de artigos também exigem processamento em lotes. Janelas de contexto, limites de taxa e erros de análise de PDFs tornam pouco confiável a extração única de todo um corpus de revisão sistemática. Um padrão durável é: definir o esquema em um conjunto piloto de 8 a 15 artigos, medir a concordância com a codificação humana, congelar a instrução e então executar os artigos restantes em ondas. O texto da instrução determina a completude e o formato; instruções únicas para cada artigo não se generalizam. Faça o piloto em um subconjunto e, depois, mantenha a instrução constante.
O Jenova’s Academic Research Assistant suporta esse padrão porque o esquema pode permanecer na memória persistente e os PDFs podem ficar anexados ao projeto. Ainda assim, você precisa trabalhar em lotes. A matriz do Elicit se aproxima mais de uma planilha de codificação nativa para campos empíricos. O Covidence pressupõe que o corpus já tenha passado pela triagem. Escolha a ferramenta de acordo com a etapa em que você realmente está.
Como Você Valida Achados Extraídos em Relação ao Contexto das Citações e ao Delineamento do Estudo?
Você valida verificando se a alegação extraída continua válida no trecho citado, na literatura posterior e entre delineamentos que respondem à mesma pergunta. Extração sem essas verificações reproduzirá o viés de citação na velocidade das máquinas.
Validar o contexto de citação significa abrir o trecho citado, e não confiar na frase que faz a citação. Artigos rotineiramente exageram o que uma referência mostrou, citam resumos em vez de resultados ou perpetuam um achado que ensaios posteriores reverteram. Portanto, uma verificação específica de “esse achado citado se sustenta?” é uma etapa separada de “o que este artigo relatou?”. Fluxos de trabalho no estilo Paperguide colocam essa verificação imediatamente antes da síntese, que é a ordem correta: não escreva o parágrafo até que a célula esteja estável.
A validação sensível ao delineamento vai além. Uma figura metodológica de 2025 em Nature Communications apresenta uma arquitetura de referência útil em duas etapas, mesmo que você nunca adote suas fórmulas de pontuação. Modelos de linguagem de grande porte analisam texto livre em população, intervenção ou exposição, relação e desfecho, depois classificam a direção do efeito como aumento, redução ou ausência de mudança. Esses registros são estratificados por delineamento — ensaios randomizados, randomização mendeliana e estudos observacionais — para que um resultado não seja tratado como intercambiável entre métodos.
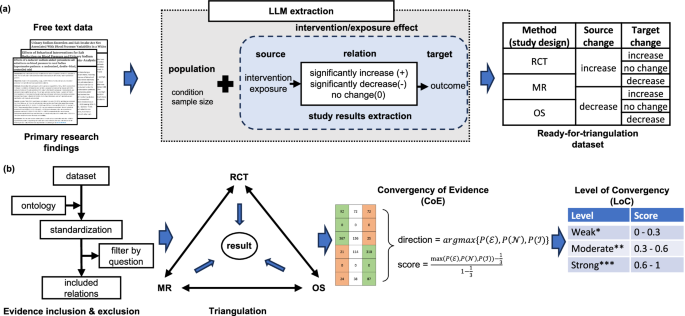
O segundo painel é a parte que a maioria das ferramentas de resumo ignora. Após a padronização e a filtragem de inclusão, os resultados são triangulados entre delineamentos. Uma pontuação de Convergence of Evidence usa a direção com a maior massa de probabilidade; uma faixa de Level of Convergence então classifica o conjunto de evidências como fraco, moderado ou forte. Você não precisa dessa métrica exata para aplicar a ideia. Mas precisa parar de combinar uma associação observacional estatisticamente significativa com um ensaio nulo como se fossem uma única frase do tipo “a literatura diz X”.
A discordância entre humano e modelo deve ser adjudicada em relação ao PDF por uma terceira etapa, não contabilizada como falha automática do modelo. Em uma prova de conceito, o Claude 2 cometeu um erro grave e cinco erros menores — e detectou 21 erros menores no padrão de referência humano. Tratar extrações publicadas como padrão-ouro subestima os modelos e superestima os humanos. A unidade correta de análise é a concordância factual de cada campo, com estatísticas compostas, como estimativa pontual mais intervalo, contadas de forma coerente em vez de como três números não relacionados.
O Jenova pode executar a verificação de contexto de citações porque consegue buscar literatura posterior e manter a tabela de extração original na memória. Ele não pode substituir um segundo revisor humano em uma revisão no estilo Cochrane. O Covidence pode exigir esse segundo revisor. Use ambos os fatos sem reduzi-los a um único vencedor.
Como Executar na Prática um Fluxo de Trabalho de Extração Orientado por Perguntas?
Você define primeiro a pergunta e os campos, testa o esquema em um piloto, extrai em lotes com localizadores de fonte, compara linhas, verifica novamente as citações e só então escreve a partir da tabela. Inverter essa ordem — escrever primeiro e recuperar citações depois — recria o problema do resumo.
Para o Jenova’s Academic Research Assistant, uma sequência típica é:
- Abra o agente e informe o protocolo em um único bloco, incluindo os critérios de inclusão e as colunas exatas desejadas.
- Anexe um conjunto piloto de PDFs, ou DOIs, em vez do corpus completo.
- Extraia os dados em uma tabela, exigindo um localizador para cada célula.
- Congele a instrução depois de corrigir o piloto.
- Processe os artigos restantes em lotes e, antes de qualquer síntese narrativa, execute uma verificação de contradições e outra de contexto de citações.
Uma instrução inicial útil:
“Pergunta de pesquisa: Em adultos com depressão resistente ao tratamento, a cetamina adjuvante reduz os escores de Montgomery–Åsberg em comparação ao placebo em 24 horas? Inclua apenas RCTs. Para cada artigo, extraia: delineamento, n randomizado, dose e via de administração, comparador, desfecho primário, ponto temporal, tamanho de efeito com IC de 95%, direção (aumento / redução / sem alteração) e limitações. Reproduza a frase de resultados para cada tamanho de efeito. Não resuma artigos que não atendam aos critérios de inclusão. Sinalize células vazias em vez de inferir.”
Uma instrução de comparação útil depois que a tabela existir:
“Usando apenas a tabela de extração, liste: (1) conflitos na direção do efeito; (2) diferenças de dose ou ponto temporal que possam explicar os conflitos; e (3) qualquer linha cujo ensaio de suporte citado seja mais antigo do que o resultado nulo mais recente sobre o mesmo desfecho. Não adicione artigos que não estejam na tabela.”
Para o Elicit, o caminho análogo é refinamento do protocolo, coleta de fontes, triagem e, depois, uma matriz com colunas personalizadas — as etapas que o produto documenta para revisões sistemáticas da literatura. Comece com perguntas empíricas cujos campos, como n, métodos e desfechos, já correspondam à matriz. Não espere o mesmo rendimento de artigos teóricos.
Para o Covidence, execute a importação de buscas, remoção de duplicatas, triagem dupla de títulos e resumos, triagem de texto completo e, então, formulários de extração. Guias de bibliotecas tratam essa classe de software como o ambiente para síntese de evidências estruturada, transparente e reproduzível, não como uma ferramenta de conversa automatizada. Se você precisa de um diagrama de fluxo PRISMA e de dois revisores independentes, comece aqui e use uma LLM apenas dentro do formulário de extração, com o segundo revisor ainda sendo humano.
Duas regras operacionais se aplicam às três ferramentas. Primeiro, nunca deixe o modelo preencher uma lacuna com um valor plausível; células vazias são dados. Segundo, meça o tempo de toda a tarefa — iteração de instruções, adjudicação e correção — não apenas a latência do modelo. O tempo gasto na tarefa é o resultado de eficiência relevante, e a elaboração das instruções faz parte desse tempo.
O Que Pesquisadores de Síntese de Evidências Dizem Sobre a Extração de Dados por LLM?
Pesquisadores tratam LLMs como aceleradores promissores para campos contextuais e como substitutos ainda não comprovados para a extração de desfechos, com o próprio desenho de validação permanecendo um problema metodológico em aberto. O consenso em artigos de métodos de 2025–2026 é condicional: úteis em um fluxo de trabalho supervisionado, mas ainda não prontos como extratores sem supervisão.
“O gargalo da síntese de evidências não é a velocidade de leitura. É fazer cada estudo responder à mesma pergunta nos mesmos campos e, depois, perceber quando esses campos divergem. Um resumo pode ser fluente e ainda assim inutilizável para essa tarefa, porque a fluência esconde campos vazios. Quando transferimos equipes de conversas por artigo para tabelas ancoradas em perguntas, a primeira coisa que apareceu não foi insight — foi ausência de dados. Tamanhos de amostra sem denominador, desfechos sem ponto temporal, citações que não sustentavam a frase à qual estavam vinculadas.”
“Também deixamos de tratar a extração humana como padrão-ouro. Uma grande parcela de estudos codificados por humanos contém pelo menos um erro de extração, e os modelos às vezes identificam esses erros enquanto introduzem outros, especialmente em estatísticas compostas. A unidade produtiva de avaliação é a concordância factual por campo, adjudicada em relação ao PDF. Até que um fluxo de trabalho possa demonstrar esse ciclo — esquema, localizador, lote, confronto de contradições e nova verificação de citações — ele é um resumidor, independentemente de quantos artigos afirme ter lido.”
— Equipe de Produto da Jenova, design de fluxos de trabalho de pesquisa, experiência na criação de projetos acadêmicos de agentes de longa duração, desde a descoberta da literatura até a preparação de manuscritos
Essa posição está alinhada a comentários independentes. Uma revisão de escopo sobre LLMs em revisões sistemáticas concluiu que elas estão em ascensão, mas ainda não prontas para uso como infraestrutura independente. Trabalhos separados sobre modelos de linguagem para extração de dados e avaliação de risco de viés estão testando fluxos mistos entre humanos e modelos, e não revisões compostas apenas por modelos. A questão atual na área não é “um modelo consegue ler 400 PDFs?”. É “uma tabela registrada, filtrada pela pergunta e com histórico pode passar por revisão dupla?”.
Quando Você Ainda Deve Usar Software Dedicado de Revisão Sistemática em Vez de um Agente de Pesquisa de IA?
Use software dedicado de revisão sistemática quando precisar de triagem independente dupla, de um fluxo PRISMA passível de relato e de uma trilha de auditoria que um periódico, órgão de ATS ou painel de diretrizes examinará. Use um agente de pesquisa de IA quando ainda estiver moldando a pergunta, codificando um corpus vivo ou transformando uma tabela estável em manuscrito. Os dois são sequenciais com mais frequência do que são rivais.
Covidence, DistillerSR, EPPI-Reviewer e JBI-SUMARI existem porque métodos reproduzíveis, fluxos de trabalho em equipe e registros em conformidade com PRISMA são exigências, não preferências, para revisões de intervenções. O aprendizado de máquina nessas plataformas mais ajudou na triagem — uma avaliação estimou reduções de até 60% na carga de triagem — enquanto as ferramentas de extração e avaliação de risco de viés continuam menos desenvolvidas. Se seu resultado for uma revisão registrada, não ignore essa pilha apenas porque um modelo de conversa consegue parafrasear PDFs.
Um agente é o melhor ambiente diário quando a pergunta ainda está mudando. Você pode anexar novos PDFs, revisar colunas e manter decisões de protocolo na memória sem abrir um novo projeto de revisão a cada ajuste. O Jenova’s Academic Research Assistant foi desenvolvido para esse modo: busca acadêmica em tempo real, textos completos anexados, esquemas de extração persistentes e um caminho para redação com citações gerenciadas. Ele não atenderá a um protocolo que exija dois revisores. Declarar essa limitação faz parte de usá-lo corretamente.
Uma divisão prática usada por muitos grupos em 2026 é esta: faça a prospecção e defina campos com um agente ou com o Elicit. Registre o protocolo. Faça a triagem e a extração no Covidence ou equivalente, opcionalmente com codificação assistida por LLM que um humano ainda verifica. Retorne ao agente para testar sob pressão o contexto das citações e redigir a partir da tabela consolidada. A lista de ferramentas de síntese de evidências da Duke lembra que nenhuma aplicação abrange todas as etapas; a habilidade profissional é saber em qual etapa você está.
O teste que deve decidir a pilha é o mesmo que abriu este artigo. Se você consegue apontar uma pergunta de pesquisa, uma coluna para cada elemento dessa pergunta, um localizador para cada célula e um registro do que foi excluído, você está extraindo evidências. Se você tem apenas uma visão geral bem escrita de “o que os artigos dizem”, ainda está resumindo — mesmo que essa visão geral tenha sido gerada a partir de centenas de arquivos.
Referências
- Declaração PRISMA — Orientações de relato para revisões sistemáticas
- The BMJ — A declaração PRISMA 2020: diretriz atualizada para relato de revisões sistemáticas
- ScienceDirect — LLMs em revisões sistemáticas: em ascensão, mas ainda não prontos para uso (revisão de escopo)
- PMC — Ferramentas digitais para apoiar o processo de revisão sistemática
- BMJ Evidence-Based Medicine — Desafios e armadilhas na avaliação de LLMs para extração de dados
- Oregon State University Libraries — Comparação de ferramentas de IA para pesquisa de literatura
- Elicit — Fluxo de trabalho para revisão sistemática da literatura
- Covidence — Software de gerenciamento de revisões sistemáticas
- UCL Library Guides — Software para revisão sistemática
- Nature npj Digital Medicine — Modelos de linguagem para extração de dados e avaliação de risco de viés
- Duke University Libraries — Software e ferramentas para síntese de evidências