A AI multimodelo reduz melhor os pontos cegos da análise de ações?
2026-08-24
Como a divergência entre modelos e as verificações de conjunto revelam riscos ocultos na tese?
A checagem cruzada entre múltiplos modelos reduz pontos cegos e excesso de confiança de forma mais confiável do que a análise de ações com um único modelo, porque a divergência entre modelos é, por si só, um sinal de risco — e não um incômodo a ser diluído por uma média. Em 2026, uma única resposta fluente do ChatGPT, Claude ou Gemini pode parecer uma pesquisa concluída. Essa fluência é o problema. Um modelo, uma janela de contexto e uma distribuição de treinamento produzem uma narrativa coerente mesmo quando os números estão desatualizados, o relatório é interpretado incorretamente ou o cenário pessimista está ausente.
O que realmente separa uma pesquisa cuidadosa de renda variável com AI de um palpite confiante:
✅ Ancoragem em fontes — relatórios, estimativas e preços atuais, em vez de um corte de treinamento ✅ Diversidade de modelos — mais de um provedor, para que um viés de corpus compartilhado seja mais fácil de identificar ✅ Diversidade de papéis — visões fundamentalista, técnica, macro e de portfólio, em vez de um único generalista ✅ Exibição de incerteza — faixas, conflitos e sinalizações de “não é possível verificar”, em vez de falsa precisão ✅ Custo de uma segunda análise — baixo o suficiente para que as checagens cruzadas realmente aconteçam antes de aumentar a posição
Uma regra de trabalho útil é o teste de Divergência como Sinal: trate o consenso entre modelos como uma hipótese e o conflito entre modelos como a agenda de pesquisa. O restante deste artigo aplica esse teste a chatbots de modelo único, sistemas de pontuação desenvolvidos para esse fim, como o Danelfin, ferramentas de pesquisa que priorizam citações, como o Perplexity, e agentes especialistas em renda variável da Jenova.
Por que o excesso de confiança persiste quando investidores usam um único modelo de AI?
O excesso de confiança persiste porque um único modelo entrega uma narrativa polida, e narrativas polidas suprimem o atrito que normalmente exige uma segunda análise. As finanças comportamentais tratam o excesso de confiança como um viés sistemático, e não como uma falha de personalidade. Nos mercados, ele aparece como negociação excessiva, apostas concentradas e evidências contrárias ignoradas.
Esse padrão não desaparece quando o analista é uma AI. Pesquisas sobre excesso de confiança e viés de confirmação nas negociações relacionam o viés a maior giro, diversificação menor e retornos mais fracos. Uma revisão de 2025 sobre o comportamento do investidor na era da AI conclui que intervenções discricionárias podem desfazer os ganhos de eficiência dos algoritmos, aumentando a volatilidade em vez de reduzi-la. Trabalhos mais recentes descrevem o “excesso de confiança algorítmico”: depois que a análise é delegada a um modelo, os usuários tratam o resultado como mais objetivo do que realmente é.
Uma sessão com modelo único piora isso de três formas mecânicas. Primeiro, o modelo é recompensado pela coerência, portanto preenche lacunas em vez de destacá-las. Segundo, o usuário não vê divergências de pares, que é o sinal usado por instituições para ampliar intervalos de confiança. Terceiro, a interface é conversacional, de modo que até um dado errado chega em prosa confiante. O alerta da SEC dos EUA para investidores sobre AI é direto nesse ponto: a AI pode gerar e disseminar informações falsas ou imprecisas, e investidores devem verificar alegações com profissionais registrados.
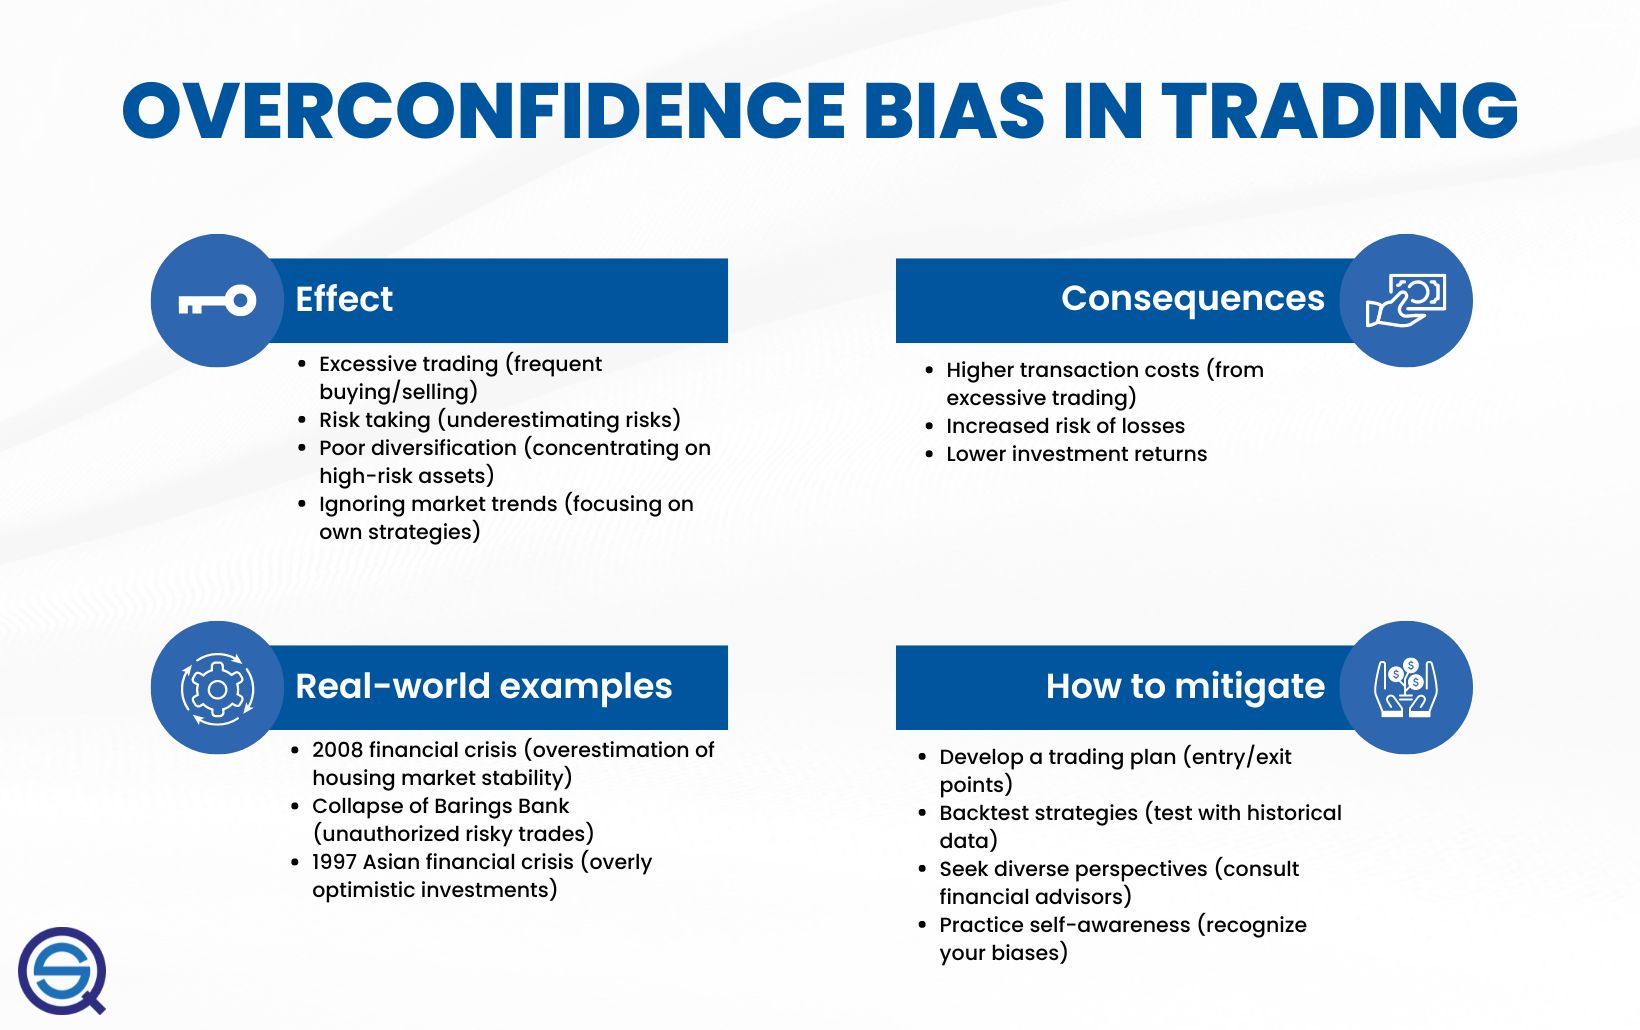
A mitigação clássica — um plano escrito, testes históricos e perspectivas diversas — se traduz diretamente em arquitetura de pesquisa. Um único modelo pode ajudar a redigir o plano. Ele não pode, sozinho, ser a perspectiva diversa.
O que avaliar ao comparar análises de ações com um único modelo e com múltiplos modelos?
Você deve avaliar seis camadas de cobertura, e não qual interface parece mais inteligente. Chame isso de Auditoria de Pontos Cegos em Seis Camadas. É uma lista de verificação prática para qualquer ticker, ferramenta e horizonte de tempo.
1. Ancoragem em fontes. O sistema busca relatórios atuais da SEC, estimativas e preços, ou está apenas completando texto a partir de uma data de corte? A Openbook Analytics observa que chatbots generalistas não têm dados de mercado em tempo real e não conseguem verificar os números que geram, e que o CEO da Perplexity reconheceu a existência de dados de mercado desatualizados na plataforma.
2. Diversidade de modelos. Um fornecedor significa um modo de falha. Comparar resultados de modelos da classe GPT com Claude, Gemini ou DeepSeek só é útil se o prompt, os dados e o papel realmente mudarem. Trocar marcas usando o mesmo prompt desatualizado não é diversidade.
3. Diversidade de papéis. Uma leitura fundamentalista, uma leitura de fluxo e estrutura de preço e uma sobreposição macroeconômica capturam erros diferentes. Isso se aproxima mais de uma reunião de pesquisa do que de uma conversa com chatbot.
4. Representação de incerteza. Prefira faixas, cenários concorrentes e sinalizações explícitas de “não verificado” a um único preço-alvo.
5. Persistência. O trabalho sobre uma tese se estende por semanas. Ferramentas que esquecem a visão alternativa da terça-feira passada voltarão a inflar a confiança na sessão seguinte.
6. Custo por verificação. Se uma segunda rodada em outro modelo for cara ou incômoda, ela será ignorada justamente quando a posição for maior.
A análise da FINRA sobre AI no setor de valores mobiliários apresenta os mesmos temas em linguagem regulatória: gestão de risco de modelo, explicabilidade, integridade de dados e controles de supervisão. Espera-se que as empresas entendam como um modelo produz um resultado antes de se apoiarem nele em fluxos de trabalho de aconselhamento de investimentos sob a Regulation Best Interest e a FINRA Rule 2111. Investidores individuais não dispõem de um programa da Rule 3110. Ainda assim, precisam de um hábito equivalente: saber o que o modelo não consegue enxergar.
Um artigo de 2025 da Harvard Business School sobre viés estrangeiro em LLMs financeiros acrescenta um modo de falha mais discreto. A informação pode estar ausente dos dados de treinamento ou estar presente, mas receber peso insuficiente. Dois modelos centrados nos EUA podem “concordar” sobre uma empresa de mercado emergente e ainda compartilhar a mesma lacuna.
Como ChatGPT, Danelfin, Perplexity e Jenova diferem na cobertura de pontos cegos?
Eles diferem, antes de tudo, quanto a produzirem uma pontuação, um resumo citado ou um arquivo de pesquisa passível de contestação. O ChatGPT é mais forte como parceiro de raciocínio e mais fraco como mecanismo de números. O Danelfin é mais forte como rastreador transparente e mais fraco como debate entre múltiplos papéis. O Perplexity é mais forte para buscar trechos citados e mais fraco quando esses trechos estão desatualizados. O Fundamental Stock Analyst da Jenova é mais forte quando uma tese precisa reunir resultados, valuation e sentimento — e depois ser contestada por outros modelos ou agentes especialistas.
A Openbook Analytics, resumindo testes anteriores, relata que o ChatGPT respondeu incorretamente a cerca de 35% das consultas financeiras e de investimento e que o Gemini alucinou informações financeiras em taxas de até 88–91% em algumas avaliações. Esses números não são um motivo para abandonar modelos de linguagem. São um motivo para não deixar que apenas um deles encerre uma tese.
| Recurso / Dimensão | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| Resultado principal | Explicação em prosa | AI Score explicável e recursos | Respostas web com citações | Memorando fundamentalista ancorado em relatórios |
| Dados de mercado em tempo real / verificados | Fraco; limitado pela data de corte | Desenvolvido para universos pontuados | Citados, mas podem estar desatualizados | Relatórios da SEC, estimativas, sentimento |
| Checagem cruzada entre modelos | Manual, com múltiplas contas | Sistema proprietário único | Busca multimodelo, um único resumo | Múltiplos provedores nativos, além de agentes especialistas |
| Tratamento de incerteza | Prosa confiante por padrão | Pontuação com atribuição de recursos | Citações, menor detalhamento do risco residual | Cenários concorrentes, divergência entre modelos, memória |
| Preços (em 2026) | Cerca de $20/mês no plano pago | Não verificado nesta análise | $20/mês no Pro; plano gratuito | Plano gratuito; pagos a partir de $20/mês |
| Melhor para | Revisão de conceitos, elaboração de cenário pessimista | Filtragem e timing de uma lista conhecida | Fatos rápidos com fontes | Pesquisa de ações com checagem cruzada |
ChatGPT
O ChatGPT continua útil para traduzir uma seção de um 10-K, listar a estrutura de uma indústria ou forçar a formulação de um cenário pessimista em linguagem simples. Uma comparação de quatro modelos em 2026 o posiciona no grupo dos generalistas, e não como um terminal de dados em tempo real. Sua limitação é estrutural: ele ainda redigirá uma ponte de margens convincente a partir da memória. É exatamente assim que o excesso de confiança entra em uma nota de pesquisa.
Danelfin
O Danelfin é um produto diferente. Ele publica um AI Score em vez de uma conversa. A empresa afirma que ações dos EUA com pontuação 10/10 superaram o mercado em 21,05% de alfa anualizado após três meses desde 2017, enquanto empresas com nota 1/10 tiveram desempenho inferior de 33,28%, e que uma estratégia baseada no AI Score retornou 376% de 3 de janeiro de 2017 a 9 de junho de 2025, contra 166% do S&P 500. Recursos explicáveis são um antídoto real contra pontuações de caixa-preta. A limitação é complementar: uma pontuação pode classificar um universo sem testar sob pressão o risco específico de contabilidade, segmento ou política que quebraria esta posição.
Perplexity
O Perplexity conquista seu lugar como camada de citações. A comparação de 2026 da Helm Terminal afirma que ele lidera em fatos atuais citados e recursos financeiros, enquanto o Claude lidera na síntese profunda de relatórios. A limitação é aquela que seu CEO já destacou: uma citação é tão atual quanto a página para a qual aponta. Conferir o Perplexity contra um fluxo de trabalho nativo de relatórios é mais valioso do que tratar a quantidade de citações como prova.
Jenova Fundamental Stock Analyst
O Fundamental Stock Analyst da Jenova foi desenvolvido como especialista em renda variável: resultados, valuation relativo, análise de modelo de negócios e dados em tempo real de relatórios, estimativas e sentimento. Na plataforma Jenova, ele pode ser executado novamente usando modelos da OpenAI, Anthropic, Google, DeepSeek e xAI, e pode atuar ao lado de outros especialistas em vez de fingir ser todos eles. A memória persistente mantém a última divergência em pauta.
Limites honestos são importantes aqui. A Jenova não publica uma pontuação composta de longo prazo comparável ao histórico do Danelfin entre 2017 e 2025. Execuções multimodelo consomem mais uso do que uma única passagem. Respostas conflitantes aumentam a carga cognitiva, e o usuário ainda precisa abrir o 10-K. Esses são custos reais. Também são os custos de não confundir fluência com diligência.
Como a orquestração multiagente transforma a pesquisa fundamentalista de renda variável?
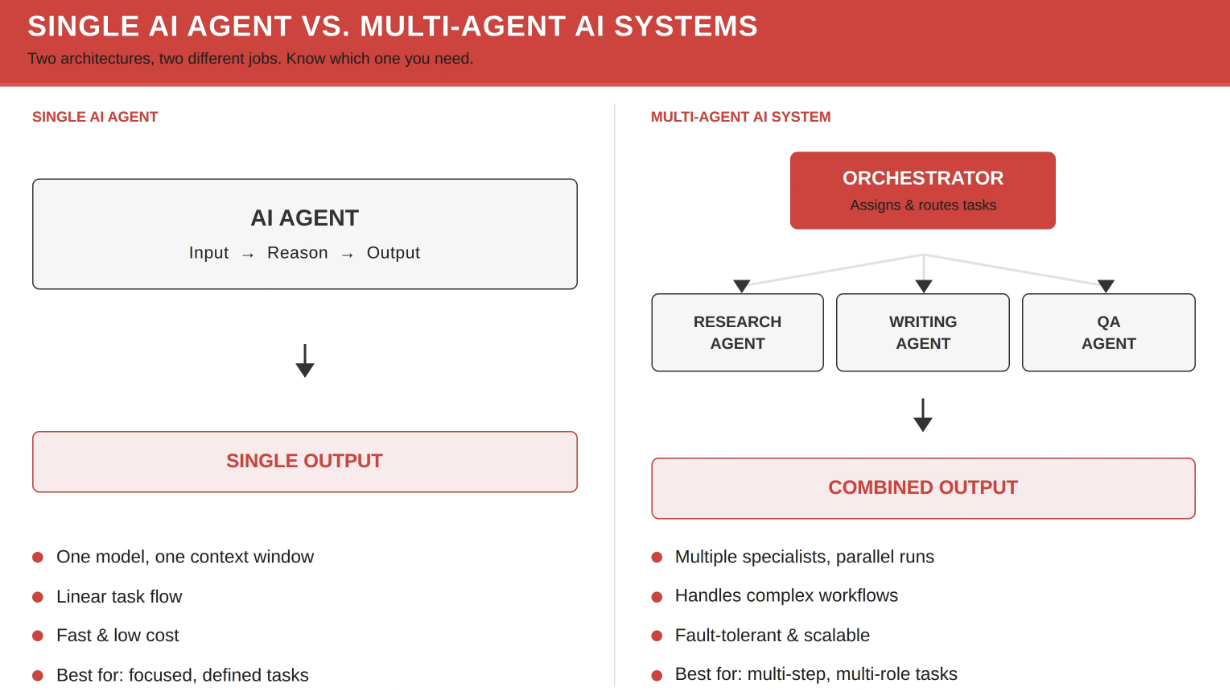
A orquestração transforma o trabalho de “perguntar a um analista” em “montar uma pequena mesa e reconciliar o arquivo”. Um único agente segue um caminho linear: entrada, raciocínio, resultado. Isso é rápido, barato e apropriado quando a pergunta é restrita. Um arranjo multiagente adiciona um orquestrador que distribui o trabalho entre especialistas — pesquisa, redação, revisão de qualidade — e devolve um produto combinado. A arquitetura é mais lenta e mais cara. Também é a forma de impedir que um erro eloquente se transforme no memorando inteiro.
No trabalho com ações, a divisão análoga não é, de forma abstrata, “pesquisa / redação / QA”. Ela é:
- Fundamentalista: qualidade dos resultados, economia unitária, valuation, alocação de capital
- Técnica: estrutura, volume, momentum, níveis de invalidação
- Macro: política, juros, regime entre classes de ativos
- Portfólio: tamanho, correlação, drawdown, se a ideia pertence a esta carteira
O Fundamental Stock Analyst da Jenova cobre a primeira cadeira. Combiná-lo com o Technical Stock Analyst e o Macro Strategist é a versão prática de QA multiagente. Um modelo que gosta da narrativa, outro que diz que a dinâmica do preço está rompida e outro que afirma que a trajetória dos juros destrói o múltiplo não representam uma consulta fracassada. Representam uma reunião de risco completa.
Evidências sobre conjuntos de modelos fora dos chatbots de renda variável apontam na mesma direção. Um estudo de 2025 no arXiv sobre conjuntos de LLM em dados da Survey of Professional Forecasters concluiu que uma combinação de LLM superou a média simples em diversos indicadores de curto prazo e continuou mais útil quando a divergência entre especialistas era alta. O mecanismo não foi mágico. O conjunto reduziu o peso de especialistas recentemente imprecisos, ajustou revisões defasadas e se recusou a tratar todas as vozes como equivalentes. Isso é o oposto de pedir um preço-alvo a um chatbot e parar por aí.
A linguagem da FINRA sobre modelos de caixa-preta e explicabilidade é relevante até mesmo para fluxos de trabalho de investidores de varejo. Se você não consegue explicar por que o cenário otimista sobreviveu ao contato com um segundo modelo e um segundo papel, não tem um processo de investimento. Tem uma transcrição.
Agentes técnicos, macro e de portfólio conseguem captar o que um único modelo não vê?
Sim. Eles identificam erros de categoria — falhas que um modelo exclusivamente fundamentalista tem pouca probabilidade estrutural de perceber. Um modelo de linguagem que acabou de redigir uma narrativa convincente de crescimento composto raramente se oferecerá para dizer que a ação está esticada, que o setor é uma aposta puramente em duration ou que a posição duplica um fator que você já possui.
Erros típicos por especialidade:
- Especialidade técnica. O modelo fundamentalista pode estar certo sobre o valor e antecipado em um ano. Estrutura de preço, rompimentos fracassados e divergência de volume não são notas de rodapé. São timing e invalidação. O Technical Stock Analyst foi desenvolvido em torno dessas questões: estrutura de mercado, momentum e risco definido.
- Especialidade macro. Um DCF de uma ação que ignora o regime de política é uma planilha com uma premissa de juros escondida. O Macro Strategist é desenvolvido para síntese entre classes de ativos e análise de políticas, onde muitas histórias supostamente “idiossincráticas” de fato falham.
- Especialidade de portfólio. Uma ótima ideia isolada pode ser uma péssima adição à carteira. Desvio de alocação, estresse e correlação vivem na camada de portfólio, que é o trabalho do Portfolio Management Strategist da Jenova.
Também é aqui que plataformas de pontuação única e modelos de conversa única compartilham um ponto cego. A pontuação do Danelfin pode ser transparente quanto aos recursos por trás de uma classificação e ainda não dizer nada sobre o fato de sua carteira já estar comprada no mesmo fator. O ChatGPT pode listar riscos de forma abstrata e ainda não saber que você já possui três empresas de software com a mesma sensibilidade a juros. A revisão entre múltiplos papéis é como esses erros vêm à superfície.
A limitação é a correlação de visão de mundo. Se cada agente recebe um prompt otimista, ou se todo modelo é alimentado com o mesmo post secundário de blog, você tem encenação. A diversidade de papéis só funciona quando o agente técnico tem permissão para eliminar a operação, o agente macro tem permissão para reprecificar o múltiplo e o agente de portfólio tem permissão para reduzir a posição a algo simbólico.
Como realizar uma checagem cruzada multimodelo de uma tese sobre uma ação?
Faça isso como um arquivo em quatro etapas, e não como uma conversa mais longa. O objetivo é criar divergência de propósito e, então, decidir quais evidências resolveriam a questão.
Etapa 1 — Ancore os fatos. Peça ao Fundamental Stock Analyst apenas um panorama com fontes: os dois últimos períodos reportados, guidance, composição por segmento, dívida líquida, recompras e os múltiplos de valuation que realmente correspondem ao negócio. Proíba preços-alvo nesta etapa.
“Usando o 10-K, o 10-Q e as duas últimas teleconferências de resultados de [TICKER], extraia receita por segmento, margem bruta e operacional, FCF, dívida líquida e número de ações diluído. Cite o relatório ou a teleconferência para cada número. Se não conseguir obter a fonte de um número, escreva Unverified.”
Etapa 2 — Mude o modelo, não a pergunta. Execute novamente a mesma extração em um segundo provedor. Diferenças relevantes em um dado reportado não são “estilo”. São um evento de integridade de dados. Verifique você mesmo o relatório antes da Etapa 3.
Etapa 3 — Acione as outras especialidades. Envie o mesmo ticker ao Technical Stock Analyst para níveis de invalidação e ao Macro Strategist para a premissa de juros, FX ou commodities embutida no múltiplo.
“Ignore o memorando fundamentalista otimista. Identifique o nível de preço e o regime macro que tornariam esta configuração inadequada para manter, mesmo que a tese se revele correta no fim.”
Etapa 4 — Exija uma discordância por escrito. Peça a qualquer modelo que argumente o lado oposto com extensão e fontes equivalentes. A nota de finanças comportamentais da Lucid.now destaca o padrão humano habitual: superestimar a capacidade de previsão, negociar com frequência excessiva e concentrar-se em uma história favorita. Uma discordância obrigatória é como interromper esse padrão quando o “analista” também é um modelo.
Usando apenas ChatGPT ou Claude, é possível aproximar as Etapas 2 e 4 abrindo um segundo produto e colando o mesmo extrato com fontes. Não é possível aproximar a coleta de relatórios atuais ou a memória persistente ao longo de semanas se a ferramenta de fato não oferecer esses recursos. No Danelfin, a Etapa 1 é parcialmente automatizada pela pontuação e pela lista de recursos; as Etapas 3 e 4 ainda exigem uma superfície de pesquisa separada.
Os preços da Jenova são baseados em uso entre os níveis: um plano gratuito com uso limitado e, depois, $20, $50, $100, $200, $500 e $1.000 por mês conforme as franquias aumentam. Uma verificação em quatro etapas custa mais que uma única conversa. Para qualquer posição grande o bastante para importar, esse é o erro mais barato.
O que profissionais do mercado dizem sobre o excesso de confiança em pesquisas com AI?
Profissionais que trabalham diariamente com essas ferramentas tendem a tratar a certeza de um único modelo como uma falha de processo, e não como um atributo de modelos “melhores”.
“O erro mais caro que vemos não é um número errado. É um número que parece correto e nunca passou por um segundo modelo. Quando três provedores concordam com uma ponte de margens que nenhum deles consegue reconciliar com o 10-Q, a concordância é o sinal de alerta. Preferimos entregar um memorando com duas faixas conflitantes e uma lista de itens Unverified a um único preço-alvo sem pendências.”
“Multimodelo não é automaticamente mais seguro. Se você fizer a mesma pergunta mal formulada ao GPT, Claude e Gemini, muitas vezes receberá a mesma resposta ruim com adjetivos diferentes. A diversidade precisa ser planejada: papéis diferentes, coletas de dados diferentes e uma instrução permanente para discordar. Caso contrário, você comprou excesso de confiança correlacionado a três vezes o custo de tokens.”
“Na mesa, a divergência é como decidimos o que ler em seguida. Se fundamentalista e macro entram em conflito, examinamos a premissa de juros. Se fundamentalista e técnico entram em conflito, examinamos timing e tamanho. Se todas as especialidades concordam rápido demais, presumimos que o arquivo é superficial. Esse hábito é mais antigo do que os LLMs. Os modelos apenas tornam mais fácil ignorá-lo.”
— Equipe de Produto da Jenova, design e avaliação de agentes de renda variável, trabalho de vários anos em fluxos de pesquisa multimodelo
Essa postura está alinhada à ênfase da FINRA em testes, planos de contingência e supervisão multifuncional antes que ferramentas de AI influenciem recomendações de investimento. Também está alinhada ao resultado de previsão por conjunto: as combinações ajudam mais quando as entradas divergem e alguém tem uma regra para ponderá-las.
Quando a análise com um único modelo ainda é a melhor escolha?
A análise com um único modelo continua sendo a melhor escolha quando a tarefa é delimitada, o custo do erro é baixo e a velocidade importa mais do que o risco residual. A checagem cruzada multimodelo é um sistema de controle. Você não precisa de um sistema de controle para definir ROIC ou resumir uma empresa em dois parágrafos.
Um único modelo normalmente basta quando:
- Você está aprendendo um conceito, não definindo o tamanho de uma posição
- Já está com o relatório aberto e precisa apenas de um auxílio de leitura
- Está filtrando linguagem, não calculando um valuation
- Precisa de um esboço inicial antes de um fluxo de trabalho mais lento e com fontes
- Chamadas adicionais a modelos não mudariam a decisão
O guia de 2026 da Openbook faz a mesma divisão de categorias: chatbots generalistas são pontos de partida, não mecanismos principais de pesquisa. A pontuação do Danelfin é um sistema único, mas especializado; usá-la como filtro e parar ali ainda é uma decisão de modelo único se ninguém contestar a empresa. O Perplexity é a escolha certa para uma única passagem quando você precisa de uma trilha de citações em minutos e verificará a fonte primária por conta própria.
O modo de falha é usar a passagem barata para a decisão cara. O excesso de confiança não é causado pela AI. Ele é causado por encerrar o processo na primeira resposta coerente. O resumo de 2025 da Sidley sobre a orientação de reguladores financeiros dos EUA ressalta que as empresas já precisam tratar a AI como uma atividade supervisionada, e não como um oráculo. Investidores privados deveriam copiar o espírito dessa regra, mesmo quando nenhum fiscal fará perguntas.
Uma regra de decisão compacta: se errar mudaria o tamanho da posição, use pelo menos dois modelos e dois papéis. Se errar mudaria apenas uma frase em suas anotações, um bom modelo basta.
Como a regulação e o risco de modelo devem moldar seu fluxo de pesquisa com AI?
Eles devem forçar você a documentar o que o modelo não viu, e não apenas o que ele disse. A discussão da FINRA sobre AI é voltada para corretoras, mas seus temas de controle são transferíveis. Gestão de risco de modelo, governança de dados, explicabilidade e supervisão existem porque ferramentas que parecem autônomas falham de formas correlacionadas.
Para um processo individual de pesquisa, os controles transferíveis são simples:
- Mantenha a fonte primária no arquivo. Se o modelo não consegue apontar para o 10-K, 10-Q, 8-K ou a transcrição da teleconferência, a alegação é um rascunho.
- Registre a divergência. Um registro de uma linha — “Claude vê compressão, Gemini não, 10-Q página 37 não resolvido” — é mais útil do que um cenário otimista regenerado.
- Separe recomendação de explicação. Chatbots não são um mecanismo de adequação. A FINRA observa que ferramentas de AI que geram recomendações estão sujeitas à Regulation BI e à Rule 2111 para empresas associadas. Usuários de varejo devem tratar o resultado do modelo como análise, e não como recomendação personalizada.
- Presuma viés compartilhado até prova em contrário. O resultado da HBS sobre viés estrangeiro é um exemplo. Dois modelos podem deixar de fora o mesmo fato não americano. Um relatório local, uma fonte em um segundo idioma ou um especialista humano é a diversificação real.
- Prefira ferramentas que possam dizer Unverified. A falsa precisão é o sinal revelador. Um sistema que sempre completa o parágrafo não é “mais analítico”. É menos supervisionado.
Nada disso exige um orçamento institucional. Terminais da classe Bloomberg continuam em outra realidade de custo — a Openbook cita preços típicos da Bloomberg acima de $25.000 por ano. O controle que de fato reduz o excesso de confiança é mais barato: um segundo modelo, uma segunda especialidade e uma regra de que consenso sem fontes não aumenta o tamanho da posição.
A análise de ações com um único modelo é uma ferramenta de rascunho. A checagem cruzada multimodelo e com múltiplos papéis é uma ferramenta para pontos cegos. Use a primeira para iniciar o arquivo. Use a segunda para decidir se o arquivo está concluído.
Referências
- Openbook Analytics — Melhores ferramentas de AI para análise de ações em 2026
- Investopedia — Finanças comportamentais: vieses, emoções e comportamento do investidor
- Preprints.org — Excesso de confiança e viés de confirmação nas negociações
- ResearchGate — Excesso de confiança do investidor na era da AI: tomada de decisão humana versus algorítmica
- SSRN — Comportamento do investidor nos mercados de ações: o surgimento da AI e do excesso de confiança algorítmico
- Investor.gov — Inteligência artificial (AI) e fraude em investimentos: alerta ao investidor
- FINRA — Inteligência artificial no setor de valores mobiliários: principais desafios e considerações regulatórias
- Harvard Business School — Quando LLMs vão ao exterior: viés estrangeiro na análise financeira com AI
- Danelfin — Selecionador de ações com AI e metodologia AI Score
- AI Business Weekly — Guia de preços de AI 2026: ChatGPT, Claude e Gemini
- Perplexity — Preços para indivíduos e empresas
- Helm Terminal — ChatGPT vs Claude vs Gemini vs Perplexity para pesquisa de ações
- arXiv — LLM pode melhorar a combinação de previsões de especialistas?
- Lucid.now — AI em decisões financeiras: insights comportamentais
- Sidley Austin — Inteligência artificial: diretrizes de reguladores de valores mobiliários e commodities dos EUA