Gerador de Voz de Personagem: Vozes com AI para Jogos, Histórias e Cinema
2026-09-06
Jenova ajuda você a criar personagens marcantes, escrever diálogos fáceis de falar e preparar prompts prontos para produção para qualquer gerador de voz de personagem. Em setembro de 2026, sistemas de fala por AI conseguem copiar um timbre em segundos, mas a maior parte do resultado ainda soa genérica porque a escrita por trás dele não tem personalidade. A dublagem em estúdio continua lenta e cara para equipes independentes, enquanto uma camada superficial de texto para fala reduz todos os papéis à mesma cadência.
- ✅ Personalidades consistentes para os personagens em histórias longas e ciclos de jogo
- ✅ Diálogos escritos para serem falados, não apenas lidos em uma página
- ✅ Prompts estruturados para modelos de voz modernos e localização
- ✅ Suporte para roteiros, quadrinhos, música e roleplay em um único fluxo criativo
Para entender por que isso importa, observe o que os criadores realmente precisam de um gerador de voz de personagem: não mais um controle deslizante chamado “feliz”, mas uma voz que pertença a alguém. O gargalo raramente é o renderizador. É a construção do personagem, a interpretação das falas e a linha ética entre uma performance original e uma imitação não autorizada.
Resposta Rápida: O Que É um Gerador de Voz de Personagem?
Um gerador de voz de personagem é um sistema de AI que produz falas distintas e específicas para cada personalidade, para que cada papel soe como uma pessoa diferente. Criadores o usam em jogos, histórias, vídeos e recursos de acessibilidade — mas a voz só funciona quando o personagem já está bem definido.
Principais capacidades:
- Timbre, ritmo e alcance emocional distintos para cada personagem
- Roteiros e prompts que funcionam em texto para fala sem soarem como um GPS
- Roleplay com consistência rígida de personagem antes mesmo de você gerar qualquer coisa
- Fluxos de trabalho com personagens originais que evitam clonar pessoas reais sem consentimento
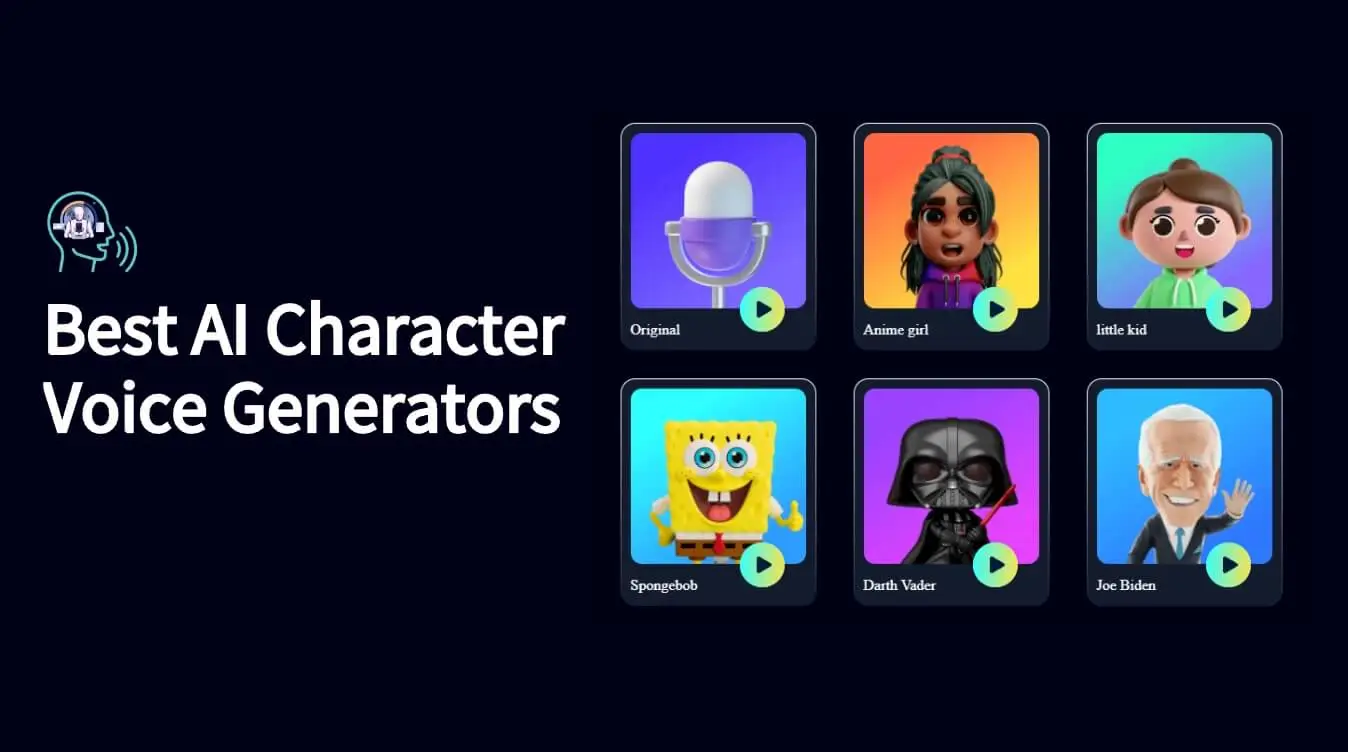
Por Que a Maioria dos Geradores de Voz de Personagem Ainda Soa Genérica
A demanda por fala sintética não é mais experimental. Empresas de pesquisa agora acompanham a geração de voz por AI como um mercado próprio, não como um recurso secundário de chatbots.
USD 6,4 bilhões — Tamanho do mercado global de geradores de voz por AI em 2025, com crescimento projetado a partir de USD 8,36 bilhões em 2026
USD 19,09 bilhões — Mercado de reconhecimento de fala e voz em 2025, projetado em USD 23,70 bilhões em 2026
Esse investimento está chegando a jogos, localização, vídeos para redes sociais e áudio para clientes. O uso de voz com AI cresceu 9 vezes em 2025, e 84 por cento das organizações pesquisadas planejavam aumentar os orçamentos de tecnologia de voz. Porém, comprar um renderizador não compra uma performance. Conseguir uma voz de que o público se lembre ainda é frustrantemente difícil:
- Todo personagem herda o mesmo ritmo, padrão de respiração e tom de “assistente prestativo”
- Sessões de estúdio são lentas e caras demais para a cauda longa de NPCs, elencos do YouTube e dublagens semanais de webtoons
- Falas escritas para a página desmoronam quando são ditas — as orações se acumulam, as piadas perdem o efeito e os nomes são pronunciados de forma errada
- Clones de celebridades e políticos criam riscos jurídicos e de confiança, mesmo quando a interface os oferece a um clique de distância
- Equipes alternam entre um roteirista, um engenheiro de prompt, um compositor e uma ferramenta de voz sem uma bíblia de personagens compartilhada
Mesma Voz, Nome Diferente
Um gerador de voz de personagem pode mudar o tom e ainda falhar na identidade. Ouvintes percebem atitude, não apenas frequência: como um vilão prolonga uma consoante, como uma criança atropela uma piada, como uma capitã cansada reduz o volume ao fim de um relatório. Pesquisas sobre fala sensível à emoção e específica para personagens de quadrinhos e geração de voz multpersonagem orientada por texto chegam repetidamente à mesma conclusão — o modelo precisa de contexto de personagem, não apenas de uma forma de onda como alvo. Sem uma personalidade escrita, você obtém figurino, não performance.
A Barreira de Custo para Equipes Independentes e de Médio Porte
Protagonistas humanos ainda conduzem cenas emocionalmente complexas. O problema de produção está na cauda longa: milhares de saudações de NPCs, variantes localizadas e pronúncias do nome do jogador. Uma análise do setor sobre voz ética com AI em jogos descreve uma divisão “humano+” — atores nas cenas principais, síntese em grande volume — e observa que equipes independentes agora conseguem localizar para dezenas de idiomas em semanas, e não meses. Isso só ajuda se as falas de origem forem fáceis de falar e a ficha do personagem for estável. Caso contrário, você paga para multiplicar um áudio medíocre.
Roteiros Que Nunca Foram Feitos para Serem Ouvidos
Prosa de romance e textos de interface entram em conflito com a fala. Orações encaixadas, siglas sem explicação e nomes de fantasia impronunciáveis levam o modelo a padrões robóticos de ênfase. Um gerador de voz de personagem vai interpretar fielmente uma fala ruim. A solução vem antes: trechos mais curtos, grafias fonéticas, direções emocionais de palco e diálogos que um intérprete realmente conseguiria dizer em uma só respiração.
Consentimento, Clonagem e Plataformas Que Convidam Problemas
Sistemas zero-shot conseguem replicar um timbre em cerca de três segundos. Essa velocidade é útil para réplicas consentidas e personagens originais. Ela é perigosa quando uma biblioteca apresenta figuras públicas ou mascotes protegidos por direitos autorais como predefinições. A FTC deixou claro que não existe isenção de AI das leis vigentes de proteção ao consumidor, e utilizou o Desafio de Clonagem de Voz e uma Regra de Personificação para combater áudio enganoso. Nos jogos, o Acordo de Mídia Interativa de julho de 2025 foi aprovado com 95,04% dos votos e tornou o consentimento por escrito inegociável para replicação de voz. Se seu fluxo não consegue comprovar o consentimento, não gere a voz.
É exatamente para isso que a Jenova foi criada: para oferecer a inteligência de personagem em torno do gerador, não um atalho para contornar a lei.
A Solução Jenova
Um gerador de voz de personagem transforma texto em áudio. A Jenova torna esse texto digno de ser dublado. Você define quem está falando, como pensa, o que nunca diria e como uma fala deve soar — depois entrega um prompt e roteiro limpos ao modelo de fala que usar. Plataformas de áudio dedicadas geram formas de onda; esta plataforma constrói a pessoa por trás da forma de onda.
| Abordagem Tradicional | Jenova |
|---|---|
| Reservar um estúdio, esperar pelas sessões e refazer cada ajuste | Fichas de personagens e rascunhos fáceis de falar em uma única sessão de trabalho |
| Uma voz TTS com um novo nome de exibição | Personalidade, dicção e momentos emocionais escritos para cada papel |
| Clonar uma voz famosa e torcer para ninguém perceber | Personagens originais, réplicas consentidas e uso documentado |
| Roteirista em uma aba, notas de prompt em outra, compositor em uma terceira | Agentes conectados para história, prompts, quadrinhos, música e entrega |
| Localização sem profundidade que ignora humor e timing | Falas estruturadas para encaixe silábico e adaptação cultural |
Bíblias de Personagens Antes de Mexer no Áudio
Comece pela identidade, não por uma predefinição. O Name Generator produz nomes culturalmente coerentes e fáceis de pronunciar — um filtro prático que muitos fluxos de voz ignoram até que um modelo tente mastigar um aglomerado de consoantes. Combine-o com o Writing Assistant para fixar a dicção: teto de vocabulário, palavras proibidas, piadas recorrentes e a metáfora à qual um personagem sempre recorre. Quando essas restrições existem, qualquer gerador de voz de personagem tem algo específico para interpretar.
Diálogo Feito para a Boca
O Film Screenwriter trata falas como comportamento cronometrado: interrupção, silêncio e subtexto. Essa técnica se transfere diretamente para falas de jogo, drama vertical e quadrinhos dublados. Você obtém indicações entre parênteses que um modelo de voz pode seguir, como “em voz baixa, depois mais viva”, em vez de rótulos vagos como “triste”. Para narrativas mobile serializadas, o Microdrama Screenwriter mantém os ganchos curtos o bastante para serem falados sem perder o fôlego.
Exemplo de direção que você pode colar em um gerador:
“Leia como a Capitã Ilya Voss, na casa dos 50, com uma voz rouca e baixa, vinda do peito. Ela nunca aumenta o volume quando está com raiva — ela fala mais devagar. Fala: ‘Você trouxe o mapa. Não trouxe o clima.’ Faça uma pausa depois de ‘mapa’. Sem sorriso.”
Prompts Que Resistem ao Contato com um Modelo
A maioria das “vozes ruins de AI” resulta de instruções ruins. O Prompt Generator transforma uma bíblia de personagem em texto pronto para o modelo: observações sobre sotaque, idade, ambiente de gravação, arco emocional e instruções negativas, como “sem cadência de locutor, sem sorrir nas vogais”. Essa é a diferença entre uma ficha de catálogo chamada “Garota de Anime” e uma pessoa que, por acaso, é animada.
Imagem, Trilha e o Resto da Cena
A voz é apenas uma camada. O Graphic Designer cria o rosto que o ouvido espera. Manga Creator, Comic Creator e Webtoon Creator produzem arte sequencial cujos movimentos labiais e ritmo dos quadros você pode musicar. O Music Composition Assistant e o Lyric Writer dão aos personagens motivos musicais e versos cantáveis para que a voz falada e a música pertençam ao mesmo mundo.
Enquanto APIs de fala dedicadas se especializam em renderizar áudio, a Jenova se especializa na escrita, nos prompts e na continuidade que determinam se alguém vai querer ouvir esse áudio uma segunda vez.
Agentes de AI Especializados para Trabalho com Vozes de Personagens
Experimente a Jenova gratuitamente — sem cartão de crédito. Estes agentes cobrem as tarefas que vêm imediatamente antes e depois de um gerador de voz de personagem.
Roleplay Game Master
Se você precisa ouvir um personagem nas palavras antes de sintetizá-lo, este é o espaço de ensaio. A memória ilimitada mantém a dicção, os segredos e os relacionamentos estáveis ao longo das sessões, o equivalente textual de um modelo de voz fixo.
- Testa bordões até que soem inevitáveis
- Mantém as vozes do grupo e dos NPCs distintas em campanhas longas
- Produz falas no personagem que você pode inserir diretamente em um gerador
Film Screenwriter
Use-o quando a voz precisa conduzir a trama, não apenas acrescentar estilo. Estrutura, objetivos de cena e técnica de diálogo impedem que as performances virem exposição com um sotaque engraçado.
- Momentos e conflitos que justificam mudanças emocionais no áudio
- Falas curtas e práticas para regravações em jogos e anúncios
- Desenvolvimento de personagem que se sustenta em uma dublagem de doze episódios
Prompt Generator
Modelos de voz são tão bons quanto o briefing. Este agente escreve prompts para sistemas de texto, imagem, música e vídeo — incluindo os modelos de fala pelos quais você já paga.
- Blocos de prompt consistentes por personagem para que os episódios combinem
- Descritores de emoção e ambiente que os modelos realmente seguem
- Refinamento iterativo quando uma tomada volta clara demais ou lenta demais
Writing Assistant
O principal instrumento para bíblias, narração e reescritas do tipo “isso deveria soar como ela”. Ele se adapta ao formato e ao público para que uma explicação do universo e um insulto de taverna não compartilhem o mesmo ritmo de frase.
- Revisão editorial para facilidade de fala e nível de leitura
- Correspondência de tom entre textos de missão, trailers e notas de atualização
- Colaboração quando você já tem um rascunho que quase funciona
Music Composition Assistant
Um gerador de voz de personagem cuida da fala. Este agente cuida da base musical por baixo dela — motivos, harmonia e notas de arranjo que você pode entregar a uma DAW ou a outro modelo.
- Leitmotivs ligados a papéis específicos
- Mapas de andamento que deixam espaço para o diálogo
- Orientação baseada em teoria para que o tema de um vilão não entre em choque com uma extensão vocal
Public Speaking Coach
Quando você é o intérprete — ou quando precisa dirigir um — este agente trabalha entrega, ansiedade e público. Ele é a contraparte humana da fala sintética: respiração, pausa e ênfase que você pode então codificar em um prompt.
- Marcações de ritmo e ênfase transferíveis para tags TTS
- Ensaio de perguntas e respostas e leituras ao vivo para transmissões híbridas
- Observações sobre o que uma fala faz com o ouvinte, não apenas sobre como ela soa
Como um Fluxo de Trabalho com Gerador de Voz de Personagem Funciona de Verdade
Você não precisa de um estúdio primeiro. Precisa de uma pessoa na página, de uma fala que possa ser dita e de um prompt que não se contradiga.
Etapa 1: Defina a Pessoa, Não a Predefinição
Escreva idade, status, corpo e uma regra que ela nunca quebra. Gere um nome fácil de pronunciar e depois uma bíblia de 150 palavras. Se dois personagens podem trocar falas sem que ninguém perceba, você ainda não tem duas vozes.
“Crie uma bíblia de personagem para Ryn Calder, 17 anos, mensageira fluvial, sempre educada com a carga e rude com capitães. Frases curtas. Sem gírias posteriores ao incêndio de sua vila. Dê-me três falas que ela nunca diria.”
Etapa 2: Escreva Falas para a Respiração, Não para a Página
Leve a cena ao Writing Assistant ou ao Film Screenwriter. Corte orações encaixadas. Escreva nomes difíceis foneticamente entre colchetes. Adicione uma indicação de performance que o modelo consiga executar.
“Reescreva este parágrafo de história do mundo como seis falas de Ryn, com no máximo doze palavras cada, e marque uma pausa antes da última fala.”
Etapa 3: Transforme a Bíblia em um Prompt para o Gerador
Entregue as mesmas restrições ao Prompt Generator. Especifique o ambiente de gravação, a distância do microfone, a emoção em uma escala de 1 a 5 e o que evitar. Mantenha um bloco salvo para cada personagem para que o quarto episódio não se desvie.
“Converta a bíblia de Ryn em um prompt para modelo de voz: contralto adolescente, seca, reverberação de armazém interno, ritmo de 1.05x, sem sorriso, sem final de locutor. Inclua instrução negativa.”
Etapa 4: Alinhe Rosto, Quadro e Trilha
Insira a mesma bíblia nos agentes visuais e musicais para que a imagem e a base musical concordem com a voz. Um rosto de desenho brilhante sobre uma interpretação fúnebre é como o público decide que o áudio é falso — mesmo quando o modelo está correto.
Etapa 5: Ensaie no Celular e Depois Gere o Áudio
A Jenova oferece paridade total de recursos na web, iOS e Android. Leia a fala em voz alta durante o trajeto, marque onde tropeçou, reescreva e só então cole no seu gerador de voz de personagem. A regravação mais barata é aquela que você nunca precisou fazer.
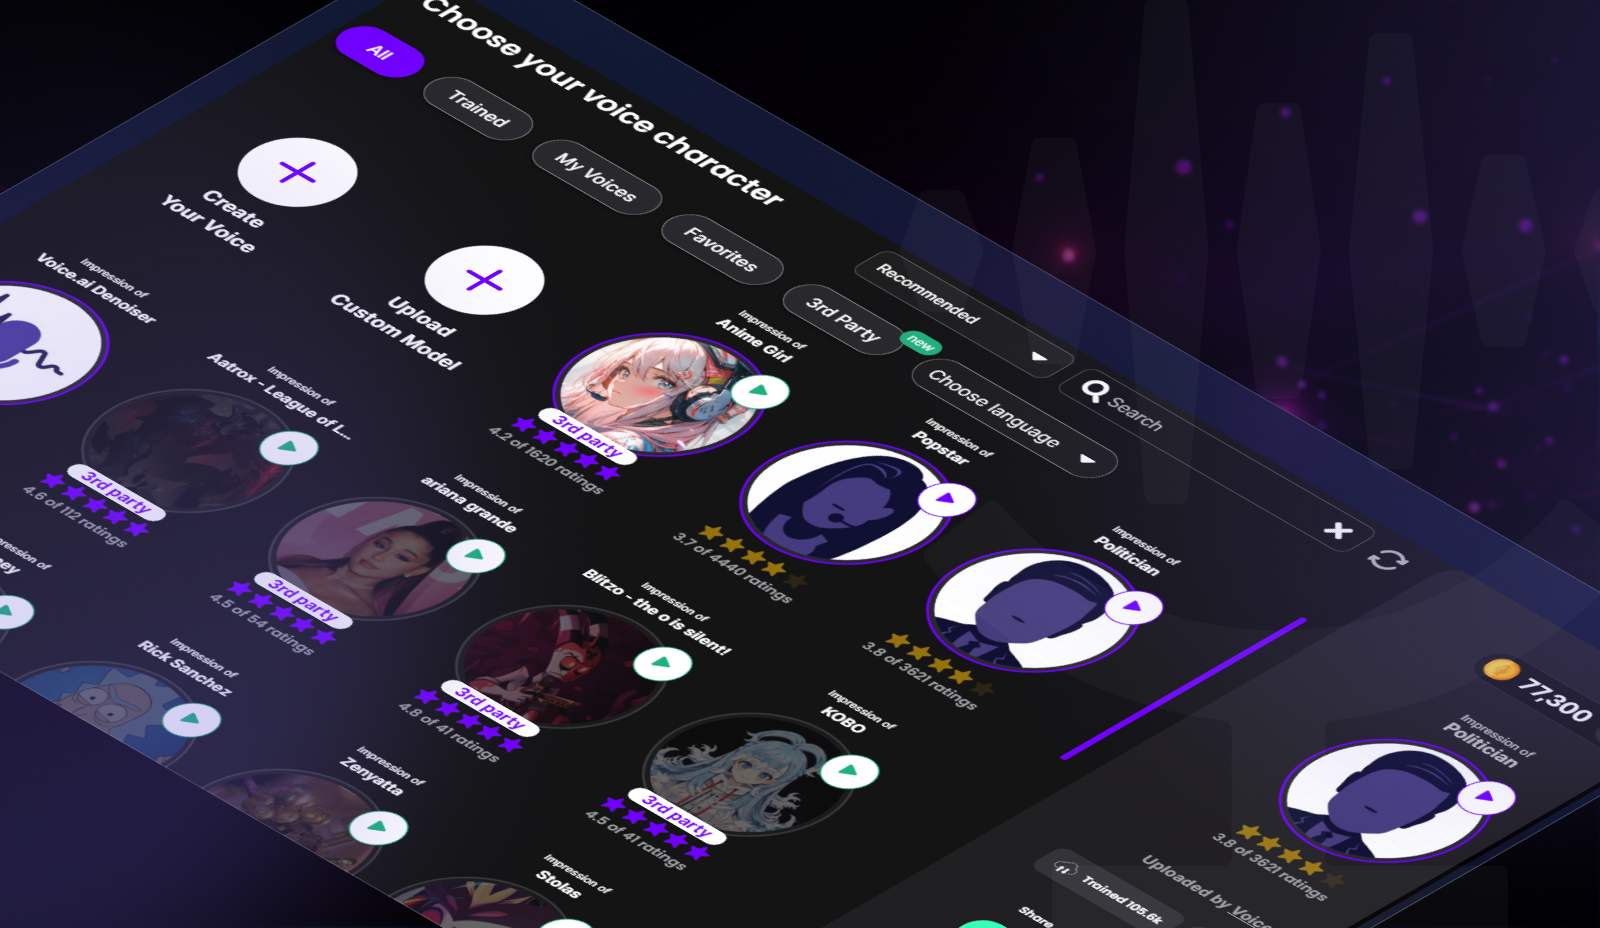
Resultados e Casos de Uso
🎮 NPCs de Jogos Independentes Sem Orçamento para Estúdio
Cenário: Um RPG de 12 horas precisa de 4.000 falas não principais, além da pronúncia do nome do jogador.
Abordagem Tradicional: Sessões com elenco sindicalizado para os papéis principais, silêncio ou falas reutilizadas para todos os demais, localização deixada para “algum dia”.
Jenova: As cenas principais permanecem humanas. A cauda longa recebe bíblias, falas fáceis de dizer e prompts estáveis para que seu gerador de voz de personagem possa preencher recepcionistas, lojistas e NPCs de rumores sem clonar uma celebridade.
- Fichas de personagem que impedem um ferreiro de soar como um mago
- Falas curtas prontas para localização
- Blocos de prompt que você pode versionar como código
🎬 Dublagem de Webtoons e Quadrinhos
Cenário: Uma série vertical semanal quer episódios em áudio sem esperar por um elenco completo.
Abordagem Tradicional: Dublagens de fãs com microfones incompatíveis ou um único narrador fazendo todos os papéis.
Jenova: O Webtoon Creator e o Comic Creator mantêm a continuidade visual enquanto o roteirista divide as vozes por quadro. Cada papel recebe seu próprio prompt, para que o gerador não precise adivinhar.
- Falas cronometradas por quadro em vez de blocos de prosa
- Elencos distintos para protagonistas e multidão
- Indicações musicais que deixam espaço para a fala
📱 Prática de Idiomas Que Soa Como Alguém
Cenário: Você está no trajeto diário e quer conversa, não uma voz de livro didático.
Abordagem Tradicional: Exercícios em App com um único tutor sintético e sem memória dos seus erros.
Jenova: O Learn English Through Roleplay coloca você em uma cena com um personagem consistente. Depois, você pode dublar essas mesmas falas em um gerador para praticar compreensão auditiva — sempre com personagens originais, não imitações.
- Memória que impede o barista de reiniciar a cada sessão
- Expressões dentro de situações que você realmente reutilizará
- Sessões mobile que cabem em uma viagem de trem
🎙️ Elencos para Podcasts e Redes Sociais de Marca
Cenário: Um canal de produto precisa de um apresentador, uma coadjuvante cética e um aviso lido diretamente toda semana.
Abordagem Tradicional: A mesma voz do fundador em todos os segmentos ou um freelancer que não pode trabalhar na quinta-feira.
Jenova: O Social Media Content Generator cria roteiros nativos para cada plataforma; os agentes de escrita e prompt evitam que o apresentador e a coadjuvante se confundam. Você renderiza na sua ferramenta de voz licenciada, não com um clone não autorizado de uma figura pública.
- Quadros recorrentes com dicção estável
- Avisos escritos para serem falados, não lidos por alto
- Ganchos dimensionados para Shorts, Reels e episódios completos
Perguntas Frequentes
O que é um gerador de voz de personagem?
Um gerador de voz de personagem é um software que transforma texto em fala com uma identidade escolhida — idade, tom, sotaque e emoção — para que papéis diferentes não compartilhem a mesma cadência. O modelo de áudio fornece o timbre. A escrita do personagem, a direção de palco e os prompts fornecem a pessoa. As ferramentas da Jenova atuam nesse lado da escrita: bíblias, diálogos e instruções prontas para modelos que você pode colar em qualquer sistema de fala licenciado.
Geradores de voz de personagem são gratuitos?
Muitos Apps de fala oferecem um plano gratuito limitado e cobram por clipes mais longos, direitos comerciais ou vozes clonadas. A Jenova tem um plano gratuito com recursos essenciais e níveis pagos caso você precise de mais uso. Planeje dois custos: o trabalho criativo, como roteiros, prompts e continuidade, e o renderizador, como minutos de áudio e licenças de voz. O consentimento e os termos comerciais para vozes clonadas são separados do preço da assinatura — leia ambos antes de publicar.
Como faço para que vozes de personagens com AI soem únicas?
Dê a cada papel uma regra, um teto de vocabulário e um hábito físico, depois escreva falas que eles não poderiam trocar entre si. Inclua essas restrições no prompt todas as vezes: ambiente, ritmo, emoção e uma instrução negativa contra a cadência de locutor. O Prompt Generator foi criado para esse briefing. Se dois personagens ainda soarem idênticos após um bom prompt, o problema está na bíblia, não no controle deslizante.
É legal clonar a voz de uma pessoa real?
Não como padrão, nem como uma predefinição de brincadeira. Você precisa de consentimento claro e registrado para o uso que realmente pretende fazer, além das regras de direito de imagem e direitos autorais aplicáveis na sua jurisdição. A FTC trata a clonagem enganosa de voz por AI como um problema de proteção ao consumidor, não como uma novidade. Acordos de jogos e entretenimento exigem cada vez mais consentimento por escrito e relatórios de uso. Crie personagens originais ou réplicas licenciadas. Não extraia a voz de um político, ator ou cantor só porque um painel tornou isso fácil.
Posso executar esse fluxo de trabalho no celular?
Sim. A Jenova foi criada para web, iOS e Android com as mesmas capacidades essenciais, incluindo conversão de fala em texto quando você prefere gravar uma nota a digitar durante o trajeto. Escreva uma fala no trem, aperte o texto, gere o prompt e depois renderize em sua ferramenta de voz para desktop, caso seja nela que seus modelos licenciados estejam disponíveis.
Como isso é diferente de texto para fala comum?
Um TTS comum lê palavras. Um gerador de voz de personagem tenta interpretar um papel. A performance ainda depende da escrita: identidade, conflito e direção. A Jenova não substitui seu renderizador de áudio licenciado. Ela produz o trabalho de personagem que esse renderizador precisa, por meio de agentes como o Roleplay Game Master e o Film Screenwriter, para que você não pague para ouvir o mesmo estagiário prestativo em seis fantasias.
Conclusão
Um gerador de voz de personagem é tão bom quanto a pessoa que você pede para ele ser. Os mercados de fala por AI estão crescendo rapidamente, os modelos conseguem fixar um timbre em segundos e os reguladores já rejeitaram a ideia de que “a AI fez isso” seja uma defesa. O caminho prático é mais restrito e melhor: personagens originais, réplicas consentidas, escrita fácil de falar e prompts que você consegue reproduzir.
Crie o papel, escreva a respiração e depois gere a tomada. Comece com a Jenova — e então leve essas falas à ferramenta de fala em que você já confia.
Explore mais desse mesmo fluxo de trabalho com o Roleplay Game Master, o Writing Assistant e o Prompt Generator. Quando o personagem está claro, a voz tem para onde ir.
Para Desenvolvedores: Todos os agentes deste artigo estão disponíveis programaticamente pela Jenova API — integre bíblias de personagens, geração de diálogos e criação de prompts para modelos de voz à sua aplicação com uma única integração. Documentação completa →