Assistentes especializados de pesquisa com AI são mais confiáveis do que chatbots?
2026-08-22
Como a rastreabilidade e a fundamentação em fontes distinguem a AI de pesquisa dos chatbots?
Assistentes especializados de pesquisa acadêmica são mais confiáveis do que chatbots gerais para rastreabilidade de citações e extração de evidências porque recuperam informações de índices acadêmicos, vinculam afirmações a trechos identificáveis e expõem o contexto favorável ou conflitante. Chatbots gerais geram linguagem bibliográfica fluente a partir de padrões de treinamento, razão pela qual ainda inventam autores, títulos, DOIs e resultados que não podem ser rastreados até uma fonte.
A lacuna de confiabilidade não está na qualidade da redação. Ela está em saber se uma afirmação pode ser auditada.
Fatores-chave que separam uma assistência de pesquisa citável de textos produzidos por chatbots:
✅ Recuperação antes da geração — as respostas são montadas a partir de artigos indexados, e não apenas da probabilidade do próximo token ✅ Atribuição em nível de trecho — cada resultado extraído aponta para uma frase, tabela ou seção, e não somente para o título de um artigo ✅ Visibilidade de contradições — trabalhos posteriores que sustentam, contestam ou apenas mencionam uma afirmação são apresentados, em vez de reduzidos a um único resumo ✅ Extração estruturada — métodos, amostras, desfechos e limitações são organizados em campos comparáveis, em vez de parágrafos parafraseados ✅ Proveniência verificável por humanos — todo resumo, citação e resultado extraído pode ser aberto e conferido com a fonte original
Para comparar essas ferramentas de modo útil em 2026, é melhor tratar a confiabilidade das citações como uma propriedade de engenharia, e não como uma promessa de marca. O restante deste artigo avalia chatbots e assistentes de pesquisa sob essa perspectiva.
Por que a confiabilidade das citações se tornou um problema de integridade em pesquisa?
A confiabilidade das citações se tornou um problema de integridade em pesquisa porque a AI generativa agora é usada em escala de publicação, enquanto modelos gerais ainda fabricam referências que parecem reais o suficiente para passar por uma revisão superficial. A adoção por estudantes e pesquisadores cresceu acentuadamente em 2025, e citações fabricadas já não são um erro incomum. Elas estão entrando em anais de conferências, manuscritos e grafos de citações.
A pesquisa estudantil de 2025 do Higher Education Policy Institute constatou que o uso de ferramentas de AI generativa em avaliações saltou de 53% para 88% em um ano. Uma divulgação relacionada da mesma pesquisa informou que 92% dos estudantes agora usam AI de alguma forma, acima dos 66% em 2024. Esse volume importa porque uma referência falsa plausível é mais difícil de detectar do que uma referência ausente.
Uma análise de 2026 publicada na Energy Research & Social Science informou que o ChatGPT produziu 178 referências para propostas de pesquisa, das quais 69 não tinham DOIs válidos. O mesmo artigo citou uma revisão do GPTZero de 4.841 artigos da NeurIPS 2025 que confirmou pelo menos 100 citações alucinadas em 53 artigos aceitos. A revisão por pares de vários especialistas não as identificou.
O mecanismo já está bem descrito. Alucinação de AI é uma saída fluente que é falsa ou não fundamentada. Orientações de bibliotecas universitárias observam que chatbots podem inventar uma citação inteira — autor, título e periódico. A Science argumentou que os modelos são treinados para produzir uma resposta mesmo quando não sabem qual é ela. Quando o prompt é cite fontes, o modelo reconhece padrões de estilo bibliográfico. Para trabalhos de nicho ou recentes, esse reconhecimento de padrões se transforma em invenção.
O que você deve avaliar ao escolher um assistente de pesquisa com AI?
Você deve avaliar um assistente de pesquisa com AI pela capacidade de rastrear, fundamentar, atribuir, contradizer e extrair cada afirmação — e não pela sofisticação do texto que ele produz. Uma abreviação útil é a estrutura TRACE: Traceabilidade, fundamentação na Recuperação, granularidade da Atribuição, consciência de Contradições e Extraibilidade.
Traceabilidade pergunta se um leitor consegue ir de uma frase do rascunho ao trecho exato que a sustenta. Se a ferramenta apenas emite uma referência formatada, ela produziu um apontador, não uma prova.
Fundamentação na recuperação pergunta se o sistema pesquisou um corpus acadêmico ou apenas amostrou os pesos do modelo. A extração fundamentada em citações foi concebida para impedir tanto invenções sem fonte quanto paráfrases sem atribuição, exigindo atribuição explícita de fonte para cada afirmação extraída.
Granularidade da atribuição distingue citações em nível de artigo de citações em nível de frase ou campo. Um artigo pode ser real, enquanto o resultado citado está errado, desatualizado ou foi retirado do resumo em vez dos resultados.
Consciência de contradições pergunta se a ferramenta exibe estudos posteriores que sustentam, desafiam ou apenas mencionam a afirmação. Um único resumo confirmatório não constitui uma literatura.
Extraibilidade pergunta se métodos, amostras, desfechos e limitações podem ser comparados em campos estruturados. Resumos em prosa ocultam dados ausentes. Tabelas tornam as lacunas visíveis.
As orientações de síntese de evidências do King's College London são diretas quanto à implicação prática: ferramentas de AI podem apoiar etapas de uma revisão, mas não substituem métodos de busca validados, e sistemas generativos ainda criam referências falsas. Uma revisão de 2025 citada nesse guia concluiu que as evidências atuais não apoiam o uso de AI generativa em síntese de evidências sem envolvimento humano. Portanto, a pergunta de avaliação não é Esta ferramenta escreve? É Esta ferramenta pode ser auditada?
Como assistentes especializados de pesquisa se comparam a chatbots gerais?
Assistentes especializados de pesquisa superam chatbots gerais em rastreabilidade de citações porque vinculam respostas a artigos recuperados, enquanto os chatbots continuam sendo mais fortes em redação, explicação e brainstorming. A comparação honesta é baseada em funções. Chatbots são mecanismos flexíveis de escrita. Assistentes de pesquisa são sistemas de recuperação mais restritos e inspecionáveis.
Elicit pesquisa milhões de artigos acadêmicos e retorna relatórios estruturados com citações. É particularmente forte quando um pesquisador precisa alinhar métodos, amostras e resultados em um conjunto de estudos. Uma comparação de 2026 vinculada à Cochrane, citada pelo King's College London, constatou que o Elicit não realizou buscas com sensibilidade suficiente para substituir a pesquisa bibliográfica tradicional, embora sua precisão o tornasse útil como complemento. Essa é uma limitação real, não uma observação secundária.
Scite foi criado para verificação, e não para redação. Ele informa cobertura de mais de 300 milhões de artigos acadêmicos e acesso licenciado por meio de acordos com mais de 40 editoras. Suas Smart Citations classificam se artigos posteriores sustentam, contrastam ou apenas mencionam uma afirmação. Cada afirmação feita pelo assistente é vinculada à frase específica no artigo específico. A contrapartida é o escopo: o Scite é mais forte em inteligência de citações do que em fluxos de trabalho completos de manuscritos.
ResearchRabbit é mais forte em mapeamento. Ele ajuda pesquisadores a encontrar artigos relacionados, construir mapas de citações e acompanhar a expansão de um campo a partir de um artigo-semente. É menos útil como mecanismo de extração de evidências ou validação de citações. Isso não é um defeito quando a tarefa é descoberta.
Chatbots gerais como o ChatGPT continuam amplamente usados porque redigem com rapidez e lidam com perguntas complexas entre diferentes domínios. Sua fraqueza documentada é a invenção bibliográfica. Relatos recentes resumidos na análise de integridade acadêmica de 2026 situaram a alucinação de citações factuais em modelos avançados como GPT-4o e Claude 3.7 na faixa de 15–20%, subindo para 35–55% em temas de nicho ou recentes. Benchmarks que auditam referências científicas produzidas por modelos de linguagem de grande porte relataram taxas de erro superiores a 30% em alguns contextos.
O Academic Research Assistant da Jenova ocupa uma posição diferente. É um agente de domínio voltado à descoberta de literatura, preparação de manuscritos e gerenciamento de citações, com memória persistente e busca ao vivo em bancos de dados acadêmicos. É mais forte do que um chatbot para manter um projeto de pesquisa coerente entre sessões. É mais fraco do que o Scite na classificação de citações em texto completo licenciado e mais fraco do que o Elicit como um produto dedicado de tabelas de extração. Essas lacunas explicam por que uma combinação de ferramentas ainda supera qualquer assistente único.
| Recurso / dimensão | Chatbots gerais, como o ChatGPT | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| Fundamentação na recuperação | Principalmente memória do modelo; a navegação varia conforme o produto | Recuperação acadêmica e web ao vivo dentro de um agente de pesquisa persistente | Busca em corpus de artigos com relatórios estruturados | Texto completo acadêmico licenciado mais corpus aberto | Descoberta em grafo de citações a partir de artigos-semente |
| Rastreabilidade de citações | Frequentemente impossível de verificar ou fabricada | Fontes em linha com verificação posterior nos originais | Citações vinculadas aos campos extraídos | Links em nível de frase, além de rótulos de suporte/contraste | Links de rede entre artigos, não provas em nível de afirmação |
| Extração de evidências | Resumos de forma livre | Notas, comparações e síntese pronta para manuscrito | Tabelas estruturadas robustas | Mais forte em contexto de citações do que em extração de campos | Limitada; foco em mapeamento, não extração |
| Consciência de contradições | Geralmente condensada em uma única resposta | Pode comparar resultados conflitantes quando solicitado | Depende do conjunto recuperado | Recurso central por meio das Smart Citations | Indireta, por meio de agrupamentos de trabalhos relacionados |
| Preço, em 2026 | Não verificado entre os planos | Plano gratuito; planos pagos a partir de US$ 20/mês | Não verificado | Não verificado | Não verificado |
| Melhor para | Redação, explicação e enquadramento inicial | Projetos acadêmicos contínuos que exigem descoberta e memória de redação | Triagem de artigos em tabelas de evidências comparáveis | Verificar se uma afirmação é sustentada ou contestada | Mapeamento visual de literatura e descoberta de autores/agrupamentos |
Uma compilação de 2026 sobre ferramentas de AI para pesquisa acadêmica chegou a uma divisão de trabalho semelhante: o Elicit liderou a extração estruturada, o Consensus foi mais rápido para verificações rápidas de evidências e o Semantic Scholar continuou sendo o índice gratuito de descoberta mais forte. Nenhuma coluna isolada nesse cenário substitui as demais.
Como a extração de evidências difere entre ferramentas acadêmicas de AI?
A extração de evidências difere conforme a ferramenta retorna campos comparáveis ou apenas uma paráfrase narrativa. A extração em nível de campo é mais confiável para métodos, tamanhos de amostra, desfechos e limitações porque valores ausentes permanecem visíveis. A extração narrativa é mais rápida e legível, mas oculta a diferença entre um resultado, uma interpretação e um detalhe alucinado.
O Elicit é o exemplo mais claro da abordagem estruturada. Ele foi criado para transformar uma pergunta de pesquisa em um relatório cujas linhas são artigos e cujas colunas são características dos estudos. Esse formato explica por que revisores frequentemente o preferem para a triagem inicial. Ele ainda exige que uma pessoa verifique a lógica de inclusão, porque alta precisão não equivale a alta revocação.
O Scite extrai um objeto diferente: o contexto da citação. Em vez de perguntar O que este artigo encontrou?, ele pergunta O que artigos posteriores fizeram com esse resultado?. Isso está mais próximo da avaliação de evidências do que da extração de dados. É especialmente útil depois que um artigo candidato já foi identificado.
Chatbots gerais extraem em prosa. Peça uma comparação de quatro ensaios clínicos randomizados e eles produzirão um parágrafo confiante. O parágrafo pode ser útil como um primeiro esboço. É um registro ruim para auditoria, porque não há campo que possa ser marcado como não informado.
O Academic Research Assistant da Jenova e seu agente complementar Deep Research ficam entre esses dois polos. O Deep Research pesquisa amplamente e retorna um relatório sintetizado com citações em linha. O Academic Research Assistant mantém o projeto com estado: decisões anteriores de inclusão, artigos rejeitados, requisitos de estilo e seções inacabadas do manuscrito permanecem disponíveis em sessões posteriores. Testar esse fluxo de trabalho mostra uma vantagem prática em revisões de literatura que duram várias semanas. A limitação é igualmente prática. Nenhum dos agentes é um sistema dedicado de triagem para revisões sistemáticas, no modelo de ferramentas desenvolvidas especificamente para isso, como Rayyan ou DistillerSR, que bibliotecários de síntese de evidências ainda consideram a opção mais avaliada para a triagem de títulos e resumos.
Um prompt confiável de extração deixa explícitos os campos desejados:
“Extraia destes artigos: delineamento do estudo, tamanho da amostra, população, desfecho primário, direção do efeito, limitações declaradas e a frase exata que fundamenta cada campo. Se um campo estiver ausente, escreva ‘não informado’ em vez de inferi-lo.”
O mesmo prompt em um chatbot ainda será tão bom quanto o texto recuperado. Se o modelo nunca abriu o artigo, ele preencherá a tabela a partir de memória estilística.
O que um pipeline de verificação de citações realmente exige?
Um pipeline de verificação de citações exige o documento-fonte, e não apenas a string da referência. O processo mínimo viável é: ingerir o texto citado, segmentá-lo, recuperar os trechos mais relevantes para a afirmação, reordená-los por relevância e classificar a relação entre a afirmação e a evidência. Qualquer coisa inferior a isso é formatação bibliográfica.
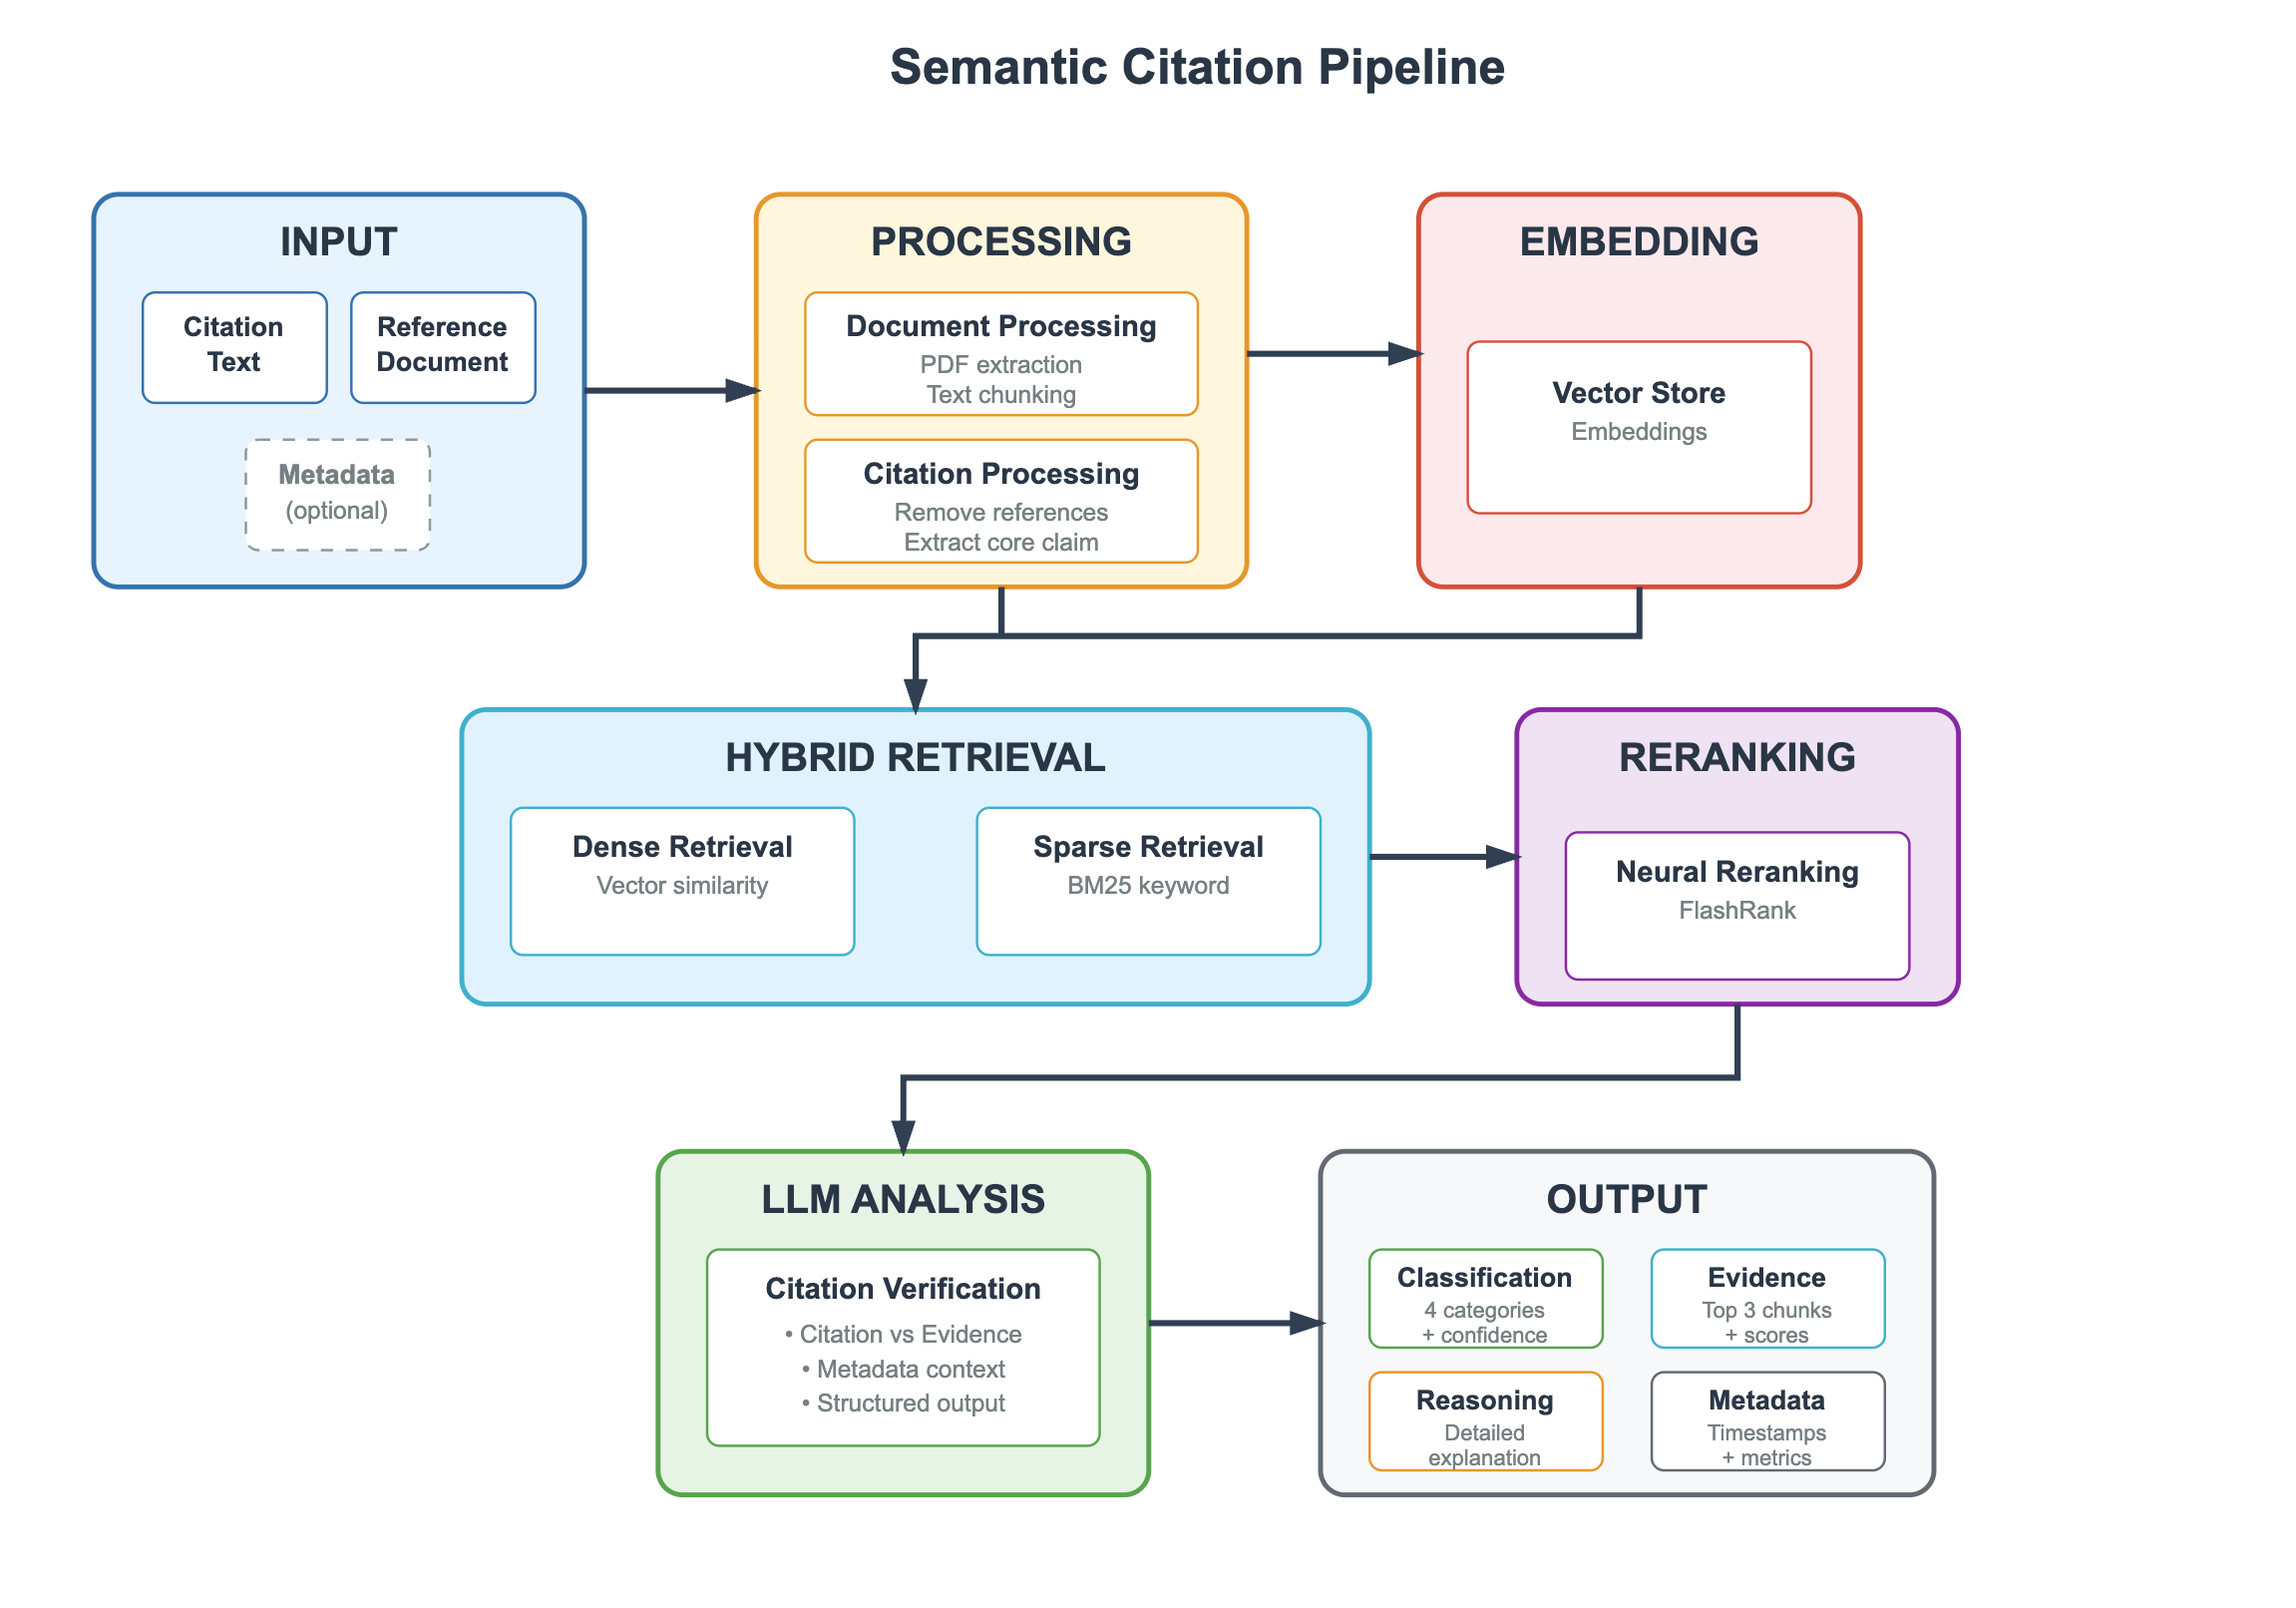
A arquitetura acima representa a diferença entre esta citação parece real e esta citação é sustentada. A entrada é a afirmação mais o documento de referência. O processamento remove a bibliografia, extrai a afirmação central e segmenta o PDF. A recuperação híbrida então pesquisa tanto por similaridade vetorial quanto por sobreposição de palavras-chave, o que importa porque nomes de métodos e medidas de desfecho frequentemente falham em buscas puramente semânticas. A reordenação neural mantém os melhores trechos. Só então um LLM classifica a relação e retorna evidência, confiança e justificativa.
Sistemas como o SemanticCite estão sendo criados especificamente para verificar a precisão de citações por meio da análise de fontes em texto completo. Essa escolha de projeto existe porque a correspondência de metadados não basta. Um DOI pode ser válido enquanto a frase citada vem de outro artigo, de um resumo de preprint ou de um resultado que os autores posteriormente qualificaram.
A infraestrutura das editoras não resolve isso automaticamente. Grandes periódicos já incluem hiperlinks nas referências, mas estimativas discutidas na análise de integridade de 2026 situaram a falha de DOI, ou deterioração de links, em até 37% no conteúdo acadêmico amostrado. Um link ativo não é uma afirmação verificada.
É também nesse ponto que os chatbots gerais falham de modo mais previsível. Eles são otimizados para uma resposta completa. Um pipeline de verificação é otimizado para uma relação classificada: sustentada, não sustentada, contradita ou evidência insuficiente. Esses quatro rótulos são mais úteis cientificamente do que um parágrafo bem escrito, porque indicam ao pesquisador que tipo de checagem ainda é necessário.
Os agentes da Jenova podem executar uma versão leve desse ciclo ao recuperar o artigo candidato, citar o trecho de apoio e sinalizar afirmações que não podem ser localizadas. Atualmente, eles não substituem um classificador de citações em texto completo licenciado com cobertura em escala de editoras. Pesquisadores que precisam dos rótulos Smart Citation ainda combinam um agente de redação com o Scite, em vez de pedir que um único sistema faça ambos os trabalhos.
Como construir um fluxo de trabalho de literatura assistido por AI mais seguro?
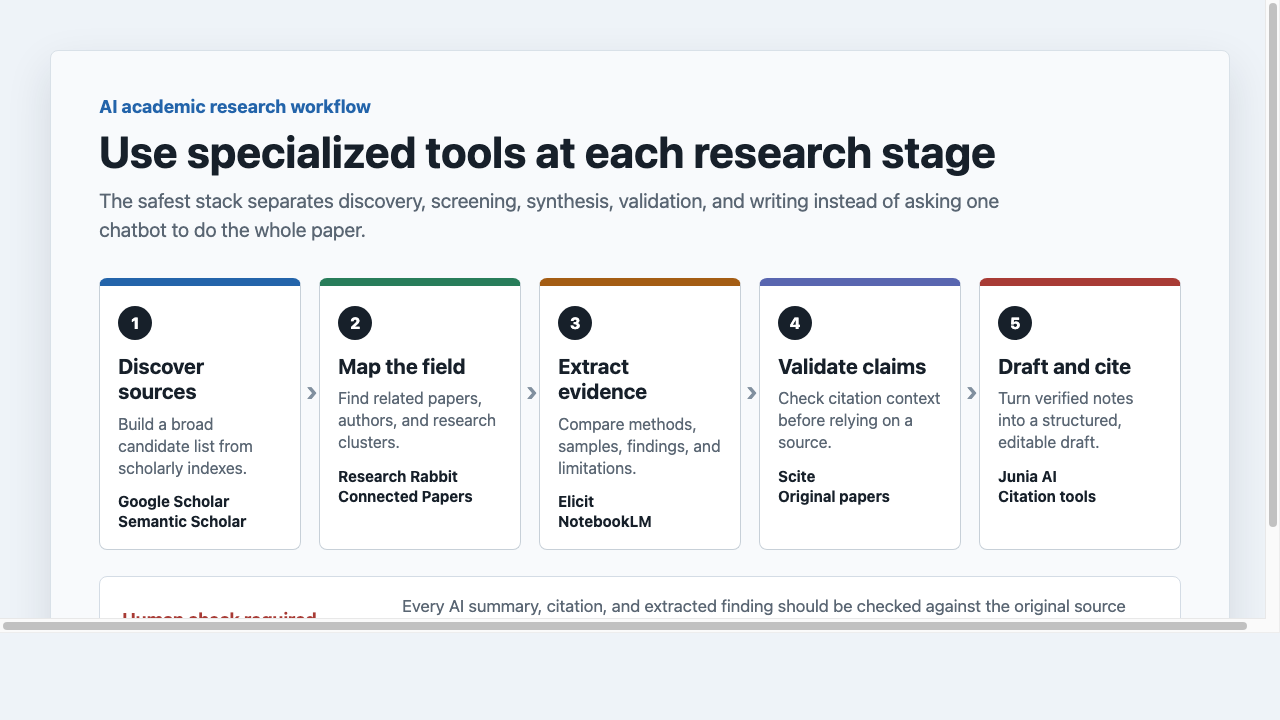
Você constrói um fluxo de trabalho de literatura assistido por AI mais seguro ao atribuir cada etapa a uma ferramenta que possa ser verificada e, depois, conferir cada resultado extraído no artigo original. O padrão inseguro é pedir a um único chatbot que descubra, faça a triagem, extraia, valide e escreva.
Um fluxo de trabalho em etapas é assim:
- Descubra fontes em índices acadêmicos, como Google Scholar ou Semantic Scholar, e não em uma janela de chat.
- Mapeie o campo com ResearchRabbit ou Connected Papers para que autores e agrupamentos relacionados fiquem visíveis.
- Extraia evidências com Elicit, NotebookLM ou um agente de pesquisa em notas estruturadas.
- Valide afirmações no Scite e nos PDFs originais antes que qualquer frase seja considerada citável.
- Redija e cite somente a partir do conjunto de notas verificadas.
Para o Academic Research Assistant da Jenova, a configuração é um briefing de pesquisa, não um tour de recursos:
- Abra o agente em jenova.ai/a/academic-research-assistant.
- Informe a pergunta, a disciplina e como será definido o resultado concluído:
“Estou escrevendo uma seção de métodos sobre taxas de erro de citações em LLMs. Priorize estudos revisados por pares e análises de editoras de 2023–2026. Para cada fonte, extraia amostra, definição de erro, taxa de alucinação e se humanos verificaram as referências.”
- Peça primeiro uma lista de candidatos, depois tabelas de extração e, por fim, prosa. Não pule diretamente para o rascunho.
- Mantenha os artigos rejeitados na mesma conversa para que o agente não os reintroduza posteriormente.
No Elicit, o ponto de partida equivalente é uma pergunta restrita e uma lista de colunas: população, intervenção, desfecho e tipo de estudo. No Scite, comece por um artigo ou afirmação conhecida e examine as citações favoráveis em comparação às contrastantes antes de escrever. Para um chatbot geral, o uso mais seguro é criar estruturas de texto e editar a linguagem depois que as fontes já existirem.
Duas regras operacionais evitam a maioria das falhas. Primeiro, nunca aceite uma citação que não possa ser aberta. Segundo, nunca deixe que o modelo de redação se torne o único registro do que um artigo disse. A nota verificada é a fonte de verdade. O rascunho é uma reorganização dessa nota.
Quando um chatbot de uso geral ainda é a melhor ferramenta acadêmica?
Um chatbot de uso geral ainda é a melhor ferramenta acadêmica quando a tarefa envolve linguagem, estrutura ou explicação, e não evidência. A confiabilidade depende do trabalho. A rastreabilidade de citações é o teste errado para um modelo de escrita, assim como a fluência em prosa é o teste errado para um índice de recuperação.
Chatbots continuam úteis para:
- Transformar uma estrutura verificada em prosa acadêmica mais clara
- Explicar um método que o pesquisador já leu
- Gerar strings de busca, contra-argumentos ou listas de verificação para revisão
- Traduzir trechos densos para linguagem mais simples em anotações, não para citação
Eles são um mecanismo ruim para a literatura primária. Trabalhos de classificação associados à Nature tratam afirmações de chatbots sem comprovação como um tipo distinto de alucinação, e orientações de bibliotecas repetem o mesmo alerta: citações fabricadas podem incluir um conjunto completo de autor, título e periódico. Esse modo de falha é caro em teses, propostas de financiamento e submissões a periódicos, nos quais uma referência inventada pode desacreditar uma argumentação que, de outro modo, seria cuidadosa.
Há também uma razão de fluxo de trabalho para manter chatbots na combinação de ferramentas. Ferramentas especializadas são mais restritas. O Elicit não vai trabalhar o ritmo de um parágrafo. O Scite não manterá uma conversa de orientação durante um semestre sobre um capítulo de tese. O ResearchRabbit não formatará o estilo de referências de um periódico. Um chatbot, ou um agente geral de redação, preenche essas lacunas depois que as evidências foram consolidadas.
A regra prática é o sequenciamento. Use primeiro a recuperação e a verificação especializadas. Use um modelo geral depois, e apenas em textos cujas fontes já existam em uma biblioteca que você possa abrir. Se um chatbot introduzir uma nova citação durante a revisão, trate essa citação como não confiável até que ela passe pelas mesmas verificações TRACE do restante do manuscrito.
O que especialistas em integridade de pesquisa dizem sobre citações de AI?
Especialistas em integridade de pesquisa tratam chatbots gerais como auxiliares de redação e sistemas especializados vinculados a fontes como a única camada aceitável para afirmações que serão citadas. O consenso não é evite a AI. É não deixe que um gerador sem fundamentação se torne o registro do que a literatura afirma.
“A falha que continuamos vendo não é que os modelos escrevem mal. É que eles escrevem bibliografias completas de artigos que não existem, ou de artigos reais que não contêm o resultado alegado. Quando essas strings entram em um rascunho, passam a se comportar como evidência. Revisores, coautores e ferramentas de citação posteriores podem propagá-las antes que alguém abra a fonte.”
“Um assistente especializado de pesquisa muda a unidade de trabalho. Em vez de pedir um parágrafo com citações, você pede uma afirmação, um trecho e uma classificação: sustentada, não sustentada, contradita ou insuficiente. Essa saída é mais lenta e menos elegante. Ela também é a única saída que uma seção de métodos pode defender.”
“A memória persistente de projetos importa mais do que as pessoas imaginam. Alucinações frequentemente voltam a entrar em um artigo durante a revisão, quando um chatbot geral recebe a instrução de adicionar fontes a uma seção que já estava limpa. Um assistente que lembra quais artigos foram excluídos, e por quê, está fazendo trabalho de integridade, não apenas de conveniência. Ainda assim, o PDF original permanece a autoridade.”
— Equipe de Produto da Jenova, fluxos de trabalho de pesquisa acadêmica, trabalho plurianual no design de agentes fundamentados em citações
Essa posição está alinhada às orientações de bibliotecários e de síntese de evidências. O King's College London aconselha usar AI como complemento, verificar direitos autorais antes de enviar textos completos e pressupor que ferramentas generativas ainda podem inventar referências e cabeçalhos de assunto. Análises em nível de editora agora tratam referências alucinadas como um problema de corpus, e não como algo anedótico. Um comentário de 2026, trabalhando a partir de uma análise da Nature de aproximadamente 4.000 publicações, observou que 65 dos 100 artigos mais suspeitos continham pelo menos uma referência inválida, um padrão que poderia implicar mais de 110.000 artigos afetados entre cerca de 7 milhões de publicações de 2025.
A implicação dos especialistas é operacional. Escolha ferramentas que tornem a verificação pouco custosa. Rejeite ferramentas que façam a verificação parecer desnecessária.
Referências
- Higher Education Policy Institute — Pesquisa estudantil sobre AI generativa 2025
- ERIC / U.S. Department of Education — Pesquisa estudantil sobre AI generativa 2025, Nota de Política 61 do HEPI
- Boretti, Energy Research & Social Science — Alucinações em AI generativa e integridade acadêmica
- Wikipedia — Alucinação, inteligência artificial
- McGoogan Library da University of Nebraska Medical Center — Alucinações de AI com citações
- Science / AAAS — Por que modelos de AI alucinam em vez de admitir incerteza
- LlamaIndex — Extração fundamentada em citações
- Guia da biblioteca do King's College London — Ferramentas de AI na síntese de evidências
- Elicit — AI para pesquisa científica
- Scite — Pesquisa apoiada por citações e Smart Citations
- ResearchRabbit — Mapeamento de literatura e redes de citações
- newline — Benchmarks para verificar referências científicas produzidas por LLMs
- Paperguide — Comparação de ferramentas de AI para pesquisa acadêmica, 2026
- arXiv — SemanticCite: verificação de citações com análise de texto completo
- Nature Humanities and Social Sciences Communications — Classificação de alucinação de AI