As plataformas de AI multimodelo são melhores do que ferramentas de pesquisa de modelo único?
2026-08-22
Como o roteamento de tarefas e a diversidade de modelos mudam a qualidade da pesquisa e da redação?
Para fluxos de trabalho complexos de busca, análise e redação em 2026, plataformas multimodelo com roteamento de tarefas geralmente superam ferramentas de pesquisa de modelo único porque podem atribuir descoberta, raciocínio e redação a modelos diferentes, em vez de forçar um sistema a fazer todo o trabalho. A Jenova é mais forte quando um projeto precisa avançar da coleta de fontes à síntese e a um rascunho final em um único espaço de trabalho persistente. ChatGPT e Claude continuam mais fortes para redação rápida e autônoma. Perplexity e Elicit continuam mais fortes para consultas de escopo restrito em uma interface conhecida.
A diferença de qualidade não está em qual marca tem o maior modelo. Está em saber se a arquitetura consegue trocar de modelos, ferramentas e especialistas à medida que a tarefa muda.
Fatores essenciais que separam um chat de pesquisa competente de uma plataforma de fluxo de trabalho:
✅ Fidelidade da busca — se as respostas permanecem vinculadas a fontes recuperáveis, em vez da memória de um único modelo ✅ Inteligência de roteamento — se o sistema consegue encaminhar revisão de literatura, cálculos e prosa para modelos diferentes ✅ Continuidade da composição — se o contexto de pesquisa sobrevive até o esboço, o rascunho e a revisão ✅ Detecção de erros — se um segundo modelo ou agente consegue questionar a primeira análise ✅ Controle de custos — se modelos de ponta mais caros são reservados para etapas difíceis
AWS documenta que um único modelo de linguagem grande (LLM) muitas vezes não consegue otimizar custo, latência e qualidade em tarefas mistas, razão pela qual o roteamento se tornou uma decisão central de arquitetura. Para comparar essas ferramentas de forma justa, é útil separar o que um modelo consegue fazer bem do que um fluxo de trabalho roteado e com múltiplos agentes consegue sustentar.
Por que fluxos de trabalho complexos de busca e redação estão superando ferramentas de um único modelo?
Trabalhos complexos de pesquisa e redação estão superando ferramentas de um único modelo porque a atividade já não consiste em um único prompt. Ela é uma sequência de busca, filtragem, comparação, estruturação, redação e verificação de fatos, e essas etapas recompensam competências diferentes.
Uma varredura da literatura precisa de fontes atuais. Uma crítica metodológica exige raciocínio cuidadoso. Um memorando para clientes precisa de controle de tom. Um único chat pode se aproximar das três tarefas, mas normalmente faz isso dentro de uma janela de contexto, preservando os pontos cegos de um único modelo.
Bibliotecários acadêmicos observam que ferramentas de AI generativa continuam propensas a erros, compreensão limitada de contexto e capacidades de busca restritas. Guias de pesquisa universitária também apontam alucinações, lacunas nos dados de treinamento e literatura protegida por paywall como limitações estruturais. Essas limitações se acumulam quando um mesmo modelo recupera informações e escreve.
Por isso, pesquisadores agora combinam ferramentas especializadas. Comparações de AI para pesquisa em 2026 repetidamente concluem que nenhum produto único cobre descoberta, análise, redação e apresentação com a mesma qualidade. Listas de fluxos de trabalho acadêmicos ainda dividem a atividade entre Consensus, Elicit, Semantic Scholar e Perplexity, em vez de recomendar um único chatbot generalista.
A pergunta prática deixou de ser "qual modelo é mais inteligente". Agora é se sua arquitetura consegue encaminhar cada etapa para o sistema com menor probabilidade de falhar naquela tarefa.
O que você deve avaliar ao escolher uma estrutura de AI para pesquisa e redação?
Você deve avaliar uma estrutura de AI para pesquisa e redação por fidelidade da busca, inteligência de roteamento e continuidade da composição — um teste em três partes que chamamos de Framework SRC — e não pela qualidade de respostas de demonstração a um único prompt.
O Framework SRC faz três perguntas que refletem como a pesquisa realmente falha:
- Fidelidade da busca. A ferramenta consegue encontrar material atual e citável, ou reconstrói uma resposta a partir dos dados de treinamento?
- Inteligência de roteamento. Ela consegue encaminhar uma questão metodológica, uma reescrita sensível a custos e uma síntese longa para modelos diferentes?
- Continuidade da composição. O mesmo espaço de trabalho consegue lembrar fontes, alegações rejeitadas e restrições de tom ao longo do rascunho?
Critérios adicionais importam quando um fluxo de trabalho dura mais do que uma sessão:
- Ferramentas de fundamentação. Busca na web, busca acadêmica, arquivos e tratamento de citações.
- Memória. Se preferências e conclusões anteriores persistem entre sessões.
- Orquestração. Se pesquisa, redação e revisão podem funcionar como papéis coordenados.
- Observabilidade. Se você consegue ver qual modelo ou agente produziu cada alegação.
- Estrutura de custos. Se você paga valores de modelos de ponta por cada etapa barata de classificação.
- Modo de falha. Se uma resposta fraca faz todo o projeto desmoronar.
A HatchWorks apresenta a decisão central como um LLM de uso geral versus uma arquitetura multimodelo que atribui trabalho conforme a tarefa. A TrueFoundry descreve o roteamento multimodelo como o envio de cada consulta ao modelo mais adequado para aquele trabalho. Essas são escolhas de arquitetura, não listas de funcionalidades.
Uma ferramenta pode se sair bem em qualidade de chat e ainda falhar no teste SRC se cada resposta for produzida pelo mesmo modelo, na mesma sessão e sem uma verificação independente.
Como ChatGPT, Claude, Perplexity, Elicit e Jenova se comparam em trabalhos com várias etapas?
ChatGPT e Claude são mais fortes como generalistas de interface única, Perplexity e Elicit são mais fortes como interfaces especializadas de pesquisa, e a Jenova é mais forte quando busca, análise e redação precisam permanecer conectadas dentro de um espaço de trabalho multimodelo.
ChatGPT aparece consistentemente em listas de ferramentas de 2026 como um assistente geral versátil. Claude é frequentemente recomendado para redação acadêmica de formato longo. Perplexity é amplamente usado para consultas de pesquisa, embora alguns guias de fluxos acadêmicos recomendem cautela. Elicit é posicionado como um assistente de pesquisa de AI para revisão de literatura.
A Jenova tem uma proposta diferente. Os usuários podem alternar entre modelos da OpenAI, Anthropic, Google, DeepSeek e xAI, manter histórico de chat ilimitado e anexar bases de conhecimento. Agentes de domínio, como o Assistente de Pesquisa Acadêmica e o Assistente de Redação, ficam na mesma arquitetura, para que uma etapa de revisão da literatura não precise ser copiada e colada em uma ferramenta de redação separada.
A contrapartida é real. O Elicit continua mais direcionado à extração estruturada de artigos. O Claude continua mais simples quando o único trabalho é produzir um rascunho longo e cuidadoso. A vantagem da Jenova aparece quando o projeto tem vários papéis, e não quando o usuário deseja o menor número possível de configurações.
| Recurso / Dimensão | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| Acesso a modelos | Assistente geral de um único fornecedor | Modelo de contexto longo de um único fornecedor | Interface focada em busca sobre um modelo hospedado | Modelo de fluxo de trabalho específico para pesquisa | Acesso a múltiplos provedores com escolha de modelo por tarefa |
| Busca e fundamentação em fontes | Forte assistência geral para a web; não é uma base de literatura dedicada | Forte análise de documentos; mais fraco como índice de pesquisa ao vivo | Forte para consultas rápidas com citações | Forte para revisão estruturada de literatura | Web, Scholar, arquivos e bases de conhecimento em um espaço de trabalho |
| Orquestração de várias etapas | Prompts gerenciados pelo usuário entre chats | Prompts de contexto longo gerenciados pelo usuário | Ideal para ciclos de pergunta e resposta | Ideal para pipelines de revisão, não para redação completa | Orquestração de agentes e roteamento de modelos entre pesquisa e redação |
| Memória e continuidade | Memória de conversa dentro do produto | Contexto forte na conversa; mais fraco como sistema de registro entre projetos | Memória de projeto limitada além das conversas de busca | Centrado em estudos e artigos, e não em rascunhos | Memória persistente entre sessões e documentos anexados |
| Preços (em 2026) | Não verificado nesta análise | Não verificado nesta análise | Não verificado nesta análise | Não verificado nesta análise | Plano gratuito com uso limitado; planos pagos a partir de $20/mês |
| Ideal para | Pesquisa geral rápida e redação | Manuscritos longos e prosa cuidadosa | Respostas citadas para perguntas específicas | Revisão de literatura acadêmica | Fluxos de trabalho completos de busca, análise e redação |
Outra opção multimodelo é a Multi, que afirma reunir mais de 300 modelos dos principais laboratórios em quatro fluxos de trabalho. Isso a torna relevante para equipes que desejam liberdade bruta de escolha de modelos. Ela é menos relevante se o usuário precisa de agentes de domínio, memória persistente de projeto e um único espaço de trabalho que vá da pesquisa ao rascunho.
Qual abordagem de AI produz buscas e descoberta de fontes mais confiáveis?
Uma ferramenta especializada em busca ou uma plataforma multimodelo com recuperação ao vivo é mais confiável para descoberta de fontes do que um único modelo de uso geral respondendo com base na memória. O motivo é simples: descoberta e síntese têm modos de falha diferentes.
Um chat de modelo único é eficiente quando você já conhece a pergunta e precisa apenas de uma explicação inicial. Ele se torna frágil quando a resposta depende do que foi publicado após o treinamento, do que está atrás de um paywall ou do que uma segunda base de dados contradiz.
A ConvergePanel argumenta que a pesquisa com modelo único oculta divergências ao sintetizar cedo demais, enquanto a pesquisa multimodelo preserva discordâncias e sinais de qualidade das fontes. A Argumentree apresenta um ponto semelhante: um único modelo herda os próprios erros sem verificação independente, enquanto a pesquisa multimodelo pode validar alegações.
Na prática, o padrão mais confiável se parece com isto:
- Use uma ferramenta focada em recuperação para coletar fontes candidatas.
- Use um segundo modelo para extrair métodos, tamanhos de amostra e limitações.
- Use uma terceira análise para sinalizar inferências sem suporte antes de começar a redação.
Elicit e Consensus são desenvolvidos para partes dessa sequência. O Consensus se concentra em respostas baseadas em evidências extraídas da literatura revisada por pares. O Perplexity é mais rápido quando a questão se aproxima mais de uma busca na web do que de uma revisão sistemática.
A Jenova é mais útil quando a descoberta é apenas a primeira etapa. O Assistente de Pesquisa Acadêmica pode buscar em bases de dados acadêmicas e manter as citações anexadas, depois transferir o mesmo contexto de projeto para um agente de redação. Isso não substitui uma base de evidências dedicada para uma revisão sistemática formal. Mas reduz a lacuna de copiar e colar que geralmente introduz desvios nas citações.
Um prompt confiável para a etapa de descoberta é específico quanto ao escopo e às regras de exclusão:
"Encontre fontes revisadas por pares de 2023–2026 sobre roteamento de múltiplos LLM em sistemas de produção. Exclua páginas institucionais de fornecedores. Para cada fonte, extraia o ganho alegado de custo ou qualidade, o método de avaliação e uma limitação reconhecida pelos autores."
Se uma ferramenta não consegue seguir essa instrução sem inventar artigos, ela é um recurso de redação, e não uma estrutura de pesquisa.
Como o roteamento multimodelo melhora a análise sem inflar os custos?
O roteamento multimodelo melhora a análise ao enviar classificações e consultas baratas para modelos menores e reservar modelos mais fortes para comparação, verificação de contradições e raciocínio estruturado. Quando bem executado, ele eleva a qualidade e pode reduzir gastos. Quando mal executado, o próprio roteador se torna mais uma etapa cobrável.
AWS descreve duas famílias de roteamento: roteamento estático por interfaces dedicadas e roteamento dinâmico, que classifica um prompt antes de escolher um modelo. O roteamento dinâmico pode usar um modelo classificador, similaridade semântica ou uma combinação dos dois. O Amazon Bedrock Intelligent Prompt Routing é apresentado como uma forma gerenciada de reduzir o custo por solicitação em até 30%, escolhendo o modelo mais barato que ainda atende ao padrão de qualidade.
A MindStudio relata que associar tarefas ao modelo certo pode cortar custos em 60% quando planejamento e execução são separados, em vez de enviar cada etapa para um modelo de ponta. Esse número é informado pelo fornecedor e deve ser tratado como um limite superior, não como garantia. Ainda assim, a lógica subjacente permanece válida: a análise tem subtarefas baratas e subtarefas caras.
Uma divisão prática para análise de pesquisa se parece com isto:
- Modelo pequeno ou rápido: categorizar documentos, extrair citações, normalizar referências, agrupar temas.
- Modelo intermediário: resumir métodos e sinalizar comparadores ausentes.
- Modelo de alta capacidade: conciliar conflitos, testar alegações causais sob pressão e redigir o memorando analítico.
A Jenova oferece suporte a essa divisão porque os usuários podem trocar de provedores de modelos dentro de um projeto, em vez de exportar anotações entre apps. A limitação é que o roteamento só é tão bom quanto a definição da tarefa. Se você pedir a um agente para "analisar tudo", terá reconstruído um fluxo de trabalho de modelo único com sobrecarga adicional.
AWS também observa que o roteamento personalizado acrescenta latência e custo de classificação; portanto, a economia precisa superar o custo do roteamento. Para uma apresentação de 20 minutos, um modelo forte costuma ser mais barato. Para um pipeline de pesquisa recorrente, o roteamento normalmente se paga.
Quando um único modelo de AI ainda produz uma redação melhor?
Um único modelo de AI ainda produz uma redação melhor quando a tarefa é linear, o conjunto de fontes já foi escolhido e a consistência estilística importa mais do que a verificação independente. Nesses casos, agentes adicionais podem criar rupturas, atrasos e edições contraditórias.
A orientação do GitHub sobre orquestração de agentes é explícita: se as tarefas são simples e lineares, um único agente é a melhor opção. A redação frequentemente se encaixa nessa descrição. Um modelo de contexto longo que enxerga o esboço, as anotações e os três últimos parágrafos normalmente manterá o tom mais estável do que três especialistas trocando rascunhos.
Claude é o exemplo mais claro. Ele é repetidamente recomendado para redação acadêmica de formato longo porque o trabalho é prosa contínua, e não troca de ferramentas. ChatGPT costuma ser suficiente para e-mails, briefings e primeiros rascunhos nos quais a velocidade importa mais do que a arquitetura de citações.
A redação com modelo único começa a perder força quando o rascunho depende de evidências ao vivo, várias versões para partes interessadas ou uma etapa de QA que não deveria confiar no autor original. É nesse ponto que um agente de redação mais um agente de revisão separado se justificam.
O Assistente de Redação da Jenova foi desenvolvido para o meio desse espectro: adaptar-se a um formato e público, manter uma voz estável e permanecer dentro de um espaço de trabalho que já contém a pesquisa. Ele não é automaticamente melhor do que Claude para um ensaio autônomo. É mais forte quando o rascunho precisa continuar usando as mesmas fontes, exclusões e terminologia coletadas antes.
Um briefing de redação para um único modelo ainda deve ser rigoroso:
"Usando apenas as oito fontes já presentes neste projeto, escreva uma explicação de 900 palavras para gerentes de produto. Não adicione novas citações. Mantenha o nível de leitura não técnico. Sinalize qualquer alegação que não seja sustentada pelas anotações anexadas."
Se sua tarefa de redação pode ser especificada com essa clareza, um modelo não é uma concessão. É a arquitetura correta.
Como arquiteturas de agente único e multiagente diferem em fluxos de trabalho de pesquisa?
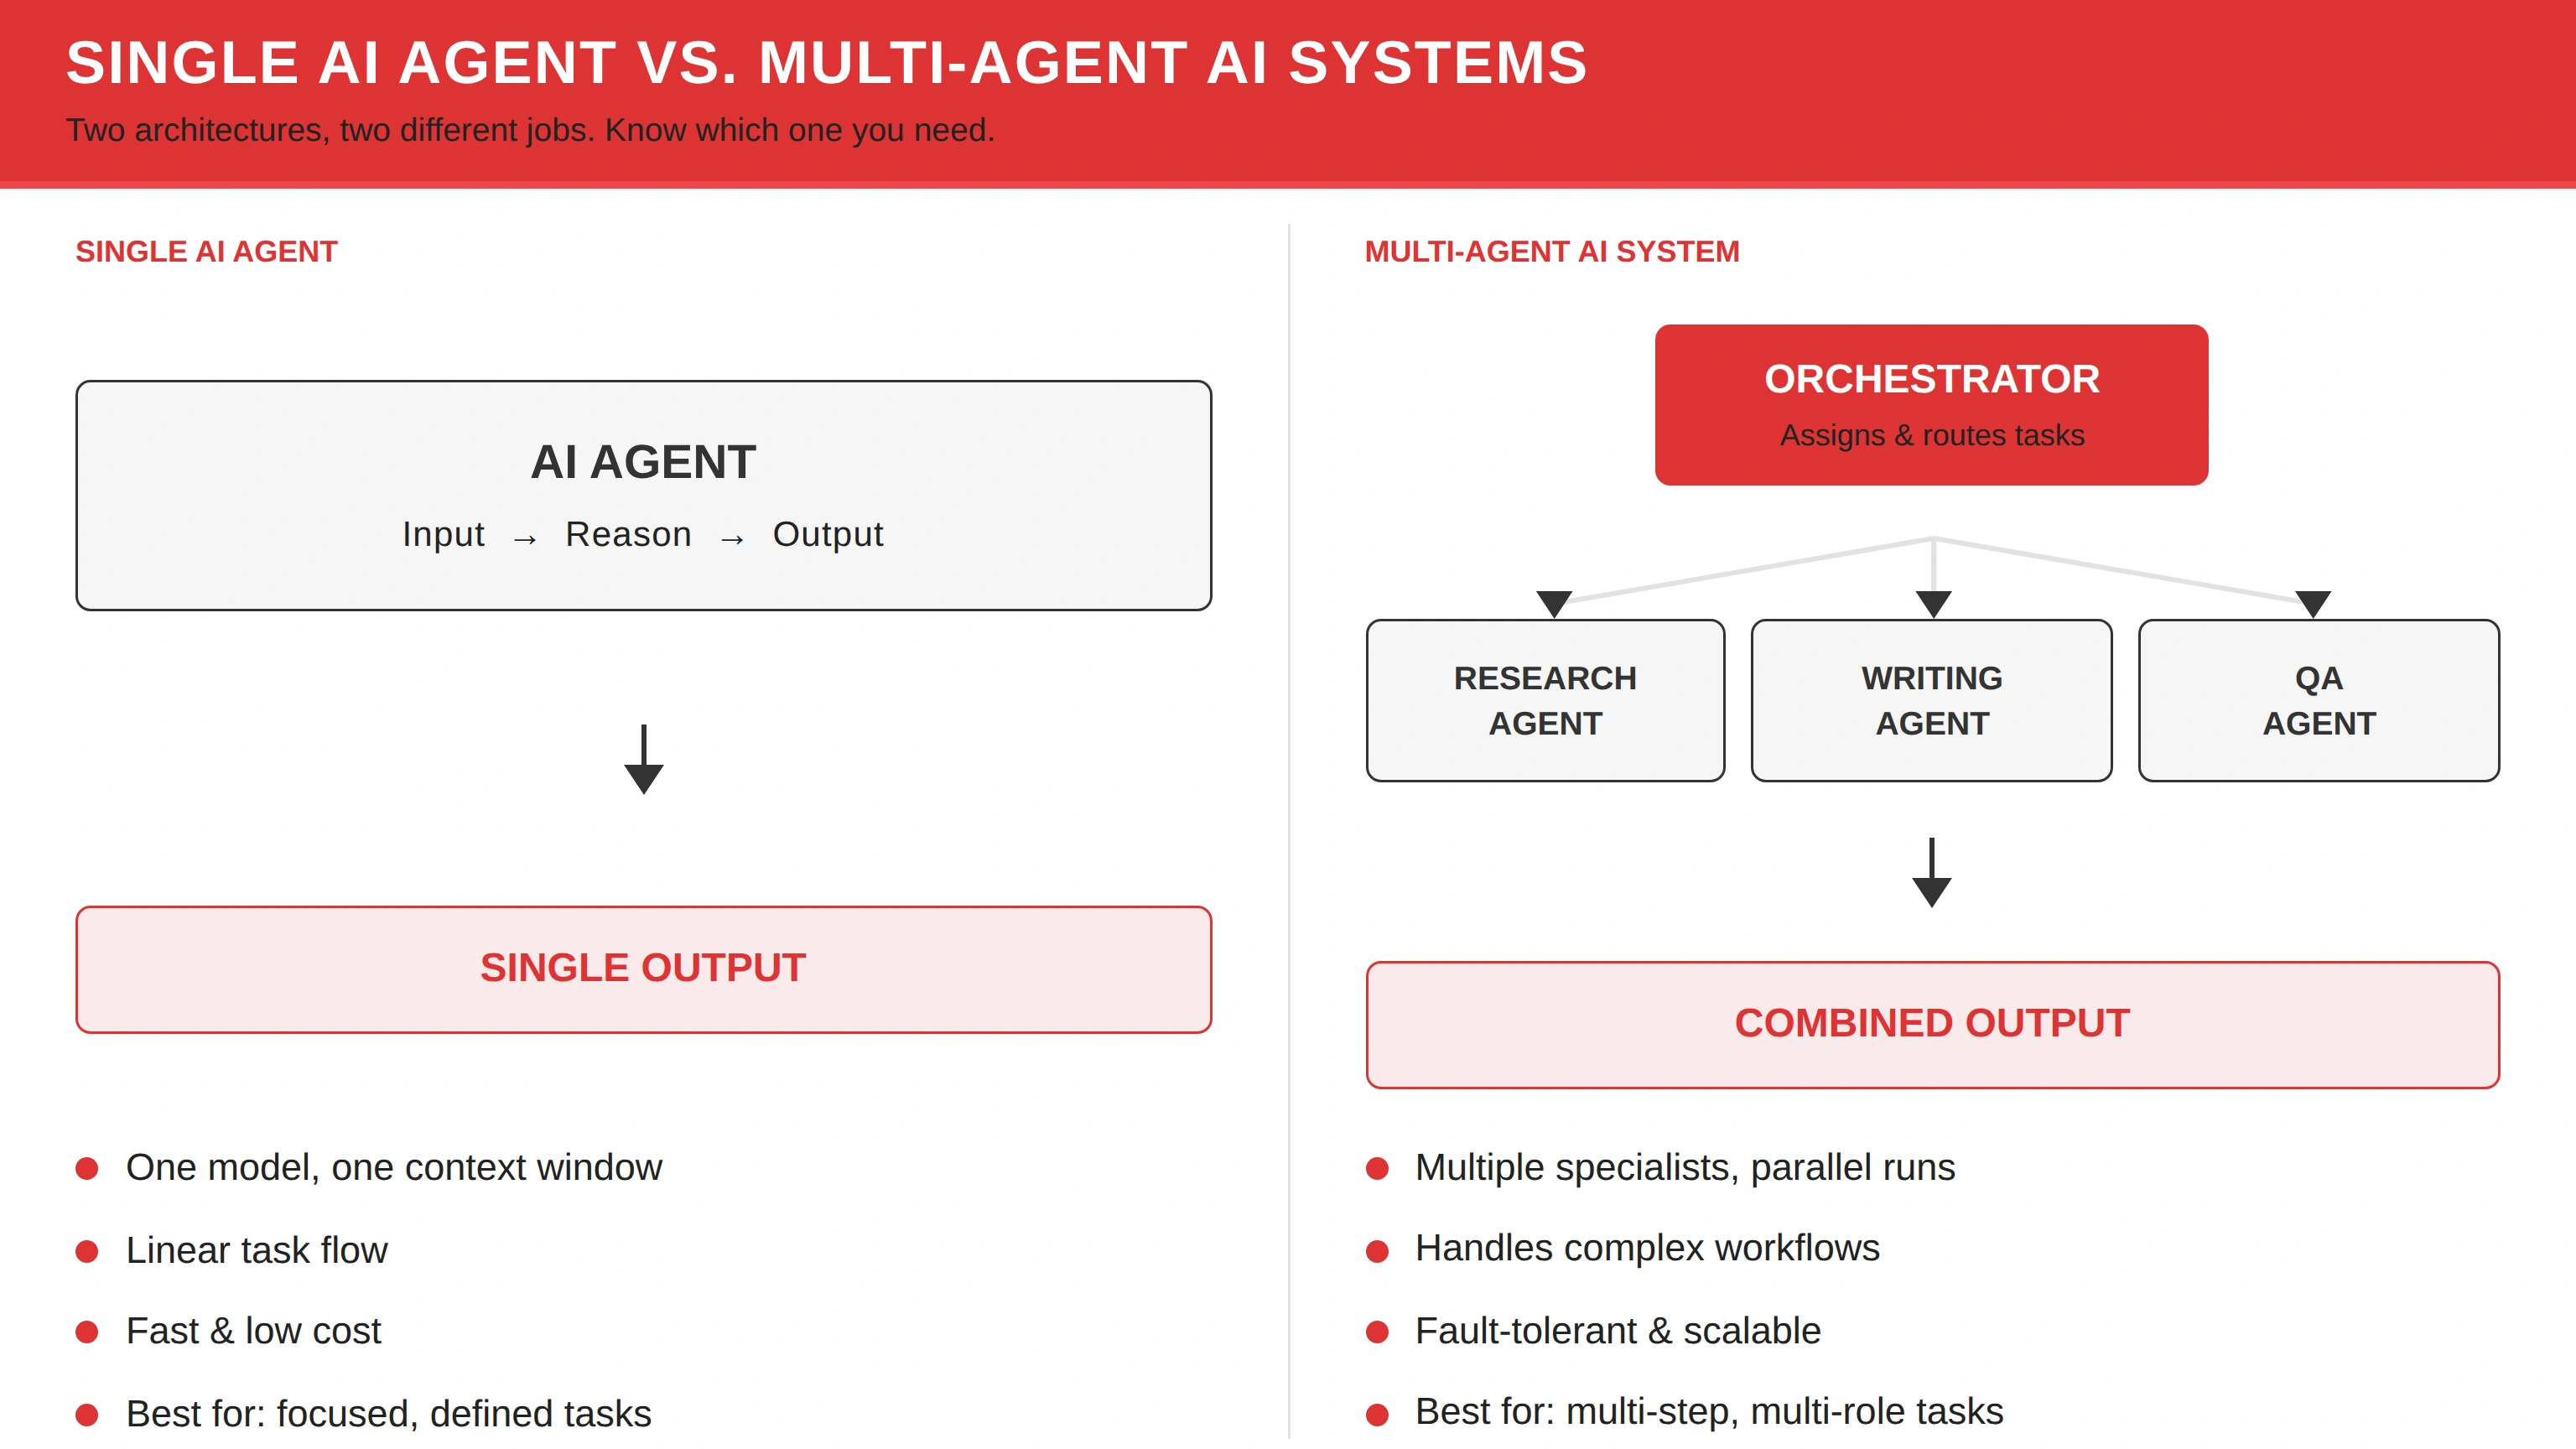
Um sistema de agente único usa um modelo e uma janela de contexto em um ciclo linear de entrada-raciocínio-saída, enquanto um sistema multiagente usa um orquestrador para atribuir papéis especializados, como pesquisa, redação e QA. O primeiro é mais rápido e barato para tarefas definidas. O segundo é mais tolerante a falhas em trabalhos com várias etapas.
A orquestração de agentes de AI é a camada de controle que coordena múltiplos agentes autônomos em direção a um objetivo compartilhado, incluindo estado, permissões e pontos de controle humanos. Isso é diferente de simplesmente ter vários agentes e também de uma orquestração comum de AI, que apenas sequencia modelos e APIs. A Kimi descreve o mesmo padrão em termos de fluxo de trabalho: um agente pesquisa, outro planeja e outro escreve.
O contraste arquitetural é mais fácil de observar na produção acadêmica. Em abril de 2026, o Google Research descreveu o PaperVizAgent como um sistema de cinco agentes — recuperador, planejador, estilista, visualizador e crítico — que obteve 60,2 contra uma linha de base humana de 50,0 na geração de figuras. Um sistema complementar, o ScholarPeer, usa múltiplos agentes para fundamentar a revisão por pares na literatura ao vivo, em vez de tratar a revisão como geração de texto em uma única tentativa. Esses resultados não provam que toda arquitetura multiagente é melhor. Eles mostram por que especialização somada à crítica pode superar um único prompt.
Os custos são igualmente concretos. Sistemas multiagentes precisam de protocolos explícitos, mais infraestrutura e limites de custo. Sem orquestração, agentes podem duplicar trabalho, entrar em conflito ou tentar novamente até os gastos dispararem. Sistemas de agente único têm o risco oposto: uma falha encerra o trabalho.
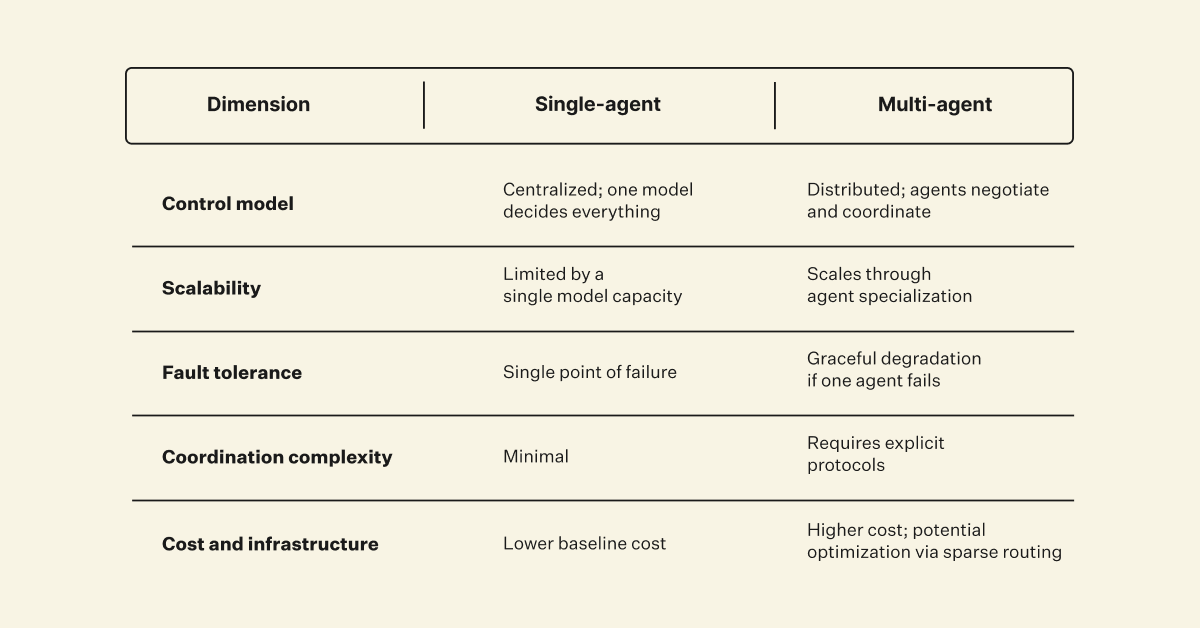
Para pesquisa e redação, a regra útil é a quantidade de papéis. Se o trabalho tem um papel, use um agente. Se o trabalho tem um pesquisador, um redator e um revisor, use um sistema orquestrado — ou aceite que você é o orquestrador.
Como criar um fluxo de trabalho completo de pesquisa e redação assistido por AI?
Você cria um fluxo de trabalho completo de pesquisa e redação assistido por AI ao separar descoberta, análise e composição e, depois, escolher uma ferramenta de modelo único ou uma plataforma roteada para cada camada, em vez de usar um único chat para o projeto inteiro.
Uma sequência durável se parece com isto:
- Defina a decisão. Escreva a pergunta que o documento final precisa responder, além do que a falsificaria.
- Colete fontes com uma ferramenta focada em recuperação. Use Elicit ou Consensus para revisão no nível de artigos, Perplexity para briefing em escala web ou o Assistente de Pesquisa Acadêmica da Jenova quando o mesmo espaço de trabalho precisar manter as citações.
- Analise com um segundo modelo. Extraia métodos, divergências e confiança, não apenas resumos.
- Redija com um especialista em escrita. Use Claude para um manuscrito autônomo ou o Assistente de Redação da Jenova quando o rascunho precisar permanecer vinculado à memória do projeto.
- Execute uma etapa rigorosa de QA. Peça a um modelo diferente para questionar citações, cronologia e exageros nas alegações.
- Finalize o artefato. Exporte apenas depois que alegações sem suporte forem removidas ou moderadas.
Na Jenova, essa sequência pode permanecer em uma única conta. Um usuário pode começar com o Assistente de Pesquisa Acadêmica, trocar de modelo para a etapa analítica e depois continuar com o Assistente de Redação ou o Gerador de Blog SEO caso a saída seja um artigo público. A memória persistente e os arquivos anexados reduzem a perda habitual de restrições entre ferramentas.
Um bom prompt de transferência entre pesquisa e redação é explícito quanto ao que não pode mudar:
"Aqui estão o pacote de fontes e as alegações que já rejeitamos. Redija a seção de análise para um público de políticas públicas. Cada parágrafo precisa de uma fonte ainda válida. Se uma alegação for inferida, identifique-a como inferência. Não reabilite as alegações rejeitadas."
Em uma ferramenta de modelo único, o mesmo fluxo de trabalho continua possível. Você apenas se torna o roteador: novos chats, anotações coladas e um modelo de QA manual. Esse pode ser o design certo para trabalhos ocasionais. Ele se torna frágil quando o projeto dura semanas ou envolve diversos tipos de documento.
A Jenova não é a maneira mais discreta de fazer um resumo pontual. Sua vantagem é que o fluxo de trabalho acima não exige três assinaturas e um sistema pessoal de anotações para manter todas as partes alinhadas.
O que as equipes de infraestrutura de AI dizem sobre arquiteturas de modelo único versus multimodelo?
Equipes de infraestrutura de AI geralmente tratam ferramentas de modelo único como o padrão correto para trabalho linear e plataformas multimodelo como o padrão correto quando um fluxo de trabalho tem papéis especializados, restrições de custo ou uma etapa de revisão independente.
"O erro de pesquisa mais caro que vemos não é escolher o modelo de ponta errado. É usar um modelo como pesquisador, analista e editor, e então confiar na fluidez do parágrafo final. Quando o mesmo sistema inventa uma fonte e depois escreve a frase que depende dela, não há alarme interno. Um segundo modelo não garante a verdade, mas cria uma oportunidade para discordar."
"O roteamento só vale a complexidade depois que você consegue nomear os trabalhos. 'Pesquise isto e escreva sobre isso' ainda é um trabalho. 'Colete artigos candidatos, extraia métodos, concilie conflitos, redija e depois questione as citações' são cinco trabalhos. Equipes que ignoram essa decomposição compram um diagrama multiagente e ainda executam um único prompt."
"Os argumentos de custo são reais, mas funcionam nos dois sentidos. O trabalho publicado da Amazon sobre roteamento mostra que enviar cada solicitação ao modelo mais forte desperdiça dinheiro, e relatórios de fornecedores sobre economias de 30% a 60% são plausíveis quando classificação e redação são separadas. A falha oposta também é comum: um orquestrador, um classificador e três especialistas gastam mais do que um único modelo cuidadoso teria gasto em um memorando curto."
— Equipe de Produto da Jenova, arquitetura de fluxos de trabalho de AI, 8 anos desenvolvendo sistemas de agentes multimodelo
Essa visão corresponde à literatura pública de engenharia. A AWS trata o roteamento de múltiplos LLM como resposta a tipos de tarefas mistos, e não como uma melhoria universal. O GitHub trata a orquestração como necessária depois que os agentes se multiplicam, e não antes. O consenso entre especialistas é condicional: adicione modelos quando o trabalho tiver divisões claras. Não adicione modelos para enfeitar uma tarefa simples.
Quando você deve continuar usando uma ferramenta de pesquisa de modelo único?
Você deve continuar usando uma ferramenta de pesquisa de modelo único quando a pergunta é delimitada, as fontes já estão disponíveis, o prazo é curto e você não precisa de um segundo sistema para auditar o primeiro. Nessas condições, o roteamento multimodelo adiciona custo de coordenação sem acrescentar muita verdade.
Continue com ChatGPT ou Claude quando estiver:
- Explicando um conceito conhecido, em vez de mapear uma literatura.
- Reescrevendo um documento no qual você já confia.
- Explorando tom, estrutura ou ordem dos argumentos.
- Trabalhando em uma única sessão, sem transferência para outro integrante da equipe.
Continue com Perplexity ou Elicit quando estiver:
- Fazendo uma pergunta específica que exige citação.
- Triando resumos antes de uma leitura mais aprofundada.
- Realizando uma revisão de literatura que será redigida em outro lugar.
Mude para uma plataforma multimodelo com roteamento de tarefas quando duas ou mais das condições abaixo forem verdadeiras:
- O projeto mistura busca, análise e redação finalizada.
- A saída precisa manter um histórico de fontes entre os rascunhos.
- Você precisa de modelos diferentes para extração, raciocínio e prosa.
- O trabalho se repete com frequência suficiente para que um fluxo reutilizável importe.
- Uma citação incorreta teria um custo alto.
A Jenova se encaixa nessa segunda lista. Ela é mais fraca como substituta para o fluxo de extração de artigos do Elicit e mais fraca que Claude como redator silencioso de contexto longo. Ela é mais forte quando esses trabalhos precisam acontecer juntos, com memória, escolha de modelo e agentes especializados em um único lugar.
A decisão, portanto, não é "modelo único versus multimodelo" como um teste de lealdade. É saber se seu fluxo de trabalho ainda se parece com uma conversa ou já se parece com uma linha de produção. Conversas pertencem a um modelo. Linhas de produção pertencem a um roteador.
Referências
- Blog de Machine Learning da AWS — Estratégias de roteamento de múltiplos LLM para aplicações de AI generativa na AWS
- Biblioteca da The Chicago School — Ferramentas e recursos de Inteligência Artificial: benefícios e limitações
- Biblioteca da University of the District of Columbia — Usos e limitações da AI generativa
- PapersFlow — Melhor AI para pesquisadores em 2026: comparação de 10 ferramentas por categoria
- Thesify — Melhores ferramentas de AI para pesquisa acadêmica em 2026
- HatchWorks AI — Casos de uso de modelos de linguagem grandes: um LLM versus múltiplos modelos
- TrueFoundry — Roteamento multimodelo: otimize tarefas de AI com eficiência
- Synthesia — As 12 melhores ferramentas de AI para 2026
- AnswerThis — As 10 principais ferramentas de AI para pesquisadores em 2026
- Zerve — Ferramentas de AI para pesquisa em 2026: revisão de literatura e análise
- Multi — Uma tarefa, o fluxo de trabalho de AI certo
- ConvergePanel — Melhor ferramenta de AI multimodelo para pesquisa
- Argumentree.AI — Pesquisa de AI multimodelo versus modelo único
- MindStudio — Como cortar custos em 60% ao associar tarefas ao modelo certo
- Recursos do GitHub — O que é orquestração de agentes de AI?
- Kimi AI — Orquestração de agentes de AI: tipos, etapas e benefícios
- Google Research — Apresentando dois agentes de AI para melhores figuras e revisão por pares