Os Espaços de Trabalho de Pesquisa com AI São Melhores para o Mapeamento Sistemático de Evidências?
2026-08-22
Como o Estado Persistente do Projeto e a Recuperação de Trechos sob Demanda se Diferenciam?
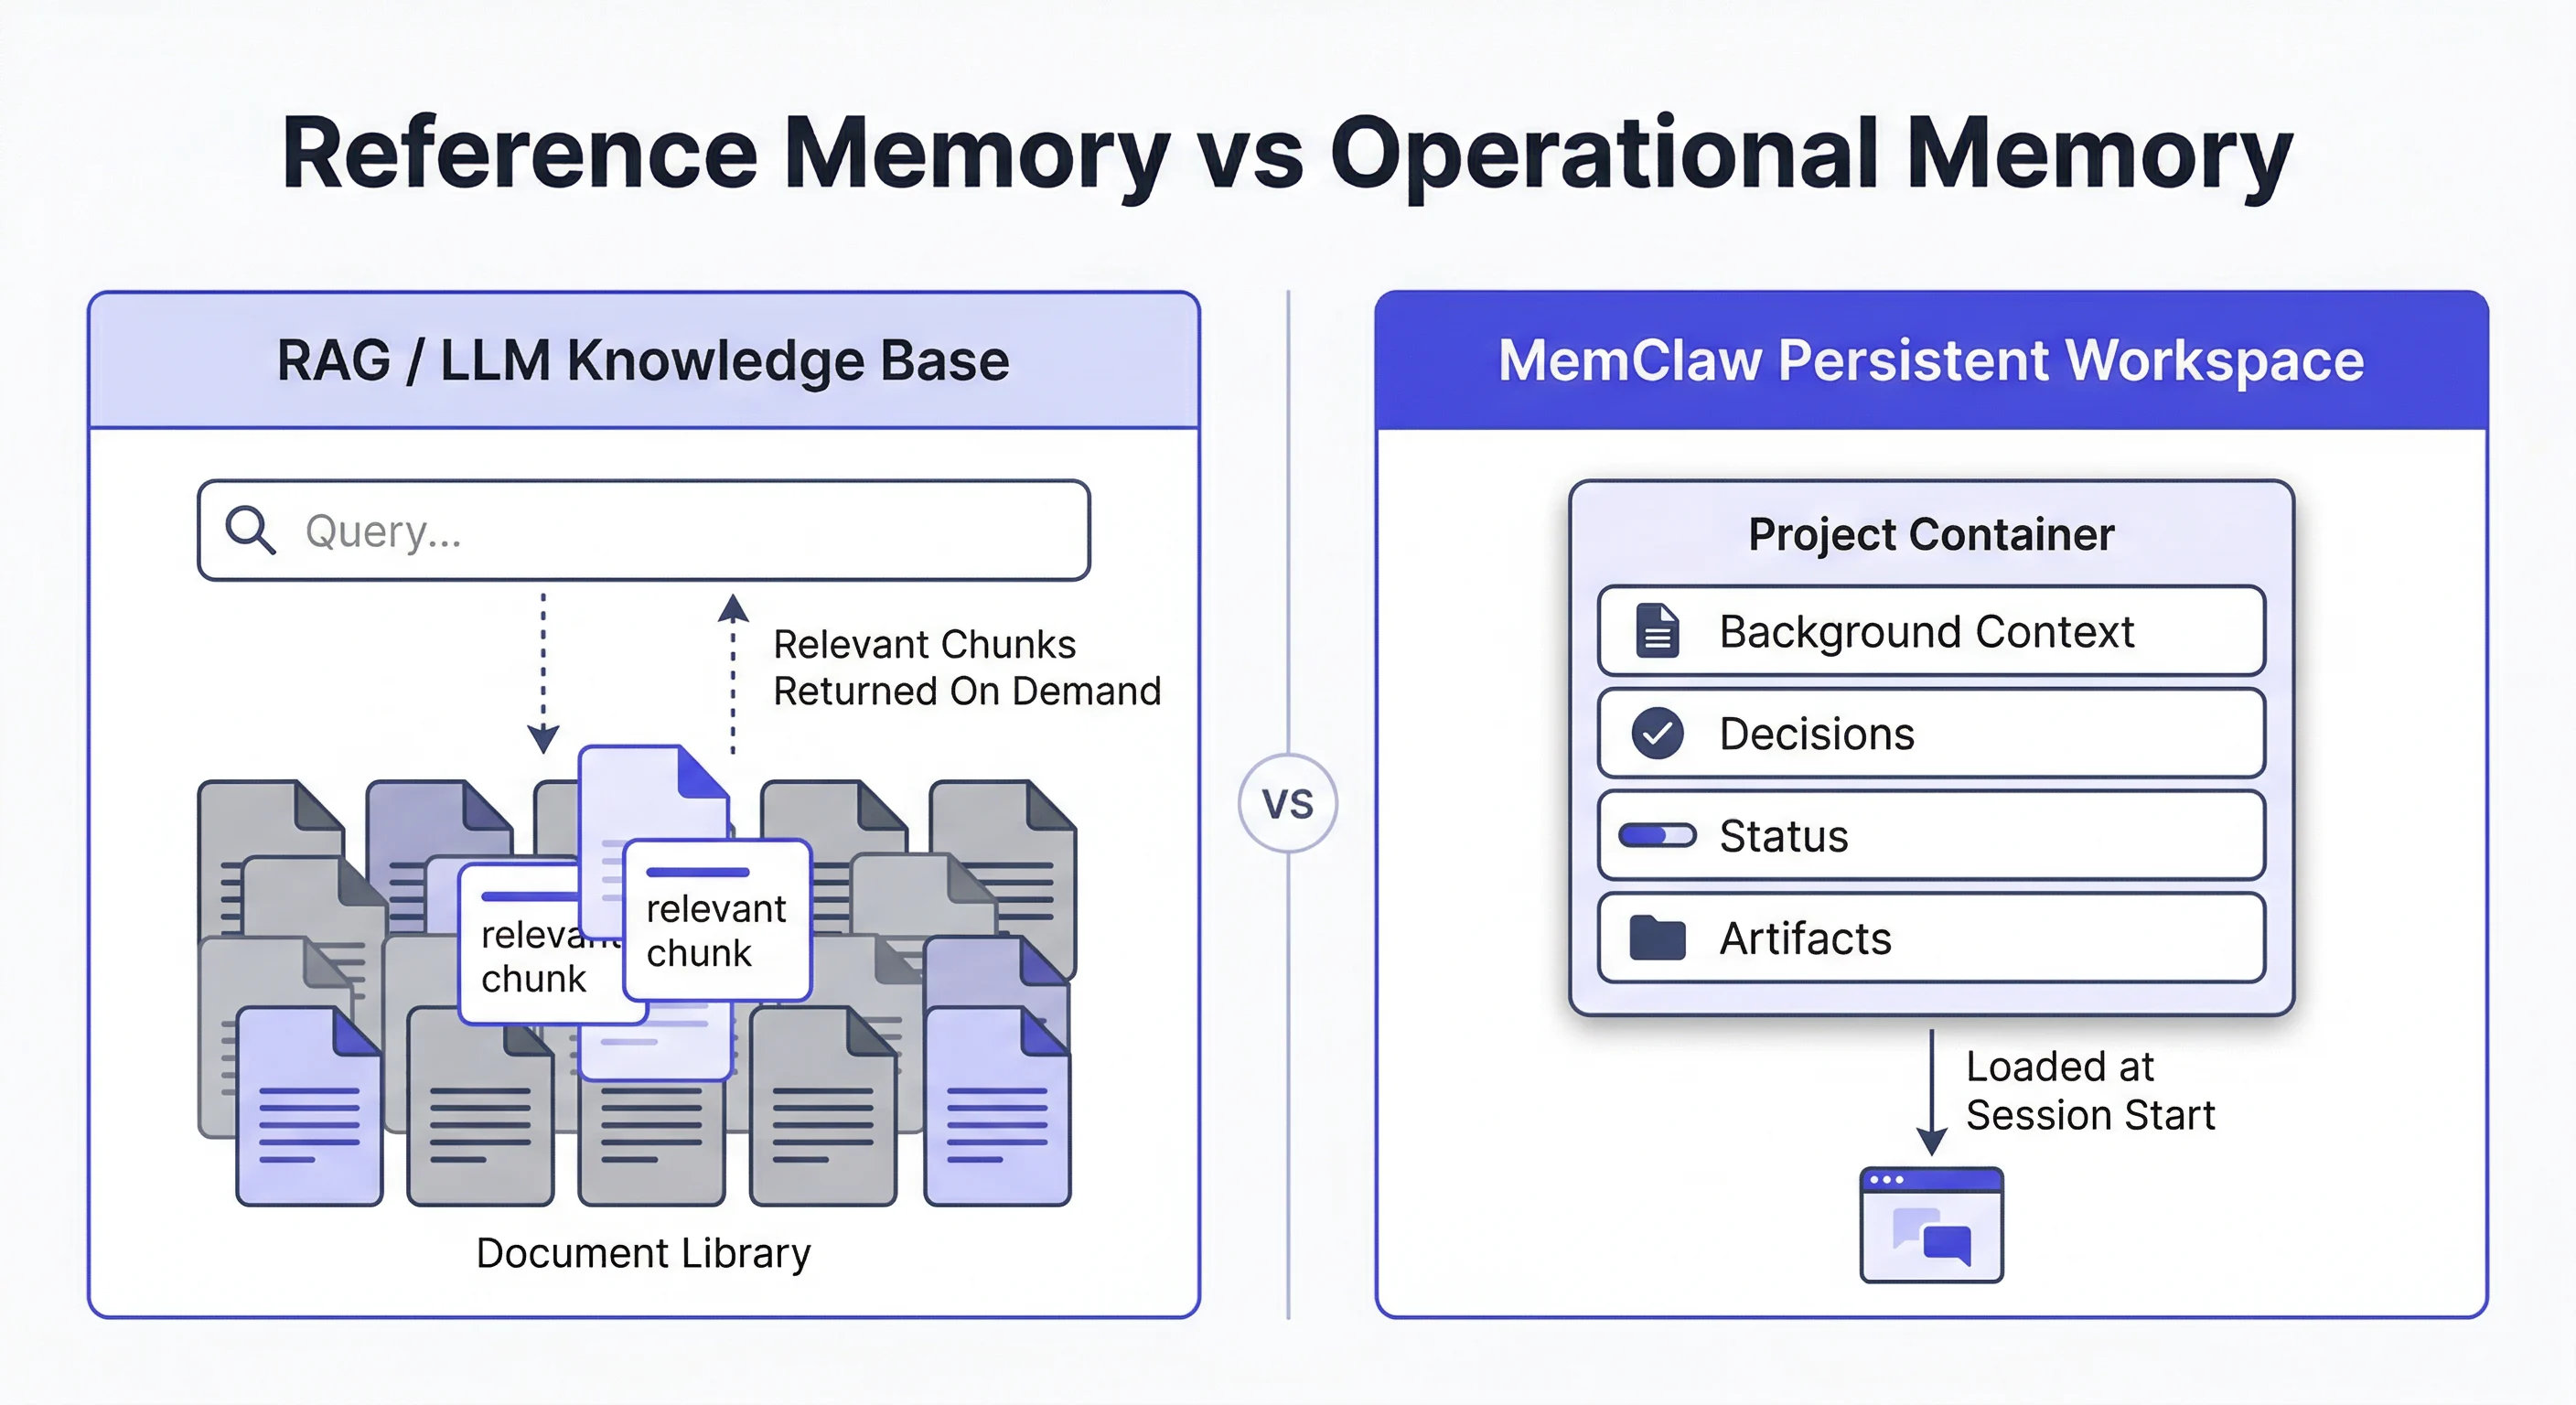
Para o mapeamento sistemático de evidências, um espaço de trabalho de pesquisa que recarrega decisões, status e artefatos no início de cada sessão é um ambiente principal melhor do que um resumidor de artigo único ou um chatbot RAG que recupera apenas “trechos relevantes” sob demanda. O mapeamento é um projeto longitudinal de codificação: os critérios de inclusão mudam, estudos limítrofes são recodificados e a síntese depende de lembrar por que uma fonte foi barrada na semana passada. Ferramentas voltadas a artigos individuais, como Elicit, Consensus e NotebookLM, continuam fortes para descoberta, extração e perguntas e respostas sobre corpus fechado. Um espaço de trabalho persistente — incluindo o Academic Research Assistant da Jenova — é mais robusto quando o mapa precisa sobreviver a semanas de mudanças no protocolo sem reescrever silenciosamente as decisões de ontem.
A distinção importante em 2026 não é “qual modelo escreve um resumo mais bonito”. É qual arquitetura de memória consegue manter um mapa de evidências vivo.
Fatores-chave que separam uma infraestrutura de mapeamento utilizável de um chat descartável sobre artigos:
✅ Memória operacional vs. memória de referência — mapas precisam de estado do projeto (critérios, códigos, exclusões), não apenas de passagens recuperadas ✅ Proveniência das decisões — cada decisão de incluir/excluir deve permanecer verificável entre sessões ✅ Extração estruturada — campos comparáveis superam resumos narrativos pontuais ✅ Fidelidade ao protocolo com supervisão humana — os organismos de evidências ainda tratam a AI como complemento, não como revisora substituta ✅ Síntese versionável — relatórios, figuras e listas de fontes devem se acumular em vez de serem regenerados do zero
Para comparar essas ferramentas de forma justa, é útil tratar o mapeamento de evidências como um problema de continuidade em quatro camadas, e não como uma competição de resumo.
Por Que o Mapeamento Sistemático de Evidências Pressiona as Ferramentas de AI para Artigos Individuais?
O mapeamento sistemático de evidências pressiona resumidores de artigos individuais porque um mapa é um inventário codificado da literatura, e não uma sequência de anotações de leitura isoladas. Os Mapas Sistemáticos de Evidências (SEMs) são uma forma de síntese de evidências que categoriza e organiza descobertas científicas segundo dimensões predefinidas — população, exposição, desfecho, método, geografia ou lacuna de evidência — para que revisores possam ver o que existe, onde há concentrações e o que está faltando.
Esse fluxo de trabalho entra em conflito com o modo como a maioria dos produtos de pesquisa com LLM funciona. Uma ferramenta RAG ou de “conversar com este PDF” responde à consulta atual buscando trechos localmente semelhantes. Ela não recarrega automaticamente o quadro de codificação da última terça-feira, os três estudos deixados em “talvez” ou a decisão de que modelos animais ficaram fora do escopo após o endurecimento do protocolo. Revisões de mapeamento também exigem um processo de triagem documentado com base em critérios de inclusão e exclusão, o que é uma tarefa diferente de gerar um parágrafo fluente sobre um artigo (metodologia para revisões de mapeamento).
A revisão manual continua lenta o bastante para tornar o atalho tentador. Uma pesquisa de 2026 sobre ferramentas de literatura estimou que um ciclo convencional de revisão leva quatro a seis semanas de triagem, extração e limpeza de citações. Ferramentas dedicadas de triagem com AI podem reduzir essa carga — o sistema AIM Review relatou reduções de carga de trabalho de 20% a 95% em seis revisões do mundo real —, mas velocidade não cria um mapa. Sem estado persistente do projeto, uma triagem mais rápida apenas produz uma pilha maior de resumos desconectados.
Bibliotecas e entidades metodológicas são explícitas sobre a lacuna restante. As orientações de síntese de evidências do King’s College London afirmam que ferramentas de AI não podem substituir os métodos tradicionais de busca, triagem e extração e devem ser usadas apenas com uma visão clara de vieses, limites de direitos autorais e risco de alucinação. Uma revisão sistemática de 2025 sobre AI generativa na síntese de evidências chegou à mesma conclusão operacional: as evidências atuais não apoiam o uso de GenAI sem envolvimento ou supervisão humana.
O Que Você Deve Procurar em um Fluxo de Trabalho de Mapeamento de Evidências com AI?
Você deve avaliar ferramentas de mapeamento com AI por meio de um teste de continuidade, e não de um teste de qualidade da escrita. Usamos uma pilha de quatro camadas — chamada de pilha CODE — porque cada camada falha de uma maneira diferente e previsível quando equipes tentam transformar chat sobre artigos em um mapa sistemático.
C — Cobertura. A ferramenta consegue pesquisar um corpus acadêmico real ou apenas arquivos que você já enviou? O Elicit pesquisa mais de 138 milhões de artigos e 545.000 ensaios clínicos. O NotebookLM, por definição, responde com base nas fontes presentes no notebook. Erros de cobertura nessa camada se tornam linhas ausentes no mapa, e não apenas parágrafos superficiais.
O — Operacionalização. Critérios de inclusão, dimensões de codificação e campos de extração podem ser definidos uma vez e reaplicados? Um resumidor que reinterpreta “relevante” a cada prompt recodificará o mesmo ensaio limítrofe de forma diferente no terceiro dia. As orientações de mapeamento tratam critérios predefinidos como obrigatórios (métodos de revisão de mapeamento).
D — Documentação das decisões. Você consegue recuperar por que um estudo foi incluído, excluído, deixado em espera ou barrado? Grupos alinhados à Cochrane, incluindo a iniciativa Responsible AI in Evidence Synthesis (RAISE) com Cochrane, Campbell e JBI, tratam a transparência como requisito de qualidade, não como um detalhe opcional.
E — Extraibilidade. As descobertas podem chegar a células comparáveis — amostra, desenho, direção do efeito, limitação — em vez de prosa impossível de reconciliar? O design do produto Elicit é construído em torno de tabelas interativas e extração em múltiplas etapas. O Consensus é mais rápido para a direção das evidências em nível de hipótese, mas não foi criado para redação estruturada de revisões.
Pondere as camadas conforme o objetivo. Uma análise exploratória pode tolerar proveniência mais fraca. Um mapa de evidências vivo que será citado, atualizado ou entregue a um coautor não pode. Ferramentas que se destacam em Cobertura e Extraibilidade ainda falham em mapas se a Operacionalização e a Documentação das decisões forem reiniciadas a cada sessão.
Como Elicit, Consensus, NotebookLM e Espaços de Trabalho de Pesquisa se Comparam?
Elicit e Consensus são a camada mais forte de descoberta e extração de artigos nesta categoria, o NotebookLM é o notebook de corpus fechado mais forte, e um espaço de trabalho de pesquisa persistente é o ambiente mais robusto para manter coerente um mapa de várias semanas. Nenhum produto vence em todas as camadas CODE, razão pela qual equipes sérias de mapeamento normalmente combinam uma ferramenta de corpus com um ambiente de memória do projeto, em vez de esperar que um único chatbot seja responsável pela revisão inteira.
Em 2026, os retratos publicados de recursos e preços são os seguintes:
| Recurso / Dimensão | Elicit | NotebookLM | Consensus | Espaço de trabalho de pesquisa da Jenova |
|---|---|---|---|---|
| Modelo de memória | Biblioteca de fontes salvas mais personalização por relatório; não é um contêiner completo do estado do projeto | Conjunto de fontes limitado ao notebook; as respostas permanecem nos materiais enviados | Memória de perguntas/listas voltada a consultas de hipóteses | Memória persistente entre sessões; o contexto do projeto pode ser recarregado em vez de recuperado novamente |
| Cobertura | 138M+ artigos, 545 mil ensaios | Apenas corpus enviado; 50 fontes no gratuito, 300 no Plus | 200M+ artigos, etiquetas de direção de evidência | Busca acadêmica e na web ao vivo, além de bases de conhecimento anexadas; não é um índice fixo de editoras |
| Extração estruturada | Tabelas, triagem e pontos de dados em escala (até 1.000 artigos / 20.000 pontos de dados) | Perguntas e respostas e esquemas vinculados às fontes, não grades de extração para revisões sistemáticas | Consensus Meter e respostas curtas sobre evidências | Relatórios de síntese e resumos com citações por meio do Deep Research; mais fraco como ferramenta dedicada de triagem dupla |
| Persistência de decisões | Fontes podem ser armazenadas em uma biblioteca; o estado do protocolo não é um recurso central | Mantém os arquivos do notebook, não a lógica codificada de incluir/excluir | Marcadores e listas nos planos pagos | Histórico de conversas, memória e arquivos de projeto anexados permanecem entre sessões |
| Preços (em 2026) | Plus a partir de cerca de $12/mês | Gratuito; Plus via Google AI Pro por cerca de $19,99/mês | Premium por cerca de $10/mês | Plano gratuito com uso limitado; Plus por $20/mês para 30× de uso |
| Melhor para | Triagem em alto volume e tabelas de extração | Conjuntos de ensino e PDFs já coletados | Verificações rápidas de “a literatura apoia X?” | Mapas vivos, codificação em múltiplas sessões e integração a manuscritos |
O Elicit é a especialista mais direta para triagem em estilo sistemático. Ele pode automatizar a triagem e a extração e relata até 80% de economia de tempo nessas etapas. Uma comparação de métodos da Cochrane ainda concluiu que a sensibilidade de busca do Elicit não era alta o bastante para substituir a busca tradicional de literatura, portanto ele funciona melhor como complemento de alta precisão. Ele também tende a se limitar a relatórios e tabelas; trabalho de redação, versionamento e manuscrito vivo geralmente é deslocado para outro lugar.
O NotebookLM é a especialista mais direta para leitura fundamentada de um conjunto fixo. Cada resposta pode ser verificada em relação a uma passagem citada, e o Google adicionou Deep Research e tipos de arquivo mais amplos. Ele não consegue descobrir artigos que você ainda não coletou e não codifica um registro de decisões no estilo PRISMA.
O Consensus é a especialista mais direta para direção de hipótese. Seu medidor e suas etiquetas de apoio/contraste são mais rápidos do que construir uma grade de extração quando você só precisa saber para que lado a literatura aponta (comparação de ferramentas). Ele é o sistema principal errado para um mapa codificado.
O Academic Research Assistant da Jenova é mais forte quando a unidade de trabalho é o projeto, e não o PDF. Ele pode pesquisar fontes acadêmicas, manter contexto de manuscrito e citações e — como a plataforma subjacente armazena histórico ilimitado de chats e memória entre sessões — continuar um quadro de codificação sem exigir que o protocolo seja colado novamente. Ele não é uma plataforma validada de triagem dupla no sentido de Covidence ou Rayyan, nem publica métricas de precisão de extração como as do Elicit. Equipes que precisam de trilhas de auditoria em padrão regulatório ainda devem manter uma ferramenta de triagem dedicada na pilha.
SciSpace e Scite preenchem funções adjacentes mais restritas. O SciSpace é repetidamente descrito como o melhor ambiente de análise aprofundada artigo por artigo, com um corpus muito grande, mas um fluxo de revisão menos unificado. As 1,6 bilhão de Smart Citations do Scite, classificadas como apoio, contraste ou menção a uma afirmação, são incomparáveis para auditoria do contexto de citações e quase inúteis como banco de dados de descoberta ou mapeamento por si só.
Como a Memória Operacional Muda a Síntese de Literatura em Múltiplas Sessões?
A memória operacional muda a síntese porque trata o contêiner do projeto — contexto de fundo, decisões, status e artefatos — como o objeto carregado no início da sessão, em vez de tratar a literatura como um palheiro a ser consultado novamente. A memória de referência pergunta: “Quais trechos se parecem com esta pergunta?”. A memória operacional pergunta: “O que já é verdadeiro sobre este projeto e o que ainda precisa de evidência?”.
Essa diferença aparece em três modos de falha que resumidores escondem bem:
- Deriva de critérios. Se “apenas RCTs em humanos adultos” estiver no prompt, e não no estado do projeto, uma sessão posterior que faça uma pergunta um pouco mais ampla reincluirá silenciosamente os estudos pediátricos que você já rejeitou.
- Talvez sem vínculo. Artigos limítrofes deixados em espera para discussão com um coautor desaparecem se o status não for um campo central.
- Síntese regenerada. Uma resposta RAG pode ser localmente fiel aos trechos recuperados hoje e ainda contradizer a tabela de lacunas da semana passada, porque nada obriga a nova resposta a herdar a codificação anterior.
Espaços de trabalho persistentes invertem a ordem de carregamento. O contexto de fundo, as decisões, o status e os artefatos entram antes da próxima consulta. A implementação desse padrão pela plataforma da Jenova é memória entre sessões mais bases de conhecimento anexáveis: o assistente pode lembrar as dimensões do mapeamento, a definição operacional de uma lacuna de evidência e quais afirmações já têm suporte suficiente. Testar isso em relação a ferramentas no estilo notebook mostra uma troca clara. O corpus fechado do NotebookLM é mais seguro contra invenções fora das fontes (respostas vinculadas às fontes). Um espaço de trabalho aberto e persistente é mais útil quando o corpus ainda está crescendo e o quadro de codificação é o ativo escasso.
A implicação prática para os SEMs é simples. Se sua entrega for uma apresentação produzida em uma única sessão sobre 15 PDFs, a memória operacional é opcional. Se sua entrega for um mapa de lacunas que será atualizado após o próximo ciclo de conferências, a memória operacional é o produto.
Como é, de Fato, um Pipeline Agêntico de Evidências de Ponta a Ponta?
Um pipeline de mapeamento de ponta a ponta se parece com uma etapa de pesquisa estruturada com portões de validação, e não com um único prompt de “resuma estes artigos”. A ilustração abaixo é uma arquitetura de referência útil: formulação de perguntas, triagem de literatura, identificação de candidatos, formalização de hipóteses, validação com múltiplas fontes, relatórios versionados e um pacote rastreado por git.
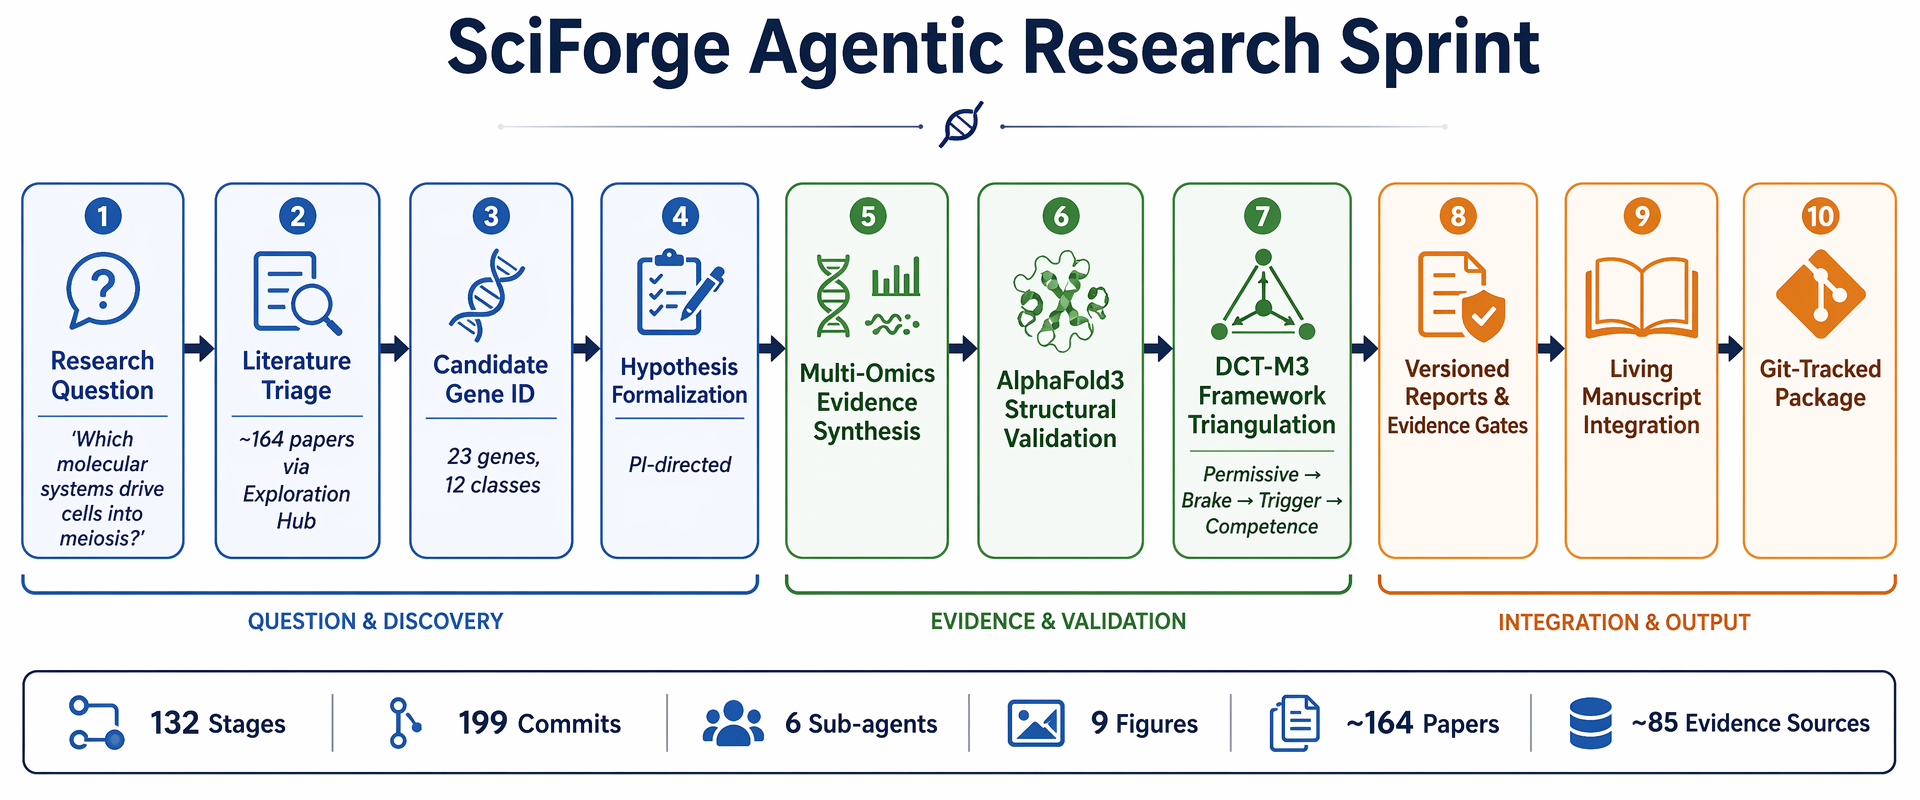
O exemplo de sprint é deliberadamente grande — na ordem de 164 artigos triados, 132 estágios, 199 commits, seis subagentes e cerca de 85 fontes de evidência — porque essa é a escala em que o chat sobre artigos entra em colapso. Um resumidor consegue descrever o artigo 17. Ele não consegue manter coerente uma cadeia de 10 estágios quando o estágio 4 altera a regra de inclusão que o estágio 2 já aplicou.
Três escolhas de design nesse pipeline importam mais do que os detalhes do domínio:
- A descoberta é uma fase, não o produto. A triagem de literatura alimenta IDs de candidatos e uma hipótese formal. Parar nos resumos deixa o mapa sem ser construído.
- A validação é multimodal. A síntese de evidências, verificações estruturais ou quantitativas e uma lógica explícita de “permissiva → freio → gatilho” forçam as afirmações a passar por portões, em vez de serem reduzidas a uma média em um parágrafo.
- A saída é versionada. A integração a manuscrito vivo e um pacote rastreado por git transformam o mapa em um artefato com histórico. Isso é o oposto de uma transcrição de chat que você não consegue reproduzir.
A Jenova pode aproximar esse padrão ao dividir funções entre Agentes, em vez de forçar um único chat a ser bibliotecário, codificador e redator. O Academic Research Assistant cuida da descoberta acadêmica e do contexto do manuscrito. O Deep Research produz síntese com citações a partir de muitas fontes. A Real-Time Search é útil quando o mapa também precisa incluir preprints, repositórios ou literatura cinzenta fora de periódicos. A limitação é a disciplina de orquestração: o humano ainda é responsável pelo protocolo, pelos portões e pela decisão de promover uma afirmação ao manuscrito vivo. Grupos metodológicos continuam tratando esse papel humano como inegociável (orientações KCL / RAISE).
Plataformas completas de revisão no estilo Paperguide tentam condensar planejar–buscar–triagem–extrair–gerar em um fluxo de trabalho de um único fornecedor, incluindo modos Extended que triam 200 candidatos e escrevem a partir dos 50 melhores. Isso está mais próximo de um espaço de trabalho do que Elicit-plus-Word, mas ainda exige um registro externo de decisões se você se importa com a proveniência depois que a revisão gerada for exportada.
Como Tirar o Máximo Proveito de um Mapa de Evidências com AI?
Você tira o máximo proveito de um mapa de evidências com AI ao escrever o protocolo no espaço de trabalho antes de pedir prosa e, depois, obrigar cada sessão posterior a herdar esse protocolo. A configuração é semelhante entre as ferramentas; a diferença é se a ferramenta consegue lembrar da configuração.
Para um mapa centrado na Jenova, uma sequência viável é:
- Abra o Academic Research Assistant e nomeie o projeto, a população e as dimensões do mapeamento na primeira mensagem.
- Fixe o protocolo em uma linguagem que o assistente possa reutilizar:
“Crie um mapa sistemático de evidências de estudos em humanos adultos sobre X. Inclua apenas RCTs e coortes prospectivas. Codifique cada estudo quanto a desenho, amostra, intervenção, desfecho primário, direção do efeito e limitações. Deixe artigos com animais e in-vitro em um registro de exclusão com uma justificativa de uma linha. Não recodifique códigos que já foram decididos.”
- Execute o Deep Research para a primeira análise do corpus, depois cole ou anexe a tabela de trabalho de volta à mesma conversa do projeto para que extração e narrativa compartilhem uma única memória.
- Após cada sessão, peça três artefatos, e não um único texto: uma tabela de estudos atualizada, um registro de exclusões e uma lista de lacunas. Esses três arquivos são o mapa.
Para o Elicit, comece com a pergunta de pesquisa, gere uma tabela de triagem e trate a biblioteca como fonte de verdade (fluxo de trabalho de revisão sistemática do Elicit). Não pule uma busca convencional em bases de dados. Os estudos de caso da Cochrane consideraram o Elicit útil para busca preliminar de alta precisão e para encontrar estudos extras exclusivos, não como único mecanismo de busca.
Para o NotebookLM, colete primeiro os PDFs, permaneça em um notebook e faça perguntas dimensão por dimensão (“Liste todos os estudos que relatam o desfecho Y com tamanho de amostra e acompanhamento”) para que o corpus fechado não se desvie. Os limites de envio — 50 fontes no plano gratuito, 300 no Plus — tornam esta a ferramenta errada para um mapa de 400 registros, a menos que você faça a pré-triagem em outro lugar.
Duas regras de processo se aplicam a qualquer pilha. Primeiro, não envie PDFs de texto completo a um modelo de consumo se os termos de direitos autorais proibirem isso; os titulares de direitos geralmente proíbem esse uso. Segundo, mantenha um humano na função de inclusão/exclusão. A assistência à triagem é a tarefa de AI com mais evidências de apoio; a síntese sem supervisão é a tarefa com menos (revisão de revisões sobre a prontidão da AI).
O Que Especialistas em Síntese de Evidências Dizem sobre Mapeamento Assistido por AI?
Especialistas aceitam cada vez mais a AI para triagem e extração supervisionadas, mas ainda rejeitam a AI como cartógrafa não supervisionada de uma área. O consenso útil de especialistas em 2026 é mais restrito do que a comunicação dos fornecedores: automatize a camada repetitiva, mantenha persistente a camada de decisão e preserve a responsabilização humana pelo mapa.
“O modo de falha que observamos não é que os modelos não consigam resumir um artigo. É que as equipes de mapeamento tratam um bom resumo como se fosse um registro codificado. Um mapa sistemático de evidências é um conjunto de decisões reversíveis — entra, sai, em espera, barrado — associadas a campos estáveis. Se essas decisões existem apenas no prompt da semana passada, o mapa já está corrompido, mesmo quando cada parágrafo ainda parece cuidadoso.”
“A recuperação de referências e a memória operacional resolvem problemas diferentes. A recuperação é como você encontra evidências candidatas. A memória operacional é como você deixa de recodificar o mesmo estudo três vezes. Ferramentas excelentes na primeira tarefa são frequentemente implantadas como se realizassem a segunda. É assim que se obtém uma análise fluente de lacunas que não consegue explicar por que 12 ensaios limítrofes desapareceram.”
“Nossa regra prática é simples. Use um mecanismo de corpus para preencher linhas. Use um espaço de trabalho persistente para manter vivo o livro de códigos, o registro de exclusões e a tabela de lacunas. Use um revisor humano em cada portão que altere o significado do mapa. Qualquer coisa vendida como um mapa sistemático de um clique pede que você ignore a única camada que grupos metodológicos ainda consideram inegociável.”
— Equipe de Produto da Jenova, design de fluxos de trabalho de pesquisa, 8 anos desenvolvendo sistemas de conhecimento para trabalho analítico em múltiplas sessões
Essa posição está alinhada às orientações formais. NICE, recomendações do RAISE vinculadas à Cochrane e serviços de bibliotecas universitárias descrevem a AI como um complemento dentro de métodos validados existentes. Um guia vivo sobre AI em busca e triagem de literatura apresenta o mesmo argumento de eficiência — a triagem é cara; a automação ajuda — sem afirmar que a geração pode substituir o protocolo.
Quando Resumidores de Artigos Individuais Ainda São a Escolha Certa?
Resumidores de artigos individuais ainda são a escolha certa quando o corpus é pequeno, já foi coletado e não está sendo codificado em um mapa reutilizável. Se você tem 12 PDFs, um clube de revista amanhã e nenhuma necessidade de atualizar o inventário em três meses, um chat sobre artigos no estilo NotebookLM ou SciSpace concluirá o trabalho com menos formalidade do que um contêiner de projeto.
Eles também são mais adequados para outras três tarefas que são equivocadamente rotuladas como mapeamento:
- Explicação de mecanismo. “Explique a Figura 3” é uma tarefa de leitura. Um notebook de corpus fechado com citações clicáveis é mais seguro do que um espaço de trabalho aberto que pode combinar artigos.
- Verificações de contexto de citações. Se a questão é se trabalhos posteriores apoiam ou contrastam uma afirmação, as citações classificadas do Scite são a camada criada para esse fim (1,6B+ Smart Citations).
- Verificações pontuais de hipóteses. O Consensus continua sendo a forma mais rápida de ver se uma proposição tem uma divisão visível entre apoio e contraste antes de você investir em um mapa (visão geral Elicit vs Consensus).
O erro é usar esses pontos fortes como substituto da infraestrutura de SEM. Um resumidor pode ser excelente localmente e ainda ser o sistema de registro errado. Da mesma forma, um espaço de trabalho persistente pode manter vivo um livro de códigos desorganizado e ainda ser a ferramenta errada para uma triagem dupla de 5.000 registros se você precisar de software dedicado para revisões sistemáticas. Guias institucionais ainda direcionam equipes para plataformas de triagem como Rayyan, Covidence e DistillerSR nessa etapa (guia CASRAI de AI para revisões sistemáticas; guia de revisão sistemática da Stony Brook).
A regra de decisão que resiste ao contato com revisões reais é, portanto, arquitetural, e não baseada em marca. Se o produto do trabalho for um conjunto de decisões de codificação comparáveis, atualizáveis e explicáveis, escolha um espaço de trabalho de pesquisa com memória de projeto e mantenha ao lado dele um mecanismo de corpus. Se o produto do trabalho for compreender os artigos que já estão em sua mesa, um resumidor de artigo único não é um compromisso. É a ferramenta corretamente dimensionada.
Referências
- ScienceDirect — Orientações para realizar mapas sistemáticos de evidências
- PubMed Central — Metodologia para revisões de mapeamento, mapas de evidências e mapas de lacunas
- Paperguide — 7 melhores ferramentas de AI para revisão de literatura em 2026
- King’s College London — Ferramentas de AI na síntese de evidências
- Elicit — AI para pesquisa científica
- NotebookLM — Ferramenta de pesquisa com AI e parceira de reflexão
- Google Blog — NotebookLM adiciona Deep Research, DOCX, Sheets e mais
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Omid Saffari — Melhores ferramentas de pesquisa com AI em 2026: Elicit vs Consensus
- Guia para usar AI em busca e triagem de literatura
- CASRAI — Ferramentas de AI para revisões sistemáticas de literatura
- Bibliotecas da Stony Brook University — Guia de revisão sistemática: Inteligência Artificial