Assistentes de Pesquisa com AI São Melhores que a Busca por Palavras-chave para Encontrar Artigos Relacionados?
2026-08-22
Quando a Correspondência Semântica Supera o Ranqueamento por Palavras-chave para Artigos Conceitualmente Relacionados?
Assistentes de pesquisa com AI semântica superam a busca tradicional por palavras-chave quando os artigos de que você precisa descrevem a mesma ideia com terminologias diferentes, enquanto mecanismos de palavras-chave continuam mais fortes quando você já conhece as frases exatas, os autores ou o grupo de citações que deseja segmentar. Em 2026, a resposta prática não é abandonar o Google Scholar, mas combinar o ranqueamento lexical com a recuperação baseada em significado — usando ferramentas como Elicit, SciSpace, Undermind e o Academic Research Assistant da Jenova.
Fatores principais que separam a descoberta conceitual eficaz da correspondência por palavras-chave:
✅ Flexibilidade de vocabulário — se o sistema consegue apresentar um artigo sobre "infarto do miocárdio" quando a consulta usou "ataque cardíaco" ✅ Sinais de ranqueamento — pontuações lexicais ponderadas por citações versus similaridade de embeddings versus um LLM avaliando a relevância ✅ Profundidade do índice — metadados de título e resumo versus correspondência de texto completo em centenas de milhões de trabalhos ✅ Controles de precisão — aninhamento Boolean, limites de campo, filtros de qualidade de periódicos e limites de exportação ✅ Tempo até obter um conjunto útil — listas exploratórias instantâneas versus buscas iterativas de vários minutos
Para comparar esses métodos com honestidade, é útil tratar a incompatibilidade de vocabulário, o viés de ranqueamento e o controle da busca como dimensões separadas, em vez de perguntar qual ferramenta é universalmente melhor.
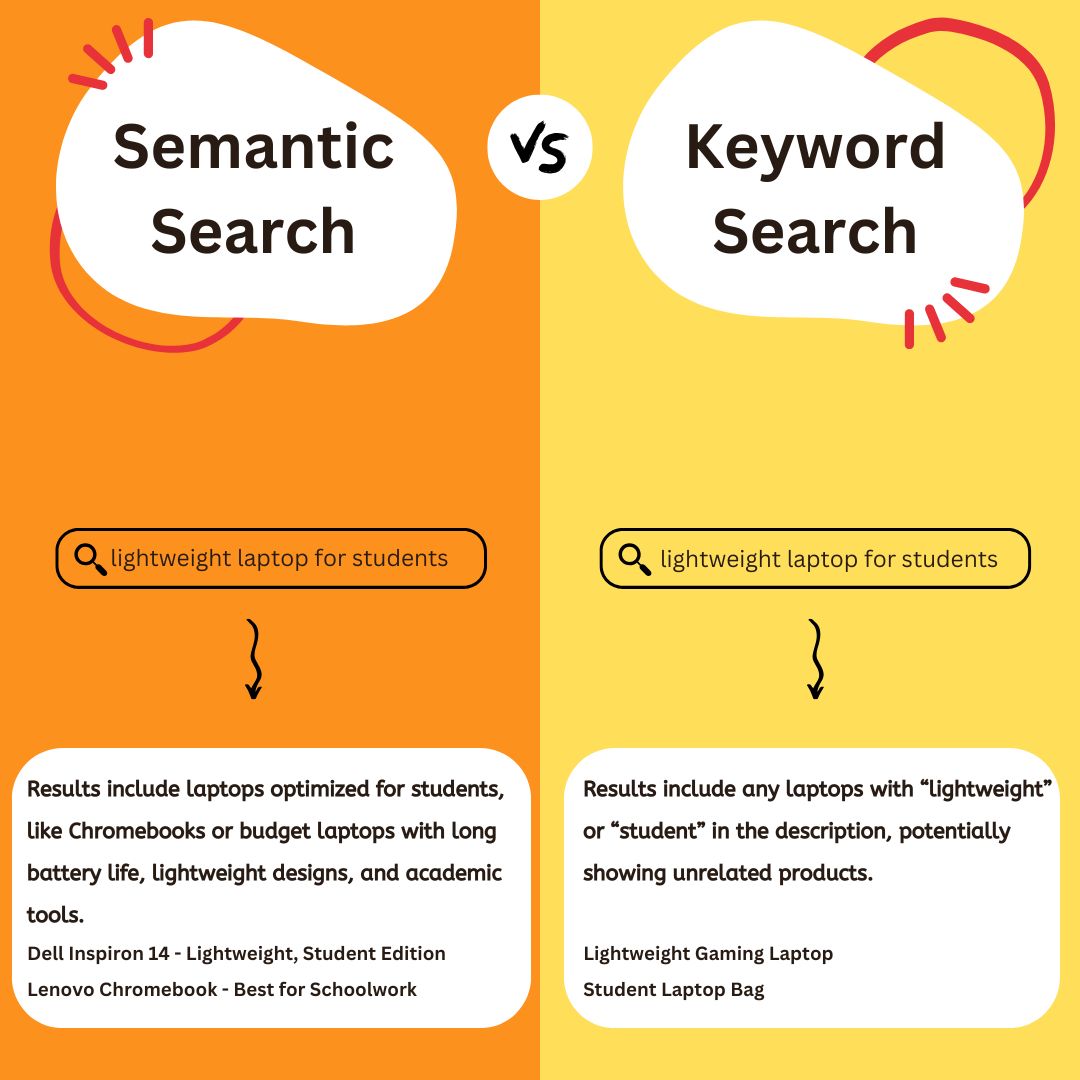
Por Que a Incompatibilidade de Vocabulário Ainda Compromete a Busca Acadêmica Tradicional em 2026?
A incompatibilidade de vocabulário ainda compromete a busca acadêmica tradicional porque autores, disciplinas e períodos históricos nomeiam o mesmo fenômeno de formas diferentes, e os mecanismos lexicais só recuperam documentos que compartilham termos superficiais suficientes com a consulta. Um artigo de saúde pública pode dizer "atividade física", um artigo de cardiologia pode dizer "capacidade de exercício" e um artigo de sociologia pode dizer "movimento no tempo livre". Se você pesquisar apenas uma expressão, os outros dois grupos podem desaparecer das primeiras páginas de resultados.
O Google Scholar continua sendo o ponto de partida padrão para a maioria dos pesquisadores e ainda é a superfície única mais ampla de busca acadêmica disponível, incluindo textos completos de editoras e repositórios. Aaron Tay, bibliotecário acadêmico da Singapore Management University, descreveu-o como o canivete suíço da busca acadêmica — a ferramenta que ele manteria se só pudesse manter uma. Seu ranqueamento, porém, continua sendo lexical. Depois das correspondências no título, ele atribui peso elevado a artigos muito citados, o que é excelente para encontrar trabalhos seminais e fraco para localizar artigos conceitualmente relacionados que usam redação diferente ou ainda não acumularam citações.
O problema é pior quando o termo da consulta é comum. Como o Google Scholar faz correspondência em todo o texto, uma busca por uma ferramenta ou conceito com nome cotidiano pode explodir em milhares de ocorrências incidentais. Tay observa que buscar por "Elicit" no Google Scholar é quase inútil, a menos que você adicione uma solução alternativa de domínio, porque a palavra aparece constantemente em seções de métodos. Sistemas semânticos reduzem esse modo de falha ao pontuar o significado em vez da sobreposição de strings, razão pela qual se tornaram uma camada complementar, e não uma novidade.
O Que Você Deve Avaliar ao Comparar Busca por Palavras-chave e Assistentes de AI Semântica?
Você deve avaliar a busca por palavras-chave e os assistentes de AI semântica em seis dimensões que este artigo chama de Framework de Recuperação de Incompatibilidades: flexibilidade de vocabulário, transparência de ranqueamento, cobertura do índice, controle de precisão, sinais de autoridade e tempo até obter um conjunto útil. Uma ferramenta que vence em uma dimensão frequentemente perde em outra, razão pela qual um único ranking de "vencedor" engana mais do que ajuda.
Flexibilidade de vocabulário pergunta se o mecanismo consegue recuperar um artigo cujo resumo nunca repete os termos da sua consulta. Embeddings densos e métodos híbridos como SPLADE, que o Elicit usa como uma abordagem de embedding esparso aprendido, foram desenvolvidos para isso. Transparência de ranqueamento pergunta se você consegue explicar por que um artigo apareceu. Sistemas Boolean-plus-BM25 são mais fáceis de auditar; a busca de vizinhos mais próximos por embedding e os reranqueadores LLM são mais difíceis de reproduzir.
Cobertura do índice não é o mesmo que "número de artigos anunciado". O OpenAlex informa 517 milhões de registros de trabalhos e 66 milhões de PDFs de texto completo, enquanto o Elicit afirma que pesquisa, resume e extrai dados de mais de 125 milhões de artigos. O Google Scholar não publica uma contagem oficial comparável, mas é amplamente considerado o maior índice acadêmico de busca em texto completo. Controle de precisão cobre Boolean aninhado, limites de campo, operadores de proximidade e vocabulário controlado — recursos nos quais The Lens e OpenAlex superam o Google Scholar.
Sinais de autoridade incluem contagens de citações, nível do periódico e indicadores de retratação. O Google Scholar e, em menor grau, o Undermind tendem a favorecer trabalhos muito citados. Elicit e SciSpace geralmente ranqueiam por similaridade semântica e não atribuem peso a citações, de modo que artigos mais novos ou menos citados sobem. Tempo até obter um conjunto útil separa a busca instantânea por palavras-chave de execuções iterativas no estilo Undermind que levam pelo menos três minutos. Pontue cada dimensão em relação à sua tarefa real — descoberta rica em sinônimos, recuperação sistemática ou uma orientação de cinco minutos — antes de escolher um mecanismo principal.
Como Google Scholar, Elicit, SciSpace, Undermind e Jenova Se Comparam na Descoberta Conceitual?
O Google Scholar é mais forte para exploração ampla ponderada por citações; Elicit e SciSpace são mais fortes quando as palavras-chave não estão claras; Undermind é mais forte para buscas estreitas e de alta precisão; e o Academic Research Assistant da Jenova é mais forte quando descoberta, síntese e trabalho com citações precisam permanecer em uma única conversa persistente. Nenhuma dessas ferramentas domina todas as células do Framework de Recuperação de Incompatibilidades.
| Recurso / Dimensão | Google Scholar | Elicit / SciSpace | Undermind | Jenova Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| Método de correspondência | Lexical / palavras-chave, ponderado por citações | Semântico ou híbrido (Elicit usa SPLADE) | Recuperação híbrida com avaliação de relevância por LLM e busca iterativa | Agente de pesquisa em linguagem natural sobre fontes acadêmicas ao vivo, incluindo Google Scholar | Busca estruturada de metadados acadêmicos com operadores avançados |
| Recuperação com redação diferente | Fraca, a menos que você adicione sinônimos ou use Related articles | Forte para consultas baseadas em significado | Forte para briefs específicos em linguagem natural | Forte em reformulações conversacionais entre sessões | Fraca a moderada; depende da construção da consulta |
| Viés de autoridade | Favorece artigos muito citados depois das correspondências no título | Pouca ponderação por citações; artigos mais novos sobem | Algum viés para trabalhos seminais por meio da busca de citações | Segue as fontes conectadas e o briefing que você fornece | Orientado por metadados; desenvolvido mais para análise do que para ranqueamento semântico |
| Recursos de precisão | Sem Boolean aninhado, limite de 256 caracteres, busca de campo limitada | Pós-filtros de qualidade de periódicos, como níveis Scimago no SciSpace | Especificidade em linguagem natural em vez de Boolean | Refinamento conversacional; não é um mecanismo de sintaxe Boolean | Boolean aninhado, proximidade, busca por campo, vocabulário controlado |
| Tempo típico de consulta | Instantâneo | Rápido o suficiente para exploração | Pelo menos ~3 minutos por busca | Interativo; interações de acompanhamento são imediatas | Instantâneo a limitado pelo ritmo da API |
| Preços (em 2026) | Gratuito | Elicit Pro por cerca de US$ 49/mês; planos pagos do SciSpace relatados de US$ 12 a US$ 160/mês | Nível exploratório gratuito; planos acadêmicos pagos | Nível gratuito com uso limitado; Plus a partir de US$ 20/mês | Busca na web gratuita; a API do OpenAlex tem um nível gratuito |
| Melhor para | Artigos seminais, encadeamento por Cited by, busca de texto completo | Palavras-chave pouco claras e consultas em formato de pergunta | Encontrar uma classe específica de estudo com alta recuperação | Trabalho de literatura de ponta a ponta com memória e suporte a manuscritos | Buscas sistemáticas, reproduzíveis e de alto controle |
Google Scholar
O Google Scholar continua sendo o generalista. As páginas oficiais de ajuda confirmam que os resultados normalmente são ordenados por relevância, não por data, e que pesquisadores podem navegar por Related articles e Cited by quando têm um artigo-semente em mãos. Esses dois recursos são o mais próximo que a busca por palavras-chave chega da descoberta conceitual, mas exigem uma boa semente. As limitações são bem documentadas: sem Boolean aninhado, sem busca por campo apenas no resumo, limite de consulta de 256 caracteres, teto de 1.000 resultados e sem exportação em massa. Essa combinação explica por que bibliotecários rotineiramente o excluem como banco de dados principal em revisões sistemáticas.
Elicit e SciSpace
O Elicit se posiciona como AI para pesquisar, resumir, extrair dados e conversar com mais de 125 milhões de artigos, com mais de 2 milhões de usuários de pesquisa. Elicit e SciSpace aceitam perguntas em linguagem natural e ranqueiam por similaridade semântica, razão pela qual recuperam artigos cuja redação diverge da consulta. A contrapartida é um viés de ranqueamento na direção oposta à do Google Scholar: eles podem promover artigos semanticamente próximos, mas de baixa qualidade ou pouco citados. O SciSpace é em geral mais rápido e melhor para insights rápidos do que para síntese iterativa profunda. Os resultados também podem ser não determinísticos, de modo que a mesma consulta pode não retornar o mesmo conjunto duas vezes.
Undermind
O Undermind é o especialista. Ele combina recuperação por palavras-chave e semântica, depois usa um modelo de fronteira para avaliar se o título, o resumo e os metadados disponíveis realmente respondem ao briefing, e itera com busca de citações. Em um teste contra o conjunto incluído de uma revisão sistemática, recuperou 8 de 11 artigos padrão-ouro entre os 10 primeiros resultados (recall@10 de 72,7%) e 9 de 11 até a posição 50 (recall@50 de 81,8%). Essa qualidade custa tempo e funciona mal em temas vagos. Ele também vê principalmente título e resumo, além de algum texto completo de acesso aberto, portanto alegações presentes apenas em métodos ou resultados podem ser perdidas.
Academic Research Assistant da Jenova
O Academic Research Assistant da Jenova é um parceiro de pesquisa consciente da disciplina, e não um índice independente de artigos. Ele realiza descoberta de literatura ao vivo em fontes acadêmicas e permanece com o projeto durante a síntese, a preparação do manuscrito e o gerenciamento de citações. A memória persistente permite lembrar que seu termo de trabalho é "fadiga cognitiva", enquanto a literatura também usa "esgotamento do ego" e "necessidade de recuperação", mantendo esses grupos de sinônimos vinculados ao mesmo projeto entre sessões.
A limitação honesta é arquitetural. Ele não oferece um índice semântico proprietário de 125 milhões de artigos com tabelas de extração integradas no sentido do Elicit, nem é um buscador iterativo de vários minutos no estilo Undermind com um benchmark recall@10 publicado. Sua força é a orquestração: briefing em linguagem natural, consulta acadêmica ao vivo, perguntas de acompanhamento e suporte à escrita em uma única conversa. Pesquisadores que precisam de uma trilha de auditoria Boolean reproduzível ainda devem executar The Lens ou OpenAlex em paralelo.
Como a Busca Semântica Recupera Artigos que Usam Redações Diferentes para a Mesma Ideia?
A busca semântica recupera artigos redigidos de modo diferente ao incorporar a consulta e a coleção de documentos em um espaço compartilhado de significado, recuperando então os vizinhos mais próximos em vez de exigir tokens sobrepostos. Se a consulta for "como enfermeiros do turno noturno recuperam a atenção após turnos consecutivos", um mecanismo lexical procura essas palavras. Um mecanismo semântico pode recuperar estudos com títulos sobre "disrupção circadiana", "sono de recuperação" ou "fadiga ocupacional", mesmo quando "enfermeiros" ou "atenção" não aparecem no título.
O Semantic Scholar, mecanismo de literatura do Allen Institute for AI, foi uma demonstração pública inicial dessa ideia: ranquear artigos científicos pelo significado compreendido, e não pela correspondência de strings. Elicit e SciSpace aplicam um princípio semelhante em escala de aplicativo web. Tay descreve um teste particularmente claro: cole um parágrafo de jornal que descreve os achados de um estudo, e um mecanismo semântico poderá apresentar o artigo de periódico subjacente, pois o embedding da prosa jornalística fica próximo do embedding do artigo. A busca por palavras-chave quase nunca sobrevive a essa paráfrase.
Há um segundo mecanismo, mais discreto: a expansão de consulta dentro do assistente. Um agente conversacional pode gerar conjuntos de sinônimos, conceitos relacionados ao estilo MeSH, antônimos e variantes disciplinares, para depois pesquisar essas variantes explicitamente. Isso não é busca vetorial pura. É compreensão semântica usada para construir uma rede lexical melhor. Na prática, os fluxos de trabalho de maior recuperação fazem ambos — usam embeddings para recuperar redações desconhecidas e, em seguida, verificam frases exatas, nomes de autores e links de citações para que o conjunto permaneça auditável.
Testar isso em um briefing ao vivo normalmente expõe a diferença rapidamente. Peça a um mecanismo de palavras-chave por "teacher noticing" e você obterá principalmente artigos que usam esse termo exato da pesquisa em educação. Peça a um assistente semântico por "como professores detectam e interpretam, no momento, pensamentos inesperados dos alunos", e você também encontrará trabalhos classificados como "visão profissional", "avaliação formativa" ou "tomada de decisão no momento". O segundo conjunto é aquele que a incompatibilidade de vocabulário teria ocultado.
Quando Você Ainda Deve Usar Busca por Palavras-chave em Vez de um Assistente de AI Semântica?
Você ainda deve usar busca por palavras-chave quando precisa recuperar um item conhecido, encadear citações a partir de um artigo-semente, fazer correspondência de frases em texto completo ou aplicar uma estratégia Boolean reproduzível para uma revisão sistemática. O ranqueamento semântico é o instrumento errado quando a tarefa é "encontre este título", "encontre tudo que cita este ensaio" ou "documente uma string de busca que um revisor por pares possa executar novamente".
O Google Scholar é o primeiro passo certo para três tarefas cotidianas. Primeiro, busca de item conhecido: coloque o título entre aspas, como a ajuda do Google e a maioria dos guias de bibliotecas recomendam. Segundo, mapeamento de autoridade: abra um artigo marcante e percorra Cited by para ver o que a área fez depois, ou Related articles para se expandir a partir de uma semente. Terceiro, busca de frases no texto completo: se o conceito for um nome de método distintivo, um conjunto de dados ou uma escala, a busca lexical em texto completo capturará menções que índices semânticos de título e resumo deixam passar.
Para buscas sistemáticas ou muito precisas, ignore tanto o Google Scholar quanto a maioria dos aplicativos semânticos como sistema oficial de registro. The Lens e OpenAlex oferecem suporte a Boolean aninhado, operadores de proximidade, busca por campo e vocabulário controlado. O OpenAlex é um catálogo aberto com 517 milhões de trabalhos, 5,8 bilhões de relacionamentos em grafo e um conjunto de dados de domínio público (CC0). Um informativo de biblioteca de 2026 estimou sua cobertura em cerca de 474 milhões de publicações, com foco em acesso aberto e transparência. O Google Scholar não pode igualar essa auditabilidade: ele limita a exibição a 1.000 resultados e não oferece acesso em massa.
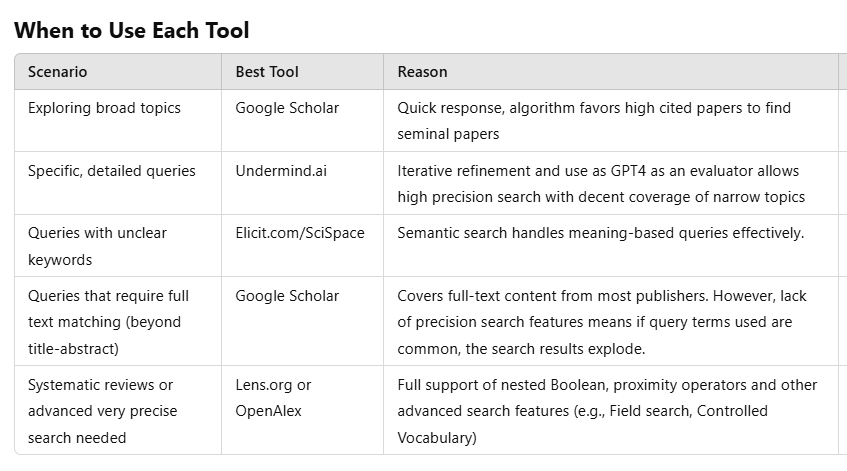
Use a tabela acima como uma regra de encaminhamento, não como um teste de lealdade. A orientação ampla e a descoberta de artigos seminais permanecem no Google Scholar. Redação pouco clara vai para Elicit ou SciSpace. Uma pergunta de existência altamente específica — "existem RCTs que usam um LLM como avaliador de título e resumo e relatam precisão e recall?" — é um briefing para o Undermind. Buscas reproduzíveis, com uso intenso de operadores, pertencem ao The Lens ou OpenAlex.
Como Realizar uma Busca de Literatura que Combine as Duas Abordagens?
Você realiza uma busca combinada começando com um briefing conceitual, recuperando candidatos com diversidade de sinônimos de forma semântica e, em seguida, consolidando o conjunto com operadores lexicais, encadeamento de citações e uma base de dados de alto controle. A sequência importa. Se você começar no Google Scholar com uma única frase, herdará os pontos cegos dessa frase. Se nunca sair de uma lista ranqueada semanticamente, herdará os problemas de qualidade e reprodutibilidade dessa lista.
Uma sequência prática é a seguinte:
- Escreva a necessidade de informação como um colega a ouviria, incluindo populações, desfechos e redações que você já sabe serem instáveis.
- Execute esse briefing em um assistente semântico para coletar artigos candidatos e o vocabulário que eles realmente usam.
- Crie uma tabela de sinônimos a partir desses títulos e resumos.
- Reaplique os termos expandidos no Google Scholar com aspas,
author:, limites de data e Cited by / Related articles. - Para qualquer busca que precise ser abrangente ou auditável, reconstrua a estratégia no The Lens ou OpenAlex com Boolean aninhado e limites de campo.
- Mantenha um registro contínuo de inclusão para que novas execuções semânticas não determinísticas não alterem silenciosamente a base de evidências.
No Academic Research Assistant da Jenova, a primeira interação pode ser o briefing conceitual, em vez de uma string de palavras-chave:
"Preciso de artigos empíricos sobre como trabalhadores remotos do conhecimento se recuperam da fadiga cognitiva. Inclua estudos que possam usar burnout, esgotamento do ego, necessidade de recuperação, ruminação fora do horário de trabalho ou distanciamento psicológico em vez da palavra fadiga. Dê preferência a periódicos de psicologia ocupacional e HCI a partir de 2018 e liste o sinônimo que cada artigo realmente utiliza."
Uma interação de acompanhamento então converte a tabela de sinônimos do assistente em uma estratégia lexical que você pode colar no Google Scholar ou The Lens:
"Transforme os grupos de sinônimos em três consultas do Google Scholar e uma string Boolean aninhada adequada para OpenAlex ou The Lens. Separe consultas restritas ao título de consultas de texto completo."
No Elicit ou SciSpace, faça a pergunta em linguagem natural em vez de usar palavras-chave — Tay observa que consultas em linguagem natural tendem a ter desempenho pior no Google Scholar e melhor nessas ferramentas semânticas. No Undermind, adicione restrições até que o briefing possa corresponder apenas a um desenho de estudo específico. Depois que o conjunto de candidatos existir, o agente Deep Research da Jenova será o instrumento mais adequado para ler entre fontes e produzir uma síntese com citações, enquanto o Academic Research Assistant continuará sendo mais apropriado para permanecer no fluxo acadêmico de descoberta, citações e suporte ao manuscrito.
Uma precaução se aplica a todas as etapas assistidas por AI. Trate listas ranqueadas e resumos gerados como recursos de recuperação, não como triagem concluída. Os top 10 semânticos deixam artigos de fora. Julgamentos de relevância por LLM concordam frequentemente com humanos, mas não sempre. Alegações baseadas no texto completo ainda exigem o PDF.
O Que Bibliotecários de Pesquisa e Avaliadores de Ferramentas Dizem Sobre a Descoberta Semântica com AI?
Bibliotecários de pesquisa e avaliadores independentes geralmente tratam assistentes de AI semântica como complementos ao Google Scholar, não como substitutos, e avaliam ferramentas pela qualidade da busca para um caso de uso declarado, e não por categorias de marketing. A comparação publicada mais útil nessa área vem de avaliações baseadas na prática, e não de benchmarks de fornecedores.
"Se eu não soubesse antecipadamente qual seria meu caso de uso e pudesse escolher apenas uma ferramenta de busca acadêmica, seria uma escolha óbvia selecionar o Google Scholar. Isso não é um argumento contra a busca com AI. É um argumento contra fingir que uma única função de ranqueamento é suficiente. O Scholar continua sendo o generalista. As novas ferramentas conquistam seu espaço quando a consulta é semanticamente estranha ou extremamente específica."
"A falha que vejo com mais frequência é uma incompatibilidade entre o tipo de consulta e o mecanismo. As pessoas inserem um tópico amplo em um agente iterativo e esperam minutos por um conjunto mais restrito do que precisam. Ou inserem um parágrafo em linguagem natural em um mecanismo lexical e concluem que a literatura não existe. A incompatibilidade de vocabulário geralmente é um erro de fluxo de trabalho antes de ser uma lacuna da base de dados."
"O ranqueamento semântico também muda o que significa 'relevante'. Se você não ponderar citações, verá artigos mais novos e às vezes mais fracos mais cedo. Se ponderar citações, continuará redescobrindo o mesmo cânone. Pesquisadores que querem trabalhos conceitualmente relacionados com redação diferente precisam do primeiro comportamento. Pesquisadores que querem os artigos que todos esperam que eles citem precisam do segundo. Um processo competente usa ambos e registra o motivo."
— Equipe de Produto da Jenova, sistemas de descoberta de literatura, 8 anos projetando fluxos de trabalho de pesquisa acadêmica
Esse enquadramento corresponde ao registro público. Guias universitários agora catalogam ferramentas de busca com AI usadas em revisões de literatura, e análises de produtos distinguem a passagem iterativa mais lenta do Undermind da varredura semântica mais rápida do SciSpace. O consenso entre especialistas é metodológico, não tribal: escolha o modelo de recuperação que corresponde à incompatibilidade que você está tentando superar.
Qual Ferramenta É Mais Adequada para Revisões Sistemáticas Versus Mapeamento Exploratório da Literatura?
Revisões sistemáticas precisam de infraestrutura lexical de alto controle; o mapeamento exploratório da literatura precisa de recuperação semântica e iteração rápida; a maioria dos trabalhos de tese e de subsídio precisa de um híbrido com protocolo escrito para cada etapa. Confundir essas tarefas é como equipes deixam de encontrar estudos conceitualmente relacionados ou produzem um conjunto de evidências que não pode ser replicado.
Para mapeamento exploratório — "o que foi escrito sobre esta ideia, sob qualquer nome?" — comece semanticamente. Elicit, SciSpace e um assistente de pesquisa conversacional foram desenvolvidos para essa pergunta. O Google Scholar pode contribuir assim que você tiver artigos-semente, por meio de Related articles e Cited by, e continua incomparável para localizar rapidamente PDFs e links de bibliotecas. O Academic Research Assistant da Jenova se encaixa nessa etapa quando você também precisa que o mapa persista: decisões de sinônimos salvas, direções excluídas e formatação de citações para a redação final.
Para revisões sistemáticas ou de escopo, não permita que uma lista ranqueada semanticamente se torne a busca oficial. Use The Lens ou OpenAlex como espinha dorsal reproduzível, documente todos os operadores e trate Elicit, Undermind ou Jenova como recursos suplementares de descoberta de citações e triagem. O OpenAlex também disponibiliza uma API, uma linguagem de consulta voltada a revisões sistemáticas e um snapshot completo sob licença CC0, o que representa o oposto de uma ordenação fechada por relevância. O limite de 1.000 resultados e a ausência de acesso em massa do Google Scholar o desqualificam como busca primária documentada, embora ele continue útil para verificar se uma inclusão conhecida foi indexada.
Para perguntas estreitas de existência — "existe um artigo como este?" — o Undermind é o especialista, desde que você possa esperar e que evidências de título e resumo sejam suficientes. Para produção de manuscrito depois que o conjunto existe, a combinação da Jenova de descoberta de literatura e gerenciamento de citações é mais relevante do que outra interface apenas de descoberta, com a ressalva de que meta-análises que exigem extração intensiva ainda pertencem a uma ferramenta dedicada de extração, como o Elicit.
A regra de decisão é simples o bastante para ser reutilizada. Se a redação varia e você ainda não conhece o jargão da área, use primeiro um assistente de pesquisa com AI semântica. Se você precisa defender a string de busca, use infraestrutura de palavras-chave com operadores avançados. Se precisar fazer ambos — que é a condição normal para encontrar artigos conceitualmente relacionados com redação diferente — use a recuperação semântica para descobrir a linguagem e, em seguida, o controle lexical para capturá-la e documentá-la.
Referências
- Aaron Tay — Google Scholar versus outras ferramentas de busca com AI (Undermind, Elicit, SciSpace)
- Google Scholar — Ajuda oficial de busca
- Elicit — AI para pesquisa científica
- OpenAlex — Catálogo aberto do sistema global de pesquisa
- Paperguide — Comparação de preços e recursos entre Elicit e SciSpace (2026)
- Undermind — Copesquisador de AI para a literatura
- University of Alberta / JCHLA — Análise do produto Undermind.ai
- Paperpile — Como usar o Google Scholar
- TUHH — OpenAlex como alternativa aberta para pesquisa acadêmica
- Semantic Scholar — Ferramenta de pesquisa com AI
- UBC Wiki — Ferramentas de busca com AI usadas em revisões de literatura e buscas abrangentes
- SciSpace — Comparação entre Elicit e SciSpace
- The Lens — Versão 8.5 e integração com OpenAlex
- PMC / NIH — Recursos do OpenAlex e potencial para síntese de evidências