Backend de Agentes de AI: Uma API vs. Construir do Zero (Julho de 2026)
2026-07-24
Todas as equipes de engenharia que lançam recursos de AI em 2026 chegam à mesma encruzilhada: construir o backend de agentes do zero ou integrar uma solução. Construir significa conectar APIs de modelos, frameworks de orquestração, bancos de dados vetoriais, armazenamentos de memória e servidores de ferramentas — uma stack que consome trimestres de tempo de engenharia antes da primeira interação do usuário. A Jenova Agent API é a alternativa: um backend de agentes totalmente gerenciado, no qual orquestração, memória, armazenamento, RAG e ferramentas funcionam por meio de uma única integração.
- ✅ Substitua toda a stack DIY de agentes — roteamento de modelos, orquestração, memória, RAG e ferramentas — por uma única API
- ✅ Crie e lance agentes personalizados de nível de produção, definidos por suas instruções, modelos, bases de conhecimento e ferramentas
- ✅ Acesse modelos da OpenAI, Anthropic, Google, xAI, Qwen e muito mais com uma única credencial
- ✅ Execute em uma infraestrutura testada em produção com mais de 30.000 usuários em mais de 70 países
Para tomar a decisão entre construir ou integrar com honestidade, você precisa dos números reais — quanto um backend de agentes construído do zero realmente custa para criar, operar e manter em 2026.
Resposta Rápida: O Que É um Backend de Agentes de AI?
Um backend de agentes de AI é a camada de infraestrutura que faz um agente funcionar em produção: orquestração entre modelos e ferramentas, memória e contexto persistentes, recuperação sobre dados privados e os sistemas subjacentes de computação, escalabilidade e confiabilidade. Construí-lo do zero significa assumir a responsabilidade por cinco ou mais sistemas distintos; uma API de agentes gerenciada oferece todos eles por meio de uma única integração.
Principais recursos de um backend de agentes gerenciado:
- Orquestração de agentes que coordena modelos, ferramentas, memória e recuperação em fluxos de trabalho de múltiplas etapas
- Roteamento entre vários modelos e provedores — sem vendor lock-in e sem gerenciamento de chaves por provedor
- Memória e contexto de conversação ilimitados integrados a cada sessão
- Armazenamento relacional e vetorial totalmente gerenciado, com RAG integrado
- Integração de ferramentas por meio de ferramentas nativas da plataforma e qualquer servidor MCP remoto
O Problema: Quanto Construir do Zero Realmente Custa
A pressão do mercado para lançar agentes é intensa. O software empresarial está a caminho de incluir AI agêntica em 33% das aplicações — acima dos menos de 1% em 2024 (Datagrid) — e 67% dos executivos de nível C esperam que agentes de AI operem de forma independente dentro de suas organizações até 2027 (VAST Data).
Mas construir o backend para suportar um deles é brutalmente caro e lento:
- Lógica de orquestração que se transforma em uma segunda disciplina de engenharia
- APIs de modelos sem estado e sem memória entre chamadas
- Pipelines de RAG com modos de falha recorrentes e documentados
- Infraestrutura de integração de ferramentas para cada capacidade externa
- Infraestrutura de produção que precisa escalar, permanecer confiável e passar por revisões de segurança
- Um custo total no primeiro ano que supera em muito todas as estimativas de protótipos
O Orçamento Real: Chamadas de Modelo São Apenas 2% da História
A demonstração de um "agente de US$ 100/mês" esconde a estrutura de custos real. Uma análise detalhada de engenharia estima que o custo realista do primeiro ano para um agente de produção pequeno ou médio seja de **US$ 270.000–US$ 690.000** — com chamadas de API de modelos representando cerca de 2% do total (Particle41).
O restante vai para onde nenhum vídeo de demonstração mostra:
US$ 30.000–US$ 80.000 — somente para engenharia e refinamento iniciais de prompts, em 200–400 horas de engenharia cotadas a US$ 150–200/hora (Particle41)
US$ 1.000–US$ 5.000/mês — hospedagem do banco de dados vetorial, além de outros US$ 1.000–US$ 2.000/mês para geração de embeddings (Particle41)
US$ 30.000–US$ 60.000 — engenharia de integração de dados para conectar o agente a apenas 4–5 sistemas existentes (Particle41)
US$ 6.000–US$ 10.000/mês por FTE — supervisão humana para revisão de falhas, porque até mesmo um agente com 95% de precisão que gerencia 10.000 interações mensais produz 500 casos que exigem revisão manual (Particle41)
E isso não termina no lançamento: o segundo ano ainda custa US$ 150.000–US$ 300.000 por ano em operação e refinamento (Particle41). Até mesmo estimativas mais restritas, exclusivamente de desenvolvimento, variam de US$ 20.000–US$ 60.000 para agentes de tarefas simples (Biz4Group) e de US$ 10.000–US$ 400.000+ para sistemas multiagente (Azilen).
A Orquestração Se Torna um Produto Próprio
Um agente de produção não responde apenas uma vez — ele planeja, chama ferramentas, recupera contexto, avalia resultados intermediários e se recupera de erros em execuções de múltiplas etapas. Construir esse ciclo de coordenação requer máquinas de estado, lógica de repetição, tratamento de timeout e proteções de custo que não têm nada a ver com o seu produto propriamente dito.
Profissionais descrevem essa lacuna de forma direta: construir um agente leva dias — levá-lo à produção leva seis meses, com loops desprotegidos elevando contas de API e estado perdido destruindo tarefas de longa duração (
). Frameworks como LangGraph e CrewAI fornecem abstrações para essa camada (Speakeasy), mas abstrações não se executam sozinhas: você ainda precisa hospedar, escalar, proteger e manter tudo que está por baixo.Pipelines de RAG São Uma Obrigação Permanente, Não um Projeto
Basear um agente em seus dados privados significa assumir ingestão, segmentação, embedding, indexação, reranking e síntese — e profissionais alertam consistentemente que um pipeline de RAG "não só é mais difícil do que parece, como também exige experiência contínua em LLMs, recuperação e MLOps especializado" (Vectara).
Um estudo de caso documentado: um projeto interno de RAG "simples" que começou em janeiro tinha, em março, consumido um engenheiro em tempo integral depurando alucinações, um engenheiro de dados em tempo integral enfrentando problemas de ingestão e um engenheiro DevOps lutando com a infraestrutura — com o orçamento triplicado (Towards AI). O mesmo relato documenta o ciclo de vida típico de oito semanas: problemas de latência, casos extremos, uma reescrita completa, novos problemas de alucinação, uma migração de banco de dados vetorial e outra reescrita.
A Infraestrutura Legada Não Foi Criada para Agentes
As cargas de trabalho de agentes exigem acesso contínuo e em tempo real aos dados — e a infraestrutura de dados legada, criada para cargas de trabalho transacionais, "não consegue suportar o raciocínio contínuo e a execução de ações exigidos por agentes de AI autônomos" (VAST Data). Uma infraestrutura de agentes de nível empresarial exige uma base de dados unificada, armazenamento de alto desempenho, vetorização em tempo real, orquestração inteligente e governança de confiança zero — cinco camadas distintas de capacidade antes de você escrever a lógica do produto.
40% — dos projetos de AI agêntica que falham devido a fundações de infraestrutura inadequadas (Landbase)
Este é exatamente o problema que a Jenova Agent API foi criada para eliminar.
A Solução: A Jenova Agent API
A Jenova Agent API é um serviço de infraestrutura de agentes totalmente gerenciado: uma integração que substitui a stack DIY de APIs de modelos, frameworks de orquestração, bancos de dados vetoriais, armazenamentos de memória e servidores de ferramentas. Você define as instruções do seu agente, seleciona um modelo, envia uma base de conhecimento e configura ferramentas — a API cuida da orquestração, memória, armazenamento e escalabilidade, para que você lance agentes personalizados de nível de produção em dias, e não em trimestres.
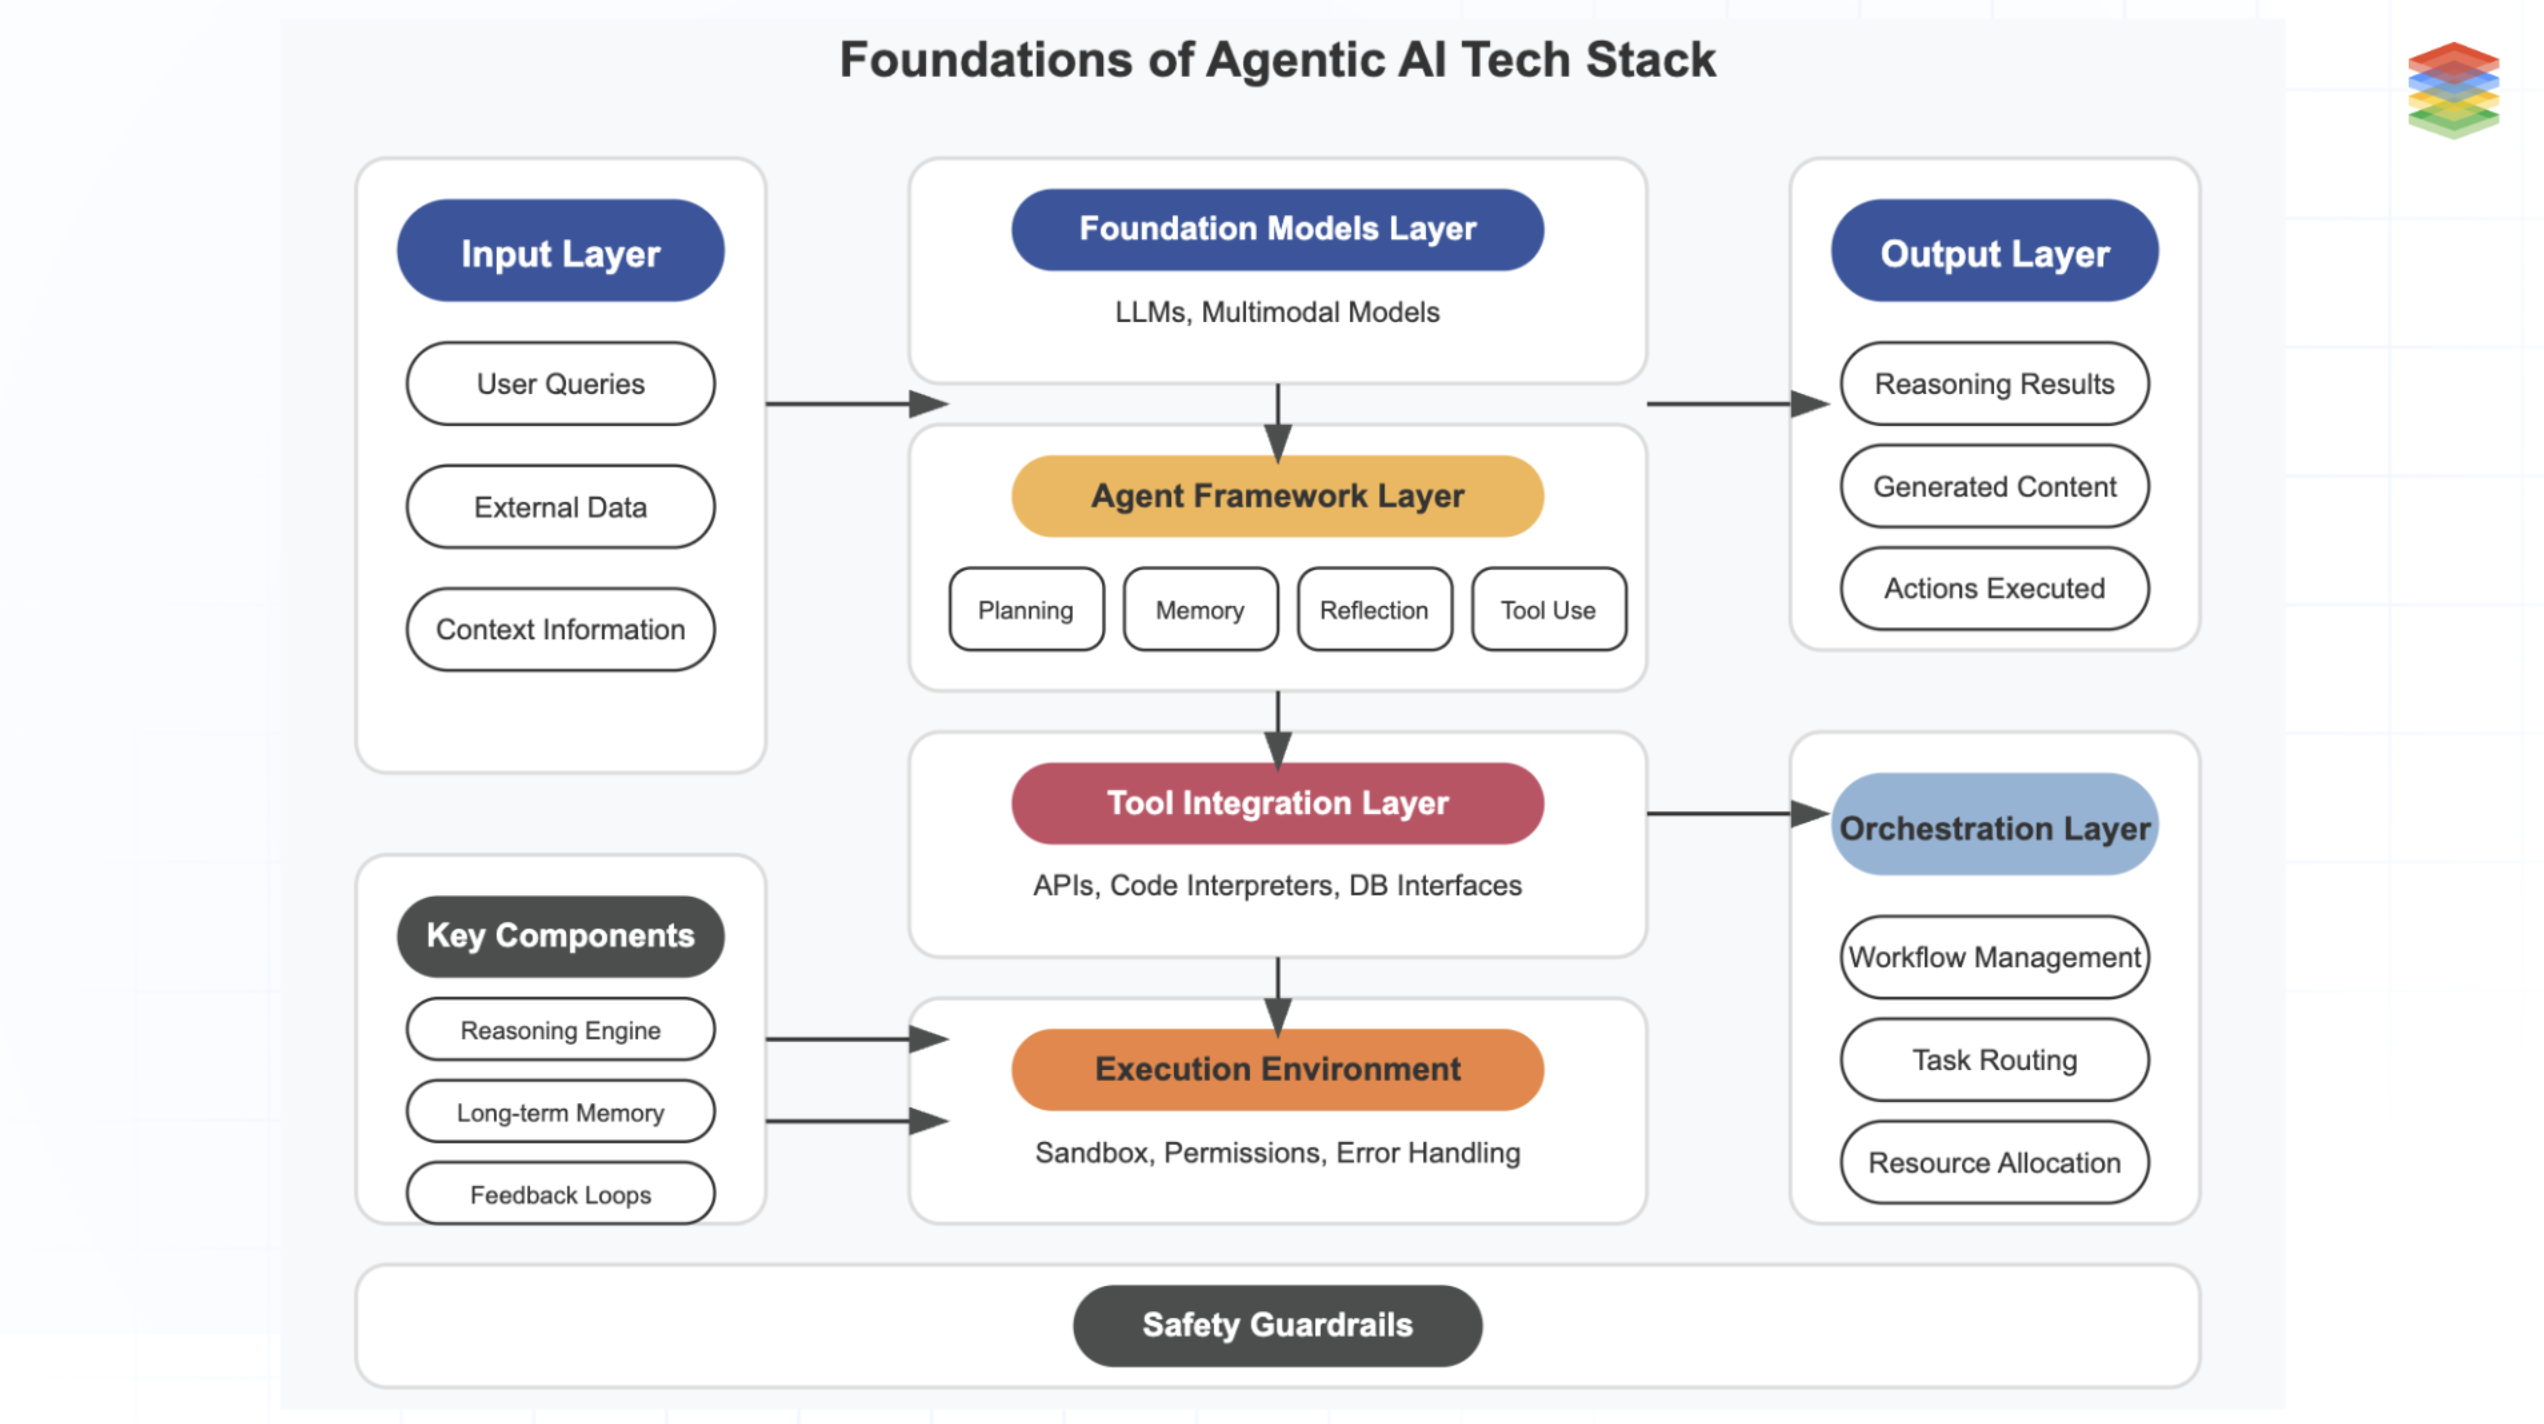
Cada camada no diagrama acima — o planejamento, a memória, a reflexão e o uso de ferramentas do framework de agentes; as APIs e interfaces de banco de dados da camada de integração de ferramentas; o sandboxing e o tratamento de erros do ambiente de execução; o gerenciamento de fluxos de trabalho e o roteamento de tarefas da camada de orquestração — é infraestrutura que o caminho DIY obriga você a construir. A Jenova Agent API executa tudo isso.
| Backend DIY de Agentes | Jenova Agent API |
|---|---|
| Grafos de orquestração personalizados, lógica de repetição, esquemas de estado | Orquestração comprovada em produção que coordena modelos, ferramentas, memória e recuperação |
| SDKs, chaves e limites de taxa separados para cada provedor de modelo | Qualquer modelo importante por meio de uma única integração — sem vendor lock-in |
| Estado de sessão em Redis/Postgres com serialização personalizada | Memória e contexto ilimitados integrados a cada sessão |
| Banco de dados vetorial provisionado, pipelines de segmentação e embedding (US$ 1.000–US$ 5.000/mês) | Armazenamento relacional e vetorial totalmente gerenciado, com RAG integrado |
| Wrappers de ferramentas escritos manualmente, fluxos de autenticação e boilerplate de erros | Ferramentas nativas da plataforma e qualquer servidor MCP remoto, prontos para uso |
| Servidores, contêineres, políticas de escalabilidade e monitoramento de disponibilidade | Infraestrutura gerenciada de nível de produção com APIs estáveis |
Orquestração de Agentes
Raciocínio de múltiplas etapas, invocação de ferramentas, recuperação e síntese de respostas são executados dentro da plataforma — sem definições de grafos, esquemas de estado ou DAGs de fluxo de trabalho para criar e manter. Você define o que o agente deve realizar; a infraestrutura determina como, com a execução limitada e controlável que a confiabilidade em produção exige.
Use Qualquer Modelo
Potencialize agentes com modelos da OpenAI, Anthropic, Google, xAI, Qwen e muito mais usando uma única credencial. Execute um modelo de ponta para raciocínio complexo e um modelo econômico para sessões de alto volume — alterne livremente por agente, sem gerenciamento de chaves por provedor e sem trabalho de migração quando novas gerações de modelos forem lançadas. Suas camadas de memória e conhecimento sobrevivem a cada mudança.
Memória e Contexto
Memória e contexto de conversação ilimitados estão integrados a cada sessão. Forneça um identificador de sessão consistente e seu agente lembrará o histórico, as preferências e os projetos de longa duração de cada usuário — sem armazenamentos de estado externos, sem código de serialização e sem engenharia de janela de contexto. A camada mais propensa a falhas da stack DIY simplesmente deixa de existir para você.
Armazenamento Totalmente Gerenciado
Bancos de dados relacionais e vetoriais gerenciados com RAG integrado. Envie documentos e bases de conhecimento; a plataforma cuida da segmentação, do embedding, da indexação e da recuperação. Não há banco de dados vetorial para provisionar, ajustar ou escalar — o item de custo de US$ 1.000–US$ 5.000/mês, e o engenheiro que o mantém, desaparecem.
Ferramentas e MCP
Integrações ilimitadas de ferramentas com ferramentas nativas da plataforma e qualquer servidor MCP remoto, prontas para uso — busca, e-mail, calendários, documentos e suas próprias APIs internas. Sem código de wrapper, sem infraestrutura para fluxos de autenticação e sem boilerplate para manter à medida que APIs de terceiros mudam.
Nível de Produção
Infraestrutura totalmente gerenciada com APIs estáveis, criada para tráfego de produção — sem servidores, contêineres ou políticas de escalabilidade do seu lado. A plataforma foi testada em produção com mais de 30.000 usuários em mais de 70 países, para que seus agentes herdem uma confiabilidade que sua equipe nunca precisará construir.
Uma única chamada executa o agente completo:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
Orquestração, memória, recuperação e chamadas de ferramentas são executadas dentro dessa solicitação. Sua aplicação renderiza a resposta; a plataforma assume tudo o que existe por trás dela.
O Que Você Pode Criar
A API foi projetada para desenvolvedores que lançam agentes personalizados e com estado como recursos dentro de seus próprios produtos. Cada item a seguir é uma aplicação que você pode criar e lançar — defina as instruções e a base de conhecimento do agente, e a API cuida da orquestração, memória e escalabilidade.
Um Agente de Suporte Treinado no Seu Produto
Crie um agente de suporte baseado na sua central de ajuda, changelog e histórico de tickets. A memória de sessão acompanha toda a jornada de suporte de cada cliente entre as interações — chega de "você pode repetir o número da sua conta?"
- Indexação e recuperação de documentos gerenciadas de ponta a ponta
- Sistemas de tickets e CRM conectados via MCP
- Lance em dias, em vez de gastar um trimestre no gerenciamento de estado
Um Analista Financeiro Integrado
Lance um consultor de portfólio dentro do seu dashboard fintech que se lembra das posições, da tolerância a risco e dos objetivos de cada cliente ao longo de meses de conversas.
- Contexto de consultoria longitudinal mantido automaticamente
- Dados de mercado e sistemas de contas conectados via MCP
- Troca de modelo conforme a complexidade da consulta para otimização de custos
Um Tutor Personalizado para Sua Plataforma de Aprendizado
Implante um tutor adaptativo que acompanha o progresso, as áreas de dificuldade e as preferências de cada aluno entre as sessões, baseado em seu currículo.
- Memória por aluno sem linhas de banco de dados por usuário para gerenciar
- Atualizações do currículo são implantadas no envio, sem reengenharia de recuperação
- Escala para milhares de alunos simultâneos em infraestrutura gerenciada
Um Assistente de Comércio que Conhece Seu Catálogo
Integre um assistente de compras conversacional que conhece seu catálogo, lembra as preferências e o histórico de compras de cada cliente e orienta a descoberta por meio do diálogo, em vez de filtros.
- Catálogo baseado em RAG gerenciado — atualizações são implantadas instantaneamente
- Memória de preferências por cliente sem armazenamentos de estado externos
- Concorrência de nível de produção para picos de tráfego
Um Agente de Operações Internas para Sua Equipe
Crie um agente de operações conectado à sua documentação interna, sistemas de tickets e sistemas de dados — respondendo a perguntas de colaboradores e executando fluxos de trabalho rotineiros com todo o contexto organizacional.
- Base de conhecimento privada indexada automaticamente
- APIs internas conectadas por servidores MCP remotos
- Novos recursos são implantados como configuração, não como código
Obtenha sua chave de API e lance seu primeiro agente em minutos.
Como Funciona: Da Chave de API ao Agente de Produção em Quatro Etapas
Etapa 1: Obtenha Sua Chave de API
Crie uma conta e gere sua chave de API no dashboard da plataforma. Uma credencial cobre todos os provedores de modelo e todos os agentes que você criar — sem gerenciamento de chaves por fornecedor entre desenvolvimento, staging e produção.
Etapa 2: Crie ou Escolha Seu Agente
Defina um agente personalizado com suas próprias instruções, modelo preferido, base de conhecimento e configuração de ferramentas — ou comece com um agente pré-criado e adapte-o. Criar o agente é uma configuração, não código: você descreve o comportamento, e a plataforma fornece a orquestração, memória e recuperação por trás dele.
Etapa 3: Adicione Créditos
Adicione créditos à sua conta. O uso é descontado do seu saldo a cada chamada — sem contas separadas de infraestrutura, faturas de banco de dados vetorial ou custos de armazenamento de memória escondidos em segundo plano.
Etapa 4: Faça a Chamada
No seu backend, encaminhe a mensagem do usuário com o ID do agente e um identificador de sessão. Reutilize o ID da sessão e o agente continuará exatamente de onde parou com aquele usuário:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
Sem armazenamento de memória para configurar, pipeline de recuperação para manter ou grafo de orquestração para depurar. Especificações completas de endpoints, esquemas de solicitação e resposta e detalhes de integração estão na documentação da API.
Resultados e Casos de Uso
💼 Startup SaaS: Um Sprint em Vez de US$ 270 Mil–US$ 690 Mil
Cenário: Uma empresa B2B SaaS com 3.000 clientes quer um agente de suporte no App que conheça sua documentação e se lembre do histórico de cada conta — com uma equipe de engenharia de três pessoas.
Abordagem Tradicional: O caminho DIY é estimado em US$ 270.000–US$ 690.000 para o primeiro ano (Particle41): seleção de framework de orquestração, provisionamento de banco de dados vetorial, memória por tenant em Redis ou Postgres, wrappers de ferramentas para o sistema de tickets e, depois, hospedagem, escalabilidade e monitoramento — antes da primeira resposta voltada ao cliente.
Jenova Agent API: Defina instruções de suporte e regras de escalonamento, envie a central de ajuda e conecte o sistema de tickets via MCP. A memória persistente de sessão oferece a cada conta um histórico contínuo de suporte desde o primeiro dia.
- ✅ Dias até a produção, em vez de meses
- ✅ Orçamento de infraestrutura de seis dígitos redirecionado para engenharia de produto
- ✅ Nenhum sistema de memória ou banco de dados vetorial para provisionar ou manter
📊 Fintech: Um Recurso de Consultoria Sem uma Equipe de Backend
Cenário: Uma fintech quer um analista de portfólio de AI como recurso premium do dashboard. Seus dois engenheiros de backend nunca construíram infraestrutura de agentes.
Abordagem Tradicional: Aprender um framework de orquestração, criar fluxos de trabalho de consultoria com estado, implementar persistência de memória para relacionamentos contínuos com clientes, provisionar RAG para documentos financeiros — a mesma lacuna de quatro a seis meses até a produção que profissionais descrevem entre protótipo e lançamento (
).Jenova Agent API: Configure um agente analista financeiro com instruções de domínio, conecte dados de mercado via MCP e deixe a memória integrada manter o contexto do portfólio em todas as conversas de consultoria.
- ✅ Nenhum framework para aprender, hospedar ou manter
- ✅ Memória longitudinal de clientes pronta para uso
- ✅ Troca de modelos para otimização de custos sem nenhuma alteração de código
📱 EdTech Mobile: Tutoria para 30.000 Alunos Simultâneos
Cenário: Um App de educação móvel que atende 30.000 alunos precisa de tutores personalizados em quatro disciplinas, cada um com conhecimento curricular e acompanhamento de progresso por aluno.
Abordagem Tradicional: Configurações de agentes por disciplina, persistência de memória por aluno em bancos de dados externos, armazenamento vetorial para o currículo — além de infraestrutura que sustente dezenas de milhares de sessões simultâneas com estado sem perder o contexto. Esta é exatamente a carga de trabalho em que a infraestrutura legada falha (VAST Data).
Jenova Agent API: Crie um agente tutor para cada disciplina com instruções e materiais específicos do currículo. A memória de sessão persiste automaticamente o progresso de cada aluno; o RAG indexa o currículo no envio.
- ✅ Contexto de aprendizado persistente e personalizado, sem armazenamentos de estado externos
- ✅ Atualizações de currículo são implantadas sem reengenharia de recuperação
- ✅ Concorrência de nível de produção desde o primeiro dia
🎯 Agência de Produto: Quatro Clientes, Uma Integração
Cenário: Uma agência de desenvolvimento está criando recursos de AI para quatro clientes — triagem na área de saúde, revisão de documentos jurídicos, descoberta de comércio e busca empresarial. O caminho DIY significa duplicar armazenamentos de memória, pipelines de RAG e hospedagem para cada cliente.
Abordagem Tradicional: Quatro stacks de agentes separadas — quatro pipelines de recuperação, quatro configurações de escalabilidade, quatro obrigações de manutenção. Considerando que 40% dos projetos agênticos falham em fundações inadequadas (Landbase), replicar quatro vezes a camada mais arriscada é uma aposta em nível de portfólio.
Jenova Agent API: Uma integração e uma chave de API para os quatro clientes. Agentes personalizados por projeto — instruções de domínio, modelos, bases de conhecimento e ferramentas — todos executados no mesmo backend gerenciado.
- ✅ Uma única integração escala para projetos ilimitados de clientes
- ✅ Seleção de modelo por cliente sem gerenciamento de provedores por cliente
- ✅ Tempo de engenharia investido na lógica do produto, não na replicação de infraestrutura
FAQ
Quanto custa construir um backend de agentes de AI do zero?
Análises de engenharia estimam que o custo realista do primeiro ano de um agente de produção seja de US$ 270.000–US$ 690.000 quando se incluem infraestrutura, engenharia de prompts, testes, integração de dados, bancos de dados vetoriais e supervisão humana — com chamadas de API de modelos representando cerca de 2% do total (Particle41). A operação contínua custa US$ 150.000–US$ 300.000 por ano depois disso.
Como funcionam os preços e os créditos da Jenova Agent API?
O uso é baseado em créditos: você adiciona créditos à sua conta, e cada chamada de API é descontada do seu saldo. Não há custos separados de infraestrutura, banco de dados ou armazenamento de memória — a stack gerenciada está incluída no uso, consolidando o que, de outra forma, seriam cinco ou seis faturas de fornecedores em uma só. Veja as tarifas atuais na página da plataforma.
Quais modelos posso usar por meio da API?
Os agentes podem ser potencializados por modelos da OpenAI, Anthropic, Google, xAI, Qwen e muito mais com uma única integração. Você seleciona o modelo por agente e pode alternar livremente — não há vendor lock-in nem trabalho de migração quando novas gerações de modelos são lançadas. A memória e o conhecimento persistem entre alterações de modelo.
Quão difícil é a integração em comparação com construir usando LangChain ou APIs de modelos brutas?
A integração segue um fluxo de quatro etapas: obter uma chave de API, criar ou escolher um agente, adicionar créditos e fazer a primeira chamada. Uma solicitação POST executa o agente completo — com orquestração, memória, RAG e ferramentas incluídos. APIs de modelos brutas fornecem apenas inferência, e frameworks como LangChain fornecem abstrações que você ainda precisa hospedar, escalar e manter; a Jenova Agent API é o próprio backend gerenciado. Os esquemas completos estão na documentação da API.
Posso criar agentes personalizados com meus próprios dados e ferramentas?
Sim. Você define instruções personalizadas, envia uma base de conhecimento privada (indexada automaticamente por RAG gerenciado), seleciona seu modelo e configura ferramentas — incluindo qualquer servidor MCP remoto, que cobre a maioria das APIs internas. O agente se comporta como um recurso proprietário do seu produto, não como um assistente genérico.
Uma API de agentes gerenciada está pronta para produção com tráfego real?
Sim. A infraestrutura é totalmente gerenciada, com APIs estáveis criadas para tráfego de produção — sem servidores ou políticas de escalabilidade do seu lado. A plataforma foi testada em produção com mais de 30.000 usuários em mais de 70 países, e o uso escala com seu saldo de créditos, em vez de com uma infraestrutura que você precisa provisionar.
Conclusão
O caminho de construir um backend de agentes de AI do zero está bem documentado em 2026: US$ 270.000–US$ 690.000 em custos no primeiro ano, meses de engenharia de orquestração e RAG, um banco de dados vetorial e uma camada de memória para manter indefinidamente, além de uma lacuna até a produção que elimina 40% dos projetos antes do lançamento. A chamada de modelo nunca foi a parte difícil — tudo em torno dela é.
A Jenova Agent API substitui toda essa stack por uma única integração: agentes personalizados definidos por suas instruções, modelos, bases de conhecimento e ferramentas, executados em uma infraestrutura de nível de produção totalmente gerenciada, com orquestração, memória, armazenamento e ferramentas MCP integrados. Defina seu agente, faça a chamada e lance em dias o que o caminho DIY agenda em trimestres. Comece a criar com a documentação da API, obtenha sua chave de API na plataforma Jenova Agent API e explore a plataforma mais ampla em Jenova.