전문 AI 연구 보조 도구는 챗봇보다 더 신뢰할 수 있을까?
2026-08-22
추적성과 근거 기반은 연구 AI를 챗봇과 어떻게 구분하는가?
전문 학술 연구 보조 도구는 학술 색인에서 정보를 검색하고, 주장을 식별 가능한 문단에 연결하며, 이를 뒷받침하거나 반박하는 맥락을 보여 주기 때문에 인용 추적성과 근거 추출 측면에서 범용 AI 챗봇보다 신뢰성이 높습니다. 범용 챗봇은 학습 패턴을 바탕으로 유창한 서지 언어를 생성하므로, 출처로 되짚어 확인할 수 없는 저자, 제목, DOI, 연구 결과를 여전히 만들어 냅니다.
신뢰성 격차는 글쓰기 품질의 문제가 아닙니다. 주장을 감사할 수 있는지의 문제입니다.
인용 가능한 연구 지원과 챗봇 문체를 구분하는 핵심 요인:
✅ 생성 전 검색 — 답변이 다음 토큰 확률만으로 생성되는 것이 아니라 색인된 논문으로부터 구성됨 ✅ 문단 수준 출처 연결 — 추출된 각 결과가 논문 제목에만 연결되는 것이 아니라 문장, 표 또는 섹션을 가리킴 ✅ 모순의 가시성 — 주장을 지지하거나, 이의를 제기하거나, 단순히 언급하는 후속 연구가 하나의 요약으로 뭉개지지 않고 드러남 ✅ 구조화된 추출 — 방법, 표본, 결과, 한계가 바꿔 쓴 문단이 아니라 비교 가능한 필드로 추출됨 ✅ 사람이 확인할 수 있는 출처 이력 — 모든 요약, 인용, 추출 결과를 원문과 대조해 열어 볼 수 있음
2026년에 이러한 도구를 유용하게 비교하려면 인용 신뢰성을 브랜드 약속이 아니라 엔지니어링 속성으로 다루는 것이 도움이 됩니다. 이 글의 나머지 부분에서는 이 속성을 기준으로 챗봇과 연구 보조 도구를 평가합니다.
인용 신뢰성이 연구 진실성 문제가 된 이유는 무엇인가?
생성형 AI가 이제 출판 규모로 사용되는 반면 범용 모델은 가벼운 검토를 통과할 만큼 그럴듯해 보이는 가짜 참고문헌을 여전히 만들어 내기 때문에, 인용 신뢰성은 연구 진실성 문제가 되었습니다. 2025년 학생과 연구자의 채택은 급격히 늘었으며, 조작된 인용은 더 이상 신기한 오류가 아닙니다. 이러한 인용은 학회 논문집, 원고, 인용 그래프에 유입되고 있습니다.
Higher Education Policy Institute의 2025년 학생 설문조사에 따르면 평가 과제에 생성형 AI 도구를 사용하는 비율은 1년 만에 53%에서 88%로 급증했습니다. 같은 설문에 대한 관련 보고에서는 현재 학생의 92%가 어떤 형태로든 AI를 사용하며, 이는 2024년의 66%에서 증가한 수치라고 밝혔습니다. 그 규모가 중요한 이유는 그럴듯한 가짜 참고문헌이 빈 참고문헌보다 발견하기 더 어렵기 때문입니다.
Energy Research & Social Science의 2026년 분석은 ChatGPT가 연구 제안서를 위해 178개의 참고문헌을 생성했으며, 그중 69개에는 유효한 DOI가 없었다고 보고했습니다. 같은 논문은 NeurIPS 2025 논문 4,841편을 검토한 GPTZero 분석에서 채택된 논문 53편에 걸쳐 최소 100개의 환각 인용이 확인되었다는 내용을 인용했습니다. 여러 전문가의 동료 심사도 이를 잡아내지 못했습니다.
그 메커니즘은 이제 잘 설명되어 있습니다. AI 환각은 사실이 아니거나 근거가 없는 유창한 출력입니다. 대학 도서관 안내는 챗봇이 저자, 제목, 저널을 포함한 인용 전체를 발명할 수 있다고 지적합니다. Science는 모델이 답을 모를 때조차 답을 생성하도록 학습된다고 주장했습니다. 프롬프트가 “출처를 인용하라”일 때 모델은 서지 형식을 패턴 매칭합니다. 틈새 분야나 최신 연구에서는 이러한 형식 매칭이 발명으로 이어집니다.
AI 연구 보조 도구를 선택할 때 무엇을 평가해야 하는가?
AI 연구 보조 도구는 문장이 얼마나 매끄러운지가 아니라 모든 주장을 추적, 근거화, 출처 연결, 반박 검토, 추출할 수 있는지를 기준으로 평가해야 합니다. 유용한 약칭은 TRACE 프레임워크입니다. 이는 추적성(Traceability), 검색 기반 근거성(Retrieval grounding), 출처 연결의 세분성(Attribution granularity), 모순 인식(Contradiction awareness), 추출 가능성(Extractability)을 뜻합니다.
추적성은 독자가 초안의 문장에서 이를 뒷받침하는 정확한 문단으로 이동할 수 있는지를 묻습니다. 도구가 서식화된 참고문헌만 출력한다면, 그것은 증거가 아니라 포인터를 만든 것입니다.
검색 기반 근거성은 시스템이 학술 코퍼스를 검색했는지, 아니면 모델 가중치에서 표본을 추출했는지를 묻습니다. 인용 근거 기반 추출은 추출된 모든 주장에 명시적 출처 연결을 요구하여 출처 없는 발명과 출처 없는 바꿔쓰기를 모두 차단하도록 설계되었습니다.
출처 연결의 세분성은 논문 수준 인용과 문장 수준 또는 필드 수준 인용을 구분합니다. 논문 자체는 실제일 수 있지만, 인용된 결과는 틀렸거나 오래되었거나 결과가 아닌 초록에서 가져온 것일 수 있습니다.
모순 인식은 도구가 주장을 지지하거나 이의를 제기하거나 단순히 언급하는 후속 연구를 보여 주는지 묻습니다. 하나의 확인적 초록만으로는 문헌이 되지 않습니다.
추출 가능성은 방법, 표본, 결과, 한계를 구조화된 필드에서 비교할 수 있는지를 묻습니다. 문장형 요약은 누락된 데이터를 숨기지만 표는 공백을 드러냅니다.
King's College London의 근거 종합 안내는 실무적 함의를 분명하게 제시합니다. AI 도구는 문헌고찰의 단계를 지원할 수 있지만 검증된 검색 방법을 대체할 수 없으며, 생성형 시스템은 여전히 가짜 참고문헌을 만들 수 있습니다. 해당 안내에서 인용한 2025년 검토 연구는 현재 증거가 사람의 개입 없이 근거 종합에 생성형 AI를 사용하는 것을 뒷받침하지 않는다고 결론지었습니다. 따라서 평가 질문은 “이 도구가 글을 쓸 수 있는가?”가 아닙니다. “이 도구를 감사할 수 있는가?”입니다.
전문 연구 보조 도구는 범용 챗봇과 어떻게 비교되는가?
전문 연구 보조 도구는 검색된 논문에 답변을 연결하는 반면 챗봇은 초안 작성, 설명, 브레인스토밍에 가장 강점을 보이므로, 인용 추적성에서 범용 챗봇을 능가합니다. 정직한 비교는 역할 기반 비교입니다. 챗봇은 유연한 글쓰기 엔진이며, 연구 보조 도구는 더 좁은 범위에서 작동하지만 더 검토하기 쉬운 검색 시스템입니다.
Elicit은 수백만 편의 학술 논문을 검색하고 인용이 포함된 구조화된 보고서를 제공합니다. 연구자가 여러 연구에 걸쳐 방법, 표본, 결과를 나란히 정리해야 할 때 특히 강합니다. King's College London이 인용한 2026년 Cochrane 연계 비교에서는 Elicit가 전통적인 문헌 검색을 대체할 만큼 높은 민감도로 검색하지는 못했지만, 정밀도가 높아 보조 도구로는 유용했다고 평가했습니다. 이는 각주 수준의 단서가 아니라 실제 한계입니다.
Scite는 초안 작성보다 검증을 중심으로 구축되었습니다. Scite는 3억 편 이상 학술 논문에 대한 범위와 40개 이상 출판사와의 계약을 통한 라이선스 접근을 제공한다고 밝힙니다. Smart Citations는 후속 논문이 주장을 지지하는지, 대조하는지, 또는 단지 언급하는지를 분류합니다. 해당 보조 도구가 제시하는 모든 주장은 특정 논문의 특정 문장에 연결됩니다. 그 대가로 범위는 제한됩니다. Scite는 전 과정 원고 워크플로보다 인용 분석에서 더 강합니다.
ResearchRabbit은 매핑에 가장 강합니다. 연구자가 관련 논문을 찾고, 인용 지도를 구축하며, 하나의 시드 논문에서 분야가 확장되는 모습을 추적하도록 돕습니다. 근거 추출 또는 인용 검증 엔진으로서는 덜 유용합니다. 과제가 발견이라면 이는 결함이 아닙니다.
ChatGPT와 같은 범용 챗봇은 빠르게 초안을 작성하고 복잡한 여러 분야의 질문을 처리하기 때문에 여전히 널리 사용됩니다. 문서화된 약점은 서지 정보의 발명입니다. 2026년 학술 진실성 분석에 요약된 최근 보고는 GPT-4o 및 Claude 3.7 같은 고급 모델의 사실 인용 환각률을 15–20%로 제시했으며, 틈새 또는 최신 주제에서는 35–55%까지 상승했습니다. 대규모 언어 모델이 생성한 과학 참고문헌을 감사하는 벤치마크는 일부 환경에서 30%를 넘는 오류율을 보고했습니다.
Jenova의 Academic Research Assistant는 다른 위치에 있습니다. 이는 문헌 발견, 원고 준비, 인용 관리를 위한 도메인 에이전트이며, 지속 메모리와 학술 데이터베이스 전반의 실시간 검색을 제공합니다. 연구 프로젝트를 여러 세션에 걸쳐 일관되게 유지하는 능력은 챗봇보다 강합니다. 반면 라이선스된 원문 인용 분류에서는 Scite보다 약하고, 전용 추출 표 제품으로서는 Elicit보다 약합니다. 이러한 차이 때문에 혼합형 도구 스택은 여전히 어느 하나의 보조 도구보다 뛰어난 성과를 냅니다.
| 기능 / 차원 | 범용 챗봇(예: ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| 검색 기반 근거성 | 주로 모델 메모리 기반, 웹 탐색은 제품별로 다름 | 지속형 연구 에이전트 내 실시간 학술 및 웹 검색 | 구조화된 보고서를 제공하는 논문 코퍼스 검색 | 라이선스된 학술 원문과 공개 코퍼스 | 시드 논문 기반 인용 그래프 발견 |
| 인용 추적성 | 검증 불가능하거나 조작된 경우가 잦음 | 원문에 대한 후속 검증이 가능한 인라인 출처 | 추출된 필드에 연결된 인용 | 문장 수준 링크와 지지/대조 라벨 | 주장 수준 증명이 아닌 논문 간 네트워크 링크 |
| 근거 추출 | 자유 형식 요약 | 노트, 비교, 원고에 바로 쓸 수 있는 종합 | 강력한 구조화 표 | 필드 추출보다 인용 맥락에 강함 | 제한적, 추출보다 매핑 중심 |
| 모순 인식 | 대개 하나의 답변으로 평탄화됨 | 요청 시 상충하는 결과를 비교할 수 있음 | 검색된 집합에 따라 달라짐 | Smart Citations를 통한 핵심 제품 기능 | 관련 연구 클러스터를 통한 간접적 파악 |
| 가격(2026년 기준) | 플랜별로 검증되지 않음 | 무료 등급, 유료 플랜은 월 $20부터 | 검증되지 않음 | 검증되지 않음 | 검증되지 않음 |
| 적합한 용도 | 초안 작성, 설명, 초기 구조화 | 발견과 글쓰기 메모리를 함께 필요로 하는 장기 학술 프로젝트 | 논문을 비교 가능한 근거 표로 선별 | 주장이 지지되는지 또는 반박되는지 확인 | 시각적 문헌 매핑과 저자/클러스터 발견 |
2026년 학술 연구 AI 도구 비교도 유사한 역할 분담에 도달했습니다. Elicit는 구조화된 추출에서 선두였고, Consensus는 빠른 근거 확인에 가장 빨랐으며, Semantic Scholar는 가장 강력한 무료 발견 색인으로 남았습니다. 이 환경에서 어느 하나의 열도 다른 열을 대체하지 못합니다.
학술 AI 도구별 근거 추출은 어떻게 다른가?
근거 추출의 차이는 도구가 비교 가능한 필드를 반환하는지, 아니면 서술형 바꿔쓰기만 제공하는지에 달려 있습니다. 필드 수준 추출은 누락값이 계속 보이므로 방법, 표본 크기, 결과, 한계에 더 신뢰할 수 있습니다. 서술형 추출은 더 빠르고 읽기 쉽지만, 결과와 해석, 환각된 세부사항 사이의 차이를 숨깁니다.
Elicit는 구조화된 접근법의 가장 분명한 사례입니다. 연구 질문을 행에는 논문, 열에는 연구 특성이 배치된 보고서로 바꾸도록 설계되었습니다. 이 형식 때문에 검토자들은 초기 선별에 이를 선호하는 경우가 많습니다. 다만 높은 정밀도가 높은 재현율을 뜻하지는 않기 때문에, 포함 기준의 논리를 사람이 확인해야 합니다.
Scite는 다른 대상을 추출합니다. 바로 인용 맥락입니다. “이 논문은 무엇을 발견했는가?”를 묻는 대신, “후속 논문은 이 발견을 어떻게 활용했는가?”를 묻습니다. 이는 데이터 추출보다 근거 평가에 가깝습니다. 특히 후보 논문이 이미 식별된 뒤에 유용합니다.
범용 챗봇은 문장으로 추출합니다. 무작위 대조 시험 4건을 비교해 달라고 요청하면 자신감 있는 문단을 만들 것입니다. 이 문단은 첫 스케치로는 유용할 수 있습니다. 그러나 “보고되지 않음”으로 표시할 수 있는 필드가 없으므로 감사 산출물로는 부적합합니다.
Jenova의 Academic Research Assistant와 보조 Deep Research 에이전트는 이 두 극점 사이에 있습니다. Deep Research는 폭넓게 검색하고 인라인 인용이 포함된 종합 보고서를 반환합니다. Academic Research Assistant는 프로젝트 상태를 유지합니다. 이전의 포함 결정, 제외된 논문, 스타일 요구사항, 미완성 원고 섹션을 이후 세션에서도 사용할 수 있습니다. 이 워크플로를 시험해 보면 수주에 걸친 문헌고찰에서 실질적인 이점이 드러납니다. 한계도 마찬가지로 실질적입니다. 두 에이전트 모두 제목 및 초록 선별에서 근거 종합 사서들이 여전히 더 많이 평가된 선택지로 보는 Rayyan 또는 DistillerSR 같은 목적 특화 도구의 체계적 문헌고찰 선별 도구는 아닙니다.
신뢰할 수 있는 추출 프롬프트는 원하는 필드를 명시합니다.
"이 논문들에서 다음을 추출하세요: 연구 설계, 표본 크기, 모집단, 주요 결과, 효과 방향, 명시된 한계, 그리고 각 필드를 뒷받침하는 정확한 문장. 필드가 누락되었다면 추론하지 말고 '보고되지 않음'이라고 작성하세요."
챗봇에서 같은 프롬프트를 사용하더라도 품질은 검색된 텍스트만큼만 보장됩니다. 모델이 논문을 열어 보지 않았다면, 문체적 메모리를 바탕으로 표를 채울 것입니다.
인용 검증 파이프라인에는 실제로 무엇이 필요한가?
인용 검증 파이프라인에는 참고문헌 문자열만이 아니라 원문 문서가 필요합니다. 최소 실행 가능 프로세스는 인용된 텍스트를 수집하고, 이를 청크로 나누고, 주장과 가장 관련 있는 문단을 검색하고, 재순위화한 뒤, 주장과 근거의 관계를 분류하는 것입니다. 이보다 부족한 것은 서지 서식화일 뿐입니다.
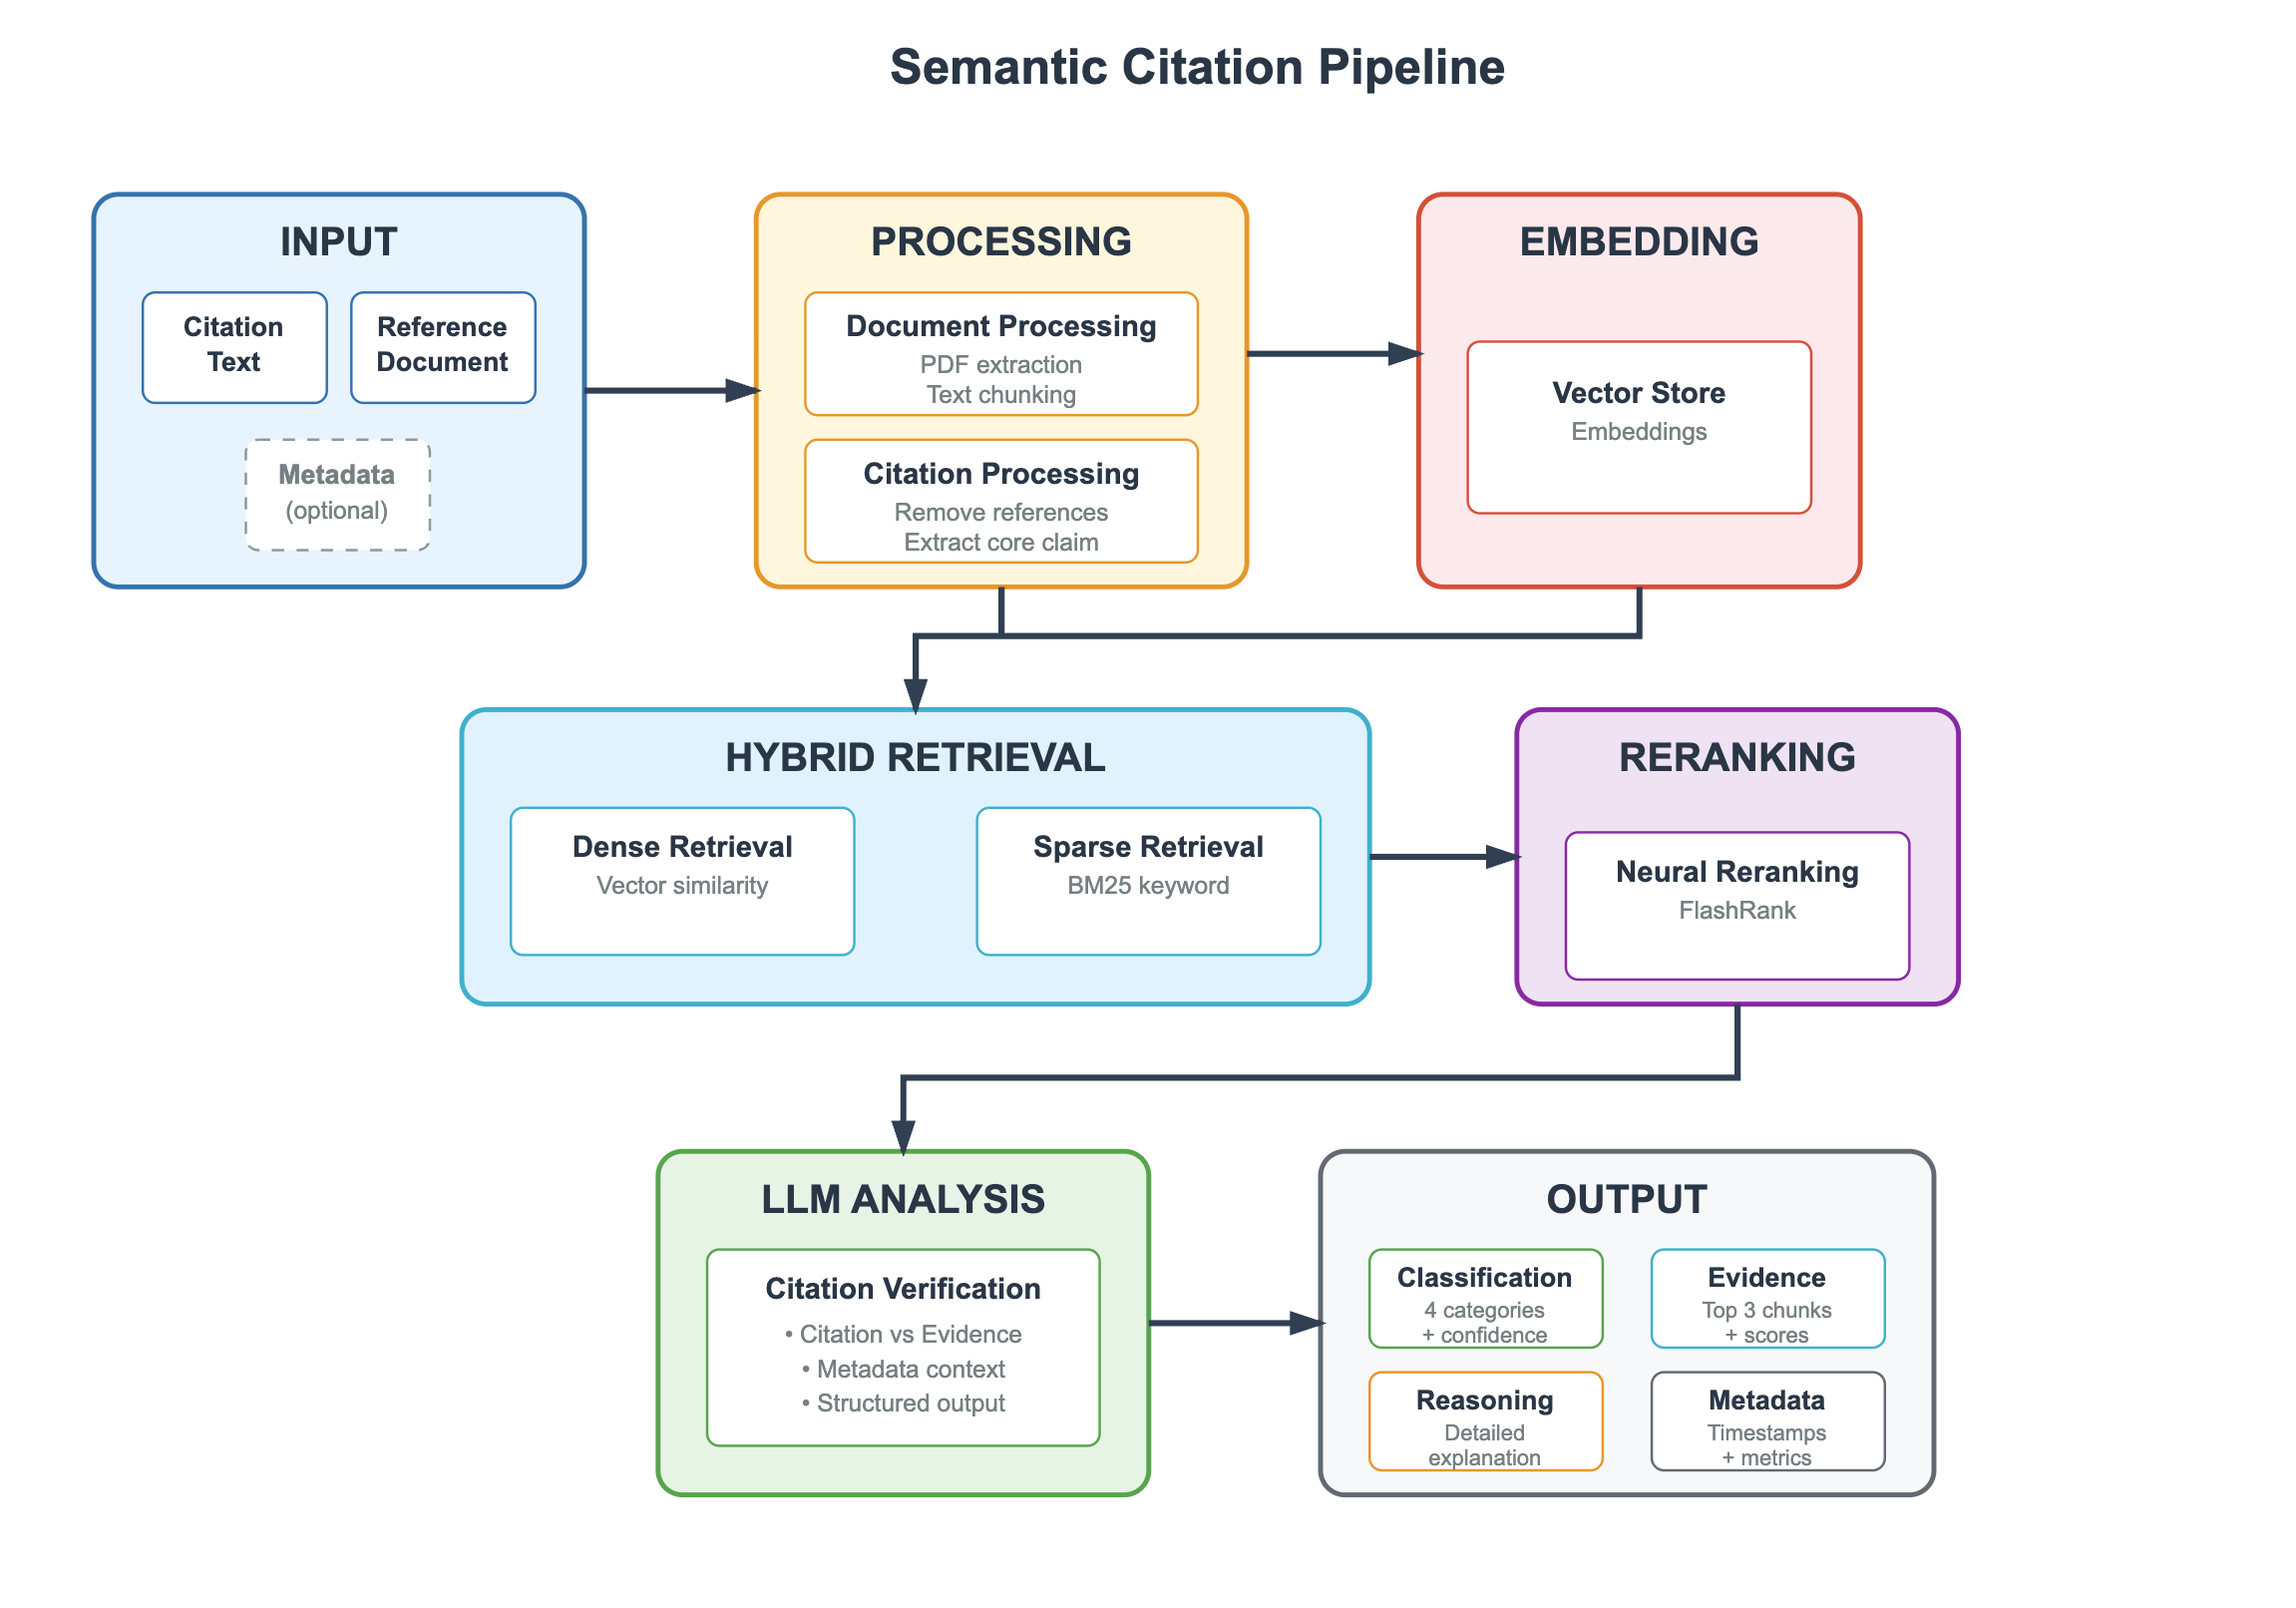
위 아키텍처는 “이 인용은 실제처럼 보인다”와 “이 인용은 뒷받침된다”의 차이입니다. 입력은 주장과 참조 문서입니다. 처리는 참고문헌 목록을 제거하고, 핵심 주장을 추출하며, PDF를 청크로 나눕니다. 하이브리드 검색은 벡터 유사성과 키워드 중복을 모두 검색합니다. 방법명과 결과 측정치는 순수 의미 검색에서 누락되는 경우가 많기 때문에 이것이 중요합니다. 신경망 재순위화는 상위 문단을 유지합니다. 그 후에야 LLM이 관계를 분류하고 근거, 신뢰도, 추론을 반환합니다.
SemanticCite와 같은 시스템은 원문 분석을 통해 인용 정확성을 검증하도록 특별히 구축되고 있습니다. 이러한 설계 선택이 존재하는 이유는 메타데이터 일치만으로 충분하지 않기 때문입니다. DOI가 유효하더라도 인용된 문장은 다른 논문, 사전 인쇄본 초록, 또는 저자들이 나중에 한정한 결과에서 가져왔을 수 있습니다.
출판사 인프라가 이를 자동으로 해결하지는 않습니다. 주요 저널은 이미 참고문헌에 하이퍼링크를 제공하지만, 2026년 진실성 분석에서 논의된 추정에 따르면 표본 학술 콘텐츠에서 DOI 실패 또는 링크 부패는 최대 37%에 이를 수 있습니다. 녹색 링크가 있다고 해서 주장이 검증된 것은 아닙니다.
바로 이 지점에서 범용 챗봇은 가장 예측 가능하게 실패합니다. 챗봇은 완전한 답변을 최적화합니다. 검증 파이프라인은 분류된 관계, 즉 지지됨, 지지되지 않음, 반박됨 또는 근거 불충분을 최적화합니다. 이 네 가지 라벨은 남은 검증의 종류를 연구자에게 알려 주므로 매끄러운 문단보다 과학적으로 더 유용합니다.
Jenova 에이전트는 후보 논문을 검색하고, 뒷받침 문단을 인용하며, 찾을 수 없는 주장을 표시함으로써 이 루프의 경량 버전을 실행할 수 있습니다. 그러나 이 에이전트들은 현재 출판사 규모의 범위를 가진 라이선스 원문 인용 분류기를 대체하지는 않습니다. Smart Citation 라벨이 필요한 연구자는 두 작업을 하나의 시스템에 맡기기보다 여전히 글쓰기 에이전트를 Scite와 함께 사용합니다.
더 안전한 AI 지원 문헌 워크플로는 어떻게 구축하는가?
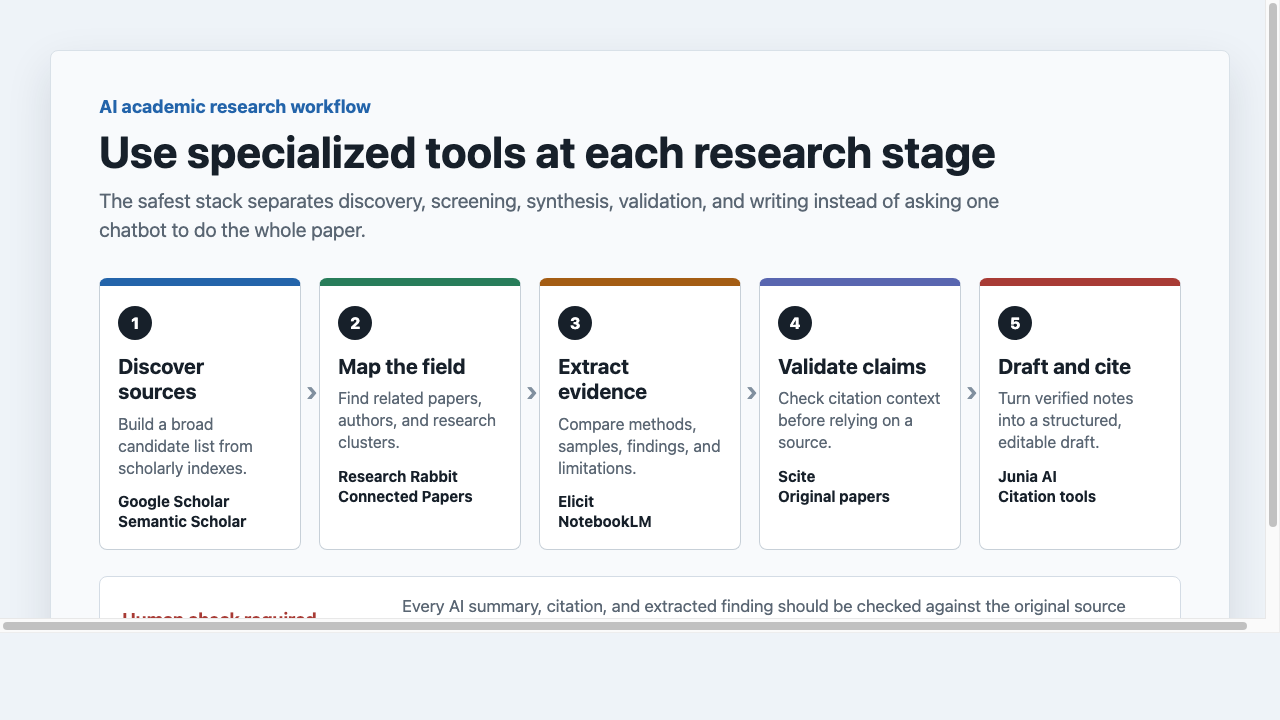
더 안전한 AI 지원 문헌 워크플로는 각 단계를 검증 가능한 도구에 할당한 뒤, 추출된 모든 결과를 원 논문과 대조하여 확인함으로써 구축합니다. 안전하지 않은 패턴은 하나의 챗봇에게 발견, 선별, 추출, 검증, 글쓰기를 모두 맡기는 것입니다.
단계별 워크플로는 다음과 같습니다.
- 채팅 창이 아니라 Google Scholar 또는 Semantic Scholar 같은 학술 색인에서 출처를 발견합니다.
- ResearchRabbit 또는 Connected Papers로 분야를 매핑하여 관련 저자와 클러스터를 확인합니다.
- Elicit, NotebookLM 또는 연구 에이전트를 사용해 근거를 추출하고 구조화된 노트에 기록합니다.
- 문장을 인용 가능한 것으로 취급하기 전에 Scite와 원본 PDF에서 주장을 검증합니다.
- 검증된 노트 집합만을 바탕으로 초안을 작성하고 인용합니다.
Jenova의 Academic Research Assistant에서는 기능 소개가 아니라 연구 브리프로 시작해야 합니다.
- jenova.ai/a/academic-research-assistant에서 에이전트를 엽니다.
- 질문, 학문 분야, 그리고 완료의 기준을 명시합니다.
"LLM 인용 오류율에 관한 방법 섹션을 작성하고 있습니다. 2023–2026년에 출판된 동료 심사 연구와 출판사 분석을 우선시하세요. 각 출처에서 표본, 오류 정의, 환각률, 사람에 의한 참고문헌 검증 여부를 추출하세요."
- 먼저 후보 목록을 요청하고, 그다음 추출 표를 요청한 뒤, 마지막에 문장을 작성합니다. 초안으로 바로 건너뛰지 마세요.
- 제외한 논문을 같은 대화 스레드에 유지하여 에이전트가 나중에 이를 다시 도입하지 않도록 합니다.
Elicit에서는 좁은 질문과 모집단, 중재, 결과, 연구 유형으로 된 열 목록이 이에 해당하는 시작점입니다. Scite에서는 알려진 논문 또는 주장으로 시작하고, 글을 쓰기 전에 지지 인용과 대조 인용을 검토합니다. 범용 챗봇은 출처가 이미 존재한 뒤 개요 작성과 문장 편집에 사용하는 것이 가장 안전합니다.
두 가지 운영 원칙이 대부분의 실패를 막습니다. 첫째, 열 수 없는 인용은 절대 받아들이지 마세요. 둘째, 초안 작성 모델이 논문 내용을 말한 유일한 기록이 되게 하지 마세요. 검증된 노트가 사실의 원천입니다. 초안은 그 노트를 재배열한 결과물입니다.
범용 챗봇이 여전히 더 나은 학술 도구인 경우는 언제인가?
과제가 근거가 아니라 언어, 구조, 설명일 때 범용 챗봇은 여전히 더 나은 학술 도구입니다. 신뢰성은 작업에 따라 달라집니다. 인용 추적성은 글쓰기 모델에 적합한 시험 기준이 아니며, 문장 유창성이 검색 색인에 적합한 시험 기준이 아닌 것과 같습니다.
챗봇은 다음 작업에서 여전히 유용합니다.
- 검증된 개요를 더 매끄러운 학술 문장으로 바꾸기
- 연구자가 이미 읽은 방법을 설명하기
- 검색 문자열, 반론 또는 수정 체크리스트 생성하기
- 인용용이 아닌 노트를 위해 밀도 높은 문단을 더 쉬운 언어로 바꾸기
하지만 챗봇은 부실한 1차 문헌 엔진입니다. Nature 연계 분류 연구는 근거 없는 챗봇 진술을 별도의 환각 유형으로 다룹니다. 도서관 안내도 같은 경고를 반복합니다. 조작된 인용에는 완전한 저자-제목-저널 묶음이 포함될 수 있습니다. 이러한 실패 방식은 하나의 발명된 참고문헌이 그 외에는 신중한 논증 전체의 신뢰를 떨어뜨릴 수 있는 학위 논문, 연구비 제안서, 저널 투고에서 큰 비용을 초래합니다.
챗봇을 도구 스택에 유지해야 하는 워크플로상 이유도 있습니다. 전문 도구는 범위가 더 좁습니다. Elicit는 문단의 리듬을 함께 다듬어 주지 않습니다. Scite는 학위 논문 장에 관해 한 학기 동안 지도 대화를 이어 가지 않습니다. ResearchRabbit은 저널의 참고문헌 형식을 맞춰 주지 않습니다. 챗봇 또는 범용 글쓰기 에이전트는 근거가 확정된 뒤 이러한 빈틈을 채웁니다.
실무 원칙은 순서입니다. 먼저 전문 검색 및 검증 도구를 사용하세요. 그다음 열어 볼 수 있는 라이브러리에 출처가 이미 존재하는 텍스트에 한해서만 범용 모델을 사용하세요. 챗봇이 수정 중 새 인용을 추가한다면, 해당 인용이 원고의 나머지 부분과 동일한 TRACE 검증을 통과하기 전까지 신뢰하지 마세요.
연구 진실성 전문가는 AI 인용에 관해 무엇이라고 말하는가?
연구 진실성 전문가는 범용 챗봇을 초안 작성 보조 도구로, 출처에 연결된 전문 시스템을 인용될 주장에 허용되는 유일한 계층으로 봅니다. 합의는 “AI를 피하라”가 아닙니다. “근거 없는 생성기가 문헌이 말하는 바에 대한 기록이 되게 하지 말라”입니다.
"계속해서 목격하는 실패는 모델이 글을 못 쓴다는 데 있지 않습니다. 존재하지 않는 논문이나 주장된 결과를 담고 있지 않은 실제 논문에 대해 완전한 참고문헌을 작성한다는 데 있습니다. 이런 문자열이 초안에 들어가면 증거처럼 작동합니다. 누군가 출처를 열어 보기 전에 검토자, 공동 저자, 후속 인용 도구가 이를 전파할 수 있습니다."
"전문 연구 보조 도구는 작업의 단위를 바꿉니다. 인용이 포함된 문단을 요청하는 대신 주장, 문단, 분류를 요청합니다. 즉 지지됨, 지지되지 않음, 반박됨 또는 근거 불충분입니다. 이 출력은 더 느리고 덜 우아합니다. 하지만 방법 섹션에서 방어할 수 있는 유일한 출력이기도 합니다."
"지속적인 프로젝트 메모리는 사람들이 예상하는 것보다 더 중요합니다. 환각은 수정 과정에서 종종 논문에 다시 들어옵니다. 이미 깔끔했던 섹션에 범용 챗봇이 '출처를 추가'하도록 요청받을 때입니다. 어떤 논문이 왜 제외되었는지를 기억하는 보조 도구는 단순한 편의 기능이 아니라 진실성 업무를 수행하는 것입니다. 그렇더라도 원본 PDF는 여전히 권위 있는 기준입니다."
— Jenova Product Team, 학술 연구 워크플로 및 인용 근거 기반 에이전트 설계에 대한 다년간의 작업
이러한 입장은 사서와 근거 종합 지침에 부합합니다. King's College London은 AI를 보조 도구로 사용하고, 원문을 업로드하기 전에 저작권을 확인하며, 생성형 도구가 여전히 참고문헌과 주제명을 발명할 수 있다고 가정하라고 조언합니다. 출판사 수준의 분석은 이제 환각 참고문헌을 일화적 문제가 아니라 코퍼스 문제로 다룹니다. Nature가 약 4,000개 출판물을 검토한 결과를 바탕으로 한 2026년 논평은 가장 의심스러운 논문 100편 중 65편에 최소 하나의 유효하지 않은 참고문헌이 포함되어 있었으며, 이 패턴은 2025년 약 700만 편의 출판물 가운데 11만 편 이상이 영향을 받았을 수 있음을 시사한다고 언급했습니다.
전문가의 시사점은 운영적입니다. 확인 비용을 낮추는 도구를 선택하세요. 확인이 불필요하게 느껴지게 만드는 도구는 거부하세요.
참고문헌
- Higher Education Policy Institute — 2025년 학생 생성형 AI 설문조사
- ERIC / 미국 교육부 — 2025년 학생 생성형 AI 설문조사, HEPI Policy Note 61
- Boretti, Energy Research & Social Science — 생성형 AI의 환각과 학술 진실성
- Wikipedia — 환각(인공지능)
- University of Nebraska Medical Center McGoogan Library — 인용이 포함된 AI 환각
- Science / AAAS — AI 모델이 불확실성을 인정하지 않고 환각하는 이유
- LlamaIndex — 인용 근거 기반 추출
- King's College London Library Guide — 근거 종합에서의 AI 도구
- Elicit — 과학 연구를 위한 AI
- Scite — 인용 기반 연구 및 Smart Citations
- ResearchRabbit — 문헌 매핑 및 인용 네트워크
- newline — LLM이 생성한 과학 참고문헌 검증 벤치마크
- Paperguide — 2026년 학술 연구 AI 도구 비교
- arXiv — SemanticCite: 원문 분석을 활용한 인용 검증
- Nature Humanities and Social Sciences Communications — AI 환각의 분류