AI 에이전트 백엔드: 하나의 API 대 직접 구축 (2026년 7월)
2026-07-24
2026년에 AI 기능을 출시하는 모든 엔지니어링 팀은 같은 갈림길에 섭니다. 에이전트 백엔드를 처음부터 구축할 것인가, 아니면 통합할 것인가입니다. 직접 구축한다는 것은 모델 API, 오케스트레이션 프레임워크, 벡터 데이터베이스, 메모리 저장소, 도구 서버를 하나로 엮는다는 뜻이며, 첫 사용자 상호작용이 발생하기도 전에 수 분기의 엔지니어링 시간을 소모하는 스택입니다. Jenova Agent API는 그 대안입니다. 오케스트레이션, 메모리, 스토리지, RAG, 도구가 하나의 통합 뒤에서 실행되는 완전 관리형 에이전트 백엔드입니다.
- ✅ 모델 라우팅, 오케스트레이션, 메모리, RAG, 도구를 포함한 전체 DIY 에이전트 스택을 하나의 API로 대체
- ✅ 지침, 모델, 지식 베이스, 도구로 정의되는 맞춤형 프로덕션급 에이전트를 구축하고 출시
- ✅ 단일 자격 증명으로 OpenAI, Anthropic, Google, xAI, Qwen 등의 모델에 접근
- ✅ 70개국 이상에서 30,000명 이상의 사용자로 프로덕션 검증을 거친 인프라에서 실행
구축과 통합 사이의 결정을 정직하게 내리려면, 2026년에 처음부터 만드는 에이전트 백엔드의 실제 구축·운영·유지 비용을 알아야 합니다.
빠른 답변: AI 에이전트 백엔드란 무엇인가요?
AI 에이전트 백엔드는 프로덕션 환경에서 에이전트가 작동하도록 하는 인프라 레이어입니다. 모델 및 도구 간 오케스트레이션, 지속형 메모리와 컨텍스트, 비공개 데이터 검색, 그리고 그 아래의 컴퓨팅·확장성·신뢰성 시스템을 포함합니다. 처음부터 구축하면 5개 이상의 개별 시스템을 직접 소유해야 하지만, 관리형 에이전트 API는 하나의 통합으로 이 모든 것을 제공합니다.
관리형 에이전트 백엔드의 핵심 기능:
- 다단계 워크플로 전반에서 모델, 도구, 메모리, 검색을 조율하는 에이전트 오케스트레이션
- 공급자 간 멀티모델 라우팅 — 벤더 종속과 공급자별 키 관리 불필요
- 모든 세션에 내장된 무제한 대화 메모리와 컨텍스트
- 내장 RAG를 갖춘 완전 관리형 관계형 및 벡터 스토리지
- 플랫폼 네이티브 도구와 모든 원격 MCP 서버를 통한 도구 통합
문제: 처음부터 구축할 때 실제로 드는 비용
에이전트를 출시해야 한다는 시장의 압박은 강력합니다. 기업용 소프트웨어에서 에이전틱 AI를 포함하는 앱의 비율은 2024년 1% 미만에서 33%까지 증가할 전망이며(Datagrid), C-suite 경영진의 67%는 2027년까지 조직 내부에서 독립적으로 작동하는 AI 에이전트를 기대하고 있습니다(VAST Data).
하지만 이를 지원하는 백엔드를 구축하는 일은 잔인할 정도로 비싸고 느립니다.
- 두 번째 엔지니어링 전문 분야가 되어 버리는 오케스트레이션 로직
- 호출 사이에 메모리가 없는 상태 비저장 모델 API
- 문서화된 반복적 장애 모드를 가진 RAG 파이프라인
- 모든 외부 기능을 위한 도구 통합 배관 작업
- 확장, 안정성 유지, 보안 심사를 통과해야 하는 프로덕션 인프라
- 모든 프로토타입 추정치를 압도하는 총 1년 차 비용
실제 예산: 모델 호출은 전체 이야기의 2%에 불과합니다
"월 $100 에이전트" 데모는 실제 비용 구조를 숨깁니다. 상세한 엔지니어링 분석에 따르면, 소규모에서 중간 규모의 프로덕션 에이전트 하나에 드는 현실적인 1년 차 비용은 **$270,000–$690,000**이며, 모델 API 호출은 전체의 약 2%에 불과합니다(Particle41).
나머지 비용은 데모 영상에서 아무도 보여 주지 않는 곳으로 향합니다.
$30,000–$80,000 — 초기 프롬프트 엔지니어링과 개선에만 드는 비용입니다. 시간당 $150–200으로 계산한 엔지니어링 시간 200–400시간에 해당합니다(Particle41).
월 $1,000–$5,000 — 벡터 데이터베이스 호스팅 비용이며, 여기에 임베딩 생성 비용으로 월 $1,000–$2,000가 추가됩니다(Particle41).
$30,000–$60,000 — 에이전트를 기존 시스템 4~5개에 연결하기 위한 데이터 통합 엔지니어링 비용입니다(Particle41).
FTE당 월 $6,000–$10,000 — 실패 사례 검토를 위한 인적 감독 비용입니다. 정확도가 95%인 에이전트라도 월간 상호작용 10,000건을 처리하면 수동 검토가 필요한 사례가 500건 발생합니다(Particle41).
출시가 끝도 아닙니다. 2년 차에도 운영과 개선에 연간 $150,000–$300,000이 듭니다(Particle41). 범위를 더 좁힌 개발 전용 추정치조차 단순 작업 에이전트는 $20,000–$60,000(Biz4Group), 멀티 에이전트 시스템은 $10,000–$400,000+에 이릅니다(Azilen).
오케스트레이션은 자체 제품이 됩니다
프로덕션 에이전트는 한 번 답하는 데 그치지 않습니다. 다단계 실행 전반에서 계획을 세우고, 도구를 호출하고, 컨텍스트를 검색하고, 중간 결과를 평가하며, 오류에서 복구합니다. 이 조정 루프를 구축하려면 실제 제품과는 무관한 상태 머신, 재시도 로직, 타임아웃 처리, 비용 가드레일이 필요합니다.
실무자들은 그 격차를 직설적으로 설명합니다. 에이전트 구축에는 며칠이 걸리지만 프로덕션에 올리는 데는 6개월이 걸리며, 제어되지 않는 루프는 API 비용을 폭증시키고 상태 손실은 장기 실행 작업을 망가뜨립니다(
). LangGraph와 CrewAI 같은 프레임워크는 이 레이어를 위한 추상화를 제공하지만(Speakeasy), 추상화가 저절로 실행되지는 않습니다. 그 아래의 모든 것을 여전히 직접 호스팅하고, 확장하고, 보안 처리하고, 유지해야 합니다.RAG 파이프라인은 프로젝트가 아니라 영구적인 책임입니다
에이전트를 비공개 데이터에 기반하게 하려면 수집, 청킹, 임베딩, 인덱싱, 리랭킹, 종합을 직접 소유해야 합니다. 실무자들은 RAG 파이프라인이 "보기보다 훨씬 어렵고, LLM, 검색, 전문 MLOps에 대한 지속적인 전문성도 요구한다"고 일관되게 경고합니다(Vectara).
문서화된 한 사례 연구를 보겠습니다. 1월에 시작한 "간단한" 사내 RAG 프로젝트는 3월이 되었을 때 환각을 디버깅하는 전담 엔지니어 1명, 수집 문제를 해결하는 전담 데이터 엔지니어 1명, 인프라와 싸우는 DevOps 엔지니어 1명을 소모했고 예산은 세 배가 되었습니다(Towards AI). 같은 사례는 일반적인 8주 수명 주기도 기록합니다. 지연 시간 문제, 엣지 케이스, 전면 재작성, 새로운 환각 문제, 벡터 DB 마이그레이션, 그리고 또 한 번의 재작성입니다.
레거시 인프라는 에이전트를 위해 만들어지지 않았습니다
에이전트 워크로드는 지속적인 실시간 데이터 접근을 요구합니다. 하지만 트랜잭션 워크로드를 위해 구축된 레거시 데이터 인프라는 "자율 AI 에이전트에 필요한 지속적 추론과 행동 수행을 지원할 수 없습니다"(VAST Data). 엔터프라이즈급 에이전트 인프라에는 통합 데이터 기반, 고성능 스토리지, 실시간 벡터화, 지능형 오케스트레이션, 제로 트러스트 거버넌스가 필요합니다. 제품 로직을 작성하기도 전에 서로 다른 5개 역량 레이어가 필요한 것입니다.
40% — 부적절한 인프라 기반 때문에 실패하는 에이전틱 AI 프로젝트의 비율(Landbase)
이것이 바로 Jenova Agent API가 없애기 위해 만들어진 문제입니다.
해결책: Jenova Agent API
Jenova Agent API는 완전 관리형 에이전트 인프라 서비스입니다. 모델 API, 오케스트레이션 프레임워크, 벡터 데이터베이스, 메모리 저장소, 도구 서버로 구성된 DIY 스택을 하나의 통합으로 대체합니다. 에이전트의 지침을 정의하고, 모델을 선택하고, 지식 베이스를 업로드하고, 도구를 구성하면 API가 오케스트레이션, 메모리, 스토리지, 확장을 처리합니다. 따라서 수 분기가 아니라 며칠 만에 프로덕션급 맞춤형 에이전트를 출시할 수 있습니다.
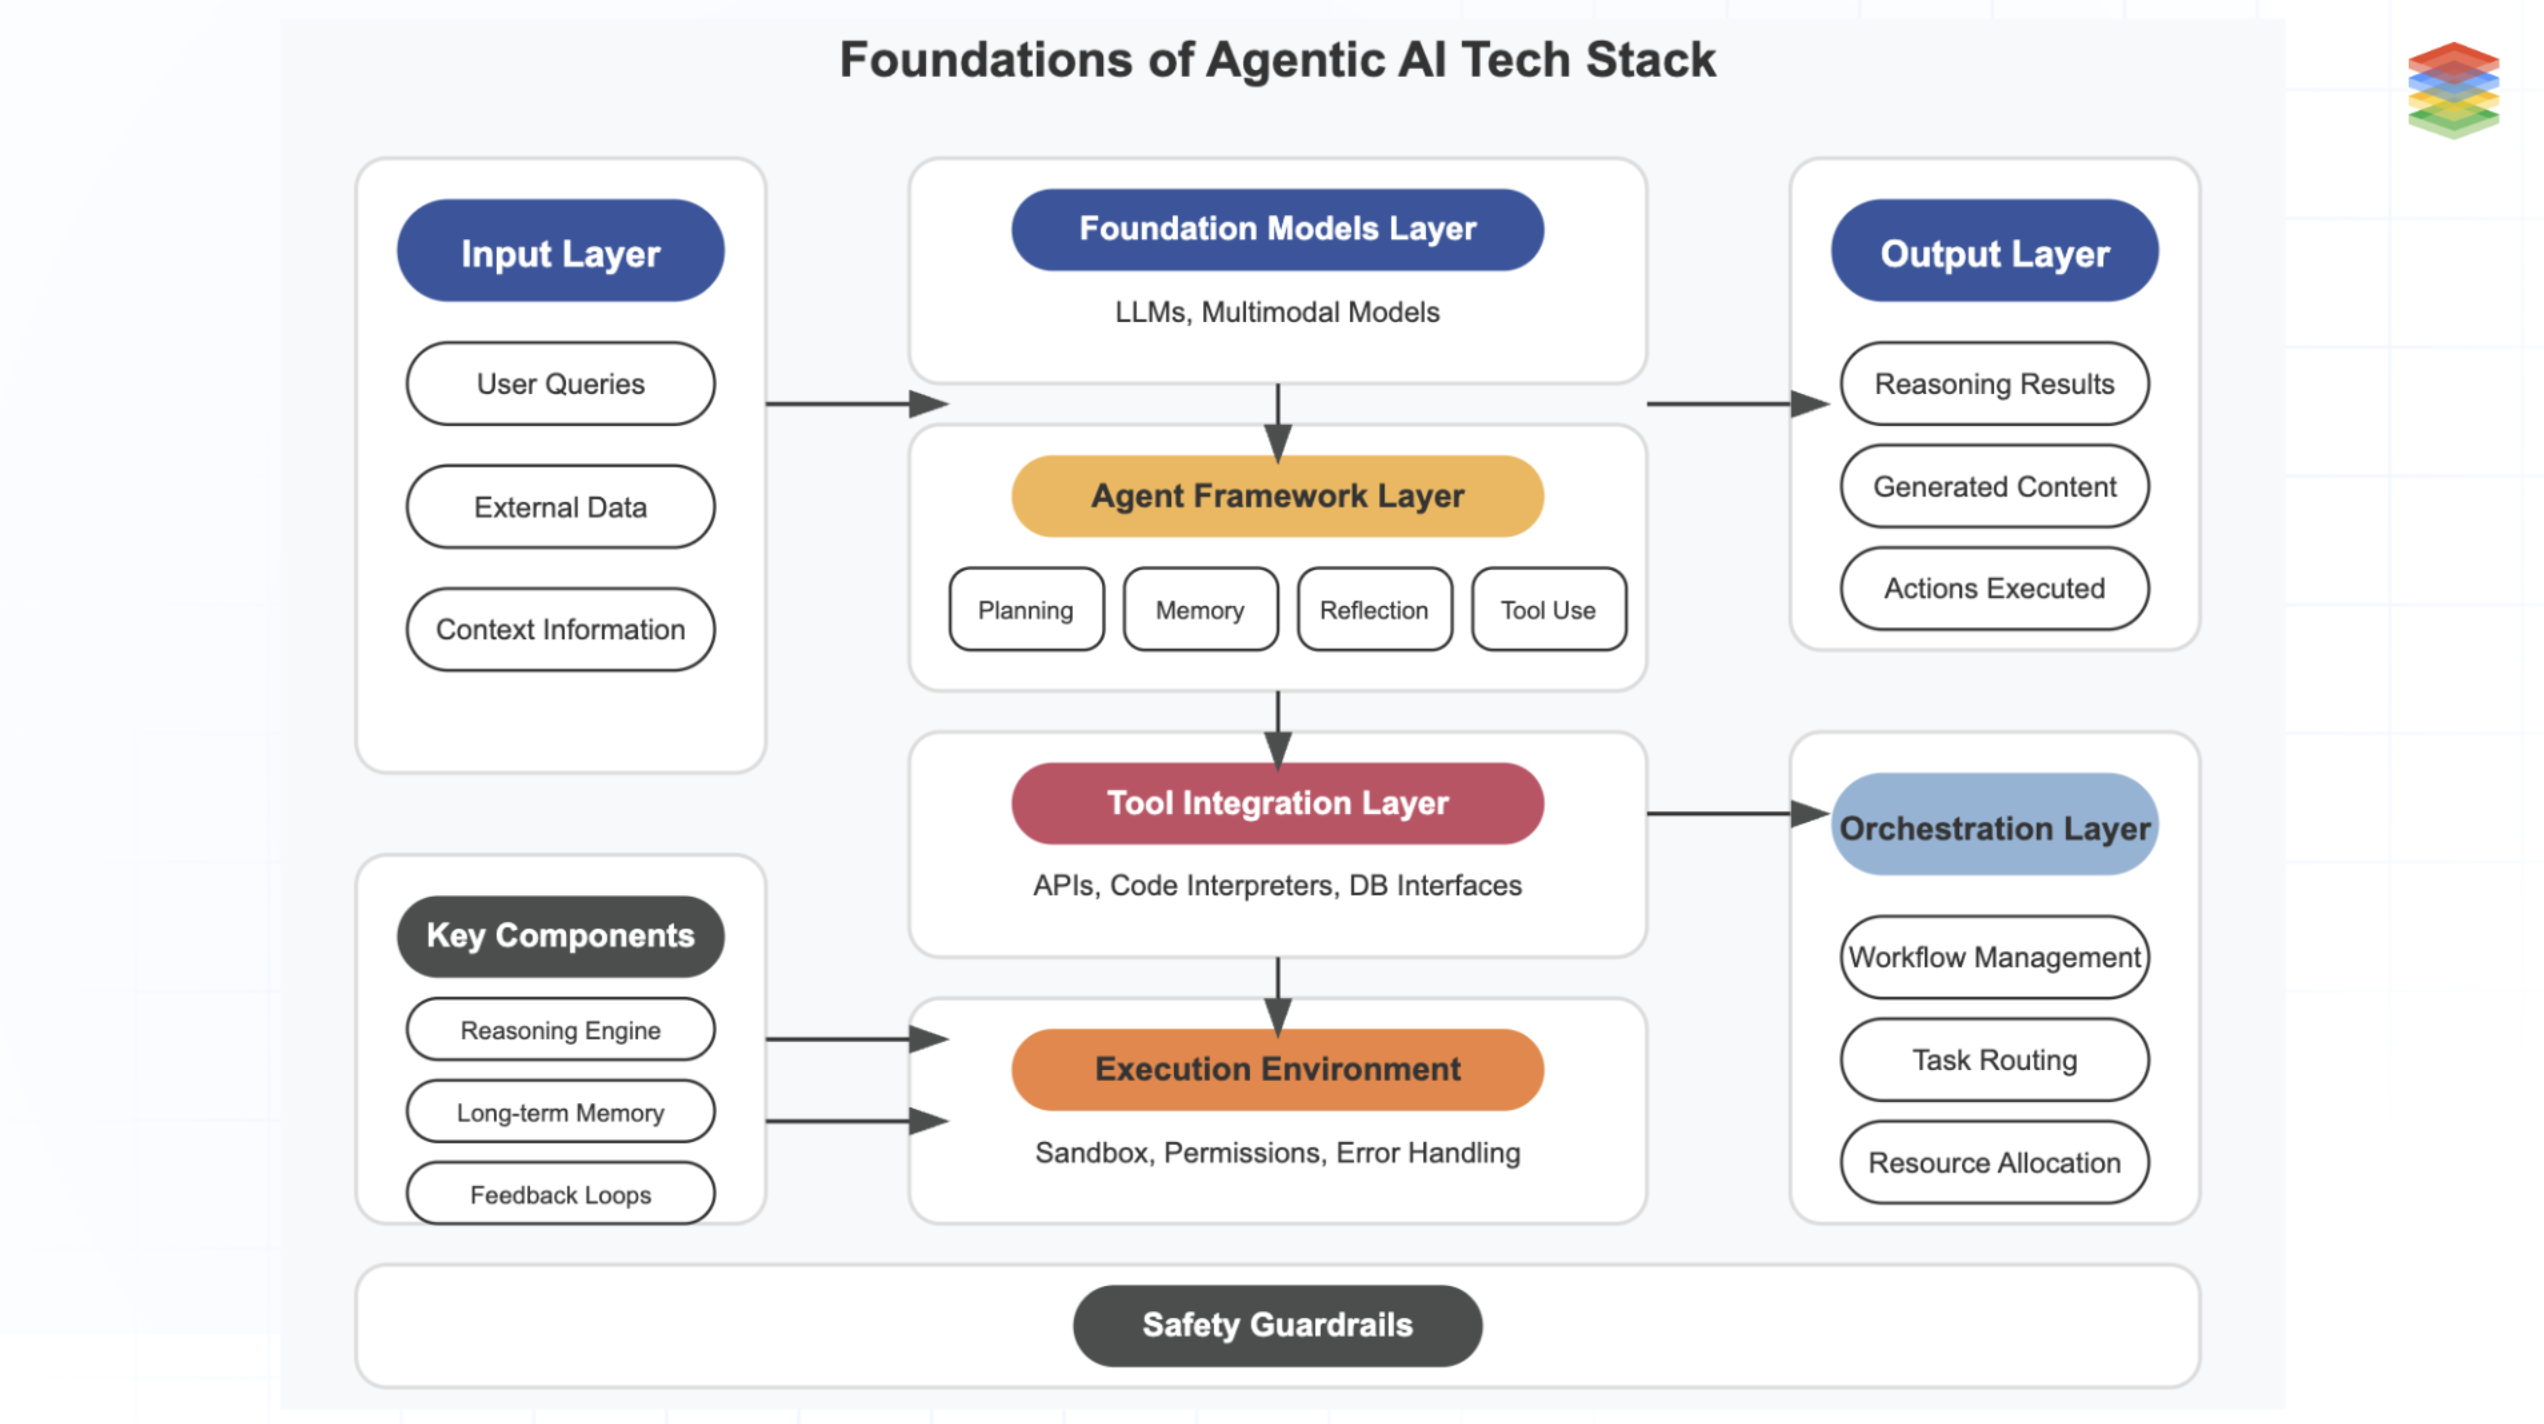
위 다이어그램의 모든 레이어, 즉 에이전트 프레임워크의 계획·메모리·성찰·도구 사용, 도구 통합 레이어의 API 및 데이터베이스 인터페이스, 실행 환경의 샌드박싱과 오류 처리, 오케스트레이션 레이어의 워크플로 관리와 작업 라우팅은 DIY 경로에서 직접 구축해야 하는 인프라입니다. Jenova Agent API가 이 모든 것을 실행합니다.
| 직접 구축 에이전트 백엔드 | Jenova Agent API |
|---|---|
| 맞춤형 오케스트레이션 그래프, 재시도 로직, 상태 스키마 | 모델, 도구, 메모리, 검색을 조율하는 프로덕션 검증 오케스트레이션 |
| 모델 공급자별 별도 SDK, 키, 속도 제한 | 단일 통합으로 모든 주요 모델 사용 — 벤더 종속 없음 |
| Redis/Postgres의 세션 상태와 맞춤형 직렬화 | 모든 세션에 내장된 무제한 메모리와 컨텍스트 |
| 프로비저닝된 벡터 데이터베이스, 청킹 및 임베딩 파이프라인(월 $1,000–$5,000) | 내장 RAG를 갖춘 완전 관리형 관계형 및 벡터 스토리지 |
| 직접 작성한 도구 래퍼, 인증 흐름, 오류 보일러플레이트 | 플랫폼 네이티브 도구와 모든 원격 MCP 서버를 즉시 사용 가능 |
| 서버, 컨테이너, 확장 정책, 가동 시간 모니터링 | 안정적인 API를 갖춘 프로덕션급 관리형 인프라 |
에이전트 오케스트레이션
다단계 추론, 도구 호출, 검색, 응답 종합은 플랫폼 내부에서 실행됩니다. 구축하고 유지할 그래프 정의, 상태 스키마, 워크플로 DAG가 없습니다. 에이전트가 달성해야 할 무엇을 정의하면, 인프라가 프로덕션 신뢰성에 필요한 제한되고 제어 가능한 실행 방식으로 어떻게 할지를 결정합니다.
어떤 모델이든 사용
하나의 자격 증명을 통해 OpenAI, Anthropic, Google, xAI, Qwen 등의 모델로 에이전트를 구동하세요. 복잡한 추론에는 프런티어 모델을 사용하고, 대량 세션에는 비용 효율적인 모델을 사용하세요. 에이전트별로 자유롭게 전환할 수 있으며, 공급자별 키 관리도 없고 새로운 모델 세대가 출시될 때 마이그레이션 작업도 필요 없습니다. 모든 전환 과정에서 메모리와 지식 레이어는 유지됩니다.
메모리 및 컨텍스트
모든 세션에는 무제한 대화 메모리와 컨텍스트가 내장되어 있습니다. 일관된 세션 식별자를 전달하면 에이전트가 각 사용자의 이력, 선호도, 장기 프로젝트를 기억합니다. 외부 상태 저장소, 직렬화 코드, 컨텍스트 윈도우 엔지니어링이 필요 없습니다. DIY 스택에서 가장 오류가 발생하기 쉬운 레이어는 여러분에게는 아예 존재하지 않습니다.
완전 관리형 스토리지
내장 RAG를 갖춘 관리형 관계형 및 벡터 데이터베이스를 제공합니다. 문서와 지식 베이스를 업로드하면 플랫폼이 청킹, 임베딩, 인덱싱, 검색을 처리합니다. 프로비저닝하거나 튜닝하거나 확장할 벡터 데이터베이스가 없습니다. 월 $1,000–$5,000의 비용 항목과 이를 유지하는 엔지니어가 사라집니다.
도구 및 MCP
플랫폼 네이티브 도구와 모든 원격 MCP 서버를 활용하는 무제한 도구 통합이 즉시 준비됩니다. 검색, 이메일, 캘린더, 문서, 자체 내부 API까지 연결할 수 있습니다. 타사 API가 변경될 때 유지해야 하는 래퍼 코드, 인증 흐름 배관 작업, 보일러플레이트가 없습니다.
프로덕션급
안정적인 API를 갖춘 완전 관리형 인프라는 프로덕션 트래픽을 위해 설계되었습니다. 여러분 쪽에서 관리할 서버, 컨테이너, 확장 정책이 없습니다. 플랫폼은 70개국 이상에서 30,000명 이상의 사용자로 프로덕션 검증을 거쳤으므로, 팀이 직접 구축할 필요 없는 신뢰성을 에이전트가 그대로 상속받습니다.
단일 호출로 완전한 에이전트를 실행할 수 있습니다.
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
오케스트레이션, 메모리, 검색, 도구 호출은 모두 해당 요청 안에서 실행됩니다. 여러분의 앱은 응답을 렌더링하고, 그 뒤의 모든 것은 플랫폼이 소유합니다.
구축할 수 있는 것
이 API는 자체 제품의 기능으로 맞춤형 상태 유지 에이전트를 출시하는 개발자를 위해 설계되었습니다. 다음 각각은 구축하고 출시할 수 있는 앱입니다. 에이전트의 지침과 지식 베이스를 정의하면 API가 오케스트레이션, 메모리, 확장을 처리합니다.
제품에 학습된 지원 에이전트
도움말 센터, 변경 로그, 티켓 이력에 기반한 지원 에이전트를 구축하세요. 세션 메모리는 상호작용 전반에 걸쳐 각 고객의 전체 지원 여정을 추적하므로, 더 이상 "계정 번호를 다시 말씀해 주시겠어요?"라고 물을 필요가 없습니다.
- 문서 인덱싱과 검색을 처음부터 끝까지 관리
- MCP를 통해 티켓 시스템과 CRM 연결
- 상태 관리에 한 분기를 쓰는 대신 며칠 만에 출시
임베디드 금융 분석가
핀테크 대시보드 안에서 포트폴리오 자문가를 출시하세요. 수개월에 걸친 대화 속에서 각 고객의 보유 자산, 위험 허용도, 목표를 기억합니다.
- 시간에 따른 자문 컨텍스트를 자동으로 유지
- MCP를 통해 시장 데이터와 계정 시스템 연결
- 비용 최적화를 위해 쿼리 복잡도별 모델 전환
학습 플랫폼을 위한 개인화 튜터
커리큘럼에 기반하여 세션 전반에서 각 학생의 진도, 취약 영역, 선호도를 추적하는 적응형 튜터를 배포하세요.
- 관리할 사용자별 데이터베이스 행 없이 학생별 메모리 제공
- 커리큘럼 업데이트는 업로드만으로 배포되며 검색 재엔지니어링 불필요
- 관리형 인프라에서 수천 명의 동시 학습자로 확장
카탈로그를 이해하는 커머스 어시스턴트
카탈로그를 이해하고, 각 쇼핑객의 선호도와 구매 이력을 기억하며, 필터가 아닌 대화로 상품 탐색을 안내하는 대화형 쇼핑 어시스턴트를 임베드하세요.
- 관리형 RAG로 카탈로그에 기반 — 업데이트가 즉시 배포
- 외부 상태 저장소 없는 쇼핑객별 선호도 메모리
- 피크 트래픽을 위한 프로덕션급 동시성
자체 팀을 위한 내부 운영 에이전트
내부 문서, 티켓 시스템, 데이터 시스템에 연결된 운영 에이전트를 구축하세요. 완전한 조직 컨텍스트로 직원 질문에 답하고 일상적인 워크플로를 실행합니다.
- 비공개 지식 베이스를 자동으로 인덱싱
- 원격 MCP 서버를 통해 내부 API 연결
- 코드가 아닌 구성으로 새 기능 배포
API 키를 받아 몇 분 만에 첫 번째 에이전트를 출시하세요.
작동 방식: API 키에서 프로덕션 에이전트까지 4단계
1단계: API 키 받기
계정을 만들고 플랫폼 대시보드에서 API 키를 생성하세요. 하나의 자격 증명으로 모든 모델 공급자와 구축하는 모든 에이전트를 사용할 수 있습니다. 개발, 스테이징, 프로덕션 환경 전반에서 공급자별 키를 관리할 필요가 없습니다.
2단계: 에이전트 구축 또는 선택
자체 지침, 선호 모델, 지식 베이스, 도구 구성으로 맞춤형 에이전트를 정의하거나, 사전 구축된 에이전트로 시작해 필요에 맞게 조정하세요. 에이전트 생성은 코드가 아니라 구성입니다. 동작을 설명하면 플랫폼이 그 뒤의 오케스트레이션, 메모리, 검색을 제공합니다.
3단계: 크레딧 추가
계정 크레딧을 충전하세요. 사용량은 호출당 잔액에서 차감됩니다. 별도의 인프라 청구서, 벡터 데이터베이스 청구서, 백그라운드에 숨은 메모리 저장소 비용이 없습니다.
4단계: 호출하기
백엔드에서 사용자의 메시지를 에이전트 ID와 세션 식별자와 함께 전달하세요. 세션 ID를 재사용하면 에이전트는 해당 사용자와 마지막으로 중단한 정확한 지점에서 다시 시작합니다.
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
구성할 메모리 저장소도, 유지할 검색 파이프라인도, 디버깅할 오케스트레이션 그래프도 없습니다. 전체 엔드포인트 사양, 요청 및 응답 스키마, 통합 세부 정보는 API 문서에서 확인할 수 있습니다.
결과 및 사용 사례
💼 SaaS 스타트업: $270K–$690K 대신 한 번의 스프린트
시나리오: 고객 3,000명을 보유한 B2B SaaS 기업이 문서를 이해하고 각 계정의 이력을 기억하는 인앱 지원 에이전트를 원합니다. 엔지니어링 팀은 3명입니다.
기존 접근 방식: DIY 경로의 1년 차 비용은 $270,000–$690,000에 이릅니다(Particle41). 오케스트레이션 프레임워크 선택, 벡터 데이터베이스 프로비저닝, Redis 또는 Postgres의 테넌트별 메모리, 티켓 시스템용 도구 래퍼, 그다음 호스팅·확장·모니터링까지 필요합니다. 첫 고객 대상 답변이 나오기도 전의 일입니다.
Jenova Agent API: 지원 지침과 에스컬레이션 규칙을 정의하고, 도움말 센터를 업로드하고, MCP로 티켓 시스템을 연결하세요. 지속형 세션 메모리가 첫날부터 모든 계정에 연속적인 지원 이력을 제공합니다.
- ✅ 수개월이 아닌 며칠 만에 프로덕션 출시
- ✅ 6자리 수 인프라 예산을 제품 엔지니어링에 재투자
- ✅ 프로비저닝하거나 유지할 메모리 시스템과 벡터 데이터베이스 불필요
📊 핀테크: 백엔드 팀 없이 만드는 자문 기능
시나리오: 한 핀테크 기업이 프리미엄 대시보드 기능으로 AI 포트폴리오 분석가를 원합니다. 백엔드 엔지니어 2명은 에이전트 인프라를 구축해 본 적이 없습니다.
기존 접근 방식: 오케스트레이션 프레임워크를 학습하고, 상태 유지 자문 워크플로를 구축하고, 지속적인 고객 관계를 위한 메모리 영속성을 구현하고, 금융 문서를 위한 RAG를 프로비저닝해야 합니다. 이는 실무자들이 프로토타입과 출시 사이에서 설명하는 4~6개월의 프로덕션 격차와 같습니다(
).Jenova Agent API: 도메인 지침으로 금융 분석가 에이전트를 구성하고, MCP로 시장 데이터를 연결한 뒤, 내장 메모리가 모든 자문 대화에서 포트폴리오 컨텍스트를 유지하도록 하세요.
- ✅ 학습, 호스팅, 유지할 프레임워크 불필요
- ✅ 즉시 제공되는 장기 고객 메모리
- ✅ 코드 변경 없이 비용 최적화를 위한 모델 전환
📱 모바일 EdTech: 동시 학생 30,000명을 위한 튜터링
시나리오: 학생 30,000명에게 서비스를 제공하는 모바일 교육 앱이 4개 과목에 걸친 개인화 튜터를 필요로 합니다. 각 튜터는 커리큘럼 지식과 학생별 진도 추적 기능을 갖춰야 합니다.
기존 접근 방식: 과목별 에이전트 구성, 외부 데이터베이스의 학생별 메모리 영속성, 커리큘럼용 벡터 스토리지가 필요합니다. 또한 컨텍스트 손실 없이 수만 개의 동시 상태 유지 세션을 처리할 인프라도 필요합니다. 이것이 바로 레거시 인프라가 실패하는 워크로드입니다(VAST Data).
Jenova Agent API: 커리큘럼별 지침과 자료로 과목당 튜터 에이전트 하나를 만드세요. 세션 메모리가 각 학생의 진도를 자동으로 유지하고, RAG가 업로드 시 커리큘럼을 인덱싱합니다.
- ✅ 외부 상태 저장소 없는 지속형 개인화 학습 컨텍스트
- ✅ 검색 재엔지니어링 없이 커리큘럼 업데이트 배포
- ✅ 첫날부터 제공되는 프로덕션급 동시성
🎯 제품 에이전시: 4개 고객사, 하나의 통합
시나리오: 한 개발 에이전시가 의료 접수, 법률 문서 검토, 커머스 상품 탐색, 엔터프라이즈 검색을 위한 AI 기능을 4개 고객사에 구축하고 있습니다. DIY 방식은 고객사별로 메모리 저장소, RAG 파이프라인, 호스팅을 중복 구축해야 함을 의미합니다.
기존 접근 방식: 4개의 별도 에이전트 스택, 즉 4개의 검색 파이프라인, 4개의 확장 구성, 4개의 유지 관리 책임이 생깁니다. 에이전틱 프로젝트의 40%가 부적절한 기반으로 실패한다는 점을 고려하면(Landbase), 가장 위험한 레이어를 4번 복제하는 것은 포트폴리오 차원의 도박입니다.
Jenova Agent API: 4개 고객사 모두에 하나의 통합과 하나의 API 키를 사용하세요. 고객사별로 도메인 지침, 모델, 지식 베이스, 도구를 갖춘 맞춤형 에이전트를 구성하되, 모두 같은 관리형 백엔드에서 실행됩니다.
- ✅ 하나의 통합으로 무제한 고객 프로젝트까지 확장
- ✅ 고객사별 공급자 관리 없이 고객사별 모델 선택
- ✅ 인프라 복제가 아닌 제품 로직에 엔지니어링 시간 투자
FAQ
AI 에이전트 백엔드를 처음부터 구축하는 데 얼마나 드나요?
인프라, 프롬프트 엔지니어링, 테스트, 데이터 통합, 벡터 데이터베이스, 인적 감독을 포함하면 프로덕션 에이전트 하나의 현실적인 1년 차 비용은 $270,000–$690,000에 이른다는 엔지니어링 분석이 있습니다. 모델 API 호출은 전체의 약 2%에 불과합니다(Particle41). 이후 지속적인 운영 비용은 연간 $150,000–$300,000입니다.
Jenova Agent API의 가격과 크레딧은 어떻게 작동하나요?
사용량은 크레딧 기반입니다. 계정에 크레딧을 추가하면 각 API 호출이 잔액에서 차감됩니다. 별도의 인프라, 데이터베이스, 메모리 저장소 비용은 없습니다. 관리형 스택이 사용량에 포함되므로, 그렇지 않았다면 5~6개 공급자에게 지불할 청구서를 하나로 통합합니다. 현재 요금은 플랫폼 페이지에서 확인하세요.
API를 통해 어떤 모델을 사용할 수 있나요?
하나의 통합을 통해 OpenAI, Anthropic, Google, xAI, Qwen 등의 모델로 에이전트를 구동할 수 있습니다. 에이전트별로 모델을 선택하고 자유롭게 전환할 수 있습니다. 벤더 종속이 없으며, 새 모델 세대가 출시되어도 마이그레이션 작업이 필요 없습니다. 메모리와 지식은 모델 변경 후에도 유지됩니다.
LangChain 또는 원시 모델 API로 구축하는 것과 비교해 통합은 얼마나 어려운가요?
통합은 API 키 받기, 에이전트 구축 또는 선택, 크레딧 추가, 첫 호출 실행의 4단계를 따릅니다. 하나의 POST 요청으로 오케스트레이션, 메모리, RAG, 도구를 포함한 완전한 에이전트가 실행됩니다. 원시 모델 API는 추론만 제공하고, LangChain 같은 프레임워크는 여전히 직접 호스팅·확장·유지해야 하는 추상화를 제공합니다. Jenova Agent API는 관리형 백엔드 자체입니다. 전체 스키마는 API 문서에서 확인할 수 있습니다.
자체 데이터와 도구로 맞춤형 에이전트를 구축할 수 있나요?
예. 맞춤형 지침을 정의하고, 비공개 지식 베이스를 업로드하며(관리형 RAG를 통해 자동 인덱싱), 모델을 선택하고, 도구를 구성할 수 있습니다. 대부분의 내부 API를 포괄하는 모든 원격 MCP 서버도 포함됩니다. 에이전트는 범용 어시스턴트가 아니라 제품만의 독점 기능으로 작동합니다.
관리형 에이전트 API는 실제 트래픽을 위한 프로덕션 준비가 되어 있나요?
예. 인프라는 프로덕션 트래픽을 위해 설계된 안정적인 API와 함께 완전 관리됩니다. 여러분 쪽에서 관리할 서버나 확장 정책이 없습니다. 플랫폼은 70개국 이상에서 30,000명 이상의 사용자로 프로덕션 검증을 거쳤으며, 사용량은 직접 프로비저닝하는 인프라가 아니라 크레딧 잔액에 따라 확장됩니다.
결론
AI 에이전트 백엔드를 처음부터 구축하는 경로는 2026년에 잘 문서화되어 있습니다. 1년 차 비용 $270,000–$690,000, 수개월의 오케스트레이션 및 RAG 엔지니어링, 영구적으로 유지해야 할 벡터 데이터베이스와 메모리 레이어, 그리고 출시 전에 프로젝트의 40%를 무너뜨리는 프로덕션 격차가 있습니다. 어려운 부분은 결코 모델 호출이 아니었습니다. 그 주변의 모든 것이 어려운 부분입니다.
Jenova Agent API는 이 전체 스택을 하나의 통합으로 대체합니다. 지침, 모델, 지식 베이스, 도구로 정의된 맞춤형 에이전트가 내장 오케스트레이션, 메모리, 스토리지, MCP 도구를 갖춘 완전 관리형 프로덕션급 인프라에서 실행됩니다. 에이전트를 정의하고, 호출하고, DIY 경로에서 수 분기로 계획하는 것을 며칠 만에 출시하세요. API 문서로 구축을 시작하고, Jenova Agent API 플랫폼에서 API 키를 받아 Jenova의 더 넓은 플랫폼도 살펴보세요.