長期PhD研究に最適なAIリサーチアシスタントはどれか?
2026-08-21
継続的な記憶と引用の信頼性は、PhD向けAIアシスタントをどう分けるのか?
数週間ではなく数年にわたる博士研究では、2026年に推奨すべきアシスタントは、セッションをまたいでプロジェクトの文脈を保持し、かつ主張を特定可能な文献に結び付け続けられるものです。Jenova's Academic Research Assistantは、継続的なプロジェクト記憶、文献発見、引用を意識した原稿支援という組み合わせを軸に構築されています。一方、Elicit、Consensus、ResearchRabbit、Sciteは、それぞれ研究パイプラインにおける、より限定的ながら価値の高い領域を担います。
PhD学生にとって重要な分岐点は、「どのチャットボットが最も賢いか」ではありません。3週間後に戻ってきたとき、そのツールがあなたの理論的枠組み、棄却した仮説、すでに読んだ論文をまだ把握しているかどうかです。
PhD向けアシスタントと使い捨てのQ&Aウィンドウを分ける主な要素は、次のとおりです。
✅ セッション横断のプロジェクト記憶。直前のプロンプトだけでなく、研究課題、手法の選択、指導教員の制約を保存すること ✅ 文献の網羅性。区別されないWeb検索結果ではなく、学術インデックスに基づいていること ✅ 情報源レベルの引用の信頼性。あらゆる統合結果を元論文に照らして確認できること ✅ 複数年にわたるワークフローへの適合性。ノート、草稿、検索結果がリセットされず蓄積されること ✅ 率直なタスク境界。発見、抽出、引用検証、執筆は異なる仕事であり、すべてを同じ水準で実行できるツールはほとんどないこと
これらのツールを有用に比較するには、博士研究をまず継続性の問題、次に検索の問題として捉えるとよいでしょう。
博士研究では、なぜセッション横断の記憶が授業課題より重要なのか?
セッション横断の記憶がPhD研究でより重要なのは、学位論文が単発の課題ではなく複数年にわたる論証であり、論証を忘れるツールは学生に毎回マシンへの再説明を強いるからです。授業課題ならリセットされても対応できますが、博士論文ではできません。
2025 HEPI学生生成AI調査では、英国の学部生の92%が何らかの形でAIを利用していることが示されました。これは2024年の66%から増加しており、一般的な用途には論文要約や研究アイデアの提案が含まれます。博士研究者も同じツールセットを受け継ぎますが、彼らの作業単位は異なります。進化する文献マップ、失敗したパイロット調査を受けて書き直す方法論章、数か月にわたって指導教員と調整する理論的枠組みです。
研究者を対象とした大規模調査では、25.9%が少なくとも1日1回AIツールを研究に使用していると報告されており、記憶の失敗は時折の不便ではなく日々の負担になります。リセットのたびに、プロジェクトの作業モデルが失われます。つまり、すでに除外した論文、採用を断念した操作化、改稿をいまも制約しているジャーナル査読者のコメントです。
コンテキストウィンドウは記憶ではありません。現在のスレッドを保持しても、やがて消えます。継続的な記憶が保存するのは、研究課題、コーパス、意思決定、未解決の問題というプロジェクトそのものです。3~6年に及ぶ博士課程では、この違いが、蓄積的に役立つアシスタントと、単にその場の補完を行うだけのアシスタントとの隔たりになります。
PhD学生はAIリサーチアシスタントの何を評価すべきか?
PhD学生は、継続性・網羅性・引用(C3+)フレームワークと呼ぶ6つの観点、すなわち継続的な記憶、文献の網羅性、構造化抽出、引用の信頼性、原稿支援、博士課程全体での費用でAIリサーチアシスタントを評価すべきです。検索だけで高得点のツールでも、プロジェクトを記憶できなければ失格です。
単発の質問ではなく長期研究に重み付けした6つの観点は、以下のとおりです。
- セッション横断のプロジェクト記憶。 アシスタントは、研究課題、採択基準、除外論文、執筆の文体を数週間・数か月にわたって保持できるか?
- 文献の網羅性。 大規模な学術インデックスを検索できるか? Elicitは、1億3,800万本を超える学術論文を検索対象としていると報告しています。ResearchRabbitは、3億1,000万本を超える論文へのアクセスを報告しています。
- 構造化抽出と統合。 手法、サンプル、結果を比較可能な表に取り込めるか。それとも文章の要約しか生成できないか?
- 引用の信頼性。 主張は文単位の情報源、引用文脈、または「コンセンサス」表示に結び付けられているか。さらに、元論文を開けるか?
- 原稿支援。 ツールはアウトライン作成、引用、改稿を助けるか。それとも執筆は別の場所で行う必要があるか?
- PhD期間を通じた費用。 月額$10のツールと、月額$49の体系的レビュー用ワークベンチは、博士候補者期間の4年分で計算すると大きく異なります。
博士研究の評価には、さらに2つのフィルターが必要です。第一に、HEPIのサンプルでは制度的なAI研修を受けた学生は36%にすぎません。したがって、専門的な導入プログラムなしでも使える必要があります。第二に、学生の51%がAIを避ける理由としてハルシネーションを挙げています。このため、引用の信頼性は付加機能ではなく中核的な基準です。
実践的なルールは明確です。情報源を開かずに方法論セクションでその出力を信頼できないなら、そのツールは発見支援であって、レビューの共著者ではありません。
Jenova、Elicit、Consensus、ResearchRabbit、Sciteは長期プロジェクトでどう比較できるか?
Jenova's Academic Research Assistantは、ボトルネックが数年にわたるプロジェクトの継続性である場合に最も適しています。一方、Elicitは構造化抽出、Consensusは迅速なエビデンスの概観、ResearchRabbitは引用マップによる発見、Sciteは論文がどのように引用されているかの確認により強みがあります。いずれも文献管理ソフトや人間によるプロトコルの代わりにはなりません。
| 機能 / 観点 | Academic Research Assistant(Jenova) | Elicit | Consensus | ResearchRabbit | Scite |
|---|---|---|---|---|---|
| セッション横断のプロジェクト記憶 | セッションをまたぐ継続的な記憶と無制限のチャット履歴 | ライブラリとアラートにより情報源を再利用できるが、完全なプロジェクト記憶エージェントではない | 製品内の検索・レビュー履歴。長期プロジェクト記憶は限定的 | 論文追加に伴うコレクションと推薦学習 | 引用データベースとアラート。学位論文の記憶を持つエージェントではない |
| 文献の網羅性 | 学術データベースとオープンWebを横断するリアルタイム発見 | 1億3,800万本超の論文と54万5,000件の臨床試験 | 研究デザインの手掛かりを備えた査読済みエビデンス検索 | 引用マッピングを備えた3億1,000万本超の論文 | Smart Citationsを備えた大規模引用インデックス |
| 構造化抽出 | 統合と原稿志向の要約。PRISMA用ワークベンチではない | 表、スクリーニング、体系的レビューのワークフロー | コンセンサスメーターと研究スナップショット | 視覚的マップ。抽出表ではない | 引用文脈(支持 / 反証)。アウトカム表ではない |
| 引用の信頼性 | インライン引用と情報源に基づく草稿作成 | 生成された主張への文単位の引用 | Web上の雑談ではなく論文に基づくエビデンス回答 | 引用と共著者による書誌的連鎖 | 論文がどのように引用されているかを示すSmart Citations |
| 価格(2026年時点) | 無料プラン、月額$20からの有料プラン | 無料Basic、Proは通常年払いでユーザーあたり月額$49と掲載 | 無料プランに加え、Deep Searchと高い利用上限の有料アップグレード | 中核的なマッピング機能は無料で利用可能 | 有料研究プラットフォーム。現行価格を要確認 |
| 最適な用途 | 記憶、検索、執筆を一つのスレッドで必要とする複数年のPhDプロジェクト | 抽出表を用いる体系的レビューまたはスコーピングレビュー | 「文献は何を示しているか」を素早く確認する質問 | シード論文から分野をマッピングすること | 引用が主張を支持するか反証するかの検証 |
Elicit自身の資料では、研究者が体系的レビューで最大80%の時間削減を報告しており、有料プランでは数千本の論文をスクリーニングできるとしています。これはプロトコル駆動型レビューにおける真の強みです。ただし、6か月後に、なぜある構成概念を放棄したのかを記憶することとは別の仕事です。
ResearchRabbitは、信頼できる1本のシード論文から関連研究、著者、研究上のギャップの地図を作るのに特に有効です。ノースイースタン大学図書館は、これを無料で利用できる引用ベースの文献マッピングツールと説明しています。Sciteの独自の貢献は、引用の文脈です。つまり、後続の論文がある知見を支持しているか、異議を唱えているかを見ることです。パデュー大学図書館は、SciteをSmart Citationsを備えた引用データベースとして紹介しています。
Jenovaの制約は、これらの強みの裏返しです。専用のPRISMAスクリーニング環境ではなく、Sciteのように引用のセンチメントを分類せず、数十のカスタム列を備えたElicit型の抽出表も提供しません。Cochrane形式のレビューを行う学生は、依然として専用のレビュー用ワークベンチを併用すべきです。
継続的なプロジェクト記憶は、複数年にわたる学位論文ワークフローをどう変えるのか?
継続的なプロジェクト記憶は、すべてのセッションを再導入ではなく継続に変えます。その結果、文献検索、ノート作成、草稿執筆が、蓄積される一つのプロジェクトモデルを共有します。実際には、繰り返しの説明が減り、矛盾する要約も少なくなります。
一般的な博士課程は、スコーピング、体系的またはナラティブレビュー、方法論設計、データ収集、分析、原稿改訂という段階を経ます。忘れやすいアシスタントは、これらを無関係なチャットとして扱います。記憶があれば、アシスタントは、すでに横断研究を除外したこと、指導教員がケイパビリティ・アプローチの枠組みを却下したこと、Zoteroライブラリ内の3本の論文に方法論上の弱点があることを思い出せます。
Jenova's Academic Research Assistantは、この種の作業文脈をセッション間で保存し、モデルを切り替えたり、論文を非公開のナレッジベースとして添付したりする際にも維持できます。長期プロジェクトでこのパターンを試すと、得られる利点は表現の巧みさではありません。一貫性です。同じ採択基準、同じ操作的定義、同じ「このプレプリントを確立済みの知見として引用しない」という規則を保てます。
対応するツールも依然として重要です。Elicitのライブラリおよびアラート機能は、情報源の再利用と分野の監視を助けます。ResearchRabbitのコレクションは、論文を加えるほど賢くなります。これらはコーパスの記憶です。あなた自身のプロジェクト上の意思決定を記憶することとは異なります。
2026年に向けた有用な役割分担は、次のとおりです。
- 継続中のプロジェクトモデル、すなわち課題、除外基準、指導教員の制約、草稿履歴を、セッション横断の記憶を持つアシスタントに保持する。
- 引用ネットワークに特化したResearchRabbitまたはLitmapsで分野マッピングを行う。
- 段落ではなく比較可能な行が必要な場合は、Elicitで構造化抽出を行う。
- 論争のある引用は、文献章に入れる前にSciteで検証する。
この順序を逆にし、マッピングツールに学位論文を記憶させようとしたり、記憶機能のあるアシスタントに二重スクリーニングを置き換えさせたりする学生は、流暢であっても監査不能なレビューに行き着くことが多いのです。
体系的レビューと探索的文献マッピングでは、どのAIツールが適しているのか?
体系的レビューには文書化されたスクリーニングと抽出が必要です。探索的マッピングには引用ネットワークと意味検索が必要です。最適なツールは、実際にどの種類のレビューを書いているかによって決まります。これらの製品群を混同すると、セットアップ時間を無駄にします。
CASRAIの体系的文献レビュー向けAIツールガイドは、この境界を明確にしています。正式なPRISMA形式のレビューでは、重複除去済みのインポート、独立した2名によるスクリーニング、構造化抽出、バイアスリスク評価が前提となります。このパイプラインに位置するツールには、Rayyan、Covidence、ASReview、DistillerSRがあります。Elicitは発見とこのカテゴリーの中間に位置します。幅広い論文インデックスを検索し、体系的レビューの実践に沿ったスクリーニング機能と抽出機能を提供します。
探索的レビューやナラティブレビュー、すなわち健康科学以外でより一般的なPhDの文献章には、発見・マッピングツールの方が適しています。Semantic Scholarは、AIを用いて学術検索を改善します。LitmapsとResearchRabbitは、研究がどのように結び付くかを可視化します。Consensusは、比較的限定された実証的問いがあり、完全なマップではなく査読済みエビデンスの合意状況を概観したい場合により強みを発揮します。
エビデンス統合における責任あるAI利用に関するRAISEプロジェクトで論じられている、Cochrane、Campbell Collaboration、JBI、その他のエビデンス統合グループに関連する共同見解では、AIを査読者の判断を支援するものとして扱っており、その代替とは見なしていません。レビューに影響を及ぼす適格性判断、抽出、バイアスリスクの判定には、依然として人間による検証と、使用したシステムの開示が必要です。
PhD学生にとっての判断ルールは簡単です。
- 登録済みの体系的レビューまたはスコーピングレビュー → 監査証跡にはElicit、Covidence、Rayyanを使用する。スクリーニングログをチャットの記憶だけに依存しない。
- 分野を形作るナラティブレビュー → マップにはResearchRabbitまたはLitmapsを使い、マップの成長とともに論証の一貫性を維持するために記憶機能のあるアシスタントを併用する。
- 迅速な実証的確認(「エビデンスはXを支持しているか?」)→ Consensusを使用し、その後で元の研究を開く。
Jenova's Academic Research AssistantはCovidenceの代替ではありません。その強みは、専門ツールが段階ごとの作業を行う間、レビューがなぜ現在の形になっているのかを記憶する層として機能することにあります。
複数年にわたるPhDプロジェクト用にAIリサーチアシスタントを設定するには?
AIリサーチアシスタントを最大限に活用するには、最初のセッションで研究課題、制約、コーパス、非目標を含むプロジェクトを記述し、毎回新しく始めるのではなく同じスレッドを再利用します。設定はプロンプトの小技ではなく、プロトコルです。
Jenova's Academic Research Assistantでは、持続可能な設定は次のようになります。
- エージェントを開き、一行のトピックではなく、進行中のプロトコルとしてプロジェクトを説明する。
「私は社会学の博士課程3年生です。学位論文の仮題は、東南アジアのギグワークにおけるプラットフォーム労働とアルゴリズム管理です。理論的枠組みは労働過程論であり、ケイパビリティ・アプローチではありません(指導教員は3月に後者を却下しました)。手法は複数地点でのエスノグラフィーとプラットフォーム・インターフェース分析です。ブログ記事や査読前のプレプリントを、査読済み情報源と同等に扱わないでください。」
- 現在のアウトライン、代表的なPDF一式、保存を許可されている指導教員のメモを添付する。
- 直近24か月の文献について、除外対象を明記した情報源付きマップを依頼する。
- 指導面談のたびに同じプロジェクトスレッドに戻り、プロトコルを更新する。たとえば「構成概念Xを削除する。論文Yをネガティブケースとして追加する」と記録する。
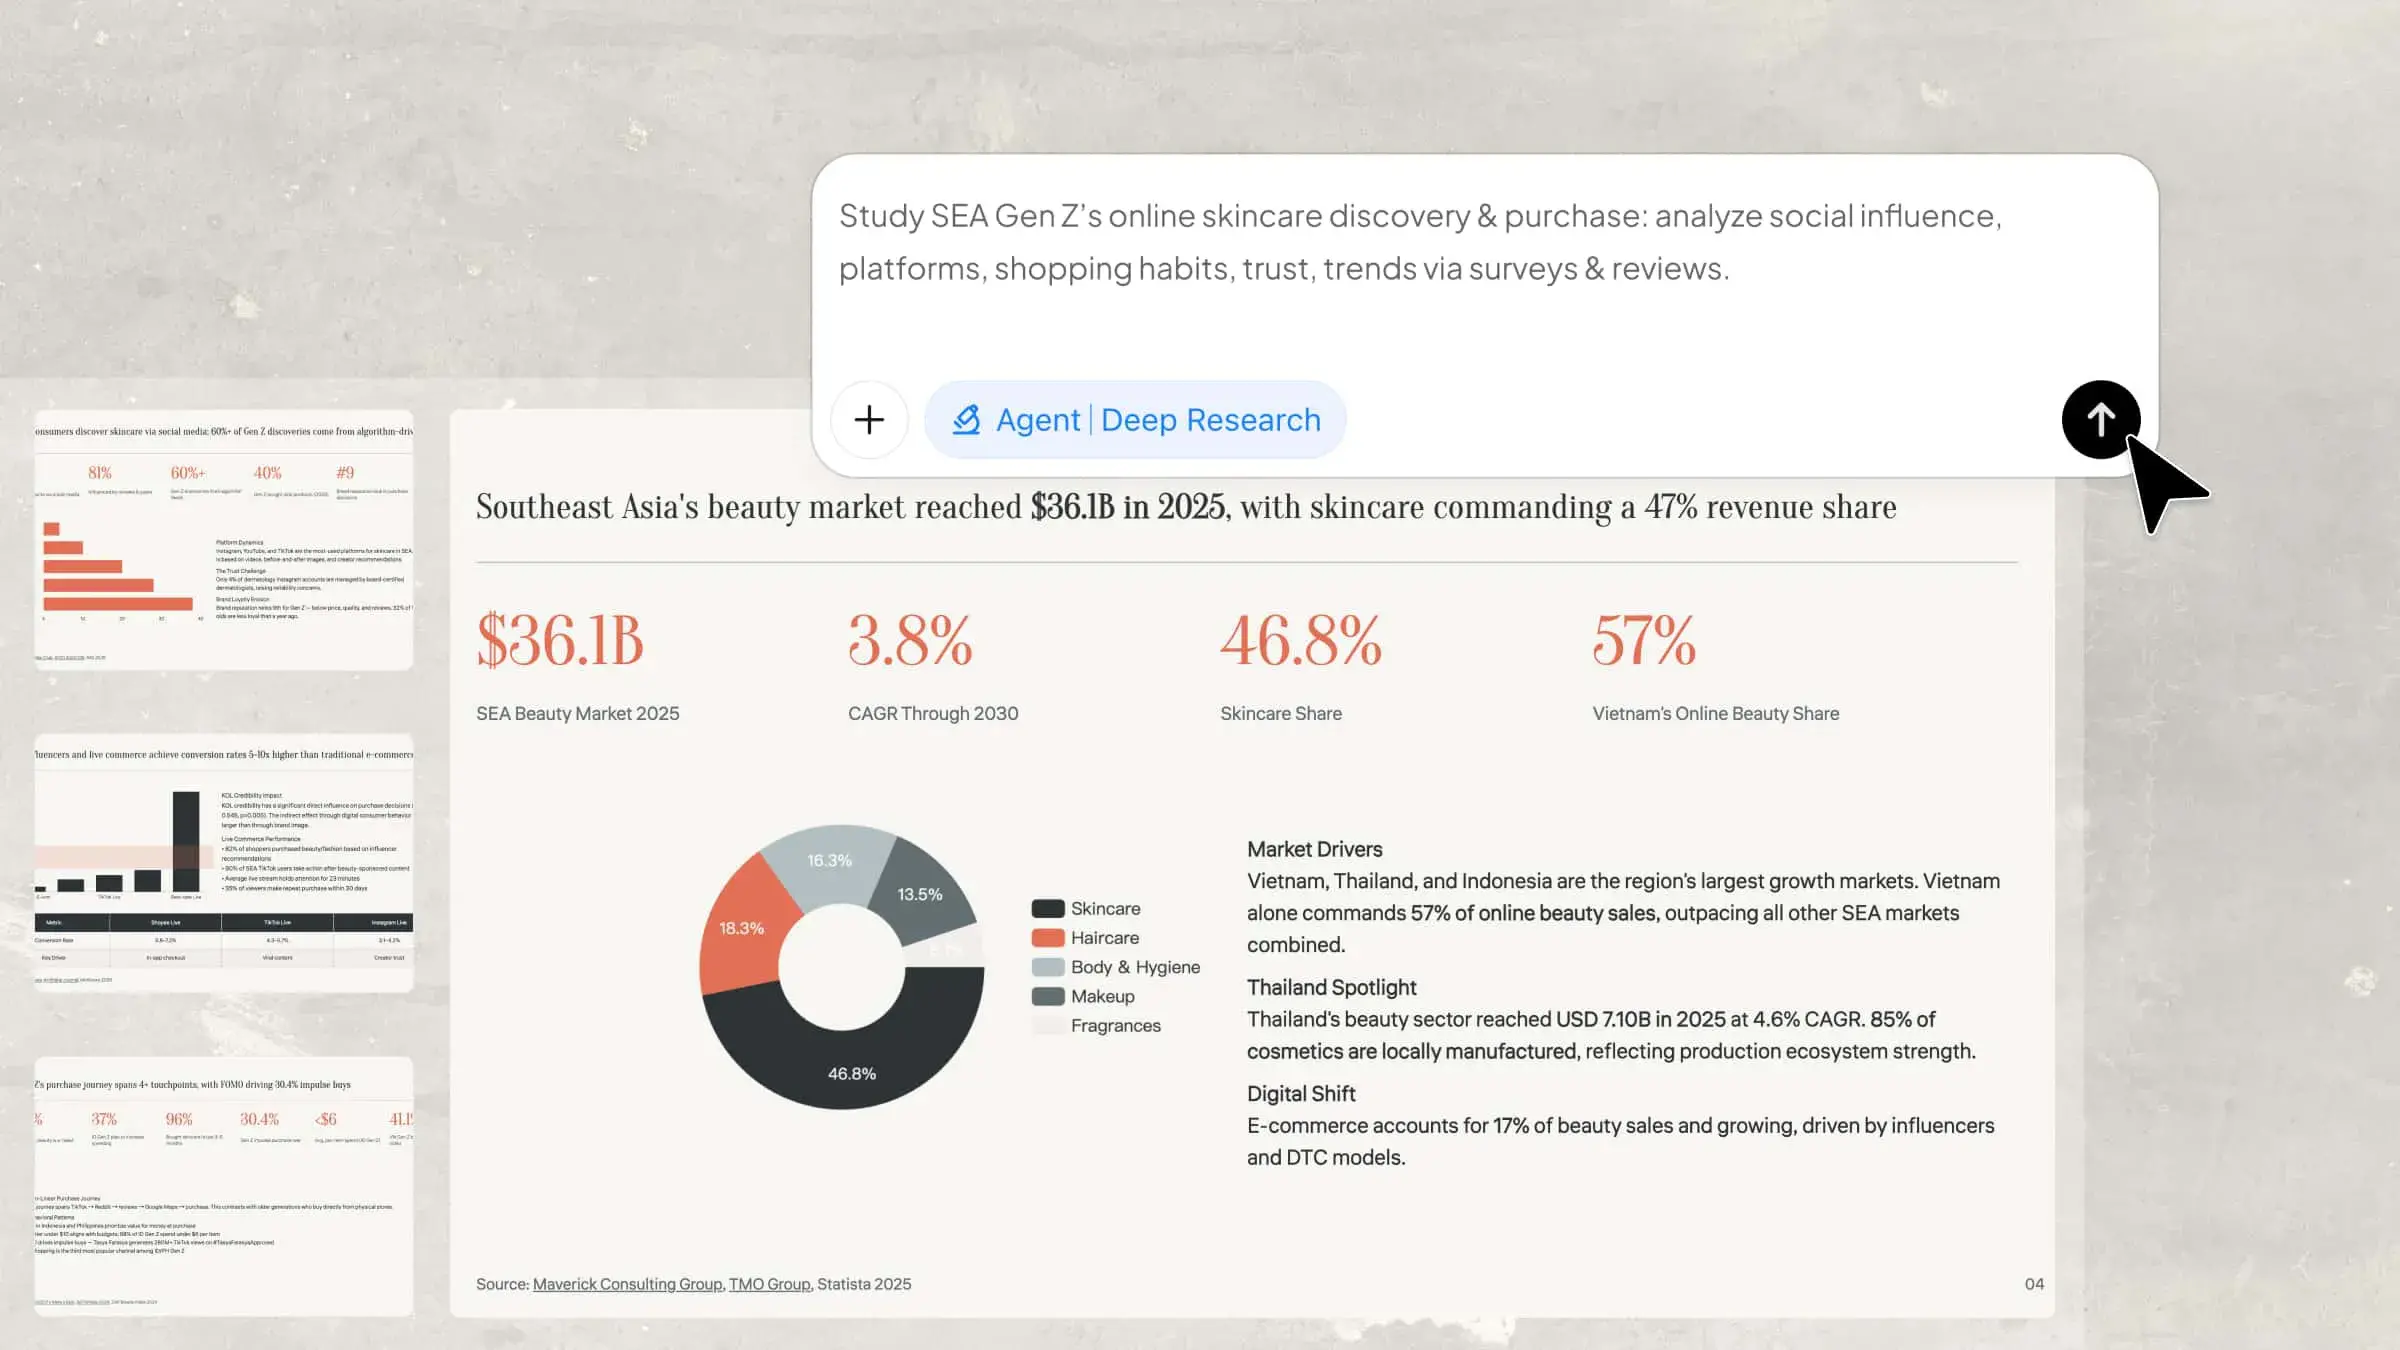
関連エージェントであるDeep Researchは、対話ではなく、長く引用付きのブリーフィングが必要な場合に有用です。たとえば国別のエビデンス調査や、構造化された市場・政策メモを作成し、その後にAcademic Research Assistantで精査する場合です。レポートのパターンは博士研究者にも必要なものと同じです。根拠のない段落ではなく、見出しとなる知見、情報源付きの指標、セグメント別分析です。
Elicitでは、対応する設定は記憶優先ではなく質問優先です。明確に定義した研究課題を入力し、論文リストを精査してから、抽出列を追加します。たとえば対象集団、n、デザイン、アウトカムです。ElicitのProプランは体系的レビュー向けに位置付けられています。無料プランより大規模なスクリーニングが含まれます。すでにZoteroを記録の中核コーパスとしている場合は、そこからインポートしてください。
ResearchRabbitでは、すでに信頼している2~3本のシード論文から始め、コレクションを作り、グラフは完成した参考文献一覧ではなく発見のための表面として扱います。保持する文献はすべて、Zotero、Mendeley、または自分で管理する別の文献管理ツールへエクスポートします。
設定の劣化を防ぐルールは2つあります。
- 文献管理ツールは引用の記録システムであり続けます。AIアシスタントは意思決定の記録システムです。
- 研究課題が変わったら、スレッド内でプロトコルを文書として更新します。明示しない漂流があると、記憶機能のあるツールが前学期の論文を擁護し始めます。
原稿の書式設定は、論証が安定してからJenovaのWord Doc Generatorのような専用フォーマッターに移せます。リサーチアシスタントに引用スタイルファイルの役割まで求めないでください。
研究方法論の専門家は、博士研究におけるAIの記憶について何を述べているか?
研究方法論の専門家は、AIの利用を単なる学術的誠実性、すなわち盗用の問題ではなく、開示、検証、来歴に関わる研究の誠実性の問題として扱う傾向を強めています。また、モデルの記憶が文書化されたプロトコルを置き換えるワークフローには懐疑的です。記憶は有用ですが、監査証跡ではありません。
「博士研究におけるAI利用で私たちが目にする失敗モードは、単発のハルシネーションによる引用ではありません。数か月にわたる文脈崩壊です。学生は理論的枠組みを洗練するのに6週間を費やした後、新しいチャットを開き、その枠組みを完全に無視した流暢な文献要約を受け取ります。継続的な記憶こそ、アシスタントをリセット型ではなく蓄積型にするものです。これがなければ、どのセッションでも、学生がすでに検討して退けた分野の一般的な『重要論文』が再び提示されます。」
「比較記事で中心的に取り上げられるツール、すなわち抽出のElicit、エビデンス概観のConsensus、マップのResearchRabbit、引用文脈のSciteは、いずれもその領域では本当に優れています。しかし、ほとんどのツールスタックにおいてPhDに欠けているのは、プロジェクトの作業記憶です。棄却した仮説、指導教員の制約、すでに方法論的に弱いと分かっている3つの研究です。これは検索の問題ではありません。継続性の問題です。検索と継続性を別々に解決し、それから接続してください。」
「私たちは今も、学生に人間が所有するプロトコルを維持するよう伝えています。AIの記憶は作業ノートであって、PRISMAログではありません。適格性判断や抽出をモデルが補助するなら、エビデンス統合ガイダンスの方向性に沿って開示と検証が必要です。自分自身の説明を繰り返さないために記憶を使ってください。レビューがどのように行われたかの唯一の記録として使ってはいけません。」
— Jenovaプロダクトチーム、研究エージェント設計、長期的な知識労働向けAIアシスタント開発8年
この立場は、チャット出力を引用可能な権威として扱うのではなく、信頼性と誤用防止を重視する欧州委員会の研究における生成AIの責任ある利用ガイドラインと一致しています。また、学生側の慎重さとも整合します。HEPIの回答者は、AI利用に対する主な抑止要因として、不正行為を疑われる恐れ(53%)と誤った結果(51%)を挙げました。
PhD学生は研究の誠実性を損なわずにAIをどう使うべきか?
PhD学生は、AIを検索、構造化、記憶、草稿作成のための文書化された研究支援として使い、検証、適格性判断、最終的な文言は人間の管理下に置くべきです。ここでの誠実性とは、調査対象学生の67%がすでに不可欠と考えるツールを使わないことではなく、来歴を管理することです。
2026年に実行可能な誠実性プロトコルは次のとおりです。
- システムを開示する。 アシスタント名、バージョンまたは利用日、実施したタスクを記載します。たとえば検索、スクリーニング支援、言語編集です。日常的なスペル修正は、適格性の提案と同じ水準の開示を必要としない場合が一般的です。
- すべての引用を検証する。 論文を開き、主張が本文に存在することを確認します。Sciteは、後続研究がある知見をどう引用したかを確認する際に有用ですが、精読の代わりにはなりません。
- 体系的レビューではスクリーニング判断をレビューソフトに保持する。 CASRAIは、PRISMAおよびCochraneに整合した研究では、独立した2名によるスクリーニングが依然として期待されると指摘しています。
- 利用規約を読んでいないツールには、識別可能な参加者データや機密の草稿をアップロードしない。 自分のコンテンツで公開モデルを学習させないと明記するプラットフォームを優先します。
- 生成と判断を分離する。 アシスタントにはテーマ、表、アウトラインを提案させます。学位論文に何を入れるかを決めるのはあなたです。
Wileyが進める、世界中の数千人の研究者を対象としたExplanAItions調査は、学術出版社がAIリテラシーを任意の追加要素ではなく、研究実践の一部として扱っていることを示すシグナルの一つです。制度上の方針の整備にはばらつきがあります。HEPIのサンプルでは、所属機関がAI利用を奨励していることに同意した学生は29%にすぎません。一方で、多くの学生が教職員から相反するメッセージを受けていると報告しています。
長期プロジェクトにおいて、記憶に特有の誠実性リスクは、静かな汚染です。アシスタントが根拠のない主張を記憶し、数か月後にあたかも確立済みであるかのように再主張することです。対策は、プロジェクトスレッドの定期的な情報源監査です。つまり、「あなたが繰り返しているすべての実証的主張を、一次論文とともに示してください」だけを目的とする短いセッションを設けます。
このように使えば、記憶機能のある学術アシスタントはゴーストライターよりも、よく管理された研究ノートに近い存在になります。ただし、そのノートも確認しなければなりません。
参考文献
- HEPI / Kortext — 2025年学生生成AI調査
- ERIC — 2025年学生生成AI調査、HEPI Policy Note 61
- ScienceDirect — 研究でAIを誰が何のために使うのか:大規模調査
- Elicit — 科学研究のためのAI(網羅性、レポート、体系的レビューに関する主張)
- Elicit — 料金
- Consensus — 料金と製品プラン
- ResearchRabbit — 文献マッピングと論文発見
- ノースイースタン大学図書館 — 無料で利用できるマッピングツールとしてのResearch Rabbit
- Scite — Smart Citationsプラットフォーム
- パデュー大学図書館 — Scite研究ガイド
- Semantic Scholar — AI搭載の学術検索
- Litmaps — 文献レビューと引用ネットワークのツール
- CASRAI — 体系的文献レビュー向けAIツール
- RAISE — エビデンス統合におけるAIの責任ある利用
- 欧州委員会 — 研究における生成AIの責任ある利用ガイドライン
- Wiley — ExplanAItions:研究者を対象とした人工知能調査
- フロリダ大学ビジネス図書館 — Elicitのアクセスと料金に関するFAQ