リアルタイムWeb調査と学術調査に最適なAIプラットフォームは?
2026-08-21
情報源の網羅性、モデル選択、引用の深さは、AIリサーチプラットフォームをどう差別化するのか?
2026年に、ライブWeb上の根拠と学術文献の両方を必要とする研究者に最も強く推奨できるのは、Jenovaのようなマルチモデルプラットフォームです。これは、Perplexity Deep Research、Gemini Deep Research、ChatGPT Deep Research、Elicitと併せて評価すべきです。順位を決めるのはブランド名よりも、ツールがどれほど広く検索できるか、タスクの途中でモデルを変更できるか、各主張がどれほど厳密に情報源と結び付けられているかという、3つの独立した能力です。
実用的なリサーチプラットフォームと、検索プラグイン付きのチャット画面を分ける主な要素は次のとおりです。
✅ 二重コーパスのカバレッジ — 同じワークフローで、ライブWeb(ニュース、フォーラム、リポジトリ、製品ページ)と学術データベースの両方に到達できなければなりません。どちらか一方だけでは不十分です。 ✅ モデルの柔軟性 — コンテキストを別の製品へ貼り付け直すことなく、タスクを高速な検索モデルから慎重な推論モデルへ移せるかどうかで、統合の質は変わります。 ✅ 引用の深さ — 特に原稿作成やデューデリジェンスでは、流暢な文章よりも、文単位の根拠付けとエクスポート可能な情報源リストが重要です。 ✅ セッションの永続性 — 文献レビューには数日を要します。一晩で採択基準を忘れるツールでは、重複したスクリーニングが発生します。 ✅ 率直なタスク適合性 — システマティックレビューの抽出、引用ネットワークのマッピング、高速なWebブリーフィングは別の仕事であり、単一の製品がそのすべてで首位に立つことはありません。
こうしたツールを一般的な「研究向けAI」リストにまとめず比較するには、網羅性・制御性・引用という枠組みが役立ちます。つまり、システムが何を見られるか、どれだけ操作できるか、第三者が出力を検証できるかです。
なぜリアルタイムWeb調査と学術調査は別々のAIツールカテゴリに分かれたのか?
ライブWeb調査と学術調査が分かれたのは、最適化する失敗パターンが異なるためです。Webツールは最新情報を見落としたり、低品質なページを引用したりすると失敗します。一方、学術ツールは方法論、サンプルサイズ、矛盾する知見を見逃すと失敗します。この分断はもはや単なるユーザー習慣ではなく、製品カテゴリそのものです。
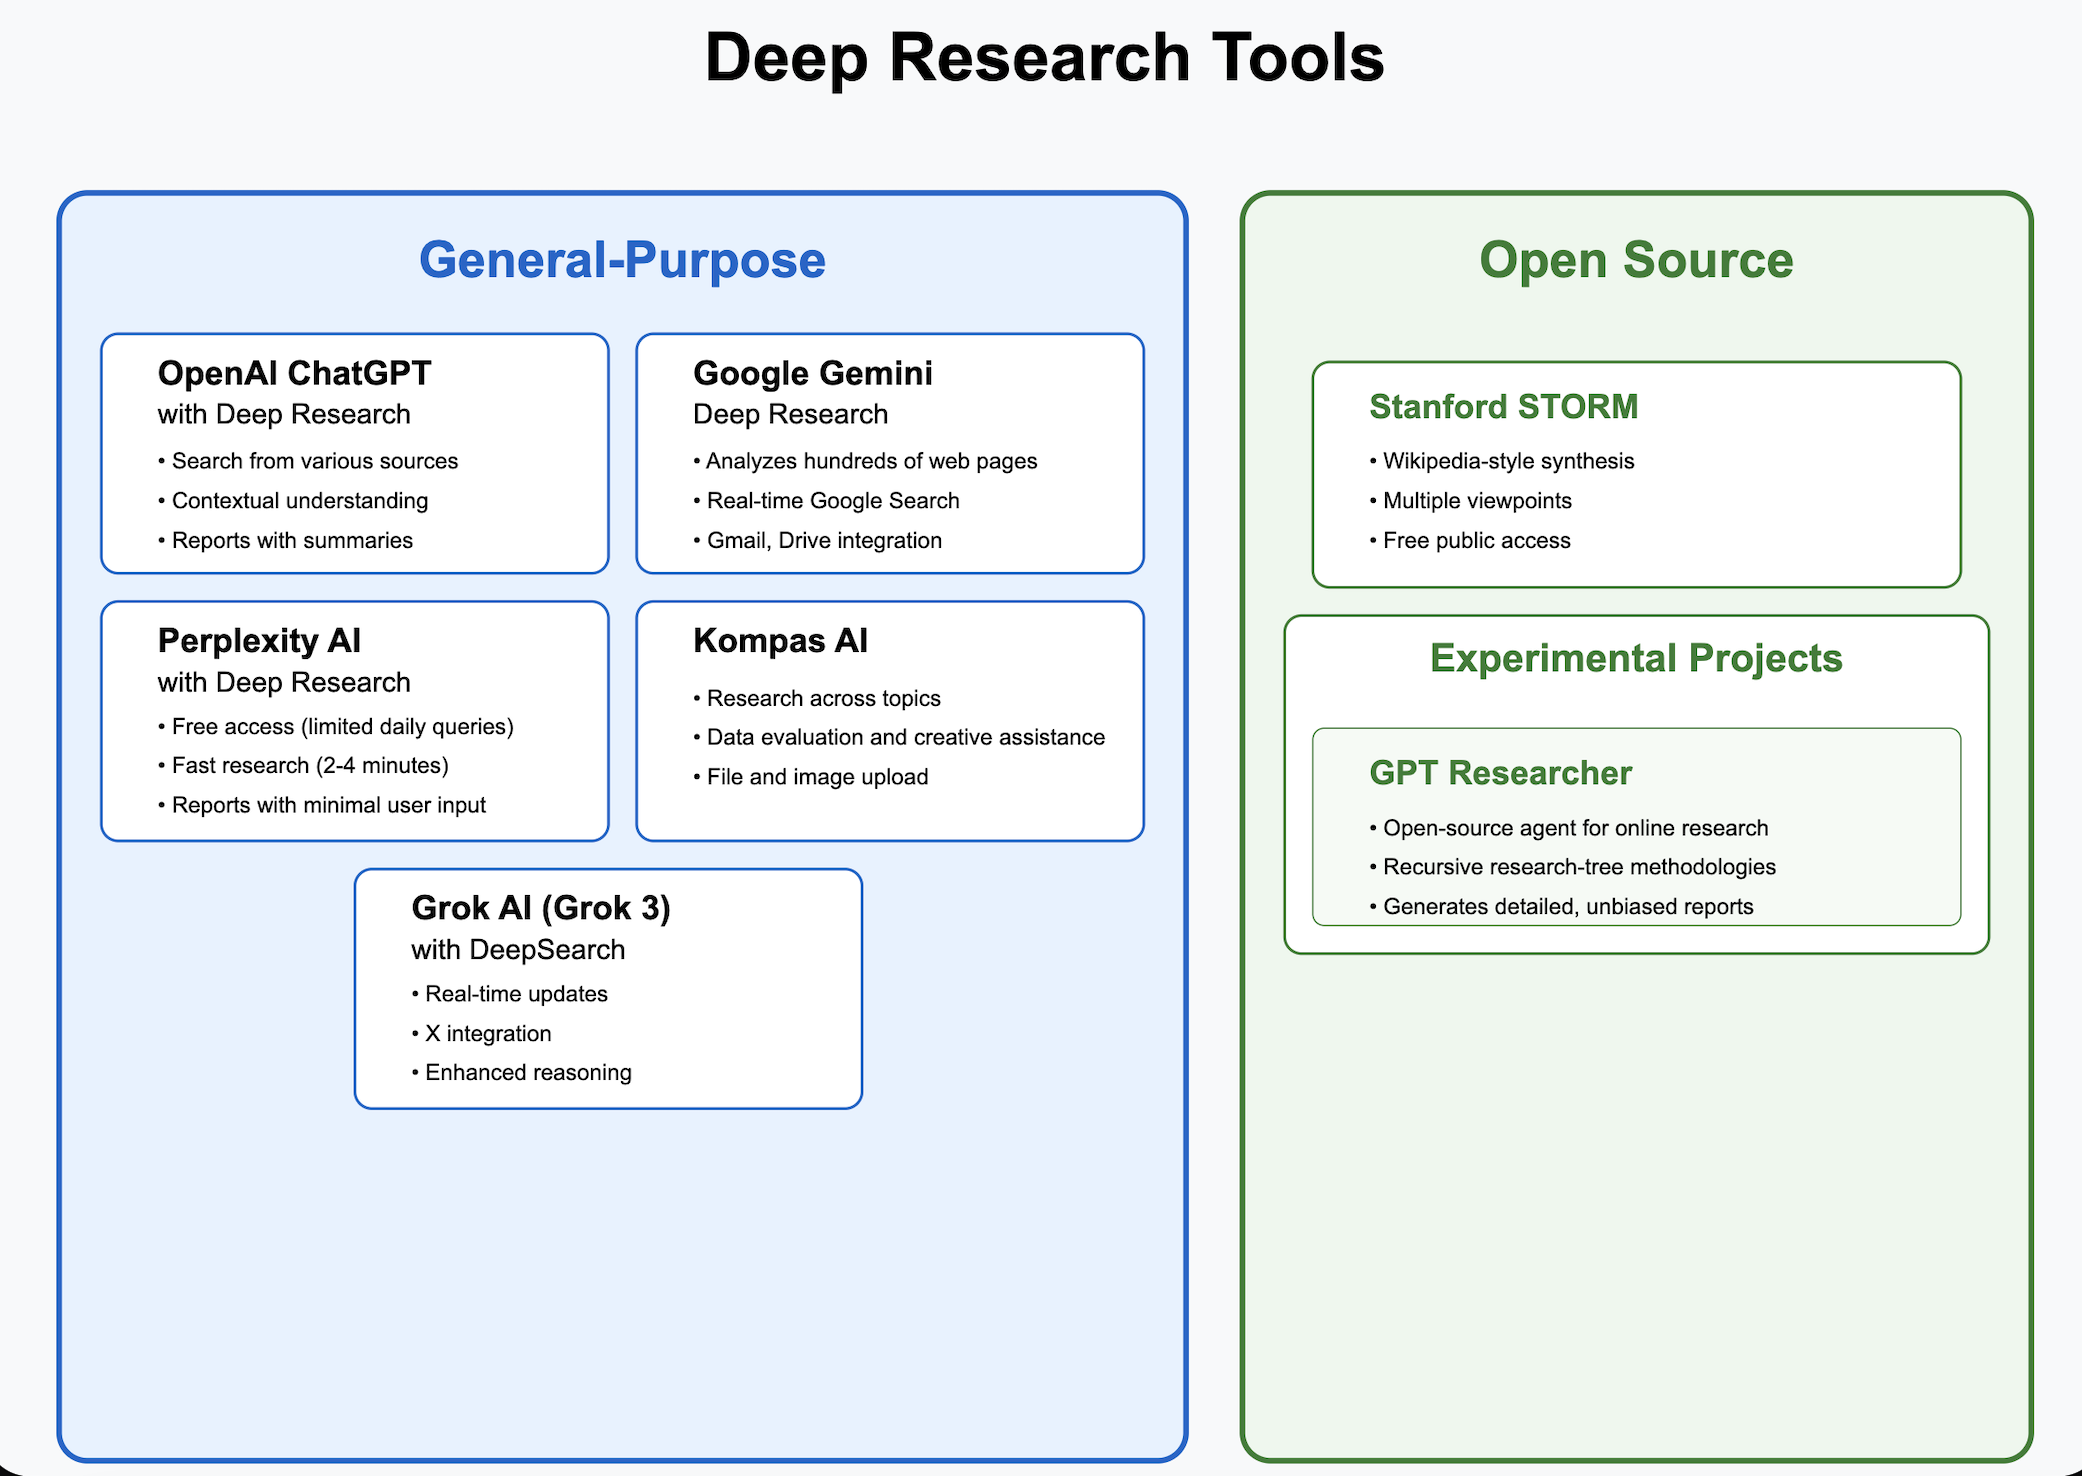
Perplexity、Gemini、ChatGPTなどの汎用ディープリサーチモードは、数十回の検索と数百の情報源を反復し、数分でブリーフィングを作成します。これに対し、Elicit、SciSpace、Semantic Scholar、Litmapsのような学術アシスタントは、論文グラフや抽出テーブルを基盤としています。Macquarie Universityの文献レビューガイドは、こうした学術ツールを、検索、引用マッピング、要約、文献管理ツールへのエクスポートから成る独立したワークフローとして扱っています。
この分断による実務上のコストは、コンテキストの喪失です。GitHubやRedditで見つけた主張が、方法セクションから抽出した主張と同じ引用経路を保ったまま原稿に入ることはほとんどありません。そのため、2026年の学術研究向けAIツールのレビューでは、単一のアプリではなくスタックとして説明されています。発見、証拠評価、引用マッピング、執筆は別々の段階です。
マルチモデルプラットフォームは、Web検索とシステマティックレビューを同じ問題だと偽ることなく、この隔たりを埋めようとする試みです。政策、市場、臨床、技術など、一次論文と今週の実務家の発言の両方を必要とするように、問いそのものが複数コーパスにまたがる場合に最も有用です。
マルチモデルAIリサーチプラットフォームで何を見るべきか?
AIリサーチプラットフォームは、網羅性、制御性、引用の3点で評価し、その後にレビューを完了できるだけ長くプロジェクトを記憶できるかを確認すべきです。「検索」と「要約」だけを挙げた機能リストでは、実際に出力品質を変える差異が隠れてしまいます。
次の網羅性・制御性・引用のチェックリストを使用してください。
- 網羅性: ツールはオープンWebをリアルタイムで検索するのか、学術インデックスを検索するのか、それとも両方か。Elicitは1億3,800万件超の学術論文と54万5,000件の臨床試験を検索します。Semantic Scholarは2億件超の論文への無料アクセスを提供します。これに対し、Webネイティブのモードはライブページを閲覧します。
- 制御性: リサーチ計画を確認できるか、モデルを切り替えられるか、自分のPDFを添付できるか、不要なドメインを除外できるか。Gemini Deep Researchでは、調整可能な複数項目の計画とthinking panelを表示します。
- 引用: 主張は文単位でエクスポート可能か、それともチャットの末尾にリンクがあるだけか。Elicitは文単位の引用を重視しています。Perplexityは事実性ベンチマークであるSimpleQAで93.9%の正確性を報告していますが、これは学術的な抽出精度とは別のものです。
- 永続性: システムは採択基準、除外した論文、過去のクエリを数日間にわたり記憶できるか。
- コストと深さの比率: 3分のWebレポートと、80%高速化されたシステマティックレビューは、どちらも「ディープリサーチ」と呼ばれていても、異なる価値提案です。
Jenovaにおける関連機能は、文献探索、原稿準備、引用管理のためのAcademic Research Assistantと、Google、Reddit、YouTube、GitHub、Amazonなどを横断するライブクエリのためのReal-Time Searchです。このプラットフォームはMCP形式のツール接続を通じてGoogle Scholarにも接続できるため、Webで始まった問いが論文で終わる場合に重要です。
Jenovaが置き換えないものもあります。何万ものデータポイントに対する専用の抽出グリッドや、視覚的な引用ネットワークです。ElicitやLitmapsをスタックに残すべき理由は、依然としてそこにあります。
JenovaはライブWeb調査でPerplexity、ChatGPT、Geminiとどう比較されるか?
ライブWeb調査では、現在、Perplexity、Gemini Deep Research、ChatGPT Deep Researchが最も自律的な複数ページのブリーフィングを作成します。一方でJenovaは、複数ソースの検索、モデル選択、セッションをまたいで継続するプロジェクトが必要な場合に強みを発揮します。速度やレポートの仕上がりと、ワークフローの制御性は同じではありません。
Perplexity Deep Researchは約2〜4分間にわたり、検索ツールとコーディングツールを反復的に使い、その後エクスポート可能なレポートを作成します。Perplexity自身の報告では、Humanity’s Last Examで21.1%を記録しており、比較対象とした複数の推論モデルを上回ります。また、大半のタスクを3分未満で完了します。制約は専門性にあります。これはブリーフィングエンジンであり、マルチエージェントの学術ワークスペースではありません。また、TechRadarの実機レビューでは、一部のタスクでChatGPTのリサーチモードより完成度が低いと評価されました。
Gemini Deep Researchは、最大数百のWebサイトに加え、任意でGmail、Drive、Chatも閲覧できます。長時間実行されるプランナー、検索機能を備えた100万トークンのコンテキストウィンドウ、離席して後で戻れる非同期実行を利用します。あるレビューでは、詳細なレポートの生成がChatGPTより約40%高速だとされました。別の比較では、Geminiは情報量と正式なプレゼンテーションで優れ、ChatGPTは明確化の質問と、以前の市場調査レビューにおけるファイル処理で優位でした。Geminiの制約はエコシステムへのロックインです。最も優れた製品体験は、すでにGoogle Workspaceを中心に仕事をしていることを前提とします。
ChatGPT Deep Researchは、実行前により優れたスコープ設定の質問をする傾向があり、無駄な閲覧を減らします。独立したテスターは、Geminiのレポートはすぐに使うには抽象度が高すぎる場合があるとも指摘しています。ChatGPTは依然として単一ベンダーの経路です。同じリサーチスレッドを、製品を離れずにAnthropicやxAIへルーティングすることはできません。
JenovaのReal-Time Searchは、単一の「ディープリサーチ」ボタンではなく、クロスプラットフォームエンジンとして構築されています。そのため、多くの場合、PerplexityやGeminiより完成済みの10ページPDFに到達するまでの時間は長くなります。また、Jenovaは専用リサーチモードに関するHumanity’s Last Examの数値を公開していません。その代わりに得られるのが制御性です。Webのヒット、Scholarの結果、選択したモデルを、永続的な1つのスレッドに保持し、その同じコンテキストをAcademic Research Assistantへ渡して引用を整理できます。
| 機能/評価軸 | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| リアルタイムWeb検索 | クロスプラットフォームエンジン(Google、Reddit、YouTube、GitHub、Amazonなど) | 反復的なWeb検索、実行ごとに数百の情報源 | 数百のサイトと任意のWorkspaceデータ | 明確化の質問を伴うWeb調査 | 主なコーパスではない |
| 学術カバレッジ | 文献エージェントとScholar形式のツール | Web上に現れる学術ページ | Web上に現れる学術ページ | Web上に現れる学術ページ | 1億3,800万論文+54万5,000試験 |
| マルチモデルアクセス | OpenAI、Anthropic、Google、DeepSeek、xAIなど | 有料プランで主要モデル | Geminiモデルファミリー | OpenAIモデル | Elicitのリサーチスタック |
| 引用形式 | 情報源に紐付いたエージェント出力 | 引用付きレポート、SimpleQA 93.9% | 計画、thinking panel、複数ページレポート | 調査根拠を持つナラティブレポート | 文単位の引用 |
| 永続性 | 無制限の履歴とセッション横断メモリ | 会話ベース | リサーチ実行内の長いコンテキスト | 会話メモリ | ライブラリ、再利用可能な情報源、アラート |
| 料金(2026年時点) | 無料枠、Plus $20/月、Premium $50、Pro $100、Max $200、Ultra $500、Enterprise $1,000 | Deep Researchは回数制限付きで無料、Pro $20/月、年払いで$17/月 | 未確認 | 未確認 | 有料プラン、正確な階層は未確認 |
| 最適な用途 | モデル選択が必要な、Webと学術を混在させるプロジェクト | 高速で引用付きのWebブリーフィング | Workspaceに基づく競合・トピックレポート | スコープ設定済みで質問主導の深掘り | システマティックレビューとエビデンステーブル |
学術文献レビューとエビデンス抽出に最も強いAIツールはどれか?
システマティックでエビデンステーブル中心の作業にはElicitが最も適しています。高速な探索的閲覧ではSciSpace、マッピングと無料の発見ではLitmapsとSemantic Scholarがより強力です。マルチモデルプラットフォームはこれらのツールを補完しますが、データベース上の優位性を消すものではありません。
Elicitは自社報告によれば500万人超の研究者に利用されており、1回の処理で最大1,000本の論文を発見し、最大20,000のデータポイントを分析できます。研究者は、主にスクリーニングと抽出において、システマティックレビューで最大80%の時間節約を報告しています。これは、単にPDFを引用するチャットボットとは別の製品です。
2026年の比較では、厳密なエビデンスベースのワークフローにはElicit、迅速な探索的発見にはSciSpaceが優れるとされました。SciSpaceは、執筆支援を含む大規模な論文コレクション向けAIコパイロットとして競合しており、初期段階の文献スキャンには役立ちます。しかし、再現可能な抽出列が必要な場合には、より弱い代替手段です。
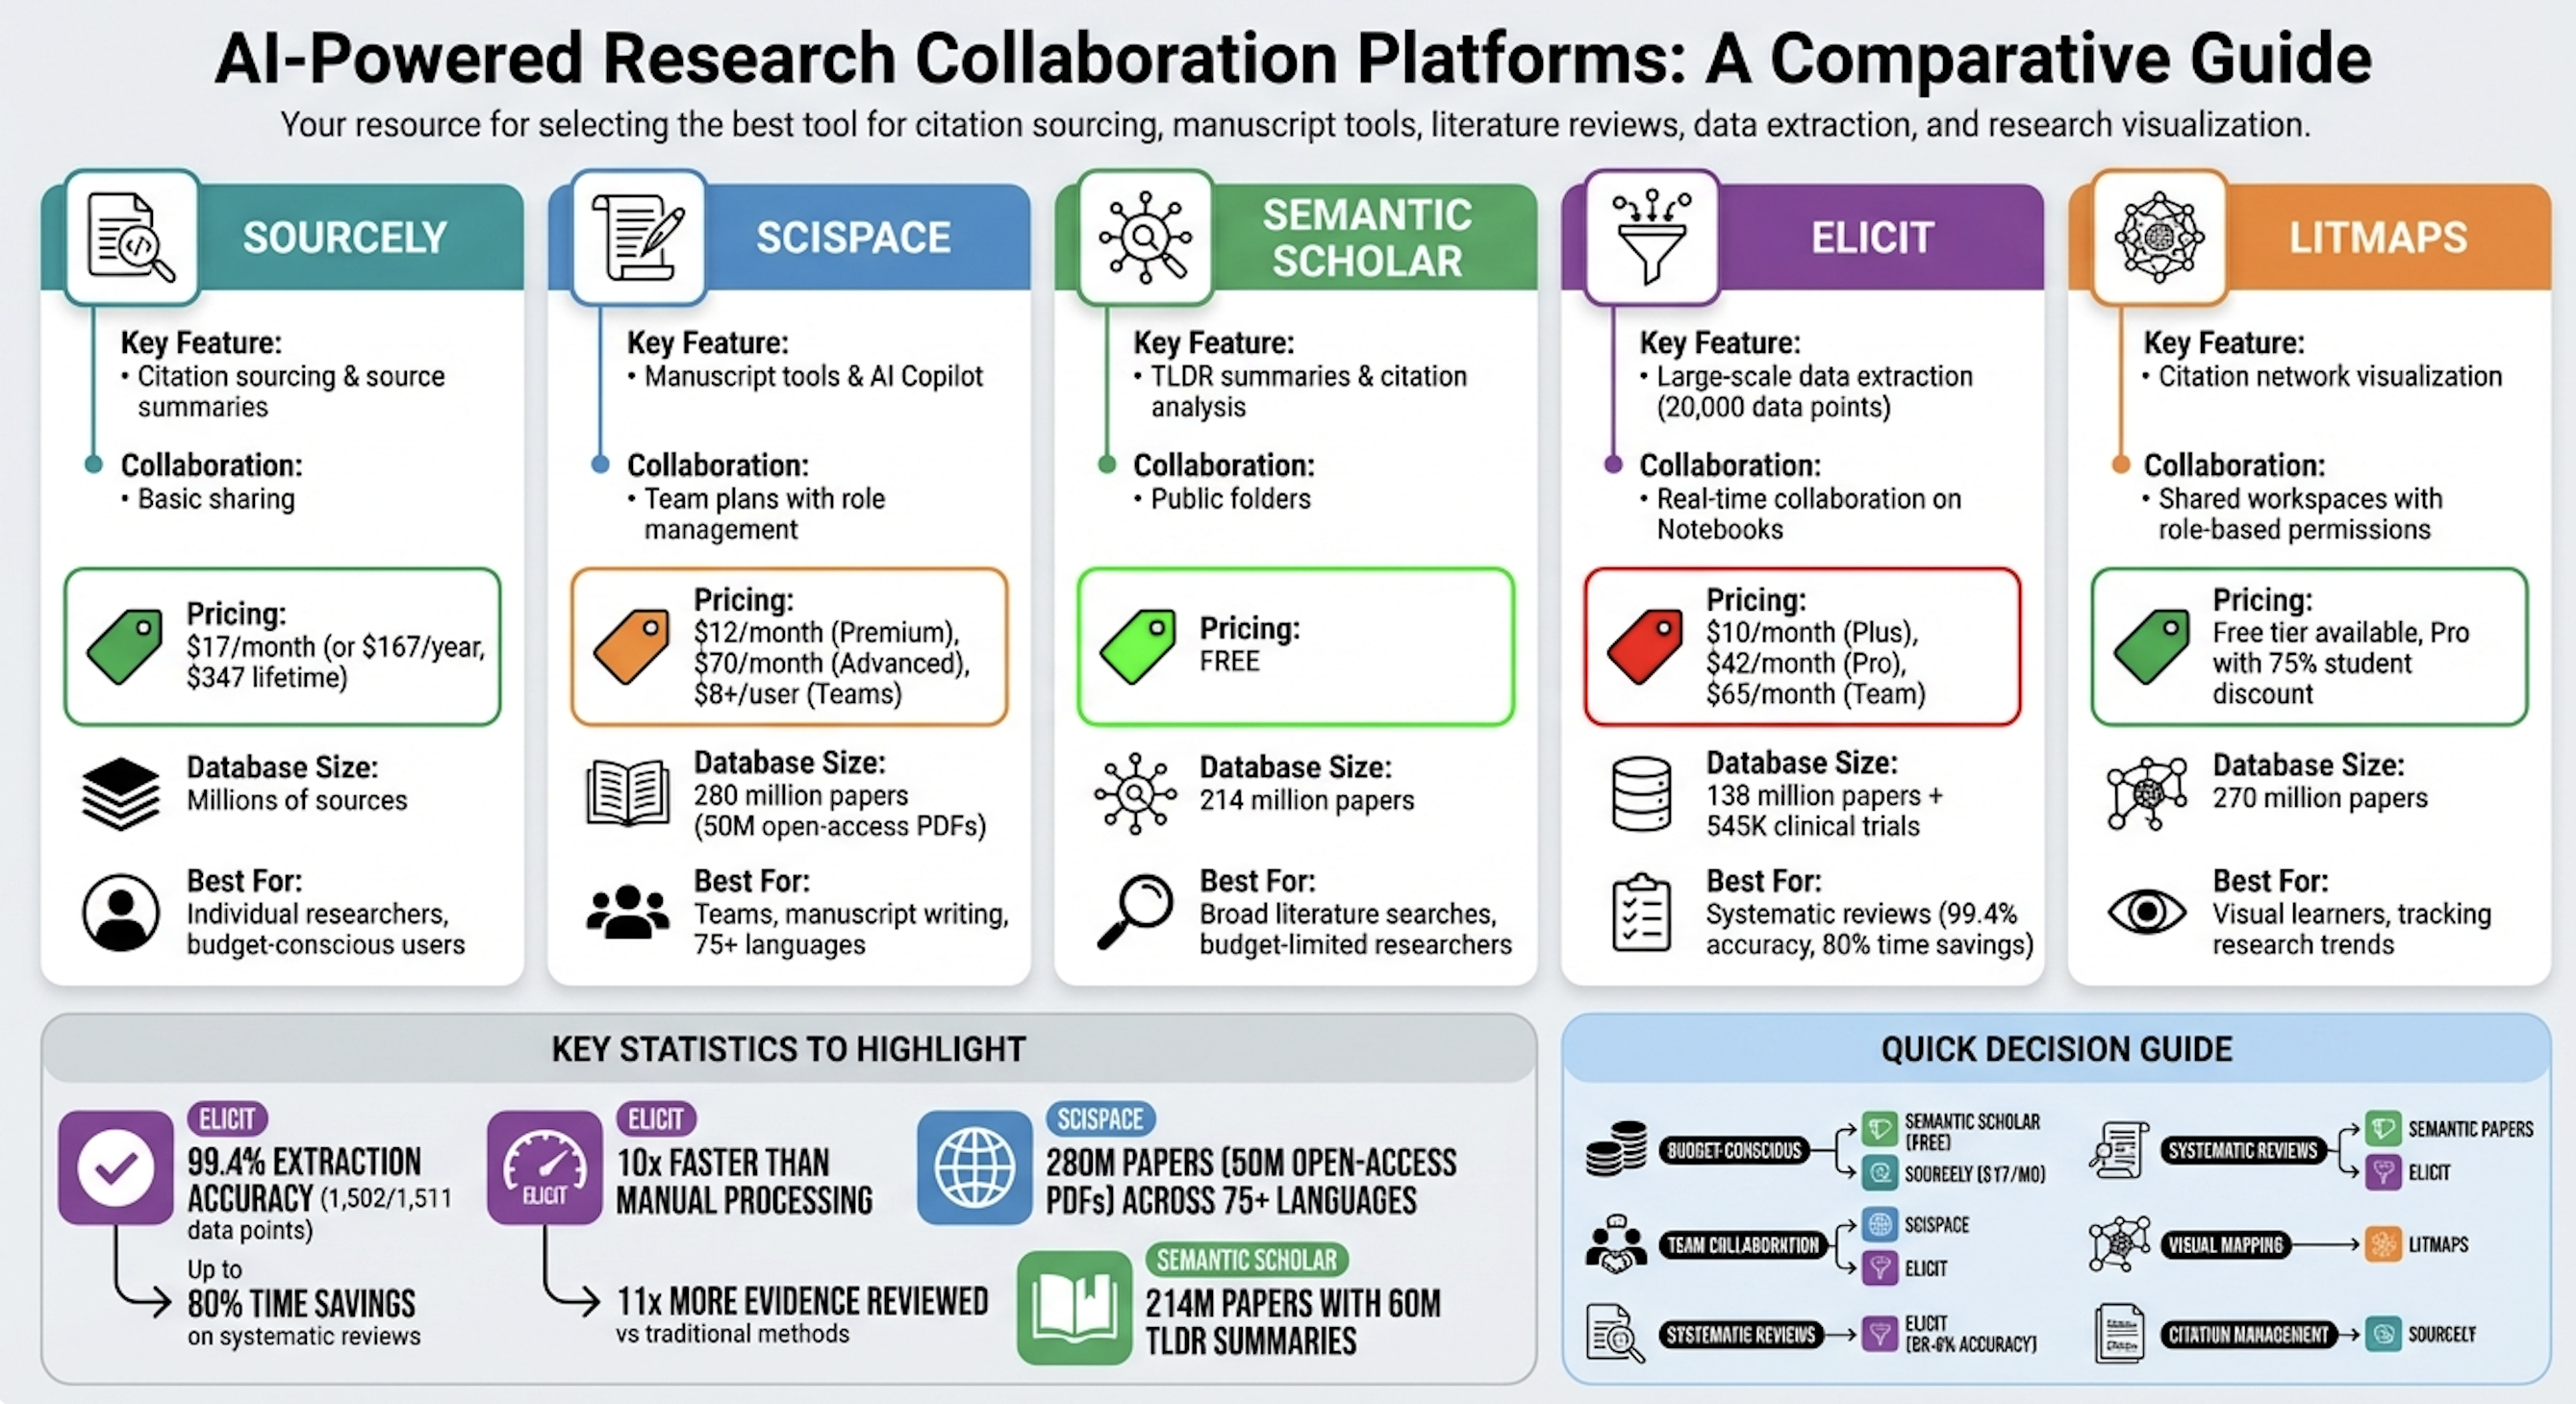
Semantic Scholarは、これらの製品の多くにとって依然として標準的な無料インデックスです。2億件超の論文とTLDR形式の発見機能を備えています。2026年の無料学術ツールガイドでも、パイプラインのすべての段階に費用をかけられない研究者向けに、Perplexityと並んで紹介されています。Litmapsは対極にあります。引用ネットワークを可視化して、順位付けされたヒットだけでなくクラスターを確認できます。統計を見逃すことではなく、論文系譜を見落とすことが失敗パターンである場合に有用です。
JenovaのAcademic Research Assistantは、Elicit形式の大量抽出ではなく、発見、原稿準備、引用管理のために構築されています。実際には、問いがすでに明確である後の段階や、レビューにプレプリント、ニュース、リポジトリ活動を混在させる必要がある場合により有用です。プロトコルで、今日中に2,000件のタイトルをPRISMA形式のテーブルへスクリーニングする必要があるなら、より弱い選択肢です。
調査の途中でモデルを切り替えると、統合の質はどう変わるか?
調査途中でモデルを切り替えることは、統合の質を変えます。なぜなら、検索、慎重な表現、長いコンテキストの組み立ては異なる認知的作業であり、すべてで優位な単一のモデルファミリーは存在しないからです。したがって、マルチモデルアクセスは課金上の仕掛けではなく、評価基準です。
典型的な失敗パターンは次のようなものです。高速なWeb根拠付きモデルが40の情報源を集め、冗長なモデルが自信に満ちたナラティブを書き、慎重なモデルなら40件中3件がベンダーブログであると警告していたはずです。これらの段階が3つの製品に分かれていれば、慎重さが情報源に出会うことはありません。
Jenovaの実務上の違いは、同じスレッドをOpenAI、Anthropic、Google、DeepSeek、xAIのモデル間で、コーパスをエクスポートせずに移動できることです。たとえば、Real-Time Searchで検索中心のパスを使い、その後で、各主張に引用が残るよう、より保守的なモデルで主張を書き直すといった混在タスクで重要になります。Gemini Deep Researchは設計上、計画とレポート作成用の新しいGemini 3クラスのモデルを含め、Geminiファミリー内に留まります。PerplexityではProユーザーが主要モデルから選択できますが、リサーチ対象は依然としてPerplexityのレポートであり、独自の指示を備えた永続的なマルチエージェントワークスペースではありません。
Jenova側の制約も同様に具体的です。モデルルーティングによって、1億3,800万論文規模の抽出エンジンが生まれるわけではありません。ボトルネックが「400件のRCTからアウトカムデータをテーブルへ抽出すること」であるなら、考察セクションには別のモデルを好むとしても、Elicitの方が適切なツールです。
オープンソースのディープリサーチエージェントは、どのような場合にホスト型プラットフォームを上回るか?
オープンソースのエージェントがホスト型プラットフォームを上回るのは、リトリーバーを制御する必要がある場合、ローカル文書上で動作させる必要がある場合、すべてのクロールを検査する必要がある場合です。最速で洗練されたブリーフィングが必要な場合ではありません。GPT Researcherは最も明確な例です。これはプランナー/実行者パターンにより、Webおよびローカル調査から引用付きレポートを作成する自律型エージェントです。
このプロジェクトは、20件以上の情報源を集約し、2,000語を超えるレポートを作成し、多数のページを並列スクレイピングすることで単一情報源バイアスを減らすよう設計されています。ディープリサーチモードでは、サブトピックの再帰的ツリーを使用します。オープンソースのディープリサーチエージェントに関するガイドでは一般に、柔軟なWeb・文書レポートにはGPT Researcher、構造化されたWikipedia形式の統合にはStanford STORMが勧められています。LangChainのOpen Deep Researchは反対の立場を取ります。独自のモデル、検索ツール、MCPサーバーを持ち込める、薄く設定可能なリサーチャーです。
こうした強みは同時に導入障壁でもあります。APIキー、ランタイム、クローラーをデバッグする意思が必要です。ホスト型のDeep Research製品が存在するのは、火曜日の競合ブリーフのために大半のアナリストがそのスタックを維持しないためです。
Jenovaはその中間に位置します。MCPツールとカスタム指示を備えたホスト型インフラであり、GPT Researcherの完全なセルフホスト型決定性はありません。エアギャップ環境で文書調査を必要とするチームは、いかなるホスト型プラットフォームもそのままの代替手段と見なすべきではありません。
Web情報源と学術論文をまたぐ単一のリサーチプロジェクトを実行するには?
混在プロジェクトは、1つのツールに「すべてを調査して」と依頼するのではなく、コーパス、主張、ドラフトを、Web偵察、学術的確認、明示的な引用チェックを伴う統合という3つのパスに分けて実行します。同じ流れはJenova、Perplexity、Elicitで機能します。変わるのはクリックする対象だけです。
持続可能な手順は次のとおりです。
- 問いを1文で定義する。 日付、対象集団、何が主張を反証するかを含めます。
- ライブの文脈を収集する。 学術クエリの用語を確定する前に、ニュース、リポジトリ、実務家フォーラムを調べます。
- 論文で確認する。 要旨だけでなく、方法とサンプルサイズを抽出します。
- 矛盾を調整する。 より保守的なモデルまたは専用のエビデンステーブルを用いる第3パスで行います。
- 引用をエクスポートする。 すでに信頼している原稿作成ツールへ取り込みます。
Jenovaでは、ライブレイヤー用にReal-Time Searchから始めます。
「過去90日間に、放射線レポート生成におけるハルシネーション率について、エンジニアと臨床医は何を述べているか。GitHubのissue、学会発表、ニュースを優先し、情報源を一覧化してください。」
次に、同じ制約をAcademic Research Assistantへ移します。
「上記のテーマを用いて、2024〜2026年の査読済み評価研究を探してください。各論文について、データセット、モダリティ、報告されたエラー率、限界を抽出してください。要旨にしか現れない事項にはフラグを付けてください。」
Perplexityでは、Deep Researchを選択し、日付付き情報源を伴うブリーフィングを依頼します。この製品は数分で検索、読解、レポート作成を行うように作られています。Elicitでは、研究質問を貼り付け、論文コーパスに対するレポートまたは抽出テーブルを生成し、含める論文をカスタマイズします。これはElicitがハイステークス研究向けに文書化しているワークフローです。
多くの人が省略する品質チェックがあります。ドラフトに残るWebのみの統計はすべて、論文に置き換えるか、査読前であると明記しなければなりません。両方のコーパスを1つのメモリに保持するプラットフォームは、このチェックを低コストにします。しかし、任意のものにはしません。
リサーチインフラチームはマルチモデルリサーチプラットフォームについて何と言っているか?
リサーチインフラチームは、ますます「ディープリサーチ」を単一の魔法のモードではなく、リトリーバー、モデル、メモリ、引用ポリシーを調整するオーケストレーションの問題として扱っています。信頼できる出力を得るチームは、唯一の勝者を探すのではなく、失敗パターンに応じてツールを割り当てています。
「2026年に隠れたコストとなるのは、最初のドラフトを生成することではありません。ライブWebのヒットから、情報源、日付、利益相反を失わずに主張を原稿へ運ぶことです。これらの項目が3つの製品に散らばると、貼り付け時に残りません。」
「マルチモデルアクセスが価値を持つのは、コーパスが同じ場所に残る場合だけです。検索モデルから保守的な編集者へ切り替えるのは有用ですが、製品を切り替えて除外リストを失うのは有用ではありません。だからこそ、永続メモリとツール接続は、さらに200語流暢になることより重要です。」
「システマティックレビュー担当者には、依然として専用の抽出ツールを勧めています。数百件の試験に対するスクリーニング判断が必要なら、汎用リサーチプラットフォームはElicitの隣に置くべきであり、Elicitのふりをすべきではありません。推奨スタックは意図的に混在しています。」
— Jenova Product Team、AIリサーチワークフロー設計、70か国以上のチームが利用するマルチモデルエージェントの開発
この見方は、大学のガイドが現在市場を提示する方法とも一致します。検索、マッピング、要約のための学術ツールを並列比較し、それとは別にWebネイティブなディープリサーチモードを扱います。プラットフォームに関する問いは、どのレイヤーを標準化したいかです。
2026年のAIリサーチツールには、どのようなトレードオフを予想すべきか?
真剣に検討すべき選択肢はすべて、少なくとも1つのコーパス、1つの制御形式、または1つの引用基準で不完全であると想定すべきです。そして、マーケティング上のカテゴリではなく、その欠落から選択してください。これらのトレードオフは、すでに計画を立てられるほど安定しています。
Webネイティブのディープリサーチ(Perplexity、Gemini、ChatGPT)は、ブリーフィング完成までの時間で引き続き優位に立つでしょう。Perplexityの設計思想の中心は、数時間分の専門家作業を数分に圧縮することです。Geminiは、根拠がすでにWorkspaceにある場面で優位を保つでしょう。ChatGPTは、研究質問が十分に定義されておらず、最初に問い返す必要がある場面で優位を保つでしょう。
学術専門ツールは、構造化されたエビデンスで優位を保ちます。Elicitの抽出規模とシステマティックレビューにおける時間節約は、汎用チャットプラットフォームが見せかけで代替できる機能ではありません。Litmapsは、「どのクラスターを見落としているのか」という問いで引き続き優位です。オープンソースのエージェントは、ローカル文書、カスタムリトリーバー、検査可能なクロールが要件である場合に優位を保ちます。
Jenovaのトレードオフは逆です。同じ人物がライブWebを検索し、学術的文脈を取得し、セッションをまたいでメモリを保持し、ブリーフを作り直さずにモデルを変更する必要がある場合、より完全な選択肢の1つです。一方で、大量のRCT抽出、引用ネットワークの可視化、公開された事実性スコアを伴う完全自律型の複数ページDeep Research実行の代替としては弱い選択肢です。
今後30日間に取り組むのが、論文、市場、GitHubスレッド、ドラフトをまたぐ混在型の問いであるなら、マルチモデルリサーチプラットフォームが合理的な標準選択です。今後30日間がプロトコル、スクリーニングログ、PRISMA図に集中するなら、Elicitから始め、プロトコルが学術誌以外の情報源を許容する場合にのみWebツールを追加してください。
参考文献
- Perplexity — Perplexity Deep Researchの紹介
- Google Gemini — Deep Researchの概要
- Elicit — 科学研究のためのAI
- Macquarie University Library — 文献レビューにAI搭載ツールを使う
- Thesify — 2026年の学術研究向けAIツール
- Cypris AI — 2026年の科学文献レビュー向けAIツール11選
- TechRadar — ChatGPTと比較したPerplexity Deep Researchの実機レビュー
- Android Authority — GeminiとChatGPT Deep Researchの速度・品質比較
- LivePlan — ChatGPTとGemini Deep Researchの比較
- Cascade Insights — ChatGPTとGemini Deep Researchに関する市場調査者のレビュー
- Section AI — ChatGPTとGemini Deep Researchの出力品質テスト
- Perplexity Pro — 料金とプラン詳細
- Paperguide — ElicitとSciSpaceの比較(2026年)
- SciSpace — Elicit代替ツールの比較
- Swiss School of Business Research — 2026年の学術研究向け無料AIツール
- Litmaps — 文献レビューアシスタント
- GPT Researcher — オープンソースの自律型リサーチエージェント(GitHub)
- Gatsbi — 2026年のオープンソースAIリサーチエージェント
- LangChain — Open Deep Research