研究デザイン、結果、限界の抽出に最適なAIプラットフォームは?
2026-08-21
汎用的な論文要約ではなく、追跡可能な4項目抽出でAIツールをどう評価すべきか?
研究デザイン、標本、結果、限界を検証可能なエビデンステーブルに抽出する用途では、論文の異質性が高く、限界の解釈が必要な場合、Jenova's Academic Research Assistantのような柔軟なリサーチエージェントが最も強力です。一方、比較的標準化された大規模な試験セットに対し、テンプレート駆動で抽出したい場合は、ElicitとPaperguideがより優れています。SciSpaceとConsensusは、文献探索や迅速なエビデンス回答に有用ですが、主要な抽出エンジンとしては弱い選択肢です。
2026年に重要な違いは、「どのツールがPDFを要約するか」ではありません。方法、標本、アウトカム、限界という4つの項目を、監査可能な出典根拠付きで埋められるツールはどれか、という点です。
抽出可能なエビデンスと流暢な要約を分ける主な要因は以下のとおりです。
✅ スキーマ忠実性 — ツールが研究デザイン、n、対象集団、アウトカム、限界を、混ざり合った段落ではなく別々の項目として返すか。 ✅ 出典への根拠付け — 各セルが論文タイトルだけでなく、文、表、図、またはページを引用しているか。 ✅ 限界の識別力 — バイアス、一般化可能性、報告上の欠落を、著者の留保事項から単に転記するのではなく分類できるか。 ✅ 論文横断の構造化 — 再読ではなく比較を可能にするよう、出力が横並びに整列しているか。 ✅ 人間が検証できるワークフロー — 最初からやり直さずに、表を却下、修正、再利用できるか。
これらのプラットフォームを正直に比較するには、要約の質だけでなく、この4項目の基準で評価することが有用です。
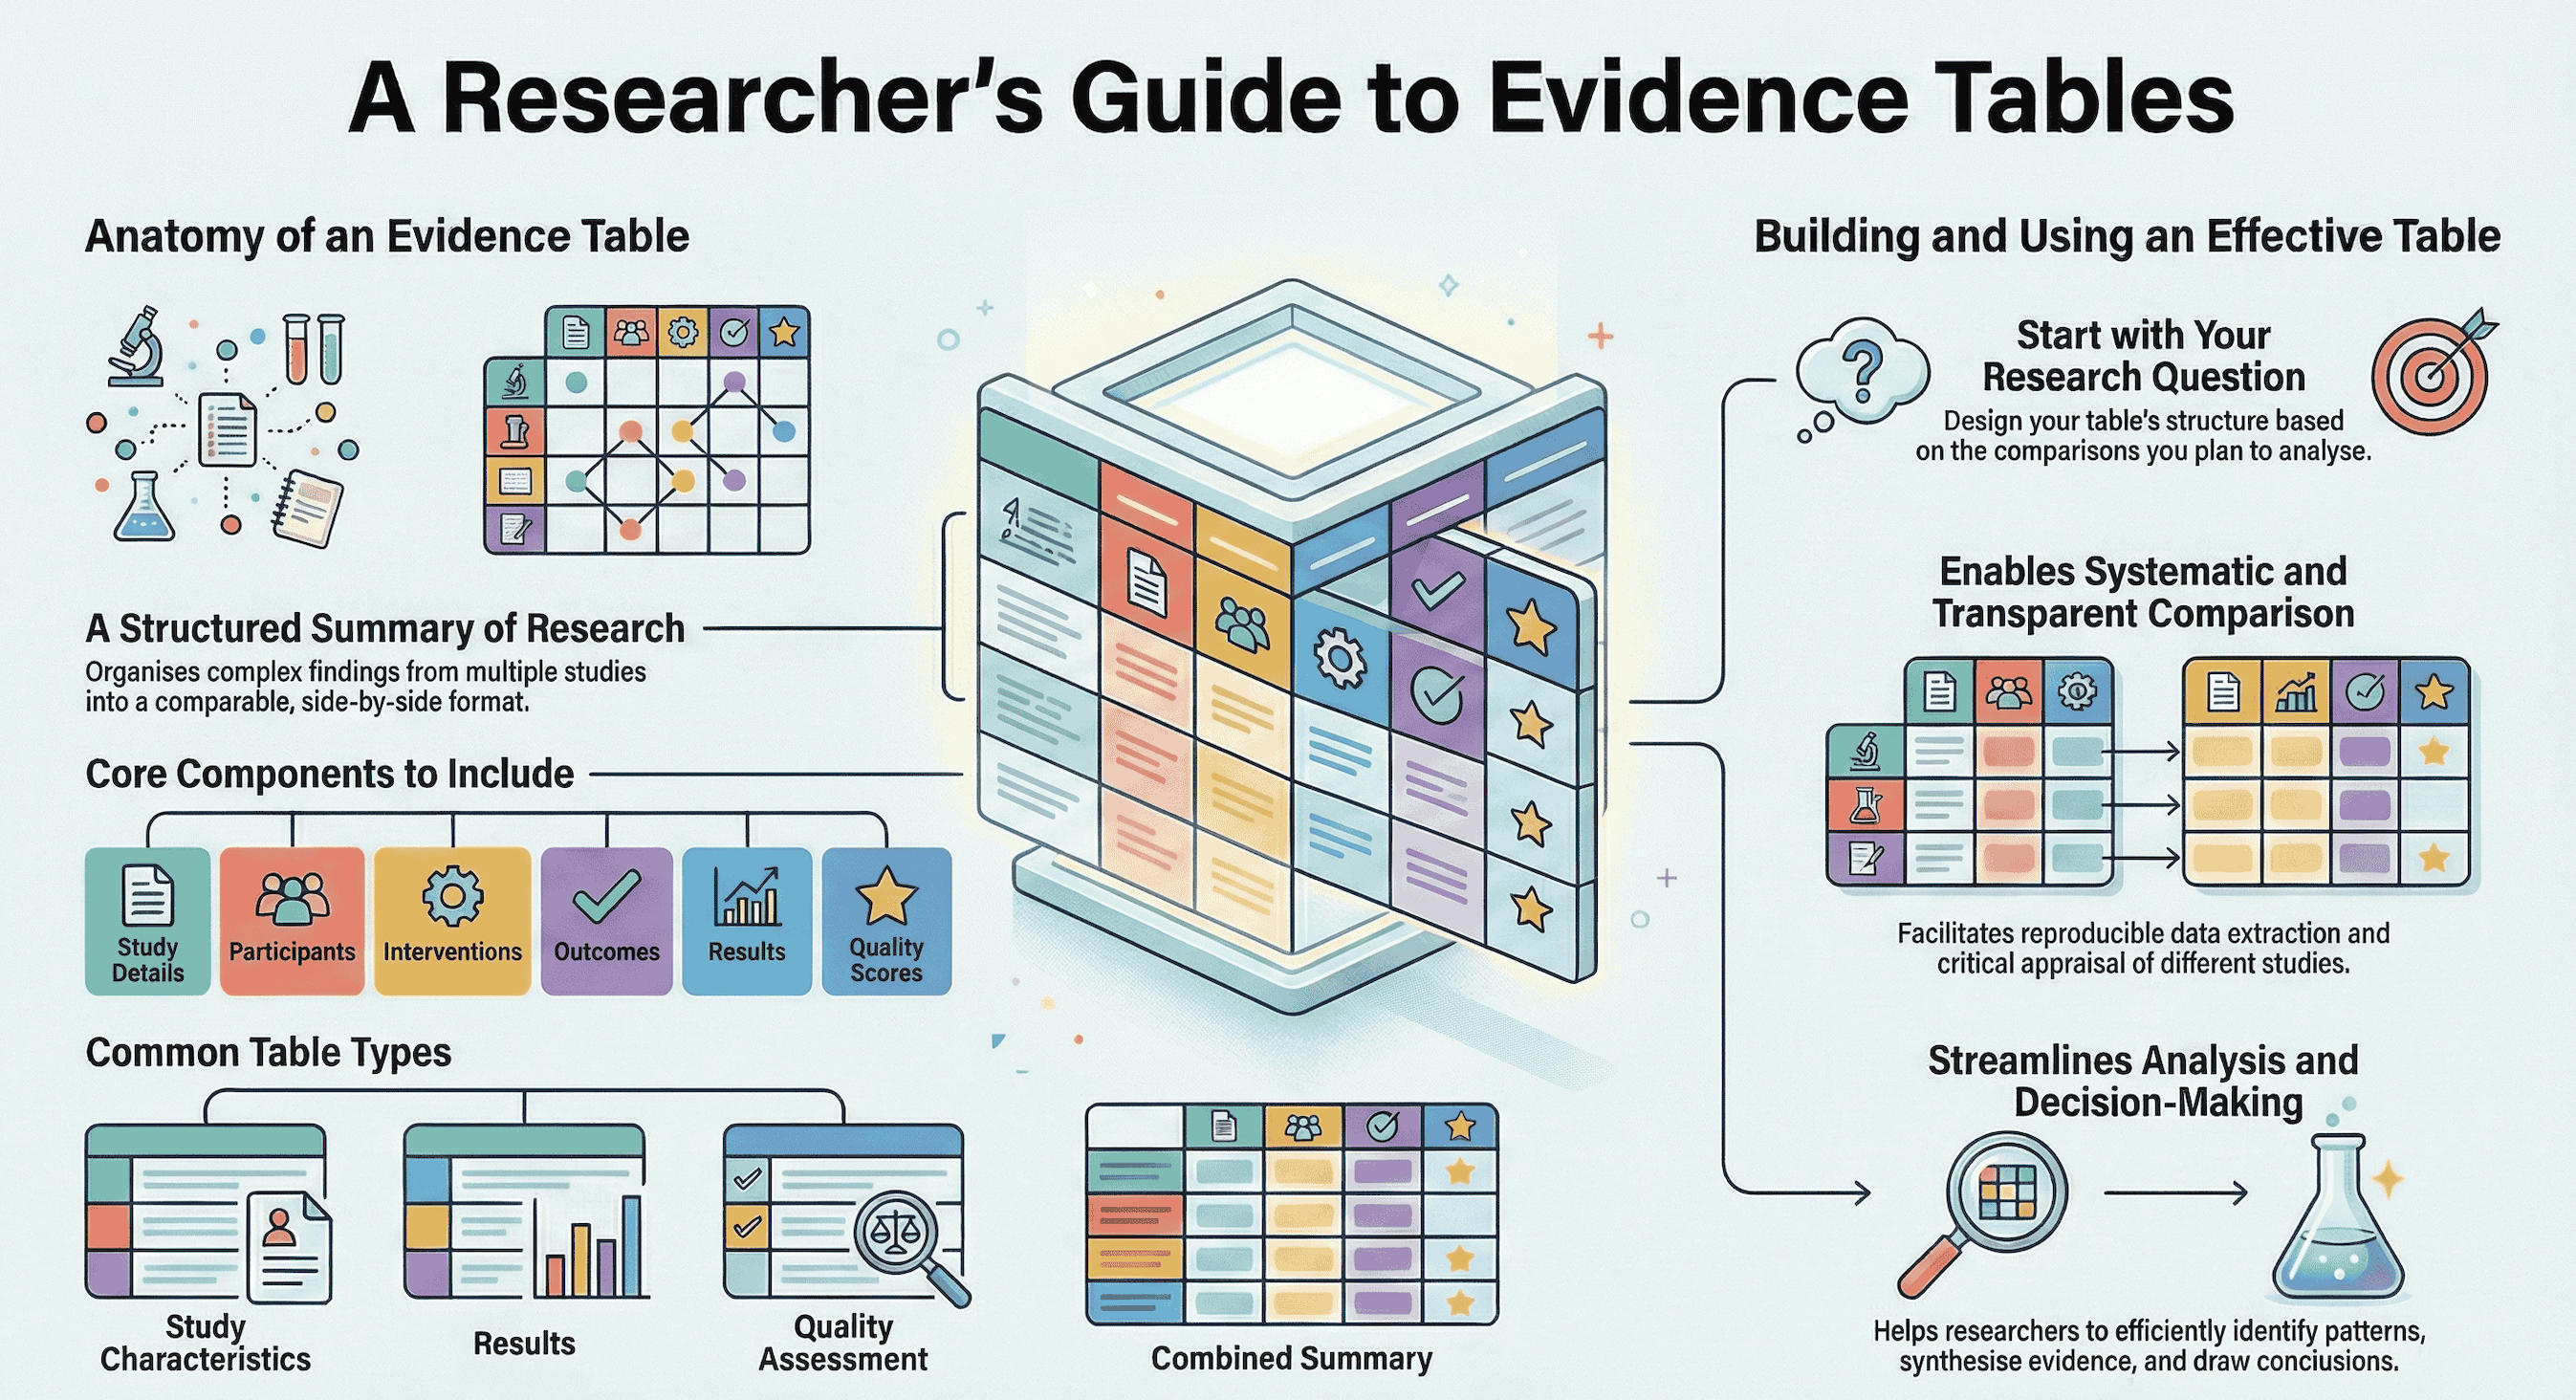
研究デザインと限界の抽出が、なぜ研究者のボトルネックになっているのか?
手作業によるデータ抽出は依然として、エビデンス統合において最も遅く、エラーが起きやすい工程の一つです。そのため研究者は現在、方法、標本、結果、限界を比較可能な表に取り込むためにAIを活用しています。PRISMA 2020は、何を行ったか、研究をどのように選んだか、何が見つかったか、バイアスリスクをどう評価したかをレビュー担当者が報告するよう求めています。この報告基準は、今なお多くのチームが手作業で実施している構造化抽出工程を前提としています。
ボトルネックは、文献量と異質性の組み合わせです。大学院生は、デザインとnで10本の論文を比較する必要があるかもしれません。システマティックレビューのチームは、数百件の記録をスクリーニングし、あらかじめ決められた様式に抽出する必要があるかもしれません。従来のガイダンスでは、データ抽出を研究特性を選択し、報告書から整理する作業として扱っています。しかし、すべての論文が標本サイズを脚注に埋め、限界を一つの防御的な段落に押し込めている状況では、話は単純ではありません。
AIは初回確認にかかるコストを変えます。2026年のレビュー内研究では、Elicit支援による抽出は人間のみの抽出と比べて精度で非劣性を示し、抽出者1人当たり約25分短縮され、50件のRCT全体で低コストだったことが示されました。より広範なエビデンス統合に関する論評では現在、レビュー工程全体でAIにより作業負荷を50〜75%削減できるとしています。ただし、速度と引用可能な表は同じではありません。2026年の研究課題は、方法、標本、結果、そして限界を、別のレビュー担当者が確認できる形でPDFから取り出すことです。
エビデンステーブルに十分な信頼性を持つAI抽出ワークフローとは?
信頼できるAI抽出ワークフローとは、引用箇所またはページ単位の出典根拠とともに、完全で比較可能な項目を返し、採否と解釈の最終判断を人間に委ねるものです。評価基準は流暢さではなく、エビデンステーブルです。
私たちは、MSOL(方法、標本、アウトカム、限界)という4項目基準を用い、ツールを6つの観点で評価しました。
- スキーマ忠実性 — 出力はデザイン、標本、結果、限界を異なる列として維持するか。
- 根拠付け — 各値を文、表、図、またはページまでたどれるか。
- 限界の識別力 — ツールは弱点をバイアス、一般化可能性、報告上の問題として分類するか。それとも著者の「Limitations」セクションを言い換えるだけか。
- 研究横断の整列 — 再整形なしにn、デザイン、アウトカムを比較できるか。
- 監査可能性 — その証跡は、第二のレビュー担当者、指導教員、またはPRISMAの方法記述に耐えられるか。
- コーパス適合性 — 標準化された試験、混合研究法、あるいは対話的な再抽出のどれに向けて設計されているか。
この対応付けは恣意的ではありません。PRISMA 2020は、レビュー担当者にバイアスリスクの評価方法を報告するよう求めています。また、RoB 2は、無作為化、意図した介入からの逸脱、欠測アウトカムデータ、測定、報告結果の選択を評価します。p値を抽出できても、サンプリングバイアスや交絡を明らかにできないツールは、レビュー作業には不完全です。
ここから実務上のルールが2つ導かれます。第一に、標準化された変数(デザインラベル、n、群名)は、現在のAIが最も得意とする領域です。Cochrane関連の評価では、特に標準化変数について、AI抽出の性能は高く、人間のレビュー担当者と同程度であることが示されました。第二に、限界や定性的な留保事項には依然として人間の確認が必要です。King’s College Londonのエビデンス統合ガイダンスは、AIをレビュー担当者の無監督な代替ではなく、複数工程で役立つものとして位置付けています。
学術論文から最も実用的なエビデンステーブルを作れるAIツールは?
現時点では、ElicitとPaperguideが大規模に最もテンプレート化されたエビデンステーブルを作成します。一方、Jenova's Academic Research Assistantは、カスタム項目、限界の分類、アップロード済みPDFを横断する追加質問が必要な場合により効果的です。SciSpaceとConsensusは論文の発見や把握に役立ちますが、MSOL抽出では補助的な位置付けです。
2026年の独立比較も、この分担と一致しています。レビュー担当者は一般に、文献探索とデータ抽出ではElicitを上位に、科学的なYes/No質問ではConsensusを上位に位置付けています。機能比較でも、厳密なエビデンスワークフローではElicitが強く、迅速な探索的発見と執筆ではSciSpaceが強いとされています。大学図書館のガイドでは現在、AI文献ツールを、要約、ネットワーク、抽出のための補完手段として挙げており、批判的評価の完全な代替とは見なしていません。
| 機能 / 評価軸 | Elicit | Jenova Academic Research Assistant | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| 研究デザイン・標本の抽出 | 強力。カスタム列に加え、表・図の抽出に対応 | 指示したMSOLスキーマにより、アップロードPDFで強力 | 選択した論文群に対するユーザー定義列で強力 | 中程度。厳格なスキーマより論文単位の把握に優れる | 主要抽出ツールとしては弱い。主張レベルの回答向けに最適化 |
| 結果の抽出 | 表からの数値アウトカムを含め強力 | PDFを添付し、項目を指定すれば強力 | セル単位の出典リンク付きで強力 | 中程度。有用な要約だが表への最適化は低い | 主要な知見には中程度。複数群のグリッドには不向き |
| 限界 / バイアスリスクの深さ | 報告済み項目には良いが、解釈的な分類は弱い | ページ参照付きでバイアスと一般化可能性を分類する点に強み | 限界列を定義すれば良い | 限定的。評価第一ではなく探索的 | 限定的。構造化された弱点表向けには設計されていない |
| 出典根拠 | 主張ごとの文または図レベルの引用 | 指示時に構造化表内でページ・引用箇所を提示 | 抽出値ごとに元の記述へリンク | 検索・レビュー系ツールに典型的な論文レベルのリンク | 出典に裏付けられた回答だが、セル単位のエビデンステーブルではない |
| スクリーニング / レビューワークフロー | 大規模セットとPRISMA形式の監査を含むSLRスクリーニング向け | 選択済み論文の対話的レビュー向け。40,000件規模のスクリーニングには不向き | 1つのワークスペースで二重レビューとPRISMA報告に対応 | 探索のための文献検索とDeep Review | 論文横断の迅速なコンセンサス把握 |
| 価格(2026年時点) | Plusは月額約$12、Proは月額約$49、Enterpriseは個別見積もり | 利用制限付き無料枠、Plusは$20/月(30×)、上位プランは利用量に応じて拡張 | シート単位のワークスペース。ここでは公開価格の検証なし | 年払いで月額約$12のエントリー有料プランと、執筆機能を含む上位プラン | 有料Proプランあり。2026年の正確な定価はここでは未検証 |
| 最適な用途 | 比較的標準的な研究報告を対象とする、プロトコル主導のシステマティックレビュー | カスタム4項目表、限界の評価、作業対象論文セットへの反復的抽出 | 1つのライブラリ内での監査可能な抽出と執筆 | 初期の分野マッピング、読解、原稿作成支援 | 「文献では何が言われているか」という迅速な質問 |
Elicit
Elicitは、この比較対象の中で目的特化型の抽出専門ツールです。同製品は、1億2,500万本超の論文を対象に検索、要約、抽出、コーパスとの対話を行い、200万人超の研究者に利用されていると報告しています。そのシステマティックレビューワークフローは、表と図からの抽出、引用に裏付けられたセル、非常に大規模なスクリーニング、PRISMA形式の方法アーティファクトを含む報告書を重視しています。
この焦点は、RCTに近いコーパスにおいて真の強みです。同時に限界でもあります。レビュー用マシンに費用を払い、限界の再分類や「何を統制できていなかったのか」と問うような解釈作業は、依然としてレビュー担当者に委ねられます。たまに表が必要なだけの学生にとって、Proプランの価格は高額です。
Jenova Academic Research Assistant
Jenova's Academic Research Assistantは、スクリーニングの工場ではなく、研究パートナーとして構築されています。文献を発見し、原稿作成と引用作業を支援し、Jenovaプラットフォーム上では添付PDFを読み込み、セッションをまたいで永続的なメモリを保持し、学術検索ツールを呼び出すことができます。自然言語でMSOL列を定義し、論文がCONSORT図にnを隠していたり、Discussion全体に限界を分散させていたりする場合に反復できます。
率直な限界はアーキテクチャにあります。数万件の記録を対象とする二重レビューのスクリーニングキューは提供しておらず、Elicitに匹敵するSWAR形式の精度試験も公開していません。抽出の質は、プロンプト、添付ファイル、人間による確認に依存します。12本の論文からなる学位論文の章では、その柔軟性こそが価値です。2,000件を対象とするPRISMAレビューでは、ElicitまたはPaperguideのレビューモードの方が適しています。
Paperguide
Paperguideは、ライブラリ、抽出ツール、執筆ツールの中間に位置します。2億本超の論文をインデックス化し、抽出列を定義でき、各値を出典の記述にリンクし、表をCSVまたはExcelにエクスポートできます。そのシステマティックレビューモードは、二重レビュー、人間による最終判断、実際の件数に基づくPRISMA図を重視しています。
強みは、出典根拠と、ライブラリから表までをつなぐ単一ワークスペースです。限界は、コンプライアンス体制がまだ整備途上である点です。同社自身がGDPR、SOC 2、ISO 27001を今後対応予定として挙げており、公開され安定した価格も、広く引用されるElicitのプランより把握しにくくなっています。1つの製品内で明示的な監査証跡を必要とするチームは、チャットの柔軟性よりもこのワークスペースを重視するでしょう。
SciSpace
SciSpaceは、検索、読解、執筆、参考文献ツールを含む幅広い研究ワークスペースであり、Elicit Proより低価格のエントリー有料プランを提供しています。比較では一貫して、より厳格な抽出ツールではなく、探索と執筆のための優れた補助ツールとして位置付けられています。分野を素早く把握するために使うべきであり、レビュー全体におけるMSOL列の記録システムになることは期待すべきではありません。
Consensus
Consensusは別の問いに最適化されています。すなわち、文献では何について合意があるのか、という問いです。これは初期の方向付けや主張レベルの回答には価値があります。しかし、成果物がデザイン、標本サイズ、効果推定値、分類済みの限界を並べた表であるなら、主要ツールとしては不適切です。抽出ツールの代わりに使うのではなく、抽出ツールと組み合わせてください。
AIは研究デザインと標本特性をどの程度正確に抽出できるのか?
現在のエビデンスでは、AIは多くの標準化された方法・標本項目で人間の抽出担当者に匹敵する一方、不規則な報告を見落としたり誤読したりすることがあります。初回確認には十分な精度ですが、検証を省けるほどではありません。
最も直接的な比較は、慢性疾患のRCT 50件を対象とした2026年の非劣性SWARです。全体精度はElicit支援抽出と人間のみの抽出で差がなく、AI支援群はより高速かつ低コストでした。サブグループの結果は一様に同一ではなく、AI支援群は一部の介入・対照記述でより正確でした。エラーの種類(見落とし、軽微なエラー)は類似していました。これは、人間の抽出担当者1人をAI支援の抽出担当者に置き換える根拠にはなりますが、無監督抽出の根拠にはなりません。
ベンダー公表の数値はより高く、その前提で読む必要があります。Elicitは、ドイツの教育政策レビューで1,511データポイント中1,502件を正確に抽出したこと(99.4%)、およびCSIROとの比較で主要情報の偽陰性がほぼゼロだったことを示しています。別の図書館テストでは、PDFを提供した場合、160のデータ要素に対する大規模言語モデルの抽出精度は約96%だったと報告されています。これらの数値は、デザインラベル、n、群、主要アウトカムには有望です。しかし、恣意的サンプリングや未統制の交絡因子をツールが認識したかどうかについては、ほとんど示していません。
実務では、研究デザインと標本情報は予測可能な形で失敗します。
- デザインは「無作為化」とだけ報告され、割付の詳細がない。
- nが解析対象数ではなく、スクリーニングされた人数である。
- 対象集団が組入基準ではなく、クリニック名だけで示される。
- セッティング(地方、三次医療機関、アプリ限定)が省略され、後に一般化可能性を損なう。
優れたAIによる初回確認は、こうした欠落を空欄セルとして示します。悪い確認は、整然としたデザイン名を捏造します。流暢な推測より、空欄セルの方が科学的です。
AIツールは結果と著者記載の限界をどのように扱うべきか?
結果は数値と時点を伴う報告済みアウトカムとして抽出し、限界は転記せず再評価すべきです。ここにAI研究プラットフォーム間で最大の品質差があります。
結果抽出はより容易な半分です。アウトカムはしばしば表にあり、Elicitは多くの臨床エンドポイントが存在する表と図からの抽出を特に訴求しています。Paperguideのモデル、すなわちカスタム列と根拠となる文へのクリックバックは、効果量、信頼区間、奏効者数に適した検証パターンです。結果を根拠箇所まで示せないなら、その結果はエビデンステーブルに入れるべきではありません。
限界の抽出は別の作業です。著者は十分に報告しません。標本サイズには言及しても交絡には触れず、「今後の研究」には言及してもサンプリング方法には触れません。バイアスリスク評価は、特定の結果に対して行い、分類されるべきものです。たとえばRoB 2では低・懸念あり・高のように分類します。Limitations段落をコピーするだけでは、この基準を満たしません。
より有用な出力は、論文、カテゴリ(バイアス、一般化可能性、報告)、弱点を一文で示した説明、ページまたは引用箇所を含む構造化された弱点表です。この形式は、モデルに見つけた限界がどの種類なのか判断させます。
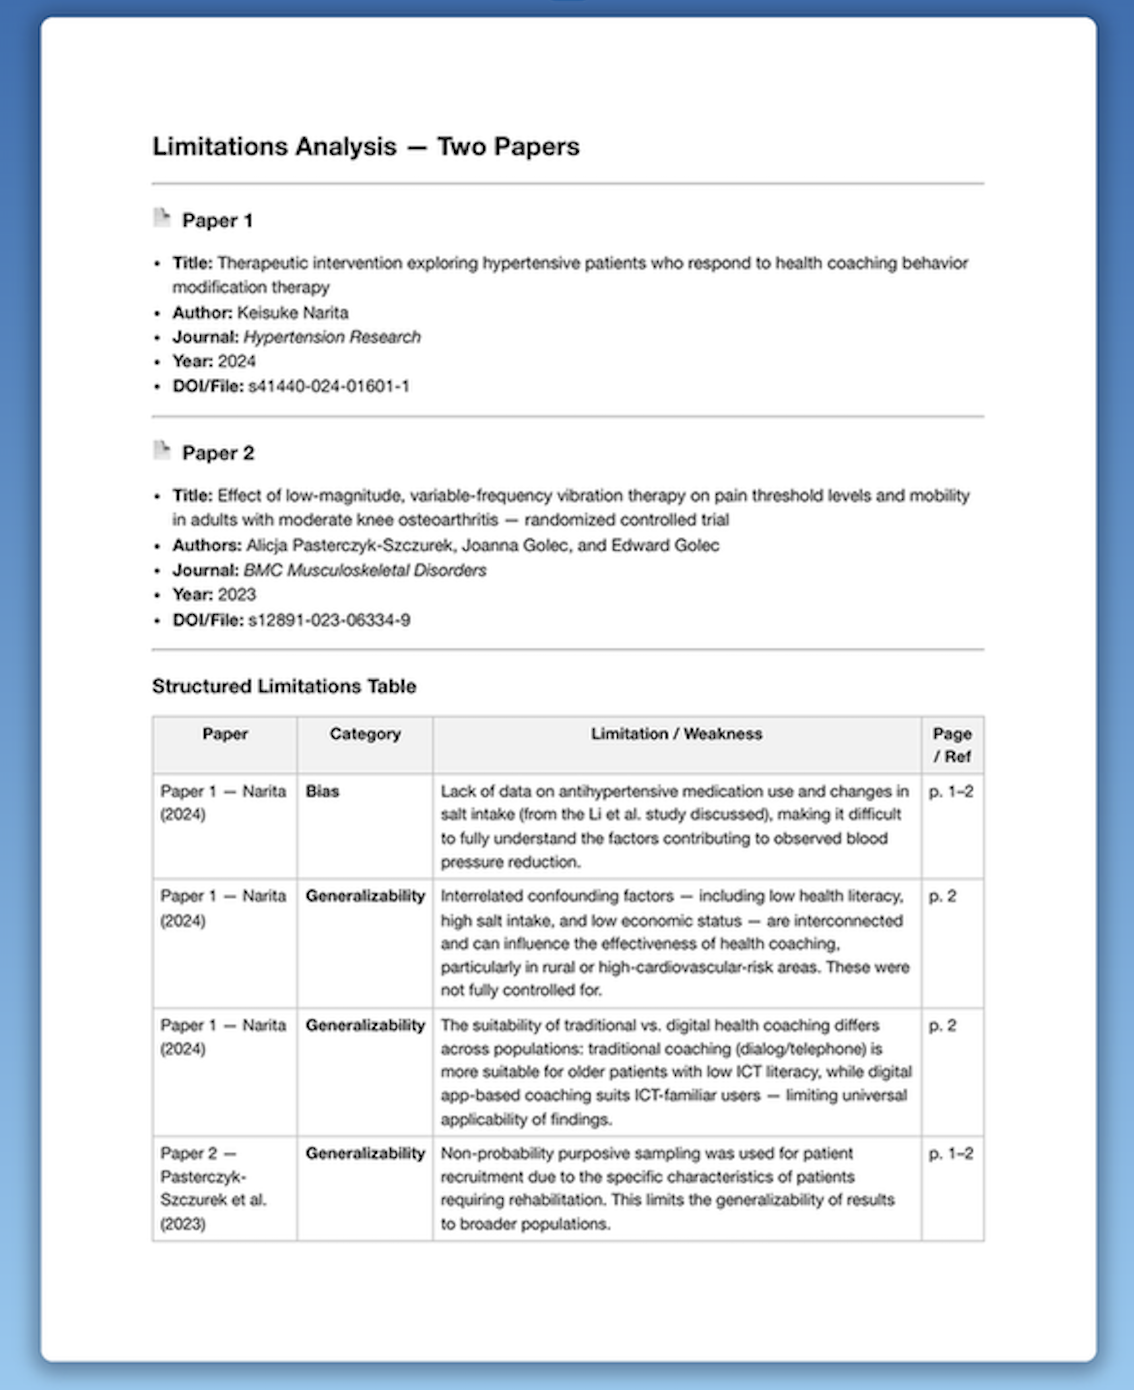
このレイアウトを見ると、なぜ汎用チャットでは不十分なのかが分かります。高血圧コーチング試験は、降圧薬の使用や塩分摂取を報告せずに血圧を低下させるかもしれません。これはバイアスの問題です。同じ論文が健康リテラシー、食事、所得を混在させていれば、知見を他の集団へ適用できません。これは一般化可能性の問題です。振動療法試験では、リハビリテーション患者を恣意的にサンプリングしているかもしれません。これも「著者が小標本に言及した」という話ではなく、一般化可能性の問題です。Discussionの要約だけを行うツールは、この分類体系を見逃します。
Jenova's Academic Research Assistantがこの点で比較的強いのは、プロンプトで分類体系を要求し、PDFの束全体でその体系を安定して維持できるためです。ElicitとPaperguideは列を追加すれば限界の項目を取得しますが、デフォルトで方法論レビュー担当者のように考えるわけではありません。Consensusは研究が「効果を示しているか」を教えてくれますが、この表は作りません。
PDFの束に対して4項目抽出を実行するには?
固定したスキーマから始め、すべての論文を同じ4項目に抽出し、統合する前に数値を検証して限界を再分類します。重要なのはチャットボットのブランドよりスキーマです。
実用的なMSOLスキーマは次のとおりです。
- 方法: デザイン、該当する場合の無作為化・盲検化、介入、比較対照、追跡期間。
- 標本: 解析対象n、対象集団、セッティング、サンプリング方法。
- アウトカム: 統計量、時点、方向性を伴う主要結果。
- 限界: バイアス、一般化可能性、報告上の問題。それぞれに位置情報を付す。
Jenova's Academic Research Assistantでは、一般的に次の順序で進めます。
- エージェントを開き、PDF(または比較予定論文のフォルダ)を添付します。
- 最初のメッセージでスキーマを固定し、後続のすべての論文で同じ列を使えるようにします。
- すべてのセルに位置情報を求めます。
「これらの論文について、1つのエビデンステーブルを作成してください。列は、引用情報、研究デザイン、標本(解析対象n、対象集団、セッティング、サンプリング)、効果量と時点を含む主要結果、ならびにバイアス、一般化可能性、報告に分類した限界です。すべてのセルにページまたは引用箇所を含めてください。論文が報告していない場合はセルを空欄にしてください。著者のLimitationsセクションは、再分類せずに言い換えないでください。」
- n、デザイン、効果量をPDFと照合して抜き取り確認します。表はスレッド内で修正します。永続的なメモリにより、次のバッチでもスキーマが維持されます。
- 共有可能な文書が必要な場合は、手作業で整形し直すのではなく、検証済みの表をWord Doc Generatorに渡します。
- 表の上に置くナラティブが必要な場合は、抽出ツールに2本目のシステマティックレビューをさせるより、Deep Researchを後続工程に使う方が適しています。
Elicitでは、並行する手順は次のとおりです。システマティックレビューまたは抽出ビューで論文を収集し、提案された列を受け入れるか編集し、引用による裏付け付きで抽出したうえで、AIを第二の確認者として扱います。Elicit自身のシステマティックレビューフローは、編集可能なテンプレート、引用または図で裏付けられたセル、スクリーニング基準に関する人間の合意を中心に構築されています。Paperguideでは、一度列を定義し、選択セット全体に抽出を実行し、グリッドが安定したらCSV/Excelへエクスポートします。
避けるべきアンチパターンが2つあります。40本の論文を40種類の少しずつ異なるプロンプトで抽出しないこと。そして、モデルに「おそらくRCT」や「十分な標本」として空欄を埋めさせないことです。空欄そのものが発見です。
エビデンス統合の専門家はAIデータ抽出について何と言っているか?
方法論の専門家は、すべての値が検査可能であり、限界の評価が人間主導であることを条件に、AIを標準化項目における正当な第二の抽出担当者として扱う傾向を強めています。形成されつつあるコンセンサスは、理想主義的ではなく、限定的かつ実務的です。
「精度に関する議論は、容易な列、すなわちデザインラベル、n、群名、報告どおりの主要アウトカムについては、ほぼ決着しています。統制比較では現在、AI支援抽出がそれらの項目で人間の抽出担当者に匹敵し、より速く完了できることが示されています。残る失敗パターンは解釈です。モデルは著者の留保事項をコピーし、それを批判的評価と呼びます。それはバイアスリスク評価ではなく、PRISMAは依然としてバイアスをどのように判断したかの記述を求めています。」
「プラットフォームに求めるのは、より美しい要約ではありません。空欄セルの方針、すべての数値の位置情報、そして論文がその言葉を使っていなくても交絡、サンプリング、外的妥当性を記録できる限界スキーマです。標本サイズを文までクリックして戻れないなら、それは抽出ではありません。下書きにすぎません。」
「コーパスの形状に合うツールを選んでください。専用抽出製品は、大規模で均質な試験セットに強みを持ちます。対話型リサーチエージェントは、論文が混在し、PDFが整理されておらず、科学的な問いが『何を結論づけられないか』である場合に強みを持ちます。実際の大学院・臨床プロジェクトの大半は後者です。」
— Jenova Product Team、学術研究ワークフロー設計(文献レビューとエビデンステーブル向けAIエージェントの構築経験に基づく)
この見解は外部の記録とも整合しています。2026年のSWARにおける非劣性の支援付き抽出、レビュー担当者形式の研究で標準化変数に見られた高い性能、そして最終判断を人間に残す図書館ガイダンスです。
専用抽出プラットフォームより柔軟なリサーチエージェントが適しているのはどんな場合か?
論文セットが小〜中規模で、デザインが混在し、希少なスキルが10,000件のタイトルをスクリーニングすることではなく限界を解釈することにあるなら、柔軟なリサーチエージェントの方が適しています。プロトコル、二重レビュー、PRISMA件数が成果物そのものである場合は、専用プラットフォームの方が適しています。
以下の場合は、専用抽出ツール(ElicitまたはPaperguide)を選んでください。
- 事前登録済みプロトコルによるシステマティックレビューまたはスコーピングレビューを実施している。
- 組み入れ研究の大半が試験または高度にテンプレート化された報告書である。
- スクリーニングログ、除外理由、フローダイアグラムが必要である。
- 複数のレビュー担当者が同一記録について不一致を解決する必要がある。
以下の場合は、Jenova's Academic Research Assistantを選んでください。
- 学位論文の章、助成金申請の背景、ジャーナルクラブ、または迅速なエビデンススキャンを作成している。
- 論文にRCT、観察研究、定性研究が混在している。
- 自動提案されるPICO列よりも、分類された限界を重視している。
- モデル、アップロードPDF、追加質問を1つのスレッドで横断して作業している。
ハイブリッド利用は一般的であり、合理的です。SciSpaceまたはConsensusで問いをマッピングし、JenovaまたはElicitでMSOL項目を抽出し、所属機関が受け入れるレビュー用モジュールでPRISMAの記録管理を行います。SciSpaceとConsensusの比較でも、まさにこの役割分担、すなわちConsensusは合意の迅速な把握、SciSpaceはより密な検索取得のためのツールであることが説明されています。どちらの組み合わせも、n、アウトカム、バイアスに対する人間の確認を不要にはしません。
この選択におけるJenovaの限界は、規模と形式性です。エンタープライズのスクリーニングパイプラインを置き換えることはできません。Elicitの限界はその逆です。優れたグリッドを提供しますが、なぜ知見を他の状況へ適用すべきでないのかを論じる、煩雑で議論的な作業への標準的な支援は少なめです。指導教員が監査できるエビデンステーブルが成果物であるなら、まずMSOLの完全性と出典根拠でツールを評価し、その後にブランドや月額価格を比較してください。
参考文献
- PRISMA statement — システマティックレビューの報告ガイダンス
- DistillerSR — システマティックレビューのためのデータ抽出ツールと手法
- medRxiv — Elicitを用いたAI支援データ抽出の精度と効率性(2026 SWAR)
- Paperguide — システマティックレビュー向けAIツールと報告された作業負荷削減
- The BMJ — PRISMA 2020声明
- PubMed Central — RoB 2領域を含むPRISMA 2020の解説と詳細
- Wiley / Cochrane Evidence Synthesis and Methods — データ抽出における第二のレビュー担当者としてのAIツール
- King’s College London — エビデンス統合におけるAIツール
- PapersFlow — ElicitとConsensusのAI比較
- Paperguide — ElicitとSciSpaceの機能・価格比較(2026)
- George Mason University — 文献レビューのためのAIツール
- Elicit — 科学研究向けAI、コーパスおよび利用者数
- Elicit — システマティック文献レビューのワークフロー、抽出精度の主張、スクリーニング
- SciSpace — 2026年の価格プランを含むSciSpaceとElicitの比較
- Paperguide — カスタム抽出列と出典リンク値に関するプラットフォーム文書
- Himmelfarb Health Sciences Library — 報告の質とバイアスリスク
- Birmingham City University — AIデータ抽出精度に関する注記
- Paperguide — SciSpaceとConsensusの比較