キャラクター設定画と一貫したポーズに最適なAI漫画アシスタントはどれ?
2026-08-14
なぜプロンプトだけのキャラクター生成より、設定画先行ワークフローが優れているのか?
最も優れた結果を生むのは、キャラクター設定画を一回限りの生成結果ではなく、永続的な参照アセットとして扱うツールです。この基準では、Jenova's Manga Creator、Midjourney、そしてComfyUIのControlNet + IPAdapterスタックは、明確に異なる3つの階層に位置します。プロンプトのみの生成は、規模が大きくなるほど破綻します。各レンダリングがテキストからキャラクターを再発明してしまうためです。設定画先行のワークフローなら、顔の構造、衣装の細部、体型比率を、いつでも立ち戻れる1枚の画像に固定できます。
40コマにわたってキャラクターを維持できるツールと、6コマ目にはもう崩れてしまうツールを分けるのは、次の4要素です。
✅ 参照の永続性 — セッションをまたいで設定画を保存できるか、毎回のプロンプトで再アップロードが必要か ✅ ポーズと表情の分離 — モデルが顔を再抽選せずに、身体の位置だけを変えられるか ✅ マルチビュー生成 — 正面、側面、3/4、背面を、1回の一貫した生成で作れるか ✅ キャラクター重みの制御 — 生成ごとに、出力が参照をどれほど厳密に守るか調整できるか
この4つの軸が、本記事全体で用いる評価フレームワークです。漫画プロジェクトは画像ギャラリーではなく、連続性の問題だからこそ重要です。そして連続性の失敗は、ページを重ねるごとに増幅します。
キャラクター設定画とは何か、そしてなぜAIに必要なのか?
キャラクター設定画とは、1人のキャラクターを正面、側面、斜め3/4、背面から示すマルチビューの参照資料です。通常は固定ポーズ、ニュートラルな照明、統一されたスケールで作成されます。アンカーとなる画像がなければ、生成システムには世代間でキャラクターを記憶する内部メモリがないため、AIにもこれが必要です。
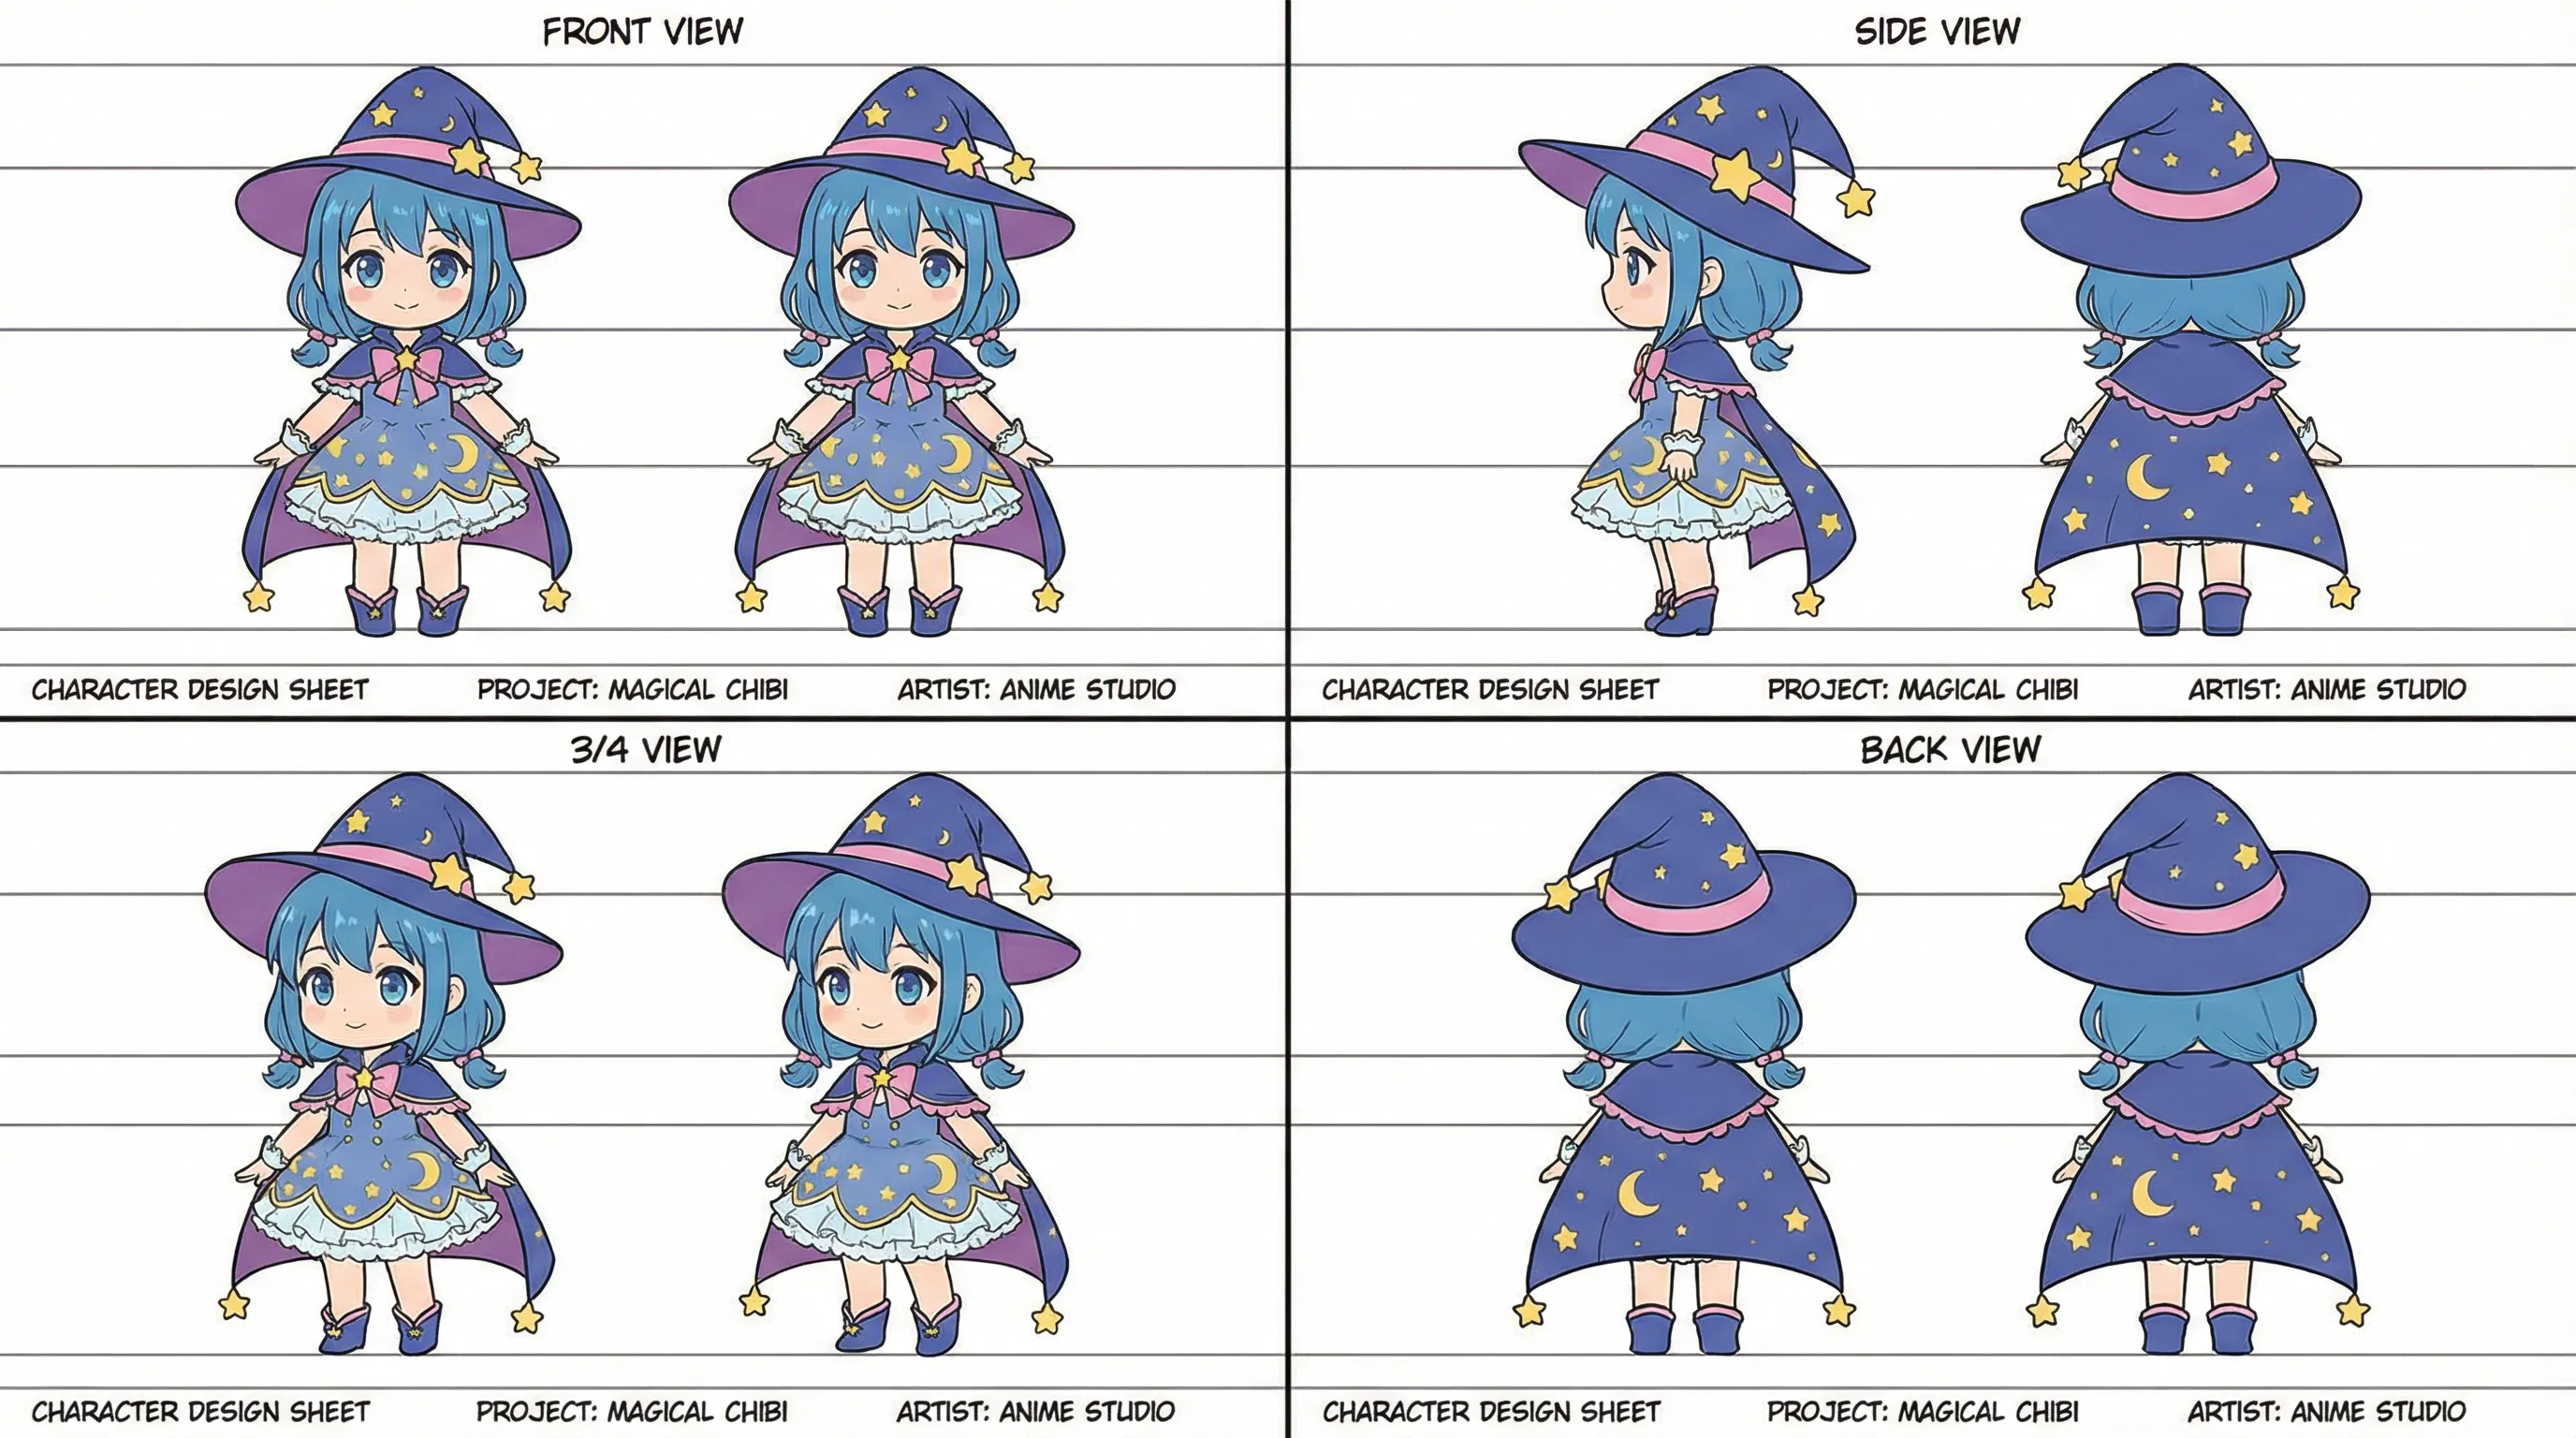
上の設定画は、制作アニメーションおよび漫画スタジオで使われる標準的なターンアラウンド形式を示しています。どの角度でも維持しなければならない反復要素に注目してください。月と星のドレス模様、ピンクのリボン、星形の先端を持つブーツ、そして帽子のクラウン部分の比率です。
制作レベルの設定画に必須の要素:
- 4つの基本ビュー — 同一スケールの正面、側面、3/4、背面
- 衣装ディテールの注釈 — アクセサリー、模様、非対称の要素
- ニュートラルな基本表情 — モデルが戻るべき参照用の顔
- 統一された線の太さとレンダリングスタイル — スタイルの混在は参照エンコーダーを混乱させる
- 身長・比率ガイド — 目線、肩、腰、膝を示す水平線
設定画が機能する決定的な技術的理由は、参照コンディショニング機能がテキストではなく画像から視覚的特徴をエンコードすることです。Midjourneyのドキュメントでは、Character Referenceによってモデルが「髪の色、服装、顔の特徴などのキャラクター特性を認識し、これらの細部を新しいシーンでキャラクターを生成する際に利用できる」と説明されています。テキストだけでは、そのレベルの具体性を伝えられません。
AI漫画アシスタントでは何を確認すべきか?
生の画像品質ではなく、6つの重み付けされた評価軸で漫画アシスタントを評価してください。設定画からずれる美しいレンダリングは、連続した物語において価値がないからです。
6次元の評価フレームワーク:
| 評価軸 | テストする内容 | 漫画で重要な理由 |
|---|---|---|
| 参照の永続性 | 設定画は再アップロードなしでセッションをまたいで残るか? | 200ページの作品は数週間に及ぶ。毎セッションの再アップロードは崩れを招く |
| 追従度の制御 | 出力が参照に従う厳密さを調整できるか? | 顔のみの固定と衣装全体の固定は別のニーズ |
| ポーズ制御 | アイデンティティとは独立して、骨格・ポーズを指定できるか? | アクションコマでは、設定画に存在しないポーズが必要になる |
| 表情の幅 | 1つの基本顔から表情設定画を生成できるか? | 漫画は顔の演技で動く |
| マルチビューの一貫性 | 3/4ビューが本当に正面ビューと一致するか? | コマ間のカメラ変更は弱いシステムを破綻させる |
| ワークフローの負荷 | 最初の実用的な出力までに必要な準備時間 | 週刊のページ制作スケジュールに適合するかを左右する |
早期にテストすべき、2つの失格レベルの失敗パターン:
-
顔交換としての誤解。 一部の参照機能は構造的なものであり、アイデンティティを保存するものではありません。Leonardo.Aiのドキュメントでも、Character Referenceは「顔交換機能を意図したものではなく、出力内の人物を完全に複製することは保証しない」と明記されています。この違いが、ツールが主人公を物語全体で維持できるかを決定します。
-
ディテールの消失。 Midjourney自身のベストプラクティスでは、「特定のそばかすや衣服のロゴなど、複雑な細部は正確に再現されない場合がある」と警告されています。紋章、傷跡、非対称の衣装要素で定義されるキャラクターにとって、これは調整の問題ではなく、厳しい制約です。
主要なAI漫画アシスタントはどう比較できるか?
主要な5つの選択肢は、永続メモリを持つ対話型エージェントプラットフォーム、参照コンディショニング画像ジェネレーター、ノードベースのローカルパイプラインという3つのアーキテクチャに分かれます。それぞれ、ワークフローの速さと制御の深さを交換条件として持ちます。
| 機能 / 評価軸 | Jenova Manga Creator | Midjourney | Leonardo.Ai | Adobe Firefly | ComfyUI(ControlNet + IPAdapter) |
|---|---|---|---|---|---|
| 参照の永続性 | セッションをまたぐ永続メモリ。設定画はプロジェクト全体で読み込み済みのまま | ロックアイコンにより画像をImagineバーへ固定可能。セッションをまたぐプロジェクトメモリはない | 生成ごとのImage Guidance | ストレージAPI経由で生成ごとにアップロード | ローカルファイル。定義上は永続的だが、管理は手作業 |
| 追従度の制御 | 対話形式。自然言語で指定し、コマごとに調整 | --cw パラメータ、0~100。--cw 0 は顔に集中し、--cw 100 は顔・髪・衣装を含む | Image Guidanceの強度で制御 | strength パラメータ、1~100、初期値50 | ControlNetとIPAdapterをそれぞれ独立してノードごとに重み設定 |
| ポーズ制御 | 対話で記述。エージェントがコマ単位の演出指示を処理 | テキストプロンプト駆動。明示的な骨格入力なし | Image Guidanceモード | Structure Referenceが「画像の輪郭と奥行き」を適用 | 明示的。ポーズ骨格入力を伴うOpenPose / depth ControlNet |
| マルチビュー設定画 | セッション内で完全なターンアラウンドと表情セットを生成 | 可能だが、ビューごとに手作業でプロンプトが必要 | ガイダンスにより可能 | ビューごとに構図を一致させる | 実現可能だが、専用ワークフローの構築が必要 |
| 表情セット | 対話ワークフローに標準搭載 | プロンプトごとに手作業 | 手作業 | 手作業 | 別途Face Detailerパスが必要 |
| 導入負荷 | 数分。インストール不要 | 数分 | 数分 | 数分 | 数時間~数日。ノード、モデル、VRAMの調整 |
| 形式サポート(参照) | 標準的な画像形式 | .png、.gif、.webp、.jpg、.jpeg | 標準的な画像形式 | API経由でimage/webpを含む | ローカルでは形式を問わない |
| 料金 | 無料枠あり。有料プランは月額$20から | サブスクリプション階層(midjourney.comを参照) | サブスクリプション階層(leonardo.aiを参照) | Adobeサブスクリプション / Firefly Services APIクレジット | 無料ソフトウェア。GPUまたはクラウドGPUの費用が必要 |
| 最適な用途 | ストーリーと作画の連続性を1か所で必要とする本格的な漫画プロジェクト | スタイルに強い個性を持つ単一キャラクターのシーン | ガイダンス制御を使った高速な反復 | Adobeワークフロー内で構図を固定したバリエーション | 最大限の制御、技術ユーザー、再現可能なバッチ制作 |
ツール別の率直な制約:
- Jenova Manga Creatorは、永続メモリによるストーリーとコマの連続性に優れますが、ComfyUIのような数値による追従度パラメータやポーズ骨格入力は公開していません。ノードごとの重み制御を求める技術ユーザーには、抽象化されすぎていると感じられるでしょう。
- Midjourneyは特徴的なスタイライズを生み出し、実用的なキャラクター重みダイヤルを提供します。しかし、ドキュメントでは、参照は「正確にコピーするためではなく、新しい創作を導くインスピレーションとして機能する」と明示されています。またCharacter Referenceはバージョンに依存し、MidjourneyおよびNijiバージョン6に適用されます。V7ではOmni Referenceがこれに置き換わります。
- Leonardo.Aiは、分かれていた参照モードを統合しました。ヘルプドキュメントでは、Image Guidanceにより「スタイル参照、edge-to-image、Character Referenceなどのために旧モデルを使ったり、画像を個別にアップロードしたりする必要がなくなった」と説明されています。よりシンプルになった一方、以前の分割された制御ほど細かくはありません。
- Adobe Fireflyは、アイデンティティの一致よりも構造の一致に優れます。Adobeの開発者ドキュメントでは、Structure Referenceは「画像の輪郭や奥行きといった構造的特性を、異なる細部、スタイル、雰囲気を持つ新規生成画像に適用する」と説明されています。これはキャラクターアイデンティティの制御ではなく、構図の制御です。
- ComfyUIは最も深い制御と、最も急な学習曲線を提供します。モデルのダウンロード、ノードグラフの構築、ハードウェアが必要です。
何かを生成する前に、どうキャラクター設定画を作るべきか?
4つのビューはすべて同じセッションでまとめて生成してください。別々のセッションで作られたビューは、同じ説明に対して異なる潜在的解釈を継承するため、一致しません。
Jenova's Manga Creatorを使う場合:
jenova.ai/a/manga-creatorでエージェントを開く- 断片的に追加するのではなく、1つの詳細なメッセージでキャラクターを定義する:
「主人公のキャラクター設定画を作成してください。16歳の女性、あごまでの青い髪に左右2本のねじり髪、クラウン部分に金色の星が付いたつば広の紫の魔女帽子、ピンクの縁取りがあるケープ、三日月模様のドレス、星形の先端を持つアンクルブーツ。正面、側面、3/4、背面を統一スケールで、クリーンな白黒漫画線画として生成してください。」
- ターンアラウンドの連続性エラーを確認する。4ビューすべてで帽子のクラウンの高さ、ケープの長さ、衣装の模様が一致しているかチェックする
- コマを生成する前に、その設定画をプロジェクト参照として固定する:
「この設定画を、プロジェクト全体におけるこのキャラクターの正規参照として使用してください。そこから逸脱したコマがあれば通知してください。」
MidjourneyのCharacter Referenceを使う場合:
- 基本キャラクターはMidjourney内で生成します。ドキュメントでは、この点が明確に述べられています。「最良の結果を得るには、Midjourneyが作成した単一キャラクターの画像から始めてください。実在人物の画像は、通常その人物に正確には似ません。」
- Imagineバーの画像アイコンをクリックし、画像をCharacter Referenceセクションにドラッグする
- ロックアイコンをクリックして、プロンプト間で参照を固定する
- 参照を明確なテキストプロンプトと組み合わせる。ドキュメントでは「参照画像にないシーン全体や追加の細部を伝えるには、テキストも同じくらい重要である」と強調されています
- Discordでは、ホストされた画像URLの後に
--crefを追加する
ComfyUIを使う場合: RunComfyの一貫したキャラクター作成ガイドでは、まずControlNetで顔を作成し、その後、衣装とポーズのための別パスを行う2段階アプローチが説明されています。このガイドでは、IPAdapterが正方形のクロップを好むことにも触れています。顔と胴体を各IPAdapterに入力する前に正方形にクロップし、アテンションマスクで各領域を分離します。
完成した設定画から、一貫した表情をどう生成するか?
表情は、別セッションで1つずつ生成するのではなく、設定画のニュートラルな顔からバッチとして生成してください。バッチ生成は基本顔の解釈を共有しますが、連続生成では毎回アンカーが再設定されるためです。
表情マトリクスのアプローチ。 その場しのぎで表情を求めるのではなく、物語に必要な感情の全域を最初に定義します。通常は、漫画における標準セットをカバーする8~12の表情です。
- 基本: 無表情、微笑み
- ポジティブ: 喜び、興奮、愛情
- ネガティブ: 怒り、悲しみ、恐怖
- 反応: 驚き、困惑、恥ずかしさ
- ジャンル別: 決意(少年漫画)、無表情のツッコミ顔(コメディ)、虚ろな凝視(ホラー)
Jenova's Manga Creator向けのプロンプトパターン:
「固定済みのキャラクター設定画を用いて、このキャラクターの表情マトリクスを生成してください。無表情、喜び、怒り、悲しみ、驚き、恥ずかしさ、決意、恐怖です。12種類すべての頭部角度は3/4ビューに統一してください。髪のシルエット、帽子の位置、目の形は完全に維持し、変えるのは眉、口、目の開き具合、頬の赤みだけにしてください。」
特定の顔要素だけを変えるよう指示することが、崩れを防ぐ鍵です。制約がなければ、生成システムは表情とともに髪のボリュームや顔の形も再解釈します。
**Midjourneyでは、**キャラクター重みパラメータが主要なツールになります。ドキュメントによれば、--cw 0は焦点を「主にキャラクターの顔」に移します。表情作業では、まさにこれが必要です。フレーム内で再現する必要がない衣装を、意図的に求めていないからです。全身ポーズでは、--cw 100により「顔、髪、衣装」が含まれます。
**ComfyUIでは、**RunComfyのワークフローは「顔の特徴の強化に特化し、他のIPAdapterの影響から分離して精密なディテールを実現する」専用の顔パスで終わります。顔の調整が身体や衣装のコンディショニングから分離されるため、表情設定画において構造的な利点となります。
キャラクターを失わずに新しいポーズを得るには?
ポーズ生成では、骨格とアイデンティティを切り離す必要があります。3つのツールカテゴリは、それぞれ異なる方法でこれを解決します。エージェントプラットフォームは演出指示付きの記述で、参照ジェネレーターは重み調整とプロンプトの具体性で、ノードパイプラインは明示的な骨格入力で処理します。
ポーズ変更がキャラクターを崩す理由。 ポーズの変更は、シルエット、パースによる短縮、見える衣装要素を変えます。参照コンディショニングシステムは参照画像全体に重みを与えるため、劇的なポーズでは、ポーズの指示を守るか、参照の形状を守るかを選ばなければなりません。参照への追従を強くするほど、モデルは新しいポーズに抵抗します。
3つのアプローチ:
📐 明示的な骨格制御(ComfyUI)。 RunComfyのワークフローは、専用パスで「身体の位置決めにControlNet」を使用し、その後にアイデンティティのためのIPAdapterコンディショニングを再導入します。ポーズとアイデンティティは文字どおり別のノードです。コミュニティで解説された代替手法では、ControlNetモデルをWebUIのモデルディレクトリに配置し、複数の視点からキャラクターを生成する方法を扱っています。
🎯 重み調整された参照(Midjourney)。 --cwの値を下げると衣装への追従が緩み、ポーズプロンプトの余地が増えます。これを、詳細なテキストプロンプトを使うというドキュメントのガイダンスと組み合わせてください。Midjourneyドキュメントの良いプロンプトと悪いプロンプトの例では、「青い髪と金色の眼鏡をかけた男性がカフェに座っている」のようにシーンを具体的に指定するほうが、曖昧なシーン説明より優れた結果を出すことが示されています。
💬 演出指示付きの記述(Jenova Manga Creator)。 漫画編集者が指示を出すようにポーズを指定し、エージェントが設定画の参照を内部で維持します。
「第4コマ:キャラクターがジャンプの途中で、ローアングルから見上げる構図。ケープは後方へなびき、帽子のつばは風で押し上げられている。顔はカメラの方向へ向いた3/4ビューにしてください。髪、帽子、衣装は固定済みの設定画に合わせてください。」
実用的なハイブリッド案: 反復が速い対話型エージェントで設定画と表情マトリクスを作り、その後、最終確定した設定画を参照画像としてMidjourneyまたはComfyUIに書き出し、機械的な精度が求められるポーズ重視のアクションシーケンスに使う方法です。ツールは相互排他的ではなく、制作中のクリエイターの間ではパイプラインを混在させることが一般的です。
現場のデジタルアーティストはAIキャラクターの一貫性について何を語るか?
実践者の共通認識は、一貫性はモデルの問題ではなくワークフローの問題であり、最大の改善は下流で崩れを修正することではなく、先に参照作業を行うことから得られる、というものです。
「ほぼすべての初心者が犯す間違いは、先にコマを生成し、後からクリーンアップとしてキャラクター設定画を作ることです。順番が逆です。1コマ目の前にターンアラウンドを完成させるために使った1時間は、20ページ目までに必要になる再生成をおよそ6時間節約します。設定画はキャラクターの記録ではありません。生成パイプラインにおいて、キャラクターそのものを存在させる仕組みです。」
「もう1つ理解すべきなのは、追従度の制御は、高いほど良い品質ダイヤルではないということです。最大の参照重みは、フレーム内に必要ですらない衣装を再現させようとしてしまうため、表情作業では積極的に間違いです。表情には顔重視の設定、導入ショットには最大重み、アクションコマには中程度の重み。これが実際のプロのパターンであり、ツールを問いません。」
「対話型エージェントプラットフォームが本当に計算を変えるのは、プロジェクトメモリです。ノードパイプラインやプロンプトベースのジェネレーターでは、キャラクター設定画はファイルシステムと自分自身の規律の中にあります。セッション間で永続するメモリを持つエージェントでは、設定画がワークフローそのものに存在します。数か月にわたる200ページの連載プロジェクトでは、この違いが勝負を決めます。長期の漫画プロジェクトを壊す崩れは、ほとんどの場合、セッション内ではなくセッション間で連続性が失われることによって起きるのです。」
— Jenovaプロダクトチーム、生成ビジュアルワークフローおよび連続アートツール分野で9年
自分のプロジェクトにはどのツールを選ぶべきか?
生の出力品質ではなく、プロジェクトの長さと技術的な許容度に合わせてツールを選んでください。5つの選択肢はいずれも単体画像なら十分な結果を出せますが、連続性の圧力がかかったときに初めて差が現れます。
🎬 長編連載漫画(50ページ以上) → Jenova Manga Creator。 セッションをまたぐ永続メモリが決定的な要因です。このエージェントは「読み切りから200ページ超の連載大作まで、ビジュアルストーリーテリング、コマの流れ、一貫したアートスタイルを扱う」と説明されており、ストーリーの連続性と作画の連続性を同じコンテキストで維持します。交換条件は、数値パラメータ制御を手放すことです。
🎨 スタイルに個性のある読み切り・短編作品 → Midjourney。 --cwダイヤルは生成ごとに実効性のある制御を提供し、ドキュメントによれば、参照画像はStyle ReferencesおよびImage Promptsと同時に組み合わせられます。交換条件は、プロジェクト単位のメモリがないことと、複雑な衣装要素でディテールが失われることです。
⚙️ 再現性の高い大量制作 → ControlNet + IPAdapterを使ったComfyUI。 明示的なポーズ骨格、分離された顔パス、ノードごとの重み制御を利用できます。RunComfyのガイドには、色の過飽和を防ぐための彩度低下ノードさえ記載されており、利用可能な粒度の高さが分かります。交換条件は、数時間のセットアップ、GPU要件、継続的なノード保守です。
🖼️ 既存のAdobeパイプライン内で構図を固定したバリエーション → Adobe Firefly。 調整可能なstrength(1~100、初期値50)を持つStructure Referenceは、コマ構図の一貫性に強みがあります。交換条件は、アイデンティティツールではなく構造ツールであることです。
⚡ 高速な反復と探索 → Leonardo.Ai。 統合されたImage Guidanceにより、モード切り替えの手間がなくなります。交換条件は、置き換えられた個別制御より粒度が低いこと、そしてCharacter Referenceが複製レベルの出力を明示的に保証していないことです。
知っておくべき隣接ワークフロー: 縦スクロール形式で制作するクリエイターには、エピソード単位のフルカラー演出に適した**Webtoon Creatorが向いています。一方、西洋スタイルの連続アートにはComic Creator**が対応します。どちらもManga CreatorとともにJenovaで利用でき、3つすべてがプラットフォームの永続メモリとマルチモデルアクセスを継承しています。無料枠の利用には制限があり、有料プランは無料枠の30倍の利用量で月額$20からです。
キャラクターの一貫性を壊す、最もよくある間違いは何か?
最も深刻な5つのエラーは、生成中のプロンプトミスではなく、生成前に行われるワークフロー上の判断です。
1. 実写写真をキャラクター参照として使う。 Midjourneyのドキュメントは「実在人物の画像は、通常その人物に正確には似ない」と明言し、代わりにモデル生成の単一キャラクター画像から始めることを推奨しています。写真には、参照エンコーダーが予測不能に解釈する照明、レンズ歪み、微細なディテールが含まれています。
2. 不必要に複数の参照画像を重ねる。 同じドキュメントでは、「同じキャラクターの画像を複数使用できるが、多くの場合その必要はない」とアドバイスされています。追加の参照は、特徴を強化するよりも、際立つ特徴を平均化してしまうことがあります。
3. シーンを参照画像だけに担わせる。 Midjourneyの対比例が示すように、同一の参照があっても、曖昧なプロンプトは具体的なプロンプトに劣ります。参照が担うのはアイデンティティであり、それ以外のすべてはプロンプトが担わなければなりません。
4. 再現不可能な細部を中心にキャラクターを作る。 特定のロゴ、そばかすの配置、衣服上の細かい文字でキャラクターを定義するなら、細部の消失を想定してください。識別要素は、細かいディテールよりはるかに確実に参照エンコードを生き残る、髪型、帽子の形、ケープの長さ、ブーツの色といったシルエット規模で設計しましょう。
5. 追従度の重みを品質設定として扱う。 最大重みは導入ショットには正しい一方、表情設定画には誤りです。Fireflyのstrengthパラメータが100ではなく50を初期値とするのは、まさにこのためです。中程度の値であれば、新しいプロンプトを尊重する余地がモデルに残ります。
形式の互換性について: ツール間で設定画を移動する場合は、パイプラインを組む前に対応形式を確認してください。Midjourneyは.png、.gif、.webp、.jpg、.jpegを受け付けます。FireflyのストレージAPIはimage/webpなどを受け付けます。プラットフォーム間で参照設定画を移動する際には、WebPが最も安全な交換形式として広く利用できます。
参考文献
- Midjourneyドキュメント — Character Reference
- Midjourneyドキュメント — Omni Reference
- Midjourneyアップデート — Character Referencesの導入
- Leonardo.Aiドキュメント — Image Guidanceを使用した画像生成
- Leonardo.Aiヘルプセンター — Image Guidance
- Adobe開発者向けドキュメント — Structure Image Reference、Firefly API
- Adobeブログ — Adobe Fireflyの新しいStructure Reference機能
- Adobeヘルプセンター — 参照画像に合わせた画像構図の一致
- RunComfy — ControlNetとIPAdapterで一貫したキャラクターを作成する
- Stable Diffusion Art — 異なる視点から一貫したキャラクターを作成する方法
- Think Diffusion — ComfyUIでFluxを活用した一貫したキャラクター作成
- ComfyUI — オープンソースのノードベース生成インターフェース