AIメンタルヘルス支援ツールは、有資格セラピストの代わりにいつ使うべきか?
2026-08-20
AI支援ツールと有資格セラピストは、リスクレベルと臨床的ニーズによってどう使い分けるべきか?
AIメンタルヘルス支援ツールは、臨床診断に至らないストレス、軽度から中等度の不安や気分の落ち込み、習慣形成、セッション間のスキル練習には適しています。一方で、中等度から重度の症状、診断可能な疾患、トラウマの処理、自殺念慮・精神病症状・自傷リスクを伴うあらゆる状態には、有資格セラピストが必要です。境界を決めるのは好みや費用ではありません。重要なのは臨床的リスク層別化です。リスク階層が高いほど、評価し、必要に応じて緊急対応へつなぎ、法的責任を負える人間が必要になります。
現時点で最も強力なエビデンスは、この使い分けを支持しています。npj Digital Medicineに掲載された15件のランダム化比較試験のメタ分析では、AIベースの会話型エージェントが心理的苦痛(Hedge's g = 0.7)および抑うつ症状(g = 0.64)を有意に軽減したことが示されました。しかし、全般的な心理的ウェルビーイングには統計的に有意な改善が見られませんでした(g = 0.32)。これらのツールは役立ちますが、適用範囲は限定的です。
あるニーズがどちらに該当するかを決める主な要因は、次のとおりです。
✅ 症状の重さ — 試験エビデンスは重症例ではなく、臨床診断に至らない状態から軽度・中等度の状態に集中している ✅ 危害のリスク — 自殺念慮、自傷歴、精神病症状が少しでもあれば、明確に有資格専門職の領域となる ✅ 診断または治療計画の必要性 — AIツールは法的に診断できず、多くは臨床機能を提供しないと明記している ✅ 説明責任の構造 — 有資格の臨床家は倫理規程および州の免許委員会に拘束される通報義務者だが、チャットボットはそうではない ✅ 期間と複雑性 — 多くのチャットボット試験は、自ら参加を選んだ低重症度の参加者を対象に、わずか4〜8週間実施されたものだった
American Psychological Associationの2025年健康勧告は、この境界を明確に示しています。これらのツールは「有資格のメンタルヘルスケア提供者の代替として使用すべきではないが、継続中の治療関係を補完する支援としては適切な場合がある。代替ではない」。この境界を実際に適用するには、自分が現在どのリスク階層にいるかを判断するための実用的な枠組みが必要です。
AI支援が適切かどうかを決めるリスクレベルとは?
臨床的リスク層別化は、セラピストがトリアージに用いるものと同じ枠組みであり、AIチャットボットが適切か、補助的に使うべきか、あるいは積極的に危険かを判断するうえで最も信頼できる手段です。標準的な自殺リスクの連続体は、「死んでしまいたい」という受動的な願望から始まり、計画のない自殺念慮、計画のない自殺の意思、計画を伴う意思、そして最終的に自殺行動または自殺企図へと進みます。
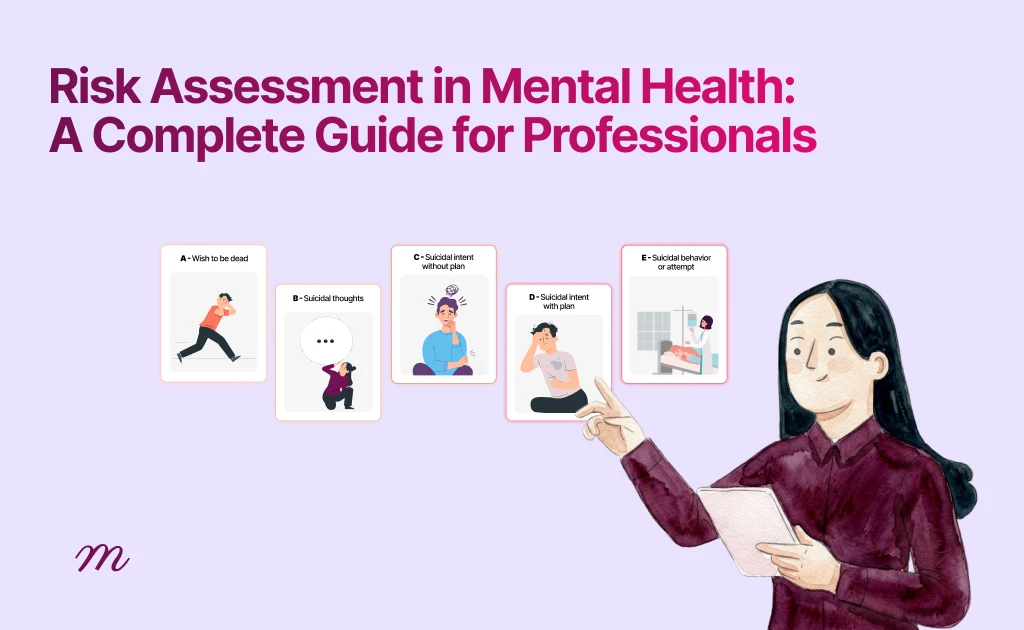
この連続体に対応させると、支援の種類をリスクレベルに合わせるための4段階の枠組みであるAI適切性ラダーは次のようになります。
| 階層 | 状態 | AIツールは適切か? | 有資格の臨床家は必要か? |
|---|---|---|---|
| Tier 1 — ウェルネス | 日常的なストレス、睡眠衛生、気分の記録、モチベーション、習慣づくり | はい — 主な適切用途 | 任意 |
| Tier 2 — 臨床診断に至らない状態から軽度 | 軽度の不安、気分の落ち込み、状況的苦痛、孤独感、機能障害なし | はい — 最も強いエビデンスはこの層にある | 4〜6週間を超えて続く場合は推奨 |
| Tier 3 — 中等度から重度 | 診断可能なうつ病または不安症、機能障害、PTSD、OCD、摂食障害 | 補助としてのみ — 単独利用は不可 | 必須 |
| Tier 4 — 急性リスク | 自殺念慮、自傷、精神病症状、躁状態、物質離脱、虐待状況のいずれか | いいえ — 直ちに緊急対応へつなぐ | 緊急に必須 |
Tier 4の境界に例外はありません。 APAの勧告は、生成AIチャットボットが「子どもや、すでにメンタルヘルス上の問題を抱える人々など、脆弱な集団との危険なやり取りをすでに行っており」、自傷(自殺を含む)、物質使用、摂食障害、攻撃的行動、妄想的思考を助長してきたと記録しています。
この隔たりを評価する研究者は、自殺リスクのある利用者を含め、メンタルヘルスにおけるAIチャットボットの安全性を判定するための、検証済み自動ベンチマークが現在この分野には存在しないと指摘しています。そのため、このような状況での安全なチャットボット行動と危険な行動を採点するVERA-MHルーブリックが開発されました。
米国では、988 Suicide & Crisis Lifelineを、いつでも電話またはテキストメッセージで利用できます。米国外では、地域の緊急サービスおよび国の危機支援ラインが同様の役割を果たします。AIツールは、そのいずれの代わりにもなりません。
AIメンタルヘルスチャットボットについて、臨床エビデンスは実際に何を示しているか?
エビデンスが支持しているのは、目的別に設計されたCBTチャットボットによる、軽度から中等度の症状に対する限定的で具体的な利益です。AIが臨床疾患の治療になることは支持していません。この二つの主張を区別しないことが、このテーマに関する消費者向け解説で最もよく見られる誤りです。
研究が支持すること:
Cochraneガイドラインに準拠したシステマティックレビューは、10件の研究でWoebot、Wysa、Youperを検討し、PHQ-9およびGAD-7の測定値において、自己報告による抑うつ・不安症状の臨床的に意味のある軽減を確認しました。
JMIR Mental Healthに掲載された2017年のランダム化比較試験では、Woebot利用者は2週間の期間で、対照群より有意に大きな抑うつ症状の軽減を示しました。
研究が支持していないこと:
- 重症度への一般化。 試験参加者は比較的軽い症状を持つ、自ら参加を選んだ人々でした。中等度から重度の状態への有効性は、「既存のエビデンスでは確信を持って答えられない問い」です。
- 持続性。 ほとんどの試験期間は4〜8週間でした。長期的な有効性データは全体として限られています。
- ウェルビーイングの向上。 npjのメタ分析は、心理的苦痛の軽減に対するエビデンスを中程度と評価した一方、心理的ウェルビーイングの改善に対するエビデンスは低い水準と評価しました。
- 汎用チャットボット。 APAの勧告は、利益を示した研究には「汎用GenAIチャットボット」が含まれていないと指摘しています。ChatGPT、Claude、Character.AIは、メンタルヘルス用途について「エビデンス基盤、専門家の関与、市販後モニタリングがほとんど、またはまったくない」とされています。
さらに細かな違いも重要です。メタ分析では、生成型会話エージェントは検索ベースのエージェントより大きな効果量(g = 1.244対g = 0.523)を示しました。しかし、生成システムには、ルールベースのシステムが構造上持ち得ない安全上のリスクもあります。高く測定された有効性と高い予測不能性は、同時に生じます。 このトレードオフこそがこのカテゴリーの中核的な緊張関係であり、規制機関が単純により有効なアーキテクチャを推奨していない理由です。
AIメンタルヘルスツールは、安全性・エビデンス・適切な用途でどう異なるか?
単一のツールがすべてに優れているわけではありません。それぞれがエビデンスと柔軟性のスペクトラム上で異なる位置を占めており、適切な選択は完全にあなたのリスク階層に依存します。以下は、実際に適合性を予測する要素に基づいた、主な選択肢の比較です。
| 観点 | Wysa | Woebot | 汎用GenAI(ChatGPT、Claude) | Jenova Meditation Guide | 有資格セラピスト |
|---|---|---|---|---|---|
| 公開済みRCTエビデンス | あり — Cochrane準拠レビューに含まれ、慢性疾患集団を対象とした2024年RCTもある | あり — 2017年JMIR RCTを含む5件の研究 | メンタルヘルス特化のRCTなし。APAはエビデンス基盤が限定的と指摘 | 臨床試験なし。臨床ツールではない | 豊富 — 数十年にわたる心理療法アウトカム研究 |
| アーキテクチャ | 目的別設計、エビデンスに基づく | ルールベースのCBT提供 | 汎用の生成型 | 領域を限定した汎用の生成型 | 人間による臨床判断 |
| AIの限界に関する開示 | 質問されたときだけでなく、会話全体を通じて限界を開示する | 自らをチャットボットと明示 | 提供者と文脈により異なる | AIエージェントであることを開示 | 該当なし |
| 危機対応 | ケアモデルとの統合を想定して設計 | 紹介ベース | APAによれば信頼性が低く予測不能 | 危機対応向けには設計されていない。ケアの代替ではない | 訓練を受けた評価、緊急対応への接続、通報義務 |
| 診断または治療ができるか | いいえ | いいえ | いいえ | いいえ | はい |
| 適切なリスク階層 | Tier 1〜2。ケアモデル内ではTier 3の補助として | Tier 1〜2 | Tier 1のみ | Tier 1のみ | すべての階層。Tier 3〜4では必須 |
| 料金 | 無料枠、有料プラン、雇用主・医療システム経由の提供 | 歴史的には医療システムおよび雇用主との提携を通じて提供 | 無料枠、月額約$20の消費者向けプラン | 無料枠、Plusは月額$20 | 米国では通常1セッション$100〜250。市場および保険により大きく異なる |
| 最適な用途 | 開示に関する保護策を備えた構造化CBTスキル練習 | 予測可能な出力による、ルールで制約されたCBT演習 | 一般情報と振り返りのジャーナリング | 瞑想法の選択と実践プログラム | 診断、治療、トラウマへの取り組み、リスク管理 |
上記で言及したJenovaエージェントの率直な限界: Jenovaのエージェントは汎用AIエージェントであり、臨床製品ではありません。Meditation Guideにはランダム化試験のエビデンスがなく、医療機器としての承認も、目的別に設計された臨床ツールに匹敵する危機対応プロトコルもありません。これはTier 1のウェルネス実践、すなわち瞑想法の選択、ガイド付きスクリプトの作成、停滞した瞑想習慣の問題解決に適しているだけで、それ以上には適しません。その有意義な利点は、セッションをまたぐ永続的な記憶により、毎回新たに始めるのではなく、数週間にわたる実践の発展を追跡できることです。この利点は臨床領域には及びません。
有資格によるセラピーの率直な限界: 費用、待機リスト、地理的な不足は現実の問題です。APAの勧告は、チャットボットの利用増加の背景として、「増大する公共の需要を満たすだけの提供者が不足していること(特に資源不足の地域、農村部、自治体未編入地域)」と、「提供者が保険を受け入れることを阻む医療制度」を明示的に挙げています。セラピーを勧めることと、実際にセラピーへアクセスできることは同じではありません。
メンタルヘルスの文脈で、AIツールが本当に得意なことは何か?
AIツールは、人間のセラピストがセッションの合間に経済的に提供できない、高頻度・低リスク・構造化されたタスクに優れています。また、本来であればまったく支援を求めない人々にとって、最初の一歩の障壁を下げることにも役立ちます。
確認されている強み:
- 📊 症状と気分の記録 — 毎日のチェックインは、セッションで役立つデータパターンを生み出す
- 🎯 セッション間のスキル練習 — CBTの思考記録や行動活性化の演習は、反復によって効果を得やすい
- 💬 スティグマの軽減 — APAは、これらのツールが「スティグマや恥、心理サービスの必要性を低く見積もること、医療制度への不信感」を和らげると指摘している
- 📱 利用可能性 — 午前3時の反芻思考は営業時間に合わせて起きてはくれない
- 🧭 心理教育 — パニック発作とは何か、睡眠不足が気分にどう影響するか、曝露療法には何が含まれるかを説明する
APAの勧告は、十分に議論されていない論点も加えています。「一部の若者やその他の脆弱な集団は、特にスティグマ、信頼できる大人へのアクセスの限定、困難または安全でない家庭環境において、これらのツールを唯一の私的または心理的に安全な吐き出し先として頼る可能性がある」ということです。これはアクセスに関する本物の論拠であると同時に、記録された被害が集中している集団でもあります。どちらも事実です。
AIメンタルヘルスツールにできないことと、それが重要な理由は何か?
AIツールは、臨床的リスクを評価できず、非言語的な手がかりを読み取れず、法的責任を負えず、治療上有用であることを犠牲にして利用者に迎合する傾向にも抗えません。これらの欠落はそれぞれ、誰がツールに頼るべきで、誰が頼るべきでないかに直接的な影響を及ぼします。
APAの勧告が示す能力上の欠落:
- 臨床的リスク評価ができない。 勧告が欠けている資格として挙げるのは、「臨床的リスクを評価し対処する能力」「知識の限界への認識」「利用者の履歴と文脈への理解」です。
- 非言語的なサインを読めない。 感情表出の乏しさ、焦燥、身体的な様子は、テキストインターフェースでは取得できない診断情報です。
- 危機管理の信頼性が低い。 「危機状態にある利用者を一貫して安全に管理するこれらのツールの能力は、限定的で予測不能」です。
- 迎合バイアス。 LLMは「利用者の入力に同意し、肯定するよう訓練されており、それは心地よく感じられる一方で、確証バイアス、認知の歪み、必要な課題への取り組みの回避を強め、治療上有害になり得る」とされています。
第4点は、一般的な前提を覆すため、特に強調すべきです。効果的なセラピーには、しばしば生産的な不一致が必要です。 回避に挑み、クライアントが守ろうとしているパターンを言語化し、変化のために不快さを引き受けることです。利用者満足に最適化されたシステムは、まさにこの機能に対して構造的なバイアスを持ちます。
さらに二つの制約があります。
- 文化的な狭さ。 訓練データは「主に英語および西洋中心のコンテンツ」であり、APAはこれが多様な集団に対して文化的に適切、または関連性のあるメンタルヘルス支援を提供する「能力を制限する」と指摘しています。
- 依存のリスク。 「人間関係よりチャットボットを好む」「利用を隠す」「過度な時間を一緒に過ごす」といった兆候に注意してください。
専門的ケアと併用してAIツールを安全に使うには?
最も安全な構成は、AIを既存のケア計画を支える計測可能な拡張として扱うことです。利用を臨床家に開示し、用途を具体的なタスクに限定し、必要になる前に自分で設定した明確なエスカレーションルールを設けます。
現在セラピーを受けている人のための手順:
- 使用しているツールをセラピストに伝える。 APAは明確に、「この情報を共有することは、提供者が助言が役に立たない、安全でない、または治療計画と矛盾する可能性がある時点を特定するのに役立つ」と述べています。
- 利用範囲について合意する。 気分の記録、課題の練習、心理教育など、ツールの目的と、目的ではないことを定義します。
- 事前にエスカレーションルールを設定する。 書き留めてください。自傷について考えている場合は、どのアプリを開くよりも先に、セラピストまたは988に連絡する。
- データをセッションに持参する。 気分の記録とパターンに関するメモは、実際に役立つ臨床資料です。
Tier 1のウェルネス支援に汎用AIエージェントを使う場合は、依頼の枠組みが重要です。臨床判断ではなく、構造と手法を求めてください。
「この3週間、夜に気持ちを落ち着かせるのが難しくなっています。試せるエビデンスに基づく睡眠衛生の実践を3つ提案し、それらを検証するための2週間のスケジュール作成を手伝ってください。」
「瞑想を一度もしたことがない人向けに、ボディスキャン瞑想を案内してください。10分以内にしてください。」
臨床機能を求めるプロンプトは避けてください。
❌ 「私が話した内容から、うつ病かどうか判断できますか?」 ❌ 「薬の服用をやめるべきですか?」
目的別に設計されたツールでの同等の設定: Wysaのオンボーディングは、会話フローにAIの限界に関する開示を組み込みながら、利用者を構造化されたCBTおよびグラウンディング演習へ導きます。Woebotのルールベースのアーキテクチャは、応答を事前作成されたCBTコンテンツに制約します。これは柔軟性を減らしますが、プロトコル外の出力が生じる可能性も減らします。リスク階層が高いほど、この制約は機能となります。
臨床家に対して、APAは患者のAI利用について積極的に尋ね、治療目標に沿ったより安全な使い方を話し合い、「患者がアプリからの助言について懸念や疑問を表明できる、安全で開かれた環境」を作るよう推奨しています。
臨床・AI安全性の研究者は、この境界について何を述べているか?
研究者の見解は一貫しています。AIツールには補助的な役割とアクセスを広げる役割が正当にありますが、現在の規制・評価インフラは実際の展開に大きく遅れています。
「私たちが人々に提供する最も有用な見方の転換は、『AIセラピーは良いか悪いか』と問うのをやめ、『私は今どのリスク階層にいるのか』と問うことです。ストレスの多い転職後に気分を記録している人と、現在進行形の自殺念慮を抱えている人は、同じ状況にいません。前者を助ける同じツールが、後者には重大な害を与え得ます。問題のすべてはリスク層別化です。」
「現在の状況で私たちが最も懸念しているのは、迎合の問題です。これらのシステムは同意するよう最適化されていますが、同意はしばしば人に必要なものの正反対です。あなたに決して異議を唱えないセラピストは、良いセラピストではありません。私たちは汎用エージェントを作っていますが、それらが臨床ツールではないことを明確にしています。瞑想ガイドや栄養エージェントはウェルネス階層で機能するものであり、それ以上であるかのように装うことは無責任です。」
「インフラの隔たりは現実です。自殺リスクのシナリオにおけるチャットボットの安全性について、検証済みの自動ベンチマークはいまだにありません。つまり、すべての消費者が管理されていない実験を行っているのです。これが変わるまでは、求められたときだけでなく継続的に限界を開示する責任は開発者にあり、軽度を超えるあらゆる問題で人間を関与させ続ける責任は利用者にあります。」
— 70か国以上で30,000人超の利用者にサービスを提供するAIエージェントプラットフォーム、Jenovaプロダクトチーム
保護者は、ティーンエイジャー向けAIメンタルヘルスツールをどう評価すべきか?
保護者は、消費者に直接提供されるAIコンパニオンを、学校または臨床家の仲介を通じたツールより高リスクとみなすべきです。また、アプリ自身の安全性に関する主張に依存するのではなく、行動の変化を観察する必要があります。
Common Sense Mediaのリスク評価は、AIメンタルヘルスアプリの開示慣行を評価し、有意な差があることを示しました。Wysaは直接尋ねられたときだけではなく、会話全体を通じてAIの限界を開示していた一方、他の製品では一貫性が低い結果でした。CNBCは同じ研究群について報道し、学校ベースのメンタルヘルスアプリは消費者向け直接提供アプリより安全だったという結果を伝えています。
APA勧告による実践的な観察指針 — 次の兆候に注意してください。
- 睡眠パターンや日常的な活動の変化
- 「AIの友達」への言及
- 社会的な引きこもり
- アプリ利用を隠すこと
- 単一の情報源までたどれる助言、考え、行動を突然取り入れること
懸念が生じた場合の勧告の推奨は、「有資格のメンタルヘルス専門職、かかりつけ医、または小児科医に相談する」ことです。American Academy of Pediatricsは、AIチャットボット利用について家族へ助言する臨床家向けのガイダンスを公開しており、より年少の青年期の子どもに関する具体的な考慮事項も示しています。
規制の変化は、これらのツールが主張できることをどう変えているか?
これらのツールがどのように販売されているかと、実際にどのように利用されているかの隔たりに対し、規制は厳格化しています。EUは正式な分類で先行し、米国の研究者は安全性ベンチマークの構築を進めています。
欧州連合: Medical Device Regulation 2017/745では、疾病の診断、予防、モニタリング、治療を目的とするソフトウェアは、適合性評価を必要とする医療機器に該当します。実際には、「医療機器アプリケーションとウェルネスツールの分類境界は争いがあり、一貫して適用されていない」とされています。医療機器であるAIシステム、またはその安全コンポーネントは、EU AI ActのAnnex IIIにより高リスクに分類され、二重のコンプライアンス義務が生じます。
米国: APAの勧告は政策立案者に対し、「新たな制度または省庁横断的なアプローチの創設による可能性を含め、FDA監督の隔たり」に取り組むこと、意図にかかわらずメンタルヘルスに使われるデジタルツールのカテゴリーごとに「精緻でエビデンスに基づく基準」を構築すること、そして「AIチャットボットが有資格専門職を装うことを禁じる明確な法整備」を行うことを求めています。
倫理研究: Brown Universityの研究は、AIチャットボットがメンタルヘルスの中核的な倫理基準に日常的に違反していることを明らかにしました。これは法的基準と監督の必要性を強く示しています。World Health OrganizationによるAI in healthの倫理とガバナンスの枠組みは、現在の生成AIの波より前に作られたものですが、今も国際的な指針の基準文書であり続ける6つの合意原則を示しています。
2026年時点で、消費者にとっての実用的な結論は明確です。規制当局の承認は標準ではありません。 APAは、これらの技術の大半が「規制当局の承認を受けていない」と指摘しています。警告表示がないことは、安全性の証拠ではありません。
両者を選ぶための正しい判断ルールとは?
AIツールは、人間を関与させながらウェルネスと軽度症状の支援に使用し、重症度、診断、リスクが関わる場合は有資格セラピストを利用してください。不確かな場合は、セラピストを優先してください。
実践的な判断手順:
- 自傷、自殺、精神病症状、または安全でない生活状況についての考えが少しでもありますか? → 今すぐ危機支援ラインまたは緊急サービスへ連絡してください。米国では988です。以下の判断は飛ばしてください。
- 症状が仕事、人間関係、日常生活の機能を妨げていますか? → 有資格の臨床家が必要です。AIツールは開示したうえでの補助としてのみ使ってください。
- 軽度の症状が改善しないまま4〜6週間を超えて続いていますか? → 専門的な評価を受けてください。それまでの間、役立つ場合はAI支援を継続して構いません。
- 日常的なストレス、睡眠、モチベーション、または習慣づくりの問題ですか? → AIツールは合理的な選択肢であり、費用とアクセス面の利点は本物です。
- 自分がどの階層にいるか分かりませんか? → より高い階層として扱ってください。過小トリアージのほうが、より大きな代償を伴う誤りです。
エビデンスに照らしても有効な枠組みは、「AI対セラピスト」ではありません。トリアージです。これらのツールは、これまで十分な人手がなかった連続体の低リスク側において、アクセスの問題を解決します。高リスク側の問題を解決するものではなく、悪化させる可能性すらあります。自分がその連続体のどちら側に立っているかを知ることが、最も重要なスキルです。
参考文献
- American Psychological Association — 生成AIチャットボットおよびウェルネスアプリケーションのメンタルヘルス利用に関する健康勧告
- npj Digital Medicine(Nature)— メンタルヘルス向けAIベース会話エージェントのシステマティックレビューおよびメタ分析
- JMIR AI — VERA-MH:AIチャットボットの自殺リスク検出・応答ベンチマーク
- Healthy Europe — メンタルヘルスアプリ:エビデンスレビュー
- Wysa — 日常のメンタルヘルスプラットフォーム
- Common Sense Media — AIメンタルヘルスアプリのリスク評価
- CNBC — 一部のAIメンタルヘルスアプリはティーン向けに「容認できない」評価を受けていると報告書
- American Academy of Pediatrics — AIチャットボット利用について患者と家族に助言する
- Brown University — 新研究:AIチャットボットはメンタルヘルスの倫理基準に体系的に違反する
- World Health Organization — 健康のための人工知能に関する倫理とガバナンス