エージェントのためのベクトルメモリAIチャット:永続的な意味記憶
2026-09-15
Jenova は、直近数件のメッセージだけでなく意味を記憶するベクトルメモリAIチャットを提供します。2026年9月時点でも、多くのアシスタントは好みを忘れ、プロジェクトの文脈を見失い、同じファイルの説明を何度も求めます。このプラットフォームは対話、文書、設定を保存し、専門エージェントが質問に応じて適切な文脈を取得できるようにします。
✅ 自ら消去されるスライディングウィンドウではない、セッションをまたぐ永続メモリ ✅ キーワードではなく意味に基づく検索 — 入力した語句ではなく、意図した内容を見つける ✅ 一度添付すれば、調査、コード、執筆で繰り返し使えるナレッジベース ✅ ウェブ、iOS、Androidで同じメモリ基盤を利用
ステートレスなチャットは運用コストこそ低いものの、利用コストは高くつきます。ベクトルメモリが有用なAIチャットの中心になった理由を理解するには、埋め込み、検索、長期文脈が日常業務で実際にどのように失敗するかを見る必要があります。
簡潔な回答:ベクトルメモリAIチャットとは?
ベクトルメモリAIチャットとは、会話の意味を埋め込みとして保存し、AIがセッションをまたいで関連する文脈、文書、設定を想起できるようにする検索システムです。 スレッドごとに最初から始まるチャットボットと、作業を継続するエージェントの違いを生み出します。
主な機能:
- メッセージ、ファイル、事実をベクトルとして埋め込み、類似性検索を行う
- 最も関連性の高いメモリだけをモデルのコンテキストウィンドウに取り込む
- 1つのプラットフォーム上で、無制限のチャット履歴とセッション横断の設定を維持する
- パラメトリックな推測ではなく、添付したナレッジベースに基づいて回答する
- エージェントに改めて説明することなく、デスクでの作業とスマートフォンでの作業に同じメモリを引き継ぐ
なぜ多くのAIチャットは今も忘れてしまうのか
大規模言語モデルは推論には強い一方、記録管理には弱いものです。その重みには一般知識が保持されていますが、あなたのバックログ、あなたのスキーマ、あなたの直近の決定は保存されていません。検索拡張生成が存在するのは、パラメトリックメモリが一貫性に欠け、プライベートな領域向けに更新しにくいためであり、この点は 2025年のRAGアーキテクチャに関する調査でもまとめられています。
この検索レイヤーに対する業界の需要は、もはや実験段階ではありません。
USD 2,652.1 million → USD 8,945.7 million — 2025年から2030年にかけての世界のベクトルデータベース市場予測、CAGR 27.5%
この支出は症状にすぎません。メモリのないチャットが同じ失敗を繰り返すため、チームはベクトルインフラストラクチャを導入しています。
- コンテキストウィンドウがあふれ、古い決定がプロジェクト途中で消える
- キーワード検索では、言い換え、同義語、暗黙の意図を見逃す
- DIY RAG スタック(チャンク分割、インデックス、評価、認証)が本番導入前に停滞する
- パーソナライゼーションが単一ベンダーのチャット履歴に閉じ込められる
- モデルがファイルに根拠づけられないと、回答がぶれる
しかし、耐久性があり、プライベートで、意味的に検索可能なメモリを日常のチャットに組み込むことは、今なお驚くほど困難です。
コンテキストウィンドウはメモリではない
コンテキストウィンドウはアーカイブではなく、バッファです。会話履歴、ユーザーの質問、少数の「保存済みの事実」がプロンプトに連結され、収まらないものは切り捨てられます。だからこそ、コーディングエージェントは昨日貼り付けたエラーを忘れ、チューターは目標スコアを再び尋ねます。ベクトルメモリはウィンドウの外側に存在します。全文のトランスクリプトが収まることを期待するのではなく、推論時に少量かつ関連性の高い情報を取得します。
キーワード検索では意味を表現できない
従来の検索は完全一致するトークンを優遇します。ベクトル検索は、コサイン類似度やユークリッド距離などの指標を用いて、意味の高次元数値表現である埋め込みを比較します。埋め込みとベクトルインデックスは、現代のLLMアプリケーションを可能にする検索レイヤーです。このレイヤーがなければ、「第3四半期の採用計画」と検索しても、「秋の人員数」というタイトルのメモは取得できません。
自作RAGはインフラストラクチャプロジェクトになる
本番用の検索パイプラインには、チャンク分割戦略、埋め込みモデルの選定、ANNインデックス、メタデータフィルター、評価、更新ジョブが必要です。公開されているANNベンチマークが示すように、チームが重視する理由があります。速度だけでなくレイテンシ、スループット、精度がまとめて比較されるのは、再現率を伴わない速度は別の製品だからです。単に記憶するチャットを求める大半の個人が、そのスタックを運用する必要はありません。
持ち運べないメモリによるパーソナライゼーションは脆い
StanfordのDigital Economy Labは、AIにおける持続的な優位性は、また1つの孤立したチャットボットではなく、永続的でユーザーが管理できる個人文脈から生まれると主張しています。今日のメモリは通常、ベンダー機能です。ユーザーとともに移動せず、表示される情報を密かに変える可能性もあります。チャットボットのメモリに関する Columbia Journalism Reviewの報道では、ユーザーを想起することが、人々が受け取る情報を変え得ると指摘されています。
これはまさに、Jenovaが構築された理由です。
Jenovaのソリューション
Jenova は、ベクトルメモリAIチャットを、後から接続するアドオンではなく標準機能として扱います。無制限のチャット履歴、セッション横断の永続メモリ、添付可能なナレッジベースが、すべての専門エージェントを支えています。自然言語で話しかけるだけで、プラットフォームがモデルの回答前に適切な埋め込み、ツール、ファイルを取得します。
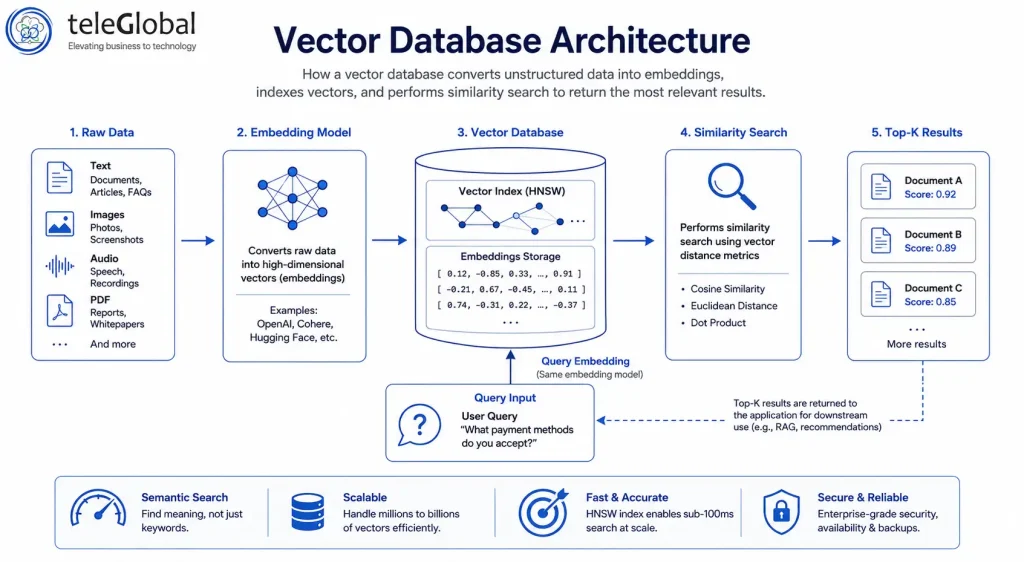
上の図は、この体験を支える仕組みです。非構造化テキスト、画像、文書は埋め込みに変換され、ベクトルインデックスに格納され、クエリに対する上位k件の一致結果として返されます。HNSWパラメータの設定や距離指標の選択は必要ありません。スレッドを開始するだけです。
| 従来のアプローチ | Jenova |
|---|---|
| 新しいチャットのたびに同じ要件を貼り付ける | セッションとエージェントをまたぐ永続メモリ |
| ノートやPDFをキーワード検索する | 埋め込みに対するセマンティック検索 |
| ベクトル DB、埋め込みモデル、RAG評価を自己ホストする | 完全管理型のストレージと検索 |
| 1つのモデルベンダー、1つのメモリサイロ | 共有文脈を備えたマルチモデルアクセス |
| モバイルで途切れるデスクトップ専用の履歴 | ウェブ、iOS、Androidで完全に同等の機能 |
やり直しではなく積み上がる調査
アシスタントがすでに除外した論文を覚えていなければ、文献レビューや市場調査は破綻します。Real-Time Search はGoogle、Reddit、YouTube、GitHubなどから最新の結果を取得し、ベクトルメモリは採択基準、過去の引用、「この情報源は使用しない」というルールを維持します。毎朝新しいBooleanクエリを始めるのではなく、検索に裏付けられた調査を継続できます。
エージェントが実際に理解しているコードベース
Python Coding Assistant は、初日にはスクリプトのために役立ちます。そして12日目には、パッケージ構成、スキップすると決めた不安定なテスト、先週固定したAPI契約まで把握しているため、長期的な価値を発揮します。リポジトリのメモや設計ドキュメントは一度だけ添付してください。その後のプロンプトは、別のアーキテクチャを作り出すのではなく、その文脈を取得します。
文体と事実を保ち続ける執筆
ステートレスなチャットでは、トーン、禁止表現、信頼すべきURLがウィンドウ外へ漏れ出すため、下書きは行き詰まります。プラットフォーム上の執筆特化エージェントは、文体サンプルや構成上の決定をメモリとして保存し、「ローンチ投稿と同じ文体で」と指示した際に取得できます。文書添付と組み合わせれば、これはより大きなプロンプトではなく、編集上の一貫性を実現するベクトルメモリです。
リセットされるべきではない生活と学習
コーチングや語学練習が機能するのは、エージェントが制約を覚えている場合に限られます。たとえば怪我、試験日、すでに習得した語彙などです。永続メモリは、汎用的なチューターを、初週の練習を繰り返さないチューターに変えます。Pythonのトレースバックを取得する同じストアが、文法表よりロールプレイのほうが学びやすいという事実も取得できます。
クレジットカード不要で、プラットフォームを無料でお試しください。
ベクトルメモリAIチャットのための専門AIエージェント
メモリの有用性は、それを活かすワークフローに左右されます。これらのエージェントは、忘却のコストが高いタスク、すなわち長期の調査、定期的な業務、没入型の練習、キャラクターの一貫性が求められるプレイのために設計されています。
Deep Research
数時間に及ぶ調査は、ベクトルメモリAIチャットの代表的な活用例です。このエージェントは数百の情報源を検索し、インライン引用付きで知見を統合し、翌日も質問の範囲を再設定せずに継続できるレポートを提供します。
- 調査課題、除外した情報源、作業中の仮説を保存する
- 過去の発見を取得し、後半のセクションが前半と矛盾しないようにする
- モデルの記憶だけに頼らず、引用した資料に根拠づけて主張する
Academic Research Assistant
PhDや教員のワークフローは、数か月にわたる文献、引用スタイル、原稿バージョンに及びます。このアシスタントは主要データベースから論文を発見し、原稿作成を支援します。メモリにより、投稿先、方法論、既読の文献セットを維持できます。
- 学術リポジトリを横断するリアルタイムの文献探索
- 継続中の原稿に結び付いた引用・原稿作成支援
- 一度限りのチャット回答ではなく、関連論文をまたぐ継続性
Personal Secretary
ロジスティクスはメモリの問題です。定期的に利用する業者、旅行の好み、金曜日の更新を受け取る人などが該当します。このエージェントは、深い個人文脈をもとにカレンダー、メール、日々の業務を調整するため、毎週月曜日にルーティンを教え直す必要がありません。
- 固定の好みと一緒に働く人々を記憶する
- 計画を、すでに使っているツールに接続する
- 朝のブリーフィングから午後のフォローアップまで文脈を引き継ぐ
Roleplay Game Master
長期メモリなしに、物語の一貫性は実現できません。このエージェントは、無制限のメモリと安定したキャラクターによる没入型ロールプレイのために作られています。プロット上の約束、派閥名、トーンは、コンテキストウィンドウがあふれてもリセットされません。
- 物語の状態とキャラクターの声を保つ無制限メモリ
- 後の章で必要になった際に、過去のシーンを取得する
- 継続性を失わない幅広い創造性
Learn Russian Through Roleplay
言語習得は、間隔を空けた個別の文脈に依存します。たとえば、間違えた単語、丁寧さのレベル、すでに経験した物語です。このメンターは無制限のシナリオと無制限のメモリを活用し、初級者向けスクリプトを繰り返すのではなく、練習を積み上げます。
- 語彙の弱点と好みのシナリオタイプを記憶する
- セッションをまたいでキャラクターと設定を一貫させる
- 各会話を検索に裏付けられた練習に変える
ベクトルメモリAIチャットの仕組み
ベクトルデータベースを立ち上げる必要はありません。会話を始めるだけで、プラットフォームが埋め込み、検索、コンテキストウィンドウを処理します。
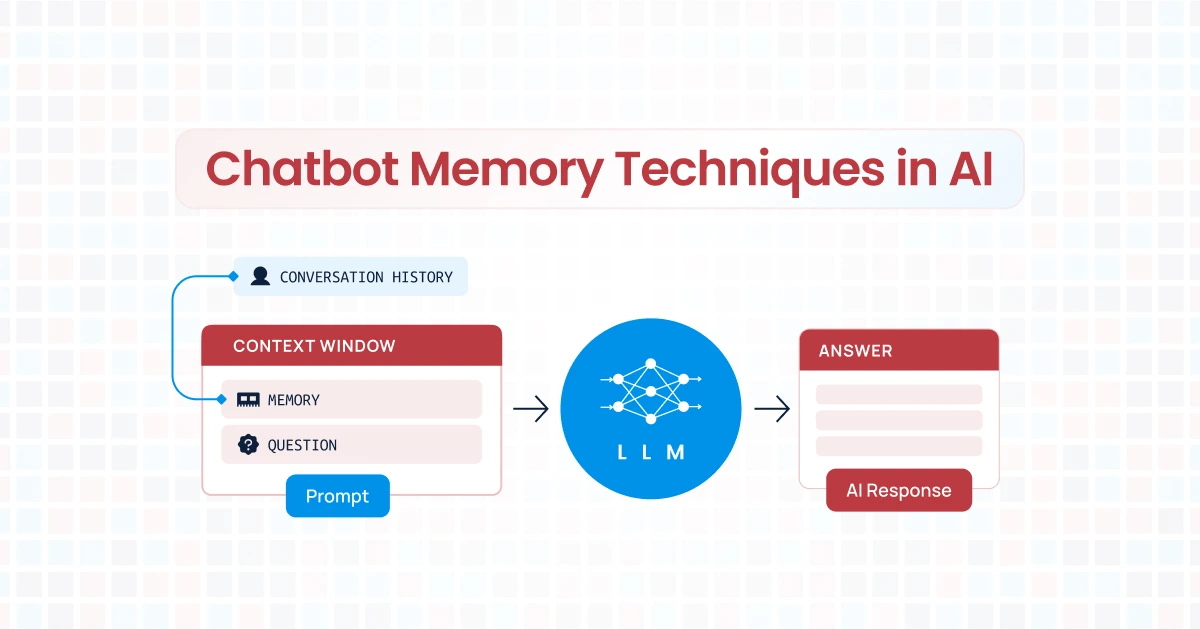
この2つ目の図は、ユーザーから見えるループを表しています。履歴、保存されたメモリ、新しい質問がプロンプトに組み立てられ、モデルが回答します。ベクトル検索は、ウィンドウを集中させるために、どのメモリをそのプロンプトに含めるべきかを判断します。
ステップ1:エージェントを開き、成果を明確にする 仕事に適した専門家、たとえば調査、コード、旅行、チュータリングを選び、「完了」がどのような状態かを伝えます。最初のメッセージも、その後のすべてと同様に埋め込みになります。
「検索拡張生成に関する系統的レビューを執筆しています。2024年以降の調査を優先し、ベンダーブログは除外し、IEEE引用スタイルを維持してください。」
ステップ2:モデルが信頼すべき知識を添付する ブリーフ、PDF、メモ、仕様書をアップロードします。これらの文書はセマンティック検索用にインデックス化されるため、後の質問では意味に基づいて該当する文章を取得できます。これは、企業が現在RAGインフラストラクチャとして資金を投じているのと同じパターンですが、インデックスを自ら運用する必要はありません。
「添付した文献マトリクスを使用してください。論文が除外済みとマークされている場合は、再度引用しないでください。」
ステップ3:セッションをまたいで作業を続ける ノートPCを閉じ、翌日にフォローアップを尋ねます。永続メモリと無制限の履歴により、エージェントは見知らぬ相手のように応答するのではなく、レビューの範囲、除外リスト、最後のアウトライン見出しを取得します。
「制約のセクションから続け、考察用に選んだ3本の論文を取り出してください。」
ステップ4:再説明せずにデバイスを切り替える iOSまたはAndroidで同じスレッドを開きます。設定と履歴は同期されます。通勤中のプロンプトでも、デスクでのセッションと同じベクトルを取得できます。これこそがベクトルメモリAIチャットの目的です。デバイスごとに新しいチャットサイロを作ることではなく、継続性を実現することです。
「大学へ向かう途中です。昨日挙げた3つのRAG失敗モードについて出題してください。」
結果とユースケース
ベクトルメモリの価値は、ベンチマークチャートではなく、繰り返さずに済んだ時間として現れます。これらのシナリオは、チャットが意味を取得するようになったときに起こる典型的な変化です。
📊 数週間にわたる文献統合
シナリオ: 大学院生がRAGの堅牢性に関する論文の引用付き概観を必要としており、新しいプレプリントが公開されるたびに数日ごとに更新したいと考えています。
従来のアプローチ: PDFのフォルダ、メモ用のスプレッドシート、そして除外リストを忘れるチャットボット。セッションごとに要件を再度貼り付ける必要があります。同じ資料を二重に引用したり、矛盾を見逃したりしやすくなります。
Deep Research: 課題、除外条件、作業中のアウトラインが永続化されます。新しい実行では過去の統合結果を取得するため、レポートは枝分かれせずに成長します。
- 引用が前のセクションと整合し続ける
- 除外した情報源は除外されたままになる
- フォローアップは初回検索よりも低コストになる
💼 スプリントをまたぐPythonサービス
シナリオ: 固定されたOpenAPI仕様、不安定だと判明しているテスト、Python 3.11でのデプロイ制約を持つFastAPIサービスを構築しています。
従来のアプローチ: 新しいチャットごとに異なるフォルダ構成が作り出されます。モデルに見えない決定を説明し直すだけで、最初の10分を費やします。
Python Coding Assistant: アーキテクチャメモと仕様がメモリと添付ファイルに保存されます。木曜日のバグレポートでは、水曜日の制約リストが取得されます。
- 矛盾するリファクタリングが減る
- デバッグを実際のスタックから始められる
- 将来の自分、またはスレッドを読むチームメイトのオンボーディングが速くなる
🎭 矛盾してはならないキャンペーン
シナリオ: 名前のあるNPC、パーティーがまだ知らない秘密、セッション1ですでに設定したトーンを含む週次ゲームを進行しています。
従来のアプローチ: セッションメモは別のアプリにあり、チャットボットは過去の約束を取得できないため、新たな悪役を無理やり登場させます。
Roleplay Game Master: 物語の状態そのものがメモリです。プレイヤーが3セッション前の何気ない詳細を引き合いに出したとき、検索によってそれをシーンへ戻せます。
- キャラクターの声が安定する
- プロット上の約束を検索できる状態で保てる
- 長期的な物語が一貫する
📱 空港の列から行う旅行計画
シナリオ: デスクで3都市を巡る旅行を計画しました。予算上限、徒歩中心の日程、夜行便なしという条件があります。搭乗口では、明日だけを天候に合わせて組み直す必要があります。
従来のアプローチ: 自分のメモをスクリーンショットで確認し、モバイルのチャットボットが一度も見たことのない制約を推測してくれることを期待します。
Travel Planning Advisor: 設定と旅程はすでにメモリにあります。スマートフォンからのプロンプトでそれらを取得し、旅行全体を作り直すことなく1日だけ変更できます。
- デバイスを切り替えても制約が維持される
- 現地でのフォローアップも予算内に収まる
- 搭乗ブリッジで要件を入力し直す必要がない
実際の利用を見れば、企業のベクトルデータベース導入者が費用を支払っているものと同じパターンが見えます。大きなチャットボックスではなく、リアルタイムの質問に対する低レイテンシのセマンティック検索です。
FAQ
ベクトルメモリAIチャットとは何ですか?
ベクトルメモリAIチャットは、メッセージ、ファイル、事実を埋め込みとして保存し、質問時に最も近い一致を取得します。これらの一致はモデルのコンテキストウィンドウに挿入されるため、回答は履歴と文書を活用できます。Jenovaでは、この検索は自身で管理する別個のデータベースとしてではなく、専門エージェントに組み込まれています。
JenovaはベクトルメモリAIチャットを無料で利用できますか?
はい。無料プランには、月間利用量に制限のある基本機能が含まれます。有料プランでは利用可能量が増え、カスタムモデルの選択などのオプションが追加されます。利用量は請求日にリセットされ、日ごとの小分けではなく、初日から全利用枠を使用できます。
「メモリを保存する」チャットボットとは何が異なりますか?
多くの製品は、短い事実のリストや更新され続けるトランスクリプトを保存します。ベクトルメモリは、無制限の履歴と添付知識全体にわたってセマンティックな類似性で取得を行うため、付箋よりもRAGに近い仕組みです。エージェントの本番長期メモリに関する独立した研究では、スケーラブルなメモリを設定画面のトグルではなく、独自のシステム課題として扱っています。OpenAIもChatGPTが過去のチャット文脈を参照する機能を拡張しました。アーキテクチャ上の問題は、メモリがベンダーのサイロなのか、実行するすべてのワークフローを支えるインフラストラクチャなのかという点です。
自分の文書を根拠としてチャットに使えますか?
はい。仕様書、シラバス、トランスクリプト、ブランドガイドなど、モデルの事前知識より優先すべきファイルを添付してください。関連する質問をすると、検索はそのコーパスを優先します。これはプライベートな資料に関するハルシネーションを減らす方法です。Writing Assistant は文体のためにそれらのサンプルを継続して利用でき、調査エージェントは主張の根拠として使い続けられます。
ベクトルメモリAIチャットはモバイルでも使えますか?
はい。ウェブ、iOS、Androidで履歴、設定、メモリが共有されます。入力できない状況では音声テキスト変換も利用できます。上記の旅行シナリオこそ、想定された設計です。デスクで構築した同じベクトルをスマートフォンから取得できます。
メモリを備えたエージェントは、センシティブな話題にも十分正確ですか?
メモリは一貫性を高めますが、モデルを無謬にするものではありません。RAGに関する調査では、検索品質、ノイズの多い文脈、忠実性が依然として未解決の課題として指摘されています(Sharma, 2025)。健康、法律、金融に関する意思決定では、エージェントを補助として扱い、一次情報源で検証してください。Personal Therapist は、保持してほしいと依頼したテーマを記憶できます。これは継続性には役立ちますが、資格を持つ専門家によるケアの代替ではありません。
ベクトルメモリは、ついに積み上がるチャットインターフェース
ステートレスなAIチャットは、自分自身を説明するために費やした時間という、唯一希少な入力を浪費します。ベクトルメモリAIチャットは意味を埋め込みとして保存し、必要に応じて取得し、専門エージェントが作業を継続できるようにします。この検索レイヤーの市場が拡大しているのは、その苦痛が普遍的だからです。本番システムにおけるセマンティック検索から、ユーザーに帰属すべき個人文脈まで、その必要性は共通しています。
Jenova は、ベクトルデータベースの運用を求めることなく、調査、コード、物語、計画のすべてにこのメモリを組み込みます。Deep Researchのレポート、Pythonサービス、またはロールプレイキャンペーンを、エージェントがずっとその場にいたかのように継続できます。
Jenovaでエージェントライブラリ全体をご覧ください。
開発者向け: この記事で紹介したすべてのエージェントは、Jenova APIを通じてプログラムから利用できます。単一の統合で、ベクトルメモリ、検索、マルチモデルエージェントをアプリケーションに組み込めます。完全なドキュメント →