AI Reddit検索MCPサーバー:ソーシャルデータをインテリジェンスに変える
2025-08-08
Reddit検索MCPサーバーは、Redditの膨大な会話アーカイブを、AIエージェントのための構造化されたクエリ可能なデータベースに変換します。Redditは10万以上のアクティブなコミュニティをホストし、事実上すべてのトピックに関する本物の議論が行われていますが、この宝の山へのアクセスは、自動化システムにとってはこれまで非常に困難でした。
Model Context Protocol (MCP)とのこの画期的な統合は、以下を提供します:
✅ 10万以上のサブレディットを横断する自然言語検索 ✅ 文脈を理解するインテリジェントな意図検出 ✅ 関連性、時間、エンゲージメントによる多次元フィルタリング ✅ AIエージェントと開発者のための構造化データアクセス
これがなぜ重要なのかを理解するために、Redditの非構造化データから意味のある洞察を抽出しようとする人が直面する課題を見てみましょう。
クイックアンサー:Reddit検索MCPサーバーとは?
Reddit検索MCPサーバーは、Model Context Protocolを使用してRedditをインテリジェントエージェントのための構造化されたクエリ可能なデータベースに変換するAI搭載の統合です。 これにより、投稿、サブレディット、ユーザーを横断する自然言語検索が、自動的な意図検出とフィルタリング付きで可能になります。
主な機能:
- 自然言語クエリと自動関連性ソートによる投稿検索
- トピック、説明、またはメンバー数に基づくコミュニティの発見
- ユーザーアクティビティと影響パターンの分析
- 複雑な発見ワークフローのための複数の検索操作の連鎖
問題点:Redditの非構造化データの課題
Redditはインターネットで最も価値のあるデータソースの1つですが、効果的にアクセスするには大きな障害があります:
主な課題:
- 曖昧な意図 – 一般的なクエリは無関係な結果を返す
- 複雑な階層 – 投稿、サブレディット、メタデータをナビゲートするには専門知識が必要
- AIネイティブなインターフェースがない – カスタムAPIラッパーは脆弱で維持が困難
- 限定的な文脈理解 – 従来の検索では「現在トレンド」と「今月最も議論された」を区別できない
- 断片化されたワークフロー – 研究者は複数の検索から手動で洞察を組み立てる必要がある
ユーザーの意図の曖昧さの解消
「AIハードウェアの最新情報」のようなクエリは、文脈によって全く異なる意味を持つ可能性があります。今日のトップ投稿を探していますか?今週最も議論されたスレッドですか?アップボートは少ないが高いエンゲージメントを持つ新たな会話ですか?
従来の検索バーには、これらの意図を区別するための文脈理解が欠けています。大規模言語モデルエージェントに関する研究によると、この曖昧さ解消の課題は、情報検索システムの根本的な限界を表しています。
Redditの複雑な構造のナビゲーション
効果的なReddit検索には、複数のレイヤーを理解する必要があります:
- 投稿メタデータ – アップボート、コメント、アワード、タイムスタンプ
- サブレディットの文脈 – コミュニティのルール、メンバー数、活動レベル
- ユーザーシグナル – カルマ、投稿履歴、コミュニティでの評判
- 時間的ダイナミクス – 異なる時間枠での「ホット」と「トップ」の違い
研究や分析のためにこの構造を手動でナビゲートするのは、時間がかかり、エラーが発生しやすいです。
統合のギャップ
AIエージェントにとって、Redditとの対話は通常、次のようなカスタムビルドのAPIラッパーを必要としました:
- RedditのAPIが進化するにつれて維持が困難
- 複数のユースケースにわたってスケールすることが不可能
- エージェント間の通信のための標準化が欠如
- 自然言語で複雑なクエリを表現できない
Reddit検索MCPサーバーは、これらの問題を解決するために特別に設計されました。
AIソリューション:MCPによる構造化アクセス
Reddit検索MCPサーバーは、MCP互換のどのエージェントでもRedditを正確にクエリできる、標準化されたインテリジェントなインターフェースを提供します。
| 従来のReddit検索 | Reddit検索MCPサーバー |
|---|---|
| キーワードマッチングのみ | 自然言語理解 |
| 手動フィルター選択 | 自動意図検出 |
| 断片的な結果 | 構造化されたリッチデータ |
| カスタムAPI統合 | ユニバーサルMCPプロトコル |
| 限定的な文脈 | 多次元フィルタリング |
アーキテクチャ:3つのコア検索ツール
サーバーは、特定の検索ベクトルごとに設計された3つの専門ツールを公開しています:
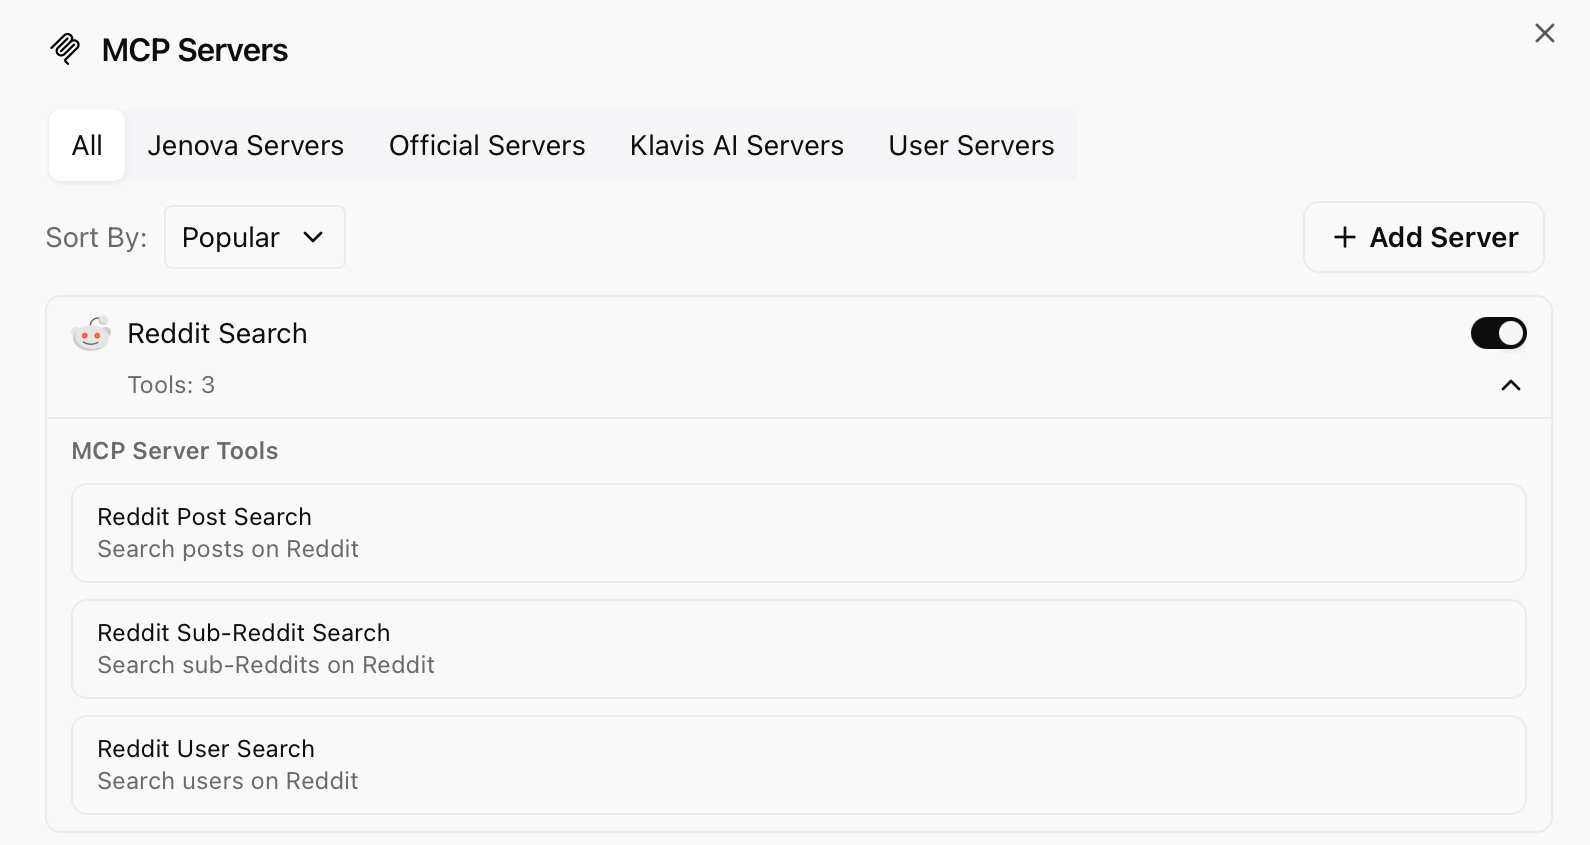
Reddit投稿検索
この主要なツールにより、エージェントは自然言語を使用して個々の投稿を検索できます。システムはユーザーの意図をインテリジェントに解釈し、関連するフィルターを自動的に適用します:
- ソートオプション:
hot,new,top,relevance - 時間フィルター: 1時間、1日、1週間、1ヶ月、1年、全期間
- エンゲージメント指標: アップボート、コメント、アワード
- サブレディットターゲティング: 特定のコミュニティ内またはReddit全体で検索
Redditサブレディット検索
以下に基づいてコミュニティ全体を発見します:
- トピックのキーワードと説明
- メンバー数と活動レベル
- コミュニティの焦点とルール
- 関連するサブレディットネットワーク
これにより、特定の会話がどこで行われているか、どのコミュニティがあなたの研究に最も関連しているかをより広範に分析できます。
Redditユーザー検索
特定のユーザーアクティビティや影響の分析が必要なアプリケーション向け:
- ユーザー名でユーザーを検索
- 公開されている活動履歴を取得
- 投稿パターンとエンゲージメントを分析
- 影響力のあるコミュニティメンバーを特定
インテリジェントなクエリ連鎖
マルチツールアーキテクチャにより、Reddit検索MCPサーバーは複雑な発見ワークフローのためにコマンドを連鎖させることができます。
ワークフロー例:
- サブレディット検索を使用して「量子コンピューティング」に関連するトップ5のコミュニティを特定
- 投稿検索を使用して、過去1週間に各コミュニティで最もアップボートされた投稿を検索
- ユーザー検索を使用して、それらの議論で最もアクティブな貢献者を特定
- すべてのデータポイントにわたる洞察を統合
このレベルのオーケストレーションは、以前は広範なカスタム開発なしでは不可能でした。
仕組み:自然言語から構造化データへ
Reddit検索MCPサーバーは、MCPエコシステムのために構築された初のAIエージェントプラットフォームであるJenovaを通じて独占的に利用可能です。この統合がReddit検索をどのように変革するかを以下に示します:
ステップ1:自然言語クエリ
ユーザーは平易な英語で質問します:「Redditの人々は新しいGPT-5のアップデートについて何を言っていますか?」クエリ構文を学んだり、手動でフィルターを選択したりする必要はありません。
ステップ2:意図検出とツール選択
Jenovaのオーケストレーションエンジンがクエリを分析して意図を理解します。ユーザーは最近の議論を探していますか?高評価の投稿ですか?新たな会話ですか?システムは自動的にReddit投稿検索ツールを選択し、適切なフィルターを適用します。
ステップ3:インテリジェントなフィルタリング
検出された意図に基づき、AIは多次元フィルターを適用します:
- 「最新の映画予告編に関するホットな意見」 → エンターテイメント関連のサブレディットでコメント対アップボート比率が高い投稿を優先
- 「最近のハードウェア発表の要約」 → 技術中心のコミュニティで高評価で有益な投稿を検索
- 「気候政策に関する新たな議論」 → 関連するサブレディットでエンゲージメントが伸びている新しい投稿を検索
ステップ4:リッチコンテンツのレンダリング
Jenovaはリンクを返すだけではありません。テキスト、画像、動画を含むRedditコンテンツをインターフェース内で直接レンダリングします。これにより、コンテキストを切り替えることなく、流れるようなリサーチ体験が生まれます。

ステップ5:反復的な絞り込み
ユーザーは会話形式で検索を絞り込むことができます:「このような投稿をもっと見せて」や「このスレッドのトップコメントは何ですか?」システムは会話全体で文脈を維持します。
実世界での応用とユースケース
📊 市場調査と競合情報
シナリオ: プロダクトマネージャーが、競合他社の最近のローンチに対する顧客の感情を理解する必要がある。
従来のアプローチ: Redditを手動で検索し、数十のスレッドを読み、メモを取り、調査結果をまとめる。所要時間:4〜6時間。
Reddit検索MCPサーバー: 自然言語クエリが、感情分析、主要テーマ、影響力のある声を含むトップディスカッションを返す。所要時間:15分。
主な利点:
- 新たな問題点が広まる前に特定
- 時間の経過とともに感情のトレンドを追跡
- ターゲットコミュニティで満たされていないニーズを発見
💼 ブランド管理のためのソーシャルリスニング
シナリオ: コミュニケーションチームが、Redditの多様なコミュニティ全体でブランドの言及を監視する必要がある。
従来のアプローチ: キーワードアラートを設定し、各言及を手動で確認し、感情と緊急性で分類する。
Reddit検索MCPサーバー: インテリジェントなフィルタリングを備えた自動監視により、対応が必要な優先度の高い言及が浮かび上がる。
主な利点:
- ブランド危機に対するリアルタイムアラート
- ブランドの支持者と批判者を特定
- コミュニティ全体でのキャンペーン効果を追跡
📱 コンテンツ発見とトレンド分析
シナリオ: コンテンツクリエーターが、ニッチな分野でトレンドになっているトピックが主流になる前に特定したい。
従来のアプローチ: 毎日複数のサブレディットを閲覧し、アップボートのパターンを手動で追跡し、新たなトレンドを推測する。
Reddit検索MCPサーバー: ターゲットコミュニティでエンゲージメント速度が高い投稿を、新着順にクエリする。
主な利点:
- トレンドがピークに達する24〜48時間前に発見
- ニッチな分野のコンテンツギャップを特定
- 特定のオーディエンスに何が響くかを理解
🎯 学術研究とデータ収集
シナリオ: オンラインコミュニティを研究する研究者が、議論のパターンを収集・分析する必要がある。
従来のアプローチ: カスタムスクリプトでRedditのAPIを使用し、データを手動でクリーンアップ・構造化し、分析を実行する。
Reddit検索MCPサーバー: 組み込みのフィルタリングを備えた構造化データアクセスにより、即時分析が可能。
主な利点:
- 再現可能な研究ワークフロー
- 研究全体で標準化されたデータ収集
- MCPを介した分析ツールとの統合
MCPの利点:信頼性とスケーラビリティ
JenovaとReddit検索MCPサーバーの緊密な統合は、Model Context Protocol標準の力を示しています。
Jenovaは、Reddit MCPサーバーが提供する専門ツールを活用するインテリジェントなクライアントとして機能します。このクライアントサーバー関係はMCPの核となる原則であり、以下を可能にします:
- 信頼性: Jenovaのマルチエージェントアーキテクチャは97.3%のツールコール信頼性率を達成し、複雑なマルチステップクエリが完璧に実行されることを保証します
- スケーラビリティ: 標準化されたプロトコルにより、同じエージェントがカスタム統合なしで複数のMCPサーバーと対話できます
- 保守性: RedditのAPIの更新は、すべてのクライアントアプリケーションではなく、サーバーレベルで処理されます
- 構成可能性: エージェントは、洗練されたワークフローのために複数のMCPサーバーにわたる操作を連鎖させることができます
このアーキテクチャは、モノリシックなシステムからモジュール式のプロトコル駆動型AIインフラストラクチャへの根本的な転換を表しています。
よくある質問
Reddit検索MCPサーバーはRedditのネイティブ検索とどう違いますか?
Reddit検索MCPサーバーは、AIエージェント向けに設計された自然言語理解、自動意図検出、構造化データアクセスを提供します。Redditのネイティブ検索は手動でのフィルター選択が必要で、非構造化された結果を返します。MCPサーバーはまた、Model Context Protocolを通じて複雑なクエリ連鎖や他のAIツールとの統合を可能にします。
Reddit検索MCPサーバーは無料で使用できますか?
Reddit検索MCPサーバーは、無料および有料プランを提供するJenovaを通じて利用できます。無料プランのユーザーは、Reddit検索MCPサーバーを含むすべてのコア機能に、毎日の使用制限付きで完全にアクセスできます。有料の加入者は、大幅に高い使用制限を受けられます。具体的な価格の詳細については、www.jenova.aiをご覧ください。
Reddit検索MCPサーバーを商用アプリケーションに使用できますか?
はい、サーバーは市場調査、ブランドモニタリング、コンテンツ発見、学術研究など、個人および商用の両方のユースケース向けに設計されています。商用ユーザーは通常、より高い使用制限のためにJenovaの有料プランを利用するメリットがあります。
Reddit検索MCPサーバーはモバイルデバイスで動作しますか?
はい、Jenovaのインターフェースは完全にレスポンシブで、モバイルデバイスに最適化されています。スマートフォンやタブレットで自然言語のReddit検索を実行し、リッチコンテンツのレンダリングを表示できます。
意図検出の精度はどのくらいですか?
システムは高度な言語モデルを活用して、クエリの意図を高精度で解釈します。Jenovaのマルチエージェントアーキテクチャは97.3%のツールコール信頼性率を達成し、クエリが正しく解釈・実行されることを保証します。ユーザーは、初期結果が意図と一致しない場合に会話形式で検索を絞り込むこともできます。
Reddit検索MCPサーバーはどのデータにアクセスしますか?
サーバーは、公式APIを通じて公開されているRedditデータにのみアクセスします。Redditの利用規約を尊重し、プライベートメッセージ、削除されたコンテンツ、または公開されている範囲を超えるユーザーデータにはアクセスしません。Jenovaはユーザーデータとプライバシーに非常に厳格であり、モデルのトレーニングにユーザーデータを使用しません。
結論:AI駆動のソーシャルインテリジェンスの未来
Reddit検索MCPサーバーは、新しい検索ツール以上のものを表しています。それはAI駆動のデータインタラクションの未来の概念実証です。Redditの広大で非構造化されたデータの上に標準化されたインテリジェントなレイヤーを置くことで、Model Context ProtocolはAIエージェントが前例のないニュアンスでソーシャルな会話を認識し、理解することを可能にします。
より多くのサービスが専用のMCPサーバーを通じてアクセス可能になるにつれて、Jenovaのようなエージェントの能力は指数関数的に増大します。私たちは、エージェントがソーシャルメディアや学術論文の検索から、カレンダーの管理やメールの送信まで、数十のサービスにわたるタスクをシームレスにオーケストレーションする未来に向かっています。これらすべてが、ユニバーサルで信頼性の高いプロトコルを通じて行われます。
手動でのRedditブラウジングから、インテリジェントなAI搭載のソーシャルリスニングへの変革は今や完了しました。市場調査、ブランド感情のモニタリング、コンテンツトレンドの発見、オンラインコミュニティの分析など、Reddit検索MCPサーバーを試して、次世代のソーシャルデータインテリジェンスを体験してください。
参考文献
- Model Context Protocol. (2024). Official MCP Documentation. Retrieved from https://modelcontext.org/
- Reddit, Inc. (2024). Reddit - Dive into anything. Retrieved from https://www.reddit.com
- arXiv. (2024). A Survey on Large Language Model based Autonomous Agents. Retrieved from https://arxiv.org/abs/2308.11432