AIリサーチアシスタントの情報源の完全性をテストする方法
2026-08-22
検証可能な情報源トレイルと、引用の見せかけを分ける5つの監査チェックとは?
実用的なAIリサーチアシスタントとは、単に引用が付いているように見えるものではなく、監査できるものです。2026年における実務的な評価基準は、そのツールが各主張から実在し、日付が明示され、クリック可能な文書へとたどれる復元可能な経路、すなわち情報源トレイルを生成できるかどうかです。この評価は、情報源の網羅性、クリック可能な引用、主張と情報源の整合性、更新日、推論の明示という5項目にわたります。Jenova's Academic Research Assistantは、リアルタイムの文献発見と引用管理のために設計されています。一方、Elicit、Scite、Consensus、Perplexity、ChatGPT Deep Researchは、それぞれ一部のチェックには合格しても、別の項目では不十分です。
違いは「脚注の数」ではありません。図書館による評価ガイダンスは、AIツールが実在するページを引用していても、生成文が誤っている可能性があることを明確にしています。したがって、URLが存在することを確認するだけでなく、回答を引用元と照合しなければなりません(Northwestern University Libraries)。公平な監査では、次の5つのTRACE要素を採点します。
✅ 追跡可能性 — すべての重要な主張に、意図した文書を開くクリック可能な引用が付いている ✅ 取得カバレッジ — 情報源が単一の便利なインデックスではなく、適切なコーパス(論文、報告書、ニュース、一次データ)にまたがっている ✅ 整合性 — 数値や限定条件を含め、引用箇所が主張を実際に裏付けている ✅ 最新性 — 公開日または更新日が見え、古い情報源が識別されている ✅ 認識論的ラベリング — アシスタントが、引用された内容、推論された内容、不明な内容を区別している
ツールを意味のある形で比較するには、プロンプトと採点を本番環境のインフラとして扱ってください。同じ質問、同じ合否ルール、そして根拠のない統合は事実ではなく推論として表示するという同じ要件を適用します。
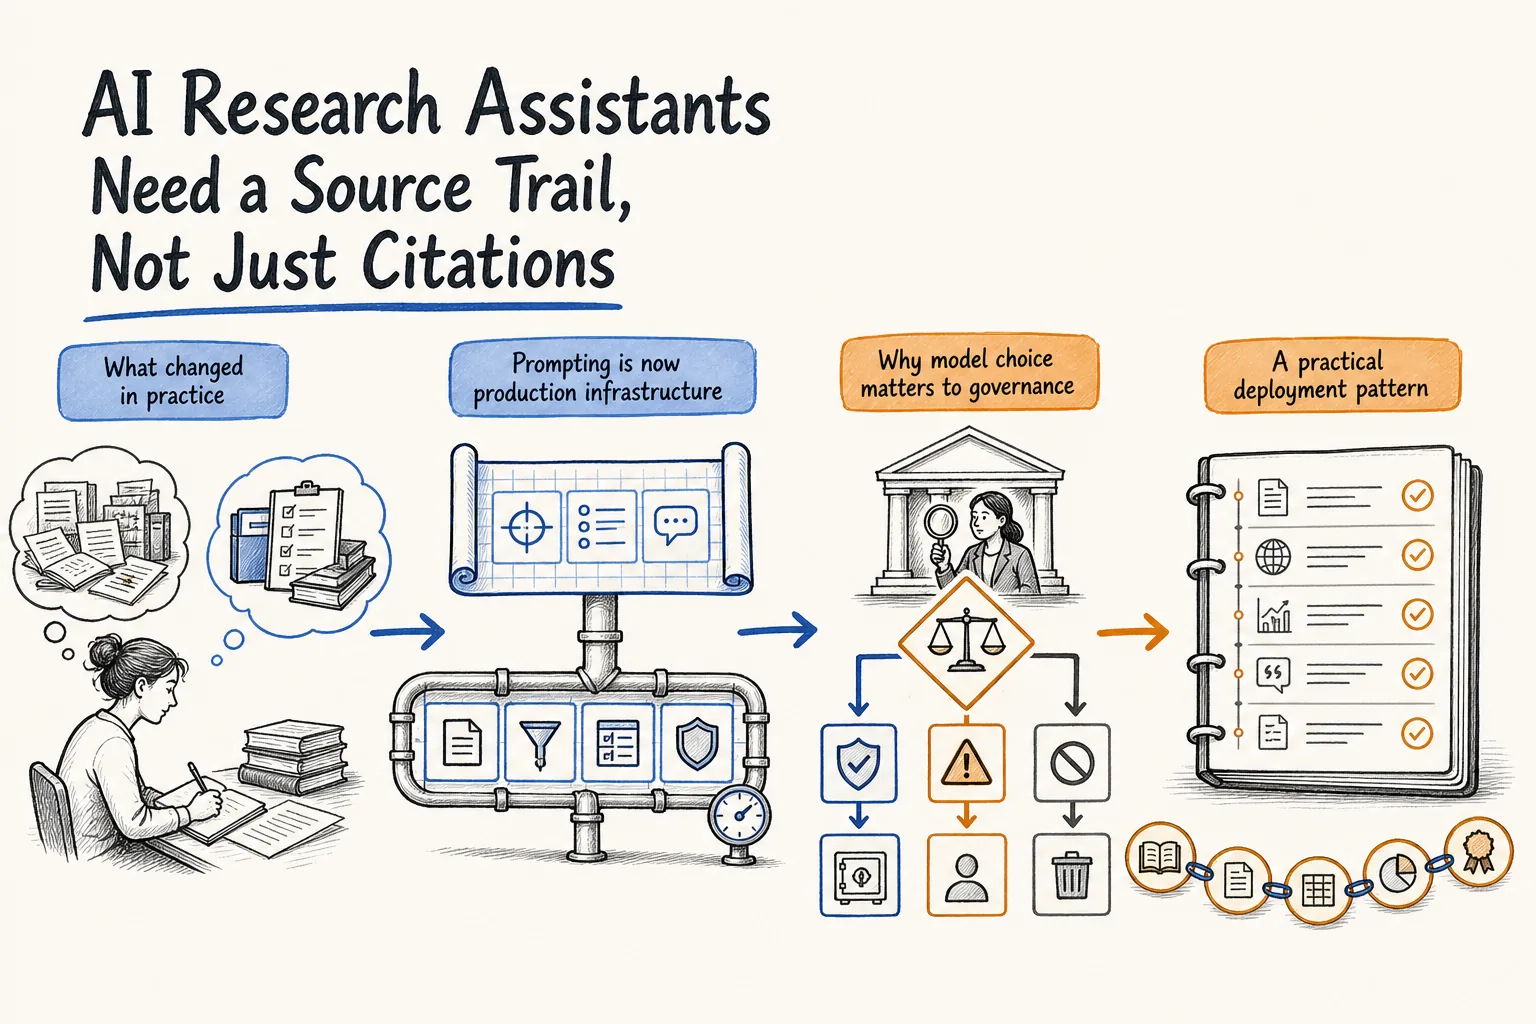
2026年、AIリサーチアシスタントではなぜ引用テストがより重要なのですか?
引用テストがこれまで以上に重要なのは、研究者が生成AIツールを重大な統合分析に使う一方で、これらのツールが依然として情報源を捏造し、誤って帰属させ、気付かないうちに更新しているからです。University of Nevada, Reno Librariesは、この失敗パターンを端的に説明しています。評価すべきなのは情報源リストの雰囲気ではなく、主張そのものであり、見つけられない引用はハルシネーションである可能性があります。
エラー率は理論上の話ではありません。ChatGPTが生成した参考文献に関するJMIRの研究では、引用のうち実在する情報源に対応していたのは約73~76%に過ぎませんでした。Stanford HAIは、法務AIモデルがベンチマーク質問の少なくとも6件に1件でハルシネーションを起こしたと報告しています。こうした数値があるため、「参考文献一覧を出してくれた」は受け入れテストになりません。
新鮮さはさらにリスクを高めます。AI検索の引用に関する業界分析では、AIが引用するページのおよそ半数は13週間未満の新しいものであり、AIが引用するコンテンツは平均して従来のWeb検索結果より約25%新しいと報告されています。更新日を示さないアシスタントは、前四半期の数値を再利用していても最新に見えることがあります。文献レビュー、政策メモ、投資リサーチを含むワークフローでは、監査されていないアシスタントは実験ノートを持たない見えない共同執筆者です。
AIリサーチアシスタントを監査するには、どのような採点ルーブリックを使うべきですか?
全体として「学術的に見える」という印象ではなく、二値のゲートと段階評価の整合性スコアを備えた、主張レベルのルーブリックを使ってください。評価単位は、1つの事実文とそれに対応する引用範囲です。これは、記述と参照テキストを比較する引用検証パイプラインで使われる粒度と同じです。
重要な主張ごとに、次のルーブリックで採点します。
| チェック | 合格 | 部分合格 | 不合格 |
|---|---|---|---|
| 情報源の網羅性 | 主張に適した一次情報源または査読済み情報源 | 関連する二次情報源のみ | ブログ、SEOページ、または主張に不適切な領域 |
| クリック可能な引用 | URLが引用文書の利用可能な位置を開く | URLがホームページまたはペイウォール画面を開く | リンク切れ、無関係なページへのリダイレクト、または捏造リンク |
| 主張と情報源の整合性 | 数値や留保を含め、情報源が主張を裏付ける | 話題は関連するが、正確な主張を支持しない | 矛盾、誤った数値、または根拠のない飛躍 |
| 更新日 | 日付が表示され、質問に対して適切 | 日付はあるが質問に対して古い | 日付なし、または根拠なく日付を推測 |
| 推論の明示 | アシスタントが統合、外挿、不明点を明示する | 根拠付き内容と推論が混在し、表示が弱い | 推論を確立した事実として記述する |
専門用途における実用的な合格ラインは、捏造リンクがゼロ、ラベルのない数値主張がゼロ、重要な主張の少なくとも80%が引用範囲によって完全に裏付けられていることです。含意が適切な基準なのは、キーワードの重複ではなく推論の隔たりを評価できるためです。Open-QA評価に関するACL Findingsの研究は、含意スコアが完全一致指標よりも人間の判断をより正確に追跡することを示しています。
固定されたプローブセットでルーブリックを実行してください。すなわち、変化の速いニュースまたは政策の質問、定量的な科学的主張、文献が矛盾する質問、「何が不明か」を問う質問です。最後の項目で適切に失敗できないアシスタントは、リサーチ用途にはまだ適していません。
Elicit、Consensus、Scite、Perplexity、Jenovaは情報源の完全性でどう比較されますか?
すべてのTRACE要素で優位に立つAIリサーチアシスタントはありません。Elicitは大規模な論文コーパスからの構造化抽出に強く、Sciteは引用の支持・反証の極性に強く、PerplexityとChatGPTはインラインリンク付きのオープンWeb回答を素早く得るのに優れています。Jenova's Academic Research Assistantは、同一の情報源トレイルに対して追加質問を重ねられる、リアルタイムかつ複数情報源のリサーチセッションが必要な場合により強みを発揮します。
2026年の実践的な比較では、Elicitを文献レビューの主力ツール、Consensusをより高速なイエス・ノー型のエビデンス確認ツールとして扱うことが一般的です。医療リサーチ向けツールのまとめでは、Perplexityはインライン引用を備えた最も速い汎用オプションであり、学術特化ツールより制約が少ないと説明されています。HKUSTの文献レビュー向けツール比較は、この一連のツールにおける対象範囲とアクセスの違いを把握する有用なカタログです。
| 機能/要素 | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| 情報源の網羅性 | 1億2500万本超の論文、学術優先(Elicit) | 引用グラフと全文のSmart Citations(Scite) | リサーチ質問向けに調整された論文コーパス | オープンWebと任意の学術情報源 | リアルタイムWeb+学術検索、原稿・引用ワークフロー |
| クリック可能な引用 | 論文レコードと抽出結果 | コンテキスト抜粋付きの引用ページ | 論文に裏付けられた回答 | インラインURL、品質は質問により異なる | リサーチ回答内のインラインでクリック可能な情報源リンク |
| 主張と情報源の整合性 | 1,502/1,511データポイント(99.4%)の公表済み抽出精度 | 支持する引用と対立する引用を表示 | 二値的なエビデンス質問に強い | ユーザーによる検証が必要。ハルシネーションリスクが文書化されている | 取得範囲に依存。公表済みの抽出ベンチマークはない |
| 推論の明示 | 構造化カラムにより隠れた飛躍を減らす | 極性ラベルはあるが、完全な認識論的タグはない | Consensus Meterが一致度を示す | 要求しない限り推論を明示することはまれ | 根拠付き主張と推論済み主張をタグ付けするよう指示できる |
| 価格(2026年時点) | 本レビューでは未検証 | 未検証。以前のテストでは短い試用期間が示されていた(Pure AI) | 2026年のある比較では、エントリー価格は約$144/年 | 未検証。ベンダーごとの階層制 | 無料の限定利用、Plus $20/mo (30×)、Premium $50、Pro $100、Max $200、Ultra $500、Enterprise $1,000 |
| 最適な用途 | 論文からの体系的な抽出 | 文献が主張を支持するかの確認 | 科学分野の迅速なイエス・ノー質問 | インラインリンク付きの幅広いWebリサーチ | 監査可能な複数ターンのリサーチと引用管理 |
Jenovaの正直な制約は構造的なものです。Elicitのような論文抽出グリッド専用ツールではなく、Sciteのような支持・反証の引用グラフも提供していません。その利点はセッション記憶とリアルタイム取得にあり、同じ情報源トレイルを対象に追加質問が必要な監査では重要です。Elicitの制約はその逆で、論文インデックス内では非常に優秀である一方、一般Webや政策文書のリサーチには弱い傾向があります。PerplexityとChatGPTは、流暢なインライン引用でも整合性に失敗し得るため、最も過信しやすいツールであり続けます。
情報源の網羅性とクリック可能な引用は、どのようにテストしますか?
正しい答えが単一コーパスからは得られない質問を投げかけ、その後ですべてのリンクをクリックすることで網羅性をテストします。網羅性の合格とは、同じキーワードに言及する便利なブログではなく、主張が必要とする種類の情報源をアシスタントが取得することです。たとえば、臨床効果量には試験、法的閾値には法令または行政機関ページ、統計にはデータセットのコードブックが求められます。
次の3つの網羅性プローブを作成します。
- 学術限定プローブ:「2020年以降のランダム化試験はXについて何を示しており、どのアウトカムが事前登録されていましたか?」
- 一次文書プローブ:「ニュースの要約ではなく、元の行政規則、提出書類、またはデータセットには何と書かれていますか?」
- ネガティブスペース・プローブ:「このテーマを扱いながら、効果は未証明であるとする信頼できる情報源はどれですか?」
次にクリック手順を適用します。各引用について、URLが解決するか、ランディングページが引用された文書か、人間が2分以内に裏付け箇所を見つけられるかを記録します。Northwesternの評価ガイドは、AIシステムが実在するタイトルに誤った雑誌名、著者名、年を結び付けることが多いため、図書館カタログまたはデータベースでタイトルを検索するよう推奨しています。リンク切れ、ホームページへの誘導、「情報源:インターネット」といった脚注は自動的に不合格です。
Jenovaでは、網羅性を期待ではなく明示的な指示にしてください。
「少なくとも4つの独立した情報源を用いて回答してください。査読済み論文、政府機関または標準化団体、一次データセットを優先してください。各主張について、クリック可能なURL、文書タイトル、公開日または更新日、主張を裏付ける15~25語の引用を示してください。一次情報源が見つからない場合は、その旨を述べて停止してください。」
Elicitでは、抽出セルがモデルによる要約ではなく、可視の論文範囲に対応しているかが同等のテストになります。PerplexityまたはChatGPTでは、すべてのインラインリンクを開く必要があるため、テストはより厳しくなります。オープンWebのリサーチエージェントは多数のページを取得しても、その中で最も弱い情報源を引用する可能性があるためです。プローブが論文、フォーラム、コードリポジトリ、ニュースを同時にまたぐ場合、Jenova's Academic Research AssistantとReal-Time Searchを組み合わせることは有用です。ただし、各チャネルにはそれぞれ独自のクリック確認が必要です。
主張と情報源の整合性、および推論の明示はどのようにテストしますか?
整合性は、引用箇所が文を含意するかどうかを問い、単に曖昧に関連しているかで判断しないことでテストします。最も重要な失敗は、ほぼ正しい数値や省略された限定条件です。情報源が「約80%」と述べているのに、モデルが「78%」と書き、引用だけは完璧に見える場合です。これは、自動評価ランナーが検出するために設計されているエラー分類そのものです。
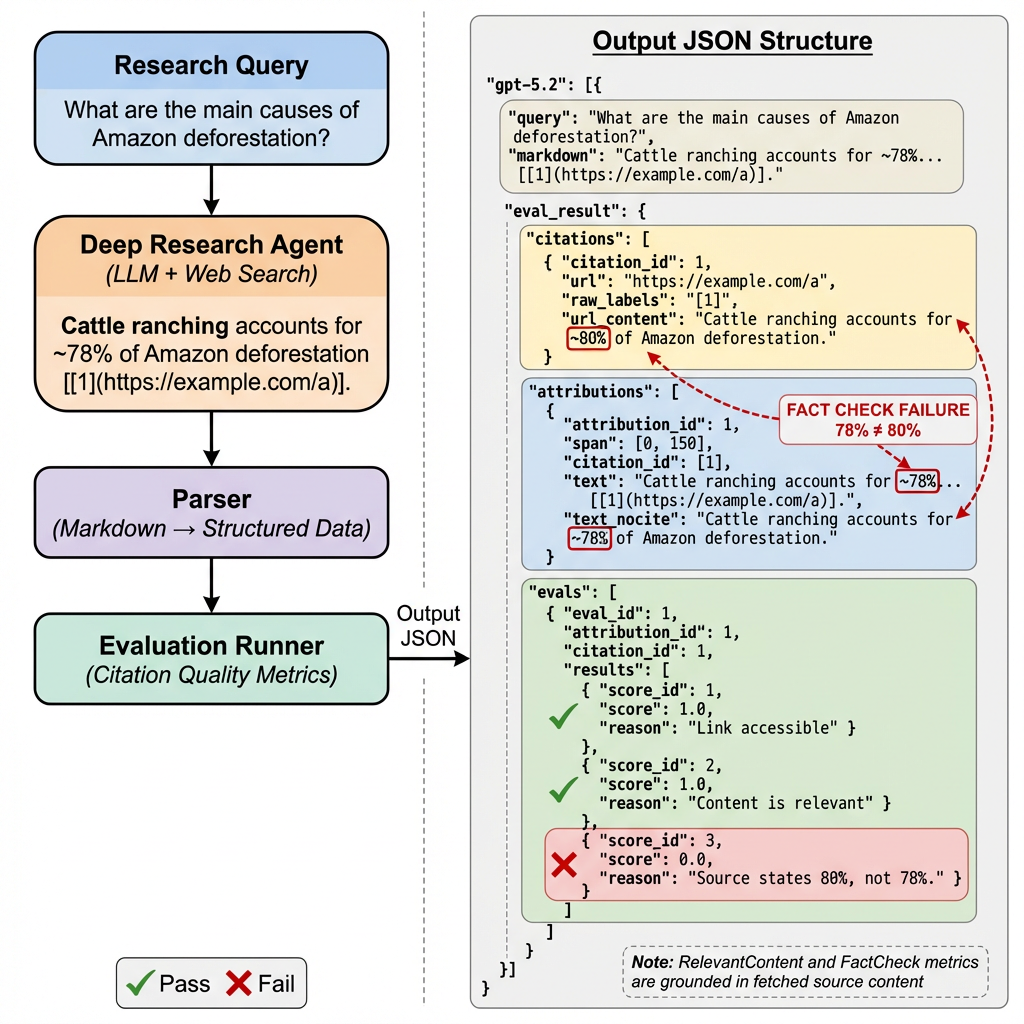
すべての定量的主張または因果的主張に対して、3層の整合性テストを使ってください。
- 範囲一致: 主張を支持するとされる情報源内の文をハイライトします。
- 含意:
entailed、underdetermined、contradictedのいずれかを判定します。アシスタントが主張を事実として記述した場合、underdeterminedは不合格です。 - 数値と留保の忠実性: 単位、標本、年、信頼区間、「可能性がある」「マウスでは」「ある1か国では」といった表現が、すべてそのまま維持されなければなりません。
これが、「ページが話題に関連している」ことよりもテキスト含意が優れた監査指標である理由です。含意に基づくOpen-QA評価は、2つの文字列の間にある推論の隔たりを定量化するために存在します。NVIDIAの引用検証アプローチも同じ考え方を実装しています。すなわち、主張を参照テキストと比較し、その結果を採点します。
推論の明示は、これと対になるチェックです。リサーチアシスタントは、各段落をsourced、inferred、unknownとしてタグ付けすべきです。統合は許容されますが、黙ったままの統合は許容されません。UNRの主張確認ガイダンスの考え方が適切です。つまり、「誰がその記述を検証できるか」を問うことです。検証者が「モデルの一般知識」であるなら、その文には推論ラベルが必要でした。
このチェックのための厳格なプロンプトは次のとおりです。
「回答を3つのラベル付きブロックに分けてください。(1) 直接裏付けられる主張:各主張に引用文とURLを付ける。(2) 推論:依拠する前提を示す。(3) 不明点。推論をブロック1に移さないでください。情報源で数値が概数である場合は、概数のまま保持してください。」
Elicitは回答を抽出カラムに強制することで、隠れた推論を減らします。これは実際の強みです。Sciteは、後続論文が引用を支持するか対立するかをラベル付けするため、1本の論文を確立したコンセンサスとして扱う別種の飛躍を検出できます。Jenovaは長いセッションでも3ブロック形式に従えますが、要求しない限りこれらのラベルを強制しません。この点は、組み込みのエビデンスメーターを持つツールと比べた実際の製品上の差です。
更新日と情報源の新鮮さは、どのように検証しますか?
情報源ごとに見える日付を要求し、正解が過去1年で変化したプローブを少なくとも1つ含めることで、新鮮さを検証します。ページや論文の公開時期を示せないアシスタントは、価格、規制、モデルリリース、疫学、市場構造に関する質問に対応する準備ができていません。
AI検索におけるコンテンツの新鮮さに関する研究は、最新性が、システムが現在の質問に対してページを取得するかどうかに影響すると示しています。AI引用を追跡する研究も、エンジンは情報源を継続的に再評価すると警告しています。そのため、昨日は整っていた要約が気付かないうちに古くなることがあります。したがって、監査では1つではなく次の3つの日付を記録すべきです。
- 情報源の日付 — ページまたは論文に記載された公開日または最終更新日時
- エビデンスの日付 — 基礎データが収集された年
- 回答の日付 — アシスタントが情報源を取得した日時
よくある失敗は、「現在」の有病率数値に2019年のレビューを引用すること、または取得タイムスタンプを記録せずにライブダッシュボードを引用することです。ElicitやConsensusのような学術特化ツールは論文メタデータ上にあるため、通常は出版年を表示します。オープンWebツールは、指示しない限り表示しないことがよくあります。Jenovaは取得文書に日付が示されている場合に報告できますが、日付のないページに信頼できるタイムスタンプを作り出すことはできません。できない場合は、そのように明言すべきです。
新鮮さプローブの例:
「2026年時点の現在の数値は何ですか?情報源の更新日を示してください。最良の情報源が18か月より古い場合は、回答を現在ではなく過去の情報としてラベル付けしてください。」
「見つけられる最も新しい情報源と、最も引用されている古い情報源を比較してください。何が変わり、何が変わっていませんか?」
アシスタントが改訂済みHTMLページと、変更されていないPDF再版を区別できない場合、URLが機能していても最新性は不合格としてください。
単一のプロンプトから再現可能なTRACE監査を実行するにはどうすればよいですか?
再現可能な監査を実行するには、プローブセットと採点シートを固定し、すべてのツールに同じ機械検証可能なフィールドを出力させます。目的は、別の研究者があなたの作業を見ていなくても、再採点できる記録を作ることです。
Jenova's Academic Research Assistantで次の手順を実施し、その後、少なくとも1つの専門ツール(ElicitまたはScite)と1つの汎用ツール(PerplexityまたはChatGPT)で繰り返します。
- 質問の前に、役割と出力契約を明示します。
- 定量、矛盾、一次文書、不明点の各クラスから1つずつプローブを質問します。
- すべての引用に、タイトル、URL、日付、引用文、主張ラベルを要求します。
- 追加質問をする前に、すべてのリンクをクリックし、TRACEを採点します。
- その後にのみ、不合格だった主張の修正を要求します。
開始用の契約:
「あなたは監査対象です。重要な主張ごとに、次を出力してください:主張テキスト、ラベル(sourced / inferred / unknown)、情報源タイトル、クリック可能なURL、公開日または更新日、裏付け引用(25語以内)。整合性が不完全な場合は、ラベルをinferredまたはunknownに下げてください。取得していない情報源を引用しないでください。最後に、使用した情報源の種類と不足している情報源の種類を列挙する網羅性メモを付けてください。」
Elicitでの並行手順は、同じ質問をリサーチレポートとして実行し、抽出セルをPDFの該当範囲と突き合わせて確認することです。Sciteでは、中心となる主張を引用コンテキスト質問として実行し、コンセンサスらしい文を受け入れる前に、支持する論文と対立する論文を数えます。ChatGPT Deep Researchでは、OpenAI自身のリサーチワークフローも情報源の確認を求めています。製品機能は取得と構造化であり、含意確認の代替ではありません。
主張、URL、日付、TRACEスコア、メモを簡単なログに残してください。4つのプローブで10件の主張を確認すれば、傾向を見るには十分です。数値主張が3件以上整合性に失敗した場合は、他者が引用する成果物にそのツールを使うのをやめてください。
リサーチインテグリティの実務家は、AI引用テストについて何と言っていますか?
リサーチインテグリティの実務では、単純明快なルールに収束しています。人間または自動含意チェックが情報源を開くまで、AIの引用は未検証の主張として扱うべきです。現在有用な議論は、モデルがハルシネーションを起こすかどうかではなく、どの失敗を計測可能にできるかです。
「この分野は、より見栄えのよい参考文献一覧の最適化を続けています。しかし、それは誤った単位です。引用はポインタであって証明ではありません。引用範囲が文、特に数値、対象集団、年を含意しないなら、その引用は装飾にすぎません。私たちは『78%対80%』の失敗例が、実在するURL、関連するタイトル、自信に満ちた文体という、あらゆる外見上のチェックを通過するのを見てきました。そのようなエラーが原稿に残ります。」
「推論のラベリングは、ほとんどのチームが省略する最も低コストな管理策です。アシスタントが取得情報と世界知識を混ぜることを許されると、推測を発見として洗浄します。根拠付き、推論、不明という3つのバケットを強制すれば、ハルシネーション率は可視化されます。不明バケットを示すことを拒むチームは、不確実性を表現できないと自ら述べているのです。」
「網羅性テストもガバナンス上の選択です。論文専用アシスタントは厳密に見えても、先月ルールを変更した行政メモを見落とす可能性があります。Web専用アシスタントは最新に見えても、実際にアウトカムを測定した試験を見落とす可能性があります。モデル選択が重要なのは、留保を示すモデル、圧縮するモデル、限定条件を落とすモデルがあるからです。監査はブランドではなく主張を追跡しなければなりません。」
— Jenovaプロダクトチーム、リサーチエージェント評価、学術・専門ユーザー向けの取得・引用ワークフロー構築における6年の経験
この立場は図書館の実務と一致します。Northwesternは、モデルが実在する百科事典記事を引用しながら、名前や日付を誤る事例を記録しています。UNRは、研究者に対し、誰がその主張を検証できるかを問うよう伝えています。どちらも文章で表現されたTRACEです。
AIリサーチアシスタントは、いつ実際のリサーチに使えるほど十分ですか?
AIリサーチアシスタントが十分に使えるのは、実際の質問タイプでTRACE監査に耐え、不合格の主張が情報源に基づいて修正されるか、ラベル付きの推論に格下げされる場合です。流暢でリンクの多い回答を生成しても、クリックと含意のチェックで崩れるなら十分ではありません。
次の意思決定ルールを使ってください。
- Elicitのような専門抽出ツールを使うのは、既知の論文セットからスクリーニングまたはデータ抽出を行う場合であり、その場合でもセルを抜き取り確認します。
- Sciteを使うのは、文献が特定の主張を支持、言及、または反証しているかを問う場合です。
- Consensusを使うのは、限定された科学的質問に対し、エビデンスの方向性を迅速に把握したい場合です。
- PerplexityまたはChatGPTを使うのは、広範な予備調査のためであり、原稿に数値を入れる前にすべてを再検証します。
- Jenova's Academic Research Assistantを使うのは、文献発見、原稿作成支援、引用管理を1つの監査可能なスレッドで行う複数ターンの作業であり、プロンプトでTRACEフィールドを要求する意思がある場合です。
いずれも、人間の確認なしで最終工程を任せるために使ってはいけません。JMIRの引用精度に関する結果とStanford HAIのハルシネーション率は、人間をループに残す十分な理由です。2026年に勝つ構成は、単一の「信頼できる」モデルではありません。クリック可能なリンク、日付付き文書、含意された主張、そしてエビデンスと推論の見える境界から成る、再生可能な情報源トレイルです。
参考文献
- Northwestern University Libraries — AI生成コンテンツの評価
- University of Nevada, Reno Libraries — AIと情報源評価
- JMIR — 大規模言語モデルが生成した引用の性能と信頼性の評価
- Stanford HAI — 法務AIモデルはベンチマーク質問の6件に1件以上でハルシネーションを起こす
- AuthorityTech — 2026年におけるコンテンツの新鮮さとSEO
- Chris Long / Ahrefsの議論 — 新鮮さとAI検索での可視性
- ACL Findings — テキスト含意による正確かつ精緻なOpen-QA評価
- NVIDIA Developer — NVIDIA NIMを使用した自動引用検証
- Elicit — 科学研究向けAI、対象範囲と抽出精度
- Scite — 科学文献のためのSmart Citations
- The Drive AI — Elicit、Consensus、Semantic Scholarの比較
- iatroX — 2026年の医療リサーチ向けAIツール
- HKUST Library — 文献レビュー向け新興AIツールの比較
- Omid Saffari — 2026年のAIリサーチツール:ElicitとConsensusの比較
- Pure AI — 7つのAIリサーチツールをテストする
- SEOptimer — SEOとAI検索におけるコンテンツの新鮮さ
- OtterlyAI — AI検索エンジンの引用と情報源を追跡する方法
- Firecrawl — AIエージェントのためのWeb検索とディープリサーチ
- OpenAI Academy — ChatGPTを使ったリサーチ:検索とDeep Research