家族と口論した後、AIで感情を記録しCBT思考チェックを行うには?
2026-08-20
診断を行わないAI感情ログは、メモアプリにできない何をしてくれるのか?
診断を行わないAI感情ログは、口論後の曖昧な状態を、感情価、具体的な感情ラベル、帰属させる生活領域という3つの構造化されたデータに変換します。その後、会話による追加質問を通じて、実際に起きたことと、それについてあなたが下した結論とを分けます。通常のメモアプリは吐き出した気持ちを記録しますが、AI支援のログはその背後にある構造を記録します。だからこそ、その記録を後からCBT思考チェックに活用できるのです。
この違いは重要です。2つのツールは異なる役割を担うからです。
✅ 感情ログ = 測定。 強度を記録し、感情を正確に言語化し、きっかけとなった領域をタグ付けします。解釈はしません。 ✅ 思考記録 = 分析。 感情を引き起こしている自動思考を切り分け、それを根拠に照らして検証します。 ✅ 診断を行わないとは、ラベルを付けないこと。 ツールは「これは不安障害のようです」とは言いません。「あなたは苦痛を80%と評価し、苛立ちという言葉を選びました」と伝えます。 ✅ AIの真の貢献は、質問の規律を保つことです。 夜11時に一人で書いているなら飛ばしてしまう追加質問を、AIは投げかけます。 ✅ AIの本質的な限界は、判断にあります。 セラピストの役割を担うチャットボットに関するStanford HAIの研究では、大規模言語モデルをセラピスト役に置いた場合、重大な安全性の失敗が確認されました。研究者は、より安全な用途を「ジャーナリング、振り返り、コーチングの支援」と明確に限定しています。
この境界線、すなわち臨床的判断ではなく振り返りの足場を提供することが、以下のすべてのツールを評価する際の枠組みです。
家族との口論は、なぜ構造なしに振り返るのが特に難しいのか?
家族間の対立を振り返ることが特に難しいのは、その対立そのものが、適切に振り返るために必要な認知能力を低下させるからです。Yale School of Medicineの研究では、家族間の対立とネガティブな生活上の出来事は、主に感情調整を乱すことで、メンタルヘルスの悪化や行動上の問題と関連していることが示されました。この乱れは副作用ではなく、作用機序そのものです。
これは実践上の問題を生みます。口論後の1時間には、次の3つが同時に起きています。
- 感情的な圧倒により、「私は軽んじられたと感じた」と「相手は私を軽んじた」を区別しにくくなります。
- 過去の圧縮によって、1件の出来事が生涯にわたるパターンへと縮約されます(「彼女はいつもこうする」)。
- 反芻ループによって、口論を何度も再生する一方で、新しい情報は何も生まれません。
家族間の対立と青年期の機能に関するPMC研究でも、家族間の対立は感情調整能力と負の関連があることが示されています。構造化された記録は、まず測定、次に解釈、最後に評価という順序を強制するため、これら3つの失敗パターンすべてに対抗できます。この順番こそ、適切に設計されたAIワークフローが維持でき、白紙のページでは維持しにくいものです。
感情ログと思考記録のためのAIツールに、何を求めるべきか?
適切なツールとは、臨床家のふりをすることなく、あなたを構造の中にとどめてくれるものです。この記事で評価したツールを比較すると、本当に役立つ振り返りの足場と、ウェルネス風のチャットを分ける6つの評価軸がありました。
本記事で使用した6次元の評価フレームワーク:
| # | 評価軸 | 優れた状態 |
|---|---|---|
| 1 | 構造への忠実性 | 実際のCBT思考記録の順序、すなわち状況 → 気分 → 自動思考 → 両方向の根拠 → バランスの取れた思考 → 再評価に従うこと。反証となる根拠の欄を飛ばさないこと。 |
| 2 | 非診断的な規律 | 状態、重症度ラベル、臨床的解釈を決して割り当てないこと。分類するのではなく、利用者の言葉をそのまま返すこと。 |
| 3 | セッションをまたぐ記憶 | 家族の人物、繰り返されるきっかけ、先週のバランス思考を覚えていること。これにより、6件目の記録が1件目を土台にできること。 |
| 4 | 関係性の文脈の扱い | すべての対立を一般論として扱うのではなく、義理の母や疎遠な兄弟といった具体的な関係性の力学を保持できること。 |
| 5 | エスカレーションに関する誠実さ | 限界を明確に示し、内容がセルフヘルプの範囲を超える場合は人によるケアを案内すること。 |
| 6 | 出力の持ち運びやすさ | エクスポート、印刷、またはセラピストへの持参が可能な形で出力できること。 |
評価軸3は特に重要です。ここで多くのツールは人知れず失敗します。思考記録の価値は、記録を重ねるほど増していきます。同じ家族について同じ自動思考を4回目に捉えたとき、あなたは単発の出来事ではなく、パターンに取り組んでいます。1件目の記録を覚えていないツールには、それを支援できません。
評価軸5は譲れません。American Psychological Associationの2026年チャットボットとメンタルヘルスに関する報告書では、心理学者のチャットボットによるメンタルヘルス助言への態度は、「安全性とプライバシーに関する大きな慎重さによって特徴づけられる」とされました。自らの役割を過大に売り込むツールは、この基準をすでに満たしていません。
口論後の振り返りにおいて、主要なAIの選択肢はどう比較できるか?
単一のツールがすべてを支配しているわけではありません。このカテゴリーは、臨床検証済みの限定的なツール、消費者向けAIジャーナル、汎用エージェントプラットフォームに明確に分かれており、それぞれ異なる評価軸に強みがあります。
| 評価軸 | Wysa | Woebot Health | Mindsera | Jenova(Relationship Advisor + Personality Analyzer) |
|---|---|---|---|---|
| CBTの構造 | ガイド付きCBTエクササイズの経路、プロトコル主導 | CBTに基づく会話プロトコル | AIによる振り返りを伴うジャーナリングプロンプト。厳密な思考記録の欄構造ではない | 完全な7列の記録を含め、与えたあらゆる構造に従える。ただし、設定は利用者自身が行う必要がある |
| 臨床的検証 | 企業によると、査読済み論文45件以上。 1,213人を対象としたJMIR研究では、AIへのアクセスにより利用者がコーチングプログラムを完了する可能性が約3倍になった | 臨床研究心理学者のDr. Alison Darcyが2017年に設立。Newsweek初のWorld's Best Digital Health Companiesリストに選出 | Wysaに匹敵する公表済みの臨床試験プログラムはない | なし。臨床製品ではない汎用プラットフォーム |
| セッションをまたぐ記憶 | アプリモデル内でのセッション継続性 | アプリ管理による継続性 | ジャーナル履歴とAIによるパターンの提示 | 永続的なセッション横断メモリ。エージェントが過去の記録や名前を挙げた家族を記憶する |
| 関係性の具体性 | 一般的な対立の枠組み | 一般的な対立の枠組み | 利用者が書くため、書いた内容の範囲で具体的 | 高い。正確な関係性を説明すれば、その文脈を保持する |
| 明示された限界 | 明確な免責事項:危機、虐待、重度の状態向けには設計されておらず、医療的または臨床的助言はできない。18歳以上 | 治療ではなくウェルネスツールとして位置づけ | ウェルネスジャーナリングとして位置づけ | 汎用AIアシスタント。メンタルヘルス製品ではなく、そのように扱うべきではない |
| 匿名性 | 設計上、明示的に匿名 | アカウントベース | アカウントベース | アカウントベース。データは公開モデルのトレーニングには使用されない |
| 価格 | 無料プランに加え、企業・医療システム向け展開 | 主に雇用主、保険者、医療システムを通じて提供 | 無料プラン、有料プランは月額$10.75~$14.99 | 無料プランですべてのコア機能を利用可能。Plusは利用量30倍で月額$20 |
| 最適な用途 | 匿名性があり、臨床的裏付けを持つプロトコル主導のCBT | 雇用主または保険者が提供する構造化サポート | 軽いAI振り返りを伴う、習慣化しやすい毎日のジャーナリング | 構造を自分で管理したい、深く関係性に特化した振り返り |
各ツールの率直な評価:
- Wysaは、臨床的検証と匿名性を優先する場合の最も有力な選択肢です。限界は構造の硬さにあります。自分のワークシートではなく、Wysaの経路に従うことになります。また、危機、虐待、重度の状態での利用を明確に対象外としています。
- Woebot Healthには確かな臨床的背景がありますが、個人がすぐにダウンロードできる消費者向けサービスというより、主に雇用主、保険者、医療システムを通じて提供されます。そのため個人の利用可能性は限られます。
- Mindseraは、この中で最も快適に毎日の習慣にしやすいツールです。ただし、AIによる振り返りの構造は緩やかです。特定の7列思考記録の規律がほしい場合は、その構造を自分で与える必要があります。
- Jenovaのエージェントは、最も高い柔軟性と最も深い関係性の文脈処理を提供し、ここで唯一、貼り付けたワークシートにそのまま従える選択肢です。ただし、正直に言えば重要なトレードオフがあります。**これは臨床製品ではなく、メンタルヘルス用途について査読済みの検証はなく、WysaやWoebotが構築している安全性の足場も備えていません。**これはあなた自身が進める振り返りツールであり、支援付きケアの経路ではありません。
実際の感情ログのステップは、どのようなものか?
感情ログは2分未満で終わり、思考の分析よりも必ず先に行うべきです。ここではまだ状態を説明するのではなく、測定します。
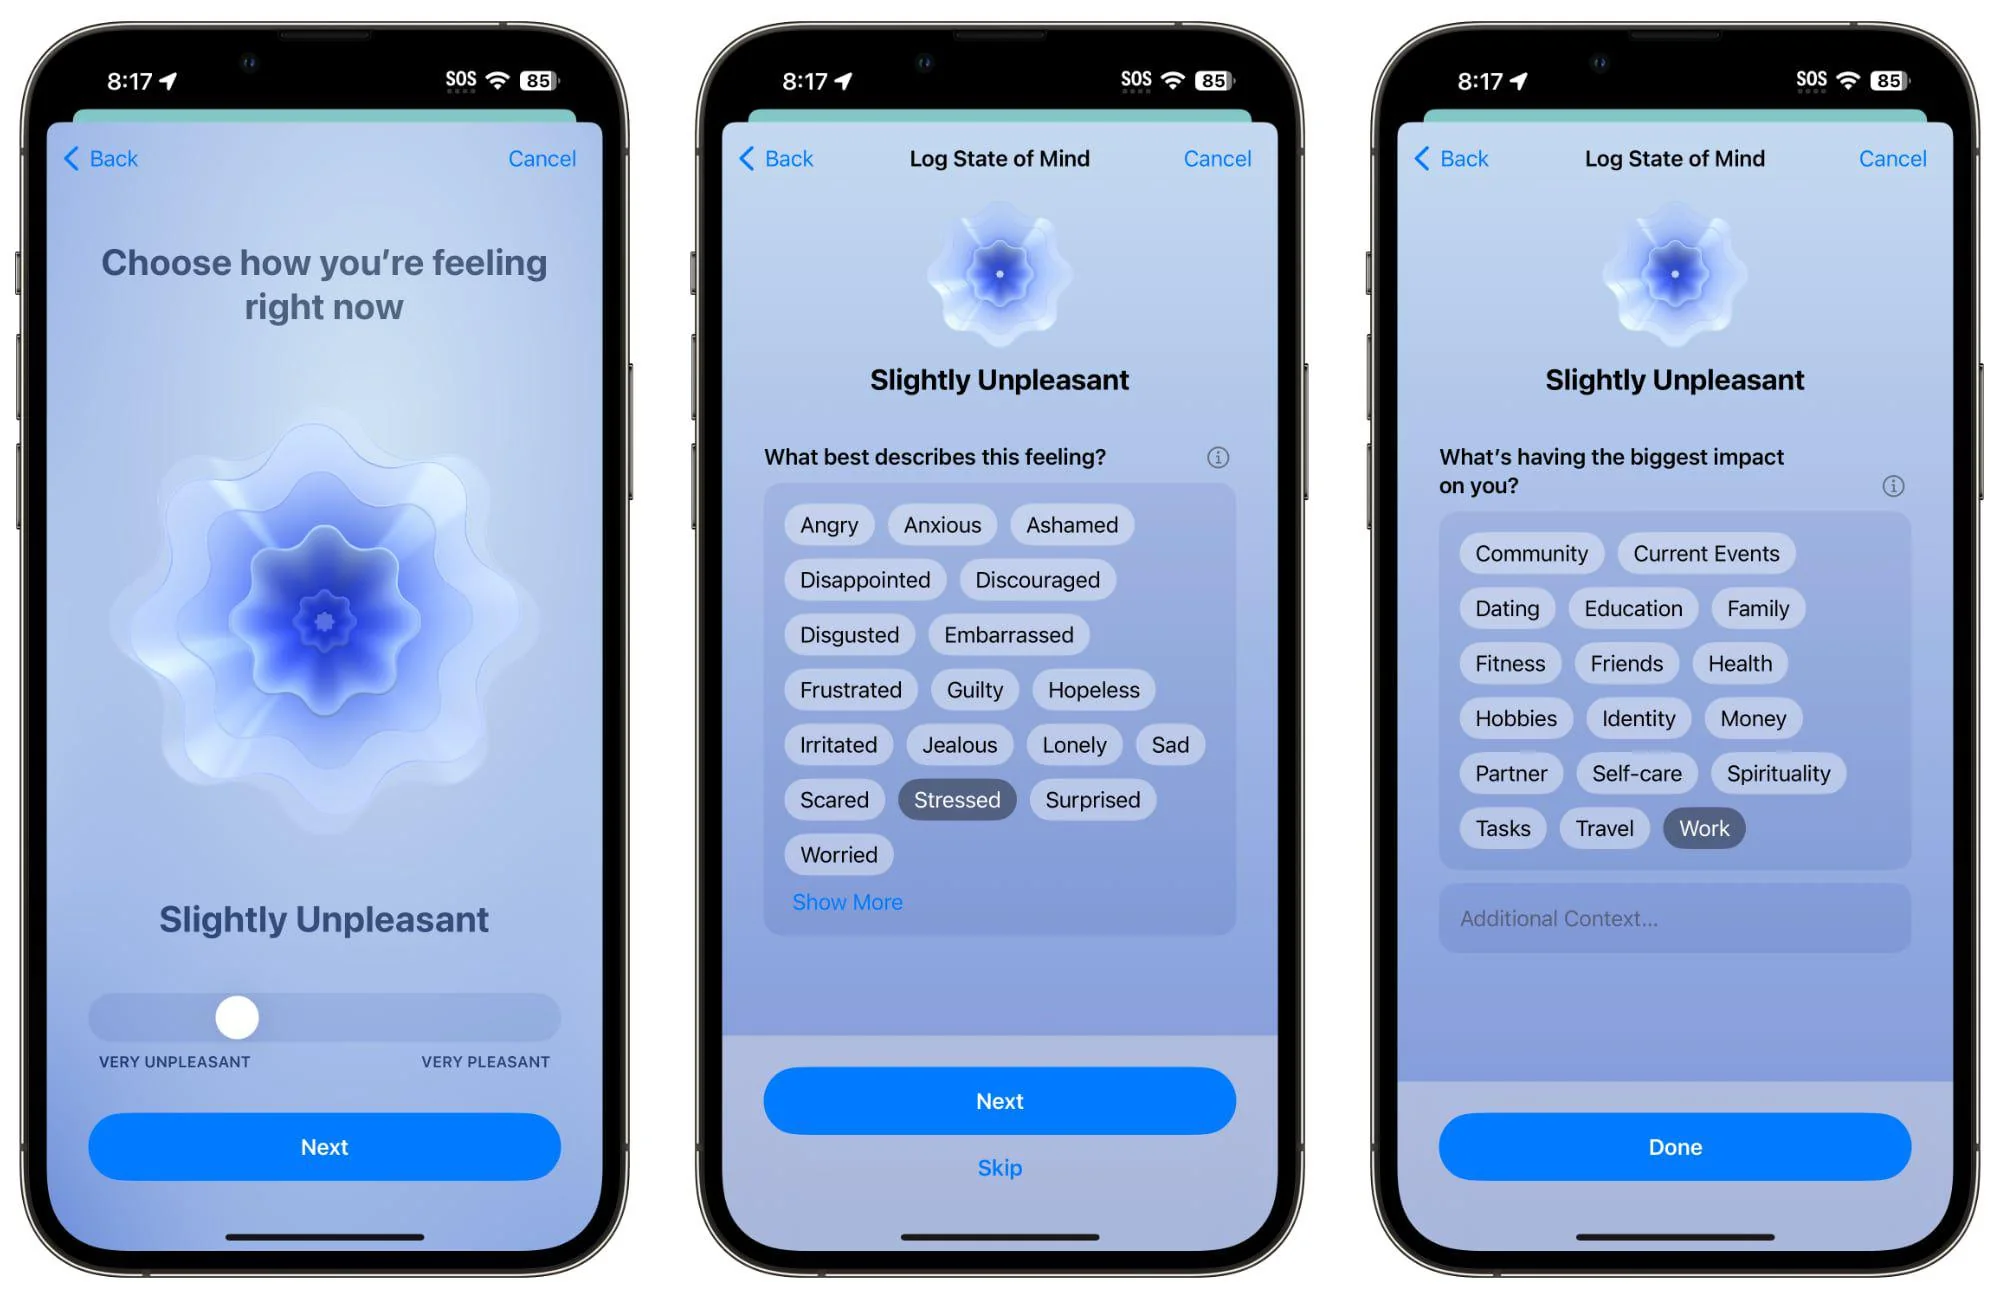
上のインターフェースに示されている3画面のパターンは、この順序をよく表しています。**感情価 → 具体的な感情 → 帰属させる領域。**どのツールを使う場合でも、この構造を再現してください。
ステップ1 — 感情価と強度を評価する。 何かを名付ける前に、感情をスペクトラム上に置き、数値を付けます。「少し不快、65/100」は、「つらい」よりも役立ちます。
ステップ2 — 包括的な言葉ではなく、正確なラベルを選ぶ。 インターフェースが苛立ち、失望、絶望感、恥、いらだち、ストレスといった表現を提示するのには理由があります。「動揺している」では、どれが実際に反芻ループを動かしているのかが隠れてしまいます。2つか3つを選びましょう。
ステップ3 — 領域をタグ付けする。 この例では家族です。10件の記録を重ねると、領域タグによって、そのパターンが関係性によるものか、状況によるものか、それとも1週間全体に広がっているのかが見えてきます。
Relationship Advisorでは、次のような設定プロンプトで十分です。
「診断を行わない感情ログだけを実施したいです。まだ分析、助言、解釈はしないでください。非常に不快から非常に快いまでの尺度での感情価、0~100の強度評価、正確な感情を表す言葉を2つか3つ、これが属する生活領域を尋ねてください。その後は止めて、私の回答を簡潔な要約としてそのまま返してください。何を意味するかは言わないでください。」
止めるという指示は重要です。制約がなければ、ほとんどのAIツールはすぐに捉え直しや助言へ進みます。その結果、測定に解釈が混ざってしまいます。これは、この2段階構造が防ぐためにあるまさにその誤りです。
Wysaでは、相当する方法は気分チェックインのフローに入り、ガイド付きの経路に順序を任せることです。カスタマイズ性は失われますが、プロトコル上の規律が得られます。
AIに解釈させずに、CBT思考チェックを実行するには?
7列の思考記録の構造をAIに直接貼り付け、1列ずつ質問するインタビュアーとしてのみ行動するよう指示してください。あなたが言っていない内容は、どの列にも書き込ませないことが重要です。
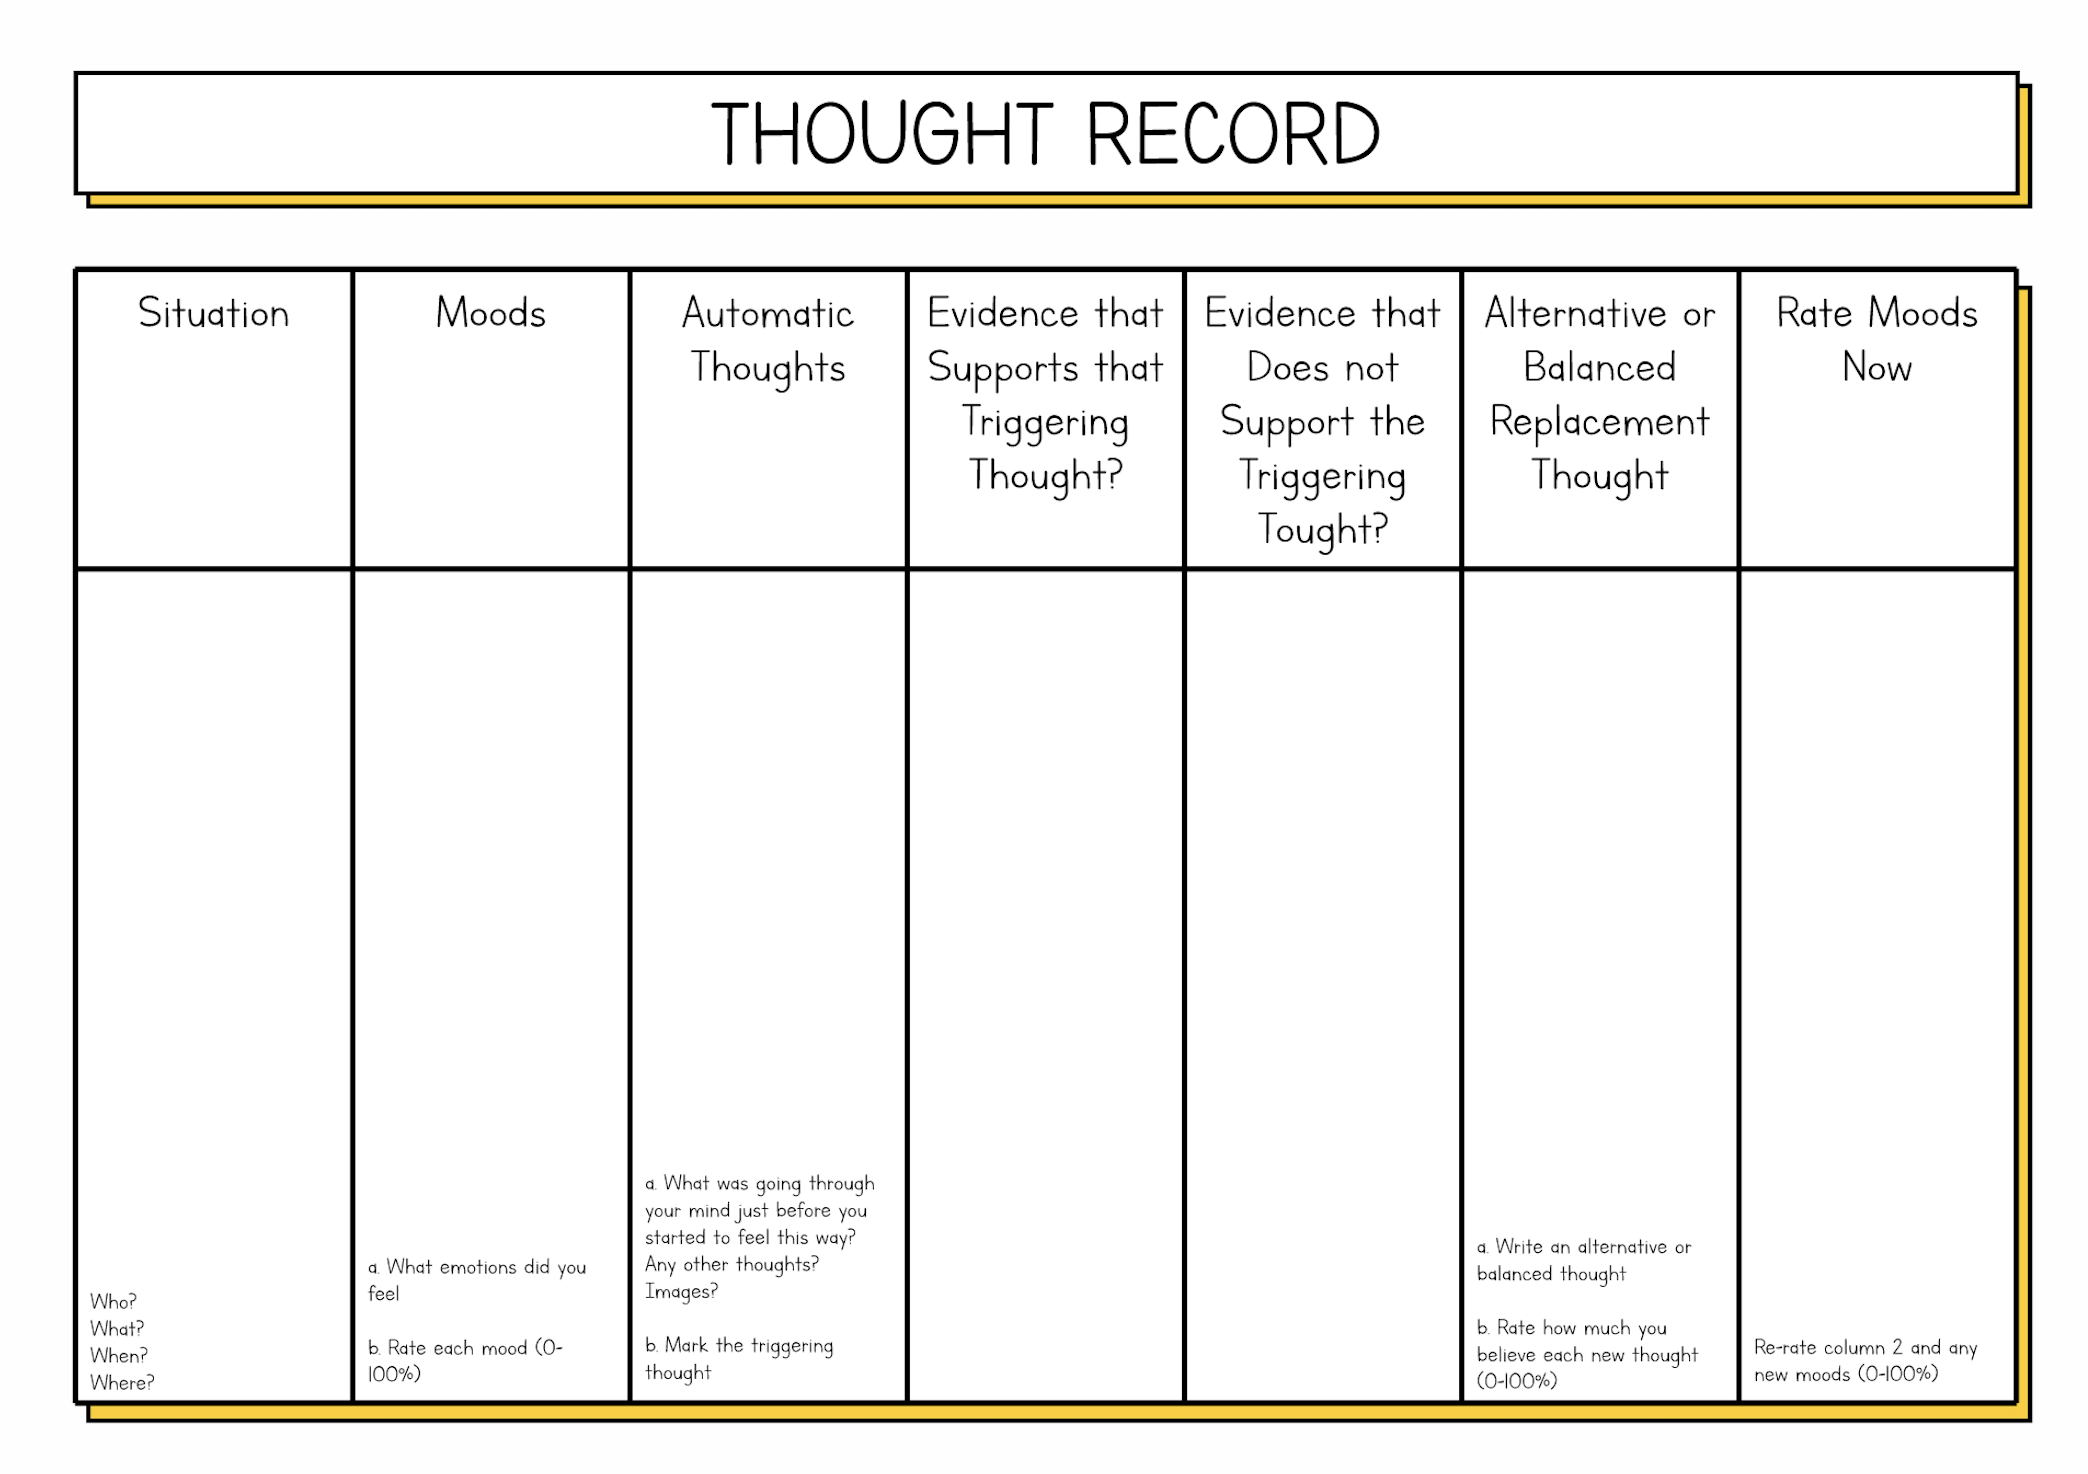
上のワークシートは標準的な構造です。NHS Every Mind Mattersの思考記録では、状況、最初の感情、役に立たない思考、それを支持する根拠、反する根拠、現実的な代替思考、現在の気持ちという、同等の7つの質問の順序を採用しています。
家族との口論後に各列を進める方法:
- 状況 — 誰が、何を、いつ、どこで。事実だけを書きます。「午後8時40分、キッチンで、父の通院予約を誰が担当するかについて兄と口論した」。「兄がまた全部私に押し付けた」ではありません。
- 気分 — 感情ログをそのまま取り込みます。苛立ち75%、罪悪感50%、孤独感40%。
- 自動思考 — 頭の中をよぎったことをすべて書き、その中で最も感情的な負荷の大きいホット思考を印します。多くの場合、*「この家族で本当に役割を果たしているのは私だけだ」*のような考えです。
- それを支持する根拠 — 実際に支持する事実を書きます。これは修辞的な練習ではありません。「先月は私が3回の通院に車で連れて行き、兄は1回も出席しなかった」。
- それを支持しない根拠 — Psychology Toolsは、思考記録が支持する根拠と反する根拠の検討だけに矮小化されがちだと指摘しています。そして、多くの人が急いで通り過ぎるのがこの欄です。ここが最も価値の高い欄であり、AIが最も役立つ場所でもあります。AIは質問を続けてくれるからです。「兄は3月に保険の書類を処理した。2月は自分が担当すると申し出たが、私が断った」。
- 代替となるバランスの取れた思考 — ポジティブな自己肯定ではありません。両方の根拠欄を踏まえた思考です。「通院の負担は私のほうが大きく、それは話し合う価値のある実際の不均衡だ。ただし、私だけが役割を果たしているというのは事実ではない。分担は不均等であって、私だけが担っているわけではない」。
- 気分を再評価する — 同じ尺度、同じ感情で評価します。この変化が結果の指標です。
AIを役割の範囲内にとどめるプロンプト:
「兄との口論についてCBT思考記録を完成させます。次の正確な構造で、1列ずつ私に質問してください:状況、0~100の評価付きの気分、ホット思考を印した自動思考、支持する根拠、支持しない根拠、バランスの取れた代替思考、再評価した気分。ルール:質問は一度に1つだけ行い、私の回答を待ってください。私の代わりにどの列も埋めないでください。何も診断せず、兄について助言をせず、私が先へ進もうとしても反証となる根拠の欄を飛ばさないでください。完了したら、完成した表を出力してください。」
複数の口論にまたがるパターンに取り組む場合、Personality Analyzerは、完成した記録の束を確認して、繰り返される自動思考を調べることができます。ただし、それは記録を正直に完成させた後に限ります。1件だけを入力しても、得られるのはパターン認識ではなく推測です。
AIをこの目的で使う際の、本当の限界とは?
AIが適しているのは、一般的な対人関係の対立に対する構造化された自己振り返りであり、危機、虐待、臨床症状に近いものには適していません。この境界を支持する根拠は、多くの製品マーケティングが示唆する以上に強いものです。
National Academy of Medicineは2026年に、AIチャットボットが致死的手段に関する指示の共有を含む有害な行動に関与したと報告しました。Brown Universityの研究者は2025年に、AIチャットボットがメンタルヘルスの中核となる倫理基準に日常的に違反していることを発見しました。Companion AIに関するHarvard Business Schoolの研究では、こうしたシステムは苦痛の兆候を認識し、適切に対応できない場合が多いとされています。
AI支援の記録が合理的な場面:
- 身の危険を感じない家族との通常の対立
- 構造を使って中断したい、口論後の反芻
- すでに通っているセラピストに持参する資料の準備
- 感情を正確に言語化する習慣づくり
適していない場面:
- 虐待、支配的なコントロール、安全への恐怖が関わるあらゆる状況
- 自傷や自殺についての考え
- 持続、悪化、または日常機能への支障を伴う症状
- 評価、診断、治療の代替となるあらゆる利用
Wysa自身の免責事項には、虐待、重度のメンタルヘルス状態、医療上の緊急事態を支援するようには設計されていないと明記されています。一方、汎用AIプラットフォームには、そのような目的別の安全設計はまったくありません。この2つの立場の差は、現実のものとして扱ってください。
臨床研究者は、認知の再構成におけるAIの役割をどう考えているのか?
研究者の間の合意は、「AIセラピーは悪い」ということではありません。AIの有用な役割は、解釈的なものではなく、狭く、補助的で、構造的なものであるという点です。
「問題はニュアンスです。これは単純に『セラピーにLLMを使うのは悪い』という話ではなく、セラピーにおけるLLMの役割について批判的に考えるよう求めるものです。LLMはセラピーにおいて非常に強力な未来を持つ可能性がありますが、その役割が具体的に何であるべきかを批判的に考える必要があります。」
— Stanford Graduate School of Education助教授、Stanford Institute for Human-Centered AI所属のNick Haber。 2025年ACM FAccT論文に関するStanford HAIの記事より
Stanfordチームによる、より安全な用途の整理は参考になります。同チームの論文では、セラピストの事務作業の処理、臨床研修における標準化患者としての利用、ジャーナリング、振り返り、コーチングといった「安全性がそれほど重要でない場面」での患者支援などの役割が示されました。キッチンでの口論についての構造化された感情ログと、自分で完成させる思考記録は、まさに最後のカテゴリーに位置します。
論文の筆頭著者で、Stanfordのコンピュータサイエンス博士課程学生であるJared Mooreは、これらの限界が持続することについても関連する指摘をしています。「より大きなモデルも新しいモデルも、古いモデルと同じくらいのスティグマを示します。AIからの既定の反応は、より多くのデータがあればこうした問題は解消されるというものになりがちです。しかし私たちが言っているのは、従来どおりのやり方では不十分だということです。」
家族との口論後にAIを使う人にとっての実践的な意味は明確です。AIには、欄を保持させ、評価を数えさせ、次の質問をさせてください。あなたの感情が何を意味するのか、あるいは兄の行動が彼について何を示すのかを、AIに語らせてはいけません。
繰り返し使える口論後のルーティンを、どう作るべきか?
実生活でも続けられるルーティンは4ステップで、合計約15分です。感情的な段階と分析的な段階を、意図的なクールダウン時間で分けます。
- 直後(2分): 感情ログだけを行います。感情価、強度、正確なラベルを2~3個、領域タグ。分析はしません。PositivePsychology.comの思考記録ガイドは、思考に挑戦する前に気分を特定するという標準的なCBTの順序を反映しています。
- 60~90分待つ。 感情の強度がピークにあるときの認知の再構成は、自己攻撃か防御的な正当化につながりがちです。どちらもバランスの取れた思考ではありません。
- その後(10分): AIを1列ずつ質問するインタビュアーとして使い、7列の思考記録を行います。気分を推測し直すのではなく、記録した気分を2列目に取り込みます。
- 毎週(5分): その週の記録を見返し、繰り返されるホット思考を探します。ここに積み重なる価値があります。認知の再構成と心理療法の成果に関するPMCレビューは、根拠を検討する問いをこの技法の中核に位置づけています。そして、繰り返しによってそれは自動的にできるようになります。
**実践上の注意点が2つあります。**完成した記録はエクスポートまたはスクリーンショットで保存してください。6件の思考記録の束は、初回のセラピーセッションにとって本当に有用な資料になります。そして、すべての記録に同じ家族が登場するなら、あなたが記録しているパターンは、捉え直しを必要とする認知の歪みではなく、対話を必要とする関係性の問題かもしれません。思考記録は、思考が正確かどうかを検証するためのものであり、正確な思考を思いとどまらせるためのものではありません。
参考文献
- NHS Every Mind Matters — 思考記録CBTエクササイズ
- Stanford HAI — メンタルヘルスケアにおけるAIの危険性を探る
- Yale School of Medicine — 家族間の対立とストレスが若者の感情調整を乱す
- PubMed Central — 青年の社会的機能における家族間の対立と結束の役割
- American Psychological Association — 患者がAIをセラピーに持ち込んでいる(2026年報告書)
- Wysa — 製品概要、臨床論文、利用に関する免責事項
- Woebot Health — 企業の使命と臨床的背景
- Mindsera — 無料プランと有料プランの価格比較
- Psychology Tools — CBT思考記録がうまく機能しないときに試すこと
- National Academy of Medicine — メンタルヘルスのためのAIチャットボット:有効なこと、有害なこと、次に必要なこと
- Brown University — 新研究:AIチャットボットはメンタルヘルスの倫理基準に体系的に違反している
- Harvard Business School — チャットボットとメンタルヘルス:Companion AIの安全性に関する知見
- PositivePsychology.com — CBTにおける思考記録:7つの例とテンプレート
- PubMed Central — 認知の再構成と心理療法の成果