AI研究における研究公正違反を防ぐには?
2026-08-22
AI研究ツールの選定で重視すべき失敗モードとは?
学術活動におけるAI関連の公正性違反の多くは、予測可能な4つの失敗モード――架空の情報源、不一致または歪曲された引用、偶発的な盗用、機微データの露出――から生じます。これらを減らすツールとは、先に文章を書き、後から参考文献を捏造するのではなく、書く前に実在する文献を取得するツールです。2026年には、Natureの分析で、2025年の数万件の出版物に無効なAI生成参考文献が含まれている可能性があることが判明しました。選択肢を比較する研究者は通常、引用管理を伴う文献作業にはJenovaのAcademic Research Assistant、体系的なエビデンス抽出にはElicit、引用文脈の確認にはSciteを評価し、提出原稿に掲載する主張については汎用チャットボットを高リスクと見なします。
研究公正を守るAI研究と、制約のない下書きを分ける主な要因は次のとおりです。
✅ 検索してから引用するアーキテクチャ — システムは、ある論文に主張を帰属させる前に、実在する論文を特定しなければなりません。 ✅ すべての参考文献の人間による検証 — AI利用が許可される場合、Cornellの教育ガイダンスは学生にすべての引用の正確性を検証するよう求めています。 ✅ 開示と人間の説明責任 — 出版倫理委員会(COPE)は、AIツールは著者になれないと明記しています。AIが下書きした文章を含め、すべての文について人間が責任を負います。 ✅ データ封じ込め — 未発表データセット、参加者を特定可能な情報、エンバーゴ中の原稿を、公開トレーニングパイプラインに入力してはいけません。 ✅ 類似性しきい値への認識 — 現在の機関規則では、コピーされた段落だけでなく、高い重複率も制裁対象となります。
ツールを有意義に比較するには、公正性を単一の盗用スコアではなく、存在性、忠実性、帰属、封じ込めという4つのゲートからなる工学的問題として捉えることが有効です。
AI生成引用が研究公正の危機になった理由とは?
AI生成引用が危機になったのは、大規模言語モデルが図書館カタログを照会するのではなく、もっともらしい書誌パターンを補完するためです。その結果、捏造された参考文献は急いだ校正をすり抜けるほど本物らしく見えます。Enagoは、AI生成の学術参考文献のおよそ5件に1件が偽物であると報告しています。こうした偽物は通常、正規の学術誌名、よくある著者名のパターン、その分野にありそうな論文タイトルを模倣しています。
この汚染は、もはや学生のレポートだけにとどまりません。不正引用の増加を扱った2026年のSTAT報道は、捏造参考文献が出版済み文献全体に広がっていると伝えました。これは科学の公的記録を汚染しています。生物医学分野の分析でも、AI生成の偽参考文献が研究論文でより一般的になっていることが確認されています。いったん幻の論文が引用されると、後続の著者が情報源を開かないまま引用を複製することがあります。こうして一つのハルシネーションが、長く残る誤りへと変わります。
David B. Resnikらは、引用がデータとして機能する場合、ハルシネーションによる引用は研究不正に該当し得ると論じています。たとえば、体系的レビュー、エビデンスマップ、あるいは誰が何を述べたかに論旨が依存する論文が該当します。この捉え方は重要です。捏造された参考文献は書式上のミスではありません。それは、学術記録の存在について行われる虚偽の実証的主張です。
現在、編集者には、検証不能な参考文献をコピー編集上の面倒ではなく、審査の失敗として扱うことが求められています。PubMed Centralの解説は、AI時代の捏造引用を学術誌編集者への警鐘として位置づけています。個々の研究者にとって実務上の含意はより単純です。ツールが情報源を提示できないなら、そこに引用はありません。
研究公正を守るAIリサーチアシスタントに求めるべきものは?
研究公正を守るAIリサーチアシスタントは、識別可能な論文を検索し、主張を特定の箇所に結び付け、未発表ファイルを公開トレーニングセットから隔離し、指導教員や編集者に説明できる開示履歴を残すべきです。機能一覧は弱い代替指標にすぎません。重要なのは、ツールの標準ワークフローが捏造を高コストにし、検証を低コストにするかどうかです。
有用な評価モデルは、情報源優先の公正性モデルです。論文の章に何かを貼り付ける前に、ツールが次の4つのゲートを通過できるかを評価してください。
- 存在性 — 永続的識別子(DOI、PMID、ISBN、または安定したURL)は実在する著作物に解決されますか?
- 忠実性 — 引用箇所は本当にその主張を裏付けていますか。それともモデルが研究結果を歪めていますか?
- 帰属 — 正しい著者、年、ページ情報が、正しい文に付与されていますか?
- 封じ込め — 特定可能な資料、エンバーゴ中の資料、または臨床的に機微な資料が、あなたの管理外へ出ていませんか?
最初に文章を生成し、後から参考文献を散りばめるツールは、ゲート1を構造的に通過できません。学術データベースを検索し、論文を返し、それから要約するツールは、完全に自動ではないものの、構造的に安全です。George Mason UniversityのAI文献レビュー・ツールガイドは、ElicitやSciteのような製品を自由形式のチャットではなくエビデンス統合のためのツールとして分類しています。この分類境界は適切です。
また、研究公正部門が実際に確認する運用基準も検討してください。
- 開示の支援 — APA、MLA、Chicagoは現在、LLM出力を引用するための形式を示しています。モデル名、日付、プロンプトを記録できますか?
- メモリの範囲 — プロジェクトメモリは一貫性の維持に役立ちますか。それとも、あるクライアントのデータを別のセッションへ密かに混在させますか?
- 人間参加型の標準設定 — インターフェースはPDFを開きやすくしますか。それとも、流暢な段落の背後に情報源を隠しますか?
- 検出器からの独立性 — Cornellは現在、自動AI検出アルゴリズムへの依存を推奨していません。信頼性が低く、執筆者を誤って告発することがあるためです。優れたツールは、情報源を確認可能にすることで検出器の必要性を減らします。
JenovaのAcademic Research Assistantは、文献探索、原稿作成、引用管理を中心に構築されており、プラットフォームレベルの永続メモリと学術検索ツールを備えています。これはiThenticate、機関審査委員会、または指導教員の承認に取って代わるものではありません。この制約は意図的なものです。研究公正は人間の責任であり続けます。
主要AI研究ツールは引用検証とプライバシーの面でどう比較できるか?
専門的なリサーチアシスタントは、論文コーパスに接続されているため、引用の公正性において汎用チャットボットを上回ります。一方、汎用モデルは次トークンの流暢さに最適化されています。以下の比較では、マーケティング上のカテゴリーではなく、情報源優先の公正性モデルを用います。評価は、2026年の執筆時点で利用可能なベンダー文書および公開報道に基づいています。
| 機能 / 観点 | 汎用LLMチャットボット | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| 引用アーキテクチャ | 生成してから引用。捏造リスクが高い | 1億3,800万本の論文と54万5,000件の臨床試験のコーパスから取得し、文レベルの引用を提供 | 3億本超の学術論文を検索し、後続論文が主張を支持または反駁しているかを表示 | リアルタイムの文献探索に加え、引用管理された原稿作成支援 |
| ハルシネーション参考文献の抑制 | ユーザーが各項目を独自に検証しない限り弱い | エビデンステーブルではより強力。ただし人間による確認は必要 | 引用文脈では強力。包括的な執筆環境としては弱い | 下書き前にScholar/検索ツールを利用する場合により強力。検証は依然として必要 |
| 偶発的盗用のリスク | 流暢な出力を変更せず貼り付けると高い | 抽出テーブルでは低い。要約が情報源の表現に近すぎる可能性は残る | 主張確認では低い。主に下書き用ツールではない | アウトラインと情報源マップに使う場合は低い。下書きは独自性の確認が必要 |
| 機微データへの対応 | ベンダーとプランにより異なる。公開モデルは特定可能なデータの標準的な選択肢として不適切 | 研究ワークスペース。トレーニング・保持条件はプランごとに確認すべき | 研究ワークスペース。トレーニング・保持条件はプランごとに確認すべき | プラットフォーム方針:ユーザーデータは公開AIモデルのトレーニングに使用されない |
| 料金(2026年時点) | 本レビューでは未検証 | 本レビューでは未検証 | 本レビューでは未検証 | 使用量が限られた無料枠。Plusは月額$20(無料枠の30×)。上位プランでは使用量が拡大 |
| 最適な用途 | 後で自分で情報源を確認する前提のブレインストーミング | 体系的スクリーニング、データ抽出、エビデンステーブル | 論文が文献内でどのように引用されているかの検証 | 探索、ノート、引用を意識した下書きを組み合わせるエンドツーエンドの学術ワークフロー |
Elicitは、構造化されたレビューを行う場合に特に強力です。同社は、研究者が体系的レビューのワークフローで最大80%の時間短縮を報告していること、そしてAI生成のすべての主張が文レベルの引用によって裏付けられていることを説明しています。2026年の独立比較では一般に、Elicitをより広範なレビュー運用ツール、Sciteを引用インテリジェンスの専門ツールとして扱っています。ある並列レビューでは、運用ではElicit、エビデンス検証ではSciteが優位と評価されました。
2026年のツール比較で説明されるConsensus型の製品は、オープンウェブのテキストではなく、査読済みのエビデンスに基づいて研究質問へ回答します。この設計はチャットボットと比べて捏造を減らしますが、忠実性の問題を取り除くわけではありません。実在する論文でも、誤って要約される可能性があります。
Jenovaの率直な限界は、責任ある研究エージェントがすべて明示すべき限界と同じです。検索、整理、下書きはできますが、有料アクセスのPDFにモデルが考えている内容が実際に書かれていることを保証することはできません。引用文脈の集計が必要な研究者は、限定されたその作業ではSciteを好むかもしれません。PRISMA形式のスクリーニングを行う研究者は、Elicitのテーブルを好むかもしれません。研究公正上の利点は、そもそも情報源優先のツールを使用し、その後に検証することです。
架空または歪曲された引用を検出し、阻止するには?
架空または歪曲された引用を検出するには、すべての参考文献を有効な記録に解決し、そのうえで引用箇所と自分の文を照らし合わせて読む必要があります。存在性と忠実性は異なる失敗だからです。404を返すDOIは、捏造または致命的なメタデータエラーです。実在する論文を、実際には述べていない研究結果の根拠として引用することは歪曲です。どちらも不正調査を引き起こし得ます。
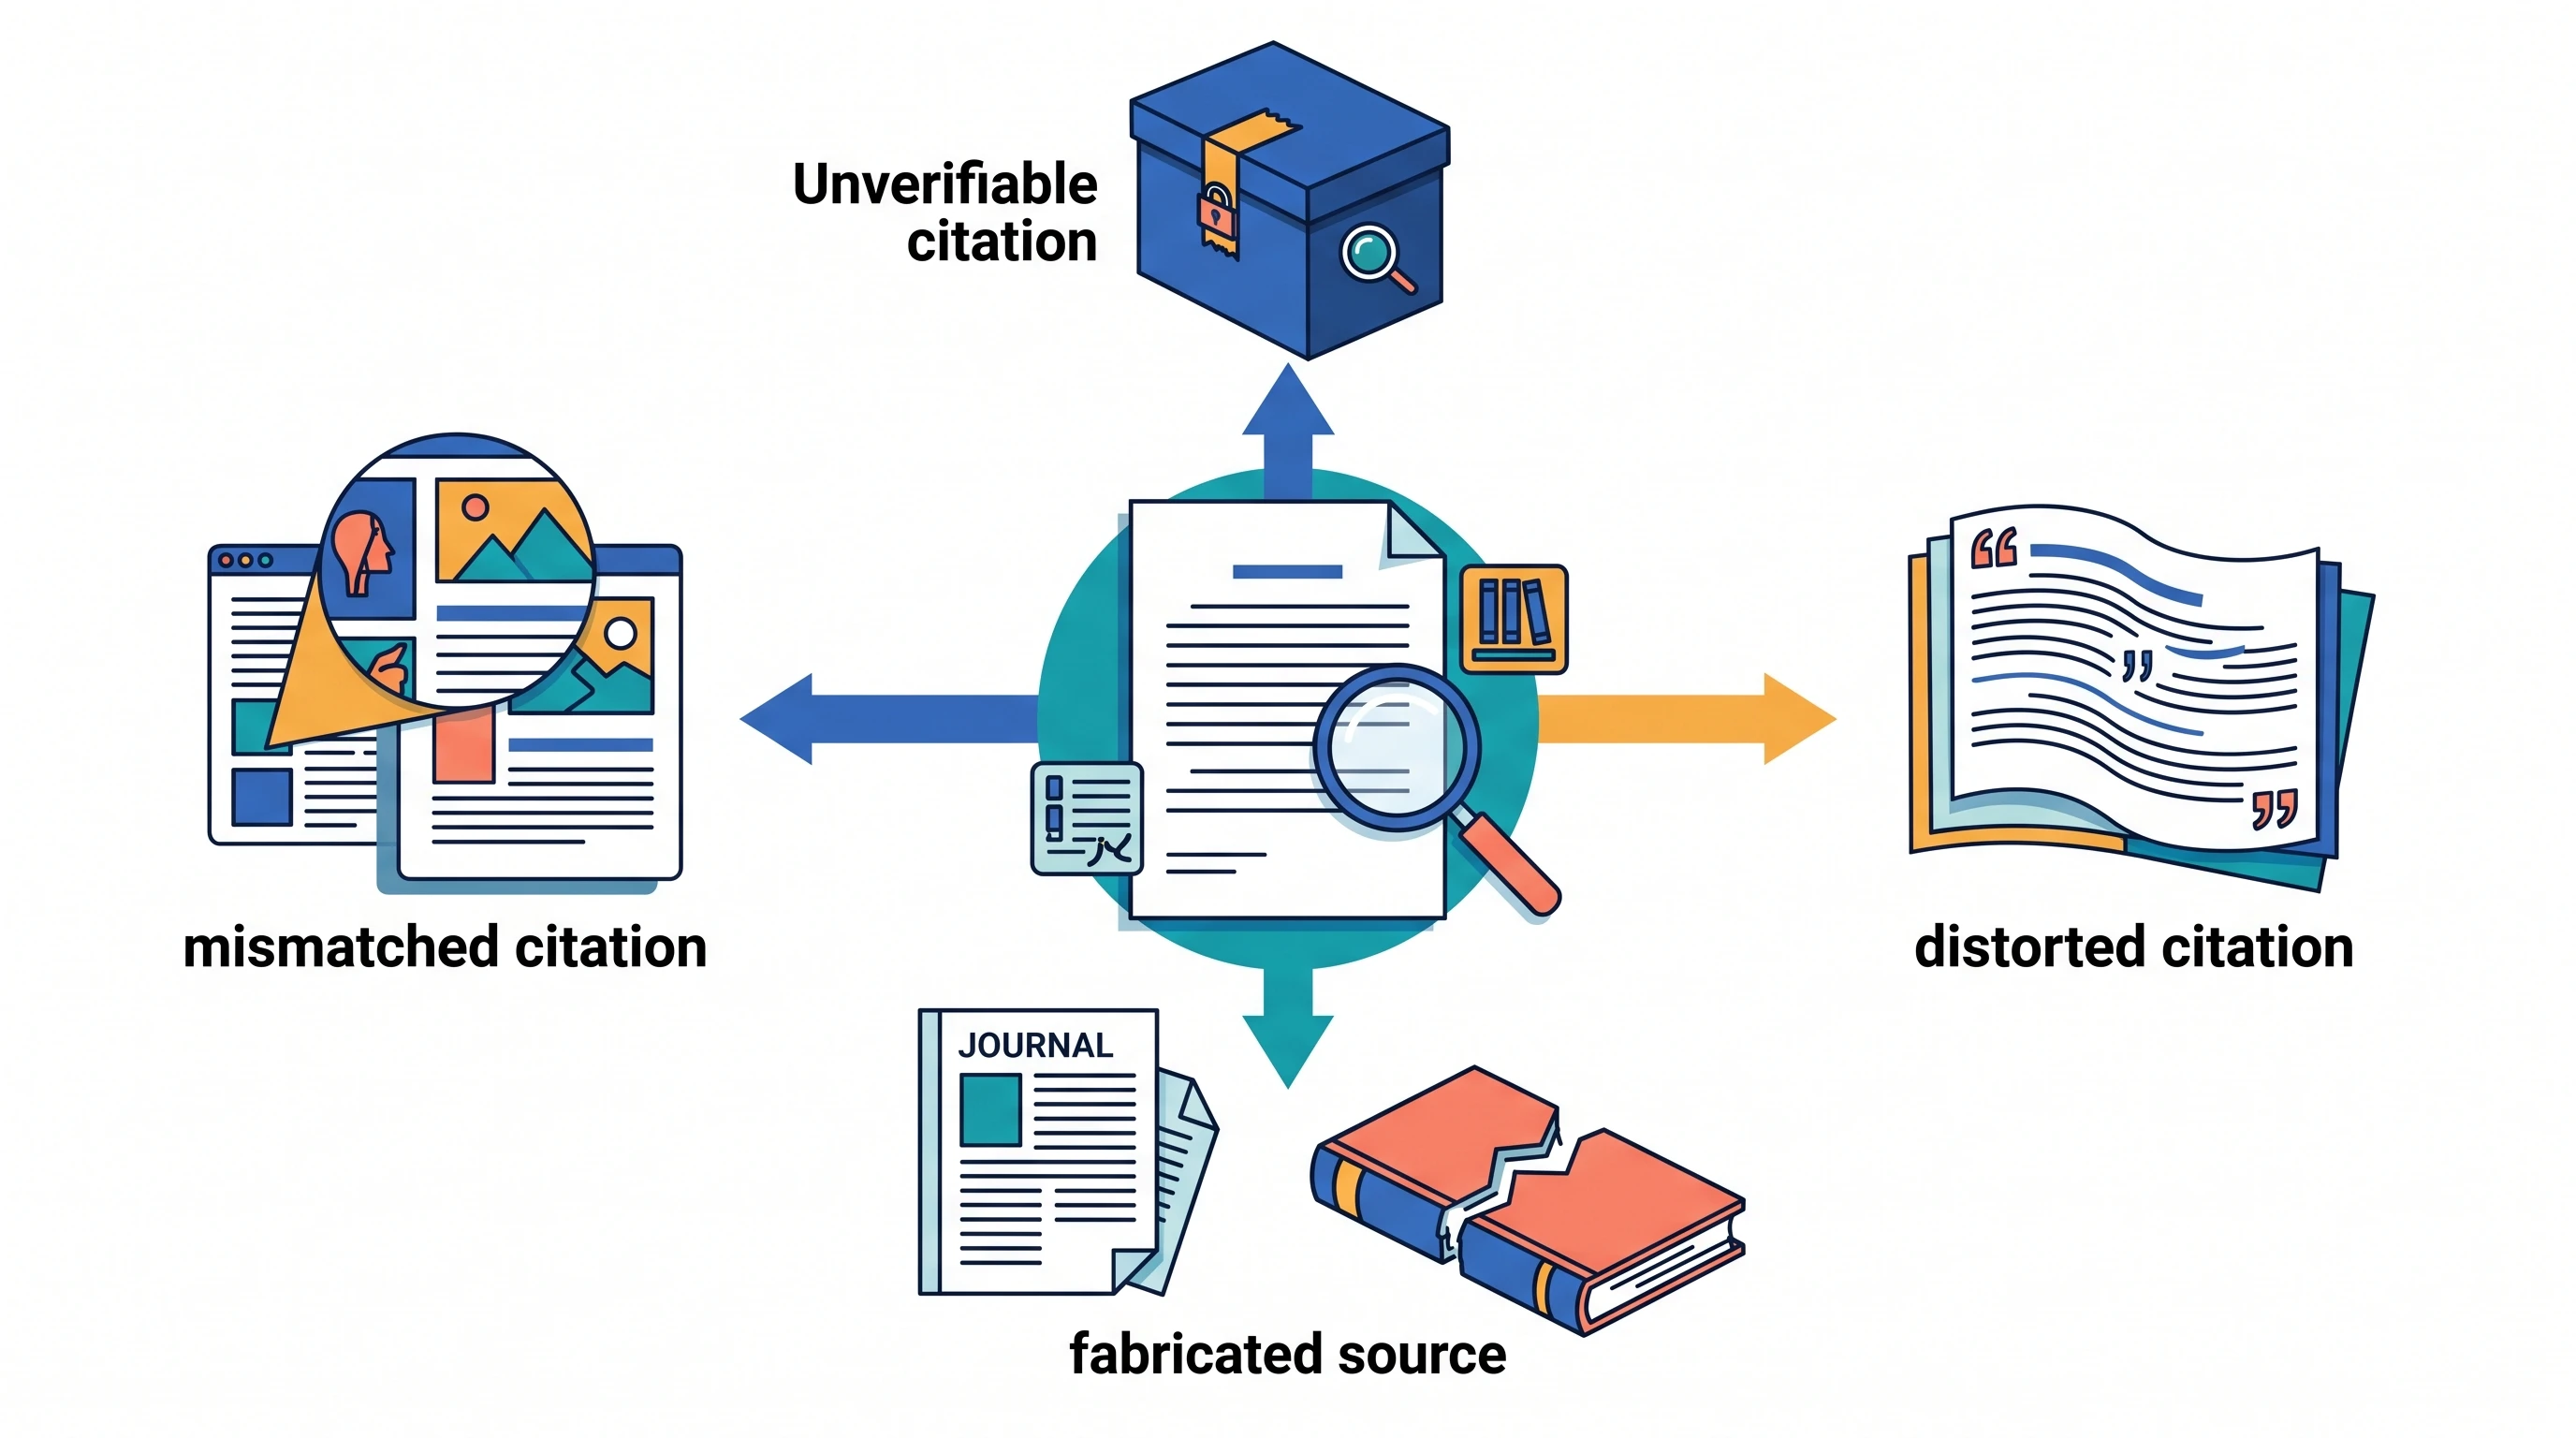
AI支援の参考文献リストでは、次の4種の違反が繰り返し見られます。
- 架空の情報源 — 論文、データセット、または書籍が存在しません。
- 検証不能な引用 — 項目自体は存在する可能性があるものの、アクセス可能な記録、DOI、またはアーカイブコピーを見つけられません。
- 不一致の引用 — 実在する著作物が誤った主張、著者、または年に付けられています。
- 歪曲された引用 — 情報源は存在し、主題にも関連していますが、モデルが結果を逆転させ、限定条件を落とし、または限界を発見として扱っています。
実践的な阻止プロトコルは、重要な主張ごとに約2分で実行でき、習慣化すればさらに短時間で済みます。
- 参考文献をCrossref、PubMed、Google Scholar、または学術誌サイトにコピーし、タイトル・著者・年の組み合わせを確認します。
- PDFまたはHTMLを開き、該当箇所を探します。見つからなければ、その引用を削除します。
- 限定表現が維持されているかを確認します。「関連がある」は「原因である」ではありません。「マウスにおいて」は「患者において」ではありません。
- モデルが求めに応じて提示できない情報源はすべて却下します。「Nature Neuroscienceの2019年の論文を覚えています……」は引用ではありません。
- 学位論文の章や学術誌への投稿では、検証ログ(スプレッドシートまたは参考文献管理ツールのノート)を保持します。
JenovaのAcademic Research Assistantは、文章が存在する前に候補論文を取得し、情報源マップを作るよう依頼するステップ1で最も役立ちます。依拠しようとしている論文を、後続の文献が支持しているか反駁しているかを知る必要がある場合は、Sciteと組み合わせてください。多数の試験から方法とアウトカムを抽出する場合は、Elicitと組み合わせてください。
高い研究公正を意識したプロンプトは、次のようになります。
「[topic]について、2020~2026年に発表された査読済み論文を探してください。各論文について、タイトル、著者、年、DOI、掲載媒体、そして抄録または結果に明示されている25語の主張を提示してください。DOIを検証できない場合は、その論文を省いてください。参考文献を捏造しないでください。」
汎用チャットボットは、このプロンプトでも失敗することがあります。違いは、情報源優先のワークフローでは失敗が見えるようになることです。
AIを使って下書きする際、偶発的盗用を防ぐには?
偶発的盗用を防ぐには、AI出力を自分の所有する文章ではなく、ライセンスのない原材料として扱い、モデルの流暢な文からではなく自分のノートから書き直してください。現在、偶発的盗用が一般的な事例です。ユーザーに盗用の意図はなくても、モデルが情報源をあまりに近い表現で圧縮すると、類似性チェッカー、試験官、または査読者は依然としてその表現を一致させられます。
COPEは、執筆、図、分析でAIを使用する著者に対し、使用したツールと使用方法を開示するよう求めています。通常はMethodsまたは同等の節で開示します。著者は「AIツールによって生成された部分を含め、原稿の内容に全面的な責任を負う」とされています。この一文が法的構造のすべてです。モデルは著作権を保有できず、利益相反を管理できず、撤回通知に応答することもできません。できるのはあなたです。
AI支援下書きには、主に3つの盗用経路があります。
- 情報源の反響 — モデルが、貼り付けた論文または検索した論文を、元の構文を保ったまま言い換えます。
- 自己盗用 — 以前に公開した方法の段落を「背景情報」としてアップロードしたため、モデルが再利用します。
- 大規模なパッチライティング — 多くの論文から少しずつ変更された文を大量に作り、類似性ソフトウェアが依然として検出します。
より安全な下書きの手順は次のとおりです。
- 自分で情報源を読み、ページ番号とともに自分の言葉で箇条書きを作成します。
- モデルにはPDFではなく、自分の箇条書きを再構成するよう依頼します。
- チャットボットの「独自性スコア」ではなく、機関の類似性ツールで章全体を確認します。
- 学術誌または大学院が指定する形式でAI支援を開示します。
情報源の反響を減らすプロンプトは次のとおりです。
「情報源のPDFではなく、私自身のアウトラインノートを貼り付けます。それらを論理的な議論に並べ替えてください。新しい引用を追加しないでください。完成した学術文として通用しそうな表現に、箇条書きを展開しないでください。まだ情報源が必要な点には印を付けてください。」
JenovaのAcademic Research Assistantは、情報源テキストをノート層に置き、別のスレッドで下書きを作成する際に役立ちます。永続メモリは、エージェントが研究質問や除外した論文を記憶できるため、長い学位論文では利点になります。同時に、共著者の未発表下書きを同じプロジェクトに貼り付けるとリスクにもなります。封じ込めは独自性の一部です。ある原稿を別の原稿に流出させてはいけません。
European Network for Academic Integrityは、機関が今なお基本的な用語として用いる一般的な研究公正ガイドラインを公開しています。2025年のScienceDirectレビューは、大学は単に検出器を購入するのではなく、学生の能力と明示的なAI方針を構築しなければならないと論じました。これは適切な重点です。検出器は推測します。開示と情報源ログは証明します。
機微な研究データを公開AIシステムから守るには?
機微な研究データを公開AIシステムから守るには、トレーニング、保持、またはサブプロセッサを特定できないツールに、特定可能な資料、エンバーゴ中の資料、契約上制限された資料を決して貼り付けないことです。IBMはAIプライバシーを、AIシステムが収集、使用、共有、保存する個人情報または機微情報を保護することと定義しています。学術研究にはまさにこの種の情報が豊富にあります。インタビュー記録、患者メモ、学校記録、未発表のネガティブ結果、助成金申請書などです。
従来のプライバシー原則は、安易なAI利用と衝突します。Victoria州の情報コミッショナーは、AIが収集の限定、目的の特定、利用の限定に課題をもたらすと指摘しています。これは、必要なものだけを収集し、理由を明示し、新しい目的に再利用しないという考え方です。テーマを見つけるために、完全な質的データセットを公開チャットボットに貼り付けることは、参加者が承認していない新しい目的です。
倫理審査にも耐える封じ込めチェックリストは次のとおりです。
- 最小化する — 生ファイルではなく、コード、非識別化した抜粋、または変数辞書を送ります。AIシステムに対するデータ最小化のガイダンスは、タスクに必要なものだけを収集・保存することです。
- アップロード前に非識別化する — 氏名、場所、まれな診断名、ファイルメタデータを削除します。
- コンテンツで公開モデルをトレーニングしないと明記するプラットフォームを優先する — Jenovaのプラットフォーム方針では、ユーザーデータは公開AIモデルのトレーニングに使用されず、転送中および保存時に暗号化されます。競合他社の規約も同じ具体性の水準で確認してください。「プライバシーを重視しています」は統制ではありません。
- プロジェクトを分離する — 研究ごとに1つのエージェントスレッドとし、病院データセットが公開ブログ記事の下書き中に呼び出されないようにします。
- 契約を確認する — 企業スポンサー付き研究、デュアルユースの知見、データ利用契約では、第三者プロセッサが全面的に禁止されていることがあります。
Jenovaは、公開トレーニングを行わない方針と、ユーザーが制御するプロジェクトメモリにより、この観点ではコンシューマー向けチャットボットより優れています。ただし、HIPAA認定の電子健康記録、匿名化エンジン、または大学のセキュアエンクレーブの代替ではありません。IRBプロトコルに承認済みソフトウェアが指定されている場合は、その一覧が優先されます。
インタビュー研究における安全なプロンプトは次のとおりです。
「氏名と場所をあらかじめ削除した、非識別化済みの6つの抜粋です。テーマ別コードのみを提案してください。個人を推測しないでください。後で忘れるよう依頼した場合、このタスクを超えてこれらの抜粋を保存しないでください。」
テキストがまだ個人を特定できるためにこのプロンプトを書けないなら、そこにAIを使う準備はできていません。
研究公正を守るAI研究ワークフローを構築するには?
研究公正を守るワークフローは、研究質問と情報源ライブラリから始め、名前を付けた段階の中でのみAIを使用し、開示文と検証ログで終えます。以下の手順はJenovaのAcademic Research Assistantで機能し、異なる強みを持ちながらElicitやSciteでも再現できます。
ステージ1 — 情報源なしで範囲を定める。 エージェントに、競合する定義、考えられるデータベース、除外基準を列挙するよう依頼します。まだ引用は受け入れないでください。
「[question]についての方法論の章を書いています。体系的検索で扱うべき下位質問を列挙してください。論文を引用しないでください。私の質問が広すぎる箇所を指摘してください。」
ステージ2 — 検索してからライブラリを固定する。 Academic Research Assistant(数百件の試験をスクリーニングする場合はElicit)を使い、DOIを含む候補レコードを収集します。それらをZotero、EndNote、または機関の管理ツールにエクスポートします。チャット記録ではなく、参考文献管理ツールを正式な記録システムにします。
Jenovaの関連するDeep Researchエージェントは、コーパスを絞り込む前に、広範で引用の多いブリーフィングが必要な場合に役立ちます。そのブリーフィングは、読んだ文献ではなく地図として扱ってください。
ステージ3 — 段落ではなく表で抽出する。 研究デザイン、サンプル、アウトカム、限界を列にして求めます。Elicitはこの目的のために構築されています。Jenovaでも、すでに開いた論文を与えれば同じ表を作成できます。
ステージ4 — 自分のノートから下書きする。 箇条書きを書くか、音声入力します。エージェントにはアウトライン化と論理の検証を許可します。情報源が固定されるまで、表現を「滑らかに」させないでください。
ステージ5 — 検証して開示する。 すべてのDOIを解決します。引用するすべての箇所を読みます。次のようなMethods文を追加します。「ノートの整理および検索語の提案に大規模言語モデル(モデル名、日付)を使用し、すべての引用を著者が一次情報源と照合した。」
Jenovaの設定には数分しかかかりません。Academic Research Assistantを開き、最初のメッセージで分野と研究公正上の制約を記載し、処理が許可されたファイルだけを添付します。無料枠では使用量に制限があり、Plusは月額$20からで、無料枠の30倍の利用枠が提供されます。使用量は1日の上限ではなく月間プールであるため、改訂作業が集中する期間には重要です。
Elicitでは、対応する手順は次のとおりです。レビュー質問を提示し、エビデンステーブルを生成し、どの論文をレポートに含めるかをカスタマイズしてから、エクスポートして検証します。Sciteでは、重要論文を入力し、コンセンサスを主張する前に支持する引用と反駁する引用を確認します。
このワークフローで譲れないルールは順序です。文より先に検索。言い換えより先に原文箇所。提出より先に開示です。
AI支援学術研究について研究公正の専門家は何を述べているか?
研究公正の専門家は、ハルシネーションによる引用、未開示のAI下書き、管理されないデータアップロードを、まれな学生の不正行為ではなく、機関が設計によって防げるプロセス上の失敗として捉える傾向を強めています。
「私たちが見ている誤りは、研究者がモデルを使うこと自体ではありません。引用そのものがデータである作業に対して、生成してから引用するループを使っていることです。結果の節が論文の存在に依存するなら、流暢な偽の参考文献は、ずさんな書式よりもデータ捏造に近いものです。解決策はアーキテクチャです。記録を取得し、主張を抽出し、それから書く。この順番を逆にするツールは、文献に幽霊を植え付け続けるでしょう。」
「プライバシー侵害も同じ順序の逆転から生じます。人々は便利だからという理由で手元にある最も豊富なファイルを貼り付けますが、それは収集の限定とは正反対です。最初に非識別化し、次に最小化し、残余データで公開モデルをトレーニングしないシステムを選んでください。利便性は倫理上の免除ではありません。」
「また私たちは、研究室に対して研究公正をAI検出器へ外部委託するのをやめるよう助言しています。検出器は情報源を示せず、意図を証明できず、非母語話者の執筆者を不当に罰する偽陽性を生み出します。検証ログとCOPE形式の開示は初日には時間がかかりますが、査読者から『この参考文献はどこから来たのですか?』と問われたときには、はるかに迅速です。」
— Jenova Product Team、学術AIワークフロー研究、引用を意識した研究エージェントの設計経験8年
この見解は正式なガイダンスとも一致しています。COPEは人間の著者に責任を課しています。Cornellは、教員に引用検証を求め、検出器のスコアではなく、存在しない参考文献や学生が説明できない方法といった客観的証拠を集めるよう勧めています。CambridgeによるAI時代の研究公正の扱いも同じ前提から始まります。評価がもはや学習を反映しないなら、失われるのは資格そのものです。
AI利用が機関の研究公正しきい値を超えると何が起きるか?
AI利用が機関のしきい値を超えると、罰則は人間の著者に、そしてますます指導教員にも及びます。必要な改訂から提出の停止、登録取り消しまで、その範囲はさまざまです。方針は国や大学によって異なりますが、2026年の流れは、類似性の許容幅の縮小、AI利用に対する明示的な審査、「モデルが作った」という説明への忍耐の低下です。
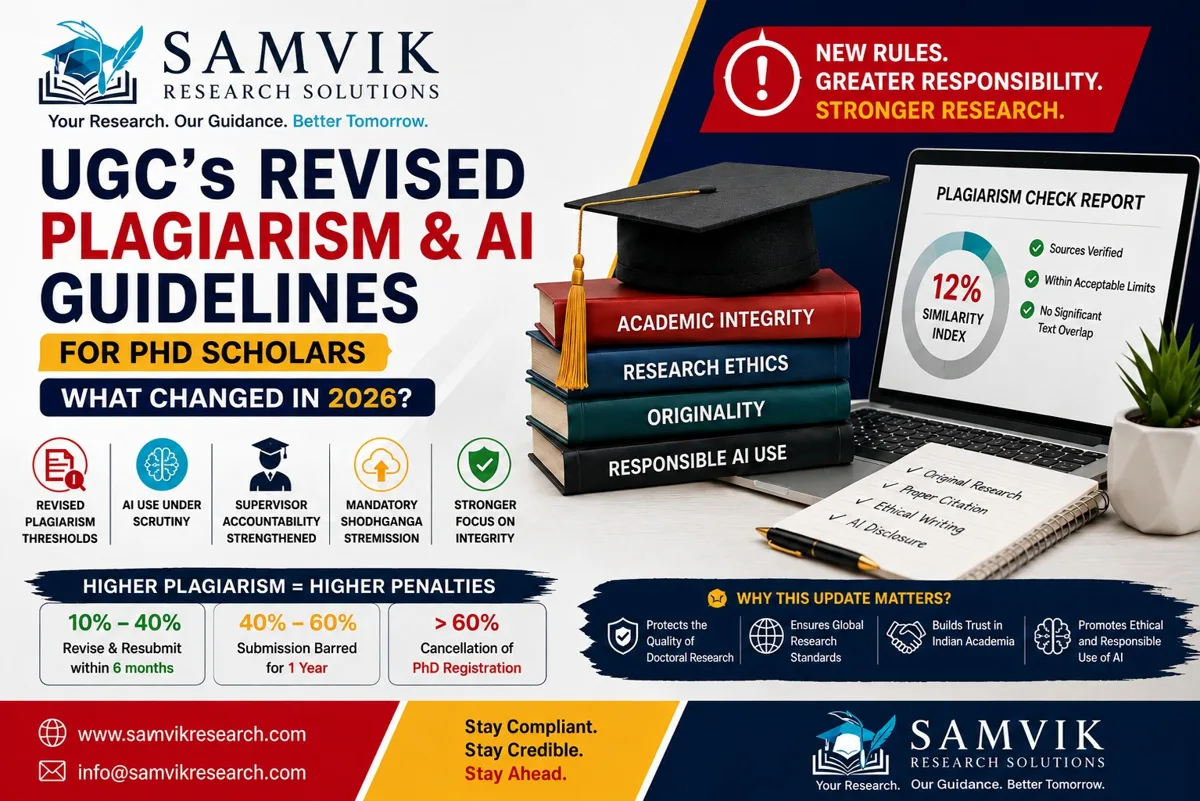
University Grants Commission(UGC)の改訂に関して、2026年にPhD研究者へ周知されたガイダンスは、数値上のしきい値がいかにキャリア上の出来事となるかを示しています。この枠組みでは、類似性が10%から40%の場合、6か月以内の修正・再提出が求められます。40%から60%では1年間提出できない可能性があり、60%を超える類似性ではPhD登録が取り消される可能性があります。同じガイダンスは、これらの区分と、AI利用のより厳密な審査、指導教員の説明責任強化、リポジトリへの登録義務を組み合わせています。あなたの大学が異なる基準値を使用していても、その論理は応用可能です。重複は測定可能な研究公正の指標として扱われ、文章が自分のものでない、または参考文献が実在しない場合、「AIが手伝った」は弁明になりません。
学術誌は第二の層を加えます。COPEの著者資格に関する立場は、ChatGPT、Elicit、Scite、またはJenovaを共著者として記載できないことを意味します。一方で、多くの場合、Methodsでツール名を記載する必要があります。科学自体が健全であっても、開示しないことは透明性違反として扱われる傾向を強めています。対照的に、架空の参考文献は学術記録を偽造するため、掲載拒否または撤回を正当化し得ます。
2026年に投稿するすべての人にとっての実務上の含意は次のとおりです。
- チェッカーを実行した後ではなく、下書きを始める前に地域の類似性基準を把握します。
- プロンプトとモデルのバージョンを保管し、ツールが何に寄与したかを再構成できるようにします。
- 低いAI検出スコアを許可証と見なさないでください。完全で解決可能な参考文献リストを許可証と見なしてください。
- 学生を指導する場合は、情報源ログを確認してください。説明責任は上位層へも移っています。
これらの制約の中で使用すれば、AIは検索、抽出、整理を正当に加速できます。捏造された参考文献リストを伴う見えない共著者として使えば、学位や論文を停滞させる最も早い方法の一つになります。
参考文献
- Nature — ハルシネーションによる引用が科学文献を汚染している
- Enago — AI生成参考文献:5件に1件は偽物
- STAT — AIハルシネーションが原因とされる不正引用が学術論文に広がっている
- Today’s Clinical Lab — AI生成の偽参考文献が生物医学文献全体で増加
- Accountability in Research(Taylor & Francis)— 生成AIが生み出すハルシネーションによる引用
- PubMed Central — AI時代の捏造引用:編集者への警鐘
- Cornell University Center for Teaching Innovation — AIと研究公正
- COPE — 著者資格とAIツール
- Elicit — 科学研究のためのAI(コーパス規模、文レベルの引用、体系的レビューのワークフロー)
- Scite — 3億本超の学術論文に基づく引用裏付け回答
- Paperguide — 研究者向けElicitとSciteの比較(2026)
- The Drive AI — Elicit、Consensus、Semantic Scholarの比較
- George Mason University Libraries — 文献レビューのためのAIツール
- IBM — AI時代におけるプライバシー問題の考察
- Office of the Victorian Information Commissioner — AIとプライバシー:課題と問題
- Fortra — AIデータプライバシー:課題と解決策
- European Network for Academic Integrity — 研究公正の一般ガイドライン
- ScienceDirect — AI時代における研究公正の再評価
- Cambridge University Press — AI時代の研究公正